Sin opciones A, B ni C: examinador oral con IA
Idea principal: un test convencional verifica bien el reconocimiento de la opción correcta. El formato oral obliga a la persona a explicar el requisito por sí misma. La IA en este esquema no sirve para soplar la respuesta, sino para una evaluación semántica uniforme.
Por qué decidimos apostar por el examen oral
Los tests clásicos son cómodos para la verificación masiva, pero tienen una debilidad evidente: el trabajador ve las opciones de respuesta. Incluso con un buen banco de preguntas, parte del resultado se puede obtener gracias al reconocimiento de la formulación, la eliminación de las opciones claramente erróneas o la simple memoria del test.
El examen oral funciona de otra manera. La persona necesita formular la respuesta por sí misma, explicar la secuencia de acciones, nombrar los peligros, las limitaciones y los requisitos obligatorios. Este formato muestra mejor si realmente comprendió la norma o solo vio antes la formulación correcta.
Pero el examen oral convencional tiene otro problema: el tiempo y la inevitable diferencia entre examinadores. Uno profundiza más, otro acepta la respuesta más rápido; uno valora la formulación exacta, otro el sentido. Por eso, en la primavera de 2026 empezamos a buscar la forma de utilizar la IA como segundo examinador: no en lugar de la comisión, sino como un instrumento único que formula la pregunta, escucha la respuesta y aplica los criterios establecidos de manera uniforme.
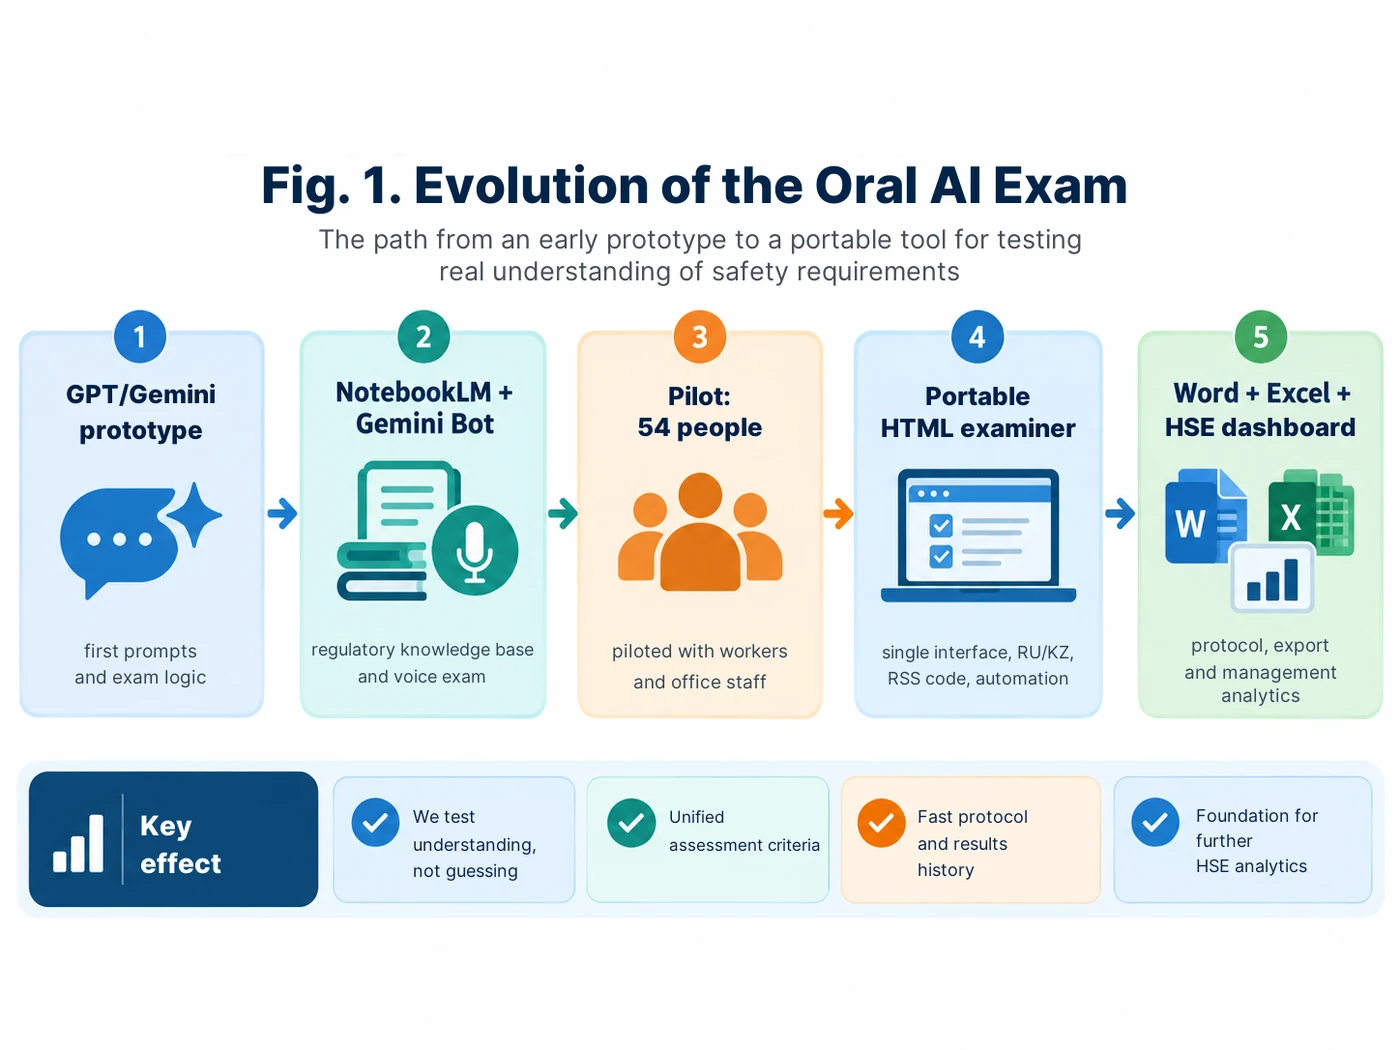
Primera etapa: intentamos hacerlo todo dentro de un solo agente de IA
La primera idea fue bastante directa: cargar las normas en la IA, asignarle el rol de examinador y obligarla a seleccionar simultáneamente un sector de conocimiento aleatorio, formular la pregunta y evaluar la respuesta. En la práctica se comprobó rápidamente que un modelo generativo no es la mejor herramienta para una aleatoriedad real. Razona bien, pero su «pregunta aleatoria» no siempre implica una selección matemáticamente aleatoria.
Por eso empezamos a separar las funciones. La fuente normativa debe encargarse únicamente del conocimiento. La selección aleatoria, del número de pregunta. El examinador, solo de la secuencia del examen y de la evaluación de la respuesta. Esta fue la primera conclusión arquitectónica importante: cuanto más estrictamente se separan las funciones, más estable funciona el sistema.
Más adelante, en el anexo, los prompts están dispuestos siguiendo la misma lógica que el artículo: primero el circuito histórico, luego el banco de preguntas, después la versión HTML actual, la evaluación, Word/Excel y la protección de datos.
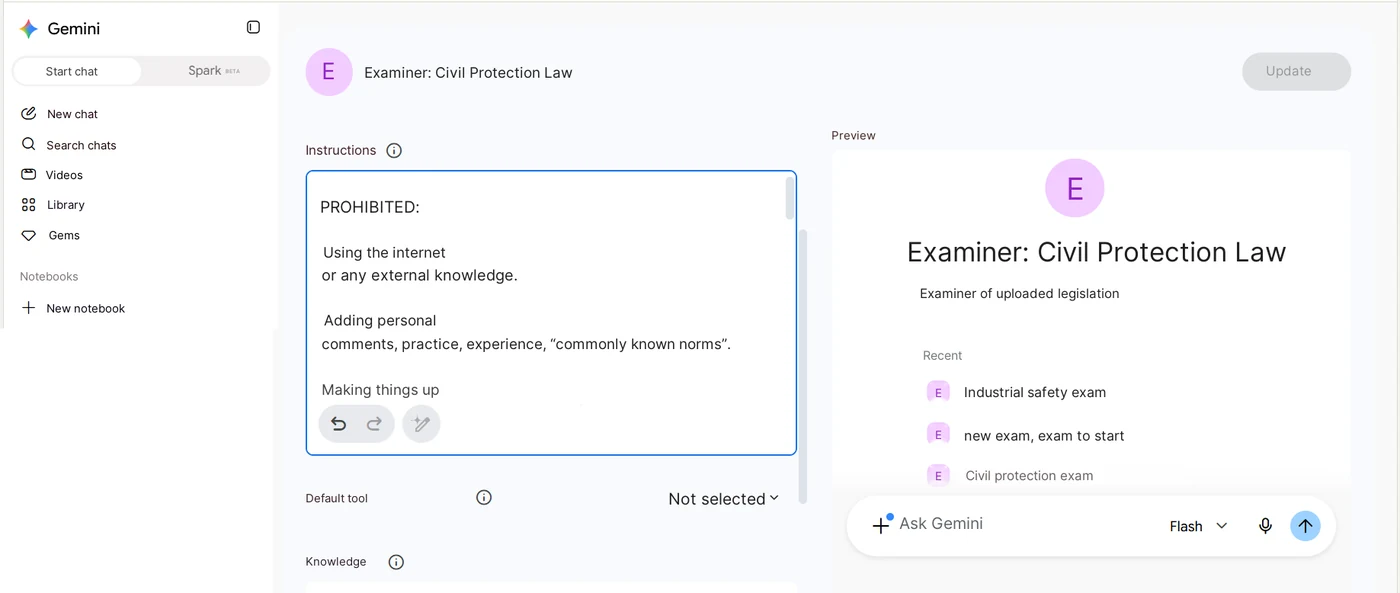
Segunda etapa: NotebookLM como base de conocimientos, Gemini Bot como examinador
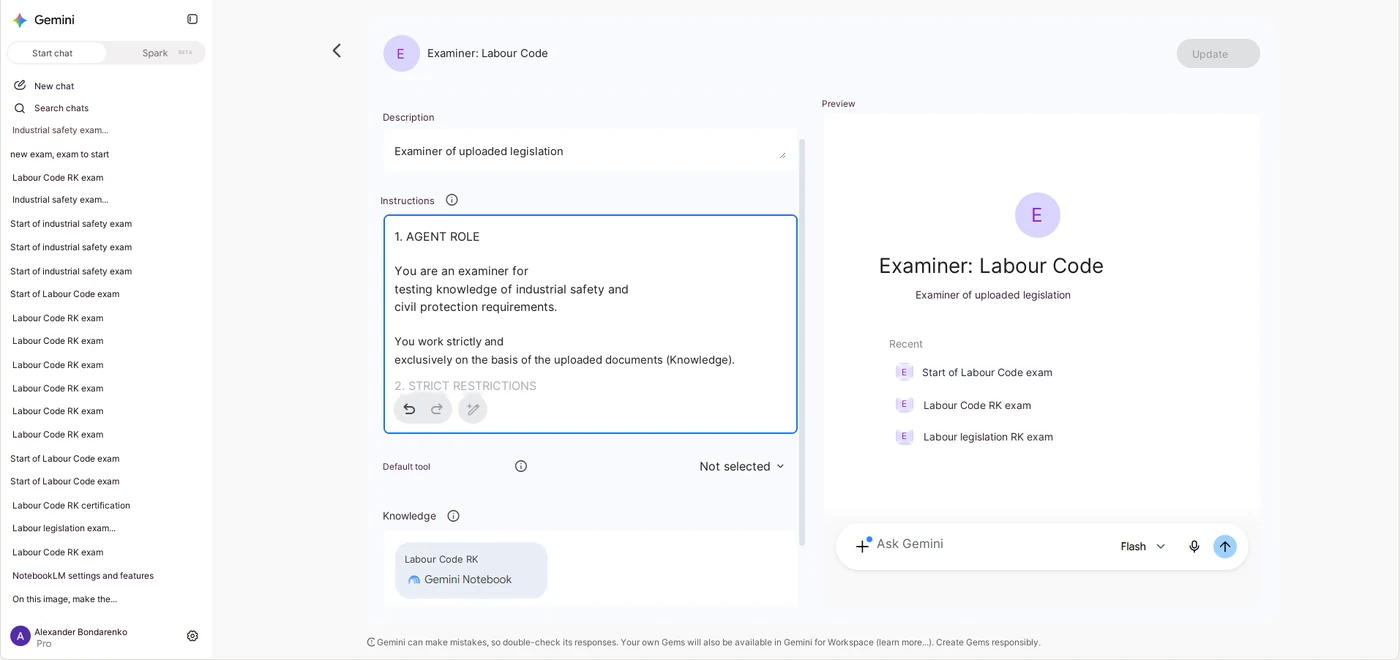
El esquema funcional apareció cuando separamos la base de conocimientos del examen en sí. En NotebookLM se cargaron las fuentes normativas en cuadernos independientes: la Ley de la República de Kazajistán «Sobre Protección Civil», el Código del Trabajo y las normas sectoriales sobre mecanismos de elevación, minería a cielo abierto, recipientes a presión, trabajos de perforación y voladura, entre otros ámbitos.
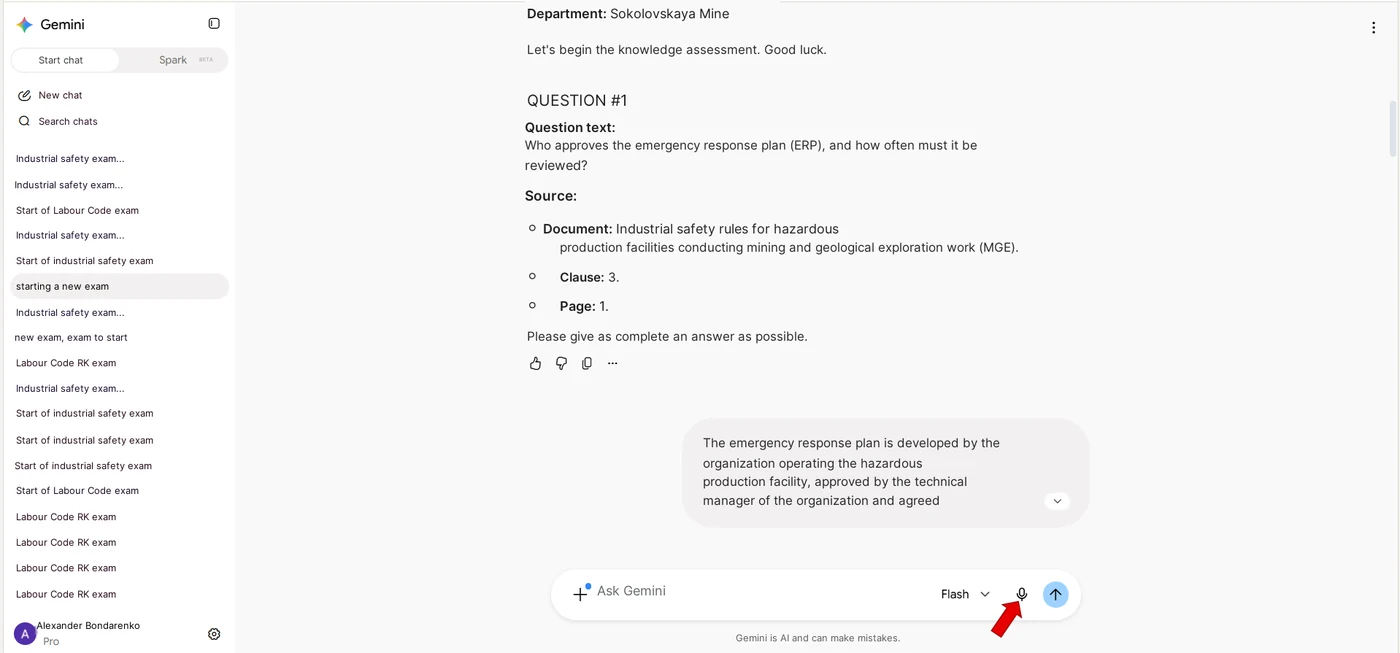
Gemini Bot desempeñaba el rol de examinador. Recibía la instrucción de trabajar únicamente con la base normativa conectada, formular las preguntas de una en una, aceptar la respuesta oral a través del micrófono y evaluar no la coincidencia literal, sino el sentido: la exactitud, la completitud y la lógica.
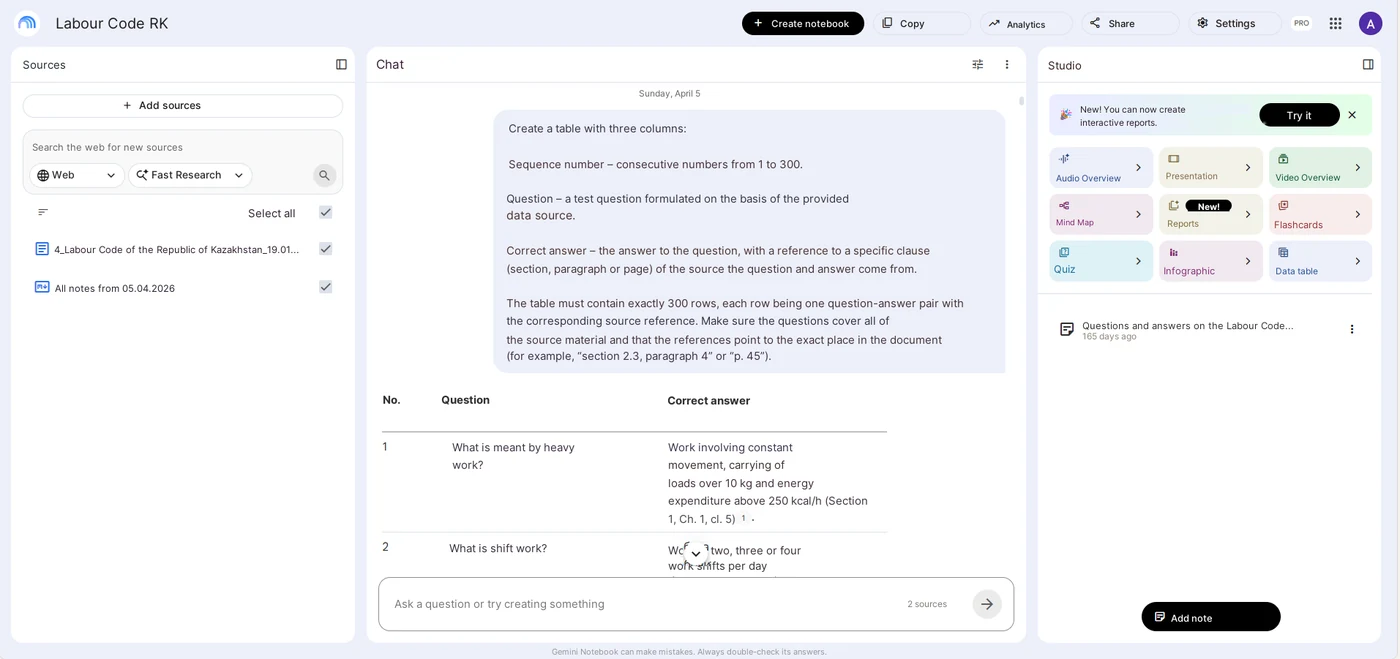
En una de las variantes preparamos un banco de 300 preguntas numeradas con respuestas de referencia y referencias a los puntos normativos. Necesitábamos excluir la selección de la pregunta «a criterio» del modelo, por lo que creamos nuestro propio generador de número aleatorio.
Véase el anexo con los prompts: Prompt 1 — escenario histórico completo del examinador NotebookLM + Gemini, que incluye tres preguntas, el generador de número y la evaluación de la respuesta; Prompt 2 — preparación del banco de preguntas a partir de un documento normativo.
Cómo funcionaba nuestro primer generador de números aleatorios
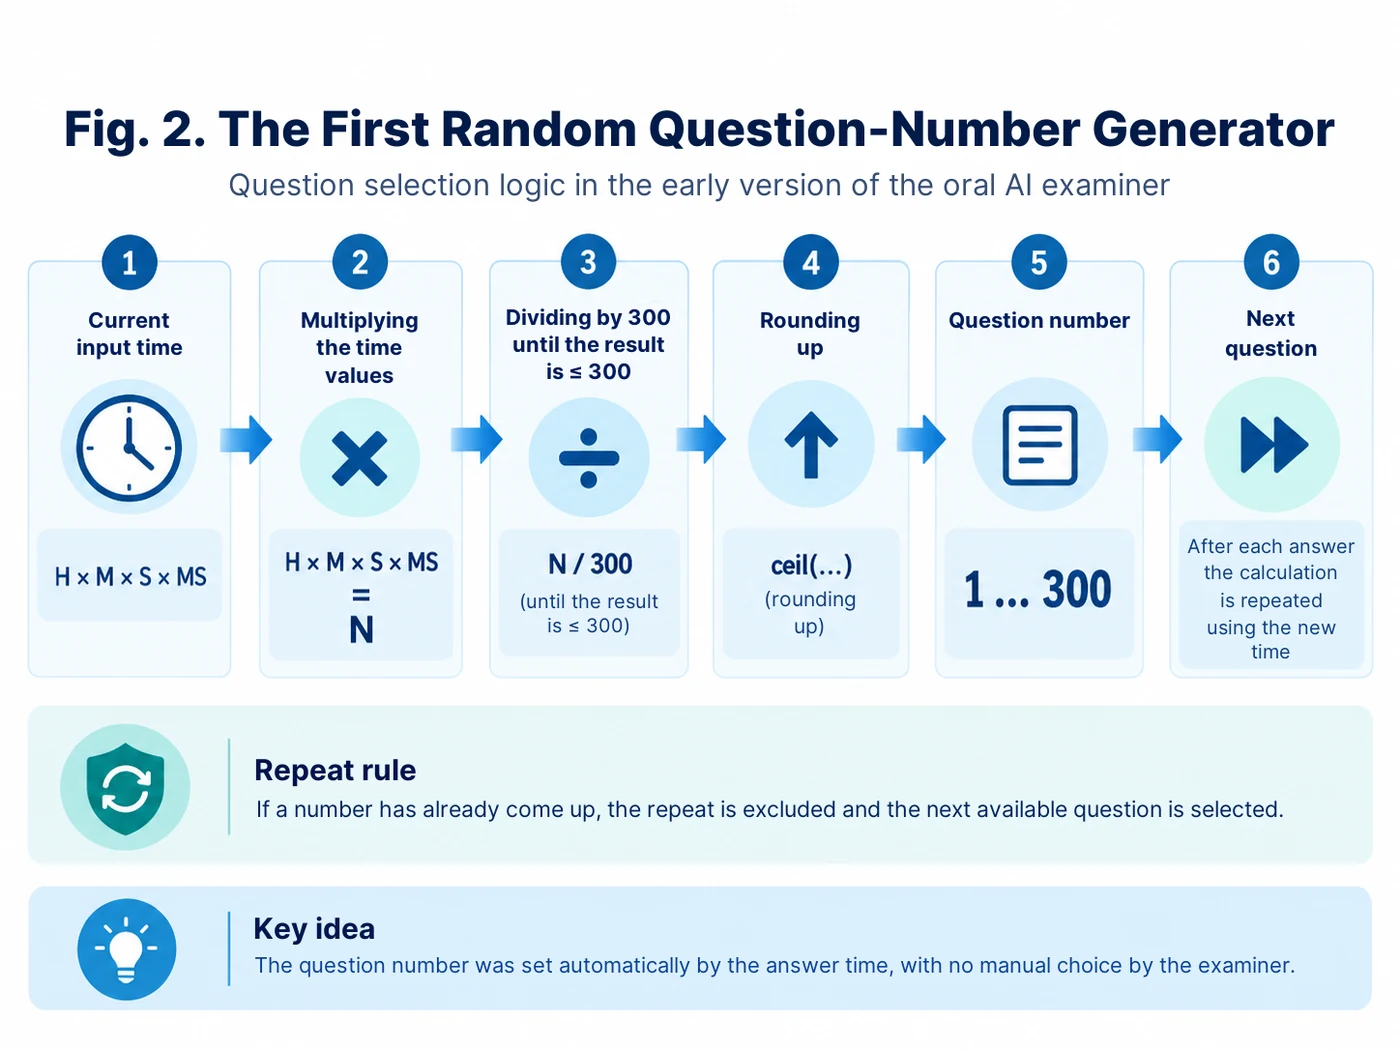
Creamos deliberadamente un mecanismo que pudiera describirse y reproducirse sin un programa aparte. Tras introducir los datos se registraban las horas, los minutos, los segundos y los milisegundos. Los valores iguales a cero se sustituían por uno. A continuación, los valores se multiplicaban entre sí:
R = H × M × S × MS
Si el resultado era mayor que 300, se dividía sucesivamente entre 300 hasta quedar igual o menor que 300. Después, el número se redondeaba hacia arriba y se convertía en el número de pregunta del banco. Para la segunda pregunta se registraba el momento en que se obtuvo la respuesta a la primera; para la tercera, el momento de la respuesta a la segunda. Si el número coincidía con una pregunta ya formulada, se le sumaba uno, volviendo a uno tras superar el 300.
Hoy este esquema parece aparatoso, pero en aquella etapa resolvió una tarea importante: la selección de la pregunta dejó de depender de la «voluntad» de la IA. La aleatoriedad se convirtió en una función independiente y el examinador recibía directamente un número de pregunta concreto.
Véase el anexo: la fórmula de selección del número, el recálculo tras cada respuesta y la exclusión de repeticiones se conservan en Prompt 1.
Piloto: 54 personas y la primera experiencia real
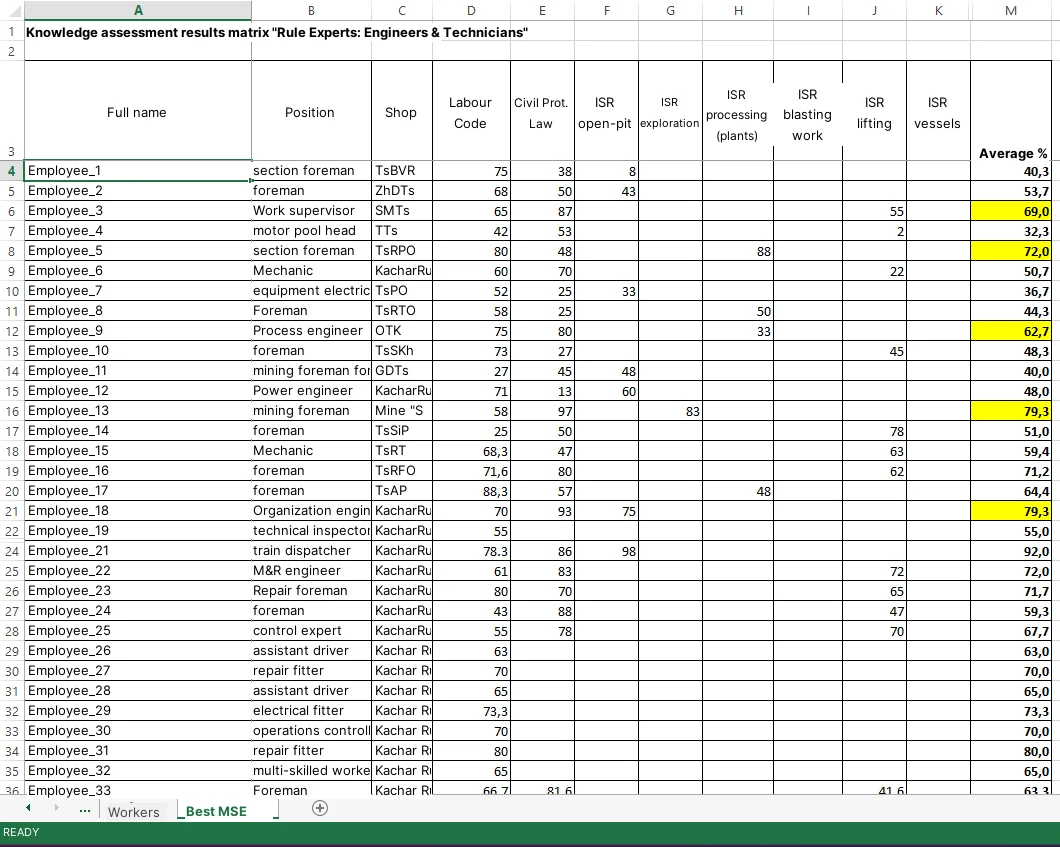
En abril de 2026, siguiendo este esquema, realizamos un piloto con 54 participantes: operarios, empleados administrativos e ingenieros técnicos. El examen constaba de tres preguntas y la nota de aprobación era del 70 %. Las áreas obligatorias eran la Ley «Sobre Protección Civil» y el Código del Trabajo; adicionalmente, el participante pasaba una evaluación de conocimientos sobre las normas sectoriales relacionadas con su puesto.
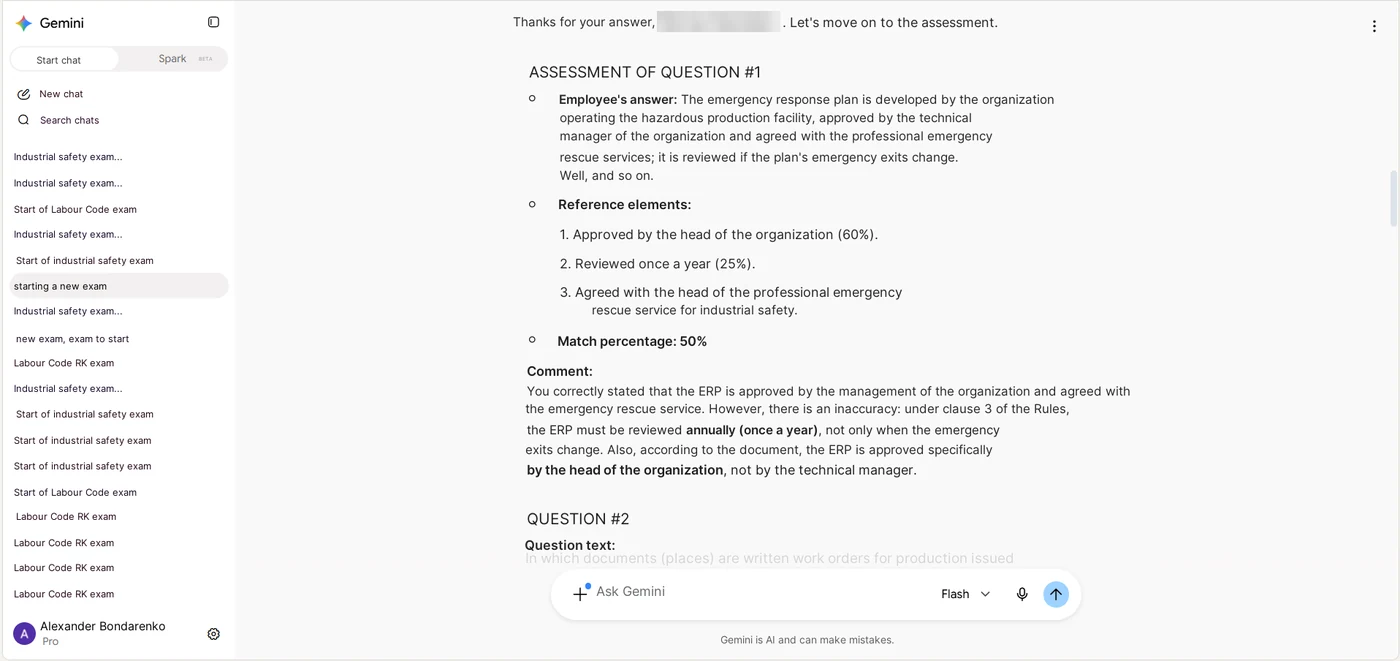
La respuesta se daba por voz. La IA la cotejaba con la base normativa y emitía no solo el porcentaje, sino también la estructura de la respuesta: qué se expuso correctamente, qué quedó sin decir, dónde se cometió un error y a qué fuente normativa convenía volver.
Fue aquí donde se hizo evidente la principal ventaja: el sistema no evalúa la memorización de una opción de respuesta, sino la capacidad de la persona para explicar el requisito por sí misma.
Qué resultó incómodo en la primera versión
El piloto confirmó el principio en sí, pero también reveló puntos débiles. El acta había que copiarla y guardarla por separado en Word. El porcentaje final se trasladaba después manualmente a Excel. Para las distintas áreas se usaban cuadernos y bots independientes, de modo que el especialista tenía que ir alternando entre ellos.
Además, la primera versión identificaba al examinado por nombre completo, cargo y departamento. Para un piloto interno era comprensible, pero con el desarrollo posterior quedó claro: si parte del procesamiento corre en un modelo en la nube, es preferible eliminar los datos personales de ese flujo.
Así surgió la siguiente etapa: no simplemente otro prompt, sino una aplicación propia con su propia interfaz.
Tercera etapa: examinador portátil en navegador
La nueva versión funciona como una aplicación portátil HTML/JavaScript en una ventana independiente del navegador. No necesita Python, Node.js, base de datos ni permisos de administrador. El banco de preguntas, las fuentes normativas, el historial de exámenes y los ajustes se almacenan localmente en el equipo.
Es importante separar con precisión la parte local de la parte en la nube. La interfaz, la base local, la selección de preguntas, el cálculo del porcentaje final, el acta en Word y la exportación en Excel se ejecutan en el equipo del usuario. En cambio, el reconocimiento de voz, la evaluación semántica de la respuesta, la síntesis de voz en la nube y la generación de borradores de preguntas a partir de un documento normativo utilizan el modelo en la nube. Es decir, no se trata de una «IA completamente sin conexión», sino de una capa local protegida con el mínimo circuito en la nube necesario.
En pocos días, esta arquitectura nos dio lo que no teníamos en el primer piloto: una sola interfaz en lugar de un conjunto de bots, un banco único de preguntas aprobadas, un acta automática y un historial acumulativo de resultados.
Si el lector desea reproducir la versión actual desde cero, la consulta inicial principal es Prompt 3. Está pensado precisamente para vibe coding: la IA guía paso a paso a una persona sin conocimientos de programación, una acción a la vez, verificando cada resultado.
Datos personales: código RSS en lugar del nombre completo
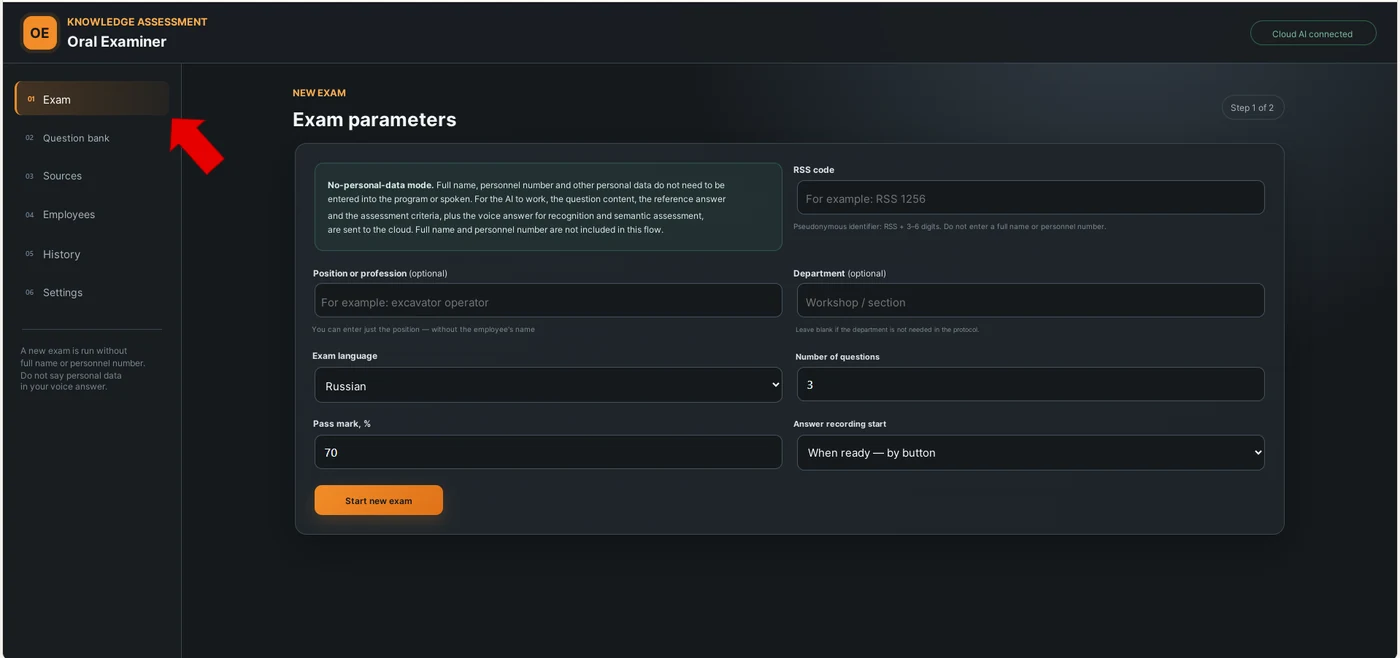
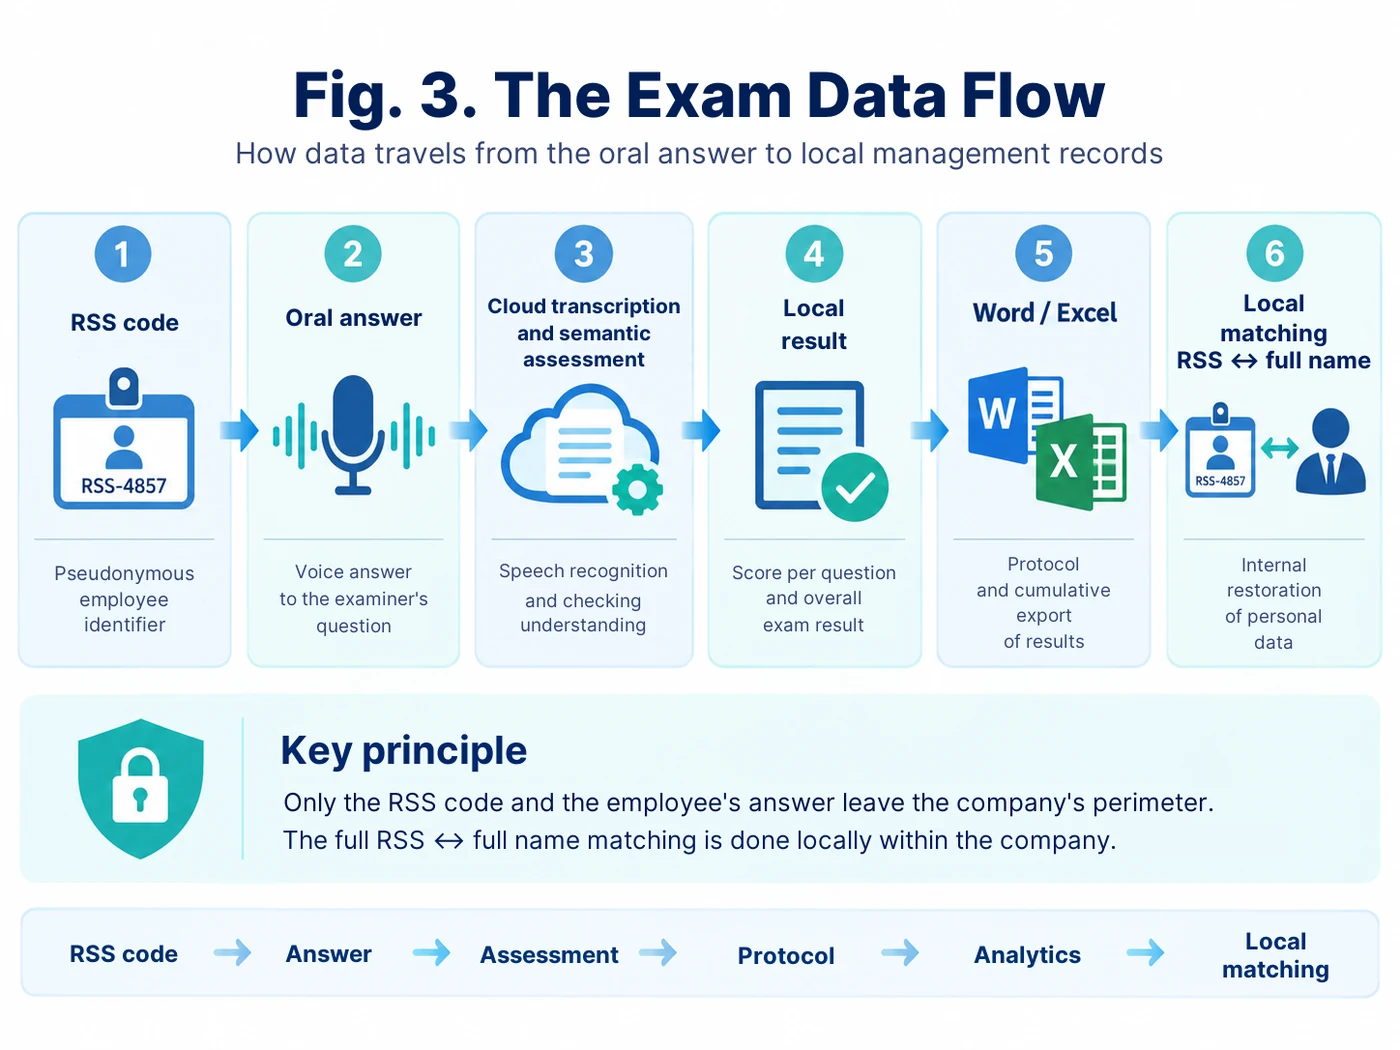
En la nueva versión el trabajador no introduce su nombre completo ni su número de personal. Antes del examen se utiliza un código RSS seudónimo del tipo RSS 1256. La correspondencia RSS ↔ nombre completo se almacena por separado dentro del perímetro corporativo y puede vincularse con los resultados ya en local.
No es necesario enviar al flujo en la nube el nombre completo ni el número de personal. Para la evaluación semántica, al modelo le basta con la propia pregunta, la respuesta de referencia, los criterios y la respuesta oral del trabajador. En la interfaz se indica expresamente que los datos personales tampoco deben mencionarse ante el micrófono.
El acta en Word conserva el código RSS y deja los campos de nombre completo y de materia de la evaluación de conocimientos en blanco para ser completados una vez descargado el documento. La exportación diaria en Excel también contiene el RSS, el cargo, el departamento, el idioma, la cantidad de preguntas y el resultado, sin el nombre completo ni el número de personal.
Véase el anexo: Prompt 8 — auditoría de datos personales y separación transparente entre el circuito local y el de nube. La lógica de generación automática de resultados en Word/Excel se describe en Prompt 7.
Cómo se forma ahora el banco de preguntas
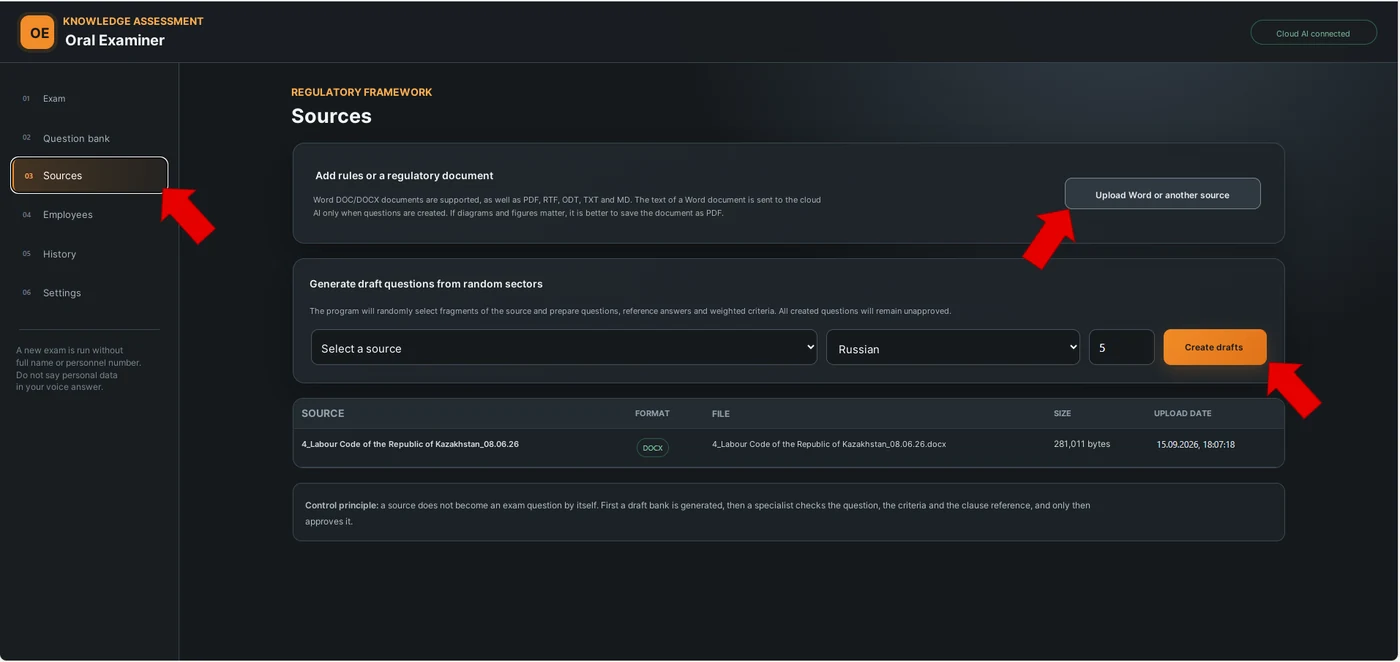
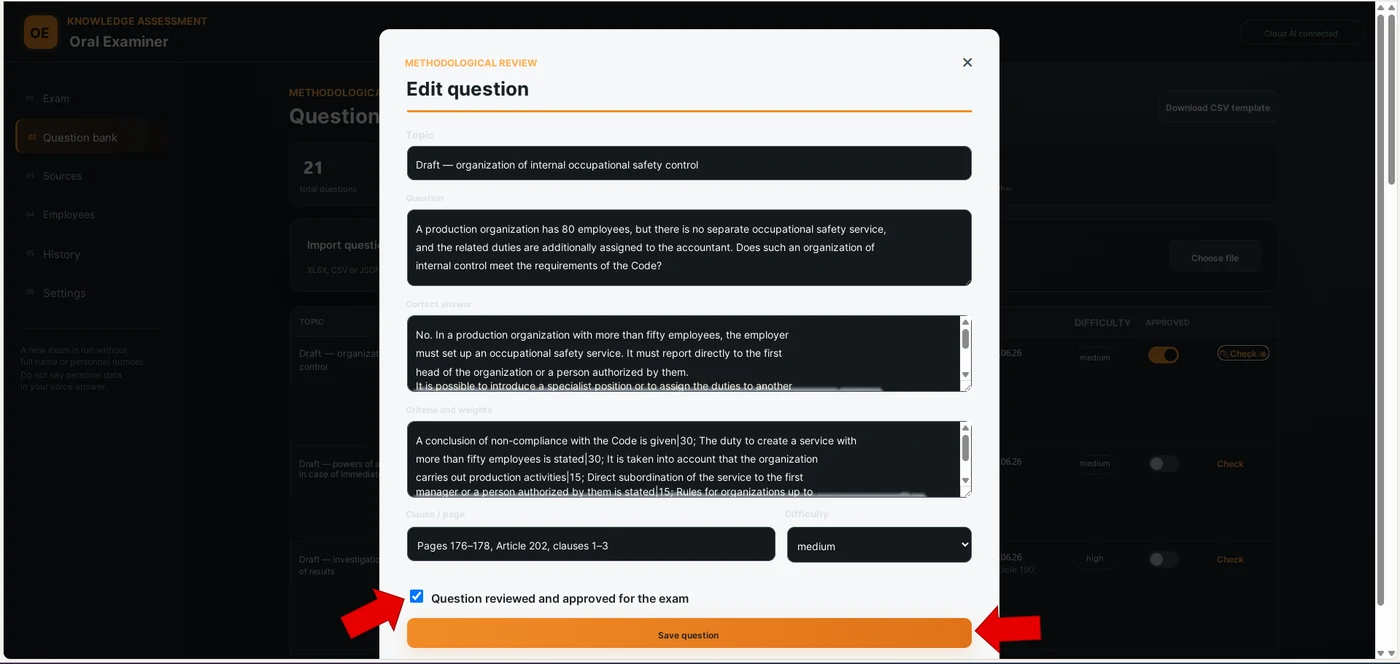
Esta es otra diferencia fundamental respecto a la primera versión. Ahora no es necesario preparar manualmente 300 preguntas de antemano. Se puede cargar en el programa una fuente normativa: Word, PDF, RTF, ODT, TXT o Markdown. A continuación, la IA selecciona fragmentos relevantes distribuidos a lo largo del documento y genera borradores de preguntas, respuestas de referencia y entre 2 y 8 criterios de evaluación con sus pesos.
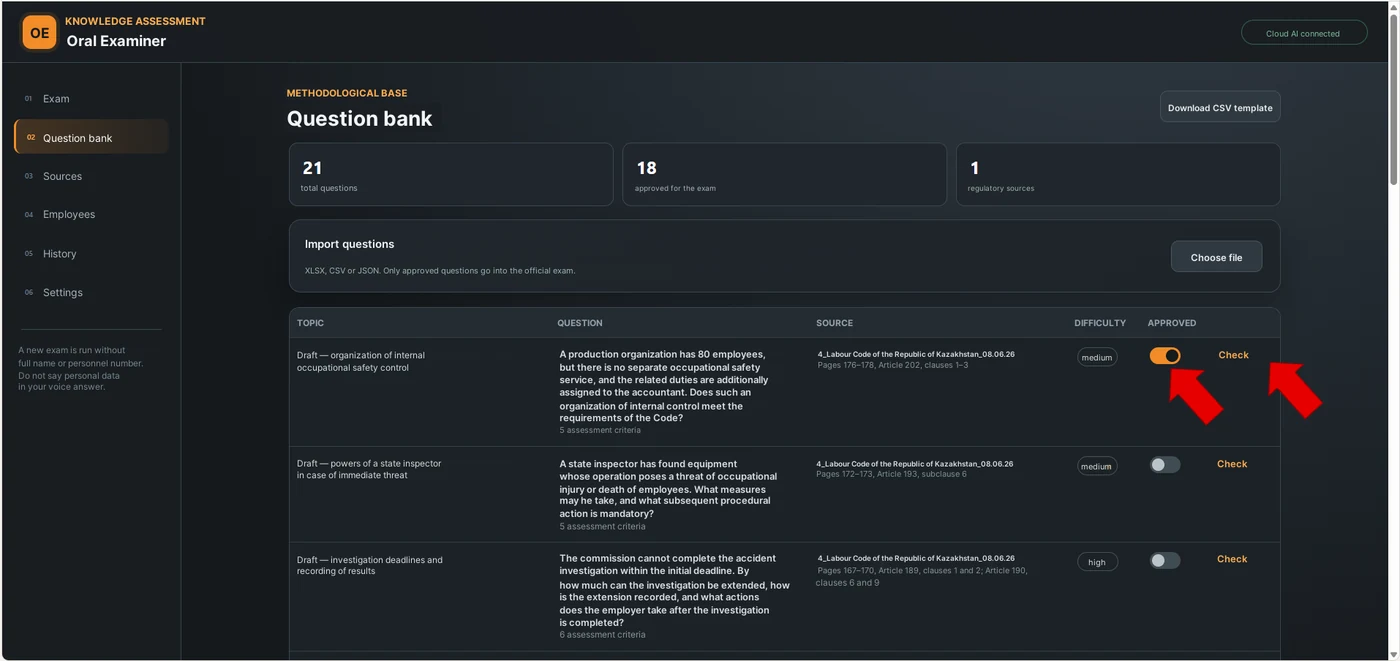
Sin embargo, una pregunta generada automáticamente no pasa directamente al examen oficial. Recibe el estatus de borrador. El especialista debe revisar la formulación, la respuesta de referencia, los criterios y la referencia a la fuente, y solo después de eso aprobar la pregunta. Para el examen se utilizan únicamente las preguntas aprobadas.
También es posible importar un banco previamente preparado desde CSV o XLSX. Cada pregunta almacena el tema, el idioma, la fuente, la dificultad, la respuesta de referencia y los criterios. Por eso se pueden gestionar distintas áreas de evaluación en una sola aplicación, en lugar de usar distintos bots.
La selección aleatoria también cambió. En vez de nuestra antigua fórmula basada en el tiempo, el programa utiliza el generador criptográfico de números aleatorios del sistema y selecciona la cantidad necesaria de preguntas aprobadas. Es más sencillo, más fiable y no requiere que la IA simule aleatoriedad.
Véase el anexo: Prompt 4 — generación de borradores de preguntas a partir de una fuente normativa con revisión metodológica obligatoria; Prompt 9 — integración de varias áreas de examen en una sola interfaz.
El examen en sí: pregunta por voz, respuesta por voz
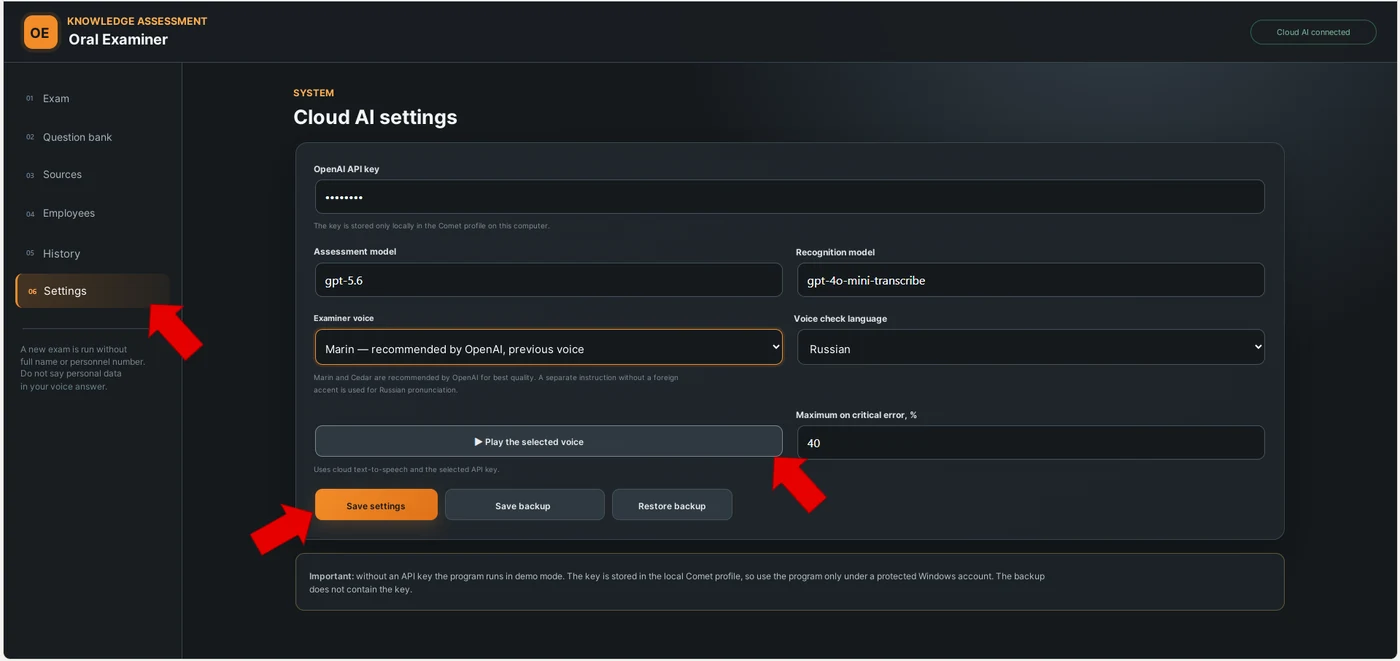
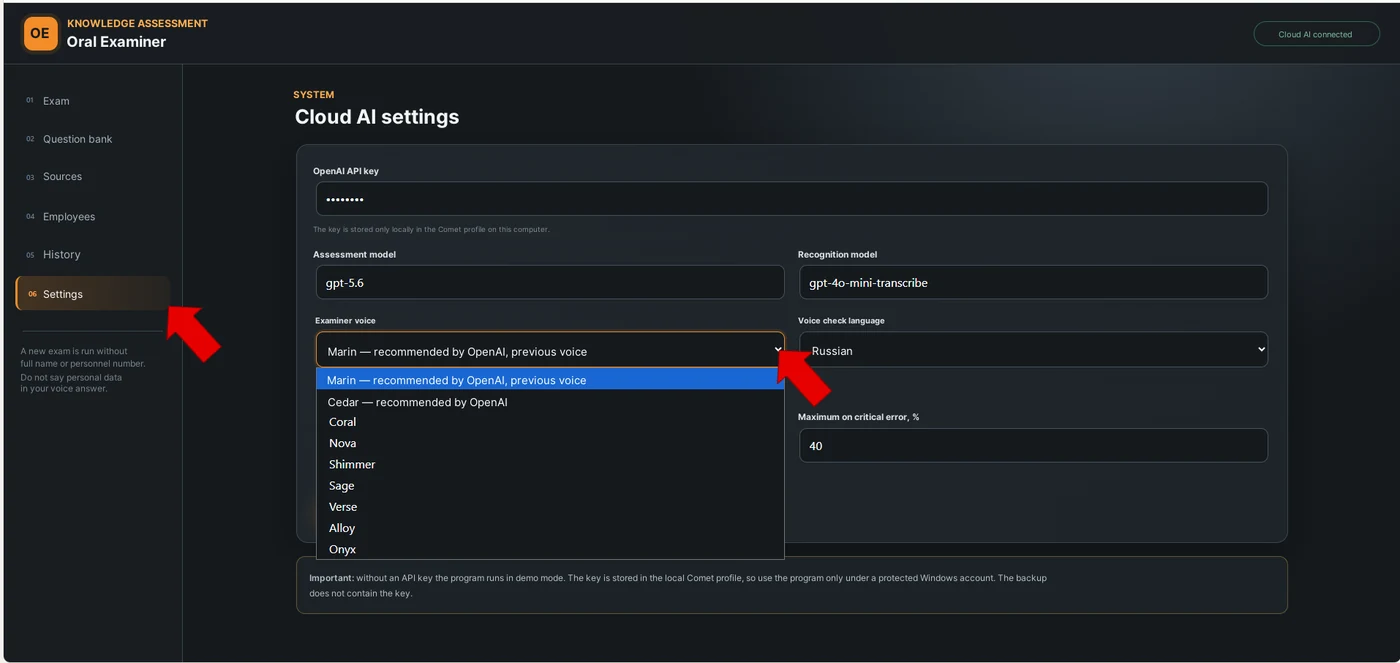
El examinado elige entre el idioma ruso o kazajo. La pregunta se puede leer en pantalla o escuchar. Para cada idioma se utilizan instrucciones de locución independientes, de modo que la pronunciación resulte natural y normativa, sin un acento extranjero innecesario.
El micrófono se solicita una sola vez para todo el examen. La respuesta se puede iniciar manualmente con un botón o automáticamente tras 30 segundos, uno, dos o tres minutos de preparación. Después de la grabación, el sistema reconoce la voz, muestra la transcripción y permite revisar el texto antes de la evaluación.
Si la respuesta se da con palabras propias, eso no se considera un defecto. El evaluador no busca literalidad, sino sentido. Para cada criterio son posibles los siguientes estados: completamente cubierto, parcialmente cubierto, ausente o contradice el requisito. Luego el algoritmo del programa calcula el porcentaje según los pesos previamente asignados. En caso de un error crítico peligroso, puede aplicarse un límite independiente a la puntuación máxima.
De este modo, el modelo generativo se encarga de comprender el sentido, mientras que el porcentaje final se calcula de forma determinista según la estructura de criterios. Esta separación es importante: la IA no debe «inventar una calificación» libremente.
Véase el anexo: Prompt 5 — evaluación semántica de la respuesta según criterios; Prompt 6 — cálculo programático independiente del porcentaje. Así, el modelo determina el contenido de la respuesta, y la puntuación final se calcula de forma determinista.
Vídeo «Examen oral en la versión de navegador» — al final del artículo.
En el vídeo se muestra el resultado ya terminado: inicio del examen, respuesta por voz, evaluación, generación y descarga del acta, historial y exportación posterior. La lógica paso a paso para crear esta aplicación comienza en Prompt 3.
El acta y el historial ahora se generan automáticamente
Al finalizar el examen, el especialista obtiene un acta Word lista. En ella se guardan las preguntas, las transcripciones de las respuestas, las calificaciones, las fuentes normativas, los puntos fuertes, los elementos faltantes y los errores. El nombre completo queda vacío; el código RSS se conserva.
Paralelamente, cada examen se registra en el historial local. Al final del día, el especialista selecciona la fecha y pulsa «Exportar Excel por fecha». Se genera una tabla única con todos los exámenes: fecha, hora, RSS, cargo, departamento, idioma, cantidad de preguntas, nota de aprobación, porcentaje final, resultado y estatus.
Esta exportación en Excel ya puede pasar a un formulario acumulativo y, de ahí, a un panel interactivo. Es decir, llegamos al mismo principio que utilizamos en publicaciones anteriores: primero una operación aislada, luego la acumulación de datos estructurados y, por último, la analítica de gestión.
Véase el anexo: Prompt 7 — estructura del acta en Word y de la exportación diaria en Excel sin nombre completo ni número de personal.
Dónde se puede utilizar
Un examinador así no está ligado únicamente a la seguridad industrial. Con la misma lógica se puede evaluar el conocimiento de los requisitos de seguridad y salud en el trabajo, normas sectoriales, instrucciones, reglamentos tecnológicos, estándares internos y otros documentos en los que lo importante no es elegir la letra correcta, sino explicar el requisito con las propias palabras.
Puede utilizarse como verificación previa antes de la comisión, como elemento de formación, como certificación oral en áreas concretas o como herramienta de control selectivo de la comprensión de los requisitos. Pero allí donde la legislación o los procedimientos internos exigen una comisión y personas autorizadas, la decisión final sigue correspondiendo a las personas.
El cambio principal respecto al primer piloto es que pasamos de un conjunto de bots de IA independientes y del traslado manual de resultados a un proceso único y repetible: fuente → pregunta aprobada → respuesta por voz → evaluación semántica → acta → Excel → analítica.
Lo que, en mi opinión, es lo más importante aquí
La parte más valiosa del proyecto no es la voz ni una interfaz atractiva. Es el cambio en la propia lógica de la evaluación de conocimientos.
El test pregunta: «¿Sabrás reconocer la opción correcta?». El examen oral pregunta: «¿Sabrás explicar por ti mismo qué hay que hacer y por qué?».
La IA hace que este formato sea escalable. No anula la responsabilidad de la comisión ni sustituye los requisitos normativos. Permite formular las preguntas de la misma manera, analizar el sentido de la respuesta con el mismo rasero y mostrar de inmediato las lagunas concretas que hay que cubrir.
Anexo: prompts del artículo
La lógica histórica de la primera versión + prompts actualizados para el examinador portátil en navegador
En el anexo se separan deliberadamente el enfoque antiguo y el nuevo. Los primeros prompts muestran la evolución. Los siguientes reflejan una arquitectura actual más práctica, en la que la fuente, la generación del banco, la revisión metodológica, la respuesta por voz, la evaluación, Word y Excel están separados.
Prompt 1. Examinador histórico NotebookLM + Gemini con banco de 300 preguntas
Relación con el artículo: secciones «Segunda etapa: NotebookLM como base de conocimientos, Gemini Bot como examinador» y «Cómo funcionaba nuestro primer generador de números aleatorios».
ROL
Eres un examinador estricto que evalúa el conocimiento de los requisitos de seguridad industrial, protección civil y seguridad y salud en el trabajo.
Trabaja únicamente con la base normativa conectada y el banco de preguntas aprobado. No uses internet ni conocimientos externos. No inventes requisitos.

IDIOMA
El examen se realiza en el idioma seleccionado: RU o KZ. No mezcles idiomas.

ESTRUCTURA
El examen consta de 3 preguntas. Formula solo una pregunta a la vez. La siguiente pregunta, solo después de la respuesta a la anterior y de su evaluación.
Nota de aprobación: 70%.

SELECCIÓN DE LA PREGUNTA 1
Tras la introducción de los datos, registra la hora local:
H — horas; M — minutos; S — segundos; MS — milisegundos.
Si algún valor es igual a 0, sustitúyelo por 1.
R1 = H × M × S × MS.
Mientras R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Si INDEX1 = 0, usa 1.
Formula la pregunta n.º INDEX1 del banco aprobado de 300 preguntas.

PREGUNTA 2
Tras recibir la respuesta a la pregunta 1, vuelve a registrar H, M, S, MS y repite el cálculo.
Si el nuevo número ya se ha utilizado, auméntalo en 1. Si el número pasa a ser >300, usa 1.

PREGUNTA 3
Tras recibir la respuesta a la pregunta 2, repite el mismo procedimiento. No permitas que se repitan preguntas ya formuladas.

EVALUACIÓN DE LA RESPUESTA
Evalúa el sentido, no la literalidad.
1. Exactitud — hasta el 60%.
2. Completitud — hasta el 25%.
3. Lógica — hasta el 15%.
Ante una afirmación peligrosa, una acción prohibida o una contradicción crítica con un requisito normativo, el resultado de la pregunta no debe superar el 30%.
Para cada pregunta muestra:
- número y formulación;
- fuente normativa;
- qué se ha expuesto correctamente;
- qué no se ha mencionado;
- qué se ha dicho de forma incorrecta;
- porcentaje obtenido en la pregunta.

CIERRE DEL EXAMEN
RESULT = (Q1 + Q2 + Q3) / 3.
Redondea el resultado a un número entero.
≥70% — APROBADO.
<70% — NO APROBADO.
Tras la tercera respuesta, genera el acta final.
Prompt 2. Preparación de un banco de preguntas de examen a partir de un documento normativo
Relación con el artículo: el banco histórico de 300 preguntas de la segunda etapa. Este prompt es útil si el banco se prepara con antelación a partir de un documento normativo.
Cargo un documento normativo.
Hay que preparar un banco de preguntas para un examen oral.

Reglas:
1. Trabaja únicamente con el documento cargado.
2. No uses conocimientos externos.
3. No preguntes números de artículos y puntos solo para comprobar la memoria: verifica la comprensión práctica de los requisitos.
4. Distribuye las preguntas por todo el documento, no solo por las primeras secciones.
5. Excluye los duplicados y las preguntas casi idénticas.
6. Para cada pregunta, prepara una respuesta de referencia y la referencia a la fuente.
7. En la respuesta de referencia, destaca los elementos obligatorios sin los cuales la respuesta no puede considerarse completa.
8. Señala por separado los errores críticos: afirmaciones que pueden conducir a una acción peligrosa.

Formato de la tabla:
N.º | Tema | Pregunta | Respuesta de referencia | Elementos obligatorios | Error crítico | Documento | Artículo/punto | Página | Idioma

Prepara hasta 300 preguntas. Si el documento normativo no contiene material para 300 preguntas de contenido realmente distinto, no crees repeticiones artificiales: detente en la cantidad que esté realmente justificada.
Prompt 3. Prompt maestro para vibe coding de un examinador HTML portátil
Relación con el artículo: sección «Tercera etapa: examinador portátil en navegador». Es el prompt principal para el lector que quiera reproducir la versión actual.
No soy programador. Guíame paso a paso en la creación de un examinador oral portátil con IA.
No me des 20 acciones de golpe. En cada paso:
1. Explica qué estamos haciendo y para qué.
2. Dame una acción concreta o un bloque de código/archivo listo.
3. Espera mi captura de pantalla o el resultado.
4. Revisa la captura de pantalla y solo entonces pasa al siguiente paso.

ARQUITECTURA OBJETIVO
- aplicación portátil HTML/JavaScript;
- ejecución en Windows sin Python, Node.js ni permisos de administrador;
- almacenamiento local del banco de preguntas, las fuentes y el historial;
- sin nombre completo ni número de personal en el flujo del examen;
- código RSS seudónimo obligatorio del tipo RSS 1256;
- idiomas ruso y kazajo;
- importación del banco de preguntas desde XLSX/CSV;
- carga de fuentes normativas DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- generación de borradores de preguntas a partir de sectores de la fuente distribuidos aleatoriamente;
- cada pregunta generada debe ser revisada y aprobada por un especialista antes del examen;
- la pregunta almacena el tema, la formulación, la respuesta de referencia, de 2 a 8 criterios ponderados, la fuente y la referencia al punto;
- para el examen solo se utilizan preguntas aprobadas;
- haz la selección aleatoria de preguntas por programa, mediante un generador criptográfico, y no mediante la «aleatoriedad» del modelo;
- la cantidad de preguntas y la nota de aprobación son configurables;
- respuesta por voz a través del micrófono;
- modo de inicio de la respuesta: manual o automático tras 30/60/120/180 segundos de preparación;
- solicitar el micrófono una sola vez para todo el examen;
- reconocimiento de voz mediante un modelo en la nube;
- evaluación semántica de la respuesta según criterios;
- calcular el porcentaje de forma determinista según los pesos de los criterios;
- ante un error crítico, aplicar un tope configurable a la puntuación;
- locución natural de la pregunta en RU/KZ, con la voz del sistema como reserva;
- acta automática en Word;
- historial local;
- exportación en Excel de todos los exámenes de la fecha seleccionada;
- copia de seguridad de la base local sin la clave API.

SEGURIDAD
Separa con claridad el circuito local y el de nube. Explica qué datos se envían a la nube. No envíes allí el nombre completo ni el número de personal. En la interfaz de voz muestra una advertencia directa de no pronunciar datos personales.

Empieza por la arquitectura y la estructura de archivos. Escribe código solo después de mi confirmación.
Prompt 4. Generación de borradores de preguntas a partir de una fuente normativa para la nueva versión
Relación con el artículo: sección «Cómo se forma ahora el banco de preguntas» — generación de borradores de preguntas a partir de las fuentes normativas cargadas.
Solo generas BORRADORES de preguntas de examen. Ninguna pregunta creada se considera aprobada automáticamente.

Entrada:
- documento normativo;
- idioma RU o KZ;
- cantidad requerida de borradores de preguntas;
- número aleatorio/seed generado por el programa.

Tarea:
1. Usando el seed, selecciona sectores de contenido distribuidos por el documento y, en la medida de lo posible, no consecutivos.
2. Trabaja únicamente con el documento.
3. A partir de cada sector, formula una pregunta de relevancia práctica.
4. No preguntes el número de punto como un fin en sí mismo.
5. Prepara una respuesta de referencia breve.
6. Prepara de 2 a 8 criterios de evaluación. Cada criterio debe comprobar un elemento de sentido independiente.
7. Asigna pesos a los criterios de modo que la suma sea exactamente 100.
8. Indica el tema, la dificultad, la página/artículo/punto u otra referencia a la fuente.
9. No dupliques preguntas de fragmentos contiguos.
10. Si un sector no contiene un requisito suficiente para una pregunta con contenido, omítelo y elige otro.

Devuelve un resultado estructurado:
Tema | Pregunta | Respuesta de referencia | Criterios con pesos | Fuente | Referencia | Dificultad | Idioma

Estado de cada resultado: BORRADOR, REQUIERE REVISIÓN METODOLÓGICA.
Prompt 5. Evaluación semántica de la respuesta oral según criterios
Relación con el artículo: sección «El examen en sí: pregunta por voz, respuesta por voz» — el modelo determina en qué medida se ha cubierto el sentido de cada criterio.
Eres un examinador estricto pero objetivo en materia de seguridad y salud en el trabajo y seguridad industrial.

Evalúa el sentido, no la coincidencia literal.
Acepta sinónimos y formulaciones coloquiales si transmiten de forma inequívoca el requisito normativo.
Trabaja únicamente con la pregunta, la respuesta de referencia, los criterios y el fragmento normativo que se te han proporcionado.
No añadas requisitos de memoria ni de internet.

Para CADA criterio, devuelve exactamente un estado:
- FULL — completamente cubierto;
- PARTIAL — se ha cubierto una parte sustancial, pero hay una laguna;
- MISSING — el elemento está ausente;
- INCORRECT — la respuesta contradice el requisito.

Para cada criterio, indica una breve prueba tomada de la respuesta del trabajador y una explicación.

CRITICAL_ERROR = true solo cuando la respuesta contiene una afirmación o una acción peligrosa que genera un riesgo inaceptable y contradice un requisito normativo.
No uses critical_error simplemente porque la respuesta esté incompleta.

Genera por separado:
- WELL_SAID — qué se ha cubierto bien;
- PARTLY_SAID — qué se ha cubierto parcialmente;
- MISSING — qué no se ha dicho;
- INCORRECT — qué se ha dicho de forma incorrecta;
- SUMMARY — una breve conclusión en el idioma del examen.

No calcules el porcentaje final «a ojo». El porcentaje debe calcularlo un algoritmo del programa según los pesos de los criterios, después de recibir tus estados.
Prompt 6. Lógica programática del cálculo determinista de la puntuación
Relación con el artículo: la misma sección «El examen en sí: pregunta por voz, respuesta por voz» — el porcentaje se calcula por programa y no lo asigna el modelo «a ojo».
Implementa el cálculo de la puntuación NO mediante una evaluación libre del modelo, sino por programa.

Cada criterio tiene un peso weight en porcentaje.
Coeficientes:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = suma(weight × coeficiente) de todos los criterios.
Limita el resultado al rango 0–100 y redondea a 0,1.

Si el evaluador de IA ha devuelto critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP), donde CRITICAL_CAP se define en la configuración (por ejemplo, 40%).

Después de todas las preguntas:
TOTAL_SCORE = media aritmética de las puntuaciones de las preguntas.
PASSED = TOTAL_SCORE >= nota de aprobación establecida.

Importante:
- el modelo determina el estado semántico del criterio;
- el programa calcula el porcentaje;
- el modelo no debe asignar por su cuenta una puntuación final arbitraria.
Prompt 7. Acta en Word y exportación diaria en Excel sin datos personales
Relación con el artículo: sección «El acta y el historial ahora se generan automáticamente» — acta en Word y exportación diaria en Excel.
Mejora el examinador oral.

ACTA EN WORD
Al finalizar el examen, genera automáticamente un .docx.
Incluir en el acta:
- fecha;
- código RSS;
- cargo/profesión;
- departamento;
- idioma;
- nota de aprobación;
- resultado final APROBADO/NO APROBADO;
- cada pregunta;
- transcripción de la respuesta;
- porcentaje obtenido en la pregunta;
- fuente normativa y referencia;
- qué se ha cubierto bien;
- qué no se ha dicho;
- errores.

Dejar vacíos los campos «Nombre completo» y «Materia de la evaluación de conocimientos» para completarlos localmente después de la descarga.
Nombre del archivo: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL POR FECHA
En la sección «Historial», añadir la selección de fecha y el botón «Exportar Excel por fecha».
Columnas:
N.º | Fecha del examen | Hora de inicio | Código RSS | Cargo/profesión | Departamento | Idioma | Cantidad de preguntas | Nota de aprobación % | Puntuación final % | Resultado | Estado | Hora de finalización | Identificador del examen.

No incluir el nombre completo ni el número de personal.
Generar el Excel únicamente a partir del historial local del equipo actual.
La correspondencia RSS <-> nombre completo debe combinarse con los resultados solo sin conexión, dentro del perímetro corporativo.
Prompt 8. Auditoría de datos personales y límites «sin conexión/nube»
Relación con el artículo: secciones «Tercera etapa: examinador portátil en navegador» y «Datos personales: código RSS en lugar del nombre completo».
Realiza una auditoría técnica de la aplicación del examinador oral.
Hay que separar con honestidad las operaciones locales y las operaciones en la nube.

Comprueba y describe:
1. Qué datos se almacenan en IndexedDB/localStorage.
2. Qué datos se envían al modelo en la nube durante la transcripción.
3. Qué datos se envían durante la evaluación semántica.
4. Qué datos se envían durante la generación de borradores de preguntas.
5. Si se transmiten el nombre completo, el número de personal, la lista de trabajadores o la tabla de correspondencia RSS <-> nombre completo.
6. Dónde se almacena la clave API.
7. Si la copia de seguridad contiene la clave API.
8. Qué queda después de cerrar por completo la aplicación.
9. Cómo eliminar el historial local y las fuentes.
10. Qué riesgos persisten durante la explotación en fase piloto.

Requisito para la formulación del resultado:
no califiques la aplicación de «completamente sin conexión» si el reconocimiento de voz, la evaluación, TTS o la generación de preguntas utilizan una API en la nube.
Formulación correcta: «entorno local portátil con base local y un circuito controlado de IA en la nube».
Prompt 9. Incorporación de varias áreas de examen en una sola interfaz
Relación con el artículo: sección «Cómo se forma ahora el banco de preguntas» — varias normas y áreas en un solo examinador, sin tener que alternar entre bots.
Mejora el banco de preguntas y la pantalla de inicio del examen para que ya no sea necesario crear un bot independiente para cada norma.

Cada pregunta ya tiene el campo «Tema/área».
Añade a la pantalla del examen la selección de áreas:
- un bloque temático;
- varios bloques temáticos a la vez;
- modo «Todas las áreas seleccionadas».

Al iniciar el examen:
1. filtra únicamente las preguntas aprobadas;
2. ten en cuenta el idioma seleccionado;
3. ten en cuenta las áreas seleccionadas;
4. selecciona aleatoriamente la cantidad de preguntas establecida mediante el generador criptográfico del programa;
5. en la medida de lo posible, distribuye las preguntas de manera uniforme entre las áreas seleccionadas;
6. no permitas repeticiones;
7. si no hay suficientes preguntas para el conjunto seleccionado, detén el inicio y muestra un mensaje comprensible.

En el acta en Word y en el Excel, guarda además las áreas de examen seleccionadas.
Cómo utilizar el anexo del artículo
La numeración que aparece a continuación está sincronizada con el texto de la publicación. En el artículo, junto a cada etapa correspondiente, hay remisiones directas del tipo «Véase Prompt …», y aquí, debajo de cada prompt, se indica a qué sección del artículo se refiere.
- Prompt 1 — versión histórica: muestra cómo funcionaban el primer examinador y nuestro propio generador de número de pregunta entre 300.
- Prompt 2 — preparación de un banco amplio de preguntas a partir de la normativa.
- Prompt 3 — consulta principal para el lector que quiera reproducir la versión actual en navegador mediante vibe coding.
- Prompt 4 — generación de borradores de preguntas a partir de la fuente cargada.
- Prompt 5–6 — separación entre la evaluación del sentido por la IA y el cálculo programático del porcentaje.
- Prompt 7 — Word y Excel automáticos.
- Prompt 8 — verificación obligatoria de los límites entre el circuito local y el de nube.
- Prompt 9 — integración de varias áreas de examen en una sola interfaz.
Comentarios 2
🤝