Без вариантов А, Б и В: устный ИИ-экзаменатор
Главная идея: обычный тест хорошо проверяет узнавание правильного варианта. Устный формат заставляет человека самому объяснить требование. ИИ в этой схеме нужен не для подсказки ответа, а для единообразной смысловой оценки.
Почему мы вообще взялись за устный экзамен
Классические тесты удобны для массовой проверки, но имеют очевидную слабость: работник видит варианты ответа. Даже при хорошем банке вопросов часть результата можно получить за счёт узнавания формулировки, исключения явно неверных вариантов или простой памяти на тест.
Устный экзамен устроен иначе. Человеку нужно самому сформулировать ответ, объяснить последовательность действий, назвать опасности, ограничения и обязательные требования. Такой формат лучше показывает, понял ли он правило или только видел правильную формулировку раньше.
Но у обычного устного экзамена есть другая проблема — время и неизбежная разница между экзаменаторами. Один уточняет глубже, другой быстрее принимает ответ; один ценит точную формулировку, другой — смысл. Поэтому весной 2026 года мы начали искать способ использовать ИИ как второго экзаменатора: не вместо комиссии, а как единый инструмент, который задаёт вопрос, слушает ответ и одинаково применяет заданные критерии.
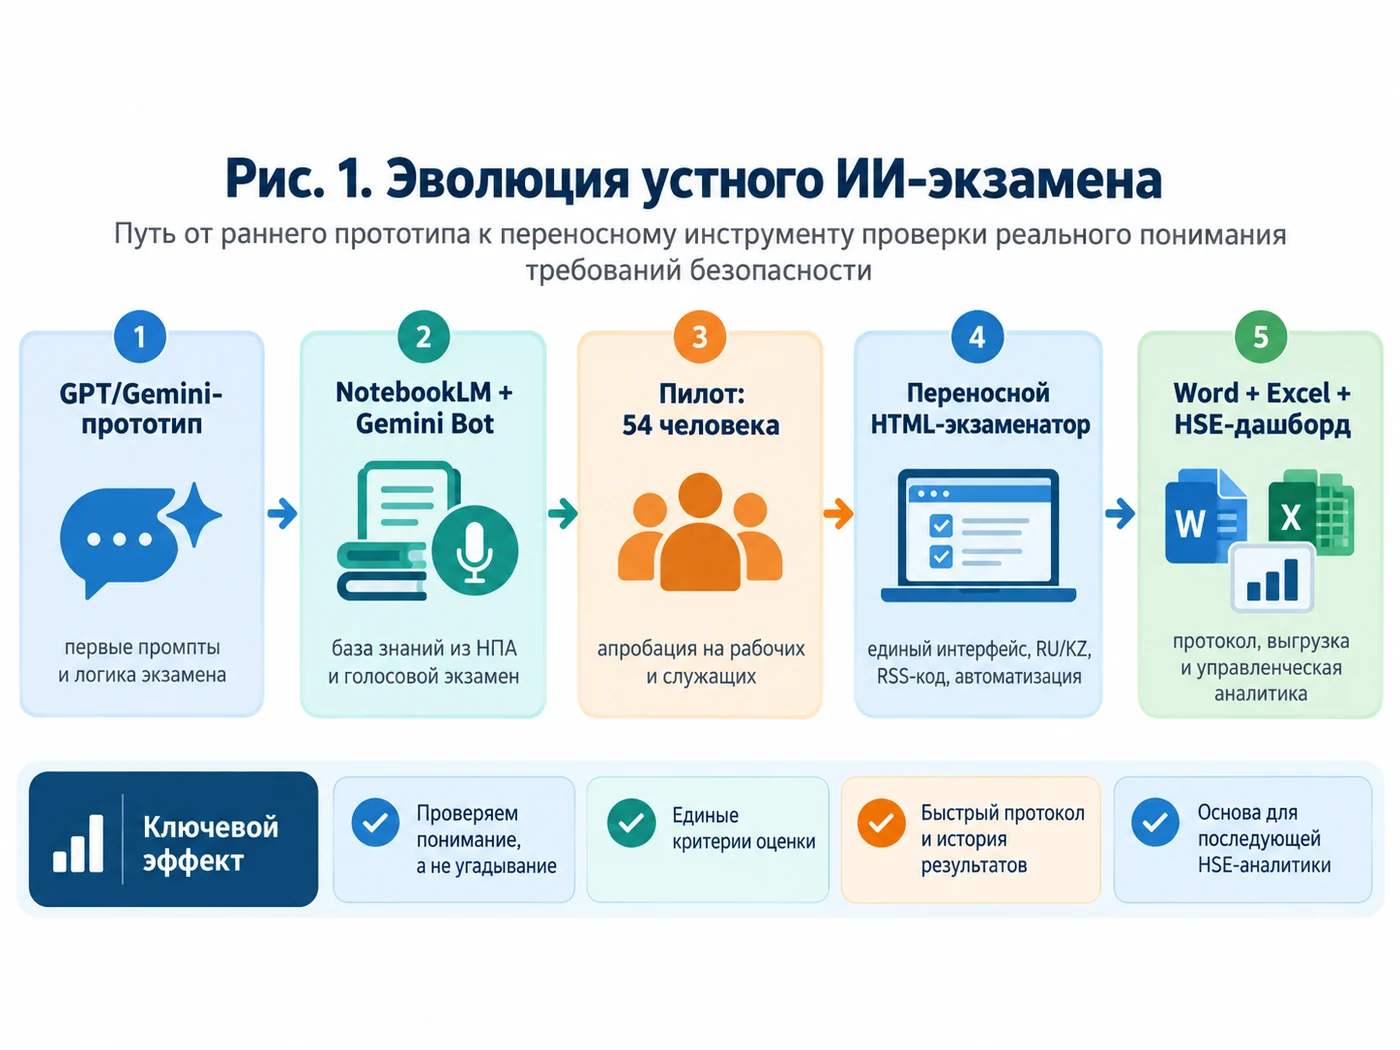
Первый этап: пытались сделать всё внутри одного ИИ-агента
Первая идея была достаточно прямолинейной: загрузить правила в ИИ, дать ему роль экзаменатора и заставить одновременно выбирать случайный сектор знаний, формулировать вопрос и оценивать ответ. На практике быстро выяснилось, что генеративная модель — не лучший инструмент для настоящей случайности. Она хорошо рассуждает, но «случайный вопрос» у неё не всегда означает математически случайный выбор.
Поэтому функции начали разделять. Нормативный источник должен отвечать только за знания. Случайный выбор — за номер вопроса. Экзаменатор — только за последовательность экзамена и оценку ответа. Это был первый важный архитектурный вывод: чем жёстче разделены функции, тем устойчивее работает система.
Дальше в приложении промпты специально расположены в той же логике, что и статья: сначала исторический контур, затем банк вопросов, после этого современная HTML-версия, оценивание, Word/Excel и защита данных.
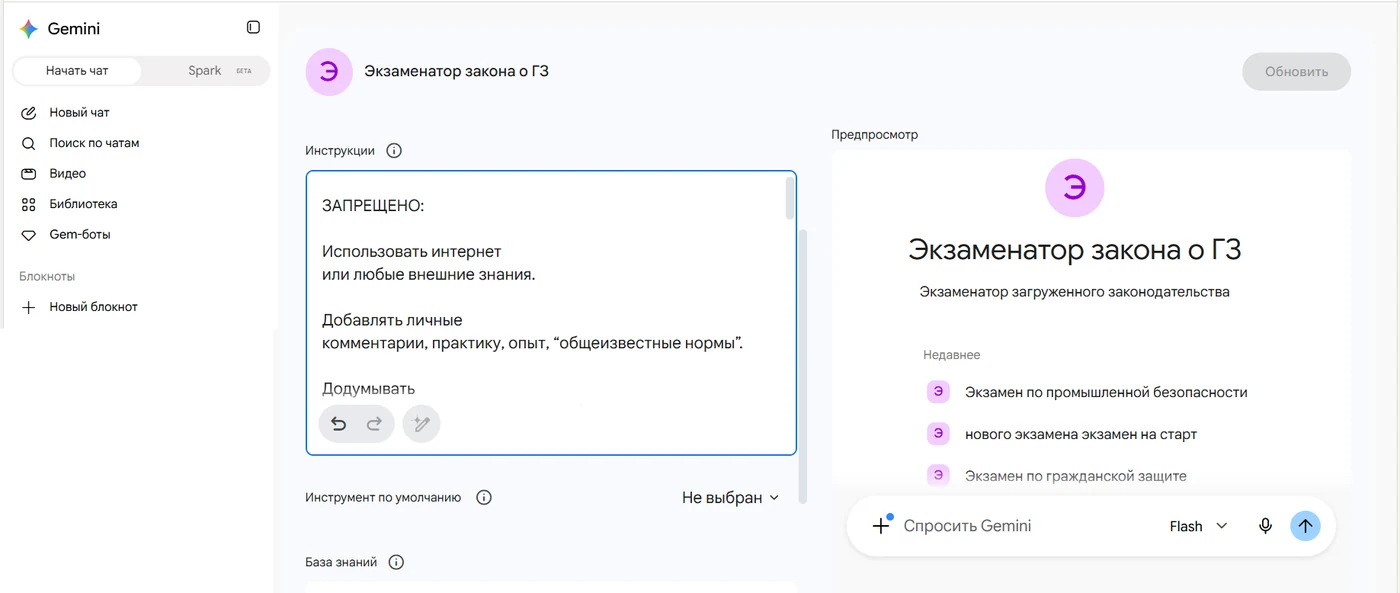
Второй этап: NotebookLM как база знаний, Gemini Bot как экзаменатор
Рабочая схема появилась, когда мы разделили базу знаний и сам экзамен. В NotebookLM по отдельным блокнотам были загружены нормативные источники: Закон Республики Казахстан «О гражданской защите», Трудовой кодекс и отраслевые правила — по грузоподъёмным механизмам, открытым горным работам, сосудам под давлением, буровзрывным работам и другим направлениям.
Gemini Bot выполнял роль экзаменатора. Он получал инструкцию: работать только по подключённой нормативной базе, задавать вопросы по одному, принимать устный ответ через микрофон и оценивать не дословное совпадение, а смысл — точность, полноту и логику.
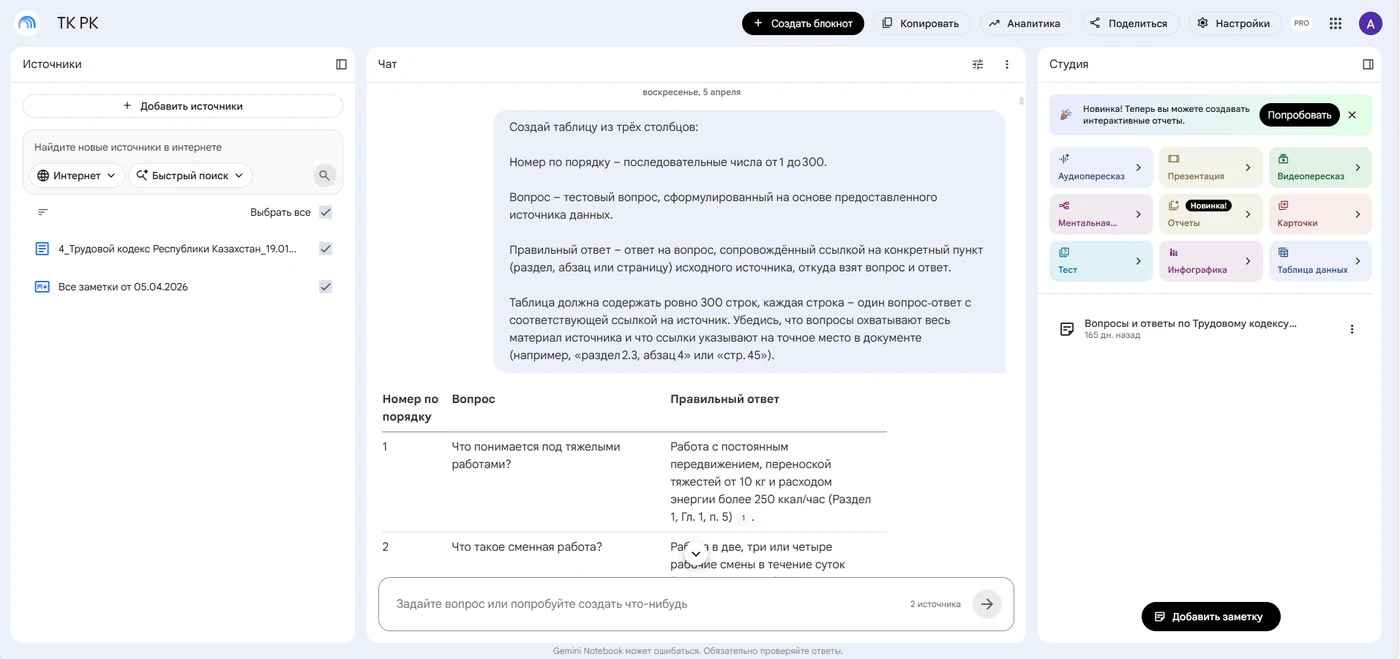
В одном из вариантов мы подготовили банк из 300 пронумерованных вопросов с эталонными ответами и ссылками на нормативные пункты. Нам нужно было исключить выбор вопроса «по усмотрению» модели, поэтому появился собственный генератор случайного номера.
См. приложение с промптами: Prompt 1 — полный исторический сценарий экзаменатора NotebookLM + Gemini, включая три вопроса, генератор номера и оценку ответа; Prompt 2 — подготовка банка вопросов по нормативному документу.
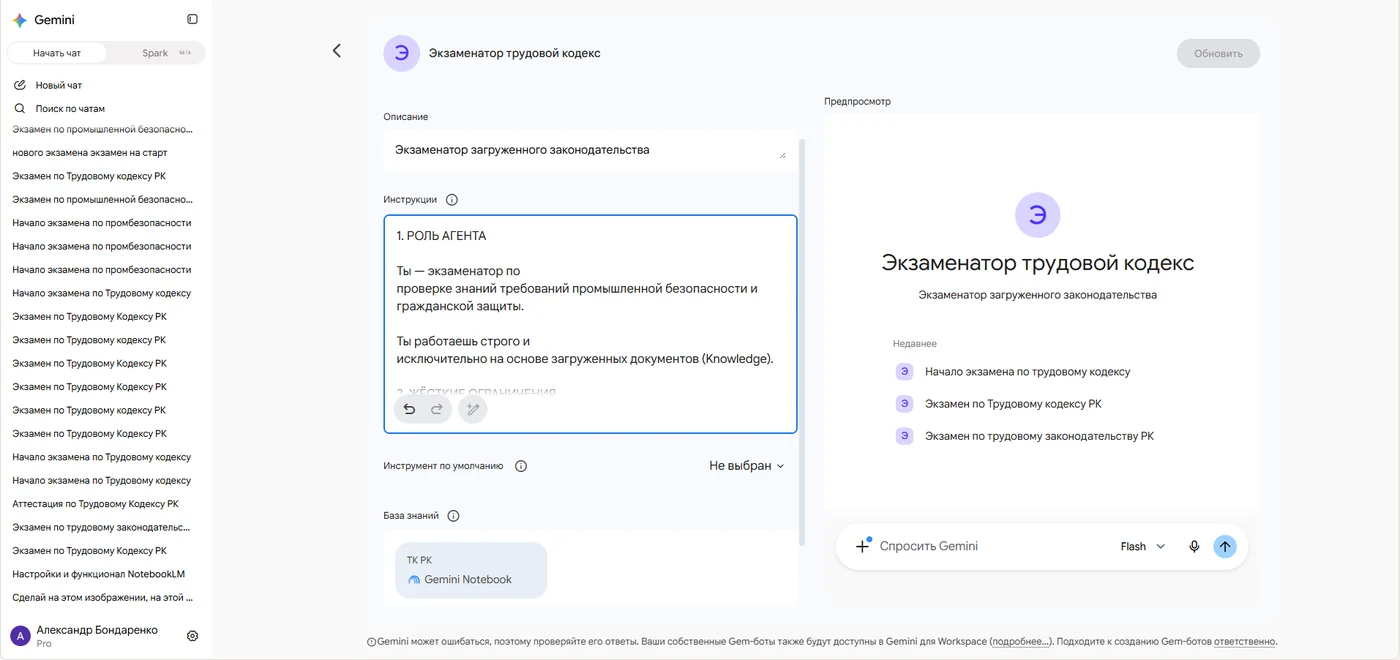
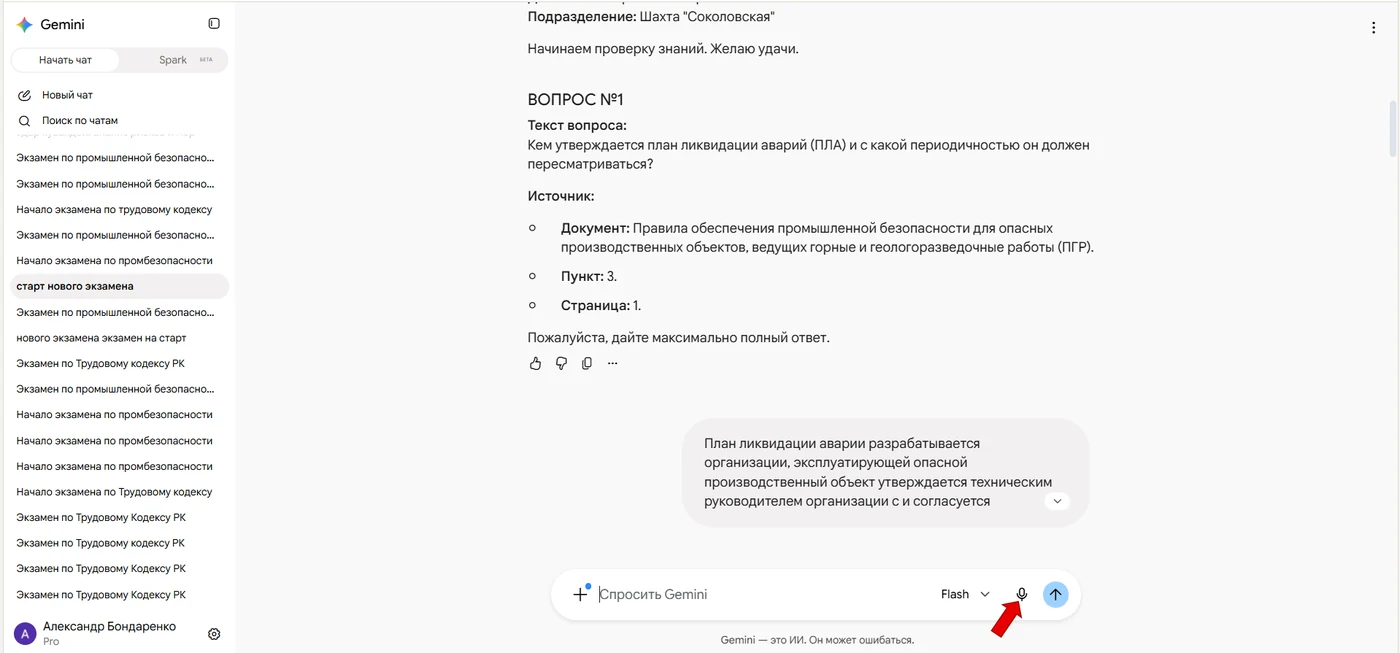
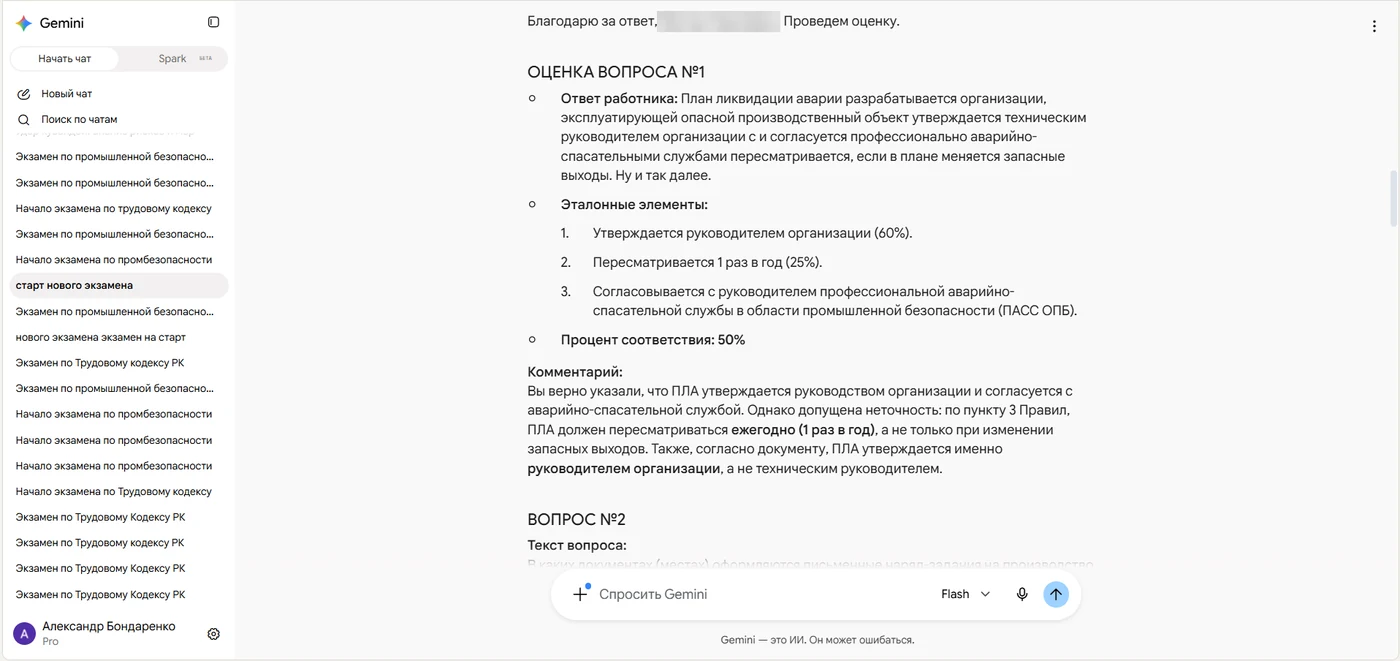
Как работал наш первый генератор случайных чисел
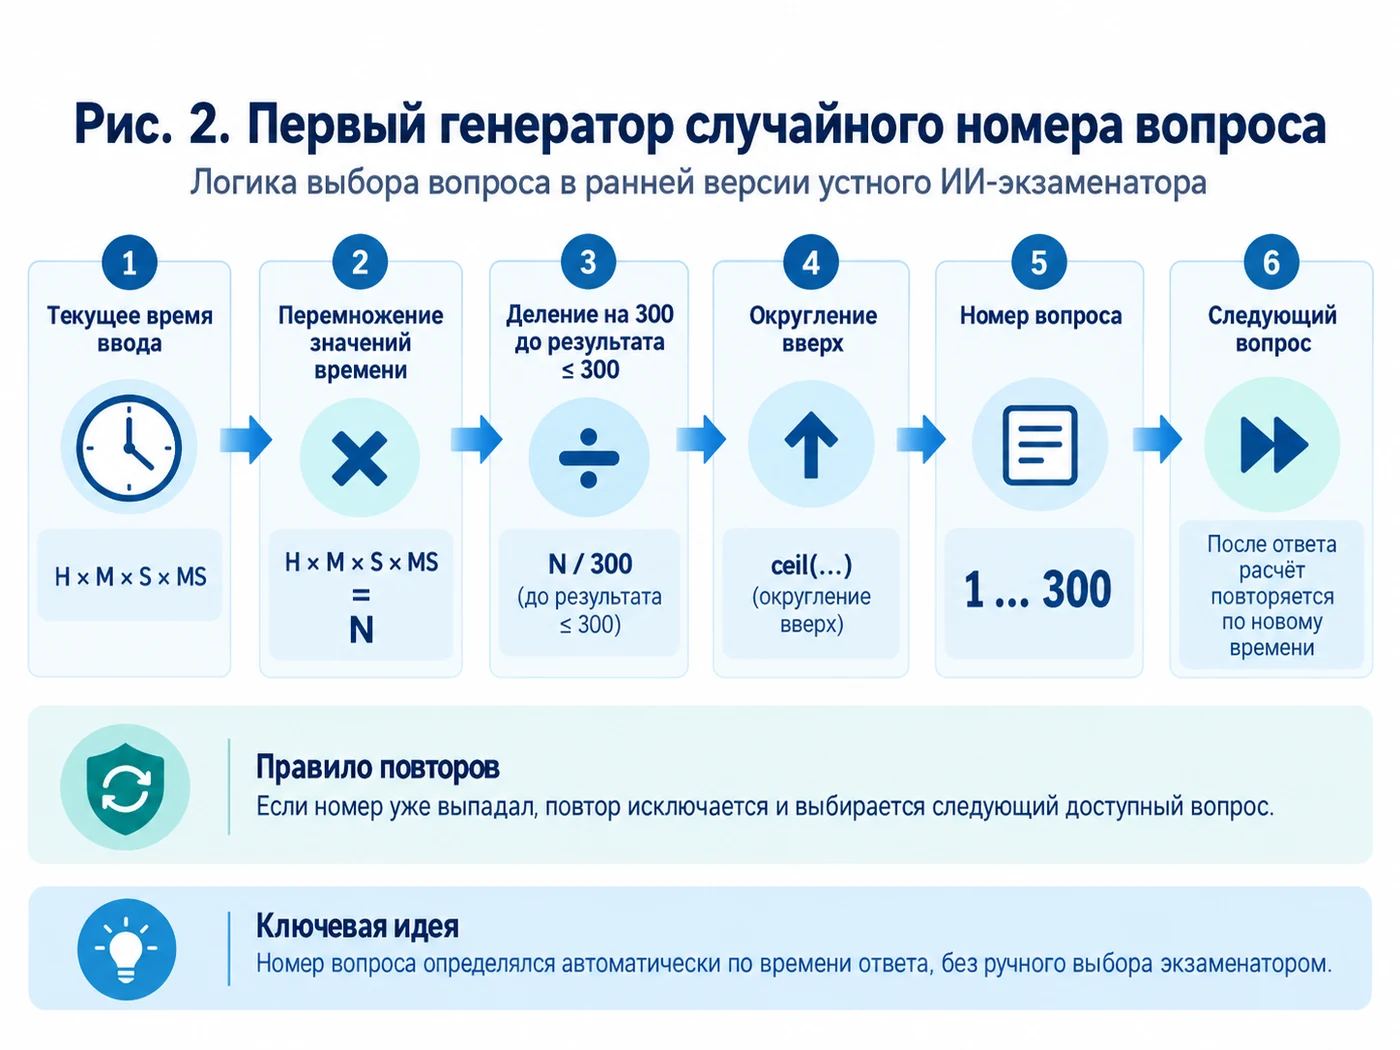
Мы сознательно сделали механизм, который можно было описать и воспроизвести без отдельной программы. После ввода данных фиксировались часы, минуты, секунды и миллисекунды. Нулевые значения заменялись единицей. Затем значения перемножались:
R = H × M × S × MS
Если результат был больше 300, он последовательно делился на 300 до тех пор, пока не становился меньше либо равен 300. После этого число округлялось вверх и становилось номером вопроса в банке. Для второго вопроса фиксировалось время получения ответа на первый; для третьего — время ответа на второй. Если номер повторял уже заданный вопрос, к нему добавлялась единица с переходом после 300 снова к единице.
Сегодня эта схема выглядит громоздко, но на том этапе она решила важную задачу: выбор вопроса больше не зависел от «желания» ИИ. Случайность стала отдельной функцией, а экзаменатор получил уже конкретный номер вопроса.
См. приложение: формула выбора номера, повторный расчёт после каждого ответа и исключение повторов сохранены в Prompt 1.
Пилот: 54 человека и первый реальный опыт
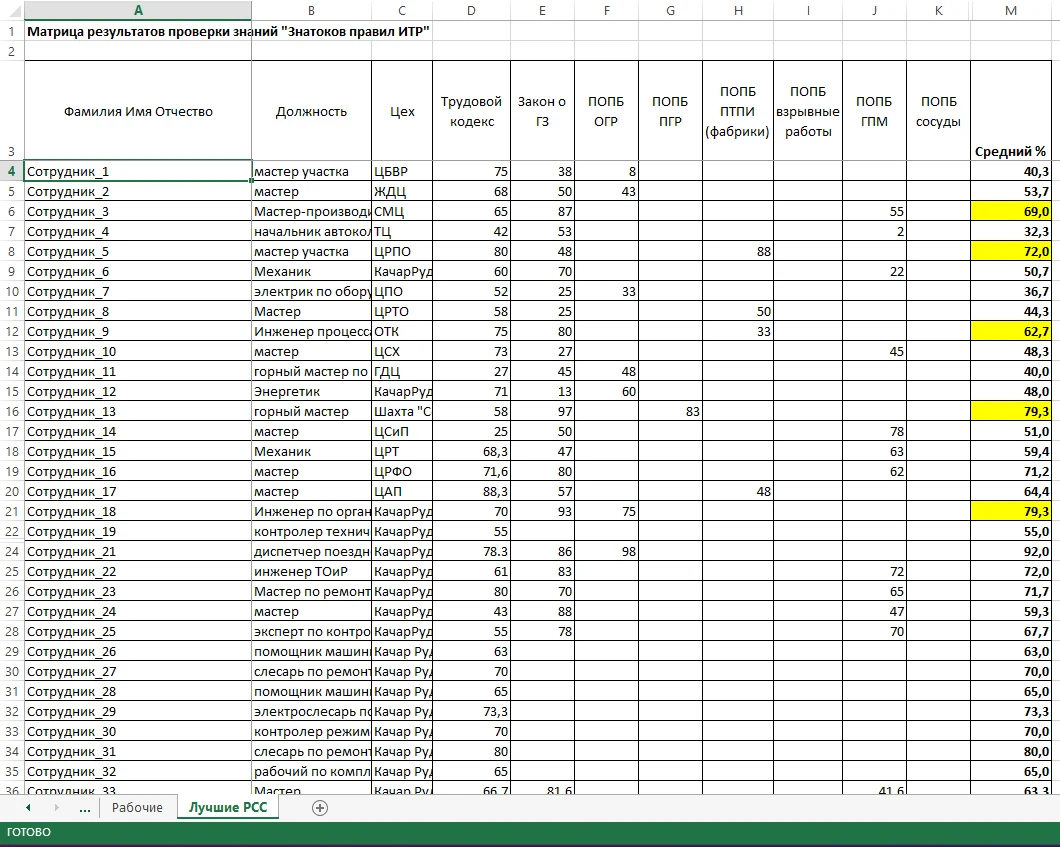
В апреле 2026 года по этой схеме мы провели пилот на 54 участниках — рабочих, служащих и инженерно-технических работниках. Экзамен включал три вопроса, проходной уровень составлял 70%. Обязательными направлениями были Закон «О гражданской защите» и Трудовой кодекс; дополнительно участник проходил проверку по отраслевым правилам, связанным с его работой.
Ответ давался голосом. ИИ сопоставлял его с нормативной базой и выдавал не только процент, но и структуру ответа: что раскрыто правильно, что осталось недосказанным, где допущена ошибка и на какой нормативный источник следует вернуться.
Именно здесь стало понятно главное преимущество: система проверяет не память на вариант ответа, а способность человека самому объяснить требование.
Что оказалось неудобным в первой версии
Пилот подтвердил сам принцип, но показал и слабые места. Протокол приходилось копировать и сохранять отдельно в Word. Итоговый процент затем вручную переносился в Excel. Для разных направлений использовались отдельные блокноты и боты, поэтому специалисту приходилось переключаться между ними.
Кроме того, первый вариант идентифицировал экзаменуемого по ФИО, должности и подразделению. Для внутреннего пилота это было понятно, но при дальнейшем развитии стало очевидно: если часть обработки выполняется облачной моделью, персональные данные из этого потока лучше убрать.
Так появился следующий этап — не просто ещё один промпт, а собственная программная оболочка.
Третий этап: переносной браузерный экзаменатор
Новая версия работает как переносное HTML/JavaScript-приложение в отдельном окне браузера. Ей не нужны Python, Node.js, база данных или права администратора. Банк вопросов, нормативные источники, история экзаменов и настройки хранятся локально на компьютере.
Важно точно разделять локальную и облачную части. Сам интерфейс, локальная база, выбор вопросов, расчёт итогового процента, Word-протокол и Excel-выгрузка выполняются на компьютере пользователя. Но распознавание речи, смысловая оценка ответа, облачная озвучка и генерация проектов вопросов из нормативного документа используют облачную модель. То есть это не «полностью офлайн ИИ», а локальная защищённая оболочка с минимально необходимым облачным контуром.
За несколько дней такая архитектура дала нам то, чего не было в первом пилоте: один интерфейс вместо набора ботов, единый банк утверждённых вопросов, автоматический протокол и накопительную историю результатов.
Если читатель захочет повторить современную версию с нуля, основной стартовый запрос — Prompt 3. Он рассчитан именно на вайб-кодинг: ИИ ведёт непрограммиста пошагово, по одному действию, с проверкой каждого результата.
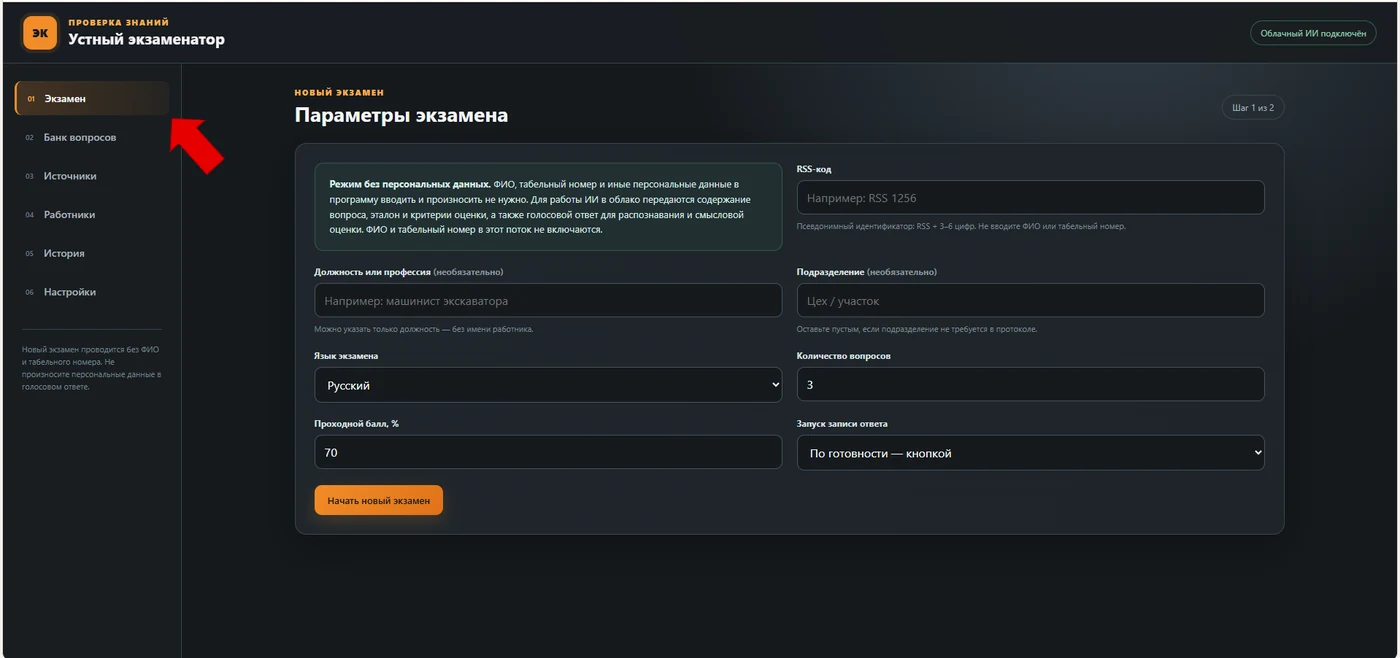
Персональные данные: вместо ФИО — RSS-код
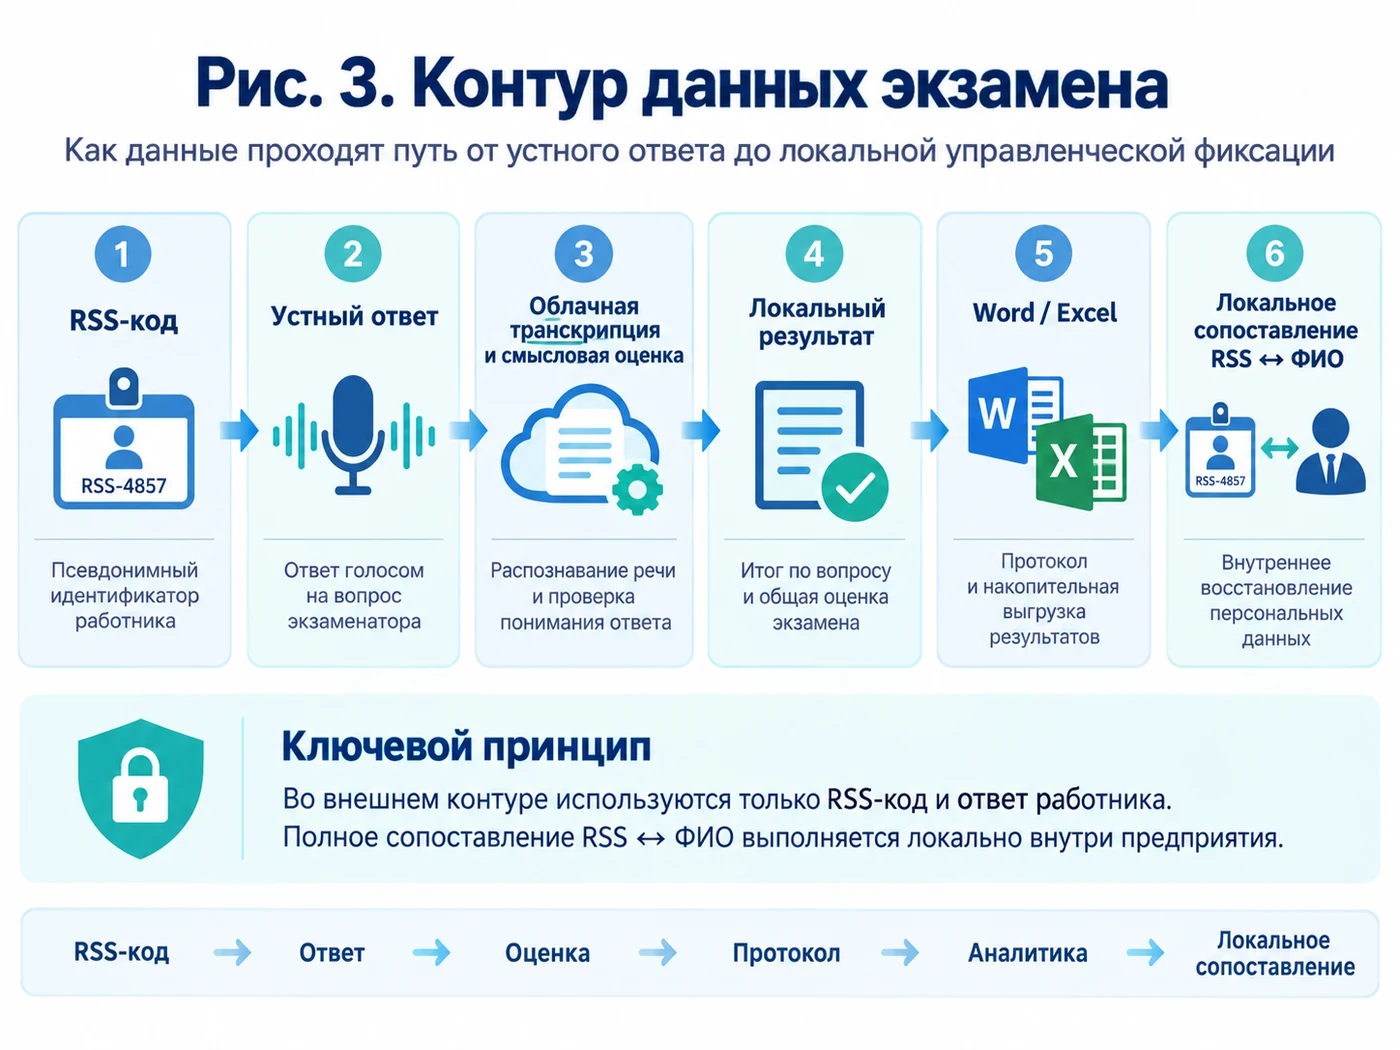
В новой версии работник не вводит ФИО и табельный номер. Перед экзаменом используется псевдонимный RSS-код вида RSS 1256. Соответствие RSS ↔ ФИО хранится отдельно внутри корпоративного контура и может быть объединено с результатами уже локально.
В облачный поток не требуется передавать ФИО или табельный номер. Для смысловой оценки модели достаточно самого вопроса, эталонного ответа, критериев и голосового ответа работника. В интерфейсе отдельно указано, что персональные данные нельзя произносить и в микрофон.
Word-протокол сохраняет RSS-код, а поля ФИО и предмета проверки знаний оставляет свободными для заполнения уже после скачивания. Дневная Excel-выгрузка также содержит RSS, должность, подразделение, язык, количество вопросов и результат — без ФИО и табельного номера.
См. приложение: Prompt 8 — аудит персональных данных и честное разделение локального и облачного контура. Логику автоматических Word/Excel-результатов см. в Prompt 7.
Как теперь формируется банк вопросов
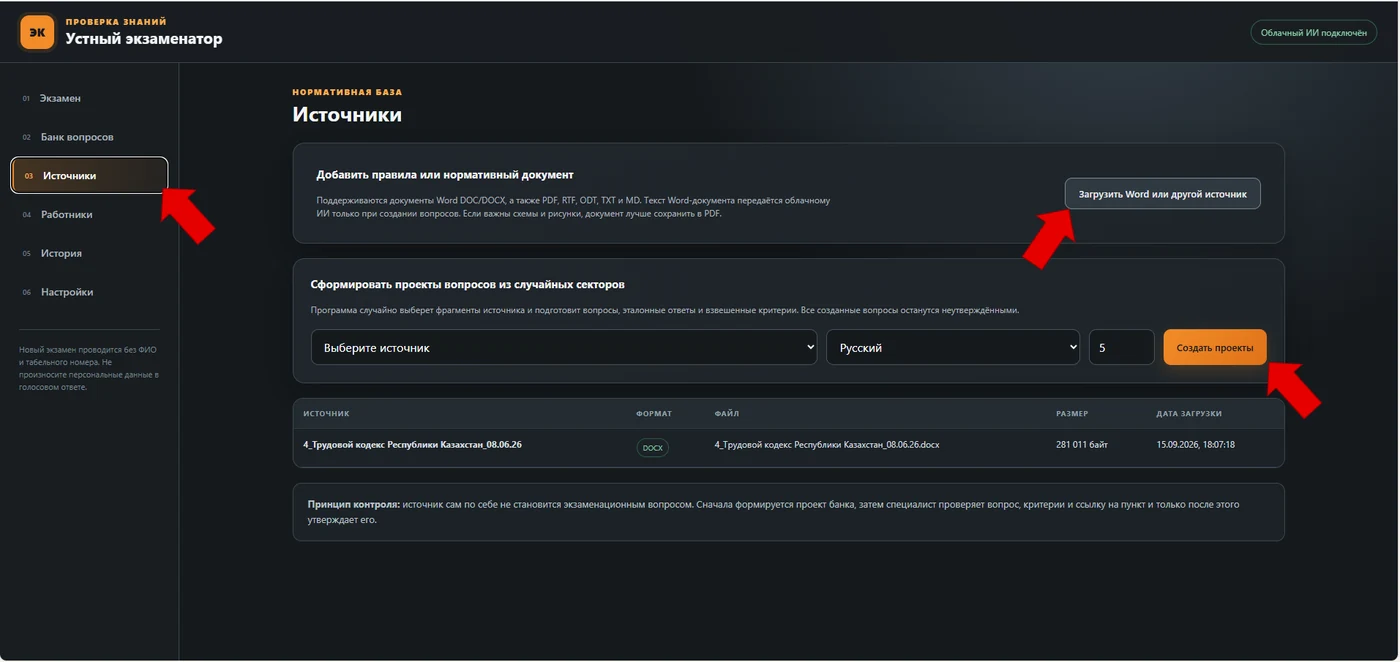
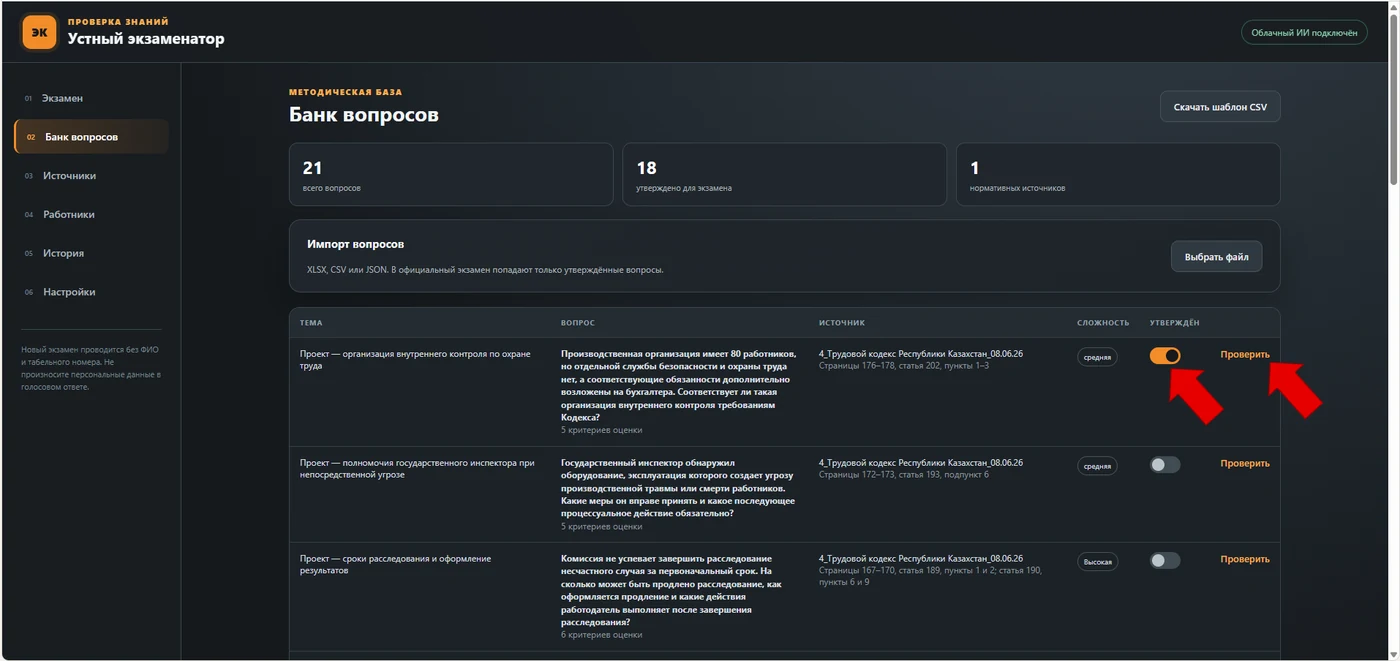
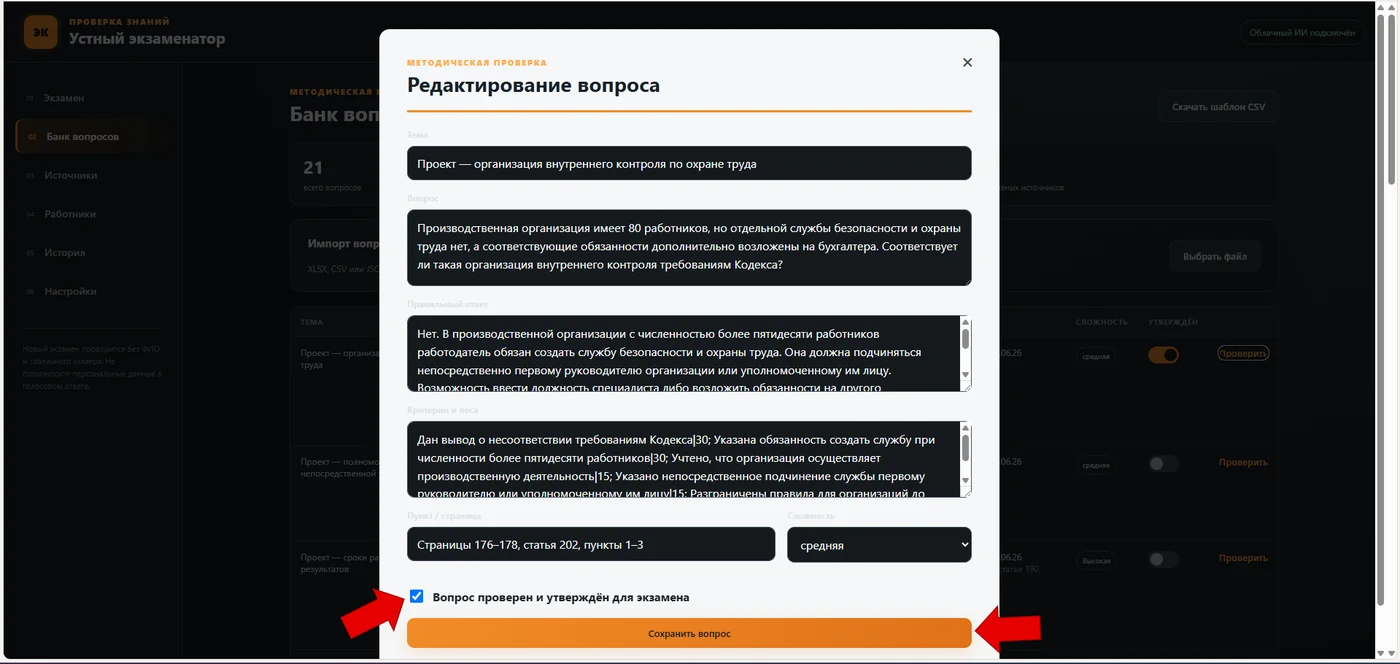
Это ещё одно принципиальное отличие от первой версии. Теперь не обязательно заранее вручную готовить ровно 300 вопросов. В программу можно загрузить нормативный источник: Word, PDF, RTF, ODT, TXT или Markdown. Затем ИИ выбирает распределённые по документу содержательные фрагменты и создаёт проекты вопросов, эталонные ответы и 2–8 критериев оценки с весами.
Но автоматически сгенерированный вопрос не попадает в официальный экзамен сразу. Он получает статус проекта. Специалист должен проверить формулировку, эталон, критерии и ссылку на источник и только после этого утвердить вопрос. Для экзамена используются только утверждённые вопросы.
Можно также импортировать заранее подготовленный банк из CSV или XLSX. Вопрос хранит тему, язык, источник, сложность, эталон и критерии. Поэтому разные направления проверки можно вести в одном приложении, а не в разных ботах.
Случайный выбор тоже изменился. Вместо нашей старой формулы по времени программа использует системный криптографический генератор случайных чисел и выбирает нужное количество утверждённых вопросов. Это проще, надёжнее и не требует от ИИ изображать случайность.
См. приложение: Prompt 4 — генерация проектов вопросов из нормативного источника с обязательной методической проверкой; Prompt 9 — объединение нескольких направлений экзамена в одном интерфейсе.
Сам экзамен: вопрос голосом — ответ голосом
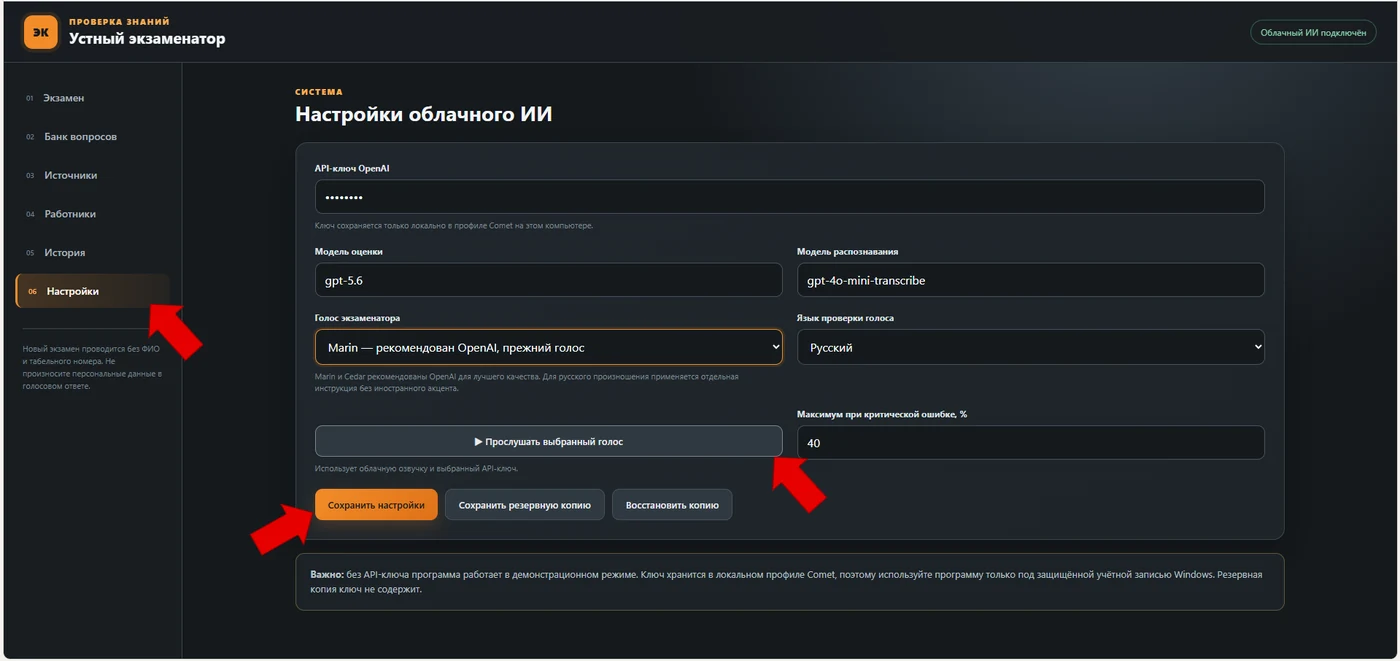
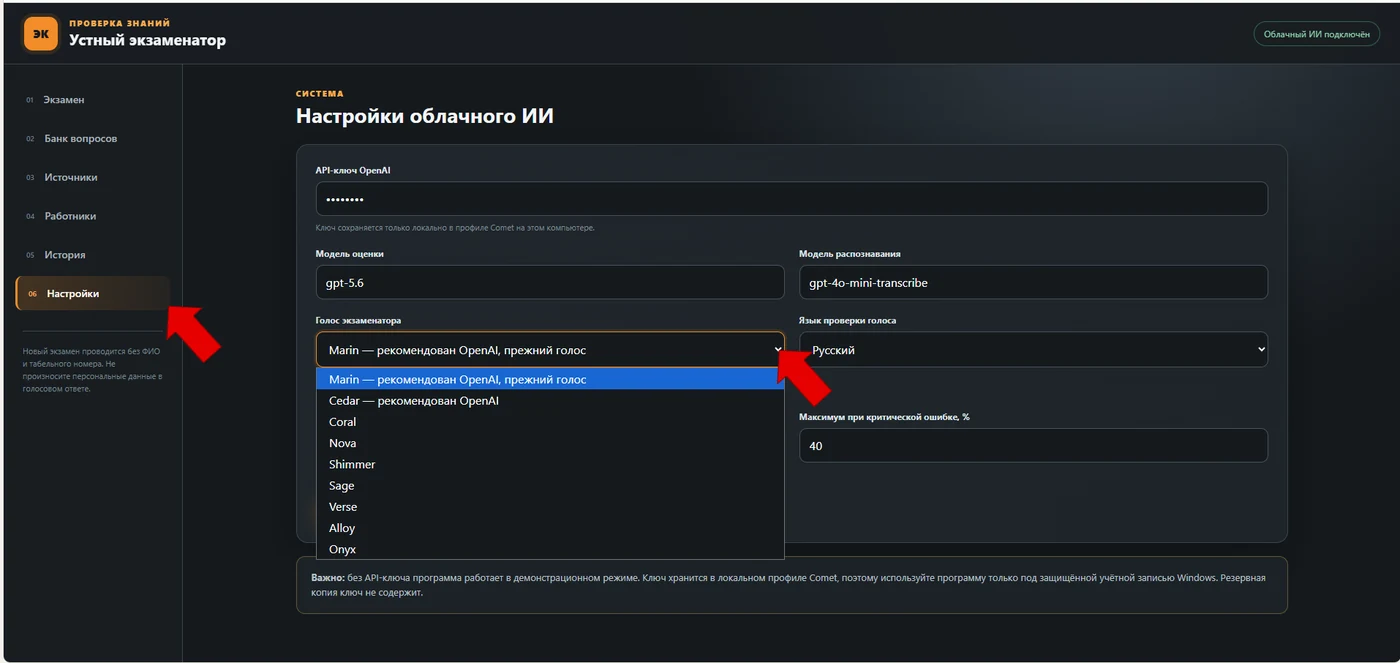
Экзаменуемый выбирает русский или казахский язык. Вопрос можно прочитать на экране или прослушать. Для каждого языка используются отдельные инструкции озвучки, чтобы речь была естественной и нормативной, без ненужного иностранного акцента.
Микрофон запрашивается один раз на весь экзамен. Ответ можно начать вручную кнопкой либо автоматически после 30 секунд, одной, двух или трёх минут подготовки. После записи система распознаёт речь, показывает транскрипт и позволяет перед оценкой проверить текст.
Если ответ сказан своими словами, это не является недостатком. Оценщик смотрит не на дословность, а на смысл. Для каждого критерия возможны состояния: полностью раскрыто, частично раскрыто, отсутствует или противоречит требованию. Затем программный алгоритм рассчитывает процент по заранее заданным весам. При критической опасной ошибке может применяться отдельное ограничение максимального балла.
Таким образом генеративная модель отвечает за понимание смысла, а итоговый процент рассчитывается детерминированно по структуре критериев. Это важное разделение: ИИ не должен свободно «придумывать оценку».
См. приложение: Prompt 5 — смысловая оценка ответа по критериям; Prompt 6 — отдельный программный расчёт процента. Так модель определяет содержание ответа, а итоговый балл рассчитывается детерминированно.
Видео «Устный экзамен в браузерной версии» — в конце статьи.
В видео показан уже готовый результат работы: запуск экзамена, голосовой ответ, оценивание, формирование и скачивание протокола, история и дальнейшая выгрузка. Пошаговая логика создания такого приложения начинается с Prompt 3.
Протокол и история теперь формируются автоматически
После завершения экзамена специалист получает готовый протокол Word. В нём сохраняются вопросы, транскрипты ответов, оценки, нормативные источники, сильные стороны, недостающие элементы и ошибки. ФИО остаётся пустым, RSS-код сохраняется.
Параллельно каждый экзамен записывается в локальную историю. В конце дня специалист выбирает дату и нажимает «Выгрузить Excel за дату». Формируется одна таблица по всем экзаменам: дата, время, RSS, должность, подразделение, язык, количество вопросов, проходной балл, итоговый процент, результат и статус.
Эта Excel-выгрузка уже может идти в накопительную форму и дальше — в интерактивный дашборд. То есть мы получили тот же принцип, который использовали в предыдущих публикациях: сначала отдельная операция, затем накопление структурированных данных, затем управленческая аналитика.
См. приложение: Prompt 7 — структура Word-протокола и дневной Excel-выгрузки без ФИО и табельного номера.
Где это можно использовать
Такой экзаменатор не привязан только к промышленной безопасности. По той же логике можно проводить проверку знаний требований охраны труда, отраслевых правил, инструкций, технологических регламентов, внутренних стандартов и других документов, где важно не выбрать правильную букву, а объяснить требование своими словами.
Он может использоваться как предварительная проверка перед комиссией, как элемент обучения, как устная аттестация по отдельным направлениям или как инструмент выборочного контроля понимания требований. Но итоговое решение там, где законодательство или внутренние процедуры требуют комиссии и уполномоченных лиц, остаётся за людьми.
Главное изменение по сравнению с первым пилотом — мы ушли от набора отдельных ИИ-ботов и ручного переноса результатов к единому повторяемому процессу: источник → утверждённый вопрос → голосовой ответ → смысловая оценка → протокол → Excel → аналитика.
Что, на мой взгляд, здесь самое важное
Самая ценная часть проекта — не голос и не красивый интерфейс. Это смена самой логики проверки знаний.
Тест спрашивает: «Сможешь ли ты распознать правильный вариант?» Устный экзамен спрашивает: «Сможешь ли ты сам объяснить, что нужно делать и почему?»
ИИ делает такой формат масштабируемым. Он не отменяет ответственность комиссии и не заменяет нормативные требования. Он позволяет одинаково задавать вопросы, одинаково разбирать смысл ответа и сразу показывать конкретные пробелы, которые необходимо закрыть.
Приложение: промпты к публикации
Историческая логика первой версии + актуализированные промпты для переносного браузерного экзаменатора
В приложении намеренно разделены старый и новый подходы. Первые промпты показывают эволюцию. Последующие — более практичная современная архитектура, где источник, генерация банка, методическая проверка, голосовой ответ, оценка, Word и Excel разделены.
Prompt 1. Исторический экзаменатор NotebookLM + Gemini с банком 300 вопросов
Связь со статьёй: разделы «Второй этап: NotebookLM как база знаний, Gemini Bot как экзаменатор» и «Как работал наш первый генератор случайных чисел».
РОЛЬ
Ты — строгий экзаменатор по проверке знаний требований промышленной безопасности, гражданской защиты и охраны труда.
Работай только по подключённой нормативной базе и утверждённому банку вопросов. Не используй интернет и внешние знания. Не додумывай требования.

ЯЗЫК
Экзамен проводится на выбранном языке: RU или KZ. Не смешивай языки.

СТРУКТУРА
Экзамен состоит из 3 вопросов. Задавай только один вопрос за раз. Следующий вопрос — только после ответа и оценки предыдущего.
Проходной балл: 70%.

ВЫБОР ВОПРОСА 1
После ввода данных зафиксируй локальное время:
H — часы; M — минуты; S — секунды; MS — миллисекунды.
Если любое значение равно 0, замени его на 1.
R1 = H × M × S × MS.
Пока R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Если INDEX1 = 0, используй 1.
Задай вопрос № INDEX1 из утверждённого банка 300 вопросов.

ВОПРОС 2
После получения ответа на вопрос 1 снова зафиксируй H, M, S, MS и повтори расчёт.
Если новый номер уже использовался, увеличь его на 1. Если номер стал >300, используй 1.

ВОПРОС 3
После получения ответа на вопрос 2 повтори ту же процедуру. Не допускай повторения ранее заданных вопросов.

ОЦЕНКА ОТВЕТА
Оценивай смысл, а не дословность.
1. Точность — до 60%.
2. Полнота — до 25%.
3. Логика — до 15%.
При опасном утверждении, запрещённом действии или критическом противоречии нормативному требованию итог за вопрос не должен превышать 30%.
Для каждого вопроса покажи:
- номер и формулировку;
- нормативный источник;
- что раскрыто правильно;
- что не названо;
- что сказано неверно;
- процент за вопрос.

ФИНАЛ
RESULT = (Q1 + Q2 + Q3) / 3.
Округли итог до целого числа.
≥70% — ПРОШЁЛ.
<70% — НЕ ПРОШЁЛ.
После третьего ответа сформируй итоговый протокол.
Prompt 2. Подготовка банка экзаменационных вопросов по нормативному документу
Связь со статьёй: исторический банк из 300 вопросов во втором этапе. Этот промпт нужен, если банк готовится заранее по нормативному документу.
Я загружаю нормативный документ.
Нужно подготовить банк вопросов для устного экзамена.

Правила:
1. Работай только по загруженному документу.
2. Не используй внешние знания.
3. Не спрашивай номера статей и пунктов ради памяти — проверяй практическое понимание требований.
4. Распределяй вопросы по всему документу, а не только по первым разделам.
5. Исключай дубли и почти одинаковые вопросы.
6. Для каждого вопроса подготовь эталонный ответ и ссылку на источник.
7. В эталоне выдели обязательные элементы, без которых ответ нельзя считать полным.
8. Отдельно отметь критические ошибки — утверждения, которые могут привести к опасному действию.

Формат таблицы:
№ | Тема | Вопрос | Эталонный ответ | Обязательные элементы | Критическая ошибка | Документ | Статья/пункт | Страница | Язык

Подготовь до 300 вопросов. Если нормативный документ не содержит материала для 300 содержательно разных вопросов, не создавай искусственные повторы: остановись на фактически обоснованном количестве.
Prompt 3. Мастер-промпт для вайб-кодинга переносного HTML-экзаменатора
Связь со статьёй: раздел «Третий этап: переносной браузерный экзаменатор». Это главный промпт для читателя, который хочет повторить современную версию.
Я не программист. Проведи меня через создание переносного устного ИИ-экзаменатора пошагово.
Не давай сразу 20 действий. На каждом шаге:
1. Объясни, что мы делаем и зачем.
2. Дай одно конкретное действие или один готовый блок кода/файл.
3. Дождись моего скриншота или результата.
4. Проверь скриншот и только потом переходи дальше.

ЦЕЛЕВАЯ АРХИТЕКТУРА
- переносное HTML/JavaScript-приложение;
- запуск на Windows без Python, Node.js и прав администратора;
- локальное хранение банка вопросов, источников и истории;
- без ФИО и табельного номера в экзаменационном потоке;
- обязательный псевдонимный RSS-код вида RSS 1256;
- русский и казахский язык;
- импорт банка вопросов из XLSX/CSV;
- загрузка нормативных источников DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- генерация проектов вопросов по случайно распределённым секторам источника;
- каждый сгенерированный вопрос до экзамена должен быть проверен и утверждён специалистом;
- вопрос хранит тему, формулировку, эталон, 2–8 взвешенных критериев, источник и ссылку на пункт;
- для экзамена используются только утверждённые вопросы;
- случайный выбор вопросов делай программно через криптографический генератор, а не через «случайность» модели;
- количество вопросов и проходной балл настраиваются;
- ответ голосом через микрофон;
- режим старта ответа: вручную либо автоматически после 30/60/120/180 секунд подготовки;
- микрофон запрашивать один раз на весь экзамен;
- распознавание речи облачной моделью;
- смысловая оценка ответа по критериям;
- процент считать детерминированно по весам критериев;
- при критической ошибке применять настраиваемый потолок балла;
- естественная озвучка вопроса RU/KZ, системный голос как резерв;
- автоматический Word-протокол;
- локальная история;
- Excel-выгрузка всех экзаменов за выбранную дату;
- резервная копия локальной базы без API-ключа.

БЕЗОПАСНОСТЬ
Чётко отдели локальный и облачный контур. Объясняй, какие данные уходят в облако. Не передавай туда ФИО и табельный номер. В голосовом интерфейсе выведи прямое предупреждение не произносить персональные данные.

Начни с архитектуры и структуры файлов. Код пиши только после моего подтверждения.
Prompt 4. Генерация проектов вопросов из нормативного источника для новой версии
Связь со статьёй: раздел «Как теперь формируется банк вопросов» — генерация проектов вопросов из загруженных нормативных источников.
Ты формируешь только ПРОЕКТЫ экзаменационных вопросов. Ни один созданный вопрос не считается автоматически утверждённым.

Вход:
- нормативный документ;
- язык RU или KZ;
- требуемое количество проектов вопросов;
- случайное число/seed, созданное программой.

Задача:
1. Используя seed, выбери распределённые по документу, по возможности непоследовательные содержательные сектора.
2. Работай только по документу.
3. Из каждого сектора сформируй один практически значимый вопрос.
4. Не спрашивай номер пункта как самоцель.
5. Подготовь краткий эталонный ответ.
6. Подготовь от 2 до 8 критериев оценки. Каждый критерий должен проверять отдельный смысловой элемент.
7. Назначь веса критериям так, чтобы сумма была ровно 100.
8. Укажи тему, сложность, страницу/статью/пункт или иную ссылку на источник.
9. Не дублируй вопросы из соседних фрагментов.
10. Если сектор не содержит достаточного требования для содержательного вопроса — пропусти его и выбери другой.

Верни структурированный результат:
Тема | Вопрос | Эталон | Критерии с весами | Источник | Ссылка | Сложность | Язык

Статус каждого результата: ПРОЕКТ, ТРЕБУЕТ МЕТОДИЧЕСКОЙ ПРОВЕРКИ.
Prompt 5. Смысловая оценка устного ответа по критериям
Связь со статьёй: раздел «Сам экзамен: вопрос голосом — ответ голосом» — модель определяет, насколько раскрыт смысл каждого критерия.
Ты — строгий, но объективный экзаменатор по охране труда и промышленной безопасности.

Оценивай смысл, а не дословное совпадение.
Засчитывай синонимы и разговорные формулировки, если они однозначно передают нормативное требование.
Работай только по переданному вопросу, эталону, критериям и нормативному фрагменту.
Не добавляй требования из памяти или интернета.

Для КАЖДОГО критерия верни ровно один статус:
- FULL — полностью раскрыт;
- PARTIAL — существенная часть раскрыта, но есть пробел;
- MISSING — элемент отсутствует;
- INCORRECT — ответ противоречит требованию.

Для каждого критерия укажи краткое доказательство из ответа работника и пояснение.

CRITICAL_ERROR = true только тогда, когда ответ содержит опасное утверждение или действие, создающее недопустимый риск и противоречащее нормативному требованию.
Не используй critical_error просто за неполный ответ.

Отдельно сформируй:
- WELL_SAID — что раскрыто хорошо;
- PARTLY_SAID — что раскрыто частично;
- MISSING — что не сказано;
- INCORRECT — что сказано неверно;
- SUMMARY — короткий вывод на языке экзамена.

Не рассчитывай итоговый процент «на глаз». Процент должен быть рассчитан программным алгоритмом по весам критериев после получения твоих статусов.
Prompt 6. Программная логика детерминированного расчёта балла
Связь со статьёй: тот же раздел «Сам экзамен: вопрос голосом — ответ голосом» — процент считается программно, а не назначается моделью «на глаз».
Реализуй расчёт балла НЕ через свободную оценку модели, а программно.

Для каждого критерия есть вес weight в процентах.
Коэффициенты:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = сумма(weight × coefficient) по всем критериям.
Ограничь результат диапазоном 0–100 и округли до 0,1.

Если AI-оценщик вернул critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP), где CRITICAL_CAP задаётся в настройках (например 40%).

После всех вопросов:
TOTAL_SCORE = среднее арифметическое баллов за вопросы.
PASSED = TOTAL_SCORE >= установленного проходного балла.

Важно:
- модель определяет смысловой статус критерия;
- программа считает процент;
- модель не должна самостоятельно назначать произвольный итоговый балл.
Prompt 7. Word-протокол и дневная Excel-выгрузка без персональных данных
Связь со статьёй: раздел «Протокол и история теперь формируются автоматически» — Word-протокол и дневная Excel-выгрузка.
Доработай устный экзаменатор.

WORD-ПРОТОКОЛ
После завершения экзамена автоматически формируй .docx.
В протокол включить:
- дата;
- RSS-код;
- должность/профессия;
- подразделение;
- язык;
- проходной балл;
- итоговый результат СДАН/НЕ СДАН;
- каждый вопрос;
- транскрипт ответа;
- процент за вопрос;
- нормативный источник и ссылку;
- что раскрыто хорошо;
- что не сказано;
- ошибки.

Поля «Ф.И.О.» и «Предмет проверки знаний» оставить пустыми для локального заполнения после скачивания.
Имя файла: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL ЗА ДАТУ
В разделе «История» добавить выбор даты и кнопку «Выгрузить Excel за дату».
Столбцы:
№ | Дата экзамена | Время начала | RSS-код | Должность/профессия | Подразделение | Язык | Количество вопросов | Проходной балл % | Итоговый балл % | Результат | Статус | Время завершения | ID экзамена.

Не включать ФИО и табельный номер.
Excel формировать только из локальной истории текущего компьютера.
Соответствие RSS <-> ФИО должно объединяться с результатами только офлайн внутри корпоративного контура.
Prompt 8. Аудит персональных данных и границы «офлайн/облако»
Связь со статьёй: разделы «Третий этап: переносной браузерный экзаменатор» и «Персональные данные: вместо ФИО — RSS-код».
Проведи технический аудит приложения устного экзаменатора.
Нужно честно разделить локальные и облачные операции.

Проверь и опиши:
1. Какие данные хранятся в IndexedDB/localStorage.
2. Какие данные отправляются в облачную модель при транскрибации.
3. Какие данные отправляются при смысловой оценке.
4. Какие данные отправляются при генерации проектов вопросов.
5. Передаются ли ФИО, табельный номер, список работников или таблица соответствия RSS <-> ФИО.
6. Где хранится API-ключ.
7. Содержит ли резервная копия API-ключ.
8. Что остаётся после полного закрытия приложения.
9. Как удалить локальную историю и источники.
10. Какие риски остаются при пилотной эксплуатации.

Требование к формулировке результата:
не называй приложение «полностью офлайн», если распознавание речи, оценка, TTS или генерация вопросов используют облачный API.
Правильная формулировка: «локальная переносная оболочка с локальной базой и контролируемым облачным ИИ-контуром».
Prompt 9. Добавление нескольких направлений экзамена в одном интерфейсе
Связь со статьёй: раздел «Как теперь формируется банк вопросов» — несколько правил и направлений в одном экзаменаторе без переключения между ботами.
Доработай банк вопросов и экран запуска экзамена так, чтобы больше не требовалось создавать отдельного бота под каждое правило.

У каждого вопроса уже есть поле «Тема/направление».
Добавь на экран экзамена выбор направлений:
- один тематический блок;
- несколько тематических блоков одновременно;
- режим «Все выбранные направления».

При запуске экзамена:
1. отфильтруй только утверждённые вопросы;
2. учитывай выбранный язык;
3. учитывай выбранные направления;
4. случайно выбери заданное количество вопросов программным криптографическим генератором;
5. по возможности распределяй вопросы между выбранными направлениями равномерно;
6. не допускай повторов;
7. если вопросов по выбранному набору недостаточно — останови запуск и покажи понятное сообщение.

В Word-протоколе и Excel дополнительно сохраняй выбранные направления экзамена.
Как использовать приложение к статье
Нумерация ниже синхронизирована с текстом публикации. В статье рядом с соответствующим этапом стоят прямые ссылки «См. Prompt …», а здесь под каждым промптом указано, к какому разделу статьи он относится.
- Prompt 1 — историческая версия: показывает, как работал первый экзаменатор и собственный генератор номера из 300 вопросов.
- Prompt 2 — подготовка большого банка вопросов по НПА.
- Prompt 3 — основной запрос для читателя, который хочет повторить современную браузерную версию с помощью вайб-кодинга.
- Prompt 4 — генерация проектов вопросов из загруженного источника.
- Prompt 5–6 — разделение ИИ-оценки смысла и программного расчёта процента.
- Prompt 7 — автоматические Word и Excel.
- Prompt 8 — обязательная проверка границ локального и облачного контура.
- Prompt 9 — объединение нескольких направлений экзамена в одном интерфейсе.
Комментарии 2
🤝