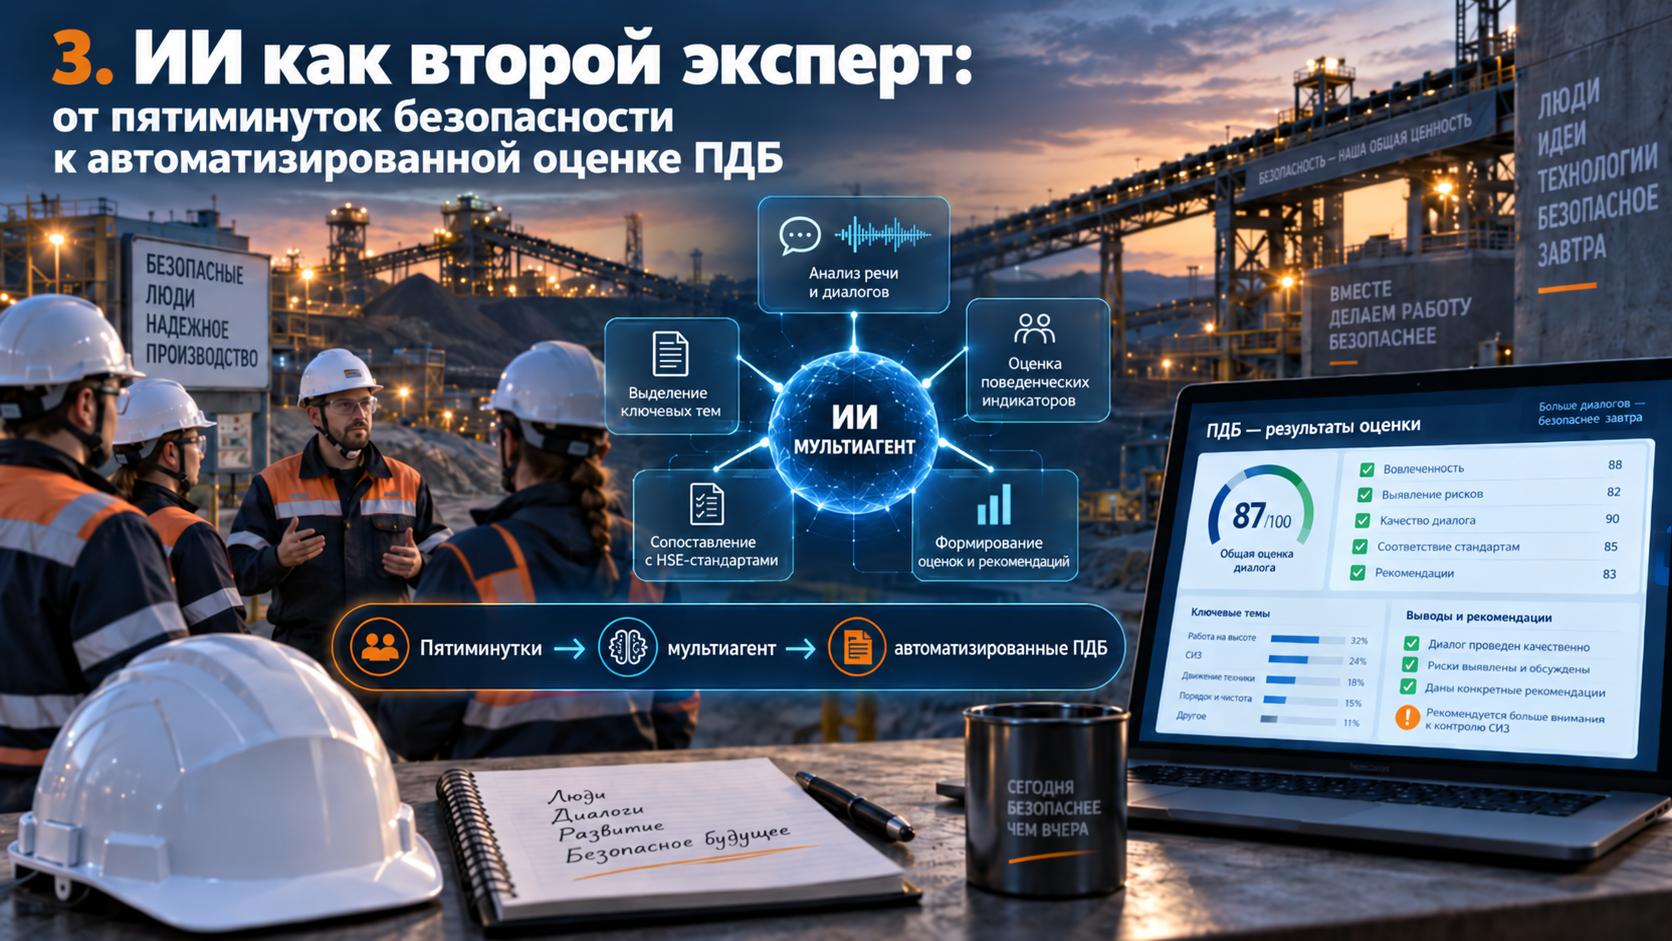
IA como segundo experto: de las charlas de seguridad a la evaluación automatizada de BSD
Charlas de seguridad → evaluación digital → Make → diálogos de seguridad conductuales automatizados
Idea principal: la IA no reemplaza al supervisor ni al especialista de seguridad. Se convierte en un "segundo experto" unificado que aplica los mismos criterios, proporciona retroalimentación personalizada y permite escalar el control de calidad a cientos y miles de conversaciones reales.
Por qué empezamos a evaluar la conversación en absoluto, y no el hecho de su realización
En salud ocupacional y seguridad industrial es fácil contabilizar el hecho: se impartió la charla de seguridad, se registró el diálogo de seguridad conductual, se completó la tarjeta. Es mucho más difícil responder a la pregunta de cuán bien condujo el supervisor la conversación en sí y si alcanzó el objetivo.
La charla de seguridad en nuestra metodología es una parte obligatoria de la reunión de cambio de turno con una duración de 5 a 10 minutos. El supervisor debe abordar un tema actual específico y establecer una conexión clara: peligro → consecuencias → medidas de seguridad. Al mismo tiempo, no solo es importante el monólogo del capataz, sino también el diálogo con los trabajadores: preguntas, respuestas y la participación en la discusión.
Por lo tanto, la tarea inicial no era "comprobar la existencia del registro", sino otra: ¿se puede enseñar a la IA a evaluar de manera uniforme la calidad real de tales conversaciones y dar al supervisor una retroalimentación específica?
Etapa 1. Primero la metodología, luego la inteligencia artificial
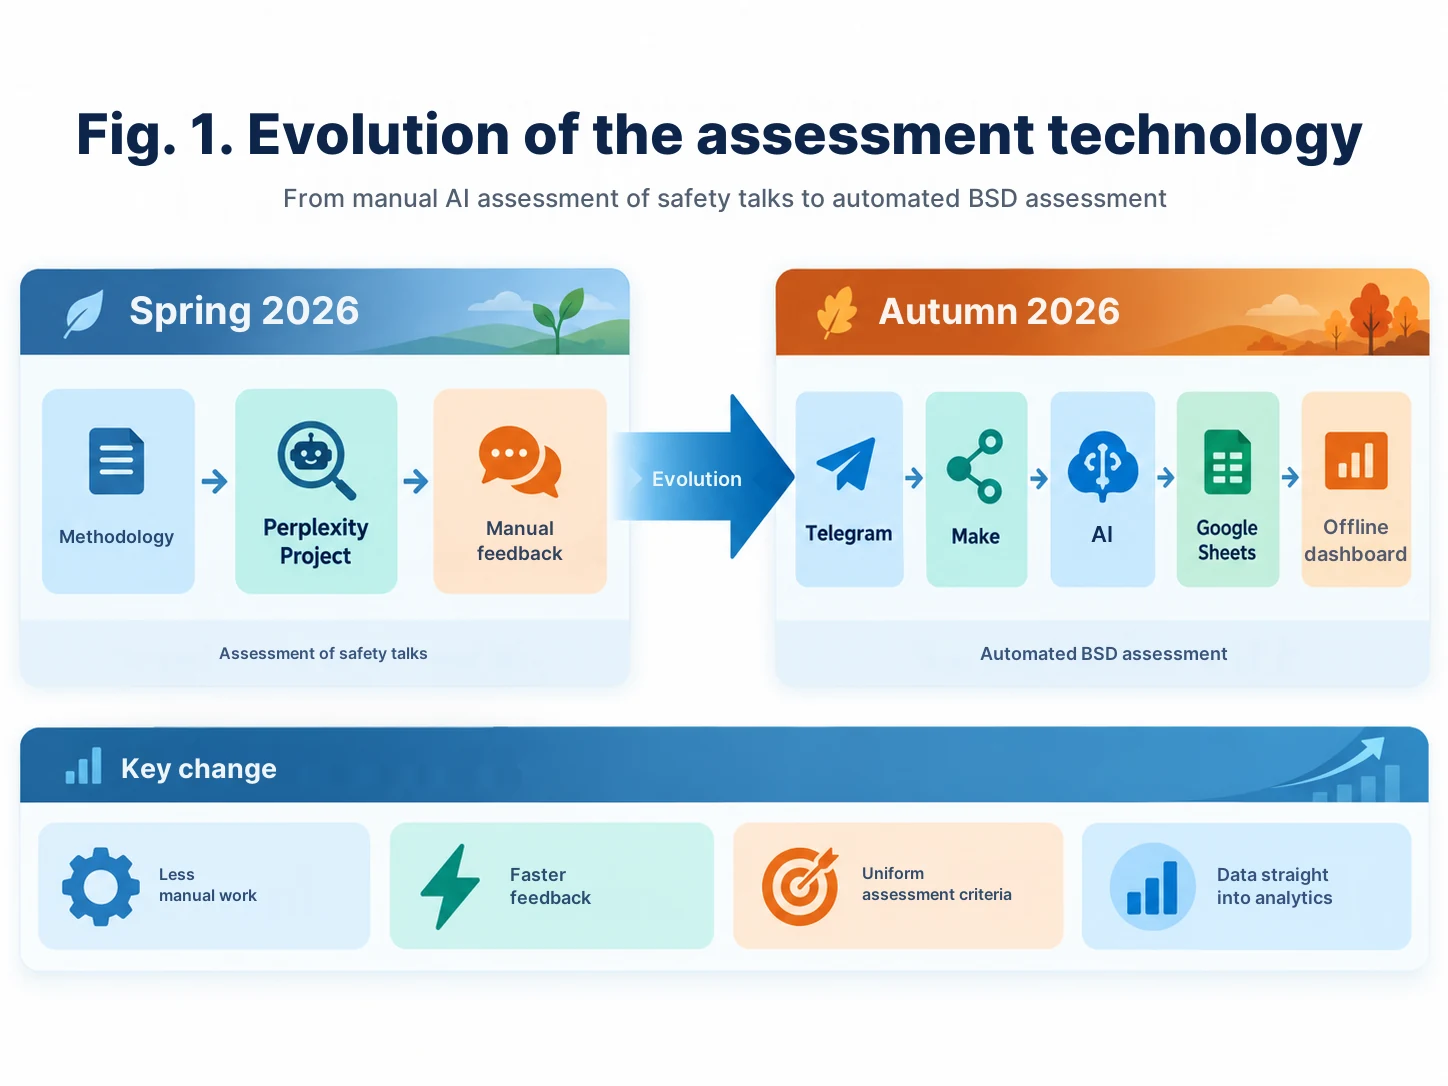
En la primavera de 2026, comenzamos con las charlas de seguridad. Antes del lanzamiento de la evaluación por IA, se prepararon pautas metodológicas y un video de capacitación sobre cómo impartir correctamente una charla de seguridad. Solo después de esto apareció el evaluador digital.
Como primer entorno de trabajo, utilizamos Perplexity Space: hoy en día, un entorno similar en Perplexity se llama Project. En el proyecto se cargaron la guía metodológica y la lista de verificación de evaluación, y para el modelo se preparó por separado un Prompt estricto.
La tarea del Prompt difería fundamentalmente de la solicitud habitual de "evaluar la presentación". A la IA solo se le permitía contabilizar lo que realmente sonaba en el audio. Si falta un elemento, 0 puntos. Si se menciona formalmente, cumplimiento parcial. Si se expone de manera lógica y completa, cumplido.
En la lista de verificación actual hay siete criterios: presentación y objetivo; peligro específico; lógica "peligro - consecuencias - medidas"; impulso emocional; medidas de seguridad; diálogo con los trabajadores; resumen final y relación con los trabajos a realizar.
Prompt 1: véase en el anexo la versión modernizada del Prompt para Perplexity Project.
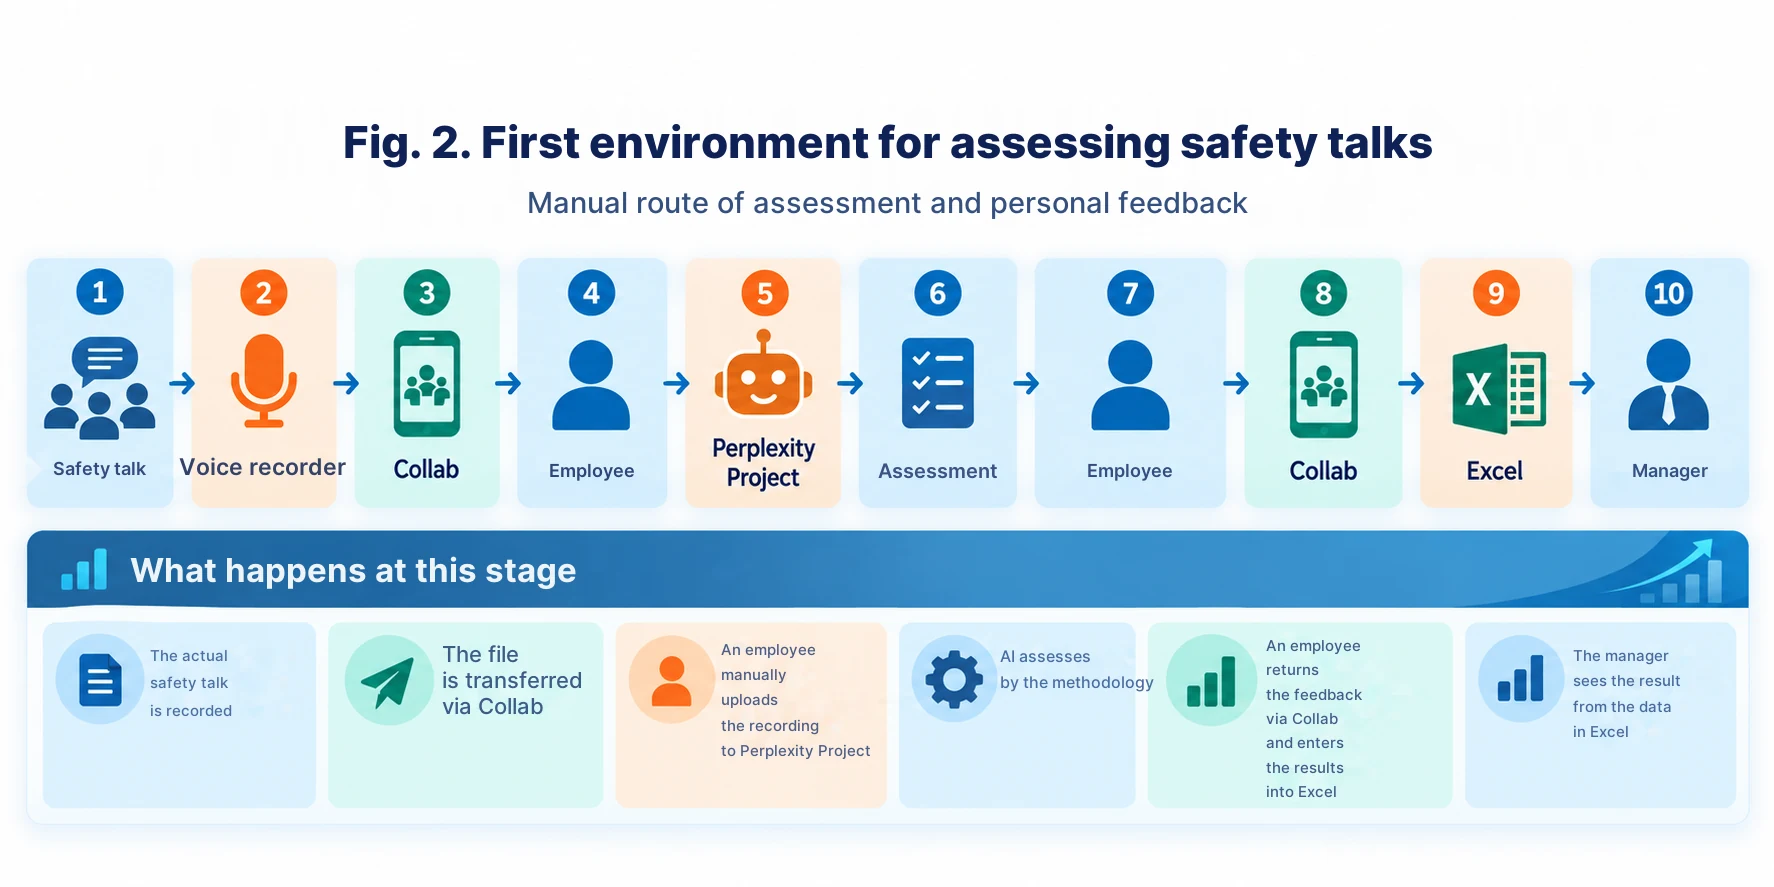
Cómo se veía el primer entorno, aún manual
El supervisor de turno grababa la charla de seguridad impartida en una grabadora de voz. A través de la aplicación corporativa Collab, la grabación se transmitía al empleado designado. El empleado subía el audio a Perplexity Project, obtenía la evaluación y devolvía la retroalimentación personalizada al supervisor también a través de Collab.
Al mismo tiempo, el resultado se ingresaba en Excel: departamento, supervisor, evaluación, número de intentos. Según la tabla, construíamos una analítica sencilla: resultados promedio de los departamentos, dinámica y número de ciclos repetidos.
Adoptamos un nivel de aprobación del 80 % para el ciclo práctico. Si el resultado era menor, el supervisor impartía la siguiente charla de seguridad ya teniendo en cuenta los comentarios de la IA. El resultado no solo era un control, sino también una capacitación individual directamente en el lugar de trabajo.
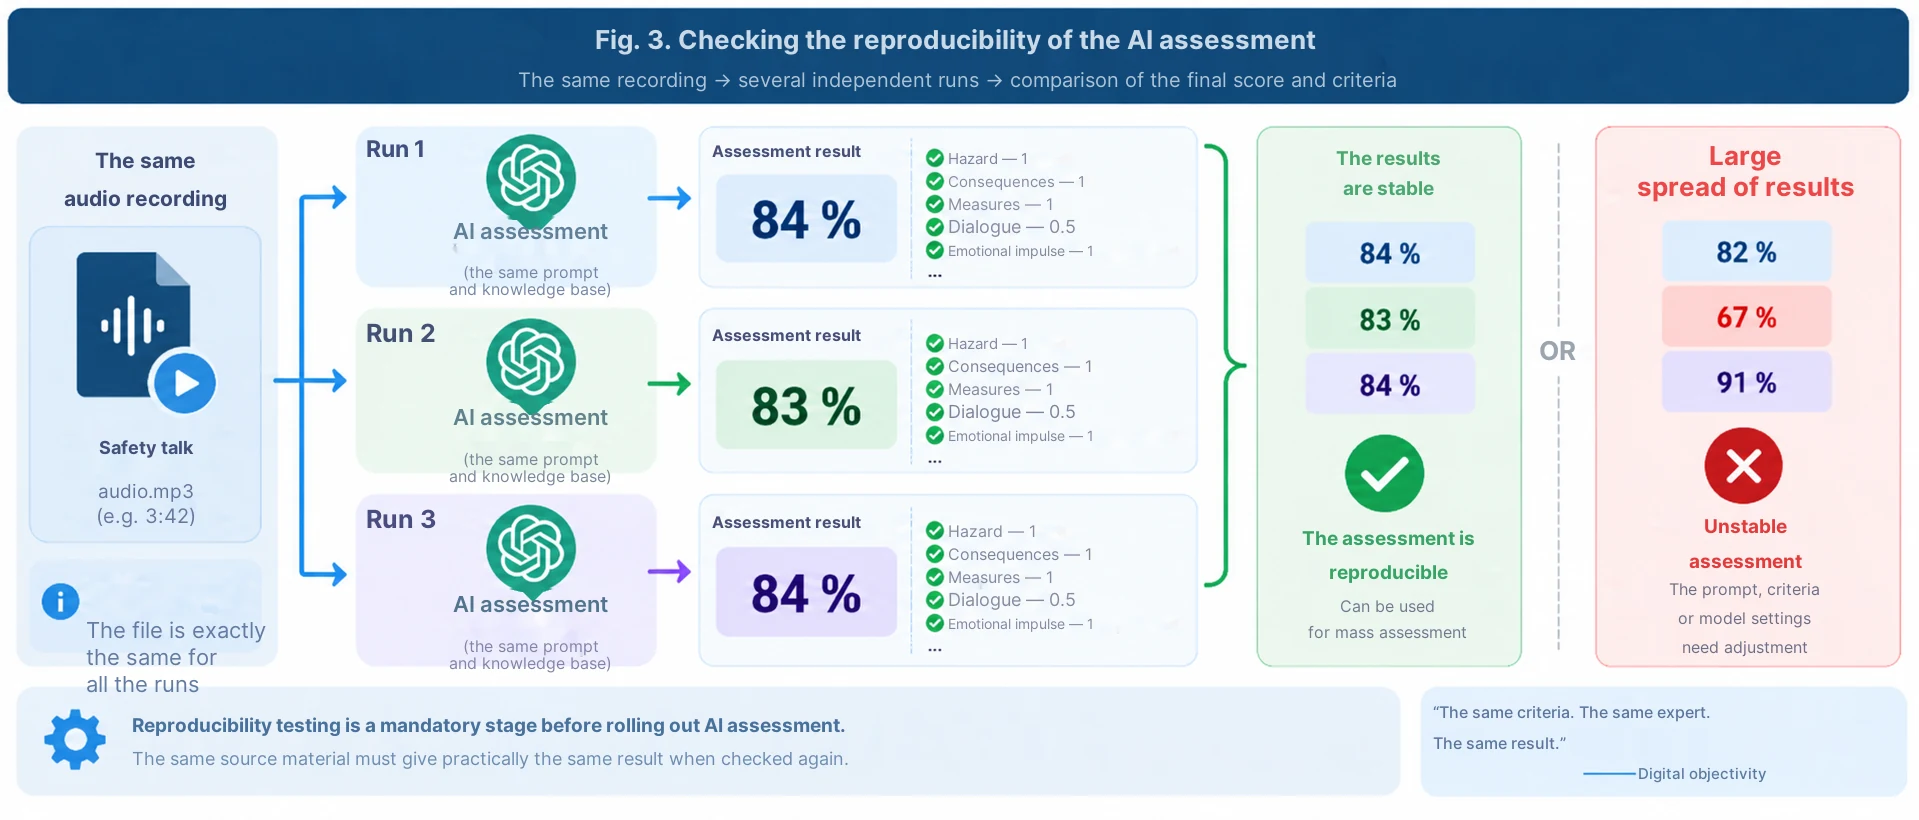
No solo comprobábamos a la persona; primero comprobábamos a la propia IA
Para mí, este es uno de los elementos más importantes de todo el esquema. Enviábamos la misma grabación de audio específicamente para evaluación varias veces. Si el mismo material obtiene hoy un 82 %, en un minuto un 65 % y luego un 91 %, dicho experto digital aún no está listo para evaluar a las personas.
Por lo tanto, buscábamos la reproducibilidad: la misma grabación debía dar la misma evaluación o una prácticamente idéntica. Si la variación se volvía notable, ajustábamos el Prompt, precisábamos los criterios y eliminábamos las formulaciones ambiguas.
Para mí, yo llamo a esto "objetividad digital". Esto no significa que la IA posea la verdad absoluta. Se trata de algo más: un experto unificado aplica la misma escala a todos y no depende del estado de ánimo, las simpatías personales o de quién está realizando exactamente la comprobación hoy.
Prompt 2: véase en el anexo el protocolo de comprobación de la reproducibilidad de la evaluación.
Por qué el esquema manual dejó de ser satisfactorio
Para el piloto, el recorrido manual era conveniente: recibir el archivo, subirlo, esperar el resultado, devolver la retroalimentación e ingresar la puntuación en Excel. Pero este enfoque tiene un límite natural.
Cuando el volumen ya se mide en cientos y miles de grabaciones, comenzamos a automatizar no la evaluación, sino a crear un nuevo trabajo administrativo en torno a la evaluación. Por lo tanto, al pasar a los diálogos de seguridad conductuales (BSD), la tarea se formuló de manera diferente: eliminar a la persona de la cadena técnica donde su participación no crea valor.
Etapa 2. El diálogo de seguridad conductual es más complejo que una charla de seguridad habitual
El diálogo de seguridad conductual no es solo una breve presentación. La metodología incluye la observación del trabajo real y una conversación con la persona. Para el supervisor, es importante ver el comportamiento seguro o peligroso, y luego a través de preguntas lograr que el trabajador mismo nombre el peligro, las posibles consecuencias y el método seguro de realización del trabajo.
Si el trabajador trabaja de manera peligrosa, la parte clave de la conversación es discutir los peligros y las consecuencias, luego el método seguro de trabajo y otras fuentes de peligro. Si la persona trabaja de manera segura, el supervisor debe notar y reforzar el comportamiento correcto, y luego usar la conversación para discutir otras cuestiones de seguridad.
Precisamente por eso, el entorno de evaluación del BSD debe comprobar no solo las palabras del supervisor, sino también la existencia de un diálogo real: si se hicieron preguntas, si el trabajador respondió, si se discutieron las causas del comportamiento, las consecuencias, las acciones seguras y la conclusión de la conversación.
Identificador seudónimo en lugar del apellido
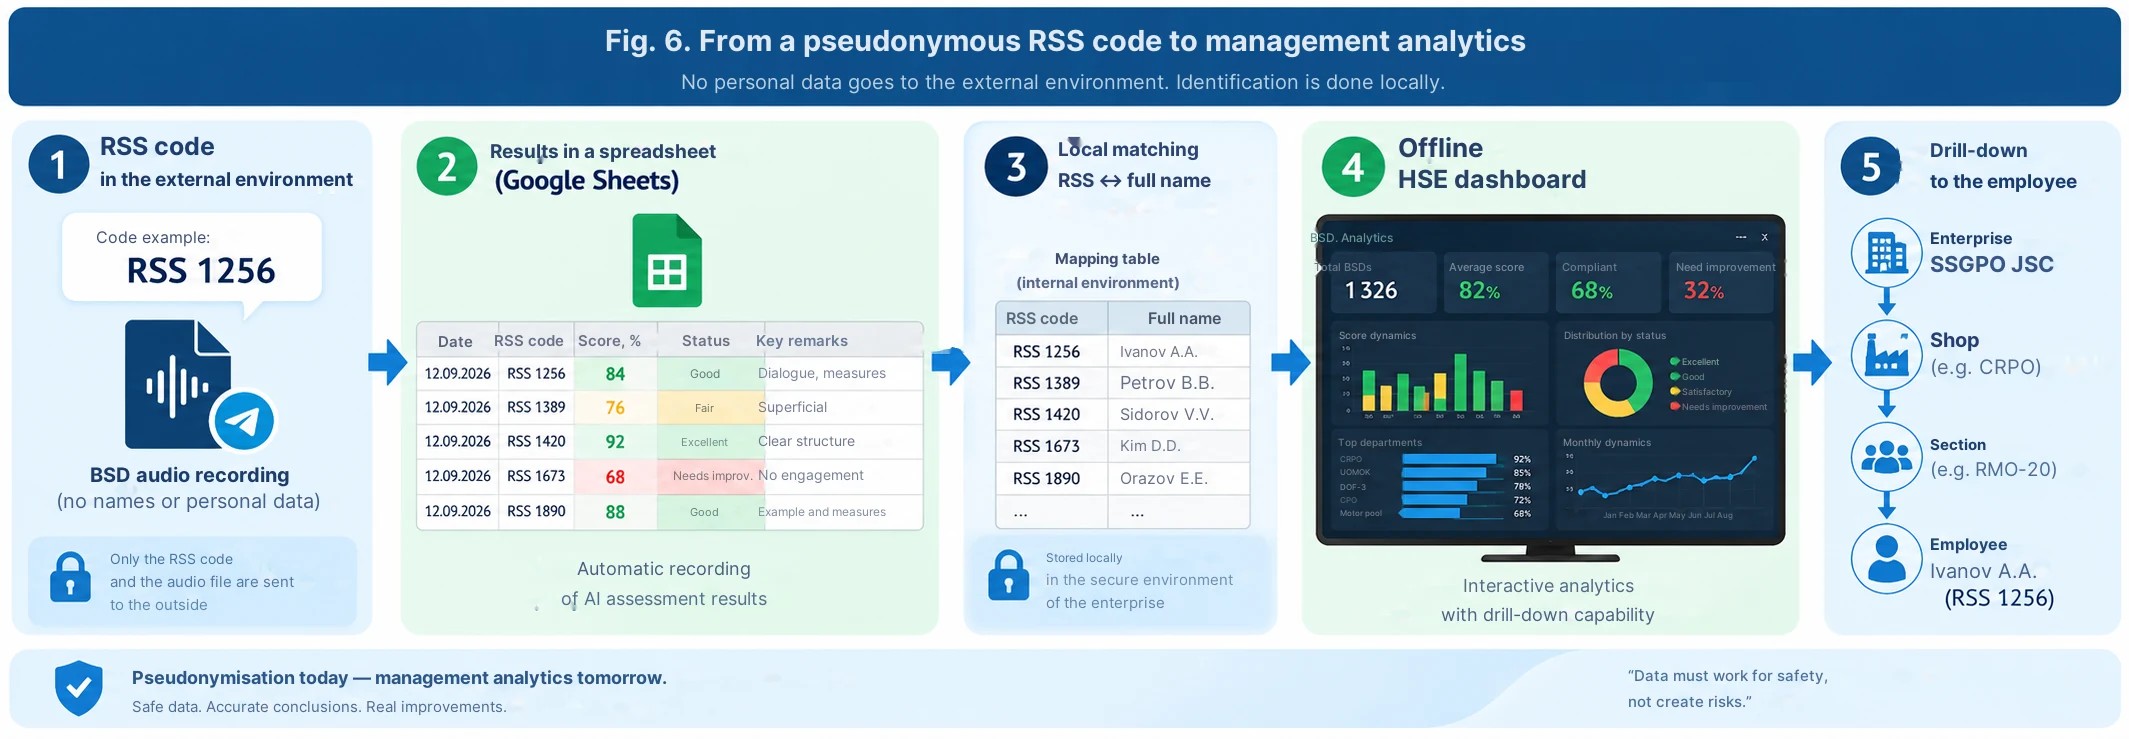
En la automatización masiva, resolvimos por separado la cuestión de la identificación. Dentro del entorno corporativo ERGIS, a cada participante se le asigna un código especial del tipo RSS 1256. Este no es un número de empleado ni un apellido.
Antes de comenzar la grabación, el supervisor pronuncia su código RSS, tras lo cual lleva a cabo el BSD. En la conversación no hay necesidad de nombrar apellidos o números de empleado. La correspondencia "código RSS ↔ empleado específico" permanece dentro del entorno corporativo y se utiliza posteriormente en la analítica local.
Aquí es más correcto hablar no de una anonimización total, sino de una seudonimización: en el archivo de audio aún permanece la voz de la persona. Pero el volumen de datos personales que pasa a través del entorno automatizado se reduce sustancialmente.
Un pequeño secreto: no soy programador
Ensamblamos la arquitectura de la nueva solución a través de Make. No soy programador y al comienzo del trabajo le escribí directamente sobre esto a ChatGPT.
La solicitud fue sencilla: "Guíame paso a paso a través de la creación de esta automatización. Dame una acción a la vez. La ejecutaré en Make y te enviaré una captura de pantalla. Después de la verificación, dame el siguiente comando".
Luego sucedió exactamente así. ChatGPT explicaba qué módulo crear y qué completar en él; yo ejecutaba la acción y enviaba la captura de pantalla; después de la verificación, recibía el siguiente paso. De manera similar se creó el bot de Telegram y se vinculó toda la cadena.
Esta es una conclusión importante para mí a partir de la práctica del vibe coding: el especialista no necesita conocer de antemano la sintaxis de la API o de Make. Pero está obligado a comprender bien el proceso de producción, el resultado que el usuario debe obtener, y saber cómo comprobar consecutivamente cada etapa.
Prompt 3: véase en el anexo el Prompt inicial "guíame paso a paso a través de Make".
Qué sucede ahora: Telegram → Make → IA → resultado
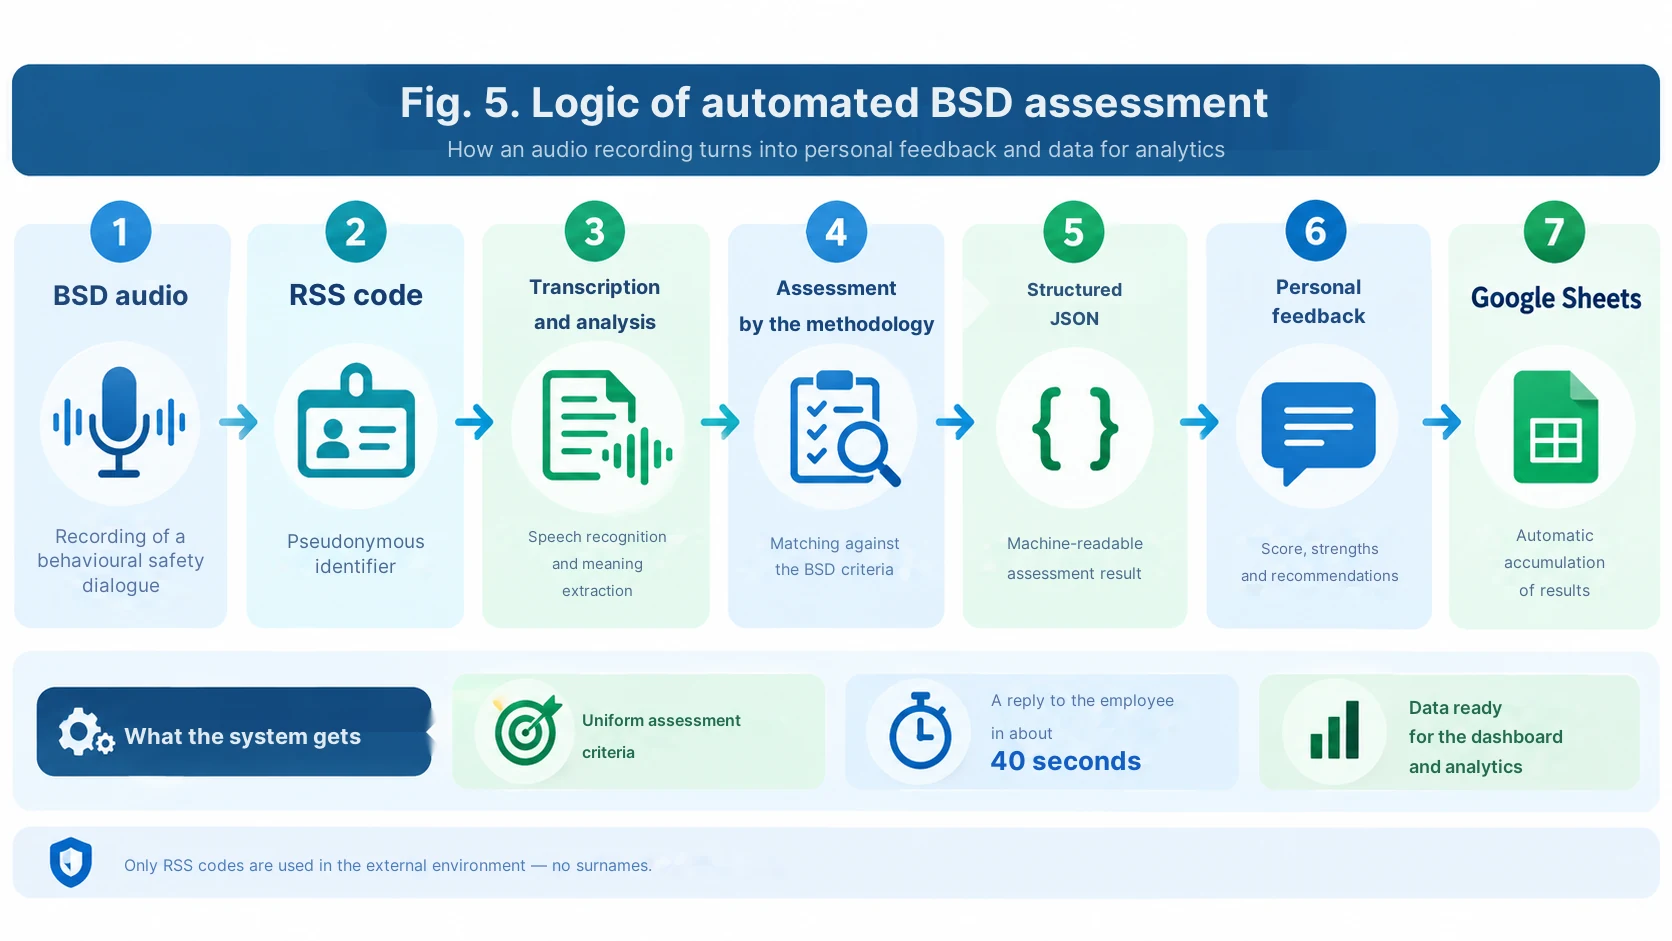
El entorno moderno funciona casi sin operador manual. El supervisor envía la grabación de audio al bot de Telegram. Make recibe el archivo, comprueba los datos de entrada e inicia la ruta de procesamiento. La IA analiza la grabación según la metodología dada, genera la evaluación y la retroalimentación. El resultado se devuelve al usuario y, al mismo tiempo, se registra en Google Sheets para la analítica general.
En el piloto actual, la retroalimentación se devuelve aproximadamente en decenas de segundos. Para el usuario, esto se ve sencillo: envió el audio, recibió la evaluación, los puntos fuertes, los errores específicos y qué cambiar la próxima vez.
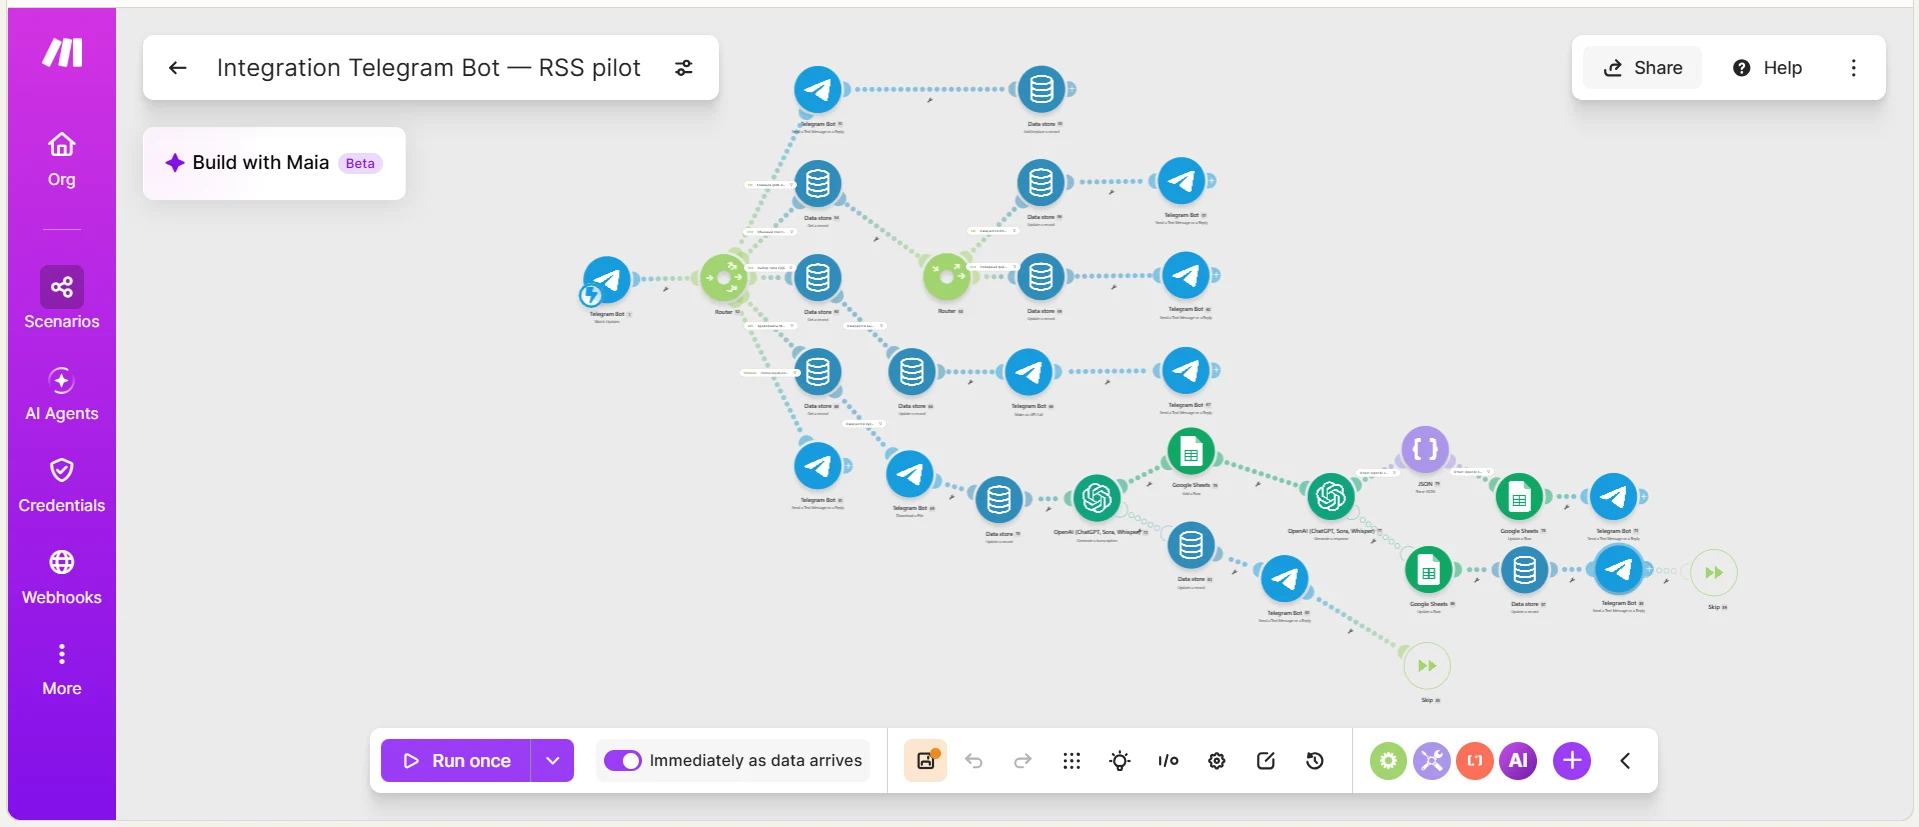
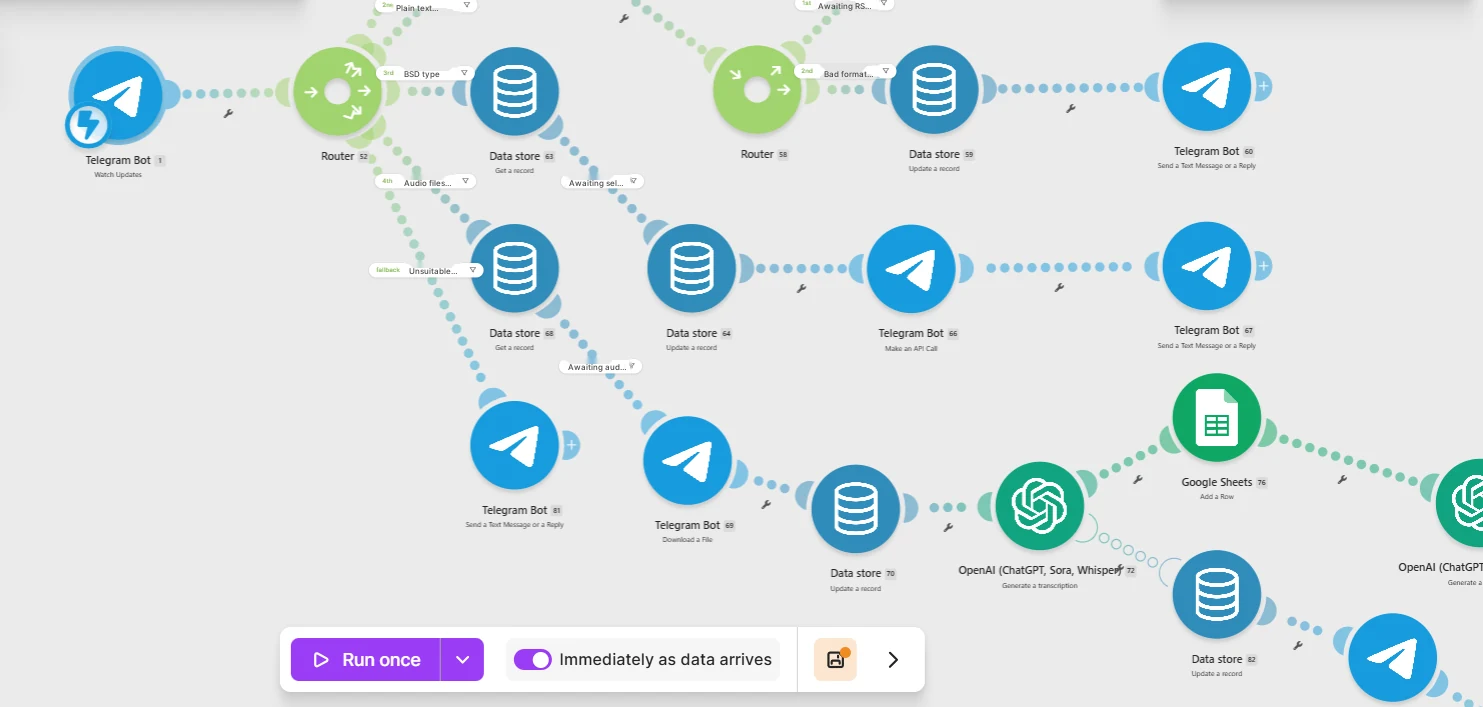
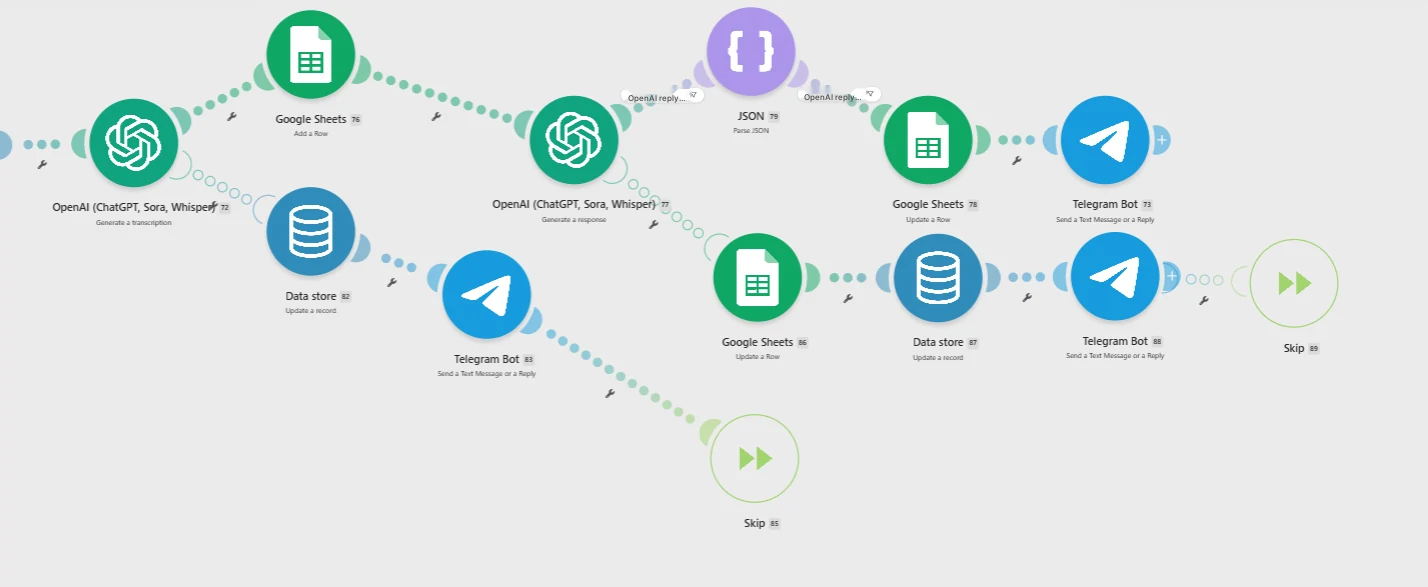
En el esquema de Make se puede ver que detrás de esta simplicidad se oculta un enrutamiento completo: Telegram, Data store, Router, OpenAI, Google Sheets, comprobaciones y mensajes de retroalimentación al usuario.
¿Es esto un multiagente o no?
Yo no usaría aquí la palabra «multiagente» solo por el efecto. En la práctica, tenemos un circuito experto de varios pasos, en el que diferentes partes del escenario realizan distintas funciones: recepción y enrutamiento del archivo, extracción del identificador, análisis del contenido, evaluación experta, formación del resultado estructurado, escritura en la tabla y retroalimentación personal.
Si varias llamadas de modelo individuales funcionan con diferentes roles del sistema (por ejemplo, una analiza el diálogo, la segunda controla el cumplimiento de la metodología y formatea el resultado), esto ya se puede considerar como una lógica multiagente o de múltiples agentes. Si una llamada de modelo realiza todas las funciones, es más honesto hablar de un evaluador de IA multifuncional.
Por eso, en el anexo he dividido los Prompts por funciones, y no llamo a cada función un agente independiente.
Cómo funciona la evaluación automatizada del BSD
En el escenario industrial es importante separar dos tareas. La primera es experta: evaluar el contenido de la conversación estrictamente en relación con la metodología. La segunda es técnica: devolver el resultado en un formato que Make entienda y pueda guardar en Google Sheets.
Por lo tanto, para la automatización es conveniente una respuesta estructurada en JSON: código RSS, puntuación final, estado, puntos fuertes, áreas de mejora, retroalimentación breve y criterios de evaluación individuales. Tal formato reduce el riesgo de que la automatización «se rompa» debido al texto hermoso pero impredecible del modelo.
Al mismo tiempo, la regla estricta sigue siendo la misma que en primavera: no contar lo que no está en la grabación; no adivinar intenciones; no inventar la respuesta correcta por el supervisor. Si la transcripción está incompleta, la grabación debe enviarse a una recarga, y no recibir una evaluación inventada.
Prompts 4–6: evaluación del BSD, JSON estructurado y formación de retroalimentación, véase en el anexo.
De la evaluación personal al panorama por departamentos
Después de cada evaluación, en Google Sheets ya no se acumula simplemente retroalimentación en texto, sino un conjunto estructurado. Por lo tanto, se puede ver la cantidad de BSD realizados, el resultado promedio, los principales errores recurrentes, la dinámica y los resultados por códigos RSS seudónimos.
El siguiente paso ya lo conocemos por el segundo artículo: asociar localmente el código RSS con el nombre completo en el circuito corporativo y cargar el resultado en un panel HSE autónomo. Entonces, el supervisor ve el panorama de la empresa, el taller y el sector, y si es necesario profundiza hasta el trabajador específico.
Es decir, el circuito de evaluación externo puede funcionar sin el apellido, y el panorama de gestión completo se restablece solo dentro de la empresa.
Cómo se puede repetir esta idea sin nuestra arquitectura
El sentido del enfoque no está ligado a una sola marca de IA. En la variante más simple, se puede crear un Perplexity Project con la metodología y el Prompt de evaluación. Se puede usar ChatGPT con una instrucción constante y una base de conocimientos cargada. Se puede construir un esquema alrededor de Google NotebookLM / Gemini Notebook como fuente de materiales metodológicos, y realizar la evaluación con un modelo separado. Para un flujo masivo, es más conveniente usar Make u otra plataforma de automatización con Telegram, OpenAI y tablas.
Los elementos clave siguen siendo los mismos: metodología aprobada → Prompt estricto → verificación de la reproducibilidad → escala comprensible → retroalimentación personal → acumulación estructurada del resultado.
Qué ha cambiado en unos meses
En primavera, un empleado transfería manualmente los archivos de audio a la IA y devolvía el resultado. Hoy construimos un circuito que es capaz de recibir y evaluar cerca de 1300 grabaciones de BSD sin un operador separado para cada archivo.
Pero el cambio principal ni siquiera está en la velocidad. Hemos obtenido la posibilidad de aplicar los mismos criterios a una gran cantidad de conversaciones reales y de convertir cada evaluación en un breve ciclo de aprendizaje individual.
La IA en este esquema no es un inspector que busca un culpable. Es simultáneamente un segundo experto y un coach digital: registra la falta de conformidad con la metodología, explica qué se debe mejorar exactamente y permite comprobarlo ya en la siguiente conversación.
Conclusión
Cuando empezamos, la tarea sonaba como un experimento: ¿podrá la IA evaluar la charla de seguridad? El resultado fue una tecnología que se puede escalar a los diálogos de seguridad conductual, la capacitación y otros tipos de comunicaciones de seguridad.
Para mí, el resultado más valioso no es la cifra automática. El valor reside en que el supervisor recibe retroalimentación casi inmediatamente después de una conversación real, y la empresa recibe simultáneamente un conjunto de datos sobre qué elementos de la metodología son realmente difíciles para las personas.
Es precisamente en este punto donde la IA empieza a funcionar no en lugar del sistema de gestión de la seguridad, sino dentro de él, como un segundo experto uniforme.
Prompts para el artículo «La IA como segundo experto»
Charlas de seguridad, verificación de la reproducibilidad, Make y evaluación automatizada del BSD
Esta es la versión de publicación de los Prompts. Está basada en una metodología real y en nuestra arquitectura de trabajo, pero antes de aplicarla en otra empresa, los criterios y umbrales deben ser reemplazados por los requisitos locales aprobados.
Prompt 1. Evaluación modernizada de la charla de seguridad en Perplexity Project
Esta es una versión de publicación mejorada del Prompt actual. He corregido las contradicciones internas: la lista de verificación ahora contiene realmente 7 criterios, y el umbral de aprobación es el mismo en todas partes: 80%.
Actúas como un experto en salud ocupacional y seguridad industrial que realiza una evaluación de control de calidad sobre la conducción de una charla de seguridad por el supervisor de turno.

FUENTES Y PRIORIDAD
1. Grabación de audio de la charla de seguridad.
2. Manual metodológico aprobado de la empresa.
3. Lista de verificación de evaluación aprobada.
En caso de conflicto de redacción, guíate por la lista de verificación y la metodología aprobadas. No añadas tus propios criterios.

ETAPA 1. TRANSCRIPCIÓN COMPLETA
- Primero, obtén una transcripción completa del audio, no un resumen breve.
- Para Perplexity Project, utiliza la herramienta de lectura del archivo de audio adjunto en modo completo (READ / presupuesto de contexto máximo disponible).
- Marca los fragmentos ininteligibles como [ininteligible].
- Si se reconoce de forma coherente menos del 80% del discurso o falta una parte sustancial de la grabación, responde solo: «Datos insuficientes. Vuelve a cargar el archivo.» y detente.
- No incluyas la transcripción completa en el informe final.

ETAPA 2. EVALUACIÓN DE EXPERTO
Evalúa solo lo que realmente se escuchó en la transcripción completa.
Prohibido:
- suponer las intenciones del capataz;
- dar crédito a algo que no está en la grabación;
- mejorar la redacción por el evaluado;
- compensar un elemento faltante con una buena impresión general.

ESCALA PARA CADA CRITERIO
Cumplido = 1 punto.
Parcialmente = 0,5 puntos.
No cumplido = 0 puntos.
Regla:
- ausente en el audio → 0;
- mencionado formalmente, sin desarrollar → 0,5;
- desarrollado de manera lógica y correcta → 1.

LISTA DE VERIFICACIÓN — EVALÚA LOS 7 PUNTOS SIN OMISIONES
1. Presentación de uno mismo y del objetivo de la charla de seguridad.
2. Nombre del peligro específico / tema actual.
3. Lógica «peligro → consecuencias → medidas de seguridad».
4. Impulso emocional a través de consecuencias reales/potenciales o un ejemplo pertinente.
5. Medidas de seguridad específicas.
6. Diálogo con los trabajadores: preguntas, respuestas, participación.
7. Resumen final y conexión con los trabajos actuales / próximos.

FORMATO DE RESPUESTA
1. Tabla:
N.º | Criterio | Qué se escuchó realmente | Evaluación | Puntuación

2. Resultado:
Obtenido: X de 7.
Porcentaje: (X/7)*100, redondear a 1 decimal.

3. Estado del ciclo:
- si el resultado es >=80%: «Nivel de aprobación alcanzado»;
- si el resultado es <80%: «Nivel de aprobación no alcanzado. Se recomienda una charla de seguridad repetida tras estudiar la retroalimentación».

4. Puntos fuertes — 2–5 puntos específicos, solo de la grabación.
5. Áreas de mejora — específicamente sobre los criterios no cumplidos/cumplidos parcialmente.
6. Retroalimentación al capataz — 3–5 oraciones: estilo profesional, exigente, de desarrollo.

CONTROL ANTES DE RESPONDER
Antes de la respuesta final, vuelve a comprobar:
- la suma de los puntos coincide con la tabla;
- el porcentaje está calculado correctamente;
- no se ha omitido ninguno de los 7 criterios;
- ninguna afirmación se basa en algo que no estaba en el audio.
Comentario: Desde la versión original se ha conservado el principio principal: primero la transcripción completa, luego la evaluación solo basada en lo que se escuchó realmente. En Perplexity el nombre específico de la herramienta de lectura de archivos puede cambiar, por lo que en la versión pública es mejor describir la función en lugar de vincular rígidamente al lector al nombre search_files_v2.
Prompt 2. Comprobación de reproducibilidad («objetividad digital»)
Este prompt se utiliza después de varias ejecuciones independientes de la misma grabación.
Realizo una validación de la reproducibilidad del evaluador de IA.

Tengo los resultados de N evaluaciones independientes de LA MISMA grabación de audio utilizando la misma lista de verificación.
Te transmitiré las tablas finales/JSON de cada ejecución.

Tu tarea:
1. Comparar el porcentaje final entre las ejecuciones.
2. Comparar la puntuación de cada criterio.
3. Resaltar los criterios en los que el modelo cambia de decisión con mayor frecuencia.
4. Calcular:
   - el porcentaje final mínimo;
   - el porcentaje final máximo;
   - el rango en puntos porcentuales;
   - el porcentaje final promedio.
5. No reevaluar la grabación original en sí y no elegir la evaluación «correcta» — analizar únicamente la estabilidad del evaluador.

CRITERIO PARA EL PILOTO
- diferencia de 0–2 p.p. — alta reproducibilidad;
- 2,1–5 p.p. — aceptable, pero comprobar los criterios controvertidos;
- más de 5 p.p. — el prompt/los criterios requieren mejora.

Proporciona la salida en formato:
- Nivel de reproducibilidad;
- Dónde se produce la dispersión;
- Qué exactamente en el prompt debe hacerse menos ambiguo;
- Si es necesario repetir la prueba después del ajuste.

No llames a esto objetividad absoluta. Utiliza el término «reproducibilidad de la evaluación».
Comentario: El umbral de dispersión en el ejemplo es una guía de trabajo para la publicación, no una norma corporativa aprobada. Puede eliminarse o sustituirse por el suyo propio.
Prompt 3. ChatGPT como mentor paso a paso para Make
Este es el mismo principio que permite a una persona sin habilidades de programación repetir la solución.
No soy programador y no he construido escenarios en Make antes.
Ayúdame a crear una automatización bajo el principio de «una acción a la vez».

OBJETIVO
El bot de Telegram recibe una grabación de audio de un diálogo de seguridad conductual (BSD). Luego Make debe:
1. recibir el archivo;
2. comprobar el tipo de entrada;
3. extraer/obtener el audio;
4. transferir el material a la IA para su análisis;
5. obtener un resultado estrictamente estructurado;
6. escribir el resultado en Google Sheets;
7. enviar al usuario una retroalimentación personal breve;
8. manejar correctamente los errores, los archivos duplicados y el formato no compatible.

REGLAS DE NUESTRO TRABAJO
- Da solo UN paso siguiente por mensaje.
- Escribe el nombre exacto del módulo de Make que se debe añadir.
- Escribe qué elegir en cada campo obligatorio.
- Si se requiere una variable de un módulo anterior, indica su origen exacto.
- Después de cada paso, detente y pídeme que envíe una captura de pantalla.
- Según mi captura de pantalla, primero comprueba si todo se ha hecho correctamente. Si hay un error, lo corregimos y solo entonces seguimos adelante.
- No te saltes las etapas y no envíes todo el escenario a la vez.
- Explica con palabras sencillas, sin suponer que conozco de API, JSON o programación.
- Si hay varias formas, elige la más sencilla y fiable para el piloto y explica brevemente por qué.

RESTRICCIONES
- el identificador de usuario en el circuito de evaluación es un código seudónimo como RSS 1234;
- los apellidos y los números de empleado no son necesarios;
- el resultado para la tabla debe estar estructurado;
- a la persona en Telegram solo se le envía retroalimentación comprensible, sin JSON técnico.

Comienza con el primer paso: la creación/conexión del bot de Telegram y el primer módulo de entrada de Make.
Prompt 4. Núcleo de evaluación del BSD para OpenAI/ChatGPT en Make
Esta es una versión de publicación universal del bloque de evaluación. Devuelve específicamente JSON, por lo que Make escribe más fácilmente el resultado en la tabla y enruta la respuesta.
SYSTEM ROLE
Eres un evaluador experto de la calidad de los diálogos de seguridad conductual (BSD). Evalúas SOLO el contenido de la transcripción proporcionada y aplicas la metodología aprobada de la empresa.

IMPORTANTE
Si la empresa ha proporcionado una lista de verificación aprobada por separado, tiene prioridad sobre la estructura de ejemplo a continuación.
No inventes criterios que no estén en la metodología.

PRINCIPIOS BÁSICOS DE LA METODOLOGÍA QUE DEBEN COMPROBARSE EN EL AUDIO
- hay una conversación real con el trabajador, no un monólogo/inspección;
- se hacen preguntas al trabajador;
- el trabajador mismo nombra/discute el peligro y las posibles consecuencias, si la situación es peligrosa;
- se discute un método seguro de realizar el trabajo;
- se discuten otras fuentes de peligro y medidas de seguridad;
- cuando el trabajo es seguro, el supervisor señala y refuerza una acción segura específica;
- la comunicación es respetuosa;
- la conversación termina con una conclusión/agradecimiento claro;
- no dar crédito a la observación visual si no se puede confirmar a través del audio.

ENTRADA
- transcript: transcripción completa;
- rss_id: identificador seudónimo como RSS 1234;
- methodology_context: extractos/reglas de la metodología aprobada;
- optional_checklist: lista de verificación local aprobada, si existe.

REGLAS DE EVALUACIÓN
1. Utiliza solo hechos del transcript.
2. No adivines las intenciones.
3. No restaures el nombre completo por la voz/el contexto.
4. Si el transcript es claramente incompleto o incoherente — quality_status="insufficient_data" y no asocies una puntuación general.
5. Si se aplica una lista de verificación local, evalúa todos sus puntos sin omisiones.
6. Para cada conclusión, guarda un evidence breve: la frase/contenido de la transcripción que confirma la decisión.

SALIDA — SOLO JSON, SIN MARKDOWN Y SIN TEXTO ANTES/DESPUÉS
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 oraciones comprensibles para el supervisor",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

ANTES DE RESPONDER COMPRUEBA
- el JSON es válido;
- rss_id no se ha modificado;
- la puntuación final corresponde a la suma de los criterios;
- el evidence no contiene hechos inventados;
- si los datos son insuficientes, no hay un overall_score_percent inventado.
Comentario: Dado que en los materiales proporcionados no se ha fijado un checklist de puntuación aprobado por separado para el BSD, no presento una escala inventada como norma corporativa. En la versión de trabajo, debe insertar su checklist real.
Prompt 5. Módulo de retroalimentación separado en Telegram
Si en el escenario se utiliza una segunda llamada al modelo, es conveniente limitarla solo a formatear la evaluación ya terminada. Esto aumenta la estabilidad: el segundo módulo no debe volver a «repensar» la puntuación.
Recibes un JSON de la evaluación experta del BSD ya TERMINADO del paso anterior.
No vuelvas a evaluar la grabación ni cambies la puntuación.

Genera una respuesta corta para el usuario para Telegram.

FORMATO
RSS: <código>
Puntuación: <porcentaje o «no evaluado — datos insuficientes»>

Qué se hizo bien:
• 2–4 puntos cortos de strengths

Qué mejorar:
• 2–4 puntos concretos de improvements

Para el próximo BSD:
<1–2 acciones lo más concretas posibles>

REGLAS
- 700–1200 caracteres como máximo;
- tono profesional y respetuoso;
- sin JSON técnico;
- sin apellidos;
- no inventar nuevas observaciones;
- no usar eslóganes motivacionales;
- si quality_status=insufficient_data — pedir volver a grabar/subir el audio y no mostrar puntuación.
Prompt 6. Normalización del resultado antes de Google Sheets
Este paso es útil si Google Sheets debe recibir la misma estructura independientemente de la longitud del texto de la evaluación.
Comprueba la fila de datos antes de escribir en Google Sheets.

Campos esperados:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

REGLAS
1. No añadas el nombre completo ni el número de empleado.
2. rss_id debe coincidir con el patrón: RSS + espacio + 3–6 dígitos.
3. overall_score_percent debe ser un número entre 0–100 o estar vacío con insufficient_data.
4. Convierte los arrays en cadenas cortas separadas por «; ».
5. Si falta un campo obligatorio — devuelve error=true y enumera los missing_fields.
6. Si todo es correcto — error=false.

SALIDA SOLO EN JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Auditoría del escenario de Make terminado mediante captura de pantalla
Adecuado como prompt final para comprobar el escenario antes del piloto masivo.
Te enviaré una captura de pantalla de mi escenario de Make.
Realiza una auditoría técnica como un mentor de automatización no-code.

Comprueba según la captura de pantalla y mi descripción:
1. el orden de los módulos;
2. las rutas del Router;
3. el manejo de mensajes no soportados;
4. el almacenamiento del estado temporal en el Data store;
5. la recepción y transmisión del archivo de audio;
6. la llamada a la IA;
7. el parsing de JSON;
8. la escritura en Google Sheets;
9. el envío del resultado a Telegram;
10. la rama de error y reintento;
11. el riesgo de duplicados al reiniciar;
12. el riesgo de que un usuario reciba el resultado de otro.

No propongas una reconstrucción completa si la arquitectura actual funciona.
Primero enumera:
- qué está bien;
- los 3 riesgos más críticos;
- qué ÚNICO paso siguiente se debe dar primero.
Después de eso detente y espera mi captura de pantalla/confirmación.
Secuencia práctica para el lector
- Cargar la metodología y el checklist aprobados en el Project/agente seleccionado.
- Configurar el Prompt 1 y probarlo en varias grabaciones de referencia.
- Ejecutar la misma grabación varias veces y aplicar el Prompt 2 para evaluar la reproducibilidad.
- Si se requiere automatización — empezar con el Prompt 3 y armar Make módulo por módulo comprobando las capturas de pantalla.
- En Make, usar el Prompt 4 como núcleo experto y requerir un JSON estricto.
- Si es necesario, separar la retroalimentación del usuario en el Prompt 5.
- Antes de escribir en Google Sheets, normalizar los datos con el Prompt 6.
- Antes del lanzamiento masivo, comprobar todo el esquema con el Prompt 7.
Comentarios 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!