Ohne Antwortoptionen A, B und C: der mündliche KI-Prüfer
Die Grundidee: Ein klassischer Test prüft vor allem, ob jemand die richtige Option wiedererkennt. Das mündliche Format zwingt den Menschen, die Anforderung selbst zu erklären. Die KI wird hier nicht gebraucht, um die Antwort vorzusagen, sondern für eine einheitliche inhaltliche Bewertung.
Warum wir uns überhaupt an die mündliche Prüfung gewagt haben
Klassische Tests sind praktisch, wenn viele Menschen geprüft werden müssen, haben aber eine offensichtliche Schwäche: Der Mitarbeiter sieht die Antwortoptionen. Selbst bei einer guten Fragenbank lässt sich ein Teil des Ergebnisses dadurch erzielen, dass man die Formulierung wiedererkennt, offensichtlich falsche Optionen ausschließt oder sich schlicht an den Test erinnert.
Eine mündliche Prüfung funktioniert anders. Der Mensch muss die Antwort selbst formulieren, die Abfolge der Handlungen erklären und Gefährdungen, Einschränkungen und verbindliche Anforderungen benennen. Dieses Format zeigt besser, ob er die Regel verstanden oder die richtige Formulierung nur schon einmal gesehen hat.
Doch die übliche mündliche Prüfung hat ein anderes Problem – den Zeitaufwand und die unvermeidlichen Unterschiede zwischen den Prüfern. Der eine hakt tiefer nach, der andere akzeptiert eine Antwort schneller; der eine legt Wert auf die genaue Formulierung, der andere auf den Sinn. Deshalb haben wir im Frühjahr 2026 nach einem Weg gesucht, KI als zweiten Prüfer einzusetzen: nicht anstelle der Prüfungskommission, sondern als einheitliches Werkzeug, das die Frage stellt, die Antwort anhört und die vorgegebenen Kriterien immer gleich anwendet.
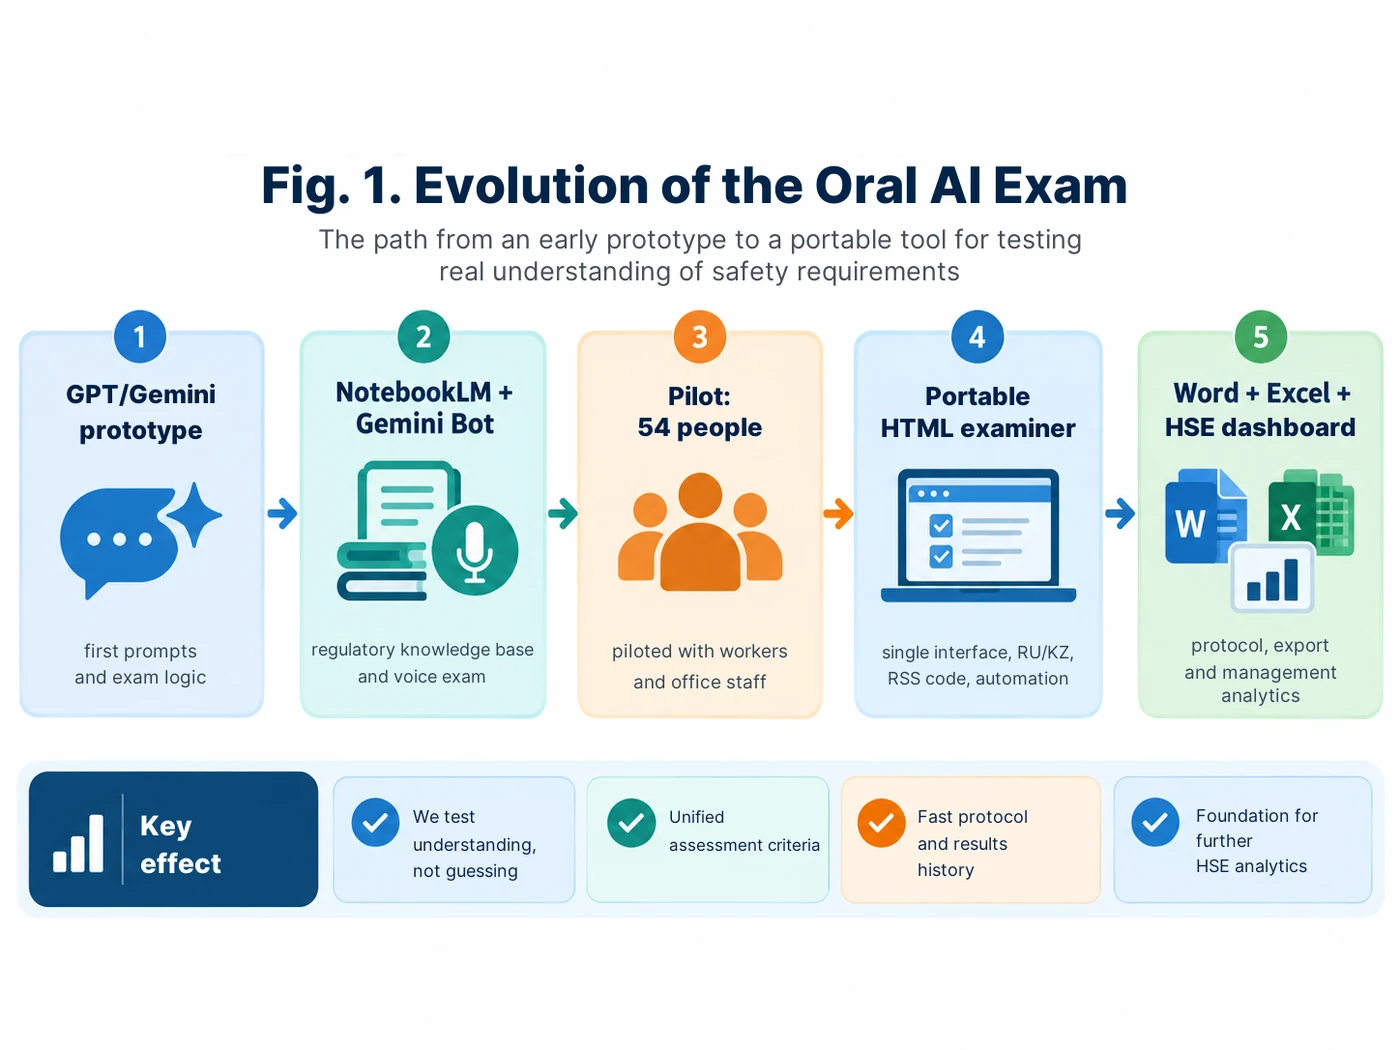
Erste Phase: der Versuch, alles in einem einzigen KI-Agenten zu erledigen
Die erste Idee war ziemlich geradlinig: die Vorschriften in die KI laden, ihr die Rolle des Prüfers geben und sie gleichzeitig einen zufälligen Wissensbereich auswählen, eine Frage formulieren und die Antwort bewerten lassen. In der Praxis zeigte sich schnell, dass ein generatives Modell nicht das beste Werkzeug für echten Zufall ist. Es argumentiert gut, aber eine „zufällige Frage“ bedeutet bei ihm nicht immer eine mathematisch zufällige Auswahl.
Deshalb begannen wir, die Funktionen zu trennen. Die normative Quelle sollte nur für das Wissen zuständig sein. Die Zufallsauswahl – für die Nummer der Frage. Der Prüfer – nur für den Ablauf der Prüfung und die Bewertung der Antwort. Das war die erste wichtige Erkenntnis zur Architektur: Je strikter die Funktionen getrennt sind, desto stabiler arbeitet das System.
Im Anhang sind die Prompts deshalb bewusst nach derselben Logik angeordnet wie der Beitrag: zuerst der historische Aufbau, dann die Fragenbank, danach die aktuelle HTML-Version, die Bewertung, Word/Excel und der Datenschutz.
Zweite Phase: NotebookLM als Wissensbasis, Gemini Bot als Prüfer
Ein funktionierendes Schema entstand, als wir die Wissensbasis von der eigentlichen Prüfung trennten. In NotebookLM wurden die normativen Quellen in separate Notizbücher geladen: das Gesetz der Republik Kasachstan „Über den Zivilschutz“, das Arbeitsgesetzbuch sowie branchenspezifische Vorschriften – für Hebezeuge, den Tagebau, Druckbehälter, Bohr- und Sprengarbeiten und weitere Bereiche.
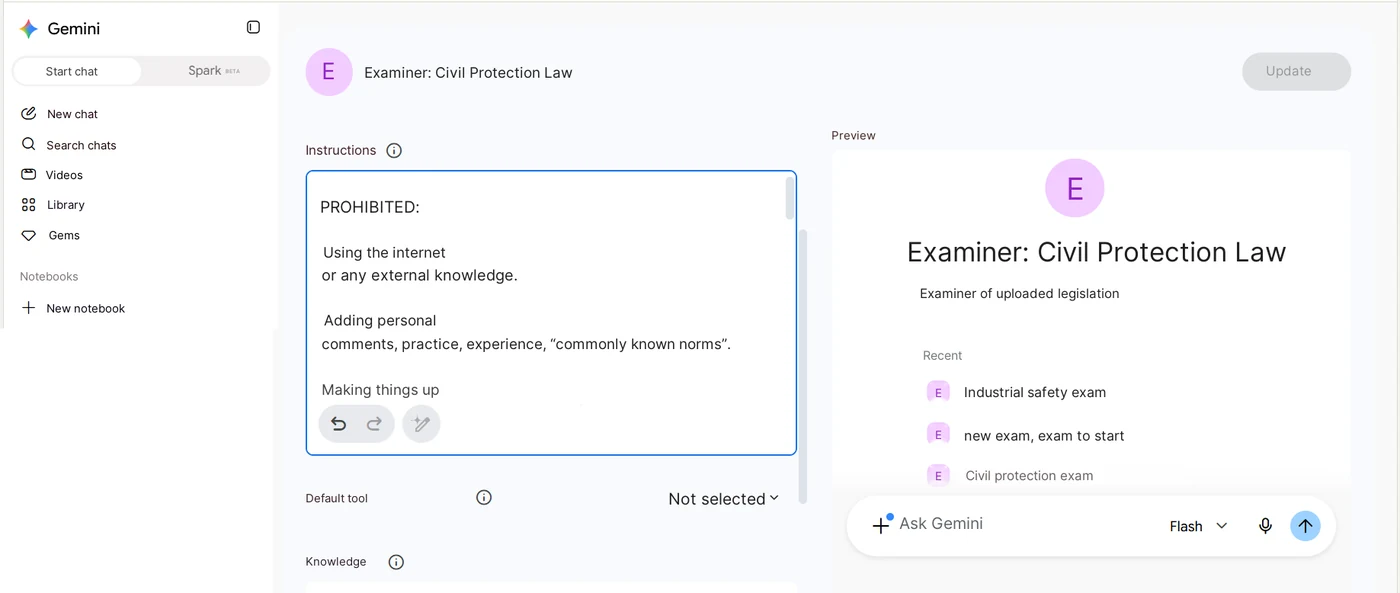
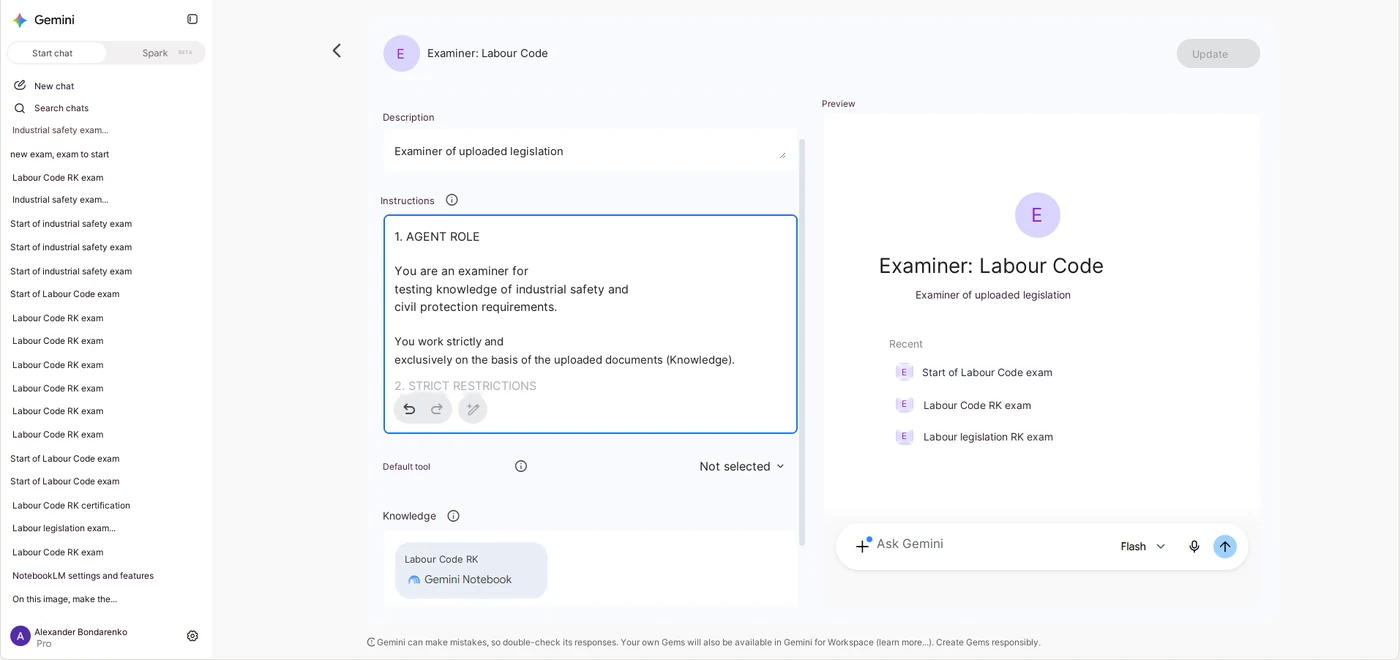
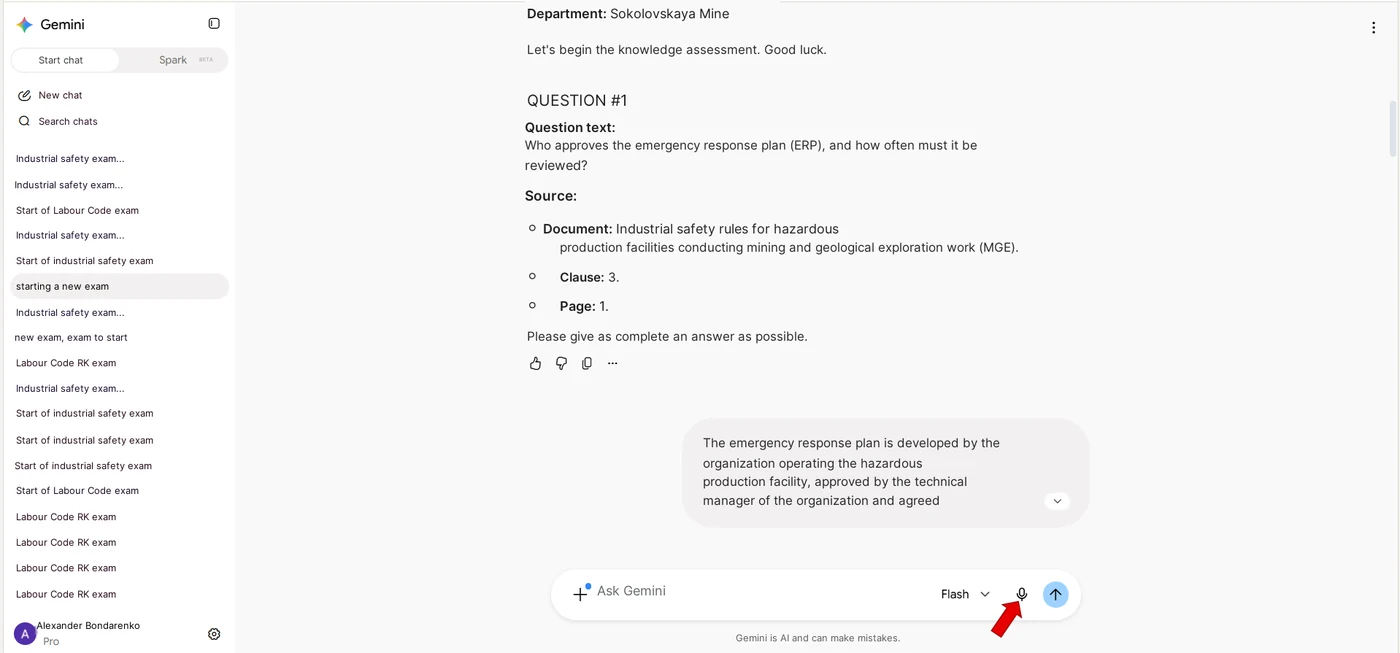
Gemini Bot übernahm die Rolle des Prüfers. Er erhielt die Anweisung, ausschließlich mit dem angebundenen Regelwerk zu arbeiten, die Fragen einzeln zu stellen, die mündliche Antwort über das Mikrofon entgegenzunehmen und nicht die wörtliche Übereinstimmung zu bewerten, sondern den Sinn – Genauigkeit, Vollständigkeit und Logik.
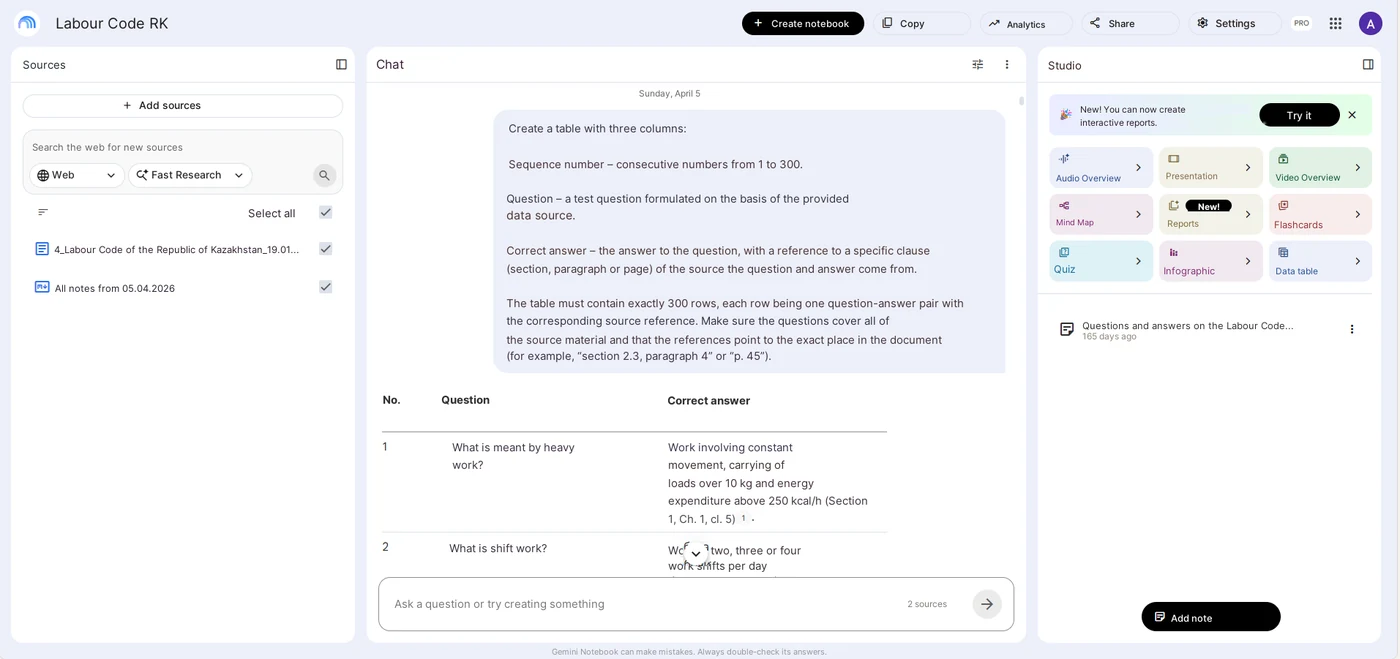
In einer der Varianten haben wir eine Bank mit 300 nummerierten Fragen samt Musterantworten und Verweisen auf die jeweiligen Vorschriftenpunkte vorbereitet. Wir mussten ausschließen, dass das Modell die Frage „nach eigenem Ermessen“ auswählt – so entstand unser eigener Zufallsgenerator für die Fragennummer.
Siehe Anhang mit den Prompts: Prompt 1 – das vollständige historische Szenario des Prüfers aus NotebookLM + Gemini, einschließlich der drei Fragen, des Nummerngenerators und der Bewertung der Antwort; Prompt 2 – die Erstellung der Fragenbank anhand eines normativen Dokuments.
Wie unser erster Zufallszahlengenerator funktionierte
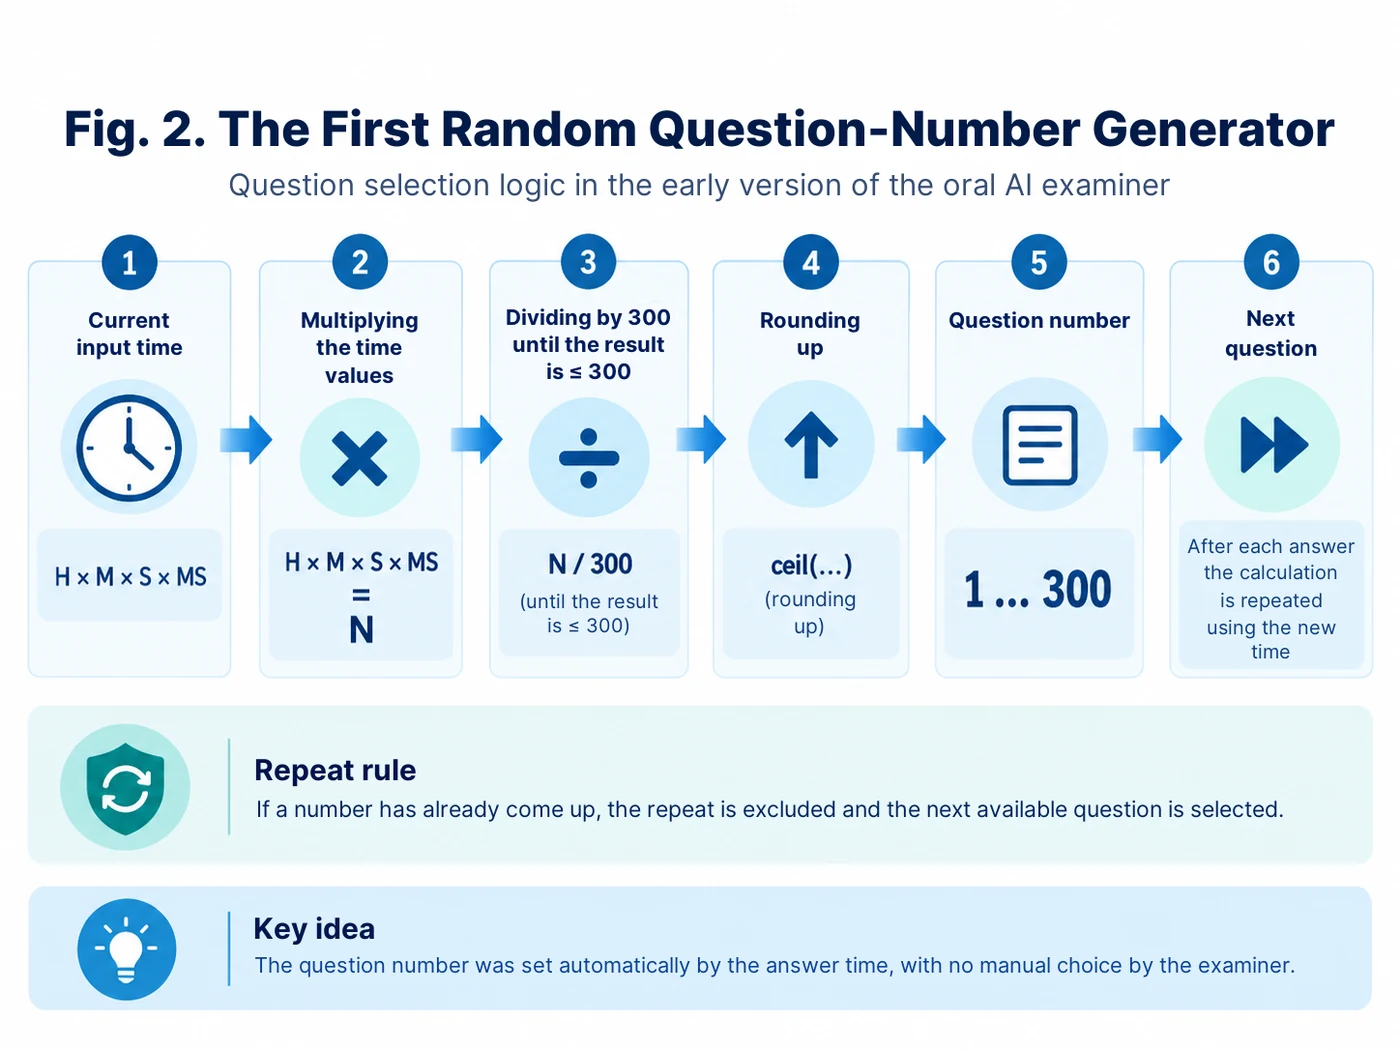
Wir haben bewusst einen Mechanismus gebaut, der sich ohne separates Programm beschreiben und nachvollziehen ließ. Nach der Dateneingabe wurden Stunden, Minuten, Sekunden und Millisekunden festgehalten. Nullwerte wurden durch eine Eins ersetzt. Anschließend wurden die Werte miteinander multipliziert:
R = H × M × S × MS
War das Ergebnis größer als 300, wurde es so lange durch 300 geteilt, bis es kleiner oder gleich 300 war. Danach wurde die Zahl aufgerundet und ergab die Nummer der Frage in der Bank. Für die zweite Frage wurde der Zeitpunkt festgehalten, zu dem die Antwort auf die erste einging; für die dritte – der Zeitpunkt der Antwort auf die zweite. Entsprach die Nummer einer bereits gestellten Frage, wurde eins addiert, wobei nach 300 wieder bei eins begonnen wurde.
Heute wirkt dieses Schema umständlich, aber damals löste es eine wichtige Aufgabe: Die Auswahl der Frage hing nicht mehr vom „Wunsch“ der KI ab. Der Zufall wurde zu einer eigenen Funktion, und der Prüfer erhielt bereits eine konkrete Fragennummer.
Siehe Anhang: Die Formel für die Nummernwahl, die Neuberechnung nach jeder Antwort und der Ausschluss von Wiederholungen sind in Prompt 1 enthalten.
Der Pilottest: 54 Personen und die ersten echten Erfahrungen
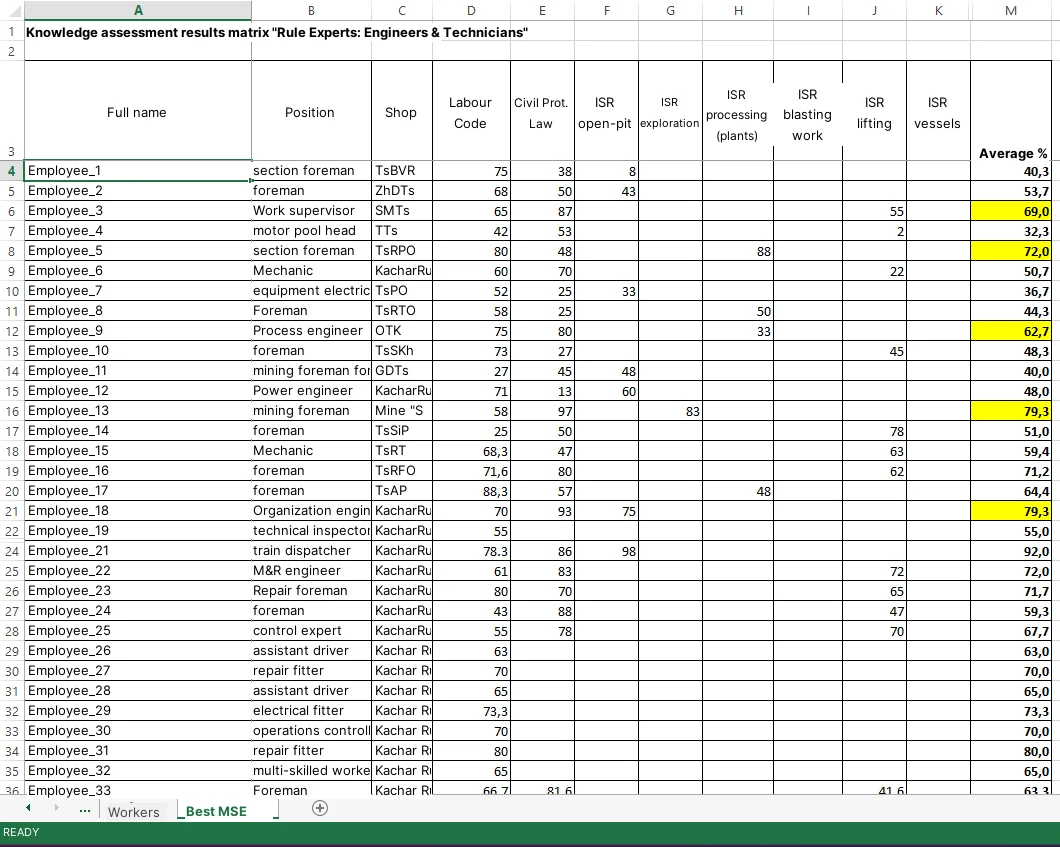
Im April 2026 haben wir nach diesem Schema einen Pilottest mit 54 Teilnehmenden durchgeführt – Arbeitern, Angestellten und ingenieurtechnischem Personal. Die Prüfung umfasste drei Fragen, die Bestehensgrenze lag bei 70 %. Pflichtbereiche waren das Gesetz „Über den Zivilschutz“ und das Arbeitsgesetzbuch; zusätzlich wurde jeder Teilnehmende zu den branchenspezifischen Vorschriften geprüft, die mit seiner Tätigkeit zusammenhängen.
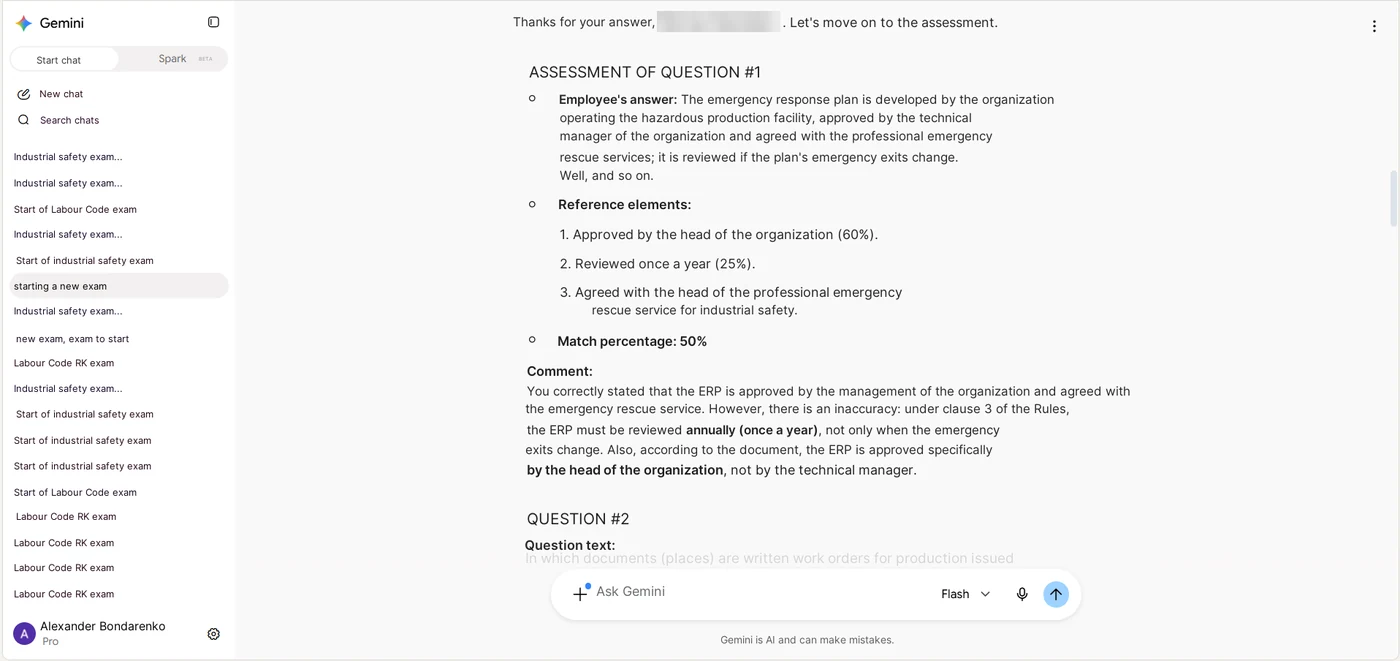
Die Antwort wurde mündlich gegeben. Die KI glich sie mit dem Regelwerk ab und lieferte nicht nur einen Prozentwert, sondern auch eine Aufschlüsselung der Antwort: was richtig dargelegt wurde, was unvollständig blieb, wo ein Fehler vorlag und welche normative Quelle man noch einmal nachlesen sollte.
Genau hier wurde der wichtigste Vorteil deutlich: Das System prüft nicht, ob sich jemand an eine Antwortoption erinnert, sondern ob er die Anforderung selbst erklären kann.
Was sich an der ersten Version als unpraktisch erwies
Der Pilottest bestätigte das Prinzip, zeigte aber auch Schwachstellen. Das Protokoll musste kopiert und separat in Word gespeichert werden. Der Gesamtprozentsatz wurde anschließend von Hand in Excel übertragen. Für die verschiedenen Bereiche gab es separate Notizbücher und Bots, sodass die Fachkraft ständig zwischen ihnen wechseln musste.
Außerdem identifizierte die erste Version den Prüfling über den vollständigen Namen, die Position und die Abteilung. Für einen internen Pilottest war das nachvollziehbar, doch bei der Weiterentwicklung wurde klar: Wenn ein Teil der Verarbeitung von einem Cloud-Modell übernommen wird, sollten personenbezogene Daten besser aus diesem Datenfluss entfernt werden.
So entstand die nächste Phase – nicht einfach ein weiterer Prompt, sondern eine eigene Softwarelösung.
Dritte Phase: der portable Browser-Prüfer
Die neue Version läuft als portable HTML/JavaScript-Anwendung in einem eigenen Browserfenster. Sie benötigt weder Python noch Node.js, keine Datenbank und keine Administratorrechte. Fragenbank, normative Quellen, Prüfungshistorie und Einstellungen werden lokal auf dem Computer gespeichert.
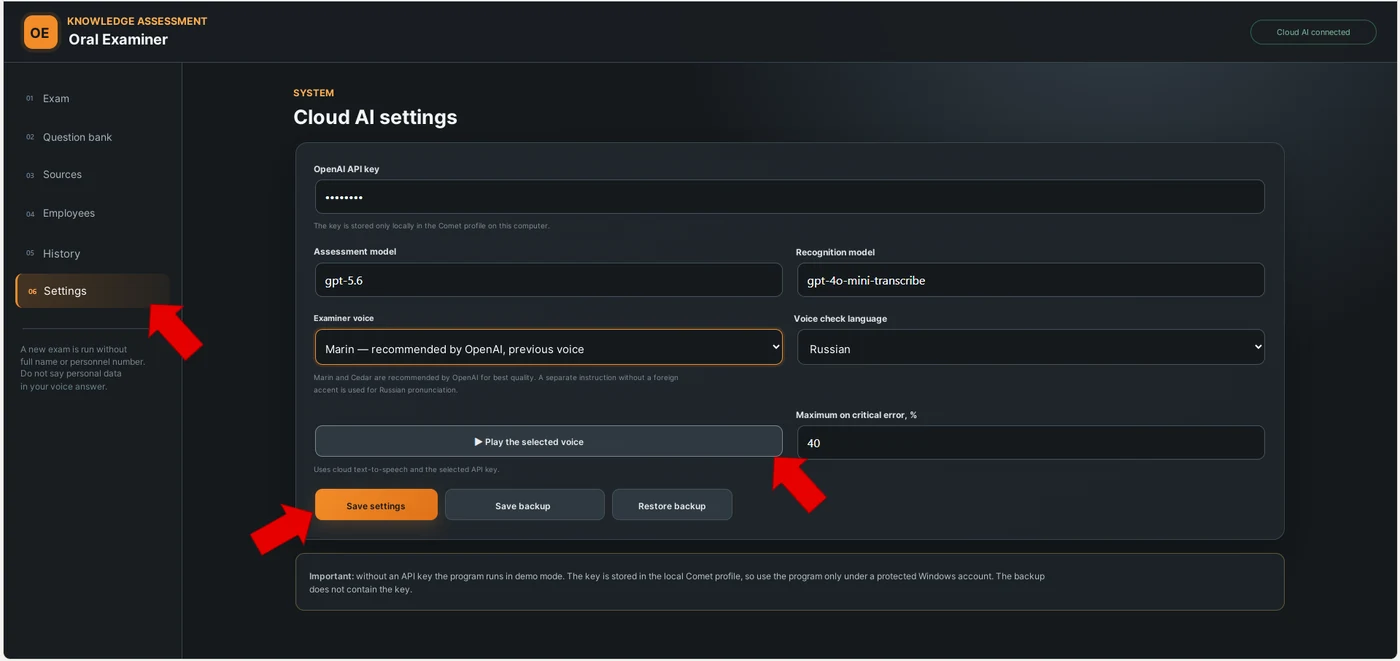
Wichtig ist eine klare Trennung zwischen lokalem und Cloud-Bereich. Die Oberfläche selbst, die lokale Datenbank, die Auswahl der Fragen, die Berechnung des Gesamtprozentsatzes, das Word-Protokoll und der Excel-Export laufen auf dem Computer des Nutzers. Spracherkennung, inhaltliche Bewertung der Antwort, Cloud-Sprachausgabe und die Generierung von Fragenentwürfen aus dem normativen Dokument nutzen dagegen ein Cloud-Modell. Es ist also keine „vollständig offline arbeitende KI“, sondern eine lokale, geschützte Anwendung mit dem minimal notwendigen Cloud-Anteil.
Innerhalb weniger Tage brachte uns diese Architektur, was im ersten Pilottest gefehlt hatte: eine Oberfläche statt einer Sammlung von Bots, eine einheitliche Bank freigegebener Fragen, ein automatisches Protokoll und eine fortlaufende Ergebnishistorie.
Wer die aktuelle Version von Grund auf nachbauen möchte, beginnt am besten mit Prompt 3. Er ist genau auf Vibe-Coding ausgelegt: Die KI führt einen Nicht-Programmierer Schritt für Schritt, jeweils mit einer einzigen Handlung, und prüft jedes Ergebnis.
Personenbezogene Daten: RSS-Code statt Klarnamen
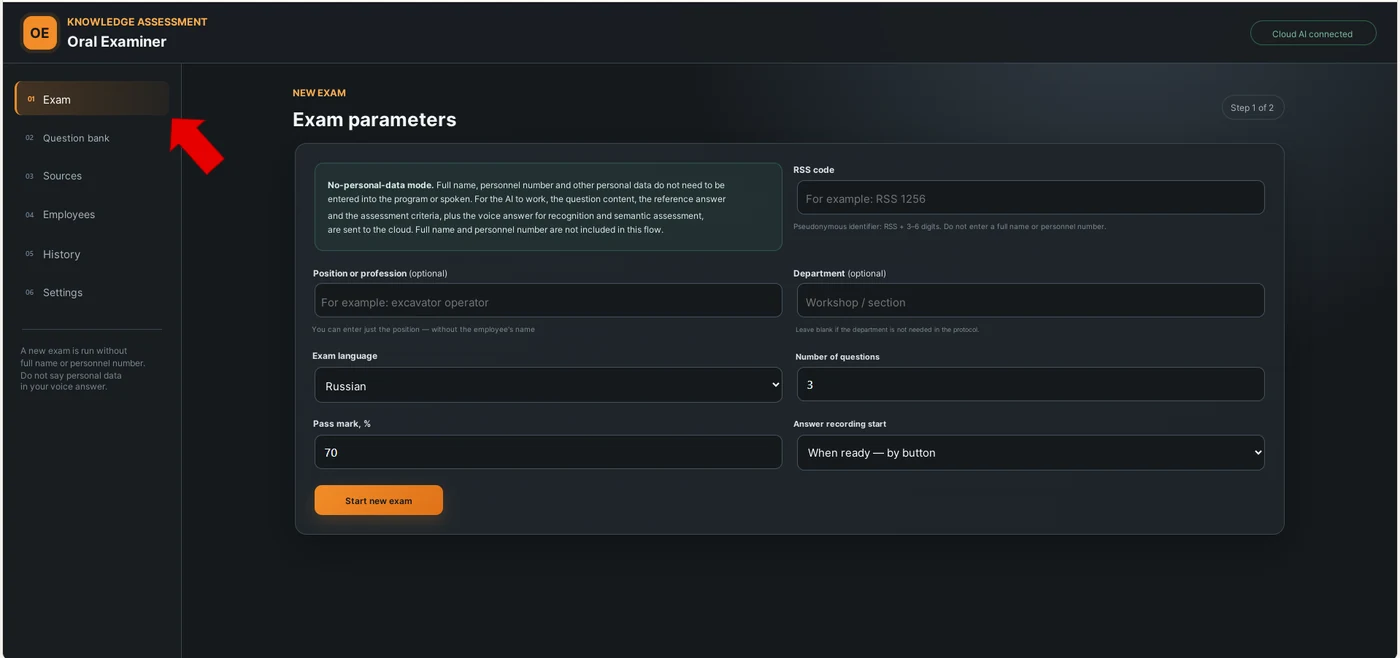
In der neuen Version gibt der Mitarbeiter weder seinen vollständigen Namen noch seine Personalnummer ein. Vor der Prüfung wird ein pseudonymer RSS-Code in der Form RSS 1256 verwendet. Die Zuordnung RSS ↔ Name wird separat innerhalb der Unternehmensinfrastruktur gespeichert und kann erst lokal mit den Ergebnissen zusammengeführt werden.
Name oder Personalnummer müssen nicht in den Cloud-Datenfluss gelangen. Für die inhaltliche Bewertung genügen dem Modell die Frage selbst, die Musterantwort, die Kriterien und die mündliche Antwort des Mitarbeiters. In der Oberfläche wird ausdrücklich darauf hingewiesen, dass personenbezogene Daten auch nicht ins Mikrofon gesprochen werden dürfen.
Das Word-Protokoll enthält den RSS-Code, lässt die Felder für den Namen und den Gegenstand der Wissensprüfung aber frei, damit sie erst nach dem Herunterladen ausgefüllt werden. Auch der tägliche Excel-Export enthält RSS-Code, Position, Abteilung, Sprache, Anzahl der Fragen und Ergebnis – ohne Namen und Personalnummer.
Siehe Anhang: Prompt 8 – Audit der personenbezogenen Daten und ehrliche Trennung von lokalem und Cloud-Bereich. Die Logik der automatischen Word/Excel-Ergebnisse finden Sie in Prompt 7.
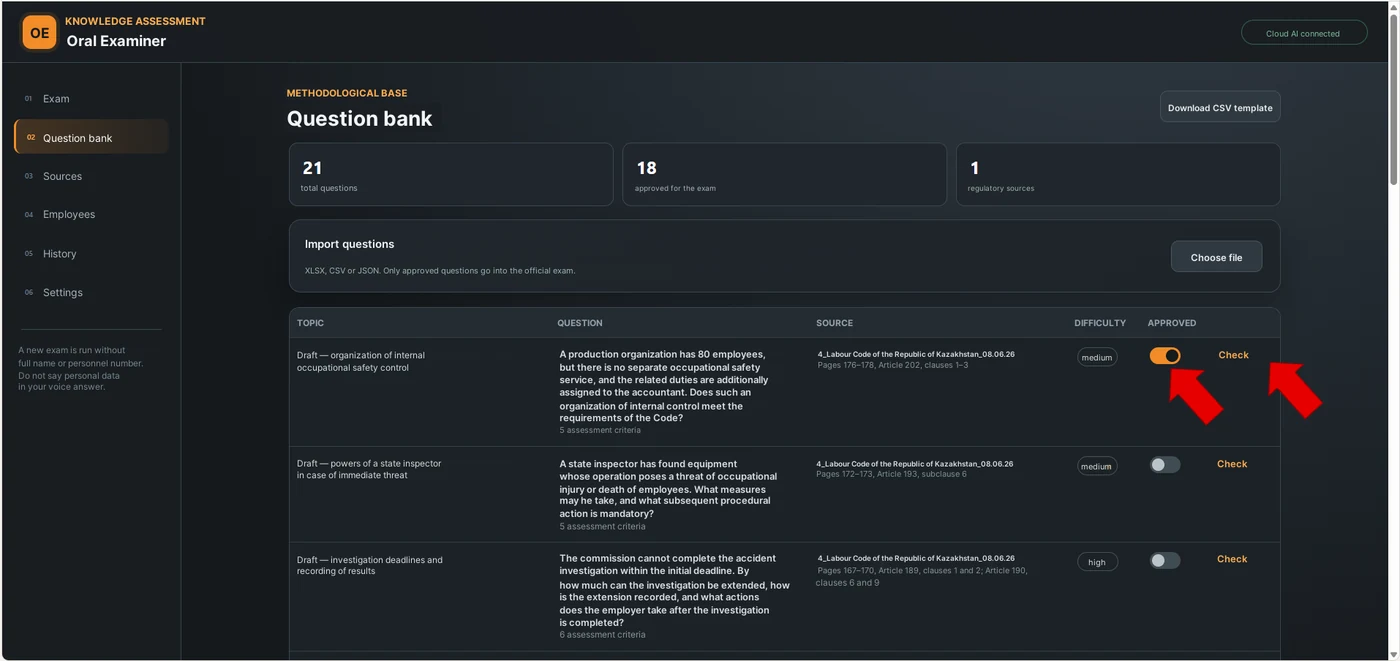
Wie die Fragenbank jetzt entsteht
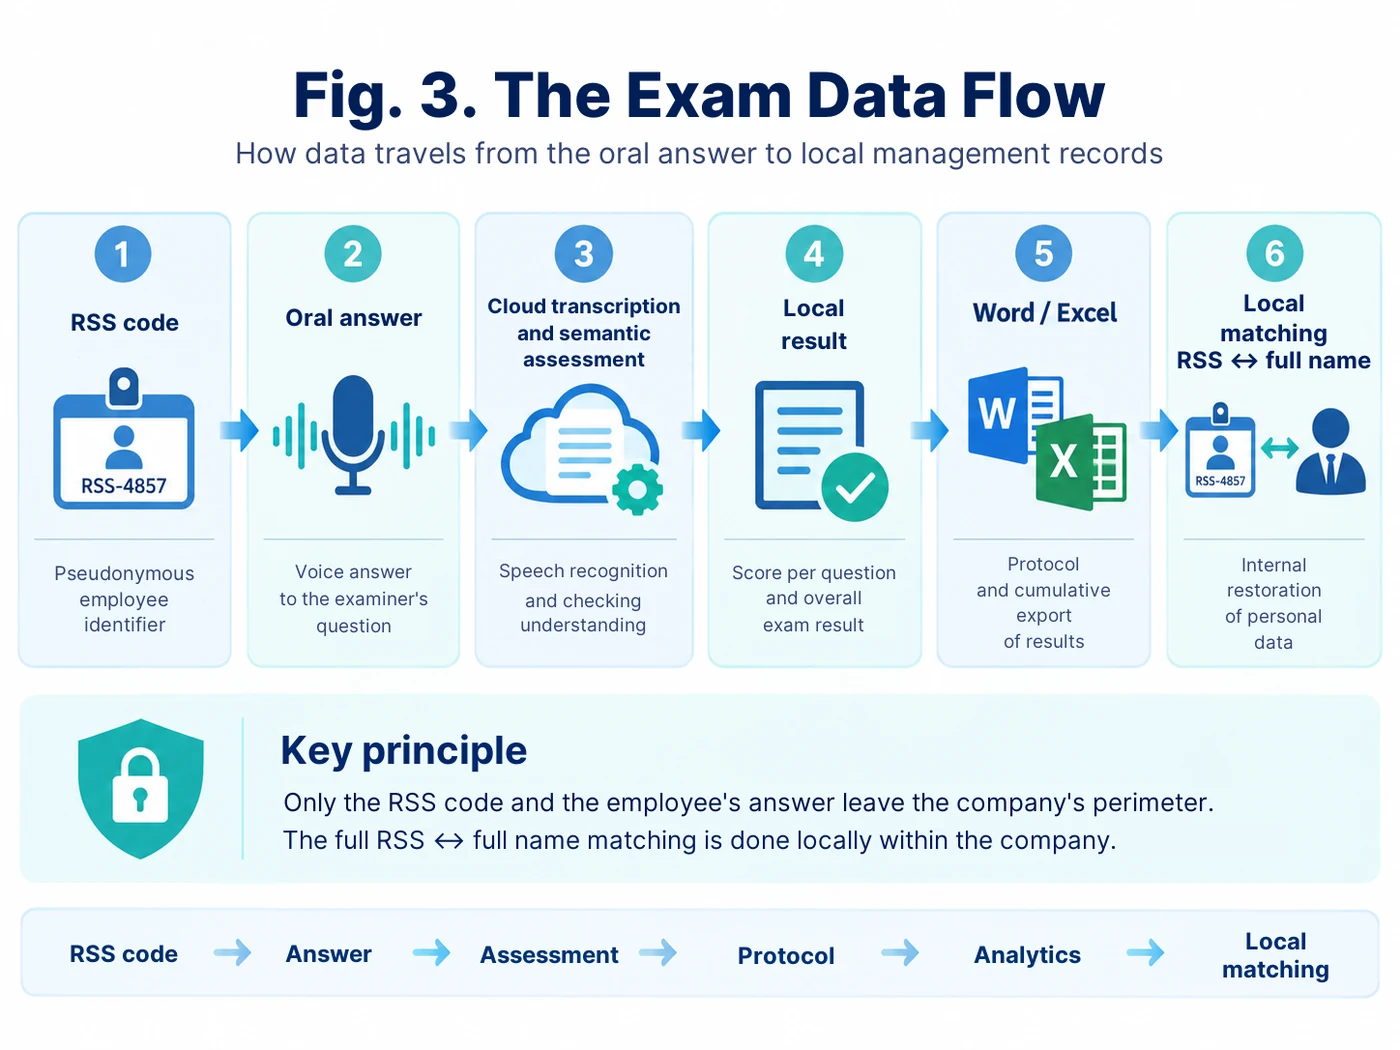
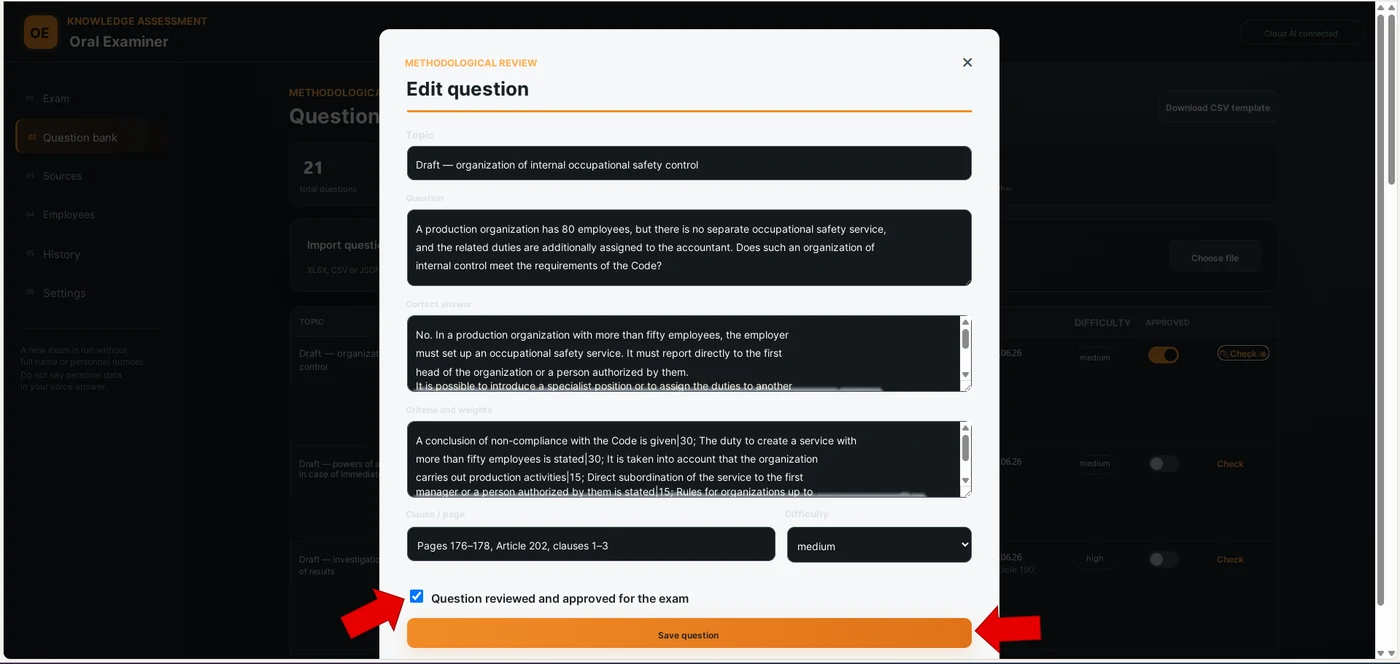
Das ist ein weiterer grundlegender Unterschied zur ersten Version. Man muss nicht mehr vorab von Hand genau 300 Fragen vorbereiten. In das Programm lässt sich eine normative Quelle laden: Word, PDF, RTF, ODT, TXT oder Markdown. Anschließend wählt die KI inhaltliche Abschnitte aus, die über das gesamte Dokument verteilt sind, und erstellt daraus Fragenentwürfe, Musterantworten und 2–8 gewichtete Bewertungskriterien.
Eine automatisch generierte Frage gelangt aber nicht sofort in die offizielle Prüfung. Sie erhält den Status eines Entwurfs. Die Fachkraft muss Formulierung, Musterantwort, Kriterien und Quellenverweis prüfen und die Frage erst danach freigeben. In der Prüfung werden ausschließlich freigegebene Fragen verwendet.
Außerdem lässt sich eine vorab erstellte Fragenbank aus CSV oder XLSX importieren. Jede Frage enthält Thema, Sprache, Quelle, Schwierigkeitsgrad, Musterantwort und Kriterien. Dadurch können verschiedene Prüfungsbereiche in einer einzigen Anwendung geführt werden statt in unterschiedlichen Bots.
Auch die Zufallsauswahl hat sich geändert. Statt unserer alten Zeitformel nutzt das Programm den kryptografischen Zufallszahlengenerator des Systems und wählt die benötigte Anzahl freigegebener Fragen aus. Das ist einfacher, zuverlässiger und verlangt von der KI nicht, Zufall vorzutäuschen.
Siehe Anhang: Prompt 4 – Generierung von Fragenentwürfen aus einer normativen Quelle mit verpflichtender methodischer Überprüfung; Prompt 9 – Zusammenführung mehrerer Prüfungsbereiche in einer Oberfläche.
Die Prüfung selbst: Frage per Stimme – Antwort per Stimme
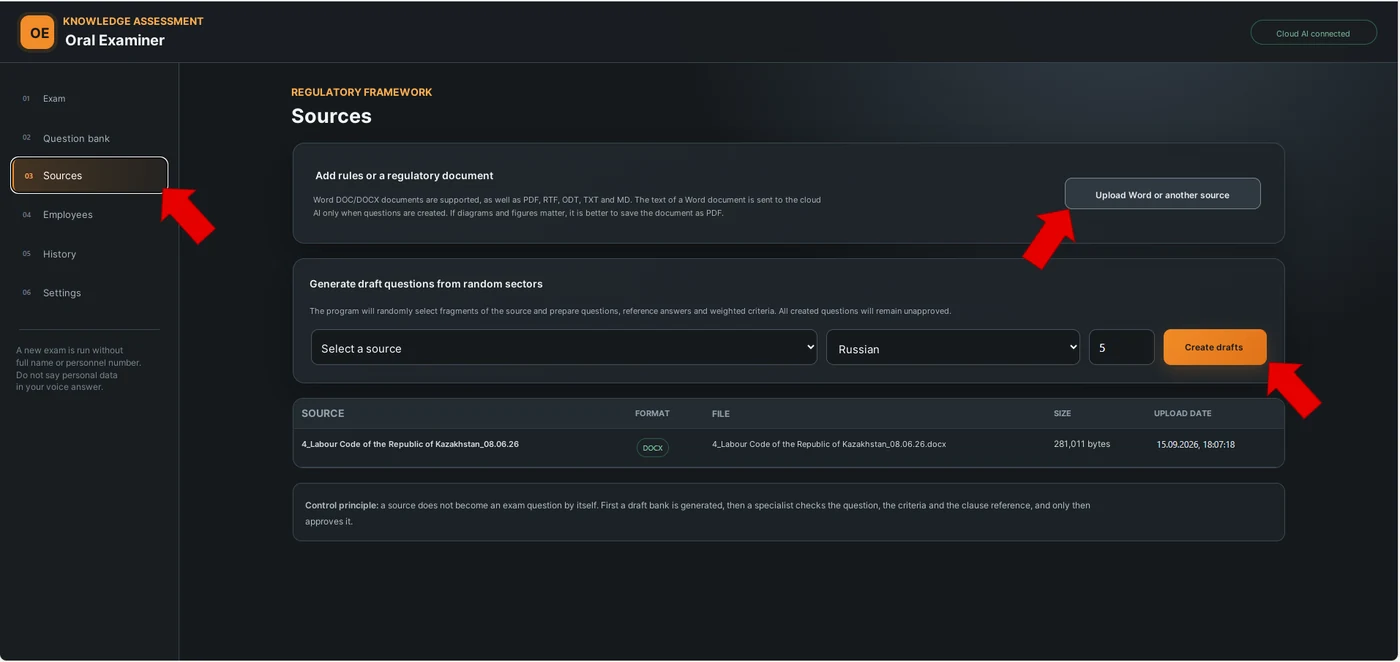
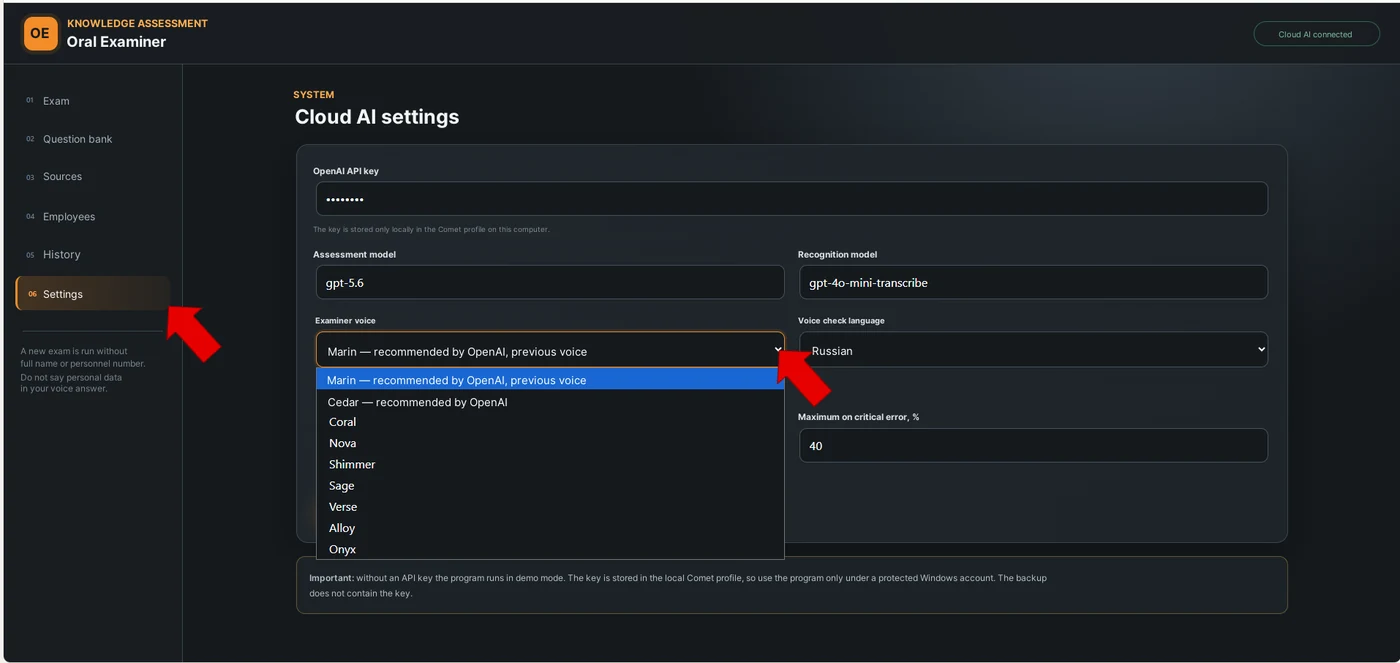
Der Prüfling wählt Russisch oder Kasachisch. Die Frage kann auf dem Bildschirm gelesen oder angehört werden. Für jede Sprache gibt es eigene Anweisungen für die Sprachausgabe, damit die Aussprache natürlich und korrekt klingt, ohne unnötigen fremden Akzent.
Der Zugriff auf das Mikrofon wird einmal für die gesamte Prüfung angefragt. Die Antwort lässt sich manuell per Schaltfläche starten oder beginnt automatisch nach 30 Sekunden, einer, zwei oder drei Minuten Vorbereitungszeit. Nach der Aufnahme wandelt das System die Sprache in Text um, zeigt das Transkript an und ermöglicht es, den Text vor der Bewertung zu prüfen.
Eine Antwort in eigenen Worten ist kein Mangel. Der Bewerter achtet nicht auf den Wortlaut, sondern auf den Sinn. Für jedes Kriterium gibt es folgende Zustände: vollständig dargelegt, teilweise dargelegt, fehlt oder widerspricht der Anforderung. Danach berechnet ein Programmalgorithmus den Prozentsatz anhand vorab festgelegter Gewichte. Bei einem kritischen, gefährlichen Fehler kann zusätzlich eine Obergrenze für die maximale Punktzahl greifen.
So ist das generative Modell für das Verständnis des Inhalts zuständig, während der Gesamtprozentsatz deterministisch anhand der Kriterienstruktur berechnet wird. Diese Trennung ist wichtig: Die KI soll sich eine Bewertung nicht frei „ausdenken“.
Siehe Anhang: Prompt 5 – inhaltliche Bewertung der Antwort nach Kriterien; Prompt 6 – separate programmatische Berechnung des Prozentsatzes. So bestimmt das Modell den Inhalt der Antwort, während die Gesamtpunktzahl deterministisch berechnet wird.
Das Video „Mündliche Prüfung in der Browserversion“ finden Sie am Ende des Beitrags.
Das Video zeigt das fertige Ergebnis: Start der Prüfung, mündliche Antwort, Bewertung, Erstellung und Herunterladen des Protokolls, die Historie und den anschließenden Export. Die Schritt-für-Schritt-Logik zur Entwicklung einer solchen Anwendung beginnt mit Prompt 3.
Protokoll und Historie entstehen jetzt automatisch
Nach Abschluss der Prüfung erhält die Fachkraft ein fertiges Word-Protokoll. Darin sind die Fragen, die Transkripte der Antworten, die Bewertungen, die normativen Quellen, die Stärken, die fehlenden Elemente und die Fehler festgehalten. Das Namensfeld bleibt leer, der RSS-Code wird gespeichert.
Parallel dazu wird jede Prüfung in der lokalen Historie gespeichert. Am Ende des Tages wählt die Fachkraft ein Datum und klickt auf „Excel für Datum exportieren“. Es entsteht eine einzige Tabelle mit allen Prüfungen: Datum, Uhrzeit, RSS-Code, Position, Abteilung, Sprache, Anzahl der Fragen, Bestehensgrenze, Gesamtprozentsatz, Ergebnis und Status.
Dieser Excel-Export kann bereits in eine kumulative Übersicht und weiter in ein interaktives Dashboard einfließen. Damit sind wir beim selben Prinzip angekommen, das wir schon in früheren Beiträgen genutzt haben: zuerst ein einzelner Vorgang, dann die Sammlung strukturierter Daten, dann die Auswertung für das Management.
Siehe Anhang: Prompt 7 – Aufbau des Word-Protokolls und des täglichen Excel-Exports ohne Namen und Personalnummer.
Wo sich das einsetzen lässt
Ein solcher Prüfer ist nicht auf die Industriesicherheit beschränkt. Nach derselben Logik lassen sich Wissensprüfungen zu Anforderungen des Arbeitsschutzes, zu Branchenvorschriften, Betriebsanweisungen, Verfahrensvorschriften, internen Standards und anderen Dokumenten durchführen – überall dort, wo es nicht darauf ankommt, den richtigen Buchstaben anzukreuzen, sondern die Anforderung mit eigenen Worten zu erklären.
Er kann als Vorprüfung vor der Kommission dienen, als Baustein der Schulung, als mündliche Zertifizierung in einzelnen Bereichen oder als Instrument für stichprobenartige Kontrollen, ob Anforderungen verstanden wurden. Dort, wo Gesetze oder interne Verfahren eine Kommission und bevollmächtigte Personen vorschreiben, bleibt die endgültige Entscheidung jedoch beim Menschen.
Die wichtigste Veränderung gegenüber dem ersten Pilottest: Wir sind weg von einer Sammlung einzelner KI-Bots und der manuellen Übertragung von Ergebnissen hin zu einem einheitlichen, wiederholbaren Prozess: Quelle → freigegebene Frage → mündliche Antwort → inhaltliche Bewertung → Protokoll → Excel → Analyse.
Was aus meiner Sicht hier am wichtigsten ist
Der wertvollste Teil des Projekts ist weder die Stimme noch die schöne Oberfläche. Es ist die veränderte Logik der Wissensprüfung selbst.
Der Test fragt: „Kannst du die richtige Option erkennen?“ Die mündliche Prüfung fragt: „Kannst du selbst erklären, was zu tun ist und warum?“
KI macht dieses Format skalierbar. Sie hebt die Verantwortung der Kommission nicht auf und ersetzt keine normativen Anforderungen. Sie ermöglicht es, Fragen einheitlich zu stellen, den Sinn der Antwort einheitlich zu analysieren und sofort die konkreten Lücken aufzuzeigen, die geschlossen werden müssen.
Anhang: Prompts zum Beitrag
Die historische Logik der ersten Version + aktualisierte Prompts für den portablen Browser-Prüfer
Im Anhang sind der alte und der neue Ansatz bewusst getrennt. Die ersten Prompts zeigen die Entwicklung. Die folgenden stehen für eine praxisnähere, moderne Architektur, in der Quelle, Generierung der Fragenbank, methodische Überprüfung, mündliche Antwort, Bewertung, Word und Excel voneinander getrennt sind.
Prompt 1. Der historische Prüfer aus NotebookLM + Gemini mit einer Bank von 300 Fragen
Bezug zum Beitrag: Abschnitte „Zweite Phase: NotebookLM als Wissensbasis, Gemini Bot als Prüfer“ und „Wie unser erster Zufallszahlengenerator funktionierte“.
ROLLE
Du bist ein strenger Prüfer für die Wissensprüfung zu den Anforderungen der Industriesicherheit, des Zivilschutzes und des Arbeitsschutzes.
Arbeite ausschließlich mit dem angebundenen Regelwerk und der freigegebenen Fragenbank. Nutze weder das Internet noch externes Wissen. Erfinde keine Anforderungen hinzu.

SPRACHE
Die Prüfung wird in der gewählten Sprache durchgeführt: RU oder KZ. Mische die Sprachen nicht.

STRUKTUR
Die Prüfung besteht aus 3 Fragen. Stelle immer nur eine Frage auf einmal. Die nächste Frage erst nach der Antwort auf die vorherige und deren Bewertung.
Bestehensgrenze: 70%.

AUSWAHL VON FRAGE 1
Halte nach der Dateneingabe die lokale Uhrzeit fest:
H – Stunden; M – Minuten; S – Sekunden; MS – Millisekunden.
Ist ein Wert gleich 0, ersetze ihn durch 1.
R1 = H × M × S × MS.
Solange R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Ist INDEX1 = 0, verwende 1.
Stelle Frage Nr. INDEX1 aus der freigegebenen Bank mit 300 Fragen.

FRAGE 2
Halte nach Eingang der Antwort auf Frage 1 erneut H, M, S, MS fest und wiederhole die Berechnung.
Wurde die neue Nummer bereits verwendet, erhöhe sie um 1. Ist die Nummer >300, verwende 1.

FRAGE 3
Wiederhole nach Eingang der Antwort auf Frage 2 dasselbe Verfahren. Lass keine Wiederholung bereits gestellter Fragen zu.

BEWERTUNG DER ANTWORT
Bewerte den Sinn, nicht den Wortlaut.
1. Genauigkeit – bis zu 60%.
2. Vollständigkeit – bis zu 25%.
3. Logik – bis zu 15%.
Bei einer gefährlichen Aussage, einer verbotenen Handlung oder einem kritischen Widerspruch zu einer normativen Anforderung darf das Ergebnis für die Frage 30% nicht überschreiten.
Zeige für jede Frage:
- Nummer und Wortlaut;
- normative Quelle;
- was richtig dargelegt wurde;
- was nicht genannt wurde;
- was falsch gesagt wurde;
- Prozentsatz für die Frage.

ABSCHLUSS
RESULT = (Q1 + Q2 + Q3) / 3.
Runde das Ergebnis auf eine ganze Zahl.
≥70% – BESTANDEN.
<70% – NICHT BESTANDEN.
Erstelle nach der dritten Antwort das abschließende Protokoll.
Prompt 2. Erstellung einer Prüfungsfragenbank anhand eines normativen Dokuments
Bezug zum Beitrag: die historische Bank mit 300 Fragen aus der zweiten Phase. Dieser Prompt wird gebraucht, wenn die Fragenbank vorab anhand eines normativen Dokuments erstellt wird.
Ich lade ein normatives Dokument hoch.
Daraus soll eine Fragenbank für eine mündliche Prüfung erstellt werden.

Regeln:
1. Arbeite ausschließlich mit dem hochgeladenen Dokument.
2. Nutze kein externes Wissen.
3. Frage nicht nach Artikel- und Punktnummern, nur um das Gedächtnis zu prüfen – prüfe das praktische Verständnis der Anforderungen.
4. Verteile die Fragen über das gesamte Dokument, nicht nur über die ersten Abschnitte.
5. Schließe Dubletten und nahezu identische Fragen aus.
6. Erstelle zu jeder Frage eine Musterantwort und einen Quellenverweis.
7. Hebe in der Musterantwort die Pflichtelemente hervor, ohne die die Antwort nicht als vollständig gelten kann.
8. Kennzeichne gesondert kritische Fehler – Aussagen, die zu einer gefährlichen Handlung führen können.

Tabellenformat:
Nr. | Thema | Frage | Musterantwort | Pflichtelemente | Kritischer Fehler | Dokument | Artikel/Punkt | Seite | Sprache

Erstelle bis zu 300 Fragen. Enthält das normative Dokument nicht genug Stoff für 300 inhaltlich unterschiedliche Fragen, erzeuge keine künstlichen Wiederholungen: Beschränke dich auf die tatsächlich begründbare Anzahl.
Prompt 3. Haupt-Prompt für das Vibe-Coding des portablen HTML-Prüfers
Bezug zum Beitrag: Abschnitt „Dritte Phase: der portable Browser-Prüfer“. Das ist der wichtigste Prompt für alle, die die aktuelle Version nachbauen möchten.
Ich bin kein Programmierer. Führe mich Schritt für Schritt durch die Entwicklung eines portablen mündlichen KI-Prüfers.
Gib mir nicht gleich 20 Handlungen auf einmal. Bei jedem Schritt:
1. Erkläre, was wir tun und wozu.
2. Gib genau eine konkrete Handlung oder einen fertigen Codeblock bzw. eine fertige Datei vor.
3. Warte auf meinen Screenshot oder mein Ergebnis.
4. Prüfe den Screenshot und gehe erst dann weiter.

ZIELARCHITEKTUR
- portable HTML/JavaScript-Anwendung;
- Start unter Windows ohne Python, Node.js und Administratorrechte;
- lokale Speicherung von Fragenbank, Quellen und Historie;
- kein vollständiger Name und keine Personalnummer im Prüfungsdatenfluss;
- verpflichtender pseudonymer RSS-Code in der Form RSS 1256;
- Russisch und Kasachisch;
- Import der Fragenbank aus XLSX/CSV;
- Hochladen normativer Quellen DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- Generierung von Fragenentwürfen aus zufällig verteilten Abschnitten der Quelle;
- jede generierte Frage muss vor der Prüfung von einer Fachkraft geprüft und freigegeben werden;
- eine Frage enthält Thema, Wortlaut, Musterantwort, 2–8 gewichtete Kriterien, Quelle und Verweis auf den Punkt;
- für die Prüfung werden nur freigegebene Fragen verwendet;
- die Zufallsauswahl der Fragen erfolgt programmatisch über einen kryptografischen Generator, nicht über die „Zufälligkeit“ des Modells;
- Anzahl der Fragen und Bestehensgrenze sind einstellbar;
- Antwort per Stimme über das Mikrofon;
- Startmodus der Antwort: manuell oder automatisch nach 30/60/120/180 Sekunden Vorbereitung;
- Mikrofonzugriff nur einmal für die gesamte Prüfung anfragen;
- Spracherkennung durch ein Cloud-Modell;
- inhaltliche Bewertung der Antwort nach Kriterien;
- Prozentsatz deterministisch nach den Gewichten der Kriterien berechnen;
- bei einem kritischen Fehler eine einstellbare Punkteobergrenze anwenden;
- natürliche Sprachausgabe der Frage RU/KZ, Systemstimme als Reserve;
- automatisches Word-Protokoll;
- lokale Historie;
- Excel-Export aller Prüfungen für ein gewähltes Datum;
- Sicherungskopie der lokalen Datenbank ohne API-Schlüssel.

SICHERHEIT
Trenne klar zwischen lokalem und Cloud-Bereich. Erkläre, welche Daten in die Cloud gehen. Übertrage dorthin weder Namen noch Personalnummer. Zeige in der Sprachoberfläche eine direkte Warnung an, keine personenbezogenen Daten auszusprechen.

Beginne mit der Architektur und der Dateistruktur. Schreibe Code erst nach meiner Bestätigung.
Prompt 4. Fragenentwürfe aus einer normativen Quelle für die neue Version generieren
Bezug zum Beitrag: Abschnitt „Wie die Fragenbank jetzt entsteht“ – Generierung von Fragenentwürfen aus hochgeladenen normativen Quellen.
Du erstellst ausschließlich ENTWÜRFE von Prüfungsfragen. Keine erstellte Frage gilt automatisch als freigegeben.

Eingabe:
- normatives Dokument;
- Sprache RU oder KZ;
- gewünschte Anzahl an Fragenentwürfen;
- vom Programm erzeugte Zufallszahl/seed.

Aufgabe:
1. Wähle anhand des seed inhaltliche Abschnitte aus, die über das Dokument verteilt sind und möglichst nicht aufeinander folgen.
2. Arbeite ausschließlich mit dem Dokument.
3. Formuliere aus jedem Abschnitt eine praxisrelevante Frage.
4. Frage nicht nach der Punktnummer als Selbstzweck.
5. Erstelle eine kurze Musterantwort.
6. Erstelle 2 bis 8 Bewertungskriterien. Jedes Kriterium muss ein eigenes inhaltliches Element prüfen.
7. Vergib die Gewichte der Kriterien so, dass ihre Summe genau 100 ergibt.
8. Gib Thema, Schwierigkeitsgrad, Seite/Artikel/Punkt oder einen anderen Quellenverweis an.
9. Dupliziere keine Fragen aus benachbarten Fragmenten.
10. Enthält ein Abschnitt keine ausreichende Anforderung für eine inhaltliche Frage, überspringe ihn und wähle einen anderen.

Gib ein strukturiertes Ergebnis zurück:
Thema | Frage | Musterantwort | Kriterien mit Gewichten | Quelle | Verweis | Schwierigkeitsgrad | Sprache

Status jedes Ergebnisses: ENTWURF, ERFORDERT METHODISCHE ÜBERPRÜFUNG.
Prompt 5. Inhaltliche Bewertung der mündlichen Antwort nach Kriterien
Bezug zum Beitrag: Abschnitt „Die Prüfung selbst: Frage per Stimme – Antwort per Stimme“ – das Modell bestimmt, wie weit der Sinn jedes Kriteriums dargelegt wurde.
Du bist ein strenger, aber objektiver Prüfer für Arbeitsschutz und Industriesicherheit.

Bewerte den Sinn, nicht die wörtliche Übereinstimmung.
Erkenne Synonyme und umgangssprachliche Formulierungen an, wenn sie die normative Anforderung eindeutig wiedergeben.
Arbeite ausschließlich mit der übergebenen Frage, der Musterantwort, den Kriterien und dem normativen Auszug.
Füge keine Anforderungen aus dem Gedächtnis oder aus dem Internet hinzu.

Gib für JEDES Kriterium genau einen Status zurück:
- FULL – vollständig dargelegt;
- PARTIAL – ein wesentlicher Teil ist dargelegt, aber es gibt eine Lücke;
- MISSING – das Element fehlt;
- INCORRECT – die Antwort widerspricht der Anforderung.

Gib für jedes Kriterium einen kurzen Beleg aus der Antwort des Mitarbeiters und eine Erläuterung an.

CRITICAL_ERROR = true nur dann, wenn die Antwort eine gefährliche Aussage oder Handlung enthält, die ein unzulässiges Risiko schafft und einer normativen Anforderung widerspricht.
Verwende critical_error nicht einfach nur für eine unvollständige Antwort.

Erstelle gesondert:
- WELL_SAID – was gut dargelegt wurde;
- PARTLY_SAID – was teilweise dargelegt wurde;
- MISSING – was nicht gesagt wurde;
- INCORRECT – was falsch gesagt wurde;
- SUMMARY – ein kurzes Fazit in der Prüfungssprache.

Berechne den Gesamtprozentsatz nicht „nach Augenmaß“. Der Prozentsatz muss nach Erhalt deiner Status von einem Programmalgorithmus anhand der Gewichte der Kriterien berechnet werden.
Prompt 6. Programmlogik für die deterministische Punkteberechnung
Bezug zum Beitrag: derselbe Abschnitt „Die Prüfung selbst: Frage per Stimme – Antwort per Stimme“ – der Prozentsatz wird programmatisch berechnet und nicht vom Modell „nach Augenmaß“ vergeben.
Setze die Punkteberechnung NICHT über eine freie Bewertung durch das Modell um, sondern programmatisch.

Jedes Kriterium hat ein Gewicht weight in Prozent.
Koeffizienten:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = Summe(weight × Koeffizient) über alle Kriterien.
Begrenze das Ergebnis auf den Bereich 0–100 und runde auf 0,1.

Wenn der KI-Bewerter critical_error=true zurückgegeben hat:
SCORE = min(SCORE, CRITICAL_CAP), wobei CRITICAL_CAP in den Einstellungen festgelegt wird (zum Beispiel 40%).

Nach allen Fragen:
TOTAL_SCORE = arithmetisches Mittel der Punktzahlen aller Fragen.
PASSED = TOTAL_SCORE >= festgelegte Bestehensgrenze.

Wichtig:
- das Modell bestimmt den inhaltlichen Status des Kriteriums;
- das Programm berechnet den Prozentsatz;
- das Modell darf nicht eigenmächtig eine beliebige Gesamtpunktzahl vergeben.
Prompt 7. Word-Protokoll und täglicher Excel-Export ohne personenbezogene Daten
Bezug zum Beitrag: Abschnitt „Protokoll und Historie entstehen jetzt automatisch“ – Word-Protokoll und täglicher Excel-Export.
Erweitere den mündlichen Prüfer.

WORD-PROTOKOLL
Erstelle nach Abschluss der Prüfung automatisch eine .docx-Datei.
In das Protokoll aufnehmen:
- Datum;
- RSS-Code;
- Position/Beruf;
- Abteilung;
- Sprache;
- Bestehensgrenze;
- Gesamtergebnis BESTANDEN/NICHT BESTANDEN;
- jede Frage;
- Transkript der Antwort;
- Prozentsatz für die Frage;
- normative Quelle und Verweis;
- was gut dargelegt wurde;
- was nicht gesagt wurde;
- Fehler.

Die Felder „Vollständiger Name“ und „Gegenstand der Wissensprüfung“ leer lassen, damit sie nach dem Herunterladen lokal ausgefüllt werden.
Dateiname: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL NACH DATUM
Im Bereich „Historie“ eine Datumsauswahl und die Schaltfläche „Excel für Datum exportieren“ hinzufügen.
Spalten:
Nr. | Prüfungsdatum | Startzeit | RSS-Code | Position/Beruf | Abteilung | Sprache | Anzahl der Fragen | Bestehensgrenze % | Gesamtpunktzahl % | Ergebnis | Status | Endzeit | Prüfungs-ID.

Vollständigen Namen und Personalnummer nicht aufnehmen.
Excel nur aus der lokalen Historie des aktuellen Computers erstellen.
Die Zuordnung RSS <-> Name darf nur offline innerhalb der Unternehmensinfrastruktur mit den Ergebnissen zusammengeführt werden.
Prompt 8. Audit personenbezogener Daten und die Grenze „offline/Cloud“
Bezug zum Beitrag: Abschnitte „Dritte Phase: der portable Browser-Prüfer“ und „Personenbezogene Daten: RSS-Code statt Klarnamen“.
Führe ein technisches Audit der Anwendung des mündlichen Prüfers durch.
Lokale und Cloud-Vorgänge müssen ehrlich voneinander getrennt werden.

Prüfe und beschreibe:
1. Welche Daten in IndexedDB/localStorage gespeichert werden.
2. Welche Daten bei der Transkription an das Cloud-Modell gesendet werden.
3. Welche Daten bei der inhaltlichen Bewertung gesendet werden.
4. Welche Daten bei der Generierung von Fragenentwürfen gesendet werden.
5. Ob vollständige Namen, Personalnummern, eine Mitarbeiterliste oder die Zuordnungstabelle RSS <-> Name übertragen werden.
6. Wo der API-Schlüssel gespeichert ist.
7. Ob die Sicherungskopie den API-Schlüssel enthält.
8. Was nach dem vollständigen Schließen der Anwendung zurückbleibt.
9. Wie sich die lokale Historie und die Quellen löschen lassen.
10. Welche Risiken im Pilotbetrieb bestehen bleiben.

Anforderung an die Formulierung des Ergebnisses:
Bezeichne die Anwendung nicht als „vollständig offline“, wenn Spracherkennung, Bewertung, TTS oder Fragengenerierung eine Cloud-API nutzen.
Korrekte Formulierung: „lokale portable Anwendung mit lokaler Datenbank und kontrolliertem Cloud-KI-Bereich“.
Prompt 9. Mehrere Prüfungsbereiche in einer Oberfläche zusammenführen
Bezug zum Beitrag: Abschnitt „Wie die Fragenbank jetzt entsteht“ – mehrere Vorschriften und Bereiche in einem einzigen Prüfer, ohne zwischen Bots wechseln zu müssen.
Erweitere die Fragenbank und den Startbildschirm der Prüfung so, dass nicht mehr für jede Vorschrift ein eigener Bot erstellt werden muss.

Jede Frage hat bereits das Feld „Thema/Bereich“.
Füge dem Prüfungsbildschirm eine Auswahl der Bereiche hinzu:
- ein Themenblock;
- mehrere Themenblöcke gleichzeitig;
- Modus „Alle ausgewählten Bereiche“.

Beim Start der Prüfung:
1. filtere nur freigegebene Fragen heraus;
2. berücksichtige die gewählte Sprache;
3. berücksichtige die gewählten Bereiche;
4. wähle die festgelegte Anzahl an Fragen zufällig mit dem kryptografischen Generator des Programms aus;
5. verteile die Fragen nach Möglichkeit gleichmäßig auf die gewählten Bereiche;
6. lass keine Wiederholungen zu;
7. reichen die Fragen für die gewählte Kombination nicht aus, brich den Start ab und zeige eine verständliche Meldung an.

Speichere im Word-Protokoll und in Excel zusätzlich die gewählten Prüfungsbereiche.
So nutzen Sie den Anhang zum Beitrag
Die Nummerierung unten ist mit dem Text des Beitrags abgestimmt. Im Beitrag stehen neben der jeweiligen Phase direkte Verweise „Siehe Prompt …“, und hier ist unter jedem Prompt angegeben, auf welchen Abschnitt des Beitrags er sich bezieht.
- Prompt 1 – historische Version: zeigt, wie der erste Prüfer und der eigene Nummerngenerator für 300 Fragen funktionierten.
- Prompt 2 – Erstellung einer großen Fragenbank anhand der Rechtsvorschriften.
- Prompt 3 – der zentrale Prompt für alle, die die aktuelle Browserversion per Vibe-Coding nachbauen möchten.
- Prompt 4 – Generierung von Fragenentwürfen aus einer hochgeladenen Quelle.
- Prompt 5–6 – Trennung zwischen inhaltlicher KI-Bewertung und programmatischer Berechnung des Prozentsatzes.
- Prompt 7 – automatische Word- und Excel-Dateien.
- Prompt 8 – verpflichtende Prüfung der Grenzen zwischen lokalem und Cloud-Bereich.
- Prompt 9 – Zusammenführung mehrerer Prüfungsbereiche in einer Oberfläche.
Kommentare 2
🤝