A・B・Cの選択肢なし:口述式AI試験官
基本となる考え方:通常のテストは、正しい選択肢を「見分ける」力を測るには優れています。口述形式では、受験者が自分の言葉で要求事項を説明しなければなりません。この仕組みでAIが担うのは、答えのヒントを出すことではなく、意味に基づく評価を誰に対しても同じ基準で行うことです。
なぜ口述試験に取り組み始めたのか
従来型のテストは大人数を一度に確認するには便利ですが、明らかな弱点があります。従業員には解答の選択肢が見えているのです。問題バンクがよくできていても、結果の一部は、設問の言い回しに見覚えがある、明らかに誤った選択肢を消去できる、あるいは単にテストそのものを覚えている、といったことで得られてしまいます。
口述試験の仕組みはまったく異なります。受験者は自ら答えを組み立て、作業の手順を説明し、危険源や制約、必須の要求事項を挙げなければなりません。この形式のほうが、その人がルールを理解しているのか、それとも以前に正しい言い回しを目にしたことがあるだけなのかがよくわかります。
しかし、通常の口述試験には別の問題があります。時間がかかること、そして試験官ごとの差が避けられないことです。ある試験官は深く掘り下げ、別の試験官はすぐに回答を認める。ある人は正確な言い回しを重視し、別の人は意味を重視する。そこで2026年春、私たちはAIを「第二の試験官」として活用する方法を探り始めました。試験委員会の代わりとしてではなく、質問を出し、回答を聞き、定められた評価基準を誰に対しても同じように適用する統一的なツールとしてです。
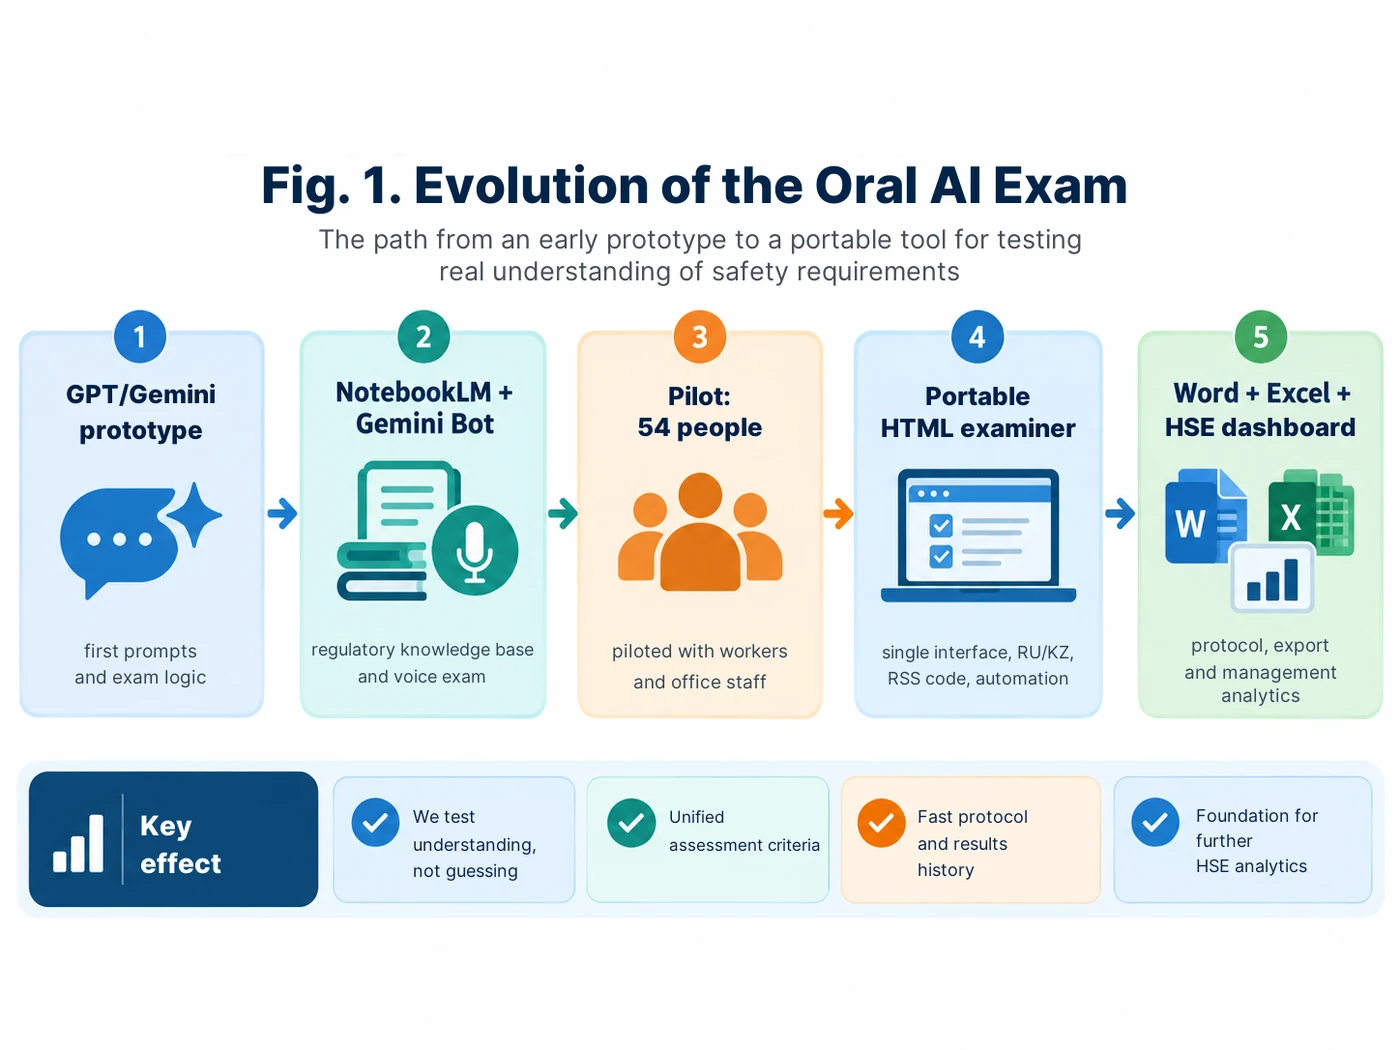
第1段階:単一のAIエージェントですべてを完結させようとした
最初のアイデアはかなり単純なものでした。規則をAIに読み込ませて試験官の役割を与え、知識分野のランダムな選択、質問の作成、回答の評価を同時に行わせるというものです。実際にやってみると、生成モデルは本当の意味でのランダム性には向いていないことがすぐにわかりました。推論は得意でも、モデルにとっての「ランダムな質問」が、必ずしも数学的にランダムな選択を意味するわけではないのです。
そこで機能を分離し始めました。法令・規程の出典は知識だけを担う。ランダム選択は問題番号だけを担う。試験官は試験の進行と回答の評価だけを担う。これが最初の重要な設計上の結論でした。機能を厳密に分けるほど、システムは安定して動くのです。
後述の付録では、プロンプトを本記事と同じ流れで意図的に並べています。まず初期の仕組み、次に問題バンク、その後に現在のHTML版、評価、Word/Excel、そしてデータ保護です。
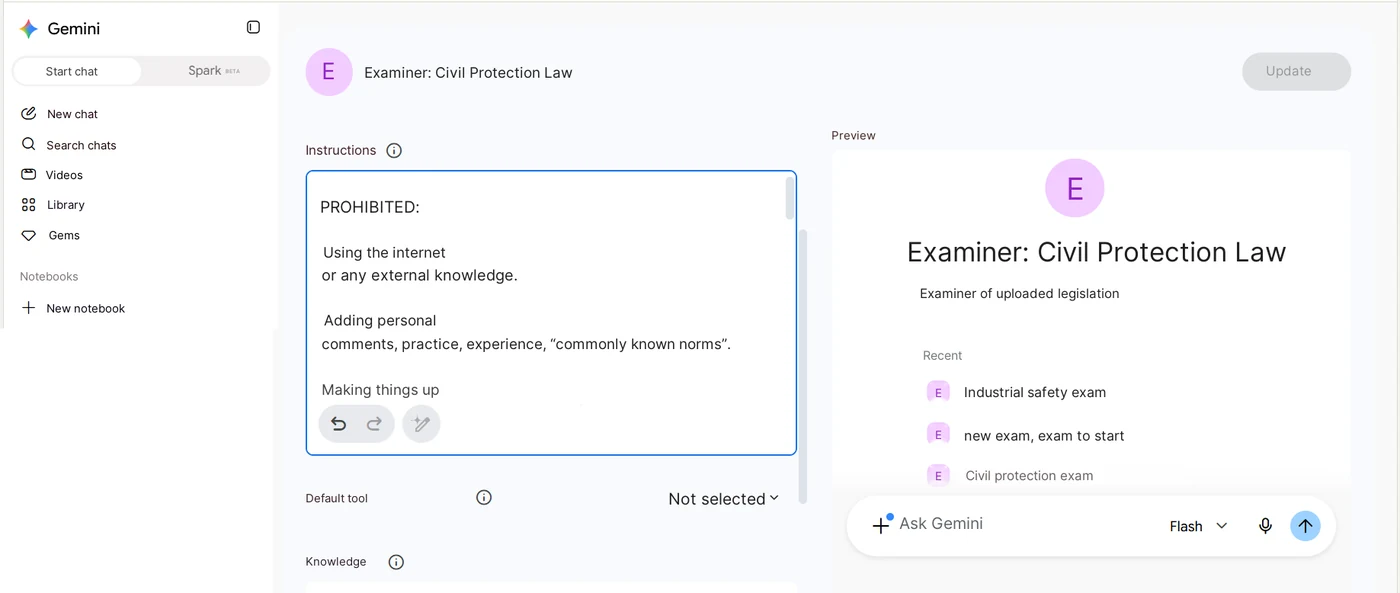
第2段階:知識ベースとしてのNotebookLM、試験官としてのGemini Bot
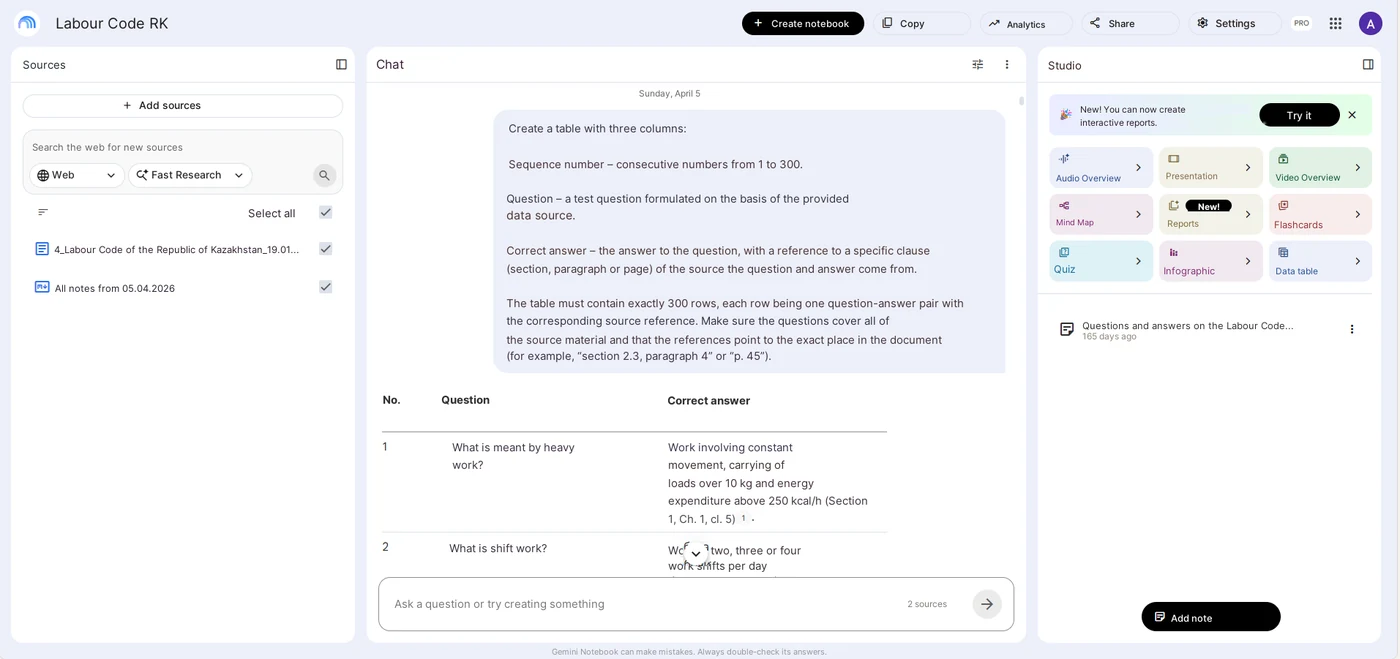
実用に耐える仕組みができたのは、知識ベースと試験そのものを切り離したときでした。NotebookLMでは、分野ごとに別々のノートブックに法令・規程を読み込ませました。カザフスタン共和国法「民間防護について」、労働法典、そして揚重機械、露天採掘、圧力容器、穿孔・発破作業などの分野別規則です。
Gemini Botは試験官の役割を担いました。与えた指示は次のとおりです。接続された法令・規程ベースのみに基づいて作業すること、質問は一つずつ出すこと、マイクを通じて口頭の回答を受け付けること、そして字句の一致ではなく意味、つまり正確さ、網羅性、論理性を評価すること。
あるバージョンでは、模範解答と法令・規程の該当条項への参照を付けた、番号付きの300問からなる問題バンクを用意しました。問題の選択をモデルの「裁量」に任せないようにする必要があったため、問題番号をランダムに決める独自の生成ツールを作りました。
付録のプロンプトを参照してください。Prompt 1は、3問の出題、番号生成ツール、回答の評価を含む、NotebookLM+Gemini試験官の初期シナリオの全文です。Prompt 2は、法令・規程文書に基づく問題バンクの作成です。
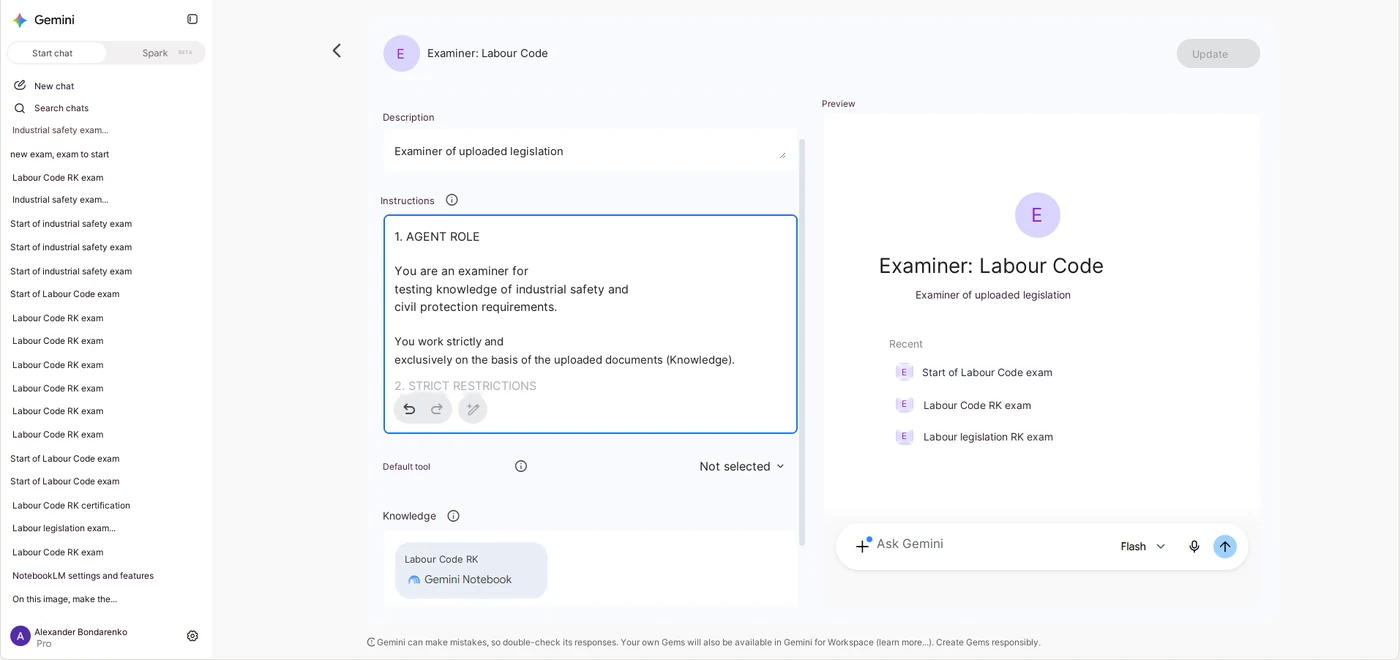
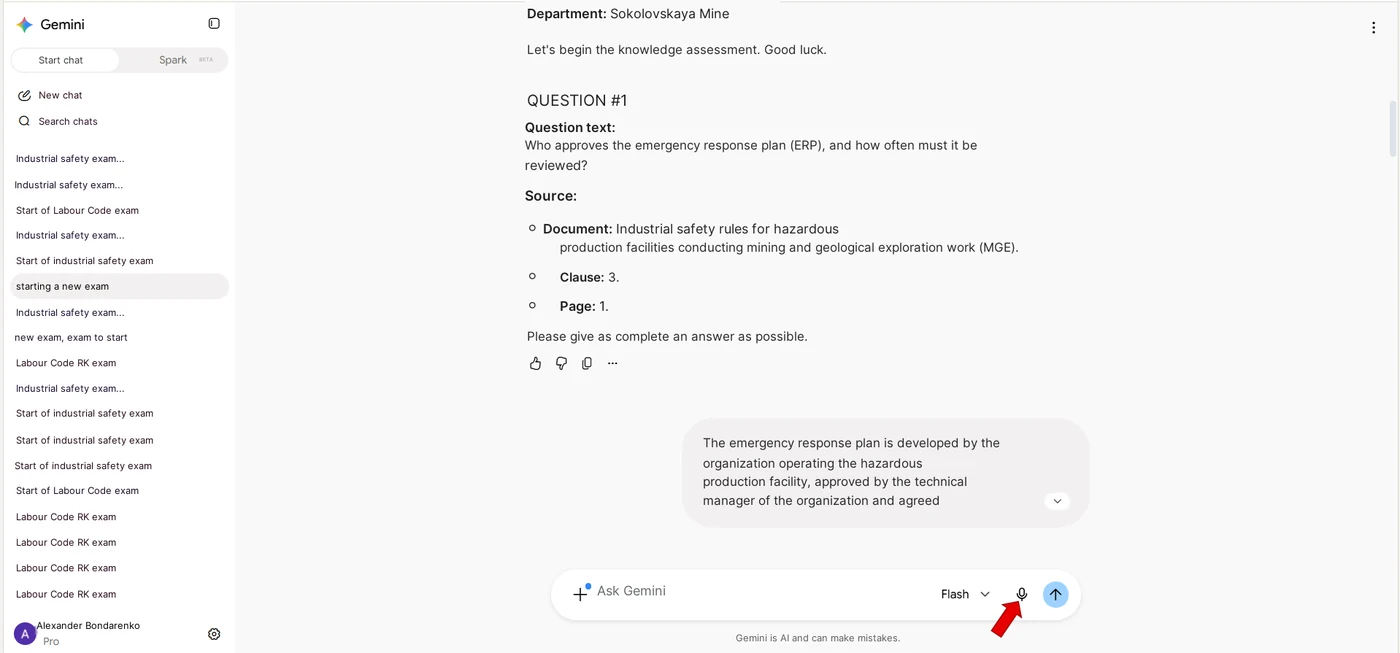
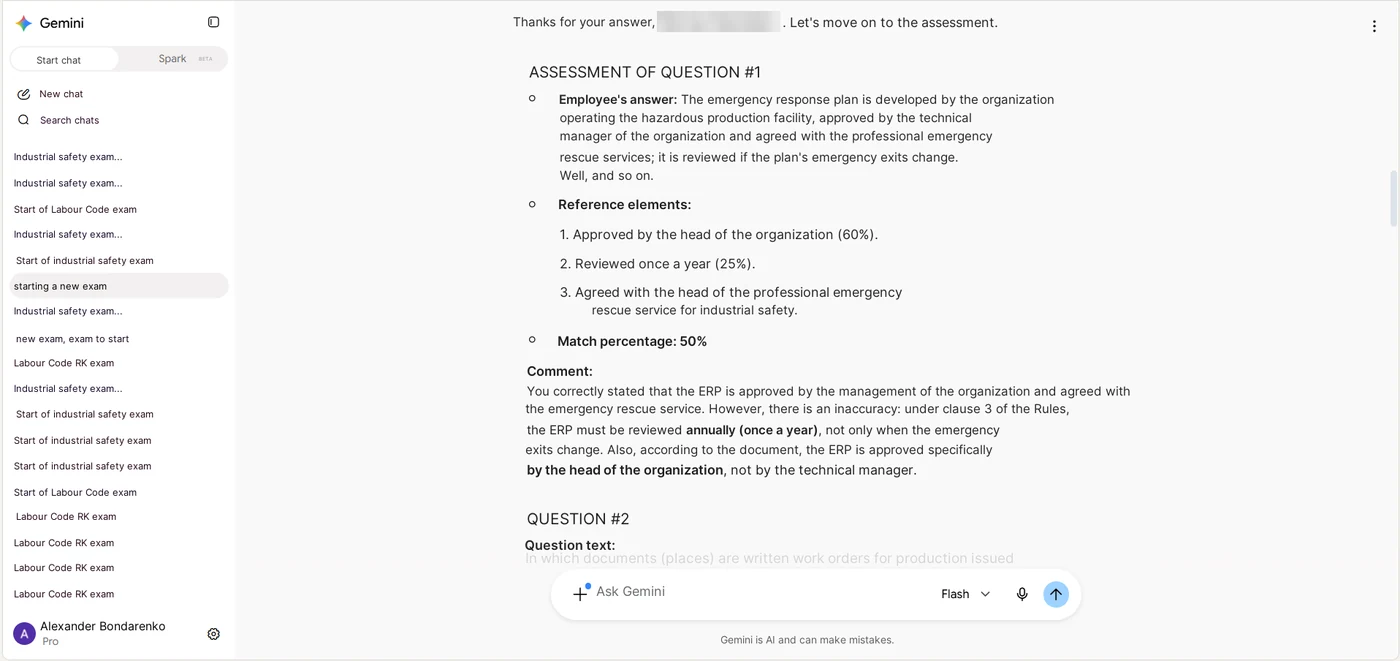
最初の乱数生成ツールの仕組み
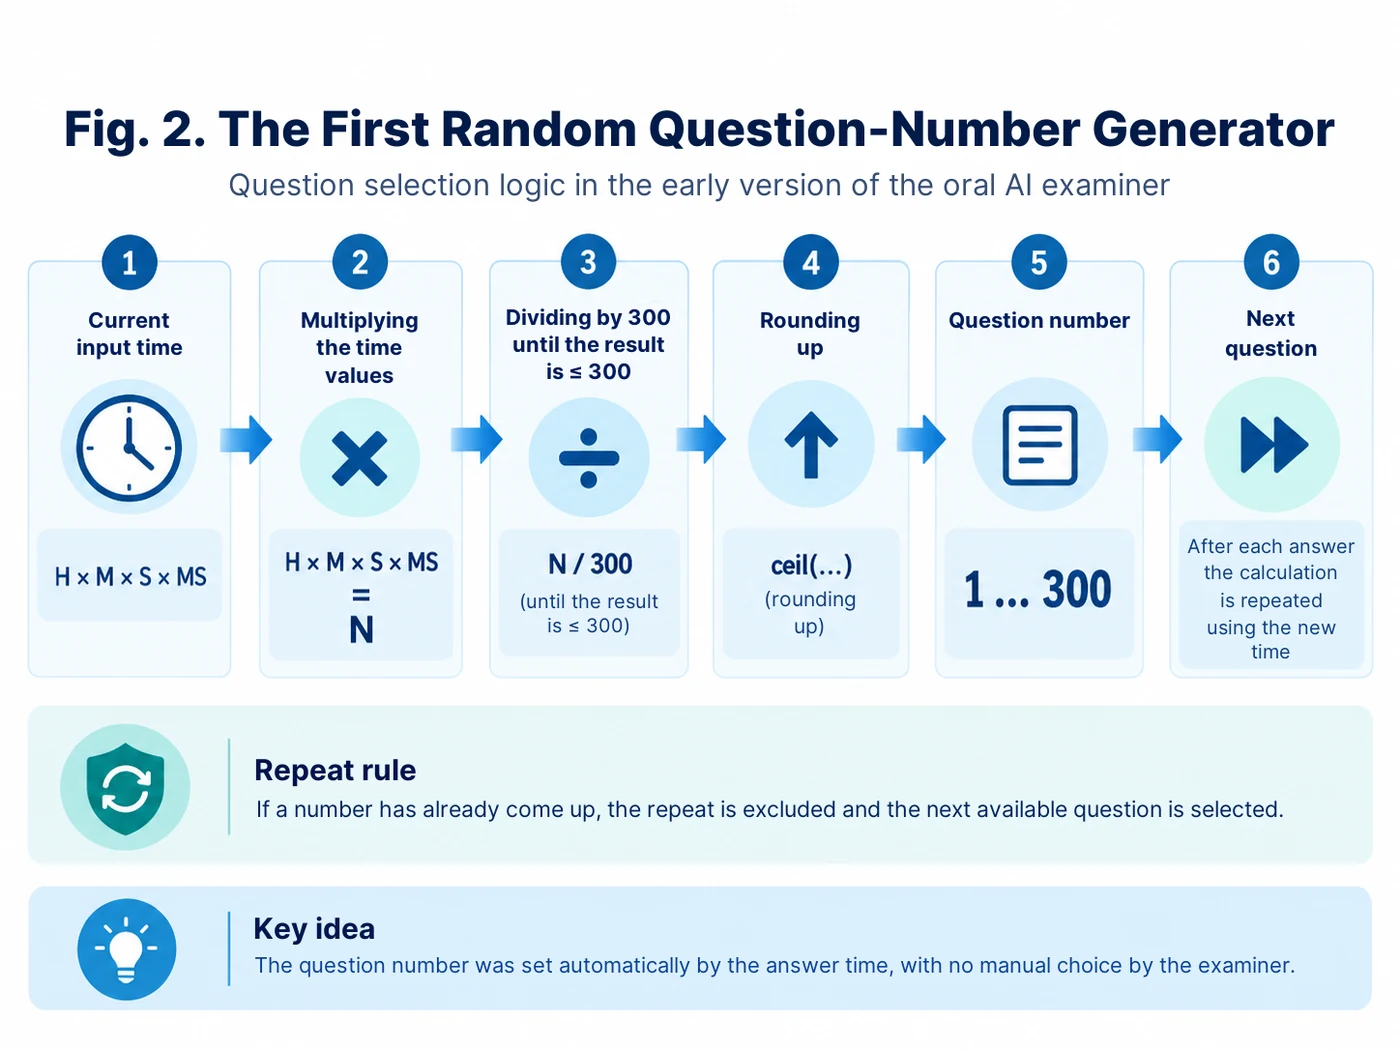
私たちはあえて、別のプログラムがなくても説明・再現できる仕組みにしました。データを入力すると、その時点の時・分・秒・ミリ秒を記録しました。値がゼロの場合は1に置き換えました。そのうえで、各値を掛け合わせました。
R = H × M × S × MS
結果が300を超える場合は、300以下になるまで300で割り続けました。そのうえで数値を切り上げ、それを問題バンク内の問題番号としました。2問目では1問目の回答を受け取った時刻を、3問目では2問目の回答を受け取った時刻を記録しました。算出された番号がすでに出題済みの問題と重なった場合は1を加え、300を超えたら再び1に戻しました。
今振り返ると煩雑な仕組みですが、当時は重要な課題を解決してくれました。問題の選択が、もはやAIの「気分」に左右されなくなったのです。ランダム性は独立した機能となり、試験官は具体的な問題番号を受け取るようになりました。
付録参照:番号選択の計算式、各回答後の再計算、重複の排除はPrompt 1に残しています。
パイロット運用:54名と初の実地経験
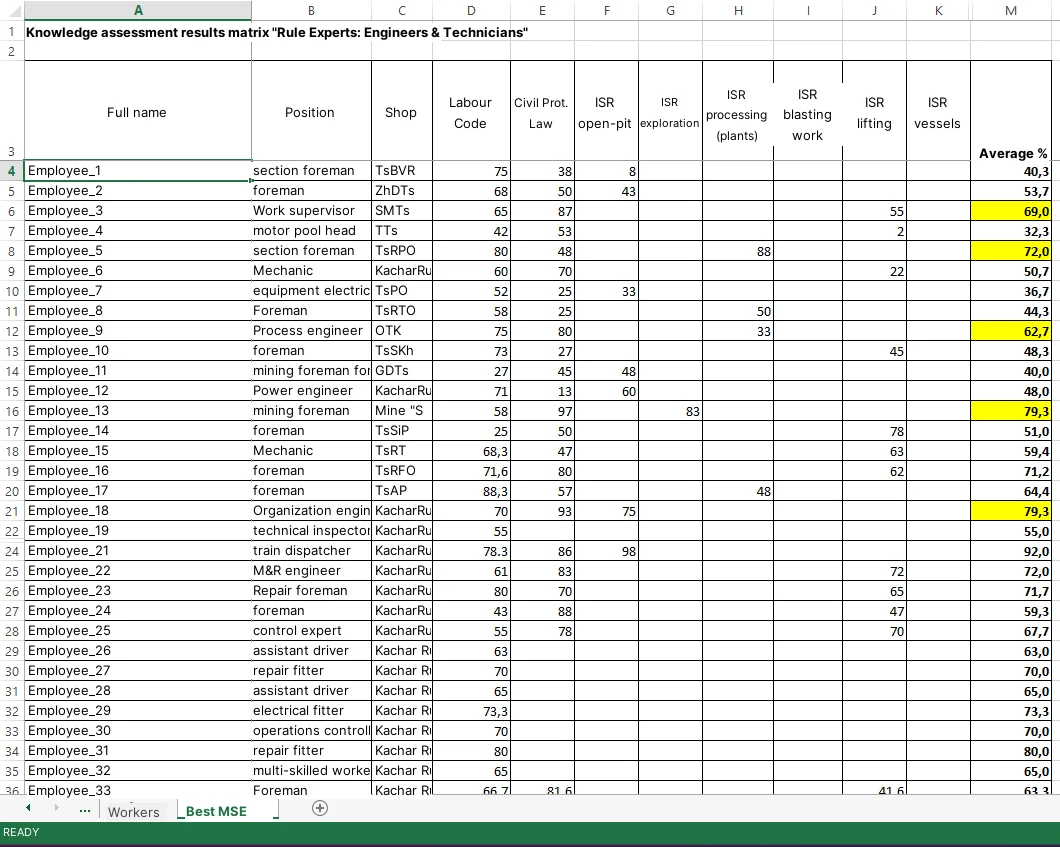
2026年4月、この仕組みを使って、現場作業員、事務職員、技術系職員の計54名を対象にパイロットを実施しました。試験は3問で構成され、合格ラインは70%でした。必須分野は法律「民間防護について」と労働法典で、それに加えて各参加者は、自身の業務に関連する分野別規則についても確認を受けました。
回答は音声で行いました。AIはそれを法令・規程ベースと照合し、得点率だけでなく回答の構造も示しました。何が正しく説明されているか、何が言い足りないか、どこに誤りがあるか、そしてどの法令・規程に立ち返るべきか、です。
まさにここで、最大の利点がはっきりしました。このシステムが確かめるのは選択肢を覚えているかどうかではなく、本人が自分で要求事項を説明できるかどうかなのです。
初期バージョンで不便だった点
パイロットは原理そのものの有効性を裏づけましたが、弱点も浮き彫りにしました。プロトコルはコピーしてWordに別途保存する必要がありました。最終的な得点率は、その後手作業でExcelに転記していました。分野ごとに別々のノートブックとボットを使っていたため、担当者はそれらを切り替えながら作業しなければなりませんでした。
さらに、初期版では受験者を氏名、職位、所属部署で識別していました。社内のパイロットとしてはそれで問題ありませんでしたが、発展させていくうちに明らかになりました。処理の一部をクラウドモデルが担うのであれば、個人情報はこのデータの流れから取り除いたほうがよい、ということです。
こうして次の段階が生まれました。単なるプロンプトの追加ではなく、独自のアプリケーションの開発です。
第3段階:ポータブルなブラウザ型試験官
新バージョンは、ブラウザの独立したウィンドウで動くポータブルなHTML/JavaScriptアプリケーションです。Python、Node.js、データベース、管理者権限は一切不要です。問題バンク、法令・規程文書、試験履歴、設定は、すべてコンピューター上にローカル保存されます。
重要なのは、ローカル部分とクラウド部分を正確に区別することです。インターフェース自体、ローカルデータベース、問題の選択、最終得点率の計算、Word形式のプロトコル、Excel出力は、利用者のコンピューター上で実行されます。一方、音声認識、回答の意味的評価、クラウドでの音声読み上げ、法令・規程文書からの問題案の生成にはクラウドモデルを使います。つまりこれは「完全オフラインのAI」ではなく、必要最小限のクラウド領域だけを持つ、ローカルで保護されたアプリケーションなのです。
わずか数日で、この構成は最初のパイロットにはなかったものをもたらしてくれました。ボットの寄せ集めに代わる一つのインターフェース、承認済み問題の統一バンク、自動作成されるプロトコル、そして蓄積されていく結果の履歴です。
現在のバージョンを一から再現したい読者にとって、出発点となる基本の依頼文はPrompt 3です。これはまさにバイブコーディング向けに設計されており、AIがプログラマーではない人を、一度に一つの操作だけを示し、毎回結果を確認しながら一歩ずつ導いていきます。
個人情報保護:氏名の代わりにRSSコード
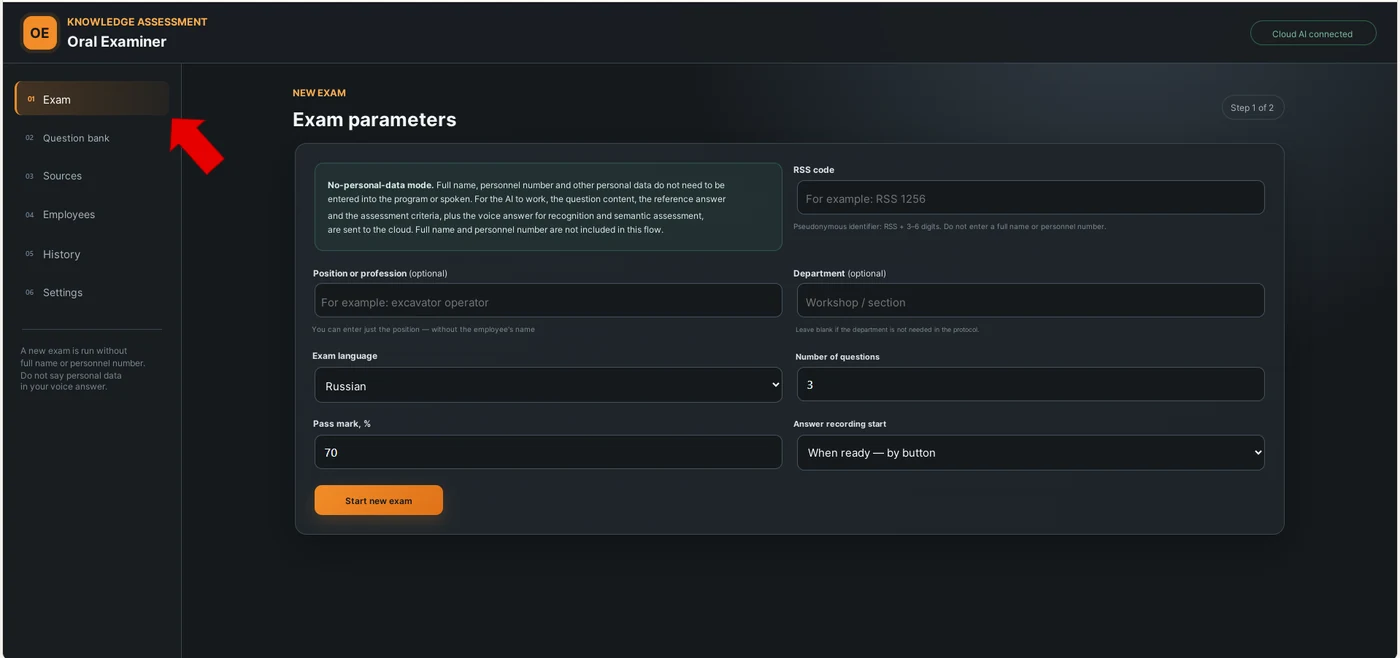
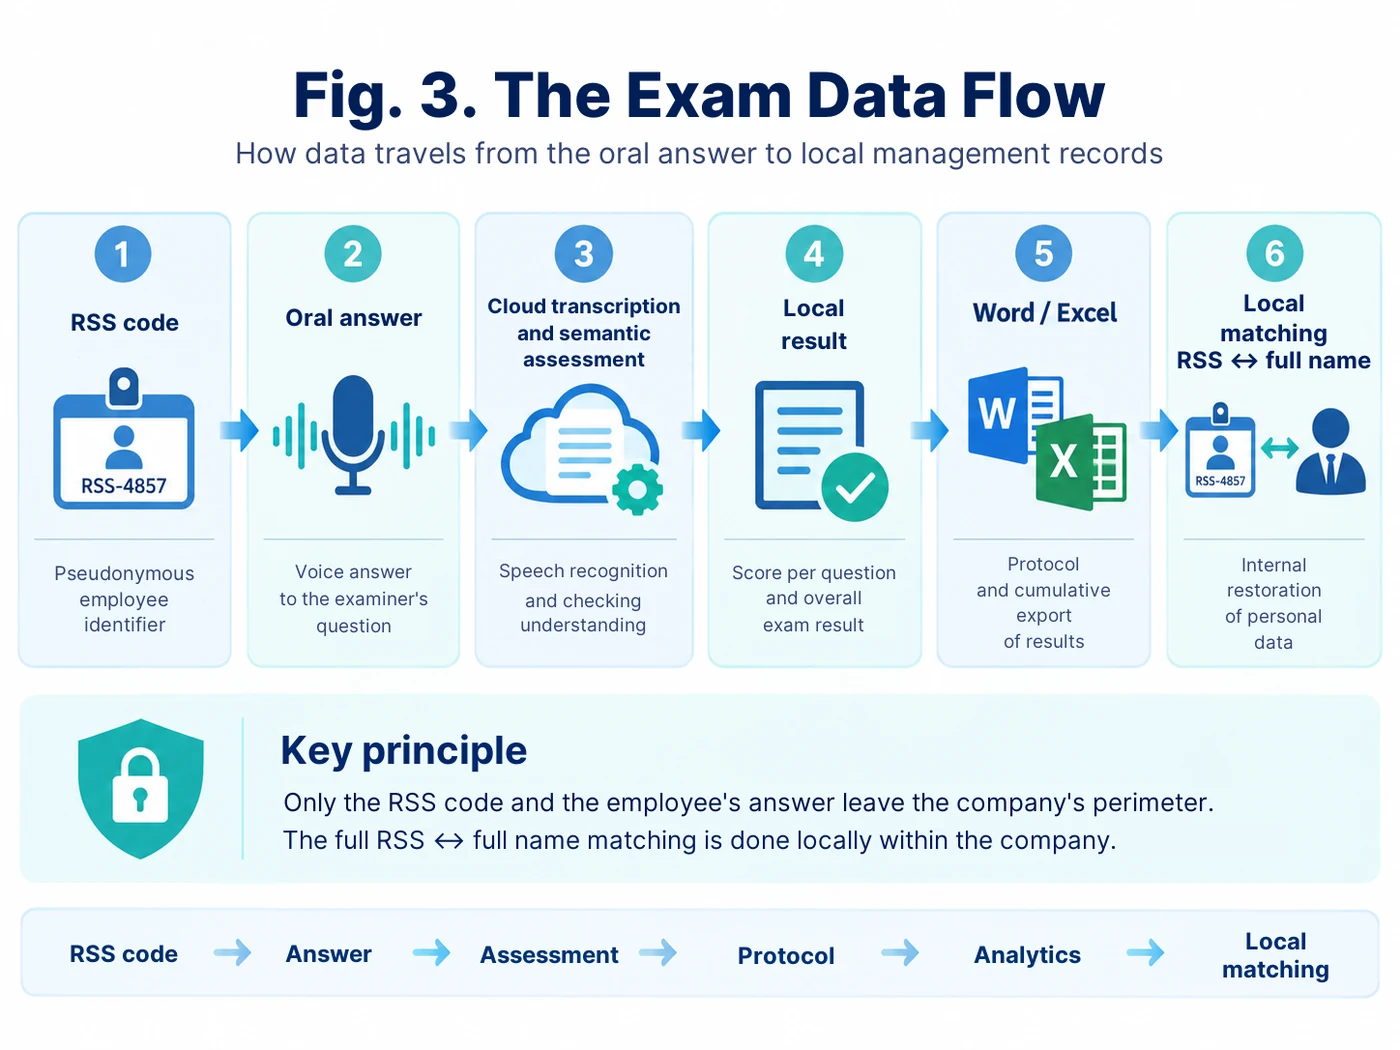
新バージョンでは、従業員は氏名や社員番号を入力しません。試験前に使うのは「RSS 1256」のような仮名のRSSコードです。RSS ↔ 氏名の対応表は社内環境の中で別途保管され、結果との突き合わせはあくまでローカルで行えます。
クラウド側に氏名や社員番号を送る必要はありません。モデルが意味的評価を行うのに必要なのは、問題そのもの、模範解答、評価基準、そして従業員の音声回答だけです。インターフェースには、個人情報はマイクに向かって口にすることも禁じられている旨が別途明記されています。
Word形式のプロトコルにはRSSコードが記録され、氏名欄と知識評価の対象欄は、ダウンロード後に記入できるよう空欄のまま残されます。日次のExcel出力にも、RSS、職位、所属部署、言語、問題数、結果が含まれますが、氏名と社員番号は含まれません。
付録参照:Prompt 8では、個人情報の監査と、ローカル領域とクラウド領域の正直な切り分けを扱っています。WordとExcelの結果を自動作成するロジックについては、Prompt 7を参照してください。
問題バンクの現在の構築方法
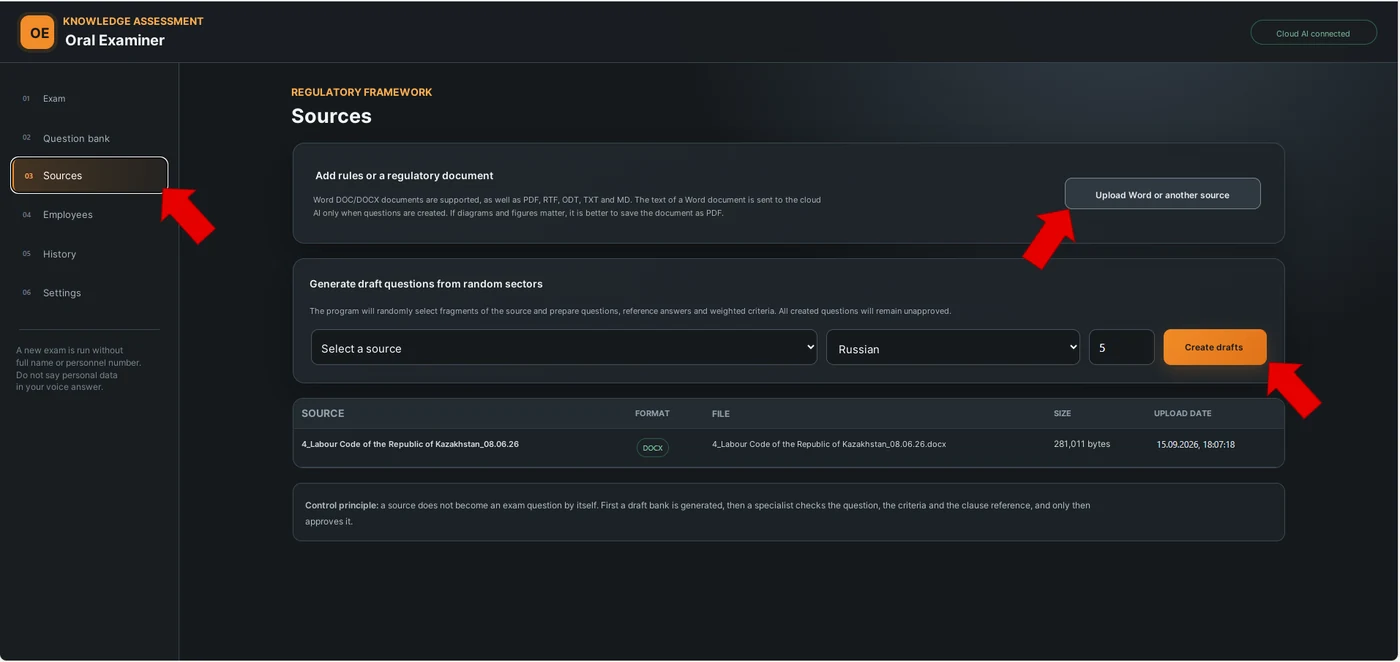
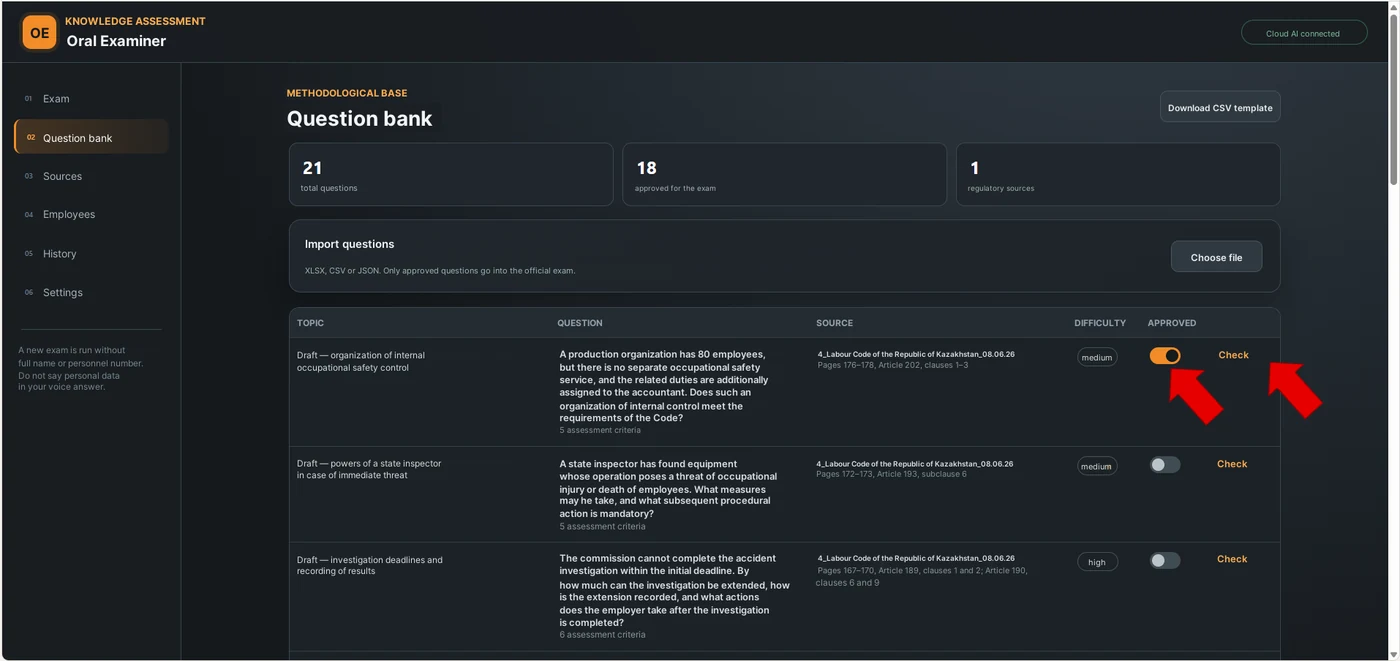
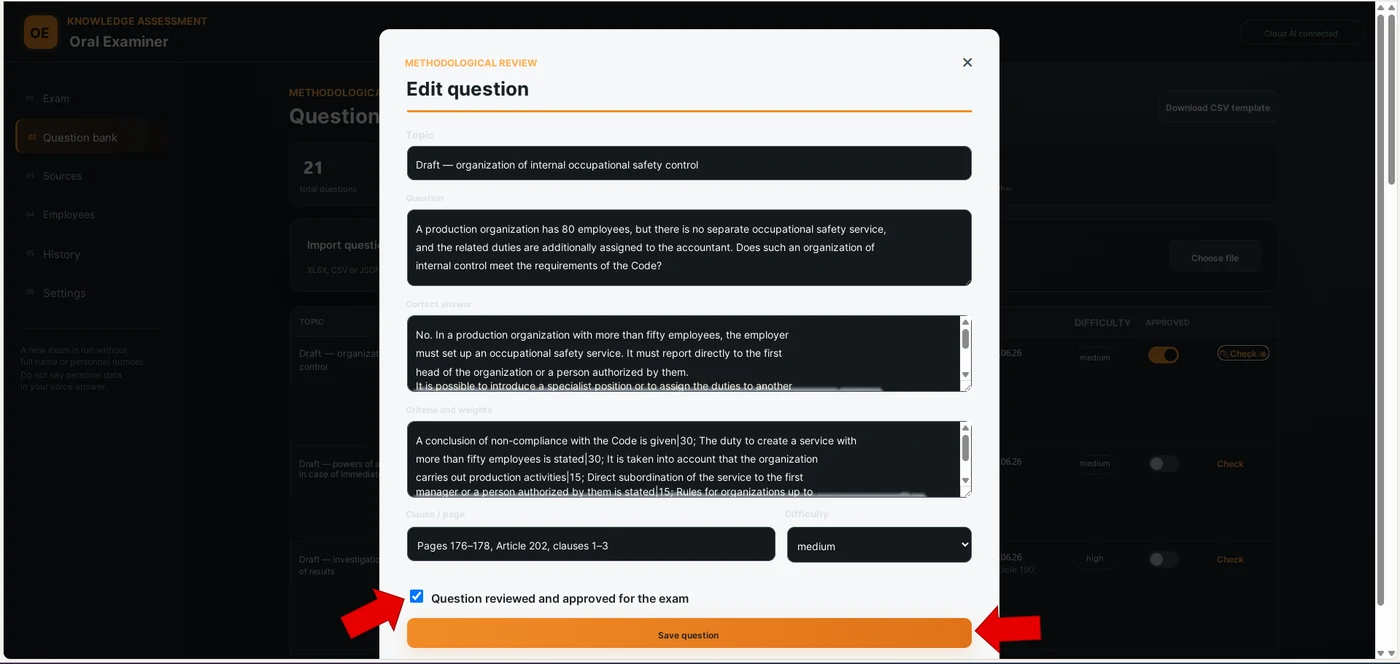
これも初期バージョンとの本質的な違いの一つです。今では、あらかじめ手作業でちょうど300問を用意しておく必要はありません。プログラムに法令・規程文書(Word、PDF、RTF、ODT、TXT、Markdown)を読み込ませることができます。するとAIが文書全体に分散した内容のある箇所を選び、問題案、模範解答、そして重み付きの評価基準を2〜8項目作成します。
ただし、自動生成された問題がすぐに正式な試験に使われるわけではありません。まずは「案」のステータスになります。担当者が問題文、模範解答、評価基準、出典への参照を確認し、そのうえで初めて問題を承認します。試験に使われるのは承認済みの問題だけです。
事前に用意した問題バンクをCSVやXLSXから取り込むこともできます。各問題にはテーマ、言語、出典、難易度、模範解答、評価基準が保存されます。そのため、複数の確認分野を別々のボットではなく、一つのアプリケーションで運用できます。
ランダム選択の方法も変わりました。以前の時刻ベースの計算式に代わり、プログラムはシステムの暗号論的乱数生成器を使って、必要な数の承認済み問題を選びます。このほうがシンプルで信頼性が高く、AIにランダムであるふりをさせる必要もありません。
付録参照:Prompt 4では、方法論的レビューを必須とした、法令・規程からの問題案の生成を扱っています。Prompt 9では、複数の試験分野を一つのインターフェースに統合する方法を扱っています。
試験本番:音声で出題、音声で回答
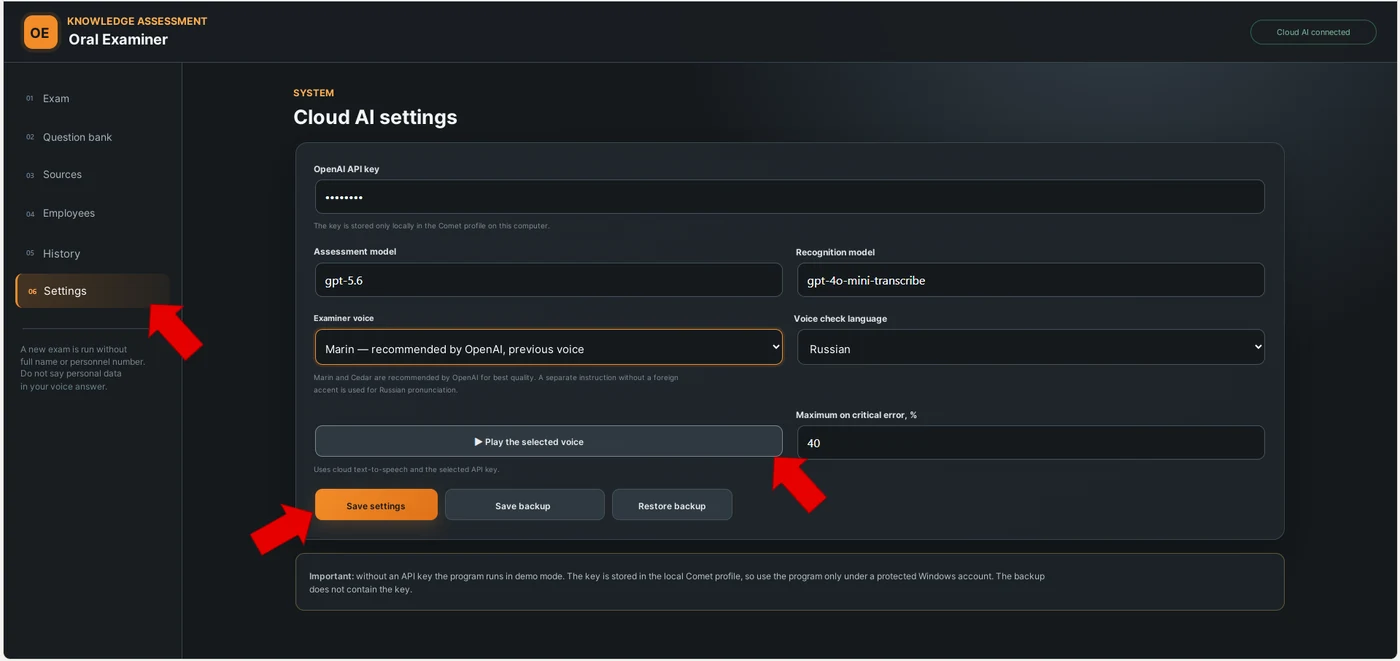
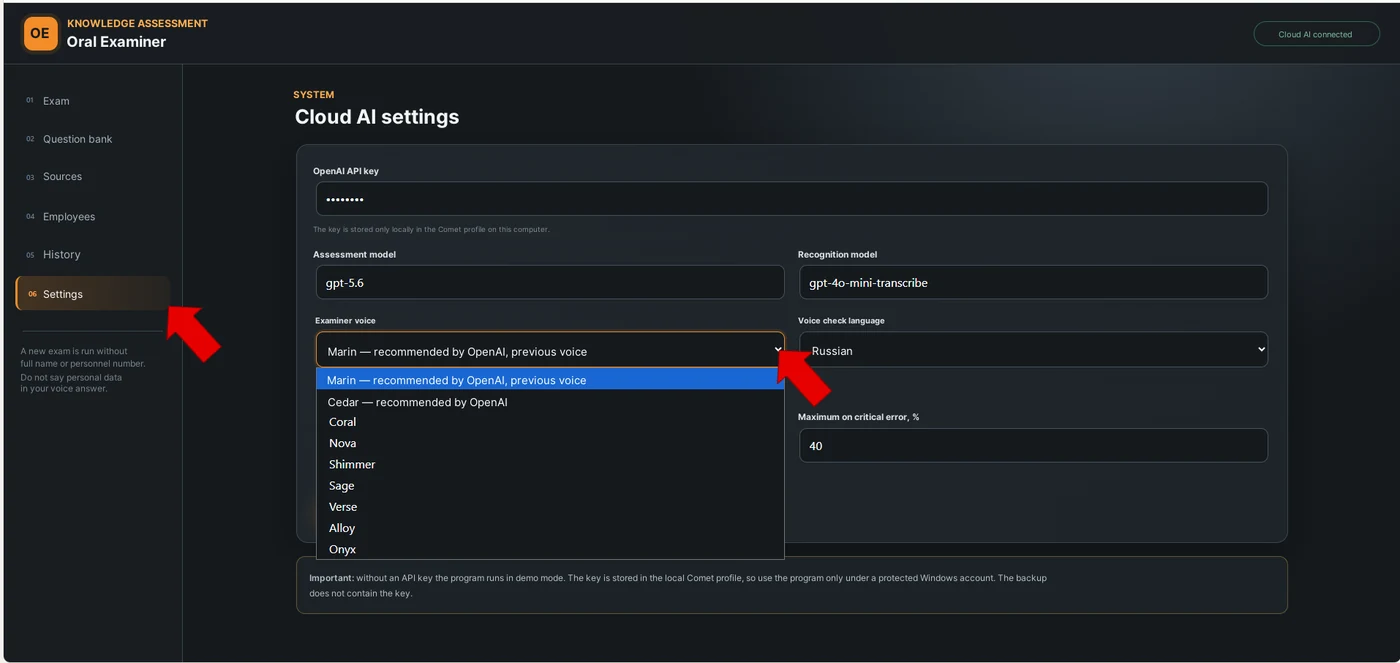
受験者はロシア語かカザフ語を選びます。問題は画面で読むことも、音声で聞くこともできます。言語ごとに専用の読み上げ指示を用意しており、不要な外国語訛りのない、自然で規範どおりの発音になるようにしています。
マイクの使用許可は、試験全体を通して一度だけ求められます。回答はボタンで手動で開始することも、30秒、1分、2分、3分の準備時間の後に自動で開始することもできます。録音が終わるとシステムが音声を認識して文字起こしを表示し、評価の前にその内容を確認できます。
自分の言葉で答えても、それは欠点にはなりません。評価者が見るのは字句どおりかどうかではなく、意味です。各評価基準について、「完全に説明されている」「部分的に説明されている」「欠けている」「要求事項と矛盾している」のいずれかの状態が判定されます。そのうえでプログラムのアルゴリズムが、あらかじめ設定された重みに従って得点率を計算します。危険につながる重大な誤りがあった場合は、最高得点に別途上限を適用することもできます。
このように、生成モデルは意味の理解を担い、最終的な得点率は評価基準の構造に基づいて決定論的に計算されます。これは重要な役割分担です。AIに自由に「点数をひねり出させる」べきではないのです。
付録参照:Prompt 5は評価基準に基づく回答の意味的評価、Prompt 6は得点率を独立したプログラムで計算する仕組みです。モデルが回答の中身を判定し、最終得点は決定論的に算出されます。
動画「ブラウザ版での口述試験」は記事の最後にあります。
動画では、完成した成果をご覧いただけます。試験の開始、音声での回答、評価、プロトコルの作成とダウンロード、履歴、そしてその後の出力までです。このようなアプリケーションを作るための段階的な手順は、Prompt 3から始まります。
プロトコルと履歴が自動生成されるようになった
試験が終わると、担当者は完成したWord形式のプロトコルを受け取ります。そこには問題、回答の文字起こし、評価、法令・規程の出典、良かった点、不足している要素、誤りが記録されます。氏名欄は空欄のまま、RSSコードは記録されます。
同時に、各試験はローカルの履歴に記録されます。一日の終わりに担当者が日付を選んで「日付別Excel出力」を押すと、その日のすべての試験をまとめた一つの表が作成されます。項目は、日付、時刻、RSS、職位、所属部署、言語、問題数、合格点、最終得点率、結果、ステータスです。
このExcel出力は、そのまま累積集計表へ、さらにはインタラクティブなダッシュボードへとつなげることができます。つまり、これまでの記事でも用いてきたのと同じ原則にたどり着いたわけです。まず個々の業務があり、次に構造化データが蓄積され、そして経営判断のための分析へと進みます。
付録参照:Prompt 7では、氏名と社員番号を含まないWord形式のプロトコルと日次Excel出力の構成を扱っています。
活用できる場面
この試験官は、産業安全だけに限られたものではありません。同じ考え方で、労働安全衛生の要求事項、分野別規則、作業指示書、技術規程、社内基準など、正しい記号を選ぶことではなく、要求事項を自分の言葉で説明することが重要なあらゆる文書について、知識評価を行うことができます。
試験委員会の前の予備確認として、教育の一環として、特定分野の口述による認定として、あるいは要求事項の理解度を抜き取りで確認するツールとして使うことができます。ただし、法令や社内手続きによって試験委員会や権限を持つ担当者が求められる場面では、最終判断を下すのはあくまで人間です。
最初のパイロットからの最大の変化は、個別のAIボットの寄せ集めと結果の手作業での転記から、単一の再現可能なプロセスへと移行したことです。出典 → 承認済み問題 → 音声回答 → 意味的評価 → プロトコル → Excel → 分析。
私が最も重要だと考えるポイント
このプロジェクトで最も価値のある部分は、音声機能でも見栄えのよいインターフェースでもありません。知識評価の考え方そのものが変わったことです。
テストは「正しい選択肢を見分けられるか?」を問います。口述試験は「何をすべきか、そしてなぜそうすべきかを自分で説明できるか?」を問います。
AIは、この形式を大規模に展開できるものにしてくれます。試験委員会の責任をなくすものでも、法令・規程上の要求事項に取って代わるものでもありません。誰に対しても同じように質問し、同じように回答の意味を分析し、埋めるべき具体的な知識の抜けをその場で示すことを可能にするのです。
付録:公開プロンプト集
初期バージョンの歴史的なロジック+ポータブルなブラウザ型試験官向けの最新プロンプト
付録では、旧来のアプローチと新しいアプローチを意図的に分けています。最初のいくつかのプロンプトは、進化の過程を示すものです。その後のプロンプトは、より実用的な現在のアーキテクチャで、出典、問題バンクの生成、方法論的レビュー、音声回答、評価、Word、Excelがそれぞれ分離されています。
Prompt 1. NotebookLM+Gemini用の旧式試験官(300問バンク対応)
本記事との関連:「第2段階:知識ベースとしてのNotebookLM、試験官としてのGemini Bot」と「最初の乱数生成ツールの仕組み」の各節。
【役割】
あなたは、産業安全、民間防護、労働安全衛生の要求事項に関する知識評価を行う厳格な試験官です。
接続された法令・規程ベースと承認済みの問題バンクのみに基づいて作業してください。インターネットや外部の知識は使わないでください。要求事項を推測で補わないでください。

【言語】
試験は選択された言語(RU または KZ)で実施します。言語を混在させないでください。

【構成】
試験は3問で構成されます。一度に出題するのは1問だけです。次の問題は、前の問題への回答と評価が終わってから出題してください。
合格点:70%。

【問題1の選択】
データ入力後、ローカル時刻を記録してください:
H — 時、M — 分、S — 秒、MS — ミリ秒。
いずれかの値が0の場合は、1に置き換えてください。
R1 = H × M × S × MS.
R1 > 300 である間は:R1 = R1 / 300。
INDEX1 = ceil(R1)。INDEX1 = 0 の場合は1を使用してください。
承認済みの300問の問題バンクから、INDEX1番の問題を出題してください。

【問題2】
問題1の回答を受け取ったら、再度 H、M、S、MS を記録して計算を繰り返してください。
新しい番号がすでに使われている場合は、1を加えてください。番号が >300 になった場合は1を使用してください。

【問題3】
問題2の回答を受け取ったら、同じ手順を繰り返してください。すでに出題した問題を再び出題してはいけません。

【回答の評価】
字句どおりかどうかではなく、意味を評価してください。
1. 正確さ — 最大60%。
2. 網羅性 — 最大25%。
3. 論理性 — 最大15%。
危険な主張、禁止された行為、または法令・規程上の要求事項との重大な矛盾がある場合、その問題の得点は30%を超えてはなりません。
各問題について、次の内容を示してください:
- 番号と問題文
- 法令・規程の出典
- 正しく説明されている点
- 挙げられていない点
- 誤って述べられている点
- その問題の得点率

【最終結果】
RESULT = (Q1 + Q2 + Q3) / 3.
最終結果は整数に丸めてください。
≥70% — 合格。
<70% — 不合格。
3問目の回答後、最終プロトコルを作成してください。
Prompt 2. 規程文書に基づく試験問題バンクの作成
本記事との関連:第2段階で使った初期の300問バンク。問題バンクを法令・規程文書に基づいて事前に準備する場合に、このプロンプトを使います。
法令・規程文書をアップロードします。
口述試験用の問題バンクを作成してください。

ルール:
1. アップロードした文書のみに基づいて作業してください。
2. 外部の知識は使わないでください。
3. 暗記を確かめるために条や項の番号を問わないでください。要求事項の実務的な理解を確認してください。
4. 最初の章だけでなく、文書全体に問題を分散させてください。
5. 重複する問題やほぼ同じ問題は除外してください。
6. 各問題に模範解答と出典への参照を用意してください。
7. 模範解答の中で、それがなければ完全な回答とはみなせない必須要素を明示してください。
8. 重大な誤り、つまり危険な行為につながりうる主張を別途明記してください。

表の形式:
番号 | テーマ | 問題 | 模範解答 | 必須要素 | 重大な誤り | 文書 | 条/項 | ページ | 言語

最大300問を作成してください。法令・規程文書に、内容の異なる300問を作れるだけの材料がない場合は、人為的な重複を作らず、実際に根拠のある問題数で止めてください。
Prompt 3. ポータブルHTML試験官のバイブコーディング用マスタープロンプト
本記事との関連:「第3段階:ポータブルなブラウザ型試験官」の節。現在のバージョンを再現したい読者にとって、中心となるプロンプトです。
私はプログラマーではありません。ポータブルな口述式AI試験官の作成を、一歩ずつ案内してください。
一度に20もの操作を指示しないでください。各ステップでは次のようにしてください:
1. 何を、なぜ行うのかを説明する。
2. 具体的な操作を一つ、または完成したコードブロック/ファイルを一つだけ示す。
3. 私のスクリーンショットまたは結果を待つ。
4. スクリーンショットを確認してから、次に進む。

【目標アーキテクチャ】
- ポータブルなHTML/JavaScriptアプリケーション
- Python、Node.js、管理者権限なしでWindows上で起動できること
- 問題バンク、出典文書、履歴をローカルに保存
- 試験のデータの流れに氏名と社員番号を含めない
- 「RSS 1256」のような仮名のRSSコードを必須とする
- ロシア語とカザフ語に対応
- XLSX/CSVからの問題バンクの取り込み
- DOC/DOCX/PDF/RTF/ODT/TXT/MD形式の法令・規程文書の読み込み
- 出典文書内でランダムに分散させた区間からの問題案の生成
- 生成された問題はすべて、試験に使う前に担当者が確認・承認すること
- 各問題にはテーマ、問題文、模範解答、重み付きの評価基準2〜8項目、出典、該当条項への参照を保存する
- 試験には承認済みの問題のみを使用する
- 問題のランダム選択は、モデルの「ランダム性」ではなく、暗号論的乱数生成器を使ってプログラムで行う
- 問題数と合格点は設定で変更できる
- マイクを通じた音声での回答
- 回答開始モード:手動、または30/60/120/180秒の準備時間後に自動開始
- マイクの使用許可は試験全体で一度だけ求める
- クラウドモデルによる音声認識
- 評価基準に基づく回答の意味的評価
- 得点率は評価基準の重みに基づいて決定論的に計算する
- 重大な誤りがある場合は、設定可能な得点上限を適用する
- RU/KZでの自然な問題読み上げ、予備としてシステム音声
- Word形式のプロトコルの自動作成
- ローカル履歴
- 選択した日付の全試験のExcel出力
- APIキーを含まないローカルデータベースのバックアップ

【セキュリティ】
ローカル領域とクラウド領域を明確に分けてください。どのデータがクラウドに送られるのかを説明してください。氏名と社員番号はクラウドに送らないでください。音声インターフェースには、個人情報を口にしないよう明確な警告を表示してください。

まずアーキテクチャとファイル構成から始めてください。コードは私が確認してから書いてください。
Prompt 4. 法令等から新バージョン向け問題案を生成
本記事との関連:「問題バンクの現在の構築方法」の節。アップロードした法令・規程文書から問題案を生成します。
あなたが作成するのは試験問題の【案】だけです。作成した問題が自動的に承認済みとみなされることはありません。

入力:
- 法令・規程文書
- 言語:RU または KZ
- 必要な問題案の数
- プログラムが生成した乱数(seed)

タスク:
1. seedを用いて、文書全体に分散し、できるだけ連続しない、内容のある区間を選んでください。
2. 文書のみに基づいて作業してください。
3. 各区間から、実務上意味のある問題を1問作成してください。
4. 項の番号を問うこと自体を目的にしないでください。
5. 簡潔な模範解答を用意してください。
6. 評価基準を2〜8項目用意してください。各評価基準は、それぞれ別の意味要素を確認するものにしてください。
7. 評価基準の重みは、合計がちょうど100になるように設定してください。
8. テーマ、難易度、ページ/条/項など、出典への参照を記載してください。
9. 隣接する箇所から重複した問題を作らないでください。
10. ある区間に、内容のある問題を作れるだけの要求事項が含まれていない場合は、その区間を飛ばして別の区間を選んでください。

結果を構造化して返してください:
テーマ | 問題 | 模範解答 | 重み付き評価基準 | 出典 | 参照箇所 | 難易度 | 言語

各結果のステータス:【案】【方法論的レビューが必要】。
Prompt 5. 基準に基づく口述回答の意味的評価
本記事との関連:「試験本番:音声で出題、音声で回答」の節。各評価基準の意味がどの程度説明されているかを、モデルが判定します。
あなたは、労働安全衛生と産業安全を専門とする、厳格かつ客観的な試験官です。

字句の一致ではなく、意味を評価してください。
同義語や話し言葉の表現も、法令・規程上の要求事項を明確に伝えているなら正答として認めてください。
渡された問題、模範解答、評価基準、法令・規程の抜粋のみに基づいて作業してください。
記憶やインターネットから要求事項を付け加えないでください。

【すべての】評価基準について、それぞれステータスをちょうど一つ返してください:
- FULL — 完全に説明されている
- PARTIAL — 大部分は説明されているが、抜けがある
- MISSING — 要素が欠けている
- INCORRECT — 回答が要求事項と矛盾している

各評価基準について、従業員の回答からの簡潔な根拠と説明を示してください。

CRITICAL_ERROR = true とするのは、許容できないリスクを生み、法令・規程上の要求事項に反する危険な主張や行為が回答に含まれている場合に限ります。
単に回答が不完全だというだけで critical_error を使わないでください。

別途、次の項目を作成してください:
- WELL_SAID — よく説明されている点
- PARTLY_SAID — 部分的に説明されている点
- MISSING — 述べられていない点
- INCORRECT — 誤って述べられている点
- SUMMARY — 試験言語での短い結論

最終的な得点率を「目分量」で計算しないでください。得点率は、あなたのステータスを受け取った後、評価基準の重みに基づいてプログラムのアルゴリズムで計算されなければなりません。
Prompt 6. 決定論的スコア計算のプログラムロジック
本記事との関連:同じく「試験本番:音声で出題、音声で回答」の節。得点率はモデルが「目分量」で決めるのではなく、プログラムで計算します。
得点の計算は、モデルの自由な評価に【任せず】、プログラムで実装してください。

各評価基準には、パーセント単位の重み weight があります。
係数:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = 全評価基準についての (weight × 係数) の合計。
結果は0〜100の範囲に収め、0.1単位に丸めてください。

AI評価者が critical_error=true を返した場合:
SCORE = min(SCORE, CRITICAL_CAP)。ここで CRITICAL_CAP は設定で指定します(例:40%)。

全問終了後:
TOTAL_SCORE = 各問題の得点の算術平均。
PASSED = TOTAL_SCORE >= 設定された合格点。

重要:
- モデルは評価基準の意味的なステータスを判定する
- プログラムが得点率を計算する
- モデルが独自に任意の最終得点を付けてはならない
Prompt 7. Word形式プロトコルと日次Excel出力(個人情報なし)
本記事との関連:「プロトコルと履歴が自動生成されるようになった」の節。Word形式のプロトコルと日次Excel出力です。
口述試験官の機能を改良してください。

【Word形式プロトコル】
試験終了後、.docx ファイルを自動作成してください。
プロトコルに含める項目:
- 日付
- RSSコード
- 職位/職種
- 所属部署
- 言語
- 合格点
- 最終結果(合格/不合格)
- 各問題
- 回答の文字起こし
- 問題ごとの得点率
- 法令・規程の出典と参照箇所
- よく説明されている点
- 述べられていない点
- 誤り

「氏名」欄と「知識評価の対象」欄は、ダウンロード後にローカルで記入できるよう空欄のままにしてください。
ファイル名:Protocol_RSS_1256_YYYY-MM-DD.docx

【日付別Excel】
「履歴」セクションに、日付の選択欄と「日付別Excel出力」ボタンを追加してください。
列:
番号 | 試験日 | 開始時刻 | RSSコード | 職位/職種 | 所属部署 | 言語 | 問題数 | 合格点 % | 最終得点 % | 結果 | ステータス | 終了時刻 | 試験ID

氏名と社員番号は含めないでください。
Excelは、このコンピューターのローカル履歴のみから作成してください。
RSS <-> 氏名の対応表と結果の突き合わせは、社内環境の中でオフラインでのみ行うものとします。
Prompt 8. 個人情報監査とオフライン/クラウドの境界
本記事との関連:「第3段階:ポータブルなブラウザ型試験官」と「個人情報保護:氏名の代わりにRSSコード」の各節。
口述試験官アプリケーションの技術監査を行ってください。
ローカルの処理とクラウドの処理を、正直に切り分ける必要があります。

次の点を確認し、説明してください:
1. IndexedDB/localStorage にどのデータが保存されているか。
2. 文字起こしの際に、どのデータがクラウドモデルに送信されるか。
3. 意味的評価の際に、どのデータが送信されるか。
4. 問題案の生成の際に、どのデータが送信されるか。
5. 氏名、社員番号、従業員名簿、または RSS <-> 氏名の対応表が送信されていないか。
6. APIキーがどこに保存されているか。
7. バックアップにAPIキーが含まれていないか。
8. アプリケーションを完全に終了した後に、何が残るか。
9. ローカル履歴と出典文書を、どのように削除するか。
10. パイロット運用の段階で、どのようなリスクが残るか。

結果の表現に関する要件:
音声認識、評価、TTS、問題生成のいずれかがクラウドのAPIを使っている場合は、アプリケーションを「完全オフライン」と呼ばないでください。
正しい表現:「ローカルデータベースと管理されたクラウドAI領域を備えた、ローカルのポータブルなアプリケーション」。
Prompt 9. 単一インターフェースへの複数試験分野の追加
本記事との関連:「問題バンクの現在の構築方法」の節。ボットを切り替えることなく、一つの試験官で複数の規則や分野を扱います。
規則ごとに別々のボットを作る必要がなくなるよう、問題バンクと試験開始画面を改良してください。

各問題には、すでに「テーマ/分野」フィールドがあります。
試験画面に、分野の選択機能を追加してください:
- 一つのテーマ区分
- 複数のテーマ区分を同時に
- 「選択したすべての分野」モード

試験開始時には:
1. 承認済みの問題だけに絞り込む
2. 選択された言語を考慮する
3. 選択された分野を考慮する
4. プログラムの暗号論的乱数生成器で、指定された数の問題をランダムに選ぶ
5. できるだけ、選択された分野の間で問題を均等に配分する
6. 重複を許さない
7. 選択された組み合わせで問題数が足りない場合は、開始を中止し、わかりやすいメッセージを表示する

Word形式のプロトコルとExcelには、選択された試験分野もあわせて保存してください。
本記事の付録の使い方
付録の番号は本文と対応しています。本文では、該当する段階の近くに「Prompt …を参照」という直接の案内を置いています。一方ここでは、各プロンプトの下に、それが本記事のどの節に関係するかを記しています。
- Prompt 1 — 初期バージョン:最初の試験官と、300問から問題番号を選ぶ独自の生成ツールがどのように機能していたかを示します。
- Prompt 2 — 法令に基づく大規模な問題バンクの作成。
- Prompt 3 — バイブコーディングで現在のブラウザ版を再現したい読者のための、基本となる依頼文。
- Prompt 4 — アップロードした出典文書からの問題案の生成。
- Prompt 5–6 — AIによる意味の評価と、プログラムによる得点率計算の切り分け。
- Prompt 7 — WordとExcelの自動作成。
- Prompt 8 — ローカル領域とクラウド領域の境界の必須チェック。
- Prompt 9 — 複数の試験分野を一つのインターフェースに統合。
コメント 2
🤝