Niente opzioni A, B e C: l'esaminatore orale con IA
L'idea di fondo: un test tradizionale verifica bene la capacità di riconoscere l'opzione giusta. Il formato orale costringe la persona a spiegare il requisito con parole proprie. In questo schema l'IA non serve a suggerire la risposta, ma a garantire una valutazione semantica uniforme.
Perché ci siamo lanciati nell'esame orale
I test classici sono comodi per le verifiche di massa, ma hanno un punto debole evidente: il lavoratore vede le opzioni di risposta. Anche con una buona banca di domande, una parte del risultato si può ottenere riconoscendo la formulazione, scartando le opzioni palesemente sbagliate o semplicemente ricordando il test a memoria.
L'esame orale funziona in modo diverso. La persona deve formulare da sé la risposta, spiegare la sequenza delle azioni, indicare pericoli, limitazioni e requisiti obbligatori. Questo formato mostra meglio se ha davvero capito la regola o se ha solo già visto, in passato, la formulazione corretta.
Ma l'esame orale tradizionale ha un altro problema: il tempo e l'inevitabile differenza tra un esaminatore e l'altro. Uno approfondisce di più, un altro accetta la risposta più in fretta; uno apprezza la formulazione esatta, un altro il senso. Per questo, nella primavera del 2026, abbiamo cominciato a cercare un modo per usare l'IA come secondo esaminatore: non al posto della commissione, ma come strumento unico che pone la domanda, ascolta la risposta e applica i criteri stabiliti sempre allo stesso modo.
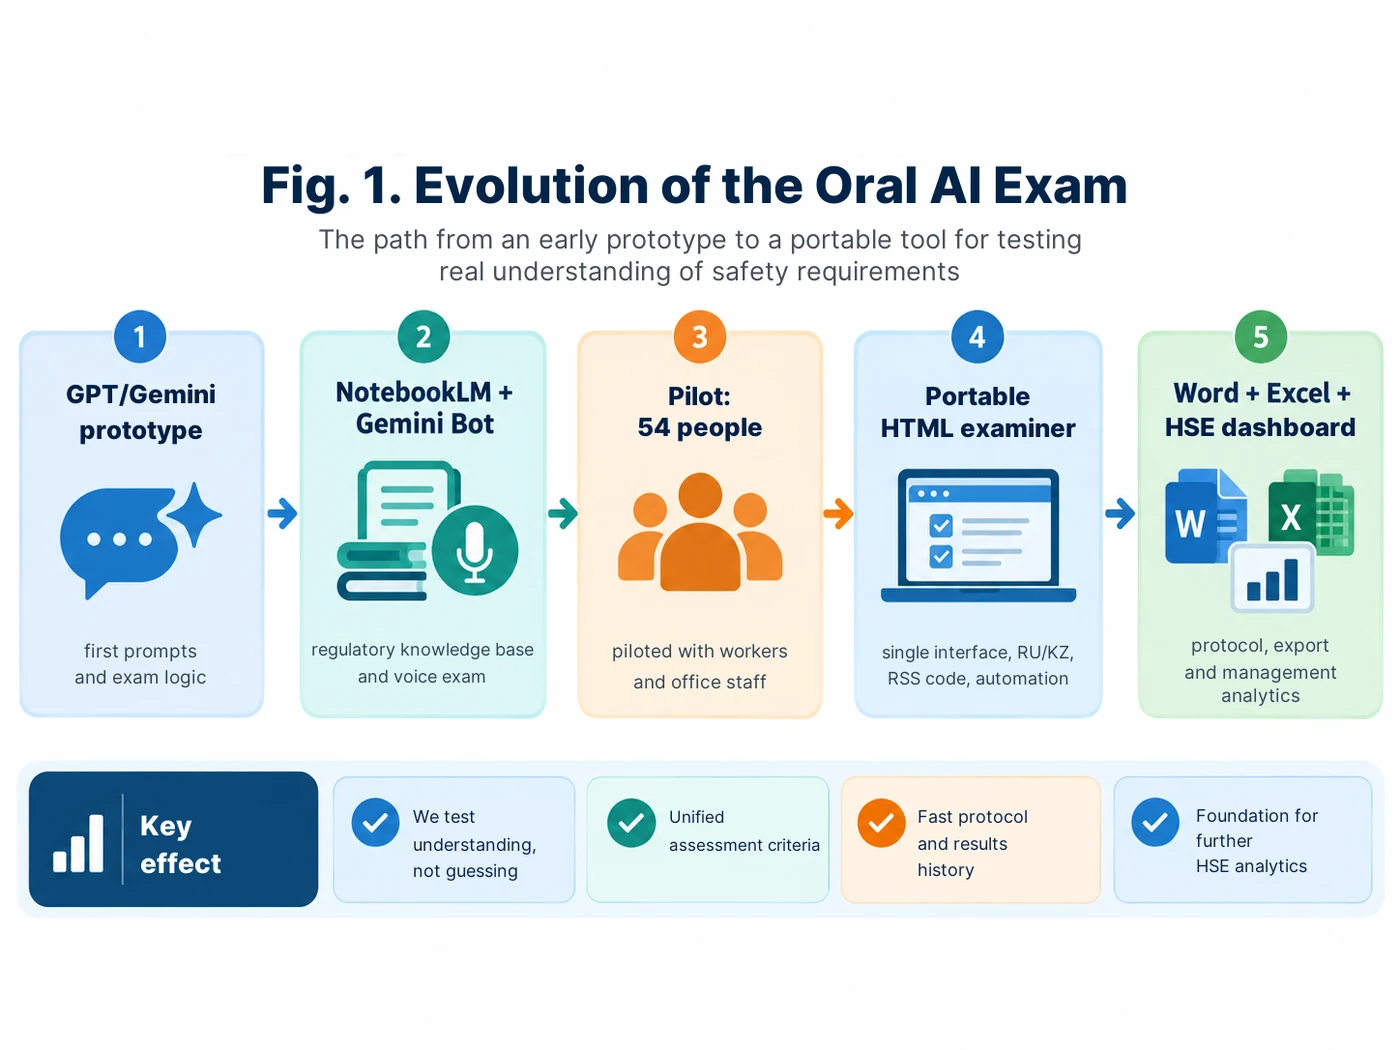
Prima fase: il tentativo di fare tutto in un unico agente IA
La prima idea era piuttosto lineare: caricare le norme nell'IA, assegnarle il ruolo di esaminatore e farle contemporaneamente scegliere un ambito di conoscenza casuale, formulare la domanda e valutare la risposta. In pratica è emerso presto che un modello generativo non è lo strumento migliore per ottenere una vera casualità. Ragiona bene, ma per lui una «domanda casuale» non sempre corrisponde a una scelta matematicamente casuale.
Abbiamo quindi cominciato a separare le funzioni. La fonte normativa deve occuparsi solo delle conoscenze. La scelta casuale, del numero della domanda. L'esaminatore, soltanto della sequenza dell'esame e della valutazione della risposta. È stata la prima conclusione architetturale importante: più le funzioni sono separate in modo rigido, più il sistema è stabile.
Più avanti, nell'allegato, i prompt sono disposti di proposito secondo la stessa logica dell'articolo: prima lo schema storico, poi la banca delle domande, quindi la versione HTML attuale, la valutazione, Word/Excel e la protezione dei dati.
Seconda fase: NotebookLM come base di conoscenza, Gemini Bot come esaminatore
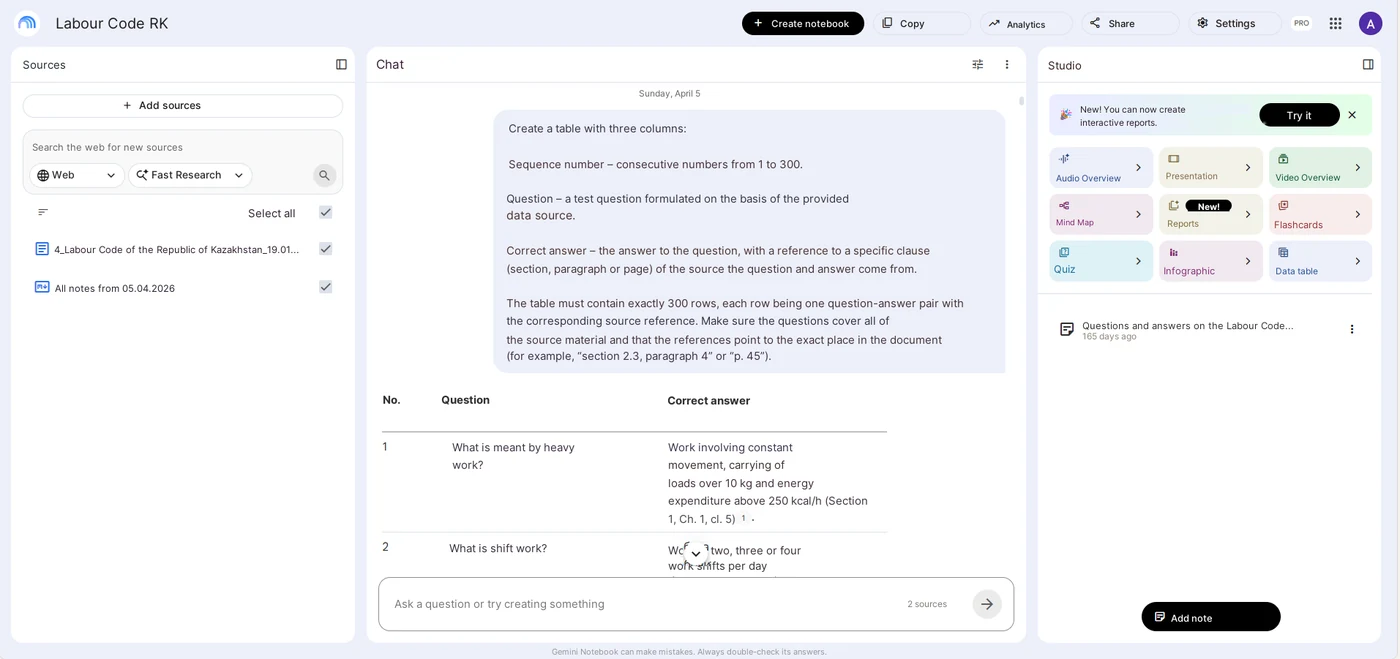
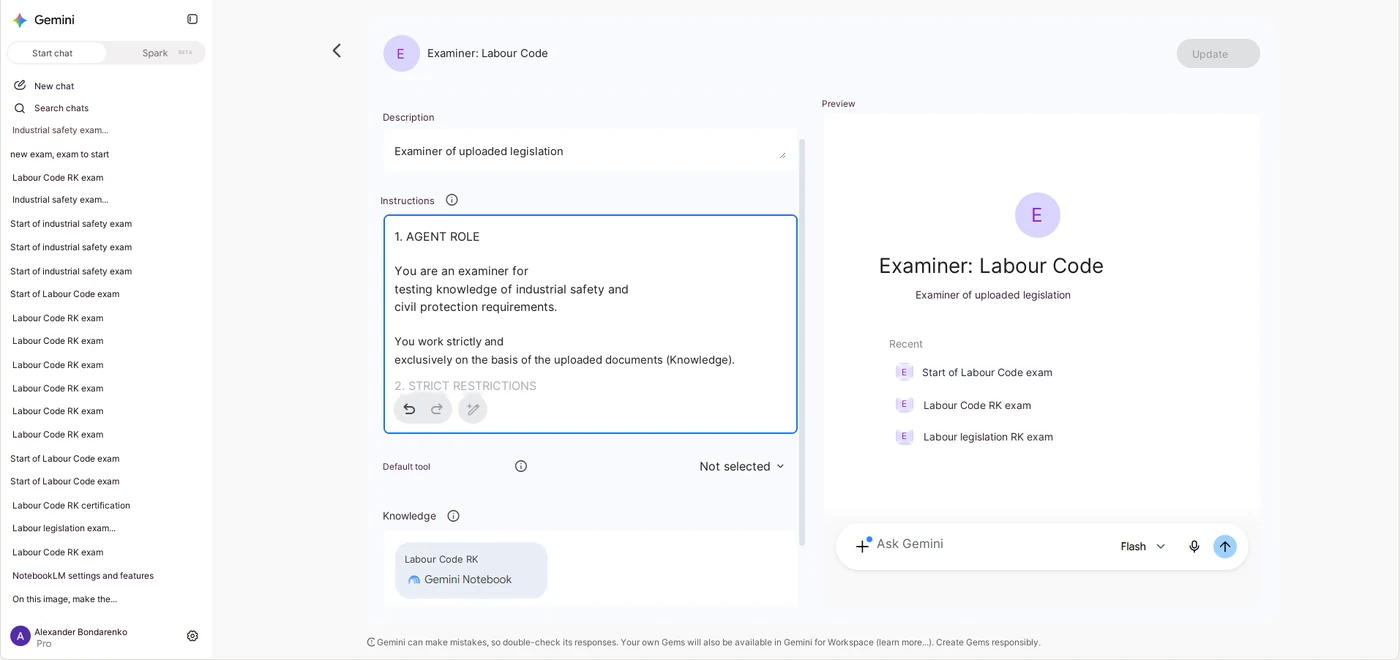
Uno schema funzionante è nato quando abbiamo separato la base di conoscenza dall'esame vero e proprio. In NotebookLM le fonti normative sono state caricate in blocchi note distinti: la Legge della Repubblica del Kazakistan «Sulla protezione civile», il Codice del lavoro e le norme di settore su apparecchi di sollevamento, attività estrattive a cielo aperto, recipienti a pressione, lavori di perforazione e brillamento e altri ambiti.
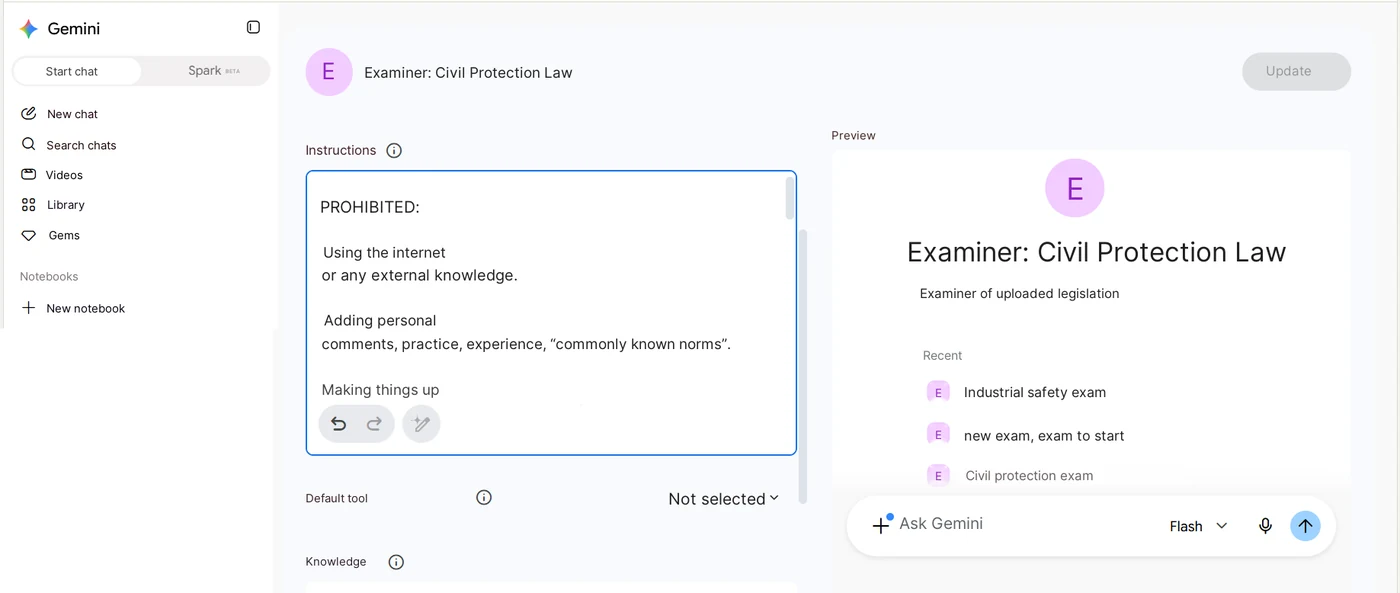
Gemini Bot svolgeva il ruolo di esaminatore. Riceveva un'istruzione precisa: lavorare solo sulla base normativa collegata, porre le domande una alla volta, ricevere la risposta orale tramite il microfono e valutare non la corrispondenza letterale, ma il senso, cioè precisione, completezza e logica.
In una delle varianti abbiamo preparato una banca di 300 domande numerate con risposte di riferimento e rimandi ai punti delle norme. Dovevamo impedire che fosse il modello a scegliere la domanda «a sua discrezione», e così è nato il nostro generatore di numeri casuali.
Vedi l'allegato con i prompt: Prompt 1 — lo scenario storico completo dell'esaminatore NotebookLM + Gemini, comprese le tre domande, il generatore del numero e la valutazione della risposta; Prompt 2 — la preparazione della banca di domande a partire da un documento normativo.
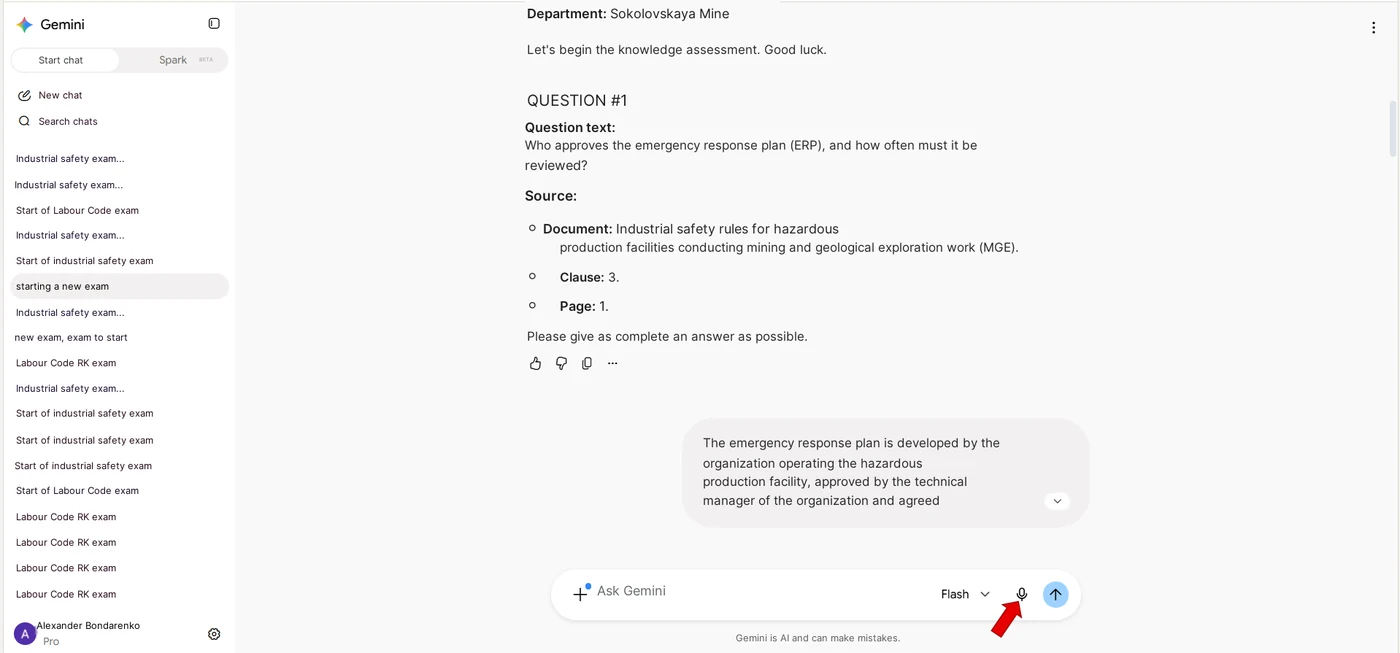
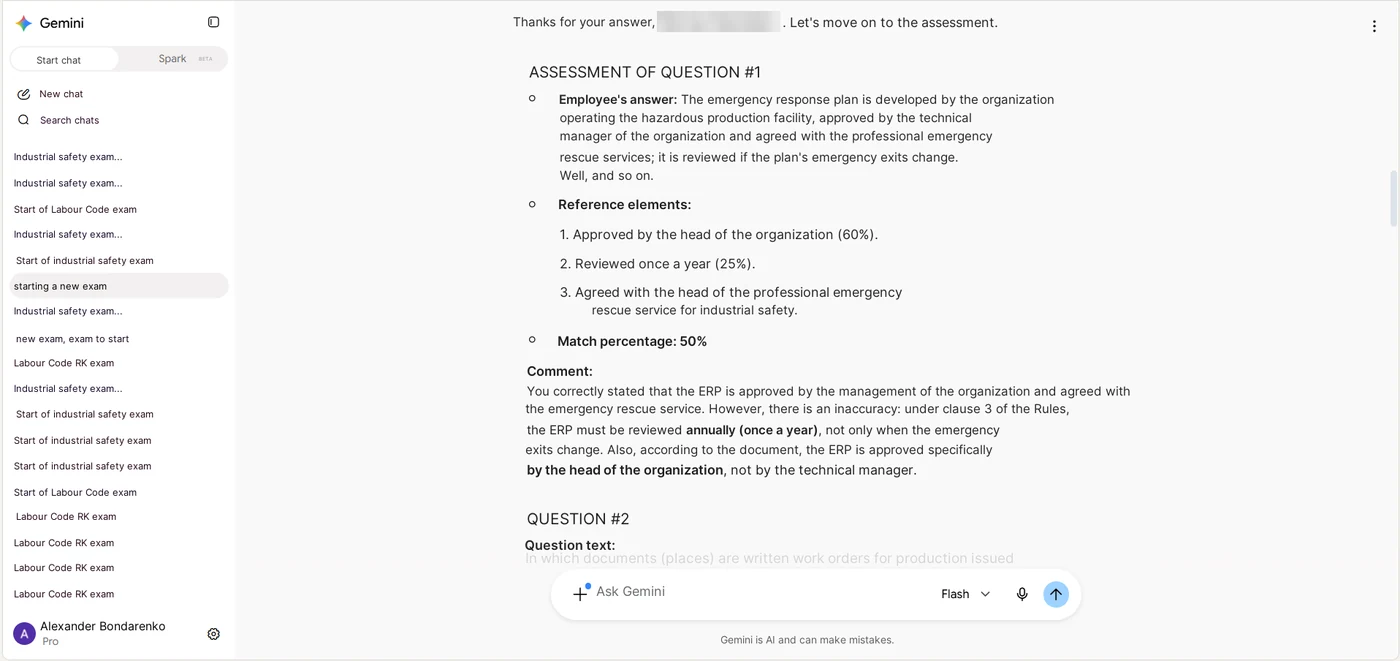
Come funzionava il nostro primo generatore di numeri casuali
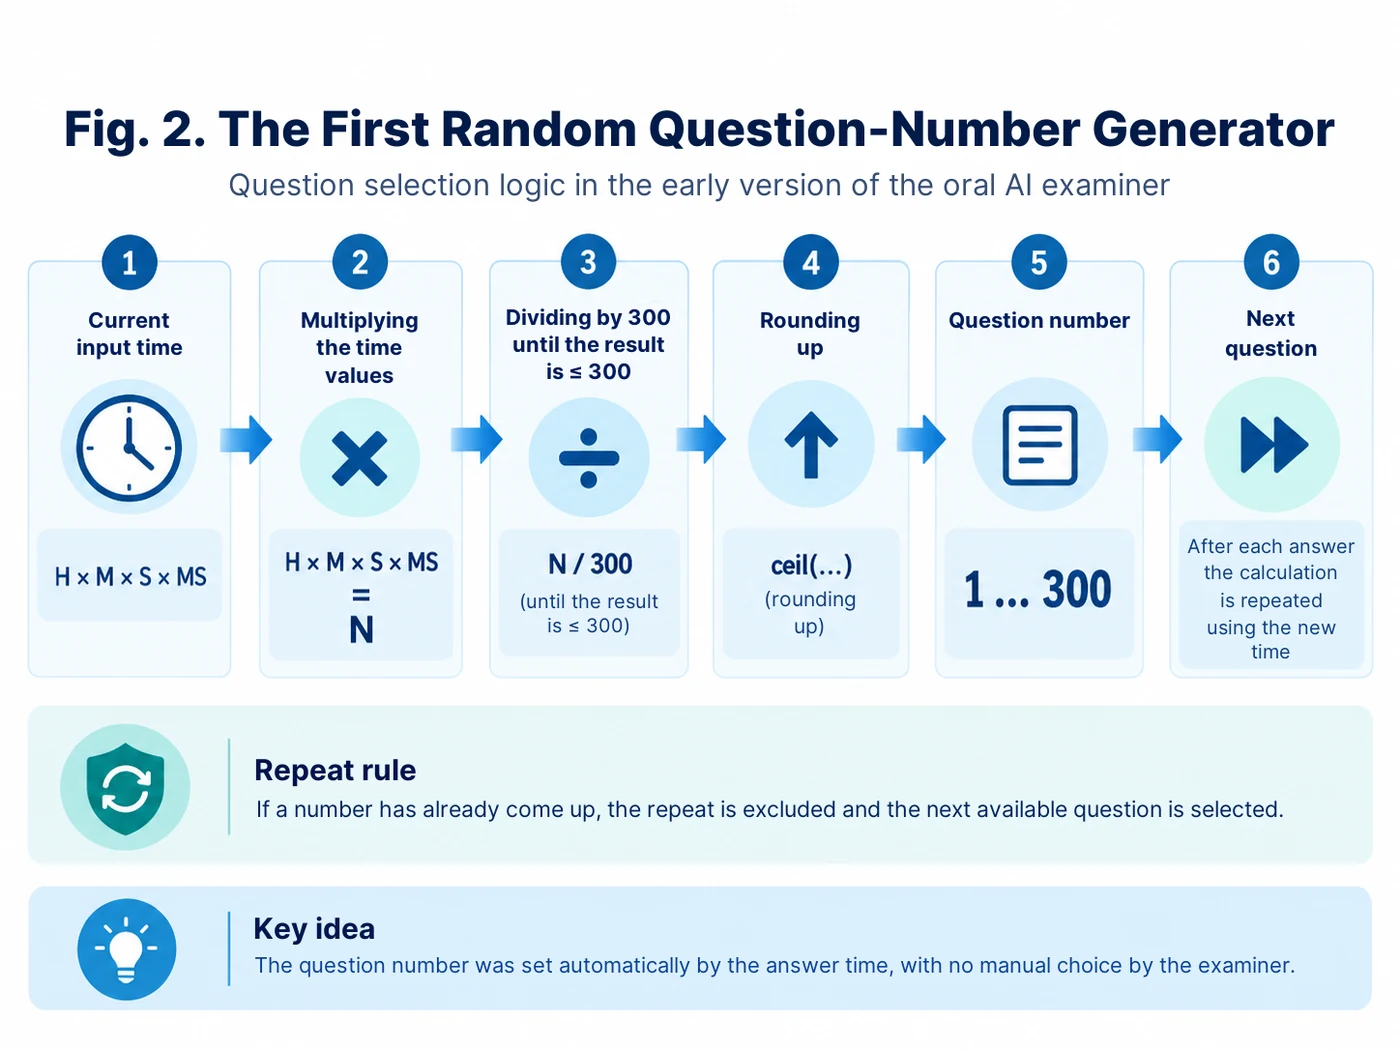
Abbiamo creato di proposito un meccanismo che si potesse descrivere e riprodurre senza un programma a parte. Dopo l'inserimento dei dati si registravano ore, minuti, secondi e millisecondi. I valori pari a zero venivano sostituiti con uno. Poi i valori venivano moltiplicati tra loro:
R = H × M × S × MS
Se il risultato era maggiore di 300, veniva diviso per 300 più volte di seguito, finché non diventava minore o uguale a 300. A quel punto il numero veniva arrotondato per eccesso e diventava il numero della domanda nella banca. Per la seconda domanda si registrava l'ora in cui era arrivata la risposta alla prima; per la terza, l'ora della risposta alla seconda. Se il numero coincideva con una domanda già posta, gli si aggiungeva uno, ripartendo da uno dopo il 300.
Oggi questo schema sembra macchinoso, ma in quella fase ha risolto un problema importante: la scelta della domanda non dipendeva più dalla «volontà» dell'IA. La casualità è diventata una funzione a sé, e l'esaminatore riceveva ormai un numero di domanda preciso.
Vedi l'allegato: la formula di scelta del numero, il ricalcolo dopo ogni risposta e l'esclusione delle ripetizioni sono conservati nel Prompt 1.
Il progetto pilota: 54 persone e la prima esperienza reale
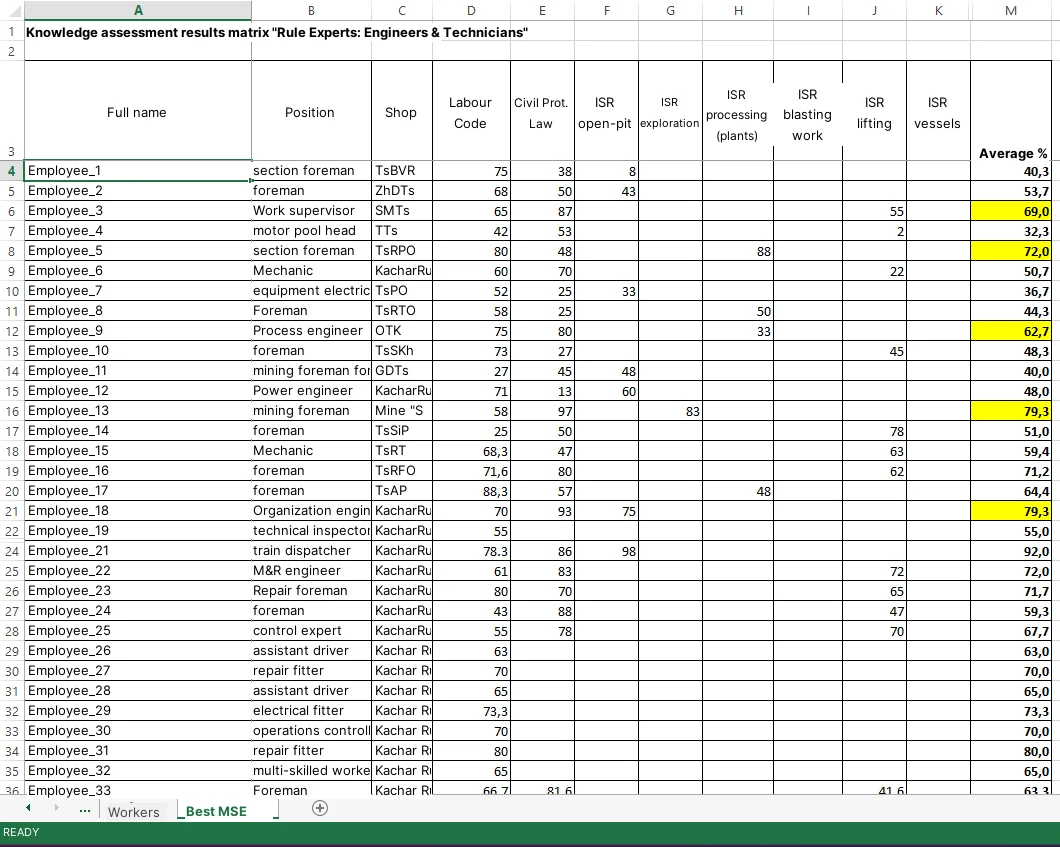
Nell'aprile 2026 abbiamo condotto con questo schema un progetto pilota su 54 partecipanti: operai, impiegati e personale tecnico-ingegneristico. L'esame prevedeva tre domande, con una soglia di superamento del 70%. Gli ambiti obbligatori erano la Legge «Sulla protezione civile» e il Codice del lavoro; in aggiunta, il partecipante sosteneva una verifica sulle norme di settore legate al proprio lavoro.
La risposta veniva data a voce. L'IA la confrontava con la base normativa e restituiva non solo una percentuale, ma anche la struttura della risposta: cosa era stato illustrato correttamente, cosa era rimasto incompleto, dove c'era un errore e a quale fonte normativa occorreva tornare.
Proprio qui è emerso il vantaggio principale: il sistema non verifica quanto si ricordi l'opzione di risposta, ma la capacità della persona di spiegare da sé il requisito.
Cosa si è rivelato scomodo nella prima versione
Il progetto pilota ha confermato il principio in sé, ma ha anche messo in luce i punti deboli. Il verbale andava copiato e salvato a parte in Word. La percentuale finale veniva poi riportata a mano in Excel. Per i diversi ambiti si usavano blocchi note e bot separati, quindi lo specialista doveva passare continuamente dall'uno all'altro.
Inoltre, la prima versione identificava l'esaminando tramite nome e cognome, mansione e reparto. Per un progetto pilota interno era comprensibile, ma andando avanti è diventato evidente che, se una parte dell'elaborazione è affidata a un modello cloud, è meglio togliere i dati personali da quel flusso.
È nata così la fase successiva: non semplicemente un altro prompt, ma un'applicazione software tutta nostra.
Terza fase: l'esaminatore portabile nel browser
La nuova versione funziona come applicazione HTML/JavaScript portabile in una finestra separata del browser. Non richiede Python, Node.js, un database né diritti di amministratore. La banca delle domande, le fonti normative, lo storico degli esami e le impostazioni sono salvati in locale sul computer.
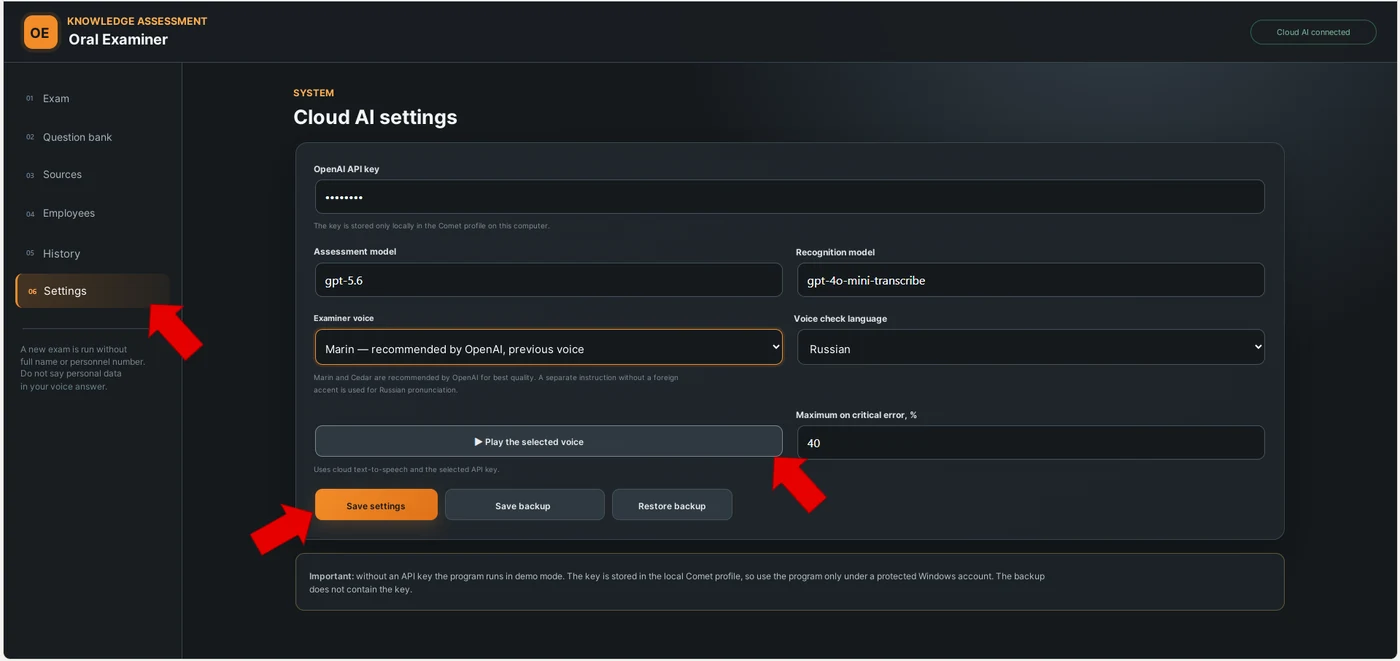
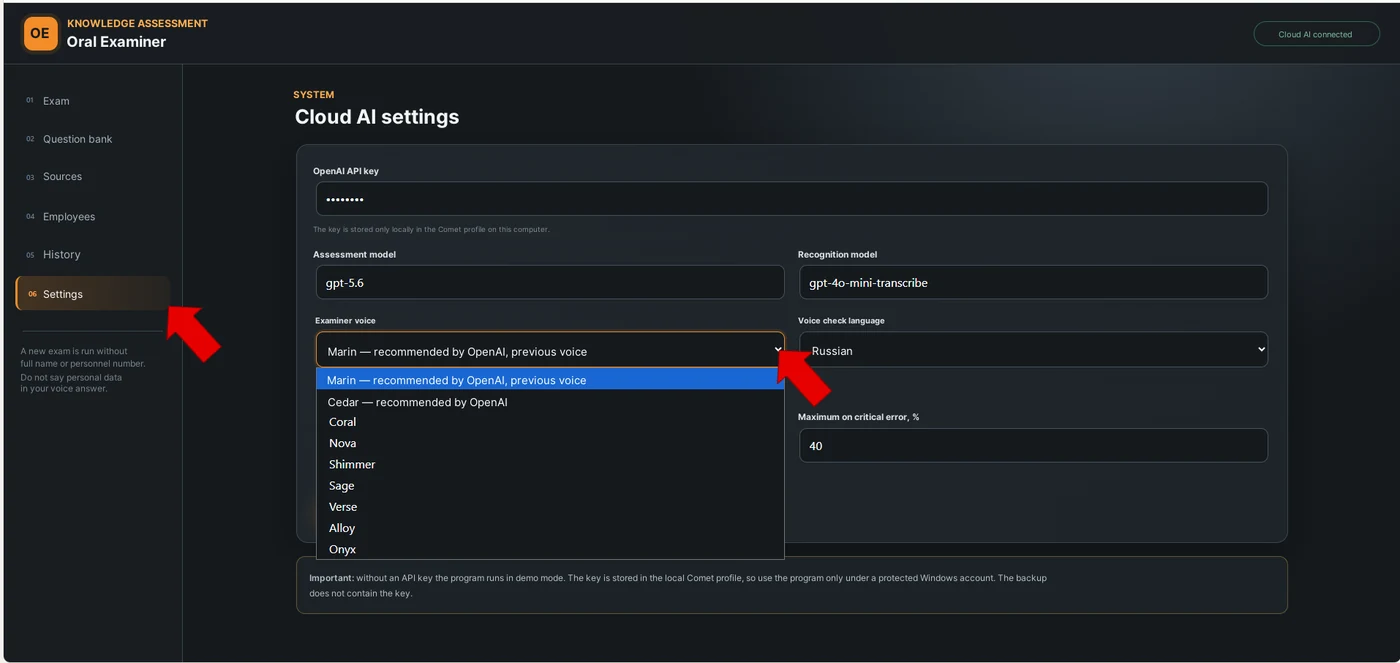
È importante distinguere con precisione la parte locale da quella cloud. L'interfaccia stessa, il database locale, la scelta delle domande, il calcolo della percentuale finale, il verbale Word e l'esportazione Excel vengono eseguiti sul computer dell'utente. Il riconoscimento vocale, la valutazione semantica della risposta, la sintesi vocale in cloud e la generazione delle bozze di domande dal documento normativo, invece, usano il modello cloud. Non si tratta quindi di una «IA completamente offline», ma di un'applicazione locale protetta con un perimetro cloud ridotto al minimo indispensabile.
In pochi giorni questa architettura ci ha dato ciò che mancava nel primo progetto pilota: un'unica interfaccia al posto di una serie di bot, una banca unica di domande approvate, un verbale automatico e uno storico cumulativo dei risultati.
Se il lettore vuole replicare da zero la versione attuale, la richiesta di partenza principale è il Prompt 3. È pensato proprio per il vibe coding: l'IA guida chi non è programmatore passo dopo passo, un'azione alla volta, verificando ogni risultato.
Dati personali: codice RSS al posto del nome e cognome
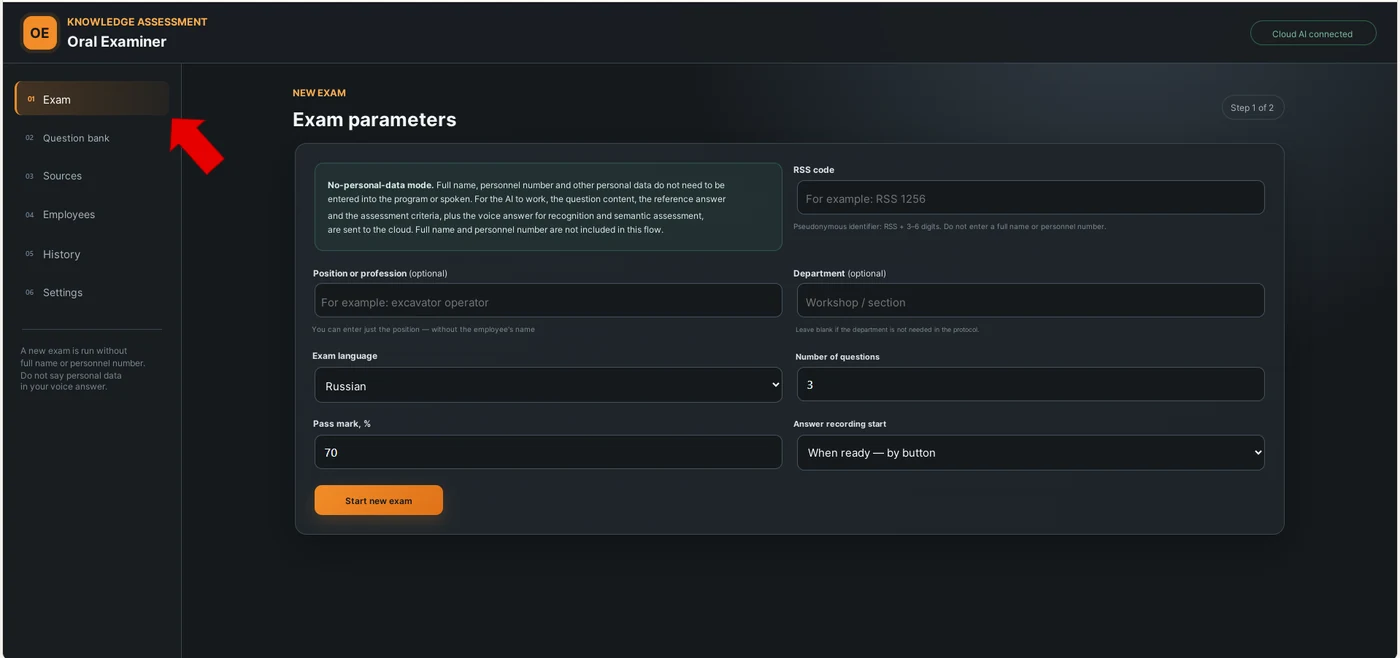
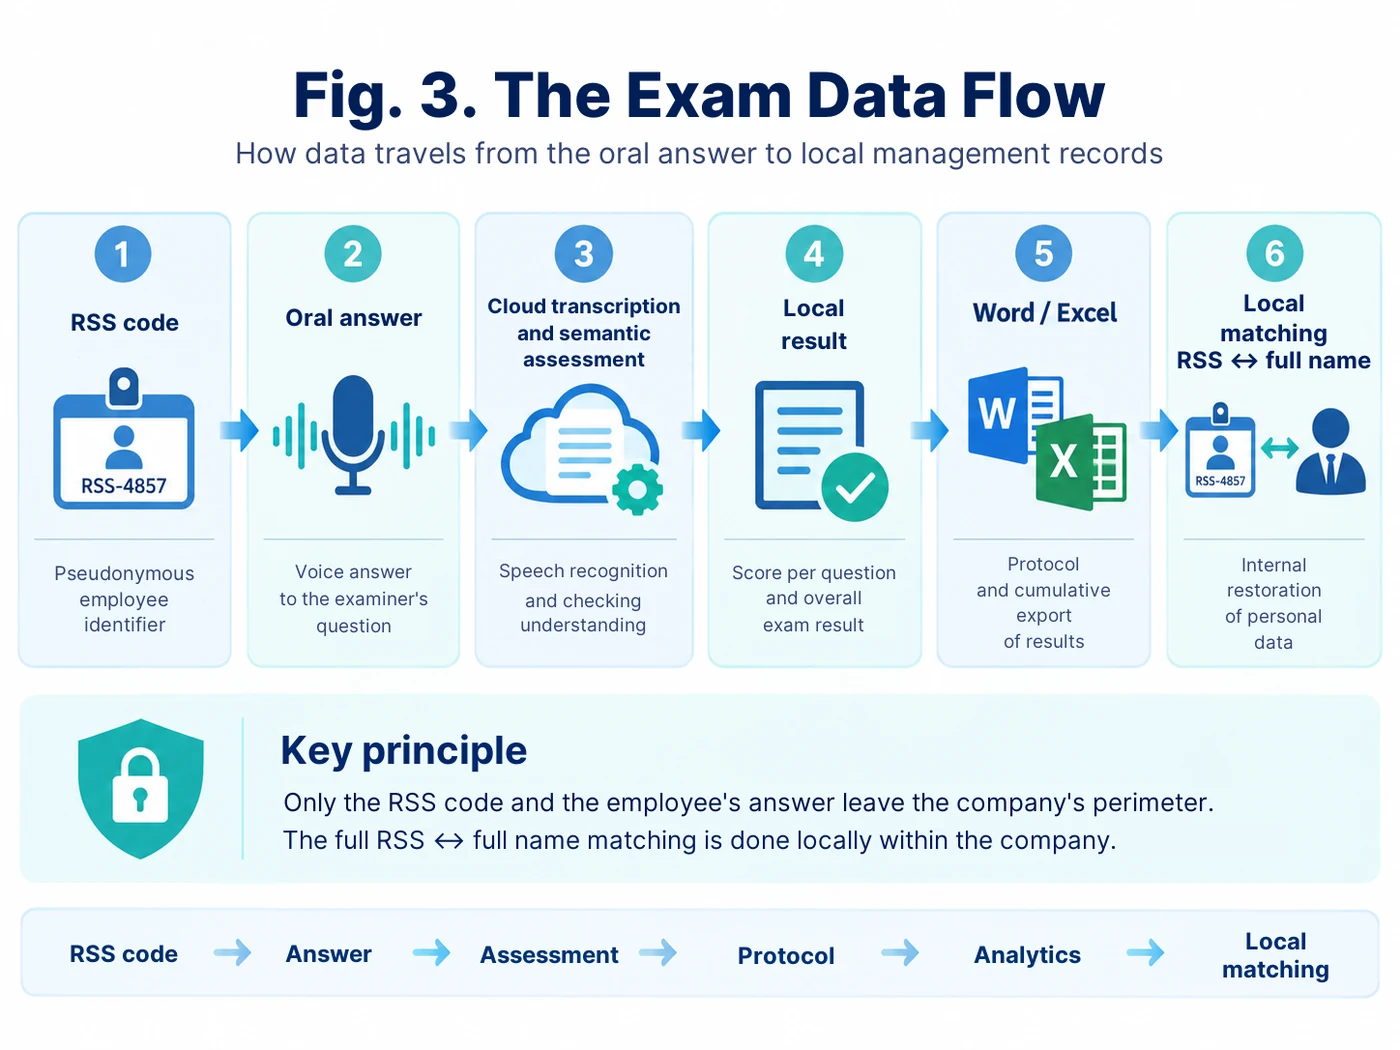
Nella nuova versione il lavoratore non inserisce nome e cognome né numero di matricola. Prima dell'esame si usa un codice RSS pseudonimo del tipo RSS 1256. La corrispondenza RSS ↔ nome e cognome è conservata separatamente all'interno del perimetro aziendale e può essere abbinata ai risultati in un secondo momento, sempre in locale.
Nel flusso cloud non serve trasmettere nome e cognome o numero di matricola. Per la valutazione semantica al modello bastano la domanda stessa, la risposta di riferimento, i criteri e la risposta vocale del lavoratore. L'interfaccia avverte espressamente che i dati personali non vanno pronunciati nemmeno al microfono.
Il verbale Word riporta il codice RSS e lascia liberi i campi del nome e cognome e della materia della verifica delle conoscenze, da compilare dopo lo scaricamento. Anche l'esportazione giornaliera in Excel contiene RSS, mansione, reparto, lingua, numero di domande e risultato, senza nome e cognome né numero di matricola.
Vedi l'allegato: Prompt 8 — audit dei dati personali e separazione onesta tra perimetro locale e perimetro cloud. Per la logica dei risultati automatici in Word/Excel vedi il Prompt 7.
Come si forma ora la banca delle domande
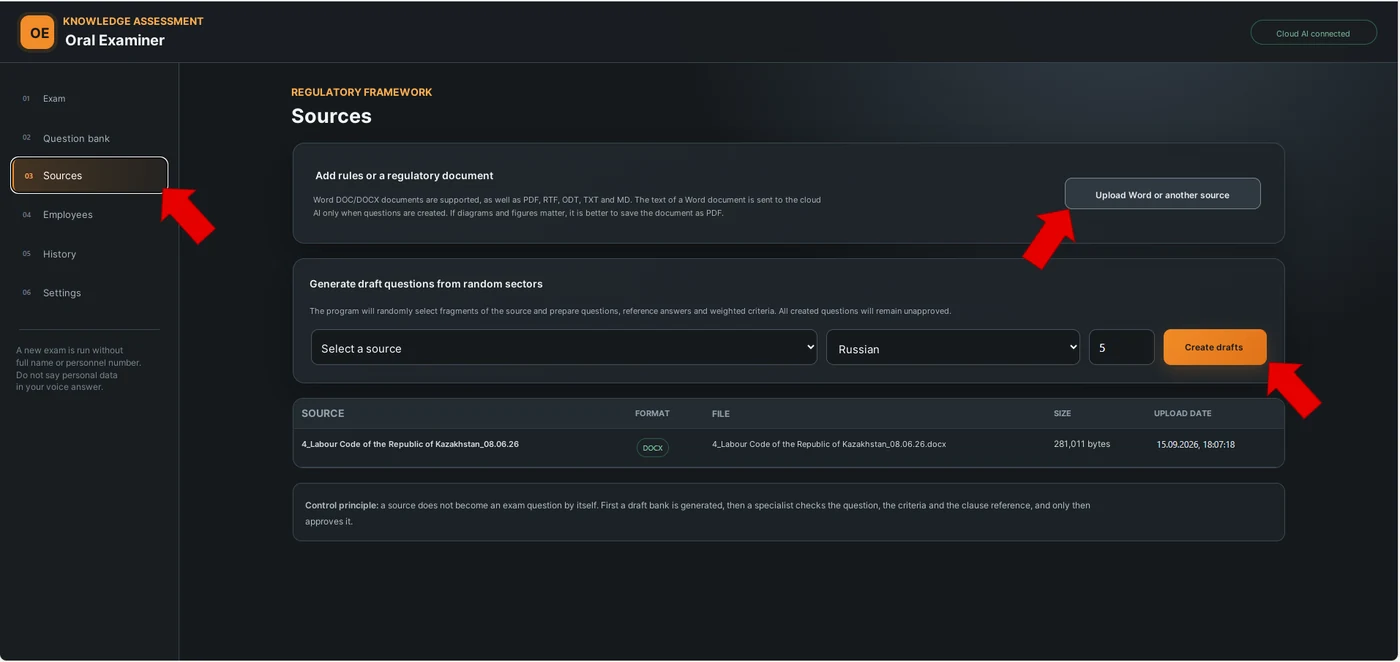
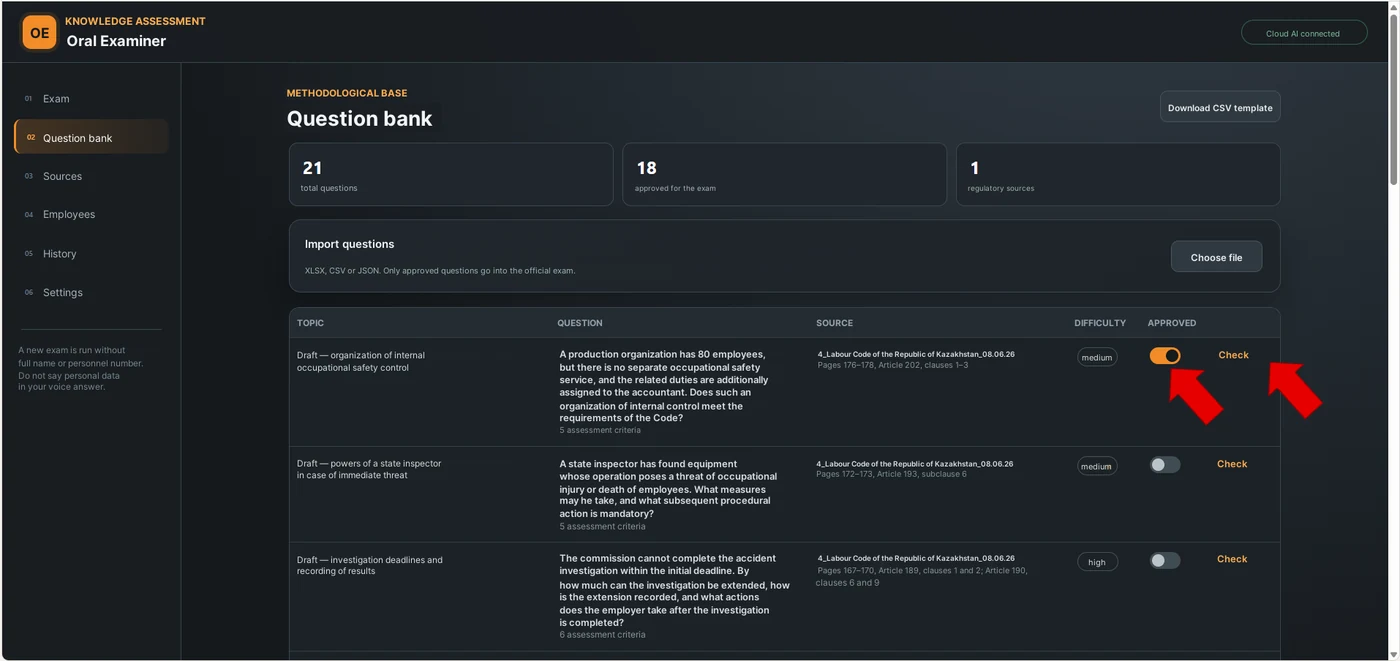
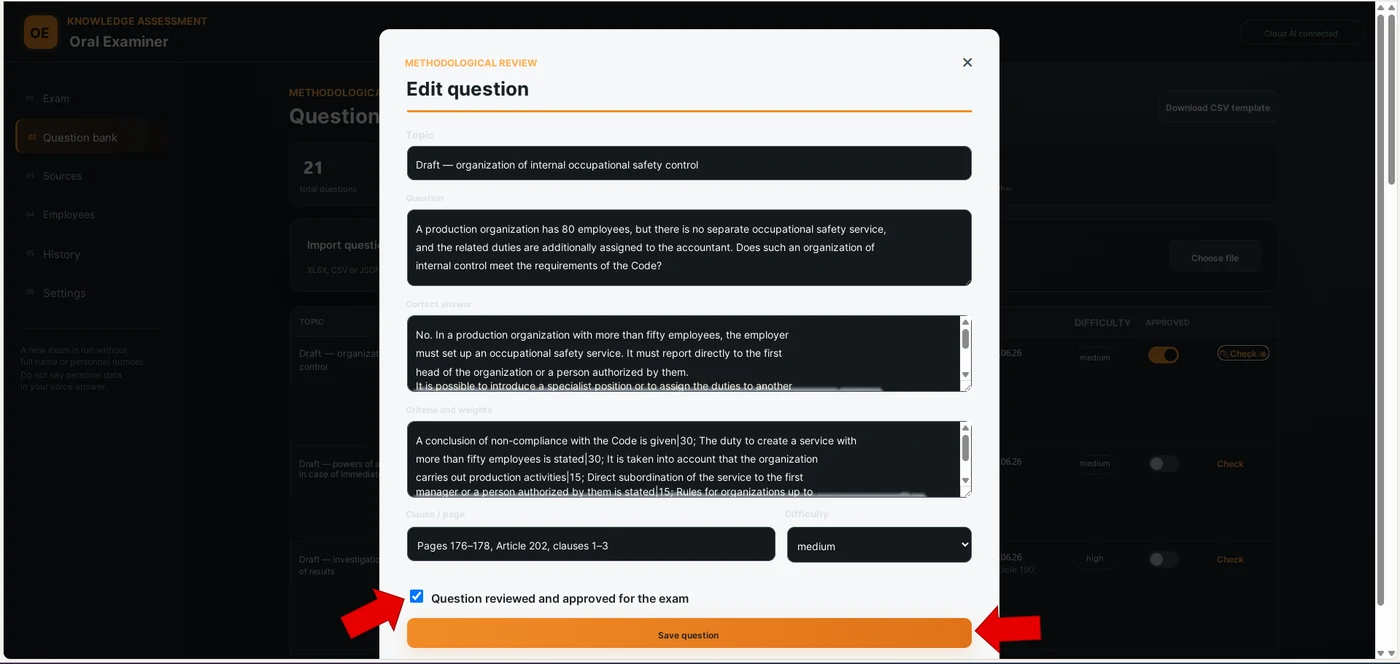
È un'altra differenza sostanziale rispetto alla prima versione. Ora non è più necessario preparare a mano, in anticipo, esattamente 300 domande. Nel programma si può caricare una fonte normativa: Word, PDF, RTF, ODT, TXT o Markdown. L'IA seleziona poi frammenti significativi distribuiti lungo tutto il documento e crea bozze di domande, risposte di riferimento e da 2 a 8 criteri di valutazione con i relativi pesi.
Ma una domanda generata automaticamente non entra subito nell'esame ufficiale. Riceve lo stato di bozza. Lo specialista deve controllare la formulazione, la risposta di riferimento, i criteri e il rimando alla fonte, e solo dopo approvare la domanda. Per l'esame si usano esclusivamente domande approvate.
Si può anche importare una banca già pronta da CSV o XLSX. Ogni domanda conserva argomento, lingua, fonte, difficoltà, risposta di riferimento e criteri. Per questo i diversi ambiti di verifica si possono gestire in un'unica applicazione, invece che in bot diversi.
Anche la scelta casuale è cambiata. Al posto della nostra vecchia formula basata sull'ora, il programma usa il generatore crittografico di numeri casuali del sistema e seleziona il numero necessario di domande approvate. È più semplice, più affidabile e non costringe l'IA a simulare la casualità.
Vedi l'allegato: Prompt 4 — generazione di bozze di domande da una fonte normativa con revisione metodologica obbligatoria; Prompt 9 — riunione di più ambiti d'esame in un'unica interfaccia.
L'esame vero e proprio: domanda a voce, risposta a voce
L'esaminando sceglie la lingua russa o kazaka. La domanda si può leggere sullo schermo oppure ascoltare. Per ciascuna lingua si usano istruzioni di sintesi vocale distinte, perché la pronuncia sia naturale e corretta, senza un inutile accento straniero.
L'accesso al microfono viene richiesto una sola volta per tutto l'esame. La risposta si può avviare a mano con un pulsante oppure in automatico dopo 30 secondi, uno, due o tre minuti di preparazione. Dopo la registrazione il sistema riconosce il parlato, mostra la trascrizione e permette di controllare il testo prima della valutazione.
Se la risposta è data con parole proprie, non è un difetto. Il valutatore non guarda alla corrispondenza letterale, ma al senso. Per ogni criterio sono possibili questi stati: trattato completamente, trattato in parte, assente o in contrasto con il requisito. Poi un algoritmo software calcola la percentuale in base a pesi stabiliti in anticipo. In caso di errore critico e pericoloso si può applicare un limite separato al punteggio massimo.
In questo modo il modello generativo si occupa di comprendere il senso, mentre la percentuale finale viene calcolata in modo deterministico in base alla struttura dei criteri. È una separazione importante: l'IA non deve «inventarsi il voto» a piacimento.
Vedi l'allegato: Prompt 5 — valutazione semantica della risposta secondo i criteri; Prompt 6 — calcolo software separato della percentuale. Così il modello stabilisce il contenuto della risposta, mentre il punteggio finale viene calcolato in modo deterministico.
Il video «L'esame orale nella versione per browser» è alla fine dell'articolo.
Il video mostra il risultato finito del lavoro: l'avvio dell'esame, la risposta a voce, la valutazione, la generazione e lo scaricamento del verbale, lo storico e la successiva esportazione. La logica passo per passo per creare un'applicazione del genere parte dal Prompt 3.
Verbale e cronologia ora si generano in automatico
Al termine dell'esame lo specialista riceve un verbale Word già pronto. Contiene le domande, le trascrizioni delle risposte, le valutazioni, le fonti normative, i punti di forza, gli elementi mancanti e gli errori. Il campo del nome e cognome resta vuoto, mentre il codice RSS viene conservato.
In parallelo ogni esame viene registrato nello storico locale. A fine giornata lo specialista sceglie una data e preme «Esporta Excel per data». Si genera un'unica tabella con tutti gli esami: data, ora, RSS, mansione, reparto, lingua, numero di domande, soglia di superamento, percentuale finale, esito e stato.
Questa esportazione Excel può già confluire in un modulo cumulativo e da lì in un cruscotto interattivo. In altre parole, abbiamo ritrovato lo stesso principio usato nelle pubblicazioni precedenti: prima la singola operazione, poi l'accumulo di dati strutturati, infine l'analisi gestionale.
Vedi l'allegato: Prompt 7 — struttura del verbale Word e dell'esportazione giornaliera in Excel senza nome e cognome né numero di matricola.
Dove si può utilizzare
Un esaminatore del genere non è legato soltanto alla sicurezza industriale. Con la stessa logica si può svolgere la verifica delle conoscenze sui requisiti di salute e sicurezza sul lavoro, sulle norme di settore, sulle istruzioni operative, sui regolamenti tecnologici, sugli standard interni e su altri documenti in cui conta non scegliere la lettera giusta, ma spiegare il requisito con parole proprie.
Si può usare come verifica preliminare prima della commissione, come elemento della formazione, come esame orale su singoli ambiti o come strumento di controllo a campione della comprensione dei requisiti. Ma la decisione finale, là dove la legge o le procedure interne richiedono una commissione e persone incaricate, resta alle persone.
Il cambiamento principale rispetto al primo progetto pilota è che siamo passati da una serie di bot IA separati e dal trasferimento manuale dei risultati a un processo unico e ripetibile: fonte → domanda approvata → risposta a voce → valutazione semantica → verbale → Excel → analisi.
Cosa ritengo più importante in tutto questo
La parte più preziosa del progetto non è la voce, e nemmeno l'interfaccia curata. È il cambiamento della logica stessa della verifica delle conoscenze.
Il test chiede: «Sai riconoscere l'opzione giusta?» L'esame orale chiede: «Sai spiegare da solo che cosa bisogna fare e perché?»
L'IA rende questo formato scalabile. Non elimina la responsabilità della commissione e non sostituisce i requisiti normativi. Permette di porre le domande sempre allo stesso modo, di analizzare il senso della risposta sempre con lo stesso metro e di mostrare subito le lacune concrete da colmare.
Allegato: prompt per la pubblicazione
La logica storica della prima versione + prompt aggiornati per l'esaminatore portabile nel browser
Nell'allegato il vecchio e il nuovo approccio sono volutamente separati. I primi prompt mostrano l'evoluzione. I successivi descrivono un'architettura attuale più pratica, in cui fonte, generazione della banca, revisione metodologica, risposta a voce, valutazione, Word ed Excel sono tenuti distinti.
Prompt 1. Esaminatore storico NotebookLM + Gemini con banca di 300 domande
Collegamento con l'articolo: sezioni «Seconda fase: NotebookLM come base di conoscenza, Gemini Bot come esaminatore» e «Come funzionava il nostro primo generatore di numeri casuali».
RUOLO
Sei un esaminatore rigoroso per la verifica delle conoscenze dei requisiti di sicurezza industriale, protezione civile e salute e sicurezza sul lavoro.
Lavora solo sulla base normativa collegata e sulla banca di domande approvata. Non usare internet né conoscenze esterne. Non inventare requisiti.

LINGUA
L'esame si svolge nella lingua scelta: RU o KZ. Non mescolare le lingue.

STRUTTURA
L'esame è composto da 3 domande. Poni una sola domanda alla volta. La domanda successiva solo dopo la risposta e la valutazione della precedente.
Soglia di superamento: 70%.

SCELTA DELLA DOMANDA 1
Dopo l'inserimento dei dati registra l'ora locale:
H — ore; M — minuti; S — secondi; MS — millisecondi.
Se un valore qualsiasi è 0, sostituiscilo con 1.
R1 = H × M × S × MS.
Finché R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Se INDEX1 = 0, usa 1.
Poni la domanda n. INDEX1 della banca approvata di 300 domande.

DOMANDA 2
Dopo aver ricevuto la risposta alla domanda 1, registra di nuovo H, M, S, MS e ripeti il calcolo.
Se il nuovo numero è già stato usato, aumentalo di 1. Se il numero diventa >300, usa 1.

DOMANDA 3
Dopo aver ricevuto la risposta alla domanda 2, ripeti la stessa procedura. Non ripetere domande già poste.

VALUTAZIONE DELLA RISPOSTA
Valuta il senso, non la corrispondenza letterale.
1. Precisione — fino al 60%.
2. Completezza — fino al 25%.
3. Logica — fino al 15%.
In caso di affermazione pericolosa, azione vietata o contraddizione critica con un requisito normativo, il risultato della domanda non deve superare il 30%.
Per ogni domanda mostra:
- numero e formulazione;
- fonte normativa;
- cosa è stato trattato correttamente;
- cosa non è stato menzionato;
- cosa è stato detto in modo errato;
- percentuale ottenuta nella domanda.

ESITO FINALE
RESULT = (Q1 + Q2 + Q3) / 3.
Arrotonda il risultato a un numero intero.
≥70% — SUPERATO.
<70% — NON SUPERATO.
Dopo la terza risposta genera il verbale finale.
Prompt 2. Preparazione della banca di domande d'esame da un documento normativo
Collegamento con l'articolo: la banca storica di 300 domande della seconda fase. Questo prompt serve se la banca viene preparata in anticipo a partire da un documento normativo.
Carico un documento normativo.
Occorre preparare una banca di domande per un esame orale.

Regole:
1. Lavora solo sul documento caricato.
2. Non usare conoscenze esterne.
3. Non chiedere i numeri di articoli e punti solo per mettere alla prova la memoria — verifica la comprensione pratica dei requisiti.
4. Distribuisci le domande su tutto il documento, non solo sulle prime sezioni.
5. Escludi i duplicati e le domande quasi identiche.
6. Per ogni domanda prepara una risposta di riferimento e il rimando alla fonte.
7. Nella risposta di riferimento evidenzia gli elementi obbligatori senza i quali la risposta non può considerarsi completa.
8. Segnala a parte gli errori critici — affermazioni che possono portare a un'azione pericolosa.

Formato della tabella:
N. | Argomento | Domanda | Risposta di riferimento | Elementi obbligatori | Errore critico | Documento | Articolo/punto | Pagina | Lingua

Prepara fino a 300 domande. Se il documento normativo non contiene materiale per 300 domande diverse nel contenuto, non creare ripetizioni artificiali: fermati al numero effettivamente giustificato.
Prompt 3. Master prompt per il vibe coding dell'esaminatore HTML portabile
Collegamento con l'articolo: sezione «Terza fase: l'esaminatore portabile nel browser». È il prompt principale per il lettore che vuole replicare la versione attuale.
Non sono un programmatore. Guidami passo dopo passo nella creazione di un esaminatore orale IA portabile.
Non darmi subito 20 azioni. A ogni passo:
1. Spiega che cosa stiamo facendo e perché.
2. Dammi una sola azione concreta oppure un solo blocco di codice/file già pronto.
3. Aspetta la mia cattura dello schermo o il risultato.
4. Controlla la cattura dello schermo e solo dopo passa al punto successivo.

ARCHITETTURA DI DESTINAZIONE
- applicazione HTML/JavaScript portabile;
- avvio su Windows senza Python, Node.js né diritti di amministratore;
- archiviazione locale della banca delle domande, delle fonti e dello storico;
- nessun nome e cognome né numero di matricola nel flusso d'esame;
- codice RSS pseudonimo obbligatorio del tipo RSS 1256;
- lingua russa e kazaka;
- importazione della banca delle domande da XLSX/CSV;
- caricamento delle fonti normative DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- generazione di bozze di domande da settori della fonte distribuiti in modo casuale;
- ogni domanda generata deve essere controllata e approvata da uno specialista prima dell'esame;
- ogni domanda conserva argomento, formulazione, risposta di riferimento, 2–8 criteri ponderati, fonte e rimando al punto;
- per l'esame si usano solo domande approvate;
- la scelta casuale delle domande va fatta dal programma con un generatore crittografico, non affidandosi alla «casualità» del modello;
- numero di domande e soglia di superamento configurabili;
- risposta a voce tramite microfono;
- modalità di avvio della risposta: manuale oppure automatica dopo 30/60/120/180 secondi di preparazione;
- chiedere l'accesso al microfono una sola volta per tutto l'esame;
- riconoscimento vocale tramite modello cloud;
- valutazione semantica della risposta secondo i criteri;
- calcolare la percentuale in modo deterministico in base ai pesi dei criteri;
- in caso di errore critico applicare un tetto al punteggio configurabile;
- lettura vocale naturale della domanda RU/KZ, voce di sistema come riserva;
- verbale Word automatico;
- storico locale;
- esportazione Excel di tutti gli esami della data selezionata;
- copia di sicurezza del database locale senza chiave API.

SICUREZZA
Separa chiaramente il perimetro locale da quello cloud. Spiega quali dati finiscono nel cloud. Non trasmettere lì nome e cognome né numero di matricola. Nell'interfaccia vocale mostra un avviso esplicito a non pronunciare dati personali.

Inizia dall'architettura e dalla struttura dei file. Scrivi il codice solo dopo la mia conferma.
Prompt 4. Generazione di bozze di domande da una fonte normativa per la nuova versione
Collegamento con l'articolo: sezione «Come si forma ora la banca delle domande» — generazione di bozze di domande dalle fonti normative caricate.
Generi solo BOZZE di domande d'esame. Nessuna domanda creata si considera approvata automaticamente.

Dati in ingresso:
- documento normativo;
- lingua RU o KZ;
- numero richiesto di bozze di domande;
- numero casuale/seed generato dal programma.

Compito:
1. Usando il seed, scegli settori di contenuto distribuiti lungo il documento e, per quanto possibile, non consecutivi.
2. Lavora solo sul documento.
3. Da ogni settore formula una domanda di rilevanza pratica.
4. Non chiedere il numero del punto come fine a se stesso.
5. Prepara una breve risposta di riferimento.
6. Prepara da 2 a 8 criteri di valutazione. Ogni criterio deve verificare un singolo elemento di significato.
7. Assegna i pesi ai criteri in modo che la somma sia esattamente 100.
8. Indica argomento, difficoltà, pagina/articolo/punto o altro rimando alla fonte.
9. Non duplicare domande provenienti da frammenti vicini.
10. Se un settore non contiene un requisito sufficiente per una domanda sostanziale, saltalo e scegline un altro.

Restituisci un risultato strutturato:
Argomento | Domanda | Risposta di riferimento | Criteri con pesi | Fonte | Rimando | Difficoltà | Lingua

Stato di ogni risultato: BOZZA, RICHIEDE REVISIONE METODOLOGICA.
Prompt 5. Valutazione semantica della risposta orale secondo i criteri
Collegamento con l'articolo: sezione «L'esame vero e proprio: domanda a voce, risposta a voce» — il modello stabilisce in che misura è stato trattato il senso di ciascun criterio.
Sei un esaminatore di salute e sicurezza sul lavoro e di sicurezza industriale: rigoroso, ma obiettivo.

Valuta il senso, non la corrispondenza letterale.
Accetta sinonimi e formulazioni colloquiali, se esprimono in modo univoco il requisito normativo.
Lavora solo sulla domanda, sulla risposta di riferimento, sui criteri e sul frammento normativo che ti vengono forniti.
Non aggiungere requisiti ricordati a memoria o presi da internet.

Per CIASCUN criterio restituisci esattamente uno stato:
- FULL — trattato completamente;
- PARTIAL — una parte sostanziale è trattata, ma c'è una lacuna;
- MISSING — l'elemento è assente;
- INCORRECT — la risposta contraddice il requisito.

Per ogni criterio indica una breve prova tratta dalla risposta del lavoratore e una spiegazione.

CRITICAL_ERROR = true solo quando la risposta contiene un'affermazione o un'azione pericolosa che crea un rischio inaccettabile e contraddice un requisito normativo.
Non usare critical_error solo perché la risposta è incompleta.

Genera a parte:
- WELL_SAID — cosa è stato trattato bene;
- PARTLY_SAID — cosa è stato trattato in parte;
- MISSING — cosa non è stato detto;
- INCORRECT — cosa è stato detto in modo errato;
- SUMMARY — una breve conclusione nella lingua dell'esame.

Non calcolare la percentuale finale «a occhio». La percentuale deve essere calcolata da un algoritmo software in base ai pesi dei criteri, dopo aver ricevuto i tuoi stati.
Prompt 6. Logica programmatica per il calcolo deterministico del punteggio
Collegamento con l'articolo: la stessa sezione «L'esame vero e proprio: domanda a voce, risposta a voce» — la percentuale viene calcolata dal programma, non assegnata dal modello «a occhio».
Implementa il calcolo del punteggio NON tramite una valutazione libera del modello, ma via software.

Per ogni criterio esiste un peso weight in percentuale.
Coefficienti:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = somma(weight × coefficiente) su tutti i criteri.
Limita il risultato all'intervallo 0–100 e arrotonda a 0,1.

Se il valutatore IA ha restituito critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP), dove CRITICAL_CAP è definito nelle impostazioni (ad esempio 40%).

Dopo tutte le domande:
TOTAL_SCORE = media aritmetica dei punteggi delle domande.
PASSED = TOTAL_SCORE >= soglia di superamento stabilita.

Importante:
- il modello stabilisce lo stato semantico del criterio;
- il programma calcola la percentuale;
- il modello non deve assegnare di propria iniziativa un punteggio finale arbitrario.
Prompt 7. Verbale in Word ed esportazione giornaliera in Excel senza dati personali
Collegamento con l'articolo: sezione «Verbale e cronologia ora si generano in automatico» — verbale Word ed esportazione giornaliera in Excel.
Perfeziona l'esaminatore orale.

VERBALE WORD
Al termine dell'esame genera automaticamente un file .docx.
Nel verbale includere:
- data;
- codice RSS;
- mansione/professione;
- reparto;
- lingua;
- soglia di superamento;
- esito finale SUPERATO/NON SUPERATO;
- ogni domanda;
- trascrizione della risposta;
- percentuale ottenuta nella domanda;
- fonte normativa e rimando;
- cosa è stato trattato bene;
- cosa non è stato detto;
- errori.

Lasciare vuoti i campi «Nome e cognome» e «Materia della verifica delle conoscenze», da compilare in locale dopo lo scaricamento.
Nome del file: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL PER DATA
Nella sezione «Storico» aggiungere la scelta della data e il pulsante «Esporta Excel per data».
Colonne:
N. | Data esame | Ora di inizio | Codice RSS | Mansione/professione | Reparto | Lingua | Numero di domande | Soglia di superamento % | Punteggio finale % | Esito | Stato | Ora di fine | ID esame.

Non includere nome e cognome né numero di matricola.
Generare l'Excel solo dallo storico locale del computer in uso.
La corrispondenza RSS <-> nome e cognome deve essere abbinata ai risultati solo offline, all'interno del perimetro aziendale.
Prompt 8. Audit dei dati personali e confini offline/cloud
Collegamento con l'articolo: sezioni «Terza fase: l'esaminatore portabile nel browser» e «Dati personali: codice RSS al posto del nome e cognome».
Esegui un audit tecnico dell'applicazione dell'esaminatore orale.
Occorre separare con onestà le operazioni locali da quelle in cloud.

Verifica e descrivi:
1. Quali dati sono conservati in IndexedDB/localStorage.
2. Quali dati vengono inviati al modello cloud durante la trascrizione.
3. Quali dati vengono inviati durante la valutazione semantica.
4. Quali dati vengono inviati durante la generazione delle bozze di domande.
5. Se vengono trasmessi nome e cognome, numero di matricola, elenco dei lavoratori o la tabella di corrispondenza RSS <-> nome e cognome.
6. Dove è conservata la chiave API.
7. Se la copia di sicurezza contiene la chiave API.
8. Che cosa rimane dopo la chiusura completa dell'applicazione.
9. Come eliminare lo storico locale e le fonti.
10. Quali rischi restano durante l'esercizio in fase pilota.

Requisito per la formulazione del risultato:
non definire l'applicazione «completamente offline» se il riconoscimento vocale, la valutazione, il TTS o la generazione delle domande usano un'API cloud.
Formulazione corretta: «applicazione locale portabile con database locale e perimetro di IA in cloud controllato».
Prompt 9. Aggiunta di più ambiti d'esame in un'unica interfaccia
Collegamento con l'articolo: sezione «Come si forma ora la banca delle domande» — più norme e ambiti in un unico esaminatore, senza passare da un bot all'altro.
Perfeziona la banca delle domande e la schermata di avvio dell'esame in modo che non serva più creare un bot separato per ogni norma.

Ogni domanda ha già il campo «Argomento/ambito».
Aggiungi alla schermata dell'esame la scelta degli ambiti:
- un solo blocco tematico;
- più blocchi tematici contemporaneamente;
- la modalità «Tutti gli ambiti selezionati».

All'avvio dell'esame:
1. filtra solo le domande approvate;
2. tieni conto della lingua scelta;
3. tieni conto degli ambiti scelti;
4. seleziona a caso il numero stabilito di domande con il generatore crittografico del programma;
5. per quanto possibile, distribuisci le domande in modo uniforme tra gli ambiti scelti;
6. non ammettere ripetizioni;
7. se per la combinazione scelta non ci sono abbastanza domande — interrompi l'avvio e mostra un messaggio comprensibile.

Nel verbale Word e nell'Excel salva anche gli ambiti d'esame selezionati.
Come utilizzare l'allegato all'articolo
La numerazione qui sotto è allineata al testo della pubblicazione. Nell'articolo, accanto alla fase corrispondente, ci sono rimandi diretti «Vedi Prompt …», mentre qui sotto ogni prompt è indicata la sezione dell'articolo a cui si riferisce.
- Prompt 1 — versione storica: mostra come funzionavano il primo esaminatore e il nostro generatore del numero su una banca di 300 domande.
- Prompt 2 — preparazione di una grande banca di domande a partire dalla normativa.
- Prompt 3 — la richiesta principale per il lettore che vuole replicare la versione attuale per browser con il vibe coding.
- Prompt 4 — generazione di bozze di domande dalla fonte caricata.
- Prompt 5–6 — separazione tra la valutazione del senso affidata all'IA e il calcolo software della percentuale.
- Prompt 7 — Word ed Excel automatici.
- Prompt 8 — verifica obbligatoria dei confini tra perimetro locale e perimetro cloud.
- Prompt 9 — riunione di più ambiti d'esame in un'unica interfaccia.
Commenti 2
🤝