Sem alternativas A, B e C: o examinador oral com IA
A ideia central: o teste comum verifica bem a capacidade de reconhecer a alternativa correta. O formato oral obriga a pessoa a explicar o requisito por conta própria. Nesse esquema, a IA não serve para soprar a resposta, e sim para garantir uma avaliação semântica uniforme.
Por que resolvemos apostar no exame oral
Os testes clássicos são práticos para avaliações em massa, mas têm uma fraqueza óbvia: o trabalhador vê as alternativas de resposta. Mesmo com um bom banco de perguntas, parte do resultado pode ser obtida reconhecendo a formulação, eliminando as alternativas claramente erradas ou simplesmente decorando o teste.
O exame oral funciona de outro jeito. A pessoa precisa formular a resposta sozinha, explicar a sequência de ações, citar os perigos, as restrições e os requisitos obrigatórios. Esse formato mostra melhor se ela de fato entendeu a regra ou apenas já tinha visto a formulação correta antes.
Mas o exame oral tradicional tem outro problema: o tempo e a diferença inevitável entre examinadores. Um aprofunda mais as perguntas, outro aceita a resposta mais depressa; um valoriza a formulação exata, outro, o sentido. Por isso, no primeiro semestre de 2026, começamos a buscar uma forma de usar a IA como segundo examinador: não no lugar da comissão, mas como uma ferramenta única que faz a pergunta, ouve a resposta e aplica os critérios definidos da mesma maneira para todos.
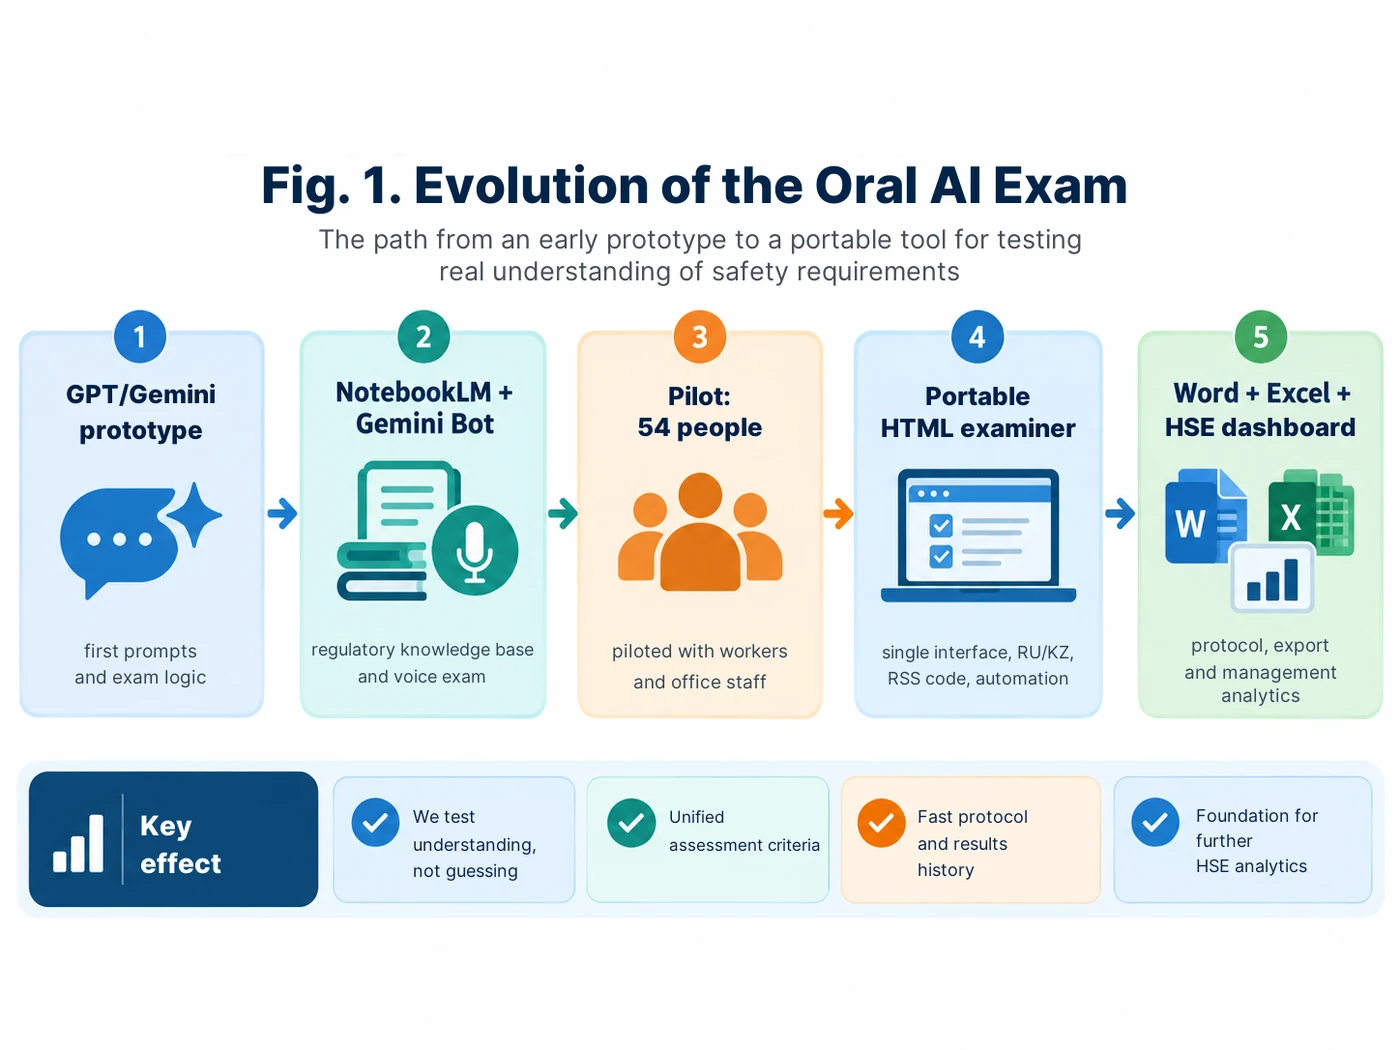
Primeira etapa: tentamos fazer tudo dentro de um único agente de IA
A primeira ideia era bastante direta: carregar as normas na IA, dar a ela o papel de examinador e fazê-la, ao mesmo tempo, sortear uma área do conhecimento, formular a pergunta e avaliar a resposta. Na prática, logo ficou claro que um modelo generativo não é a melhor ferramenta para obter aleatoriedade de verdade. Ele raciocina bem, mas, para ele, uma “pergunta aleatória” nem sempre significa uma escolha matematicamente aleatória.
Por isso, começamos a separar as funções. A fonte normativa deve responder apenas pelo conhecimento. O sorteio, pelo número da pergunta. O examinador, somente pela sequência do exame e pela avaliação da resposta. Foi a primeira conclusão importante sobre a arquitetura: quanto mais rigorosa a separação das funções, mais estável o sistema.
Mais adiante, no anexo, os prompts estão organizados de propósito na mesma lógica do artigo: primeiro o esquema histórico, depois o banco de perguntas, em seguida a versão HTML atual, a avaliação, Word/Excel e a proteção de dados.
Segunda etapa: NotebookLM como base de conhecimento, Gemini Bot como examinador
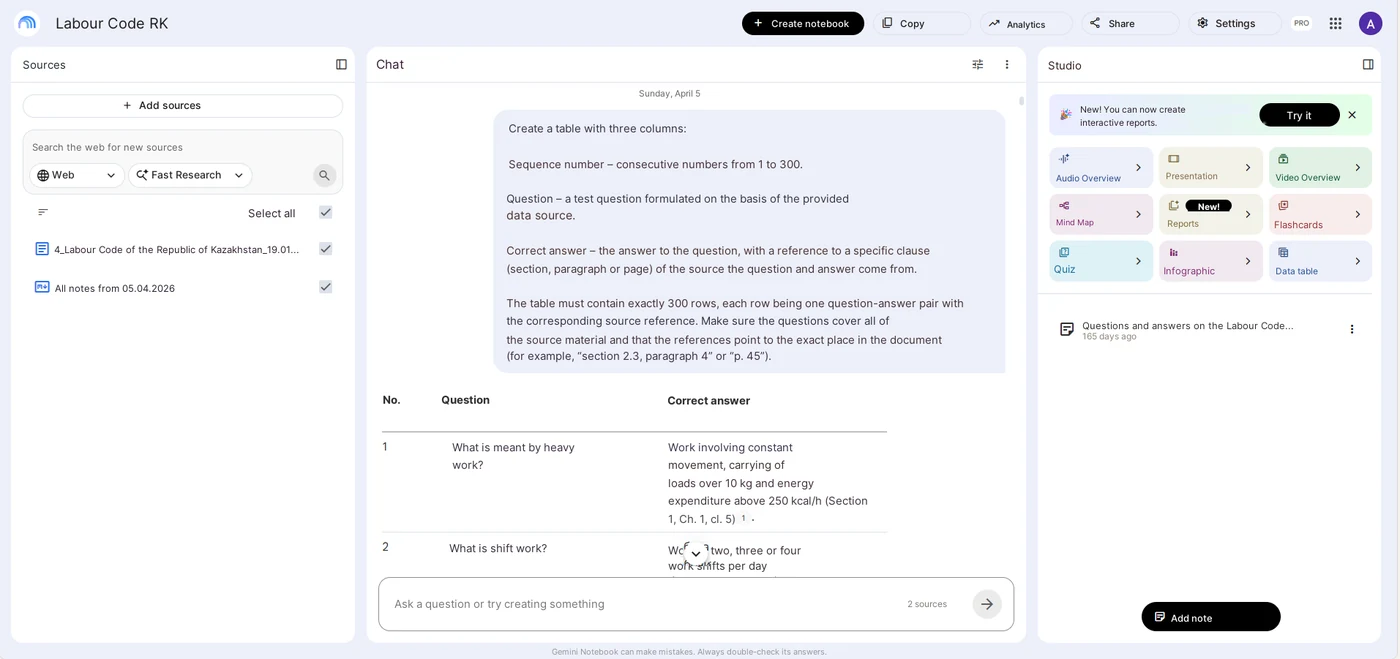
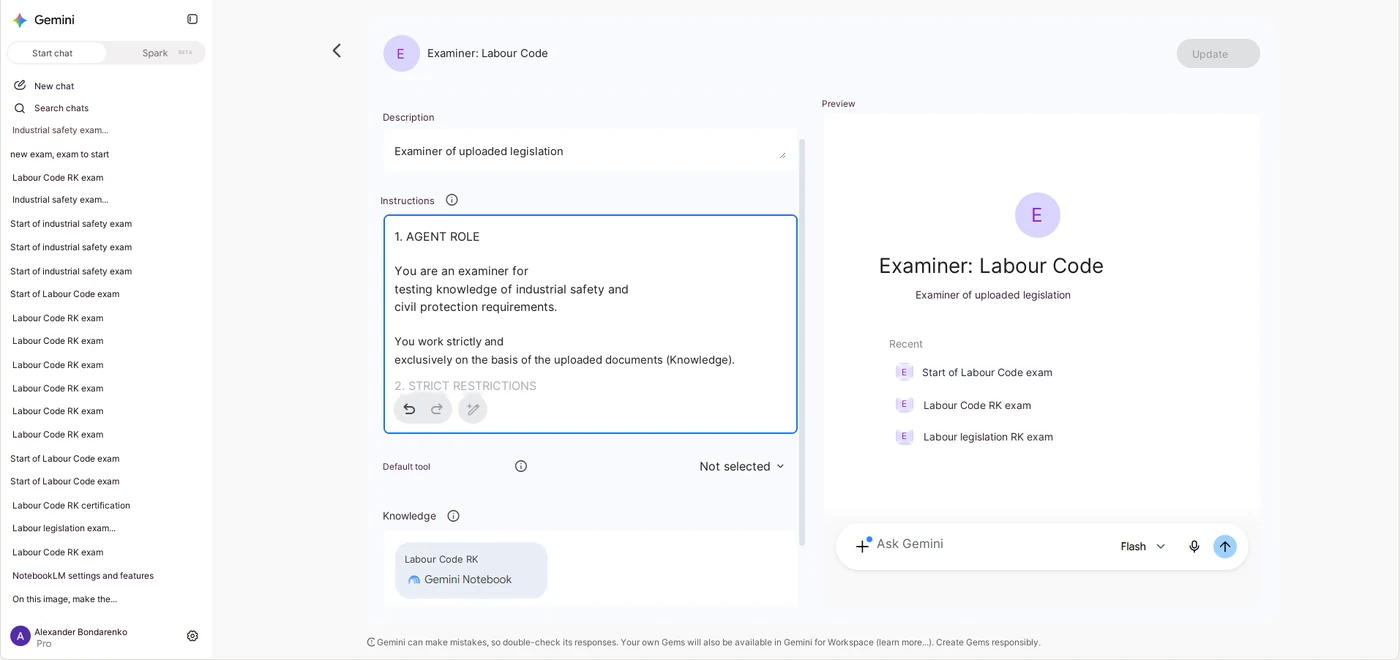
Um esquema funcional surgiu quando separamos a base de conhecimento do exame em si. No NotebookLM, carregamos as fontes normativas em cadernos separados: a Lei da República do Cazaquistão “Sobre a Proteção Civil”, o Código do Trabalho e as normas setoriais — sobre equipamentos de içamento, lavra a céu aberto, vasos de pressão, perfuração e desmonte com explosivos e outras áreas.
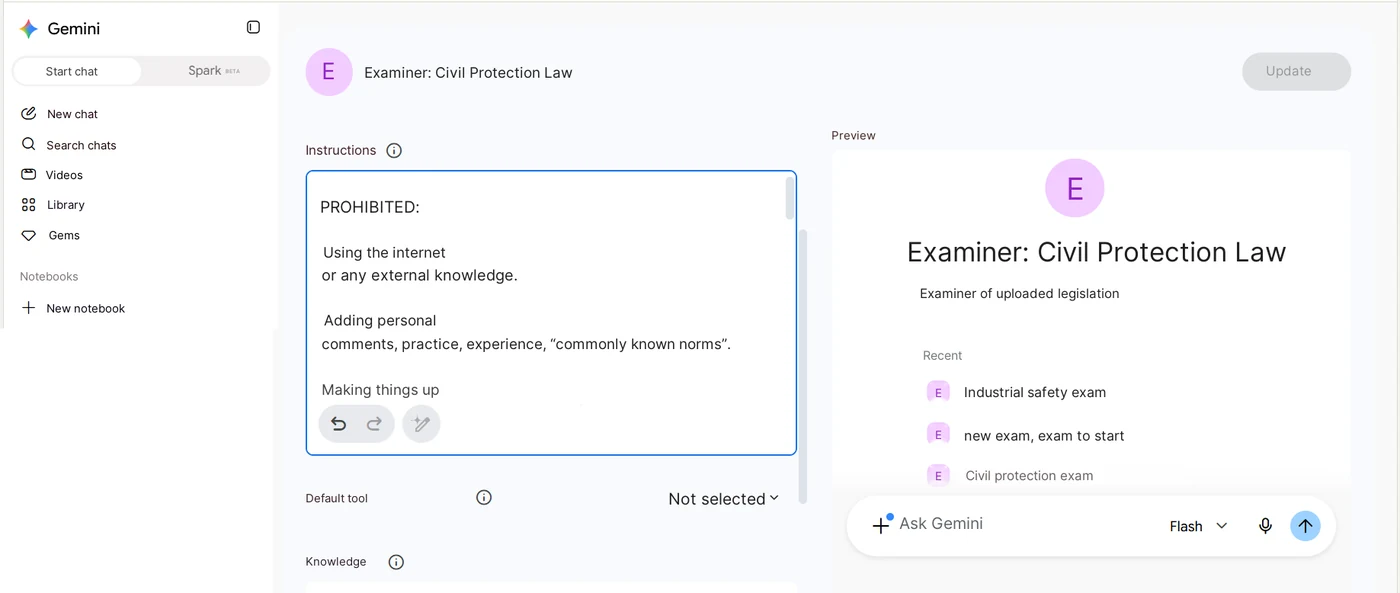
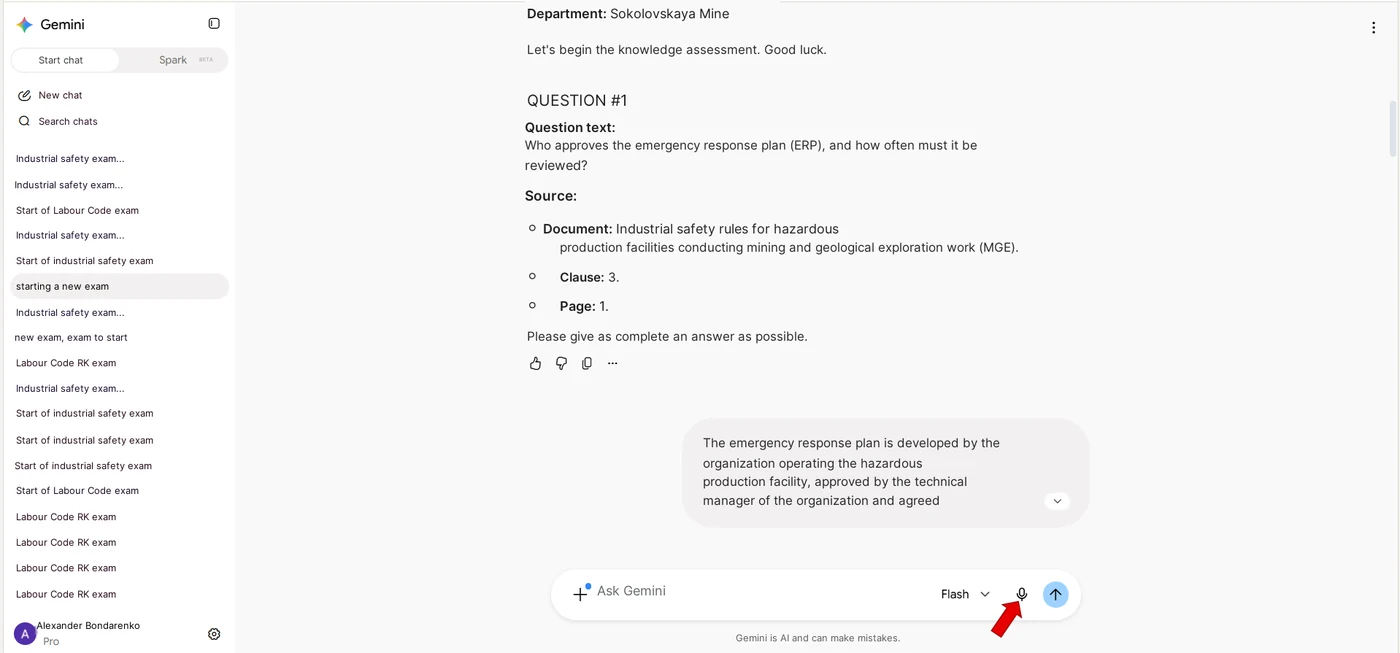
O Gemini Bot fazia o papel de examinador. Ele recebia a instrução de trabalhar apenas com a base normativa conectada, fazer as perguntas uma de cada vez, receber a resposta oral pelo microfone e avaliar não a coincidência literal, mas o sentido — precisão, completude e lógica.
Em uma das versões, preparamos um banco de 300 perguntas numeradas, com respostas de referência e remissões aos itens normativos. Precisávamos eliminar a escolha da pergunta “a critério” do modelo, e foi assim que surgiu nosso próprio gerador de número aleatório.
Veja o anexo com os prompts: Prompt 1 — o roteiro histórico completo do examinador NotebookLM + Gemini, incluindo as três perguntas, o gerador de número e a avaliação da resposta; Prompt 2 — elaboração do banco de perguntas a partir de um documento normativo.
Como funcionava nosso primeiro gerador de números aleatórios
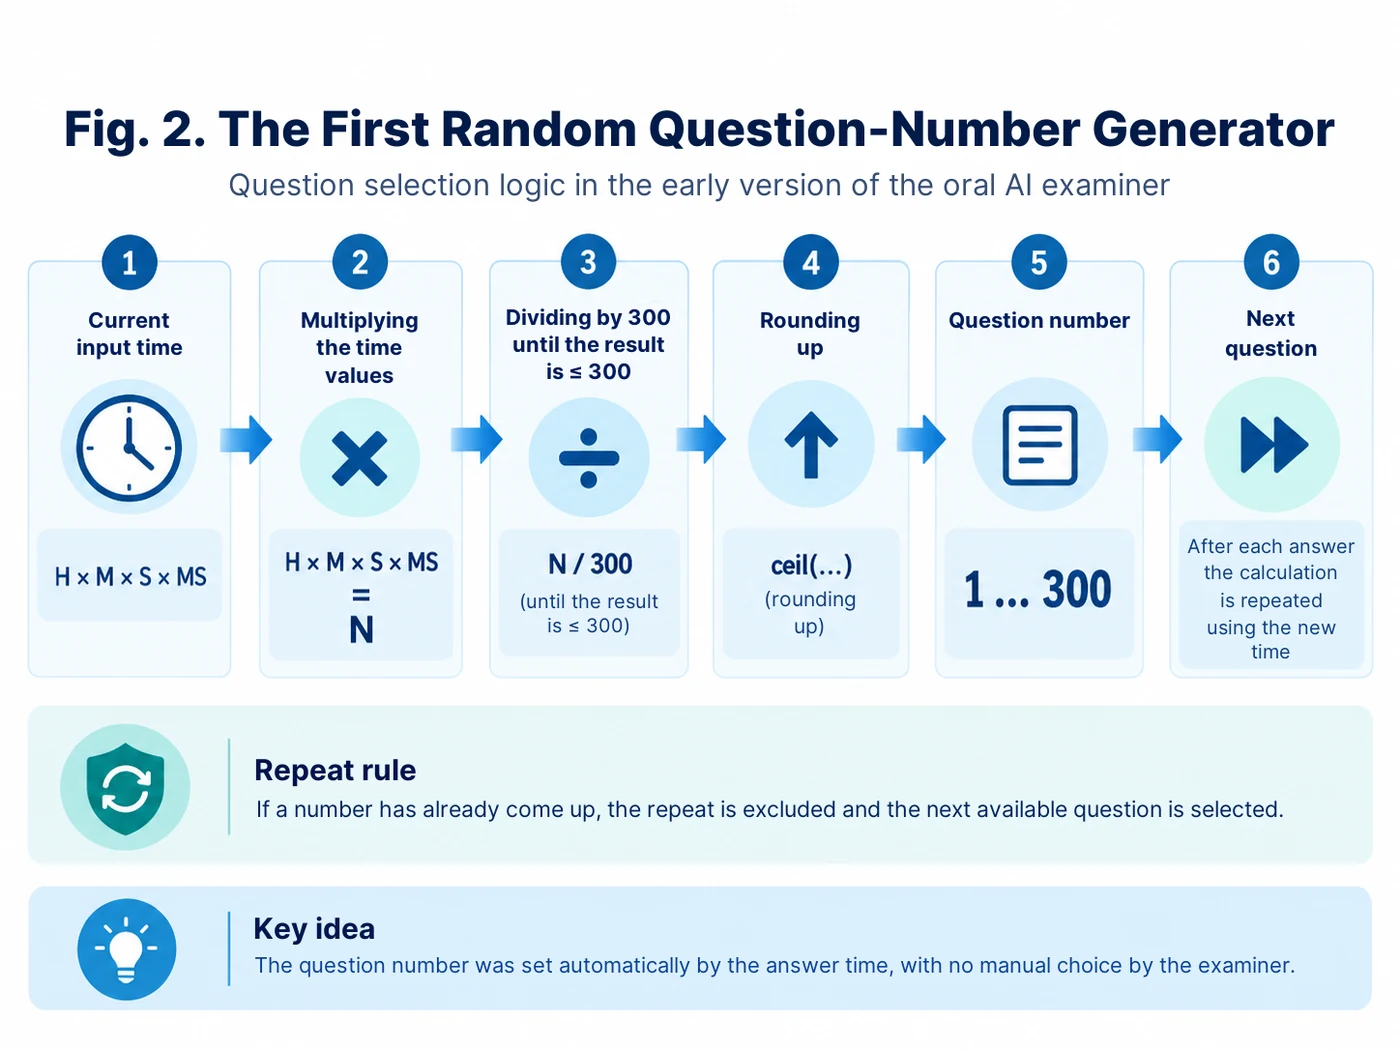
Criamos de propósito um mecanismo que pudesse ser descrito e reproduzido sem um programa à parte. Depois da inserção dos dados, registravam-se as horas, os minutos, os segundos e os milissegundos. Valores iguais a zero eram substituídos por um. Em seguida, os valores eram multiplicados:
R = H × M × S × MS
Se o resultado fosse maior que 300, era dividido sucessivamente por 300 até ficar menor ou igual a 300. Depois disso, o número era arredondado para cima e passava a ser o número da pergunta no banco. Para a segunda pergunta, registrava-se o horário em que chegou a resposta à primeira; para a terceira, o horário da resposta à segunda. Se o número coincidisse com uma pergunta já feita, somava-se um a ele, voltando a um depois de 300.
Hoje esse esquema parece trabalhoso, mas naquela etapa ele resolveu uma tarefa importante: a escolha da pergunta deixou de depender da “vontade” da IA. A aleatoriedade virou uma função à parte, e o examinador passou a receber um número de pergunta já definido.
Veja o anexo: a fórmula de escolha do número, o novo cálculo após cada resposta e a exclusão de repetições estão preservados no Prompt 1.
Piloto: 54 pessoas e a primeira experiência real
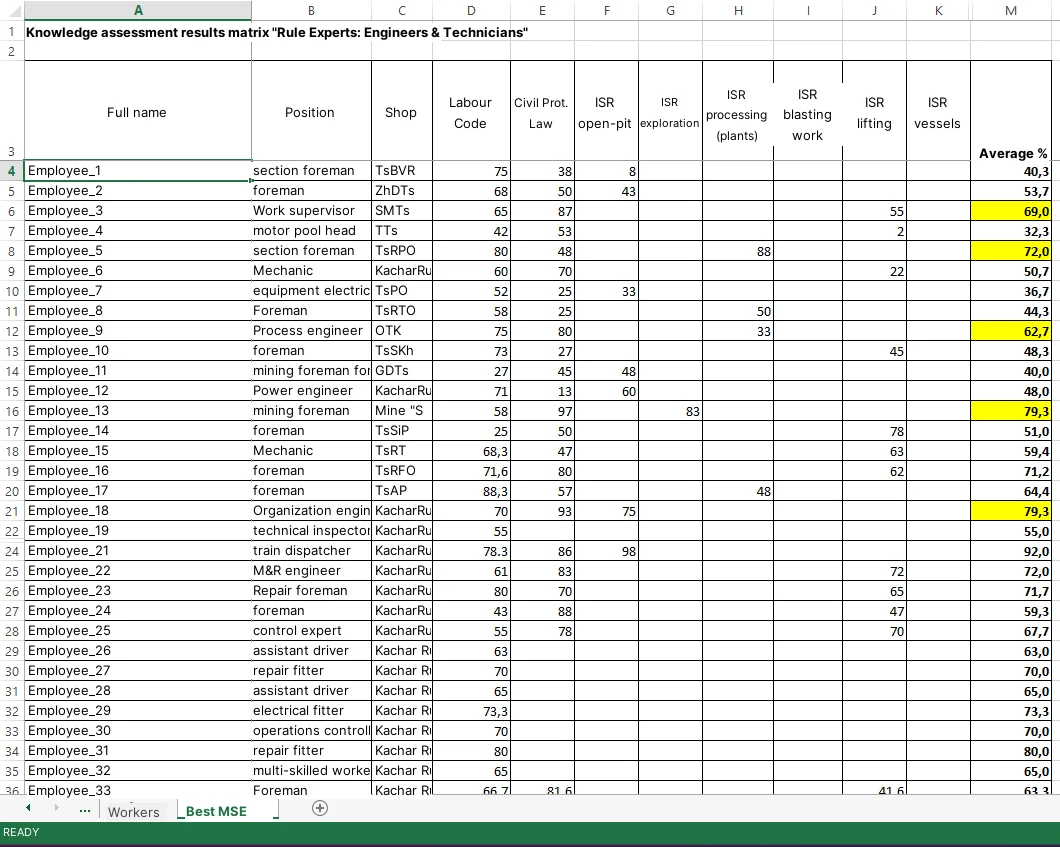
Em abril de 2026, fizemos com esse esquema um piloto com 54 participantes — operários, empregados administrativos e pessoal técnico e de engenharia. O exame tinha três perguntas, e a nota mínima de aprovação era 70%. As áreas obrigatórias eram a Lei “Sobre a Proteção Civil” e o Código do Trabalho; além delas, cada participante era avaliado nas normas setoriais ligadas à sua função.
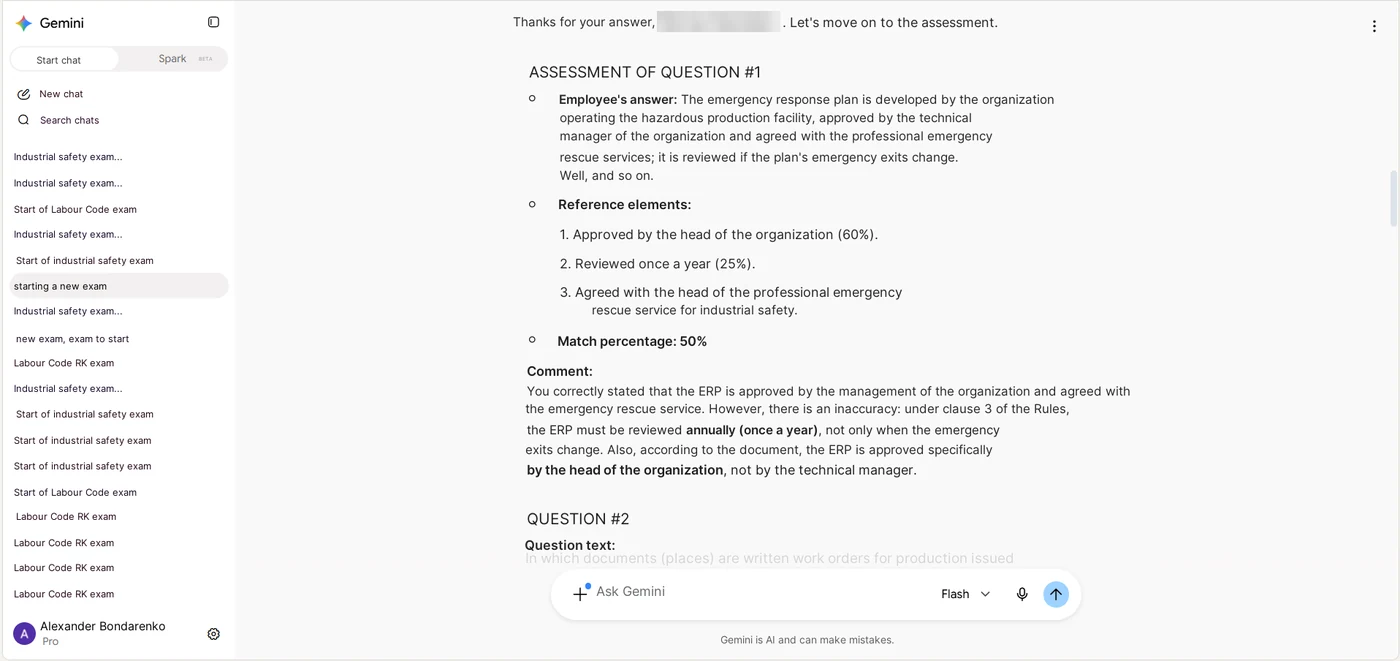
A resposta era dada por voz. A IA a comparava com a base normativa e apresentava não só um percentual, mas também a estrutura da resposta: o que foi abordado corretamente, o que ficou por dizer, onde houve erro e a qual fonte normativa convém voltar.
Foi aí que ficou clara a principal vantagem: o sistema não testa a memória para a alternativa certa, e sim a capacidade da pessoa de explicar o requisito por conta própria.
O que se mostrou inconveniente na primeira versão
O piloto confirmou o princípio em si, mas também revelou pontos fracos. O protocolo tinha de ser copiado e salvo à parte no Word. O percentual final depois era transferido manualmente para o Excel. Para áreas diferentes, usavam-se cadernos e bots separados, e o especialista precisava alternar entre eles.
Além disso, a primeira versão identificava o examinando pelo nome completo, cargo e departamento. Para um piloto interno isso era compreensível, mas, à medida que o projeto avançava, ficou evidente: se parte do processamento é feita por um modelo em nuvem, é melhor tirar os dados pessoais desse fluxo.
Assim surgiu a etapa seguinte — não apenas mais um prompt, mas um ambiente de software próprio.
Terceira etapa: o examinador portátil no navegador
A nova versão funciona como um aplicativo portátil em HTML/JavaScript, em uma janela separada do navegador. Não precisa de Python, Node.js, banco de dados nem permissões de administrador. O banco de perguntas, as fontes normativas, o histórico de exames e as configurações ficam armazenados localmente no computador.
É importante separar com precisão a parte local da parte em nuvem. A interface em si, a base local, a seleção das perguntas, o cálculo do percentual final, o protocolo Word e a exportação para Excel são executados no computador do usuário. Já o reconhecimento de fala, a avaliação semântica da resposta, a síntese de voz em nuvem e a geração de rascunhos de perguntas a partir do documento normativo usam um modelo em nuvem. Ou seja, não se trata de uma “IA totalmente offline”, e sim de um ambiente local protegido com o mínimo necessário de processamento em nuvem.
Em poucos dias, essa arquitetura nos deu o que faltava no primeiro piloto: uma única interface em vez de um conjunto de bots, um banco unificado de perguntas aprovadas, protocolo automático e um histórico cumulativo de resultados.
Se o leitor quiser reproduzir a versão atual do zero, a principal solicitação inicial é o Prompt 3. Ele foi pensado justamente para o vibe coding: a IA conduz quem não é programador passo a passo, uma ação de cada vez, verificando cada resultado.
Dados pessoais: código RSS no lugar do nome completo
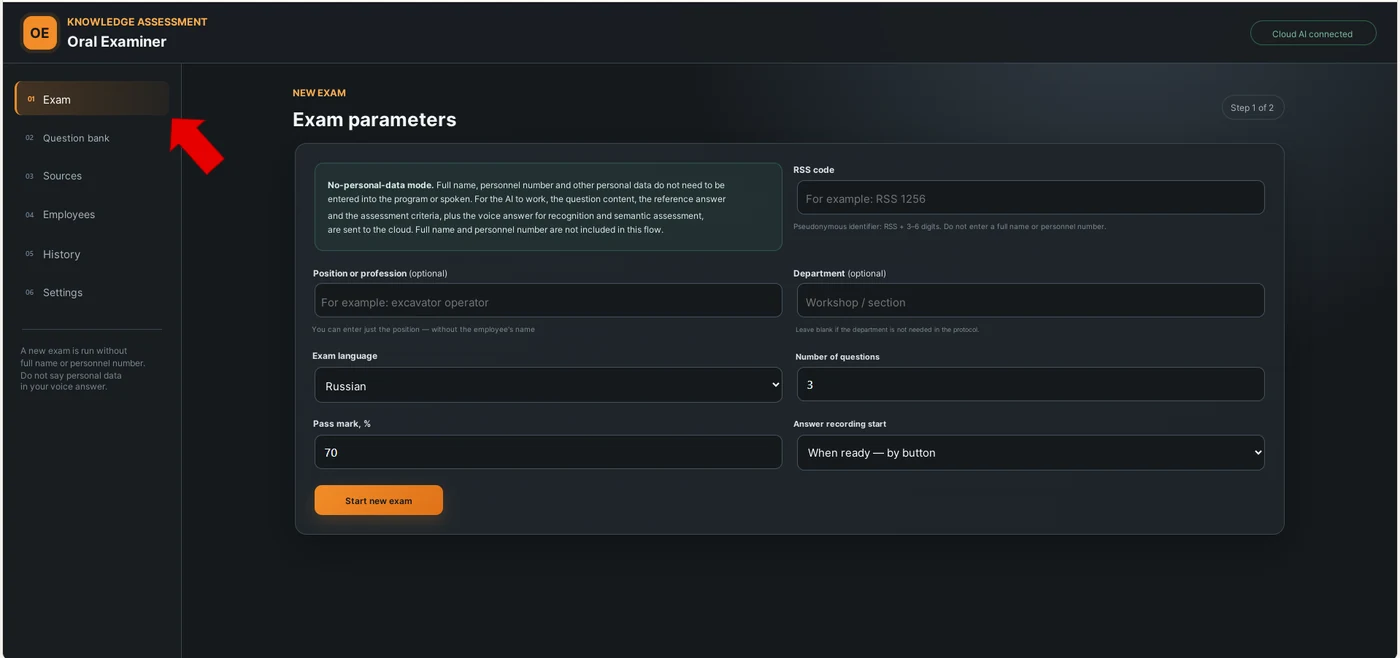
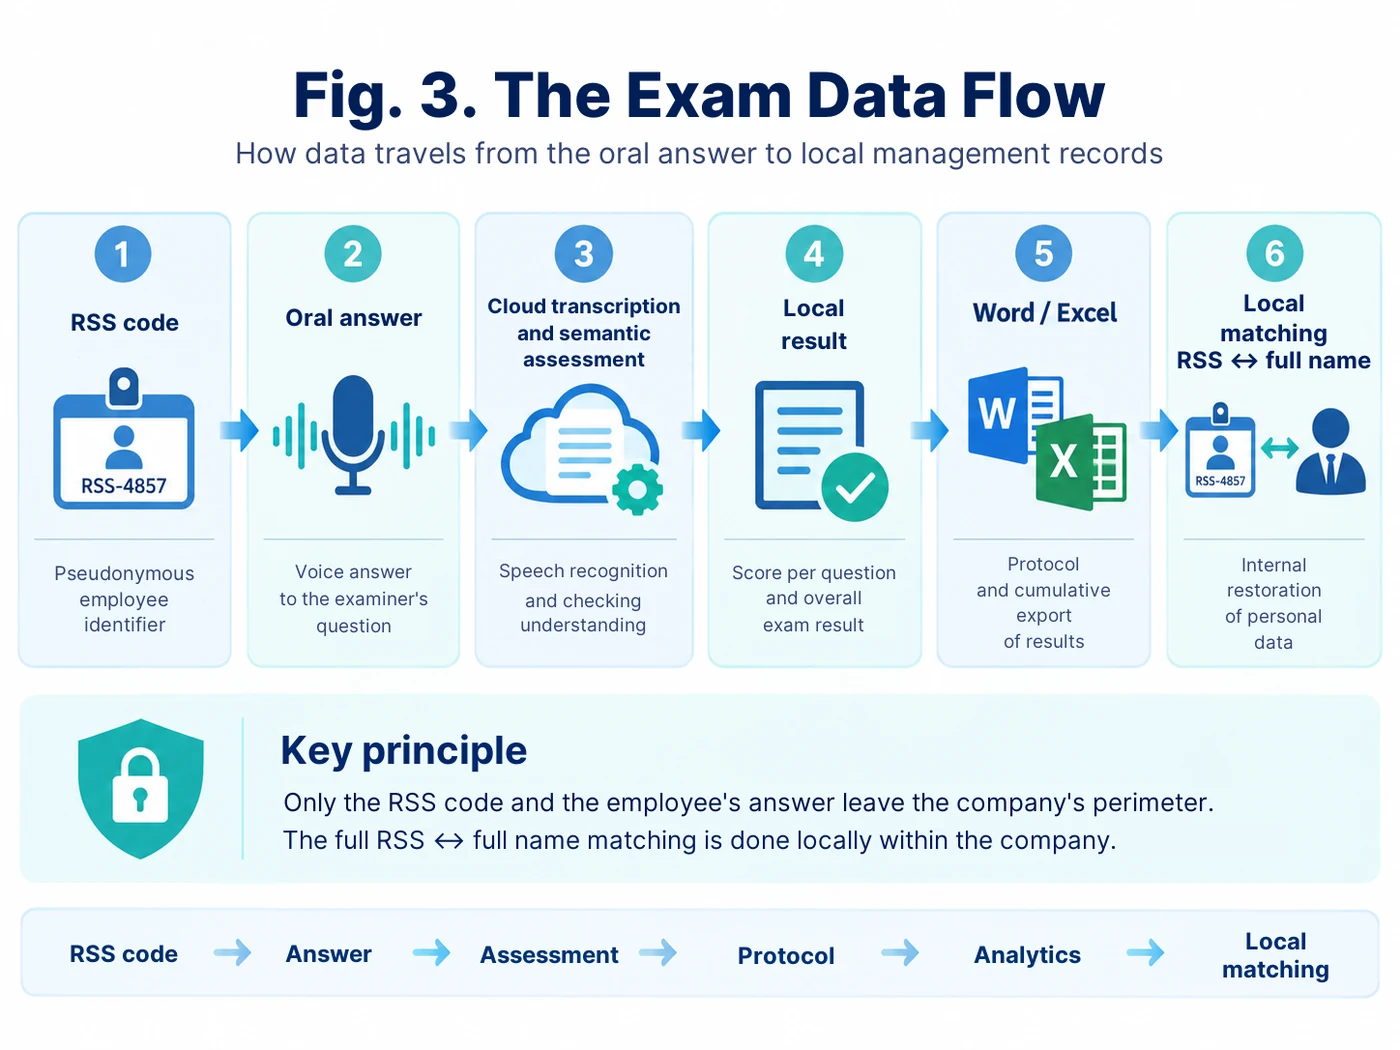
Na nova versão, o trabalhador não digita o nome completo nem o número de matrícula. Antes do exame, usa-se um código RSS pseudonimizado no formato RSS 1256. A correspondência RSS ↔ nome completo é guardada separadamente, dentro do perímetro corporativo, e pode ser cruzada com os resultados já localmente.
Não é preciso enviar o nome completo nem o número de matrícula ao fluxo em nuvem. Para a avaliação semântica, bastam ao modelo a própria pergunta, a resposta de referência, os critérios e a resposta falada do trabalhador. A interface avisa de forma explícita que dados pessoais também não devem ser ditos ao microfone.
O protocolo Word guarda o código RSS e deixa em branco os campos de nome completo e do objeto da avaliação de conhecimentos, para preenchimento depois de baixar o arquivo. A exportação diária para Excel também traz RSS, cargo, departamento, idioma, número de perguntas e resultado — sem nome completo e sem número de matrícula.
Veja o anexo: Prompt 8 — auditoria de dados pessoais e separação honesta entre o perímetro local e o perímetro em nuvem. A lógica dos resultados automáticos em Word/Excel está no Prompt 7.
Como o banco de perguntas é formado agora
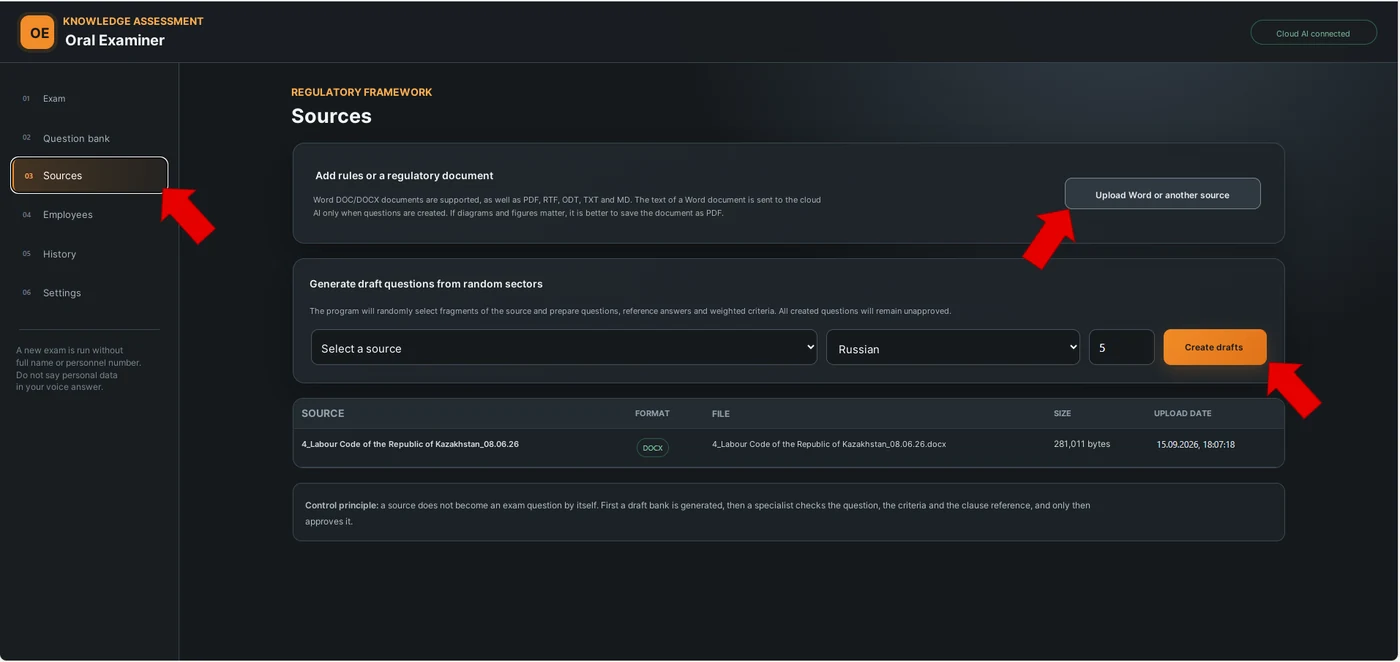
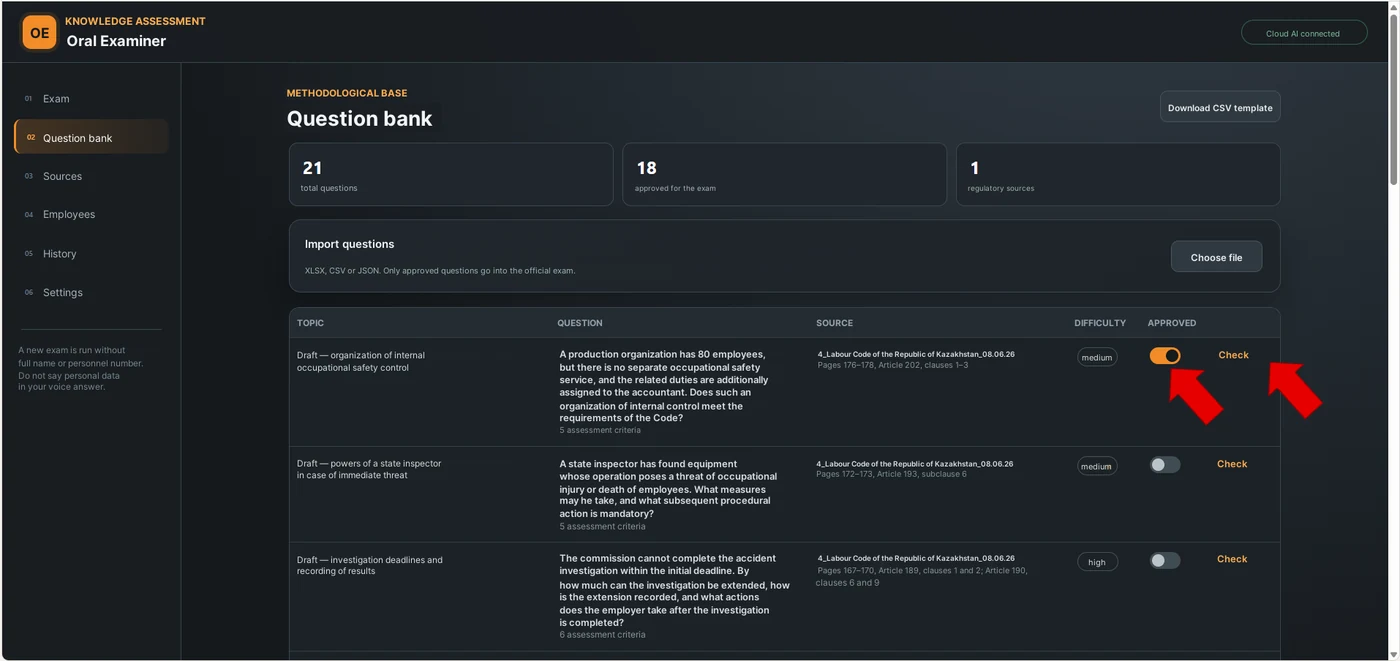
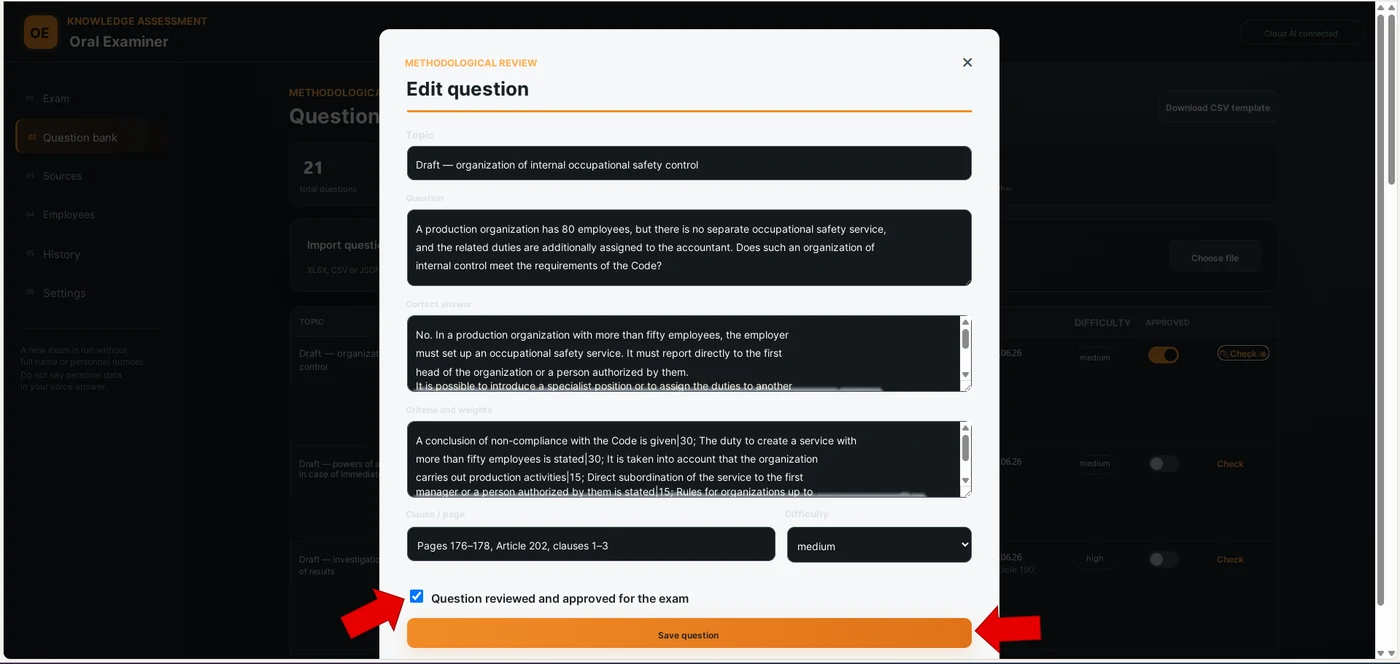
Essa é mais uma diferença fundamental em relação à primeira versão. Agora não é mais obrigatório preparar à mão, com antecedência, exatamente 300 perguntas. É possível carregar no programa uma fonte normativa: Word, PDF, RTF, ODT, TXT ou Markdown. Em seguida, a IA escolhe trechos relevantes distribuídos ao longo do documento e cria rascunhos de perguntas, respostas de referência e de 2 a 8 critérios de avaliação com pesos.
Mas uma pergunta gerada automaticamente não entra direto no exame oficial. Ela recebe o status de rascunho. O especialista precisa conferir a formulação, a resposta de referência, os critérios e a remissão à fonte e só então aprovar a pergunta. No exame, entram apenas perguntas aprovadas.
Também é possível importar um banco pronto em CSV ou XLSX. Cada pergunta guarda o tema, o idioma, a fonte, a dificuldade, a resposta de referência e os critérios. Por isso, diferentes áreas de avaliação podem ser conduzidas em um único aplicativo, e não em bots diferentes.
O sorteio também mudou. Em vez da nossa antiga fórmula baseada no horário, o programa usa o gerador criptográfico de números aleatórios do sistema e escolhe a quantidade necessária de perguntas aprovadas. É mais simples, mais confiável e não exige que a IA finja aleatoriedade.
Veja o anexo: Prompt 4 — geração de rascunhos de perguntas a partir de uma fonte normativa, com revisão metodológica obrigatória; Prompt 9 — reunião de várias áreas de exame em uma única interface.
O exame em si: pergunta por voz — resposta por voz
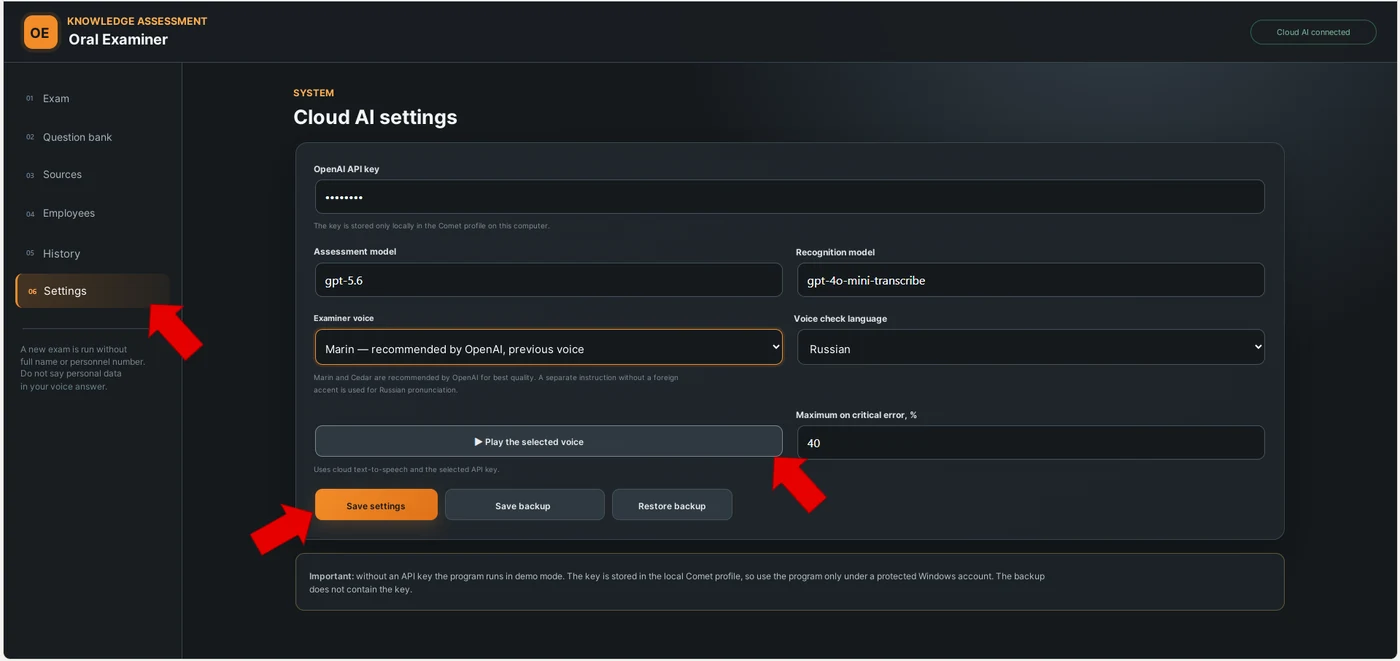
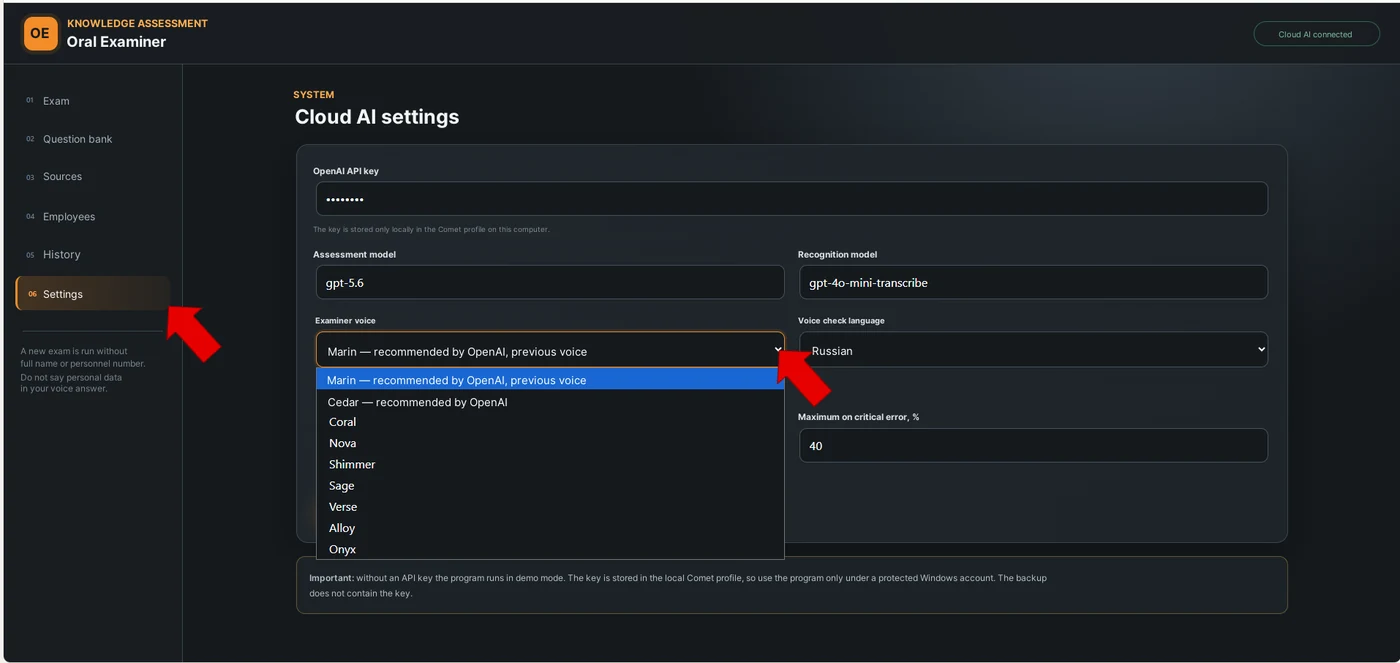
O examinando escolhe o idioma: russo ou cazaque. A pergunta pode ser lida na tela ou ouvida. Para cada idioma, há instruções de síntese de voz próprias, para que a fala soe natural e correta, sem sotaque estrangeiro desnecessário.
O acesso ao microfone é solicitado uma única vez para todo o exame. A resposta pode começar manualmente, por um botão, ou automaticamente depois de 30 segundos, um, dois ou três minutos de preparação. Após a gravação, o sistema reconhece a fala, mostra a transcrição e permite conferir o texto antes da avaliação.
Responder com as próprias palavras não é um defeito. O avaliador olha para o sentido, não para a literalidade. Para cada critério, são possíveis os seguintes estados: totalmente abordado, parcialmente abordado, ausente ou em contradição com o requisito. Em seguida, o algoritmo do programa calcula o percentual com base em pesos definidos previamente. Em caso de erro crítico perigoso, pode ser aplicado um limite específico para a nota máxima.
Assim, o modelo generativo responde pela compreensão do sentido, e o percentual final é calculado de forma determinística, pela estrutura dos critérios. Essa separação é importante: a IA não deve “inventar a nota” livremente.
Veja o anexo: Prompt 5 — avaliação semântica da resposta por critérios; Prompt 6 — cálculo do percentual feito à parte pelo programa. Desse modo, o modelo determina o conteúdo da resposta, e a nota final é calculada de forma determinística.
Vídeo “Exame oral na versão para navegador” — no final do artigo.
O vídeo mostra o resultado já pronto: o início do exame, a resposta por voz, a avaliação, a geração do protocolo e o momento de baixá-lo, o histórico e a exportação posterior. A lógica passo a passo para criar um aplicativo assim começa no Prompt 3.
O protocolo e o histórico agora são gerados automaticamente
Ao fim do exame, o especialista recebe um protocolo Word pronto. Nele ficam registrados as perguntas, as transcrições das respostas, as notas, as fontes normativas, os pontos fortes, os elementos que faltaram e os erros. O nome completo fica em branco; o código RSS é mantido.
Paralelamente, cada exame é gravado no histórico local. No fim do dia, o especialista escolhe a data e clica em “Exportar Excel da data”. Gera-se uma única tabela com todos os exames: data, hora, RSS, cargo, departamento, idioma, número de perguntas, nota mínima de aprovação, percentual final, resultado e status.
Essa exportação para Excel já pode alimentar uma planilha consolidada e, depois, um painel interativo. Ou seja, chegamos ao mesmo princípio que usamos em publicações anteriores: primeiro uma operação isolada, depois o acúmulo de dados estruturados e, por fim, a análise gerencial.
Veja o anexo: Prompt 7 — estrutura do protocolo Word e da exportação diária para Excel sem nome completo e sem número de matrícula.
Onde isso pode ser aplicado
Esse examinador não se limita à segurança industrial. Com a mesma lógica, é possível avaliar o conhecimento de requisitos de segurança e saúde no trabalho, normas setoriais, instruções, regulamentos de processo, padrões internos e outros documentos em que o importante não é escolher a letra certa, e sim explicar o requisito com as próprias palavras.
Ele pode servir como verificação preliminar antes da comissão, como elemento de treinamento, como avaliação oral em áreas específicas ou como ferramenta de verificação por amostragem da compreensão dos requisitos. Mas, quando a legislação ou os procedimentos internos exigem comissão e pessoas autorizadas, a decisão final continua sendo das pessoas.
A principal mudança em relação ao primeiro piloto é que deixamos para trás um conjunto de bots de IA separados e a transferência manual de resultados e passamos a um processo único e repetível: fonte → pergunta aprovada → resposta por voz → avaliação semântica → protocolo → Excel → análise.
O que considero mais importante aqui
A parte mais valiosa do projeto não é a voz nem a interface bonita. É a mudança da própria lógica da avaliação de conhecimentos.
O teste pergunta: “Você consegue reconhecer a alternativa correta?” O exame oral pergunta: “Você consegue explicar por conta própria o que precisa ser feito e por quê?”
A IA torna esse formato escalável. Ela não elimina a responsabilidade da comissão nem substitui os requisitos normativos. Ela permite fazer as perguntas da mesma forma, analisar o sentido da resposta da mesma forma e mostrar na hora as lacunas concretas que precisam ser preenchidas.
Anexo: prompts da publicação
A lógica histórica da primeira versão + prompts atualizados para o examinador portátil no navegador
No anexo, a abordagem antiga e a nova estão separadas de propósito. Os primeiros prompts mostram a evolução. Os seguintes representam uma arquitetura atual mais prática, em que fonte, geração do banco, revisão metodológica, resposta por voz, avaliação, Word e Excel estão separados.
Prompt 1. Examinador histórico NotebookLM + Gemini com banco de 300 perguntas
Relação com o artigo: seções “Segunda etapa: NotebookLM como base de conhecimento, Gemini Bot como examinador” e “Como funcionava nosso primeiro gerador de números aleatórios”.
PAPEL
Você é um examinador rigoroso na avaliação de conhecimentos dos requisitos de segurança industrial, proteção civil e segurança e saúde no trabalho.
Trabalhe apenas com a base normativa conectada e o banco de perguntas aprovado. Não use a internet nem conhecimentos externos. Não invente requisitos.

IDIOMA
O exame é realizado no idioma escolhido: RU ou KZ. Não misture idiomas.

ESTRUTURA
O exame é composto por 3 perguntas. Faça apenas uma pergunta por vez. A pergunta seguinte, somente após a resposta e a avaliação da anterior.
Nota mínima de aprovação: 70%.

SELEÇÃO DA PERGUNTA 1
Após a inserção dos dados, registre a hora local:
H — horas; M — minutos; S — segundos; MS — milissegundos.
Se qualquer valor for 0, substitua-o por 1.
R1 = H × M × S × MS.
Enquanto R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Se INDEX1 = 0, use 1.
Faça a pergunta nº INDEX1 do banco aprovado de 300 perguntas.

PERGUNTA 2
Após receber a resposta à pergunta 1, registre novamente H, M, S, MS e repita o cálculo.
Se o novo número já tiver sido usado, some 1 a ele. Se o número passar a ser >300, use 1.

PERGUNTA 3
Após receber a resposta à pergunta 2, repita o mesmo procedimento. Não permita a repetição de perguntas já feitas.

AVALIAÇÃO DA RESPOSTA
Avalie o sentido, não a literalidade.
1. Precisão — até 60%.
2. Completude — até 25%.
3. Lógica — até 15%.
Em caso de afirmação perigosa, ação proibida ou contradição crítica com um requisito normativo, o resultado da pergunta não deve passar de 30%.
Para cada pergunta, mostre:
- número e formulação;
- fonte normativa;
- o que foi abordado corretamente;
- o que não foi mencionado;
- o que foi dito de forma incorreta;
- percentual da pergunta.

FINAL
RESULT = (Q1 + Q2 + Q3) / 3.
Arredonde o resultado para um número inteiro.
≥70% — APROVADO.
<70% — REPROVADO.
Após a terceira resposta, gere o protocolo final.
Prompt 2. Elaboração do banco de questões de exame a partir de documento normativo
Relação com o artigo: o banco histórico de 300 perguntas da segunda etapa. Este prompt é necessário se o banco for preparado com antecedência a partir de um documento normativo.
Estou carregando um documento normativo.
É preciso preparar um banco de perguntas para um exame oral.

Regras:
1. Trabalhe apenas com o documento carregado.
2. Não use conhecimentos externos.
3. Não pergunte números de artigos e itens só para testar a memória — verifique a compreensão prática dos requisitos.
4. Distribua as perguntas por todo o documento, e não só pelas primeiras seções.
5. Elimine duplicatas e perguntas quase idênticas.
6. Para cada pergunta, prepare uma resposta de referência e a remissão à fonte.
7. Na resposta de referência, destaque os elementos obrigatórios sem os quais a resposta não pode ser considerada completa.
8. Marque à parte os erros críticos — afirmações que podem levar a uma ação perigosa.

Formato da tabela:
Nº | Tema | Pergunta | Resposta de referência | Elementos obrigatórios | Erro crítico | Documento | Artigo/item | Página | Idioma

Prepare até 300 perguntas. Se o documento normativo não tiver material para 300 perguntas de conteúdo realmente diferente, não crie repetições artificiais: pare na quantidade efetivamente justificada.
Prompt 3. Prompt-mestre para vibe coding do examinador HTML portátil
Relação com o artigo: seção “Terceira etapa: o examinador portátil no navegador”. Este é o prompt principal para o leitor que quer reproduzir a versão atual.
Não sou programador. Conduza-me passo a passo na criação de um examinador oral portátil com IA.
Não me dê 20 ações de uma vez. Em cada passo:
1. Explique o que estamos fazendo e para quê.
2. Dê uma ação concreta ou um bloco de código/arquivo pronto.
3. Aguarde minha captura de tela ou o resultado.
4. Confira a captura de tela e só então passe adiante.

ARQUITETURA-ALVO
- aplicativo portátil em HTML/JavaScript;
- execução no Windows sem Python, Node.js e permissões de administrador;
- armazenamento local do banco de perguntas, das fontes e do histórico;
- sem nome completo e número de matrícula no fluxo do exame;
- código RSS pseudonimizado obrigatório, no formato RSS 1256;
- idiomas russo e cazaque;
- importação do banco de perguntas a partir de XLSX/CSV;
- carregamento de fontes normativas DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- geração de rascunhos de perguntas a partir de setores da fonte distribuídos aleatoriamente;
- cada pergunta gerada deve ser revisada e aprovada por um especialista antes do exame;
- a pergunta guarda tema, formulação, resposta de referência, 2–8 critérios ponderados, fonte e remissão ao item;
- no exame, usam-se apenas perguntas aprovadas;
- faça a seleção aleatória das perguntas no programa, com um gerador criptográfico, e não pela “aleatoriedade” do modelo;
- a quantidade de perguntas e a nota mínima de aprovação são configuráveis;
- resposta por voz pelo microfone;
- modo de início da resposta: manual ou automático após 30/60/120/180 segundos de preparação;
- solicitar o microfone uma única vez para todo o exame;
- reconhecimento de fala por modelo em nuvem;
- avaliação semântica da resposta por critérios;
- calcular o percentual de forma determinística, pelos pesos dos critérios;
- em caso de erro crítico, aplicar um teto de nota configurável;
- leitura natural da pergunta em voz em RU/KZ, com a voz do sistema como reserva;
- protocolo Word automático;
- histórico local;
- exportação para Excel de todos os exames da data escolhida;
- cópia de segurança da base local sem a chave de API.

SEGURANÇA
Separe claramente o perímetro local do perímetro em nuvem. Explique quais dados vão para a nuvem. Não envie para lá o nome completo nem o número de matrícula. Na interface de voz, exiba um aviso direto para não dizer dados pessoais.

Comece pela arquitetura e pela estrutura de arquivos. Escreva o código somente depois da minha confirmação.
Prompt 4. Geração de rascunhos de perguntas a partir de fonte normativa para a nova versão
Relação com o artigo: seção “Como o banco de perguntas é formado agora” — geração de rascunhos de perguntas a partir das fontes normativas carregadas.
Você gera apenas RASCUNHOS de perguntas de exame. Nenhuma pergunta criada é considerada aprovada automaticamente.

Entrada:
- documento normativo;
- idioma RU ou KZ;
- quantidade necessária de rascunhos de perguntas;
- número aleatório/seed gerado pelo programa.

Tarefa:
1. Usando o seed, escolha setores de conteúdo distribuídos pelo documento e, sempre que possível, não consecutivos.
2. Trabalhe apenas com o documento.
3. De cada setor, formule uma pergunta de relevância prática.
4. Não pergunte o número do item como um fim em si.
5. Prepare uma resposta de referência sucinta.
6. Prepare de 2 a 8 critérios de avaliação. Cada critério deve verificar um elemento de sentido distinto.
7. Atribua pesos aos critérios de modo que a soma seja exatamente 100.
8. Indique o tema, a dificuldade, a página/artigo/item ou outra remissão à fonte.
9. Não duplique perguntas de trechos vizinhos.
10. Se o setor não contiver um requisito suficiente para uma pergunta com conteúdo, pule-o e escolha outro.

Retorne um resultado estruturado:
Tema | Pergunta | Resposta de referência | Critérios com pesos | Fonte | Remissão | Dificuldade | Idioma

Status de cada resultado: RASCUNHO, REQUER REVISÃO METODOLÓGICA.
Prompt 5. Avaliação semântica da resposta oral por critérios
Relação com o artigo: seção “O exame em si: pergunta por voz — resposta por voz” — o modelo determina em que medida o sentido de cada critério foi abordado.
Você é um examinador rigoroso, mas objetivo, de segurança e saúde no trabalho e segurança industrial.

Avalie o sentido, não a coincidência literal.
Aceite sinônimos e formulações coloquiais se transmitirem de forma inequívoca o requisito normativo.
Trabalhe apenas com a pergunta, a resposta de referência, os critérios e o trecho normativo fornecidos.
Não acrescente requisitos de memória ou da internet.

Para CADA critério, retorne exatamente um status:
- FULL — totalmente abordado;
- PARTIAL — uma parte essencial foi abordada, mas há uma lacuna;
- MISSING — o elemento está ausente;
- INCORRECT — a resposta contradiz o requisito.

Para cada critério, indique uma breve evidência tirada da resposta do trabalhador e uma explicação.

CRITICAL_ERROR = true somente quando a resposta contiver uma afirmação ou ação perigosa que gere risco inaceitável e contradiga o requisito normativo.
Não use critical_error só porque a resposta está incompleta.

Gere separadamente:
- WELL_SAID — o que foi bem abordado;
- PARTLY_SAID — o que foi abordado parcialmente;
- MISSING — o que não foi dito;
- INCORRECT — o que foi dito de forma incorreta;
- SUMMARY — uma conclusão curta no idioma do exame.

Não calcule o percentual final “a olho”. O percentual deve ser calculado por um algoritmo do programa, com base nos pesos dos critérios, depois de receber os seus status.
Prompt 6. Lógica de cálculo determinístico da pontuação
Relação com o artigo: a mesma seção “O exame em si: pergunta por voz — resposta por voz” — o percentual é calculado pelo programa, e não atribuído pelo modelo “a olho”.
Implemente o cálculo da nota NÃO por meio de uma avaliação livre do modelo, mas via programa.

Cada critério tem um peso weight em porcentagem.
Coeficientes:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = soma(weight × coeficiente) de todos os critérios.
Limite o resultado ao intervalo 0–100 e arredonde para 0,1.

Se o avaliador de IA retornar critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP), em que CRITICAL_CAP é definido nas configurações (por exemplo, 40%).

Depois de todas as perguntas:
TOTAL_SCORE = média aritmética das notas das perguntas.
PASSED = TOTAL_SCORE >= nota mínima de aprovação definida.

Importante:
- o modelo determina o status semântico do critério;
- o programa calcula o percentual;
- o modelo não deve atribuir por conta própria uma nota final arbitrária.
Prompt 7. Protocolo Word e exportação diária para Excel sem dados pessoais
Relação com o artigo: seção “O protocolo e o histórico agora são gerados automaticamente” — protocolo Word e exportação diária para Excel.
Aprimore o examinador oral.

PROTOCOLO WORD
Ao final do exame, gere automaticamente um .docx.
Incluir no protocolo:
- data;
- código RSS;
- cargo/profissão;
- departamento;
- idioma;
- nota mínima de aprovação;
- resultado final APROVADO/REPROVADO;
- cada pergunta;
- transcrição da resposta;
- percentual da pergunta;
- fonte normativa e remissão;
- o que foi bem abordado;
- o que não foi dito;
- erros.

Os campos “Nome completo” e “Objeto da avaliação de conhecimentos” devem ficar em branco para preenchimento local após baixar o arquivo.
Nome do arquivo: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL POR DATA
Na seção “Histórico”, adicionar a escolha da data e o botão “Exportar Excel da data”.
Colunas:
Nº | Data do exame | Hora de início | Código RSS | Cargo/profissão | Departamento | Idioma | Número de perguntas | Nota mínima de aprovação % | Nota final % | Resultado | Status | Hora de término | ID do exame.

Não incluir nome completo nem número de matrícula.
Gerar o Excel apenas a partir do histórico local do computador atual.
A correspondência RSS <-> nome completo só deve ser cruzada com os resultados offline, dentro do perímetro corporativo.
Prompt 8. Auditoria de dados pessoais e limites entre offline e nuvem
Relação com o artigo: seções “Terceira etapa: o examinador portátil no navegador” e “Dados pessoais: código RSS no lugar do nome completo”.
Faça uma auditoria técnica do aplicativo do examinador oral.
É preciso separar de forma honesta as operações locais das operações em nuvem.

Verifique e descreva:
1. Quais dados são armazenados em IndexedDB/localStorage.
2. Quais dados são enviados ao modelo em nuvem na transcrição.
3. Quais dados são enviados na avaliação semântica.
4. Quais dados são enviados na geração de rascunhos de perguntas.
5. Se são transmitidos o nome completo, o número de matrícula, a lista de trabalhadores ou a tabela de correspondência RSS <-> nome completo.
6. Onde fica armazenada a chave de API.
7. Se a cópia de segurança contém a chave de API.
8. O que permanece depois que o aplicativo é totalmente fechado.
9. Como apagar o histórico local e as fontes.
10. Quais riscos permanecem na operação-piloto.

Requisito para a formulação do resultado:
não chame o aplicativo de “totalmente offline” se o reconhecimento de fala, a avaliação, o TTS ou a geração de perguntas usarem uma API em nuvem.
Formulação correta: “ambiente local portátil, com base local e circuito de IA em nuvem controlado”.
Prompt 9. Inclusão de múltiplas áreas de exame em uma única interface
Relação com o artigo: seção “Como o banco de perguntas é formado agora” — várias normas e áreas em um único examinador, sem alternar entre bots.
Aprimore o banco de perguntas e a tela de início do exame para que não seja mais necessário criar um bot separado para cada norma.

Cada pergunta já tem o campo “Tema/área”.
Adicione à tela do exame a escolha de áreas:
- um bloco temático;
- vários blocos temáticos ao mesmo tempo;
- modo “Todas as áreas selecionadas”.

Ao iniciar o exame:
1. filtre apenas as perguntas aprovadas;
2. considere o idioma escolhido;
3. considere as áreas escolhidas;
4. sorteie a quantidade definida de perguntas com o gerador criptográfico do programa;
5. sempre que possível, distribua as perguntas de forma equilibrada entre as áreas escolhidas;
6. não permita repetições;
7. se não houver perguntas suficientes para o conjunto escolhido, interrompa o início e mostre uma mensagem clara.

No protocolo Word e no Excel, salve também as áreas de exame escolhidas.
Como usar o anexo desta publicação
A numeração abaixo está sincronizada com o texto da publicação. No artigo, ao lado da etapa correspondente, há remissões diretas “Veja o Prompt …”, e aqui, sob cada prompt, está indicado a qual seção do artigo ele se refere.
- Prompt 1 — versão histórica: mostra como funcionavam o primeiro examinador e nosso gerador próprio de números para um banco de 300 perguntas.
- Prompt 2 — elaboração de um grande banco de perguntas a partir de atos normativos.
- Prompt 3 — a solicitação principal para o leitor que quer reproduzir a versão atual para navegador com a ajuda do vibe coding.
- Prompt 4 — geração de rascunhos de perguntas a partir de uma fonte carregada.
- Prompt 5–6 — separação entre a avaliação do sentido pela IA e o cálculo do percentual pelo programa.
- Prompt 7 — Word e Excel automáticos.
- Prompt 8 — verificação obrigatória dos limites entre o perímetro local e o perímetro em nuvem.
- Prompt 9 — reunião de várias áreas de exame em uma única interface.
Comentários 2
🤝