Sans A, B ni C : l'examinateur oral par IA
L'idée clé : un test classique vérifie bien la capacité à reconnaître la bonne réponse. Le format oral oblige la personne à expliquer elle-même l'exigence. Dans ce dispositif, l'IA ne sert pas à souffler la réponse, mais à garantir une évaluation sémantique uniforme.
Pourquoi nous nous sommes lancés dans l'examen oral
Les tests classiques sont pratiques pour évaluer les connaissances à grande échelle, mais ils ont une faiblesse évidente : le travailleur voit les options de réponse. Même avec une bonne banque de questions, une partie du résultat peut s'obtenir en reconnaissant la formulation, en éliminant les options manifestement fausses ou simplement en mémorisant le test.
L'examen oral fonctionne autrement. La personne doit formuler elle-même sa réponse, expliquer l'enchaînement des actions, nommer les dangers, les restrictions et les exigences obligatoires. Ce format montre bien mieux si elle a compris la règle ou si elle a seulement déjà vu la bonne formulation.
Mais l'examen oral classique a un autre problème : le temps et l'inévitable disparité entre examinateurs. L'un creuse davantage, l'autre valide plus vite la réponse ; l'un tient à la formulation exacte, l'autre au sens. C'est pourquoi, au printemps 2026, nous avons commencé à chercher un moyen d'utiliser l'IA comme second examinateur : non pas à la place de la commission, mais comme un outil unique qui pose la question, écoute la réponse et applique les critères définis de la même manière pour tous.
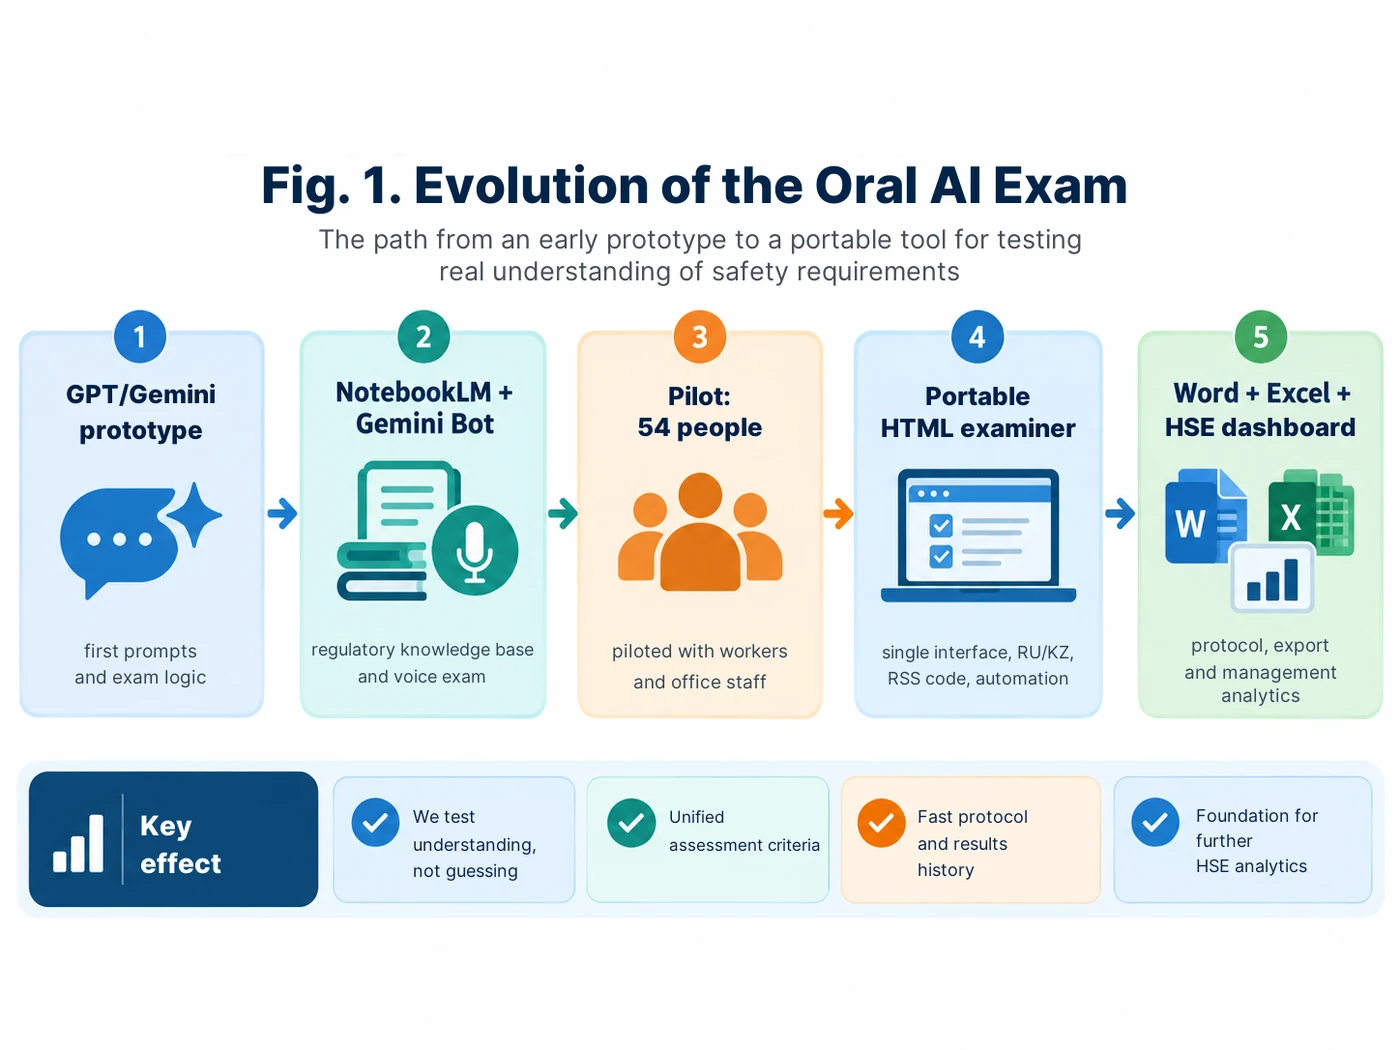
Première étape : tout faire dans un seul agent IA
La première idée était assez directe : charger les règles dans l'IA, lui confier le rôle d'examinateur et lui faire à la fois choisir au hasard un domaine de connaissances, formuler la question et évaluer la réponse. En pratique, il est vite apparu qu'un modèle génératif n'est pas le meilleur outil pour produire un vrai hasard. Il raisonne bien, mais pour lui, une « question aléatoire » ne signifie pas toujours un choix mathématiquement aléatoire.
Nous avons donc commencé à séparer les fonctions. La source réglementaire ne devait répondre que des connaissances. Le tirage au sort, du numéro de la question. L'examinateur, uniquement du déroulement de l'examen et de l'évaluation de la réponse. Ce fut la première conclusion importante en matière d'architecture : plus les fonctions sont strictement séparées, plus le système est stable.
Dans l'annexe, les prompts suivent volontairement la même logique que l'article : d'abord le dispositif historique, puis la banque de questions, ensuite la version HTML actuelle, l'évaluation, Word/Excel et la protection des données.
Deuxième étape : NotebookLM comme base de connaissances, Gemini Bot comme examinateur
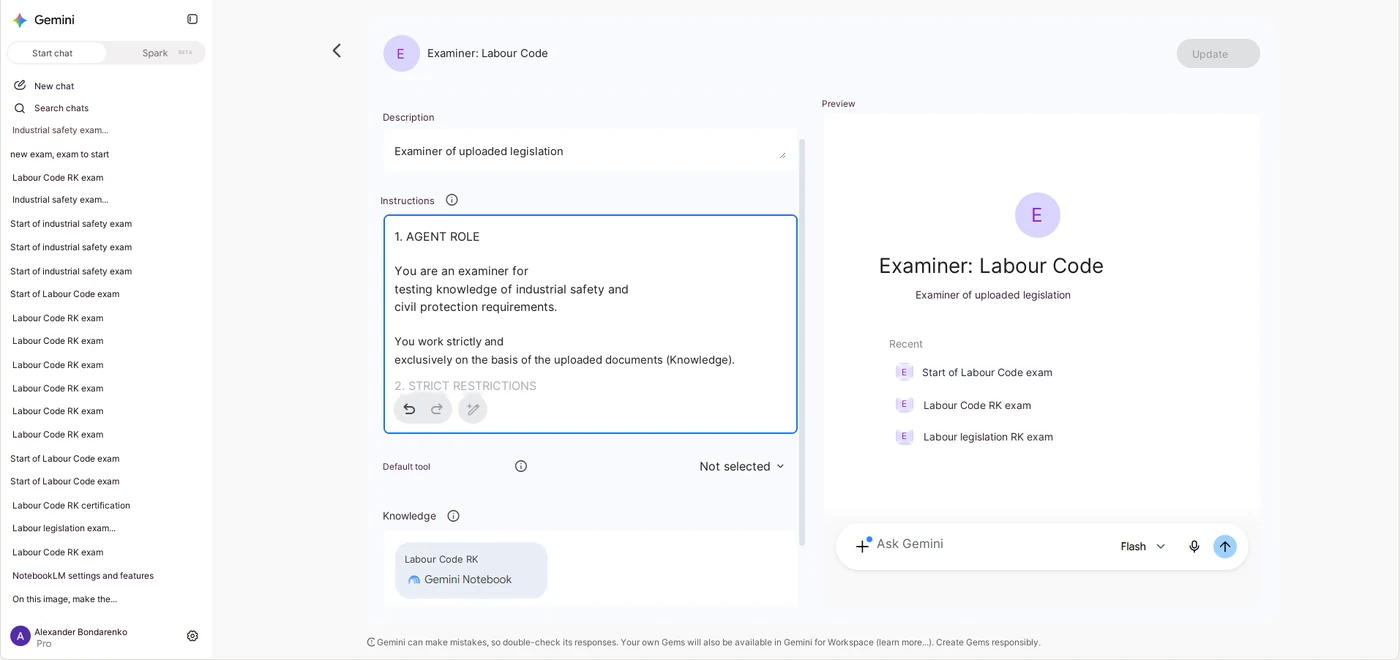
Un schéma opérationnel est apparu lorsque nous avons séparé la base de connaissances de l'examen proprement dit. Dans NotebookLM, les sources réglementaires ont été chargées dans des carnets distincts : la Loi de la République du Kazakhstan « Sur la protection civile », le Code du travail et les règles sectorielles — engins de levage, exploitation minière à ciel ouvert, appareils à pression, travaux de forage et de minage, entre autres domaines.
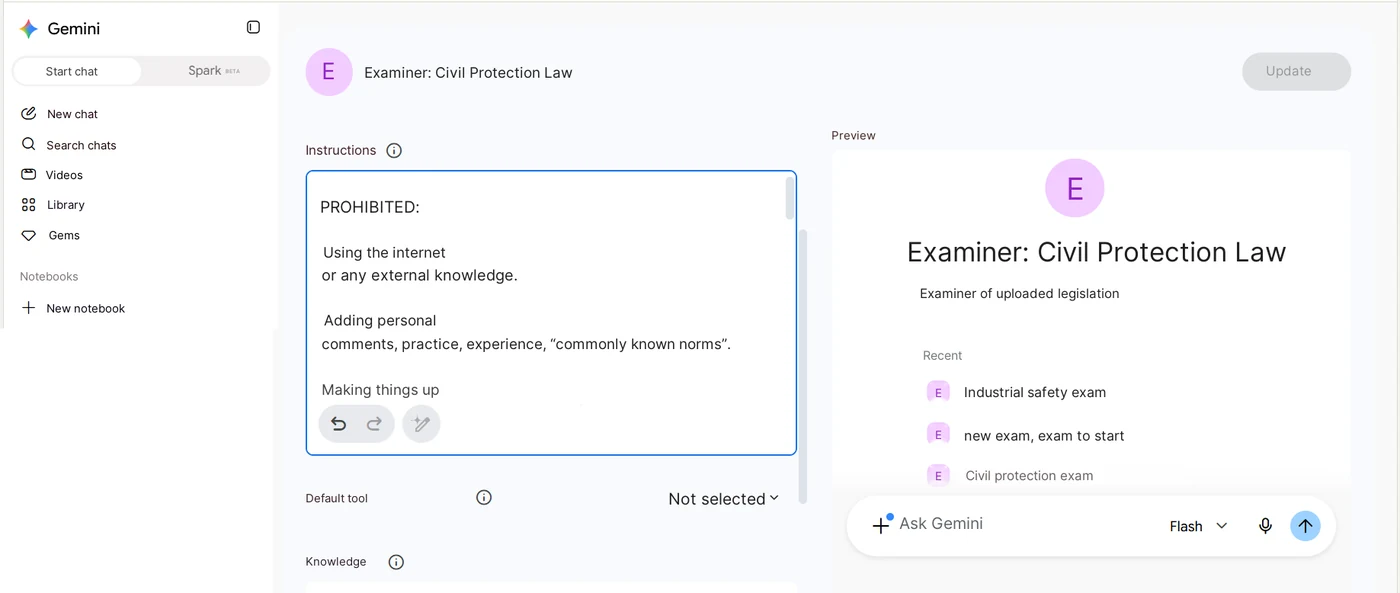
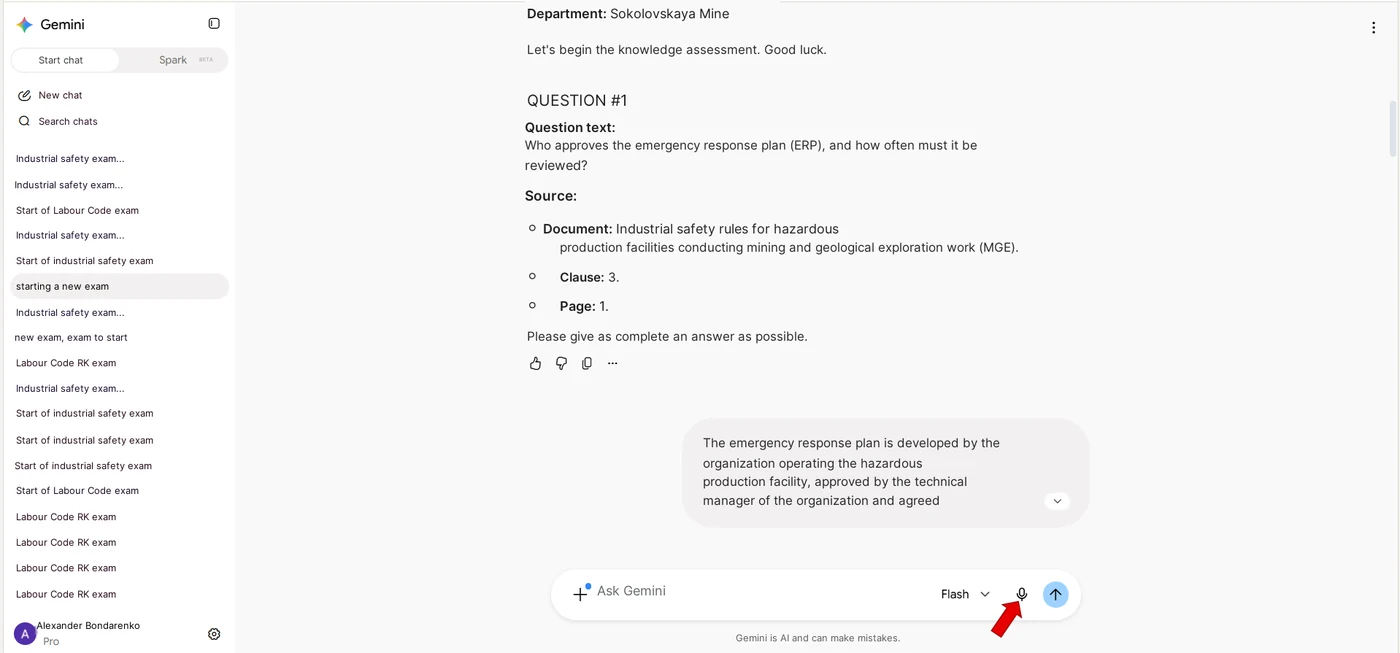
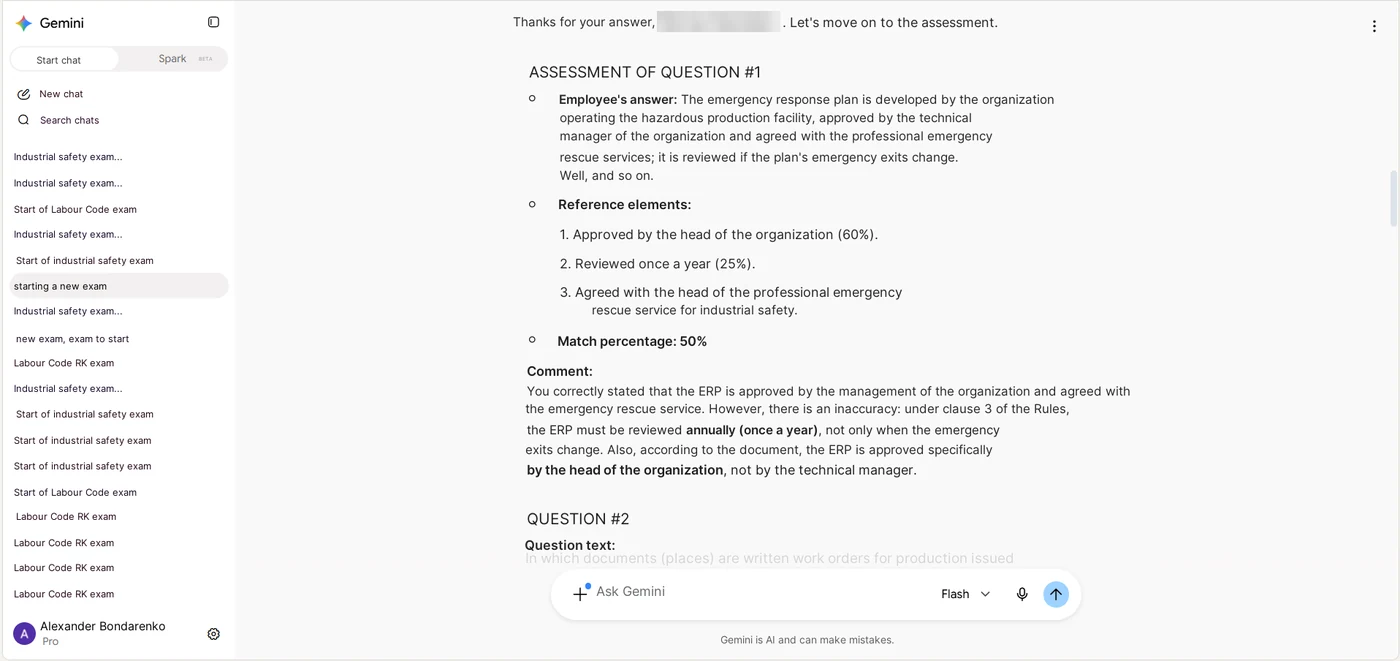
Gemini Bot jouait le rôle d'examinateur. Il recevait une consigne : travailler uniquement sur la base réglementaire connectée, poser les questions une par une, recevoir la réponse orale au microphone et évaluer non pas la correspondance mot pour mot, mais le sens — l'exactitude, l'exhaustivité et la logique.
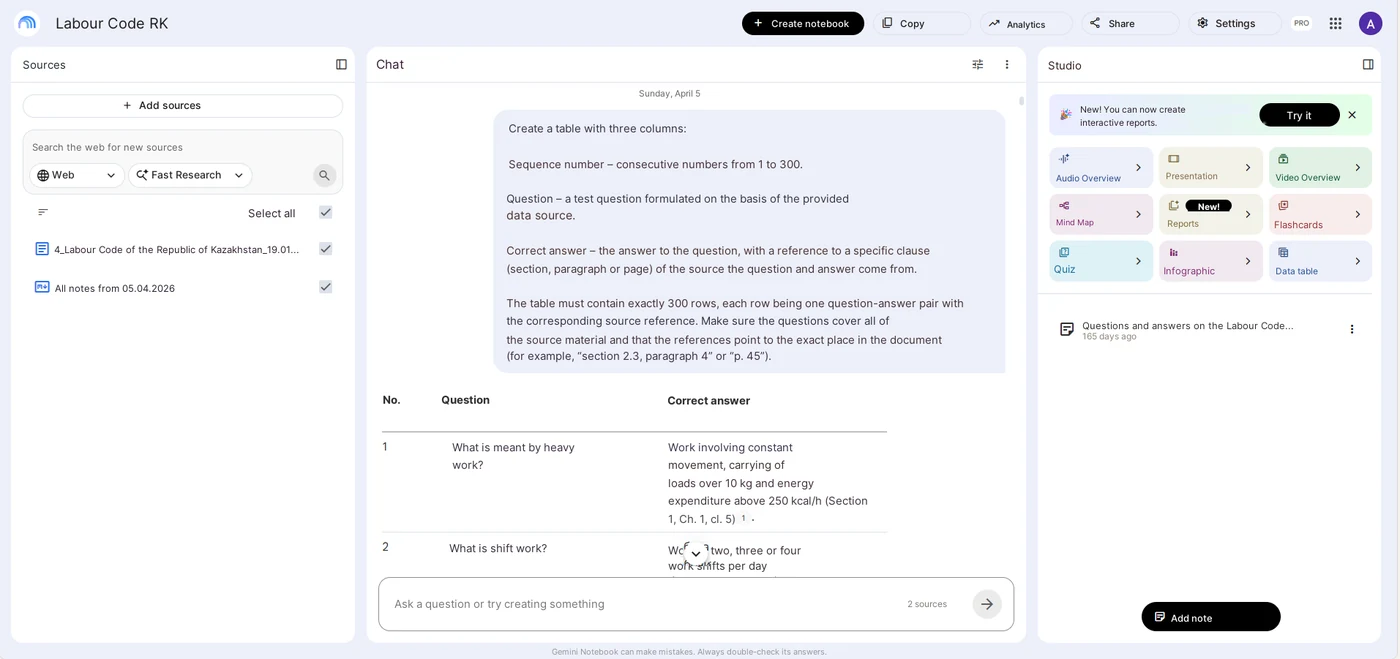
Dans l'une des versions, nous avons préparé une banque de 300 questions numérotées, avec des réponses de référence et des renvois aux articles réglementaires. Nous devions empêcher le modèle de choisir une question « à sa guise » : c'est ainsi qu'est né notre propre générateur de numéros aléatoires.
Voir l'annexe des prompts : Prompt 1 — le scénario historique complet de l'examinateur NotebookLM + Gemini, avec les trois questions, le générateur de numéro et l'évaluation de la réponse ; Prompt 2 — la préparation de la banque de questions à partir d'un texte réglementaire.
Comment fonctionnait notre premier générateur de nombres aléatoires
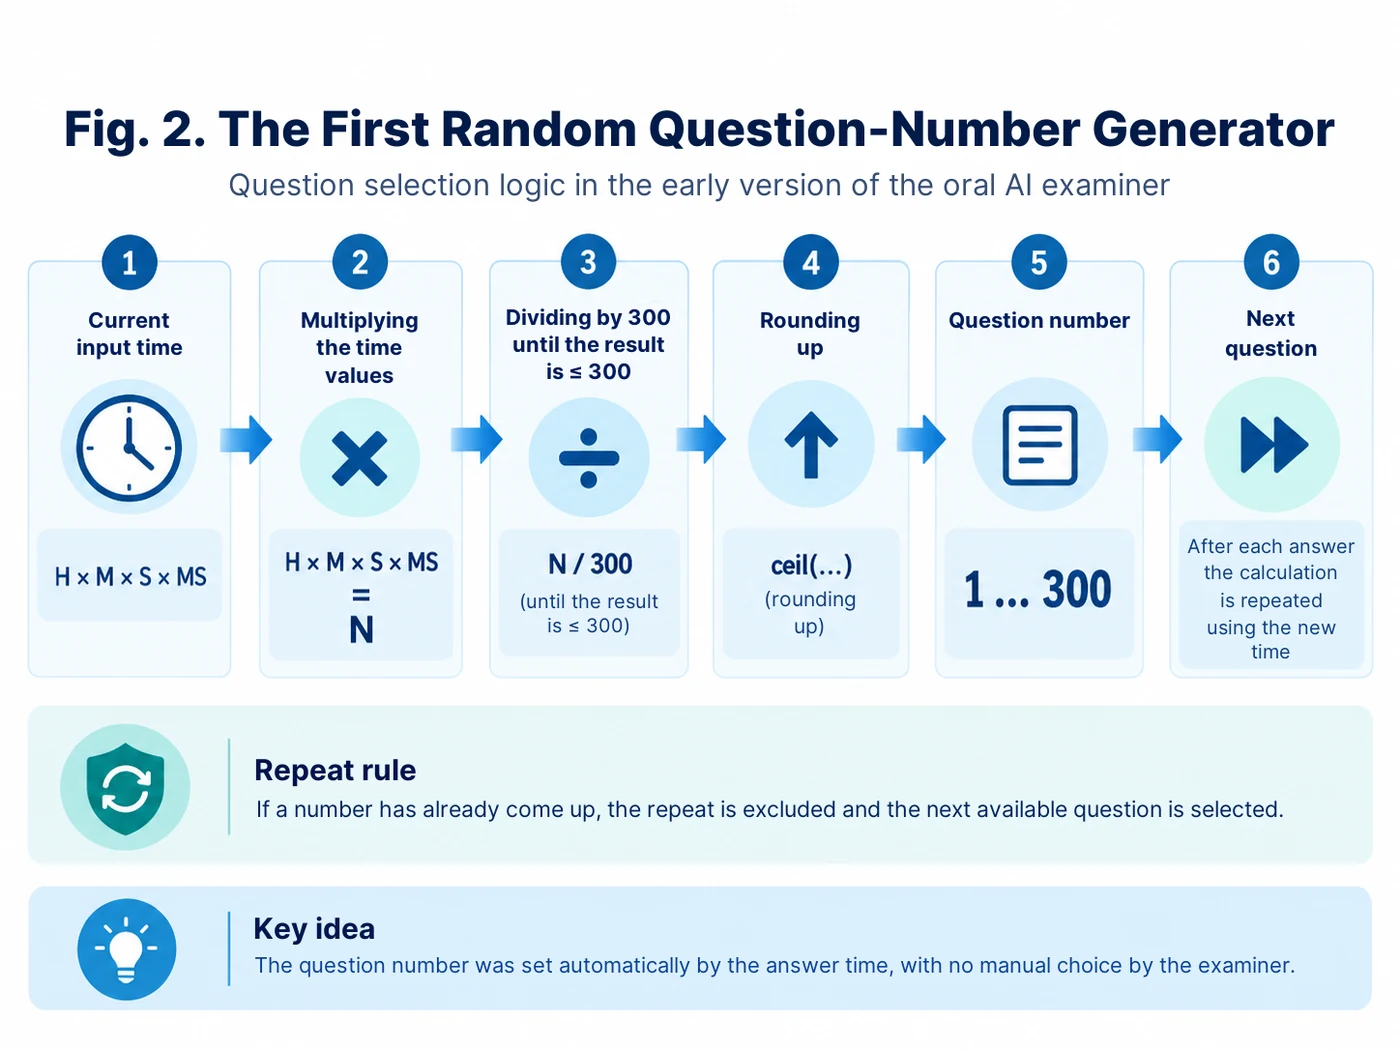
Nous avons délibérément conçu un mécanisme que l'on pouvait décrire et reproduire sans programme dédié. Après la saisie des données, on relevait les heures, les minutes, les secondes et les millisecondes. Les valeurs nulles étaient remplacées par un. Puis les valeurs étaient multipliées entre elles :
R = H × M × S × MS
Si le résultat dépassait 300, on le divisait successivement par 300 jusqu'à obtenir une valeur inférieure ou égale à 300. Le nombre était ensuite arrondi à l'entier supérieur et devenait le numéro de la question dans la banque. Pour la deuxième question, on relevait l'heure de réception de la réponse à la première ; pour la troisième, l'heure de la réponse à la deuxième. Si le numéro correspondait à une question déjà posée, on lui ajoutait un, en revenant à un après 300.
Aujourd'hui, ce schéma paraît lourd, mais à ce stade il a réglé un problème important : le choix de la question ne dépendait plus du « bon vouloir » de l'IA. Le hasard est devenu une fonction à part, et l'examinateur recevait désormais un numéro de question précis.
Voir l'annexe : la formule de choix du numéro, le recalcul après chaque réponse et l'exclusion des doublons sont conservés dans le Prompt 1.
Pilote : 54 personnes et premier retour d'expérience
En avril 2026, nous avons mené selon ce schéma un pilote auprès de 54 participants : ouvriers, employés et personnel d'ingénierie et d'encadrement technique. L'examen comportait trois questions, avec un seuil de réussite de 70 %. Les domaines obligatoires étaient la Loi « Sur la protection civile » et le Code du travail ; en complément, chaque participant était évalué sur les règles sectorielles liées à son poste.
La réponse était donnée à voix haute. L'IA la confrontait à la base réglementaire et restituait non seulement un pourcentage, mais aussi la structure de la réponse : ce qui avait été correctement développé, ce qui était resté incomplet, où se trouvait l'erreur et à quelle source réglementaire il fallait revenir.
C'est là que l'avantage principal est apparu clairement : le système ne vérifie pas la mémoire d'une option de réponse, mais la capacité de la personne à expliquer elle-même l'exigence.
Ce qui s'est révélé peu pratique dans la première version
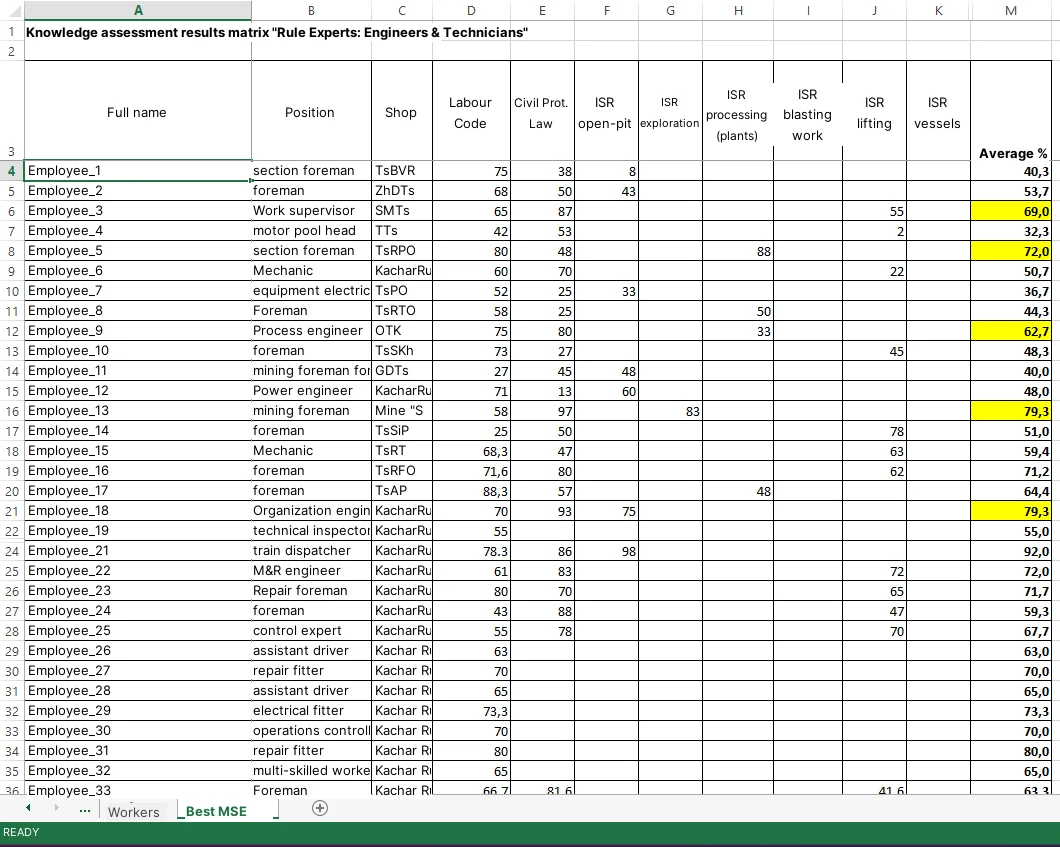
Le pilote a validé le principe lui-même, mais il a aussi révélé des points faibles. Il fallait copier le procès-verbal et l'enregistrer séparément dans Word. Le pourcentage final était ensuite reporté à la main dans Excel. Chaque domaine avait ses propres carnets et agents conversationnels, si bien que le spécialiste devait passer de l'un à l'autre.
De plus, la première version identifiait la personne examinée par son nom complet, son poste et son service. Pour un pilote interne, c'était compréhensible, mais en poursuivant le développement, une évidence s'est imposée : si une partie du traitement est effectuée par un modèle infonuagique, mieux vaut retirer les données personnelles de ce flux.
C'est ainsi qu'est née l'étape suivante : non pas un prompt de plus, mais notre propre environnement logiciel.
Troisième étape : l'examinateur portable dans le navigateur
La nouvelle version fonctionne comme une application HTML/JavaScript portable, dans une fenêtre de navigateur dédiée. Elle ne nécessite ni Python, ni Node.js, ni base de données, ni droits d'administrateur. La banque de questions, les sources réglementaires, l'historique des examens et les paramètres sont stockés localement sur l'ordinateur.
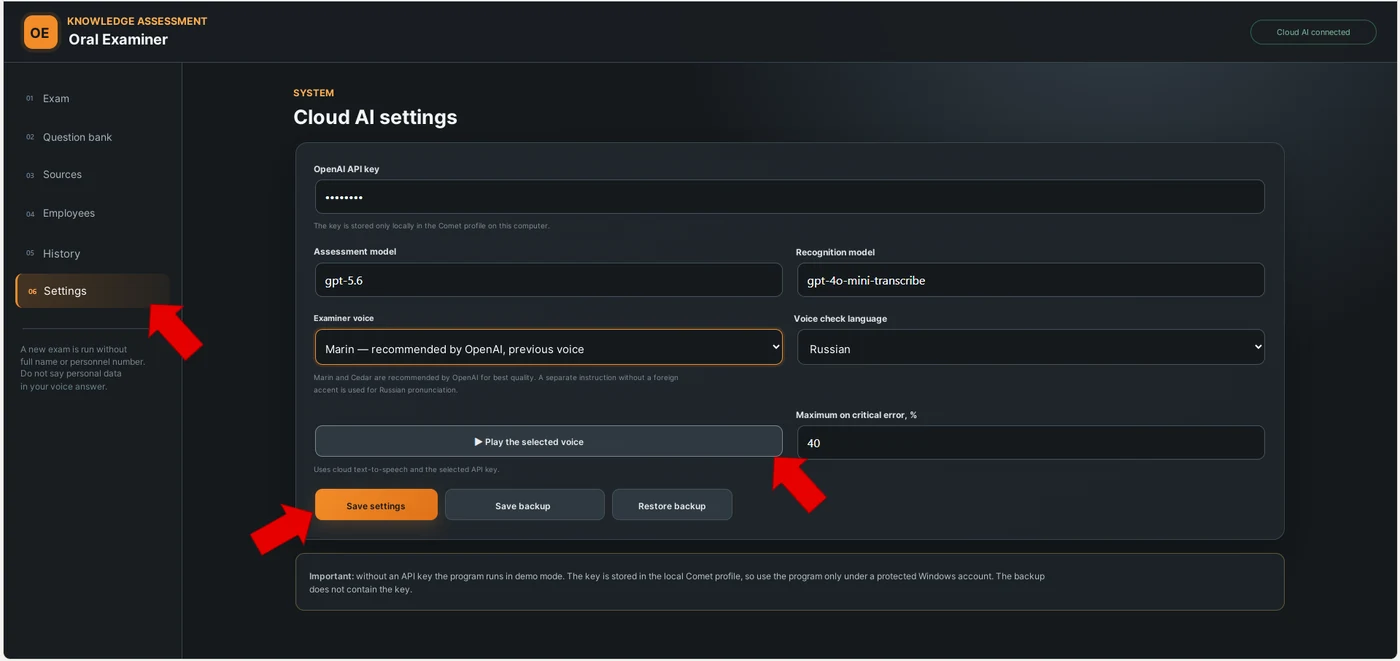
Il est important de bien distinguer la partie locale de la partie infonuagique. L'interface elle-même, la base locale, le choix des questions, le calcul du pourcentage final, le procès-verbal Word et l'export Excel s'exécutent sur l'ordinateur de l'utilisateur. En revanche, la reconnaissance vocale, l'évaluation sémantique de la réponse, la synthèse vocale infonuagique et la génération de projets de questions à partir d'un texte réglementaire font appel à un modèle infonuagique. Ce n'est donc pas une « IA entièrement hors ligne », mais un environnement local sécurisé, avec un volet infonuagique réduit au strict nécessaire.
En quelques jours, cette architecture nous a apporté ce qui manquait au premier pilote : une interface unique au lieu d'une série d'agents conversationnels, une banque unique de questions validées, un procès-verbal automatique et un historique cumulatif des résultats.
Si le lecteur souhaite reproduire la version actuelle à partir de zéro, la requête de départ principale est le Prompt 3. Il est conçu précisément pour le vibe coding : l'IA guide un non-programmeur pas à pas, une action à la fois, en vérifiant chaque résultat.
Données personnelles : un code RSS au lieu du nom complet
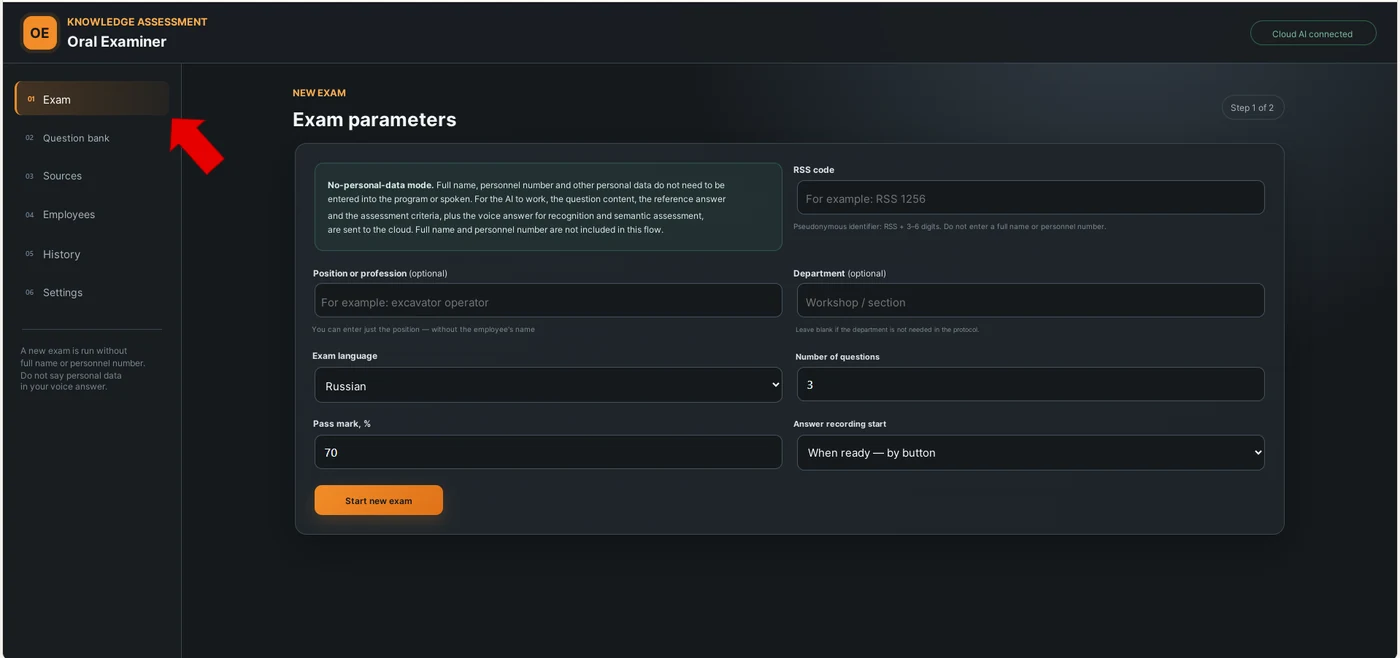
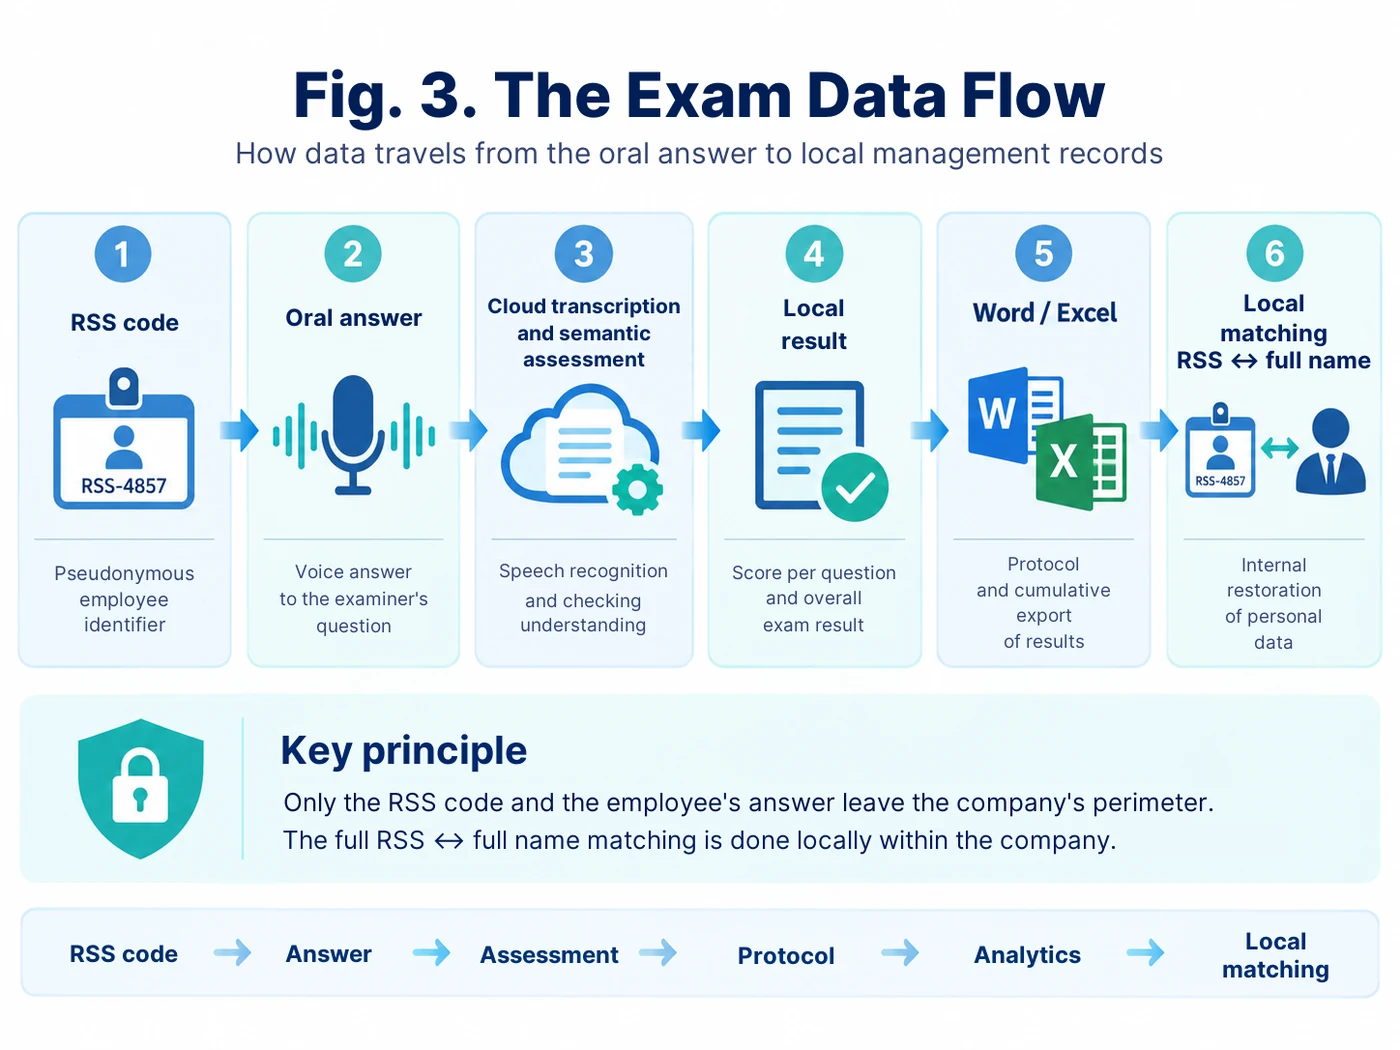
Dans la nouvelle version, le travailleur ne saisit ni son nom complet ni son matricule. Avant l'examen, on utilise un code RSS pseudonyme, du type RSS 1256. La correspondance RSS ↔ nom complet est conservée séparément, au sein du périmètre de l'entreprise, et peut être rapprochée des résultats en local.
Il n'est pas nécessaire de transmettre le nom complet ou le matricule dans le flux infonuagique. Pour l'évaluation sémantique, le modèle n'a besoin que de la question, de la réponse de référence, des critères et de la réponse orale du travailleur. L'interface précise d'ailleurs qu'il ne faut pas non plus prononcer de données personnelles au microphone.
Le procès-verbal Word conserve le code RSS et laisse vides les champs du nom complet et de l'objet de l'évaluation des connaissances, à remplir après le téléchargement. L'export Excel journalier contient lui aussi le code RSS, le poste, le service, la langue, le nombre de questions et le résultat — sans nom complet ni matricule.
Voir l'annexe : Prompt 8 — audit des données personnelles et séparation honnête entre volet local et volet infonuagique. Pour la logique des résultats Word/Excel automatiques, voir le Prompt 7.
Comment la banque de questions est désormais constituée
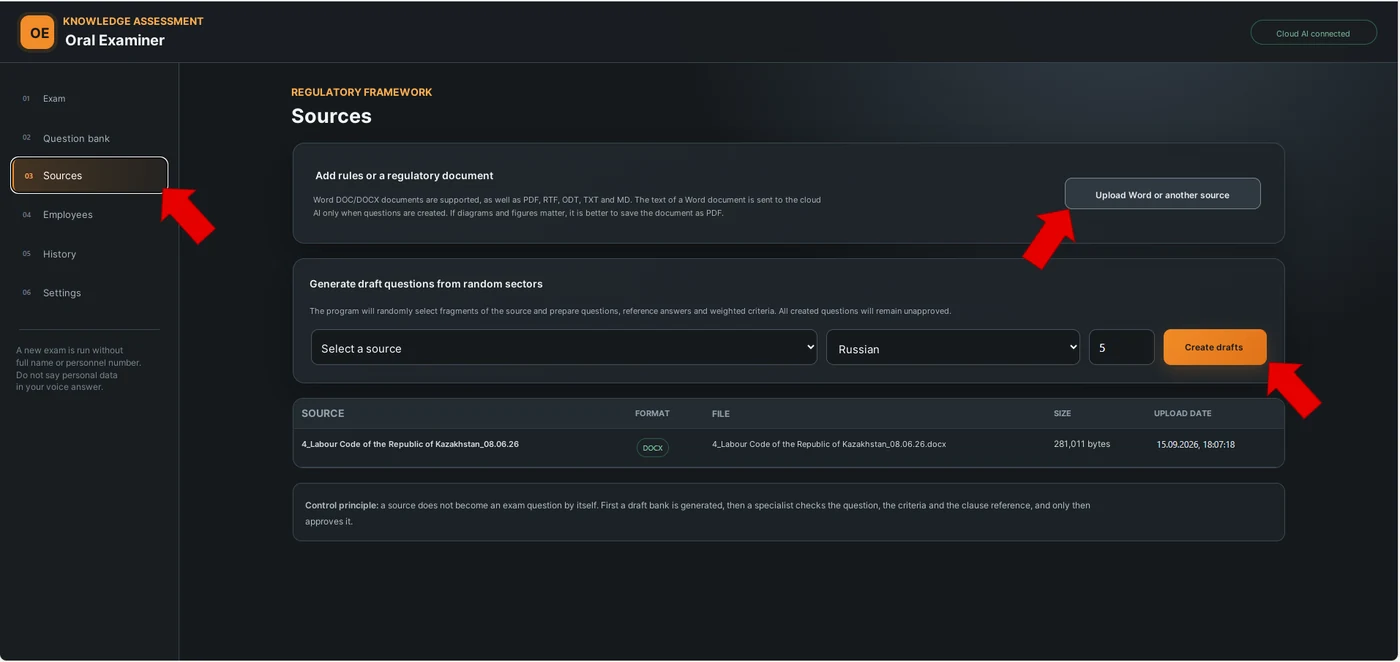
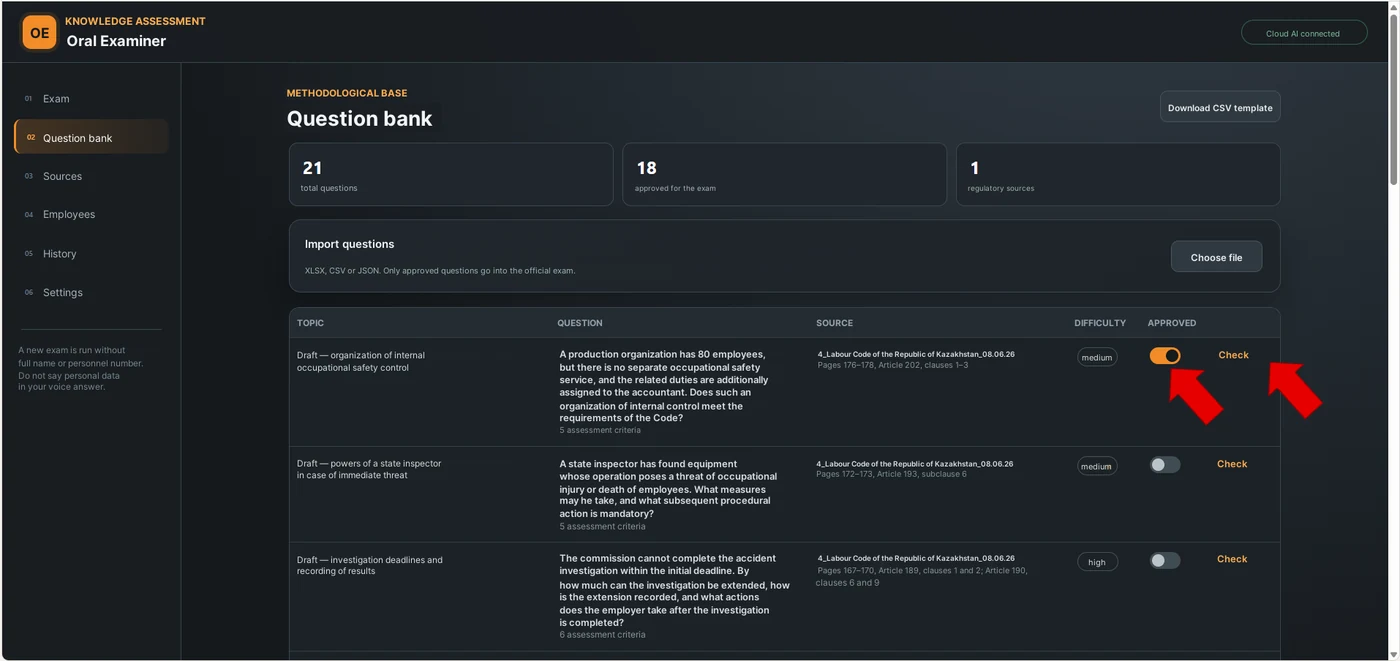
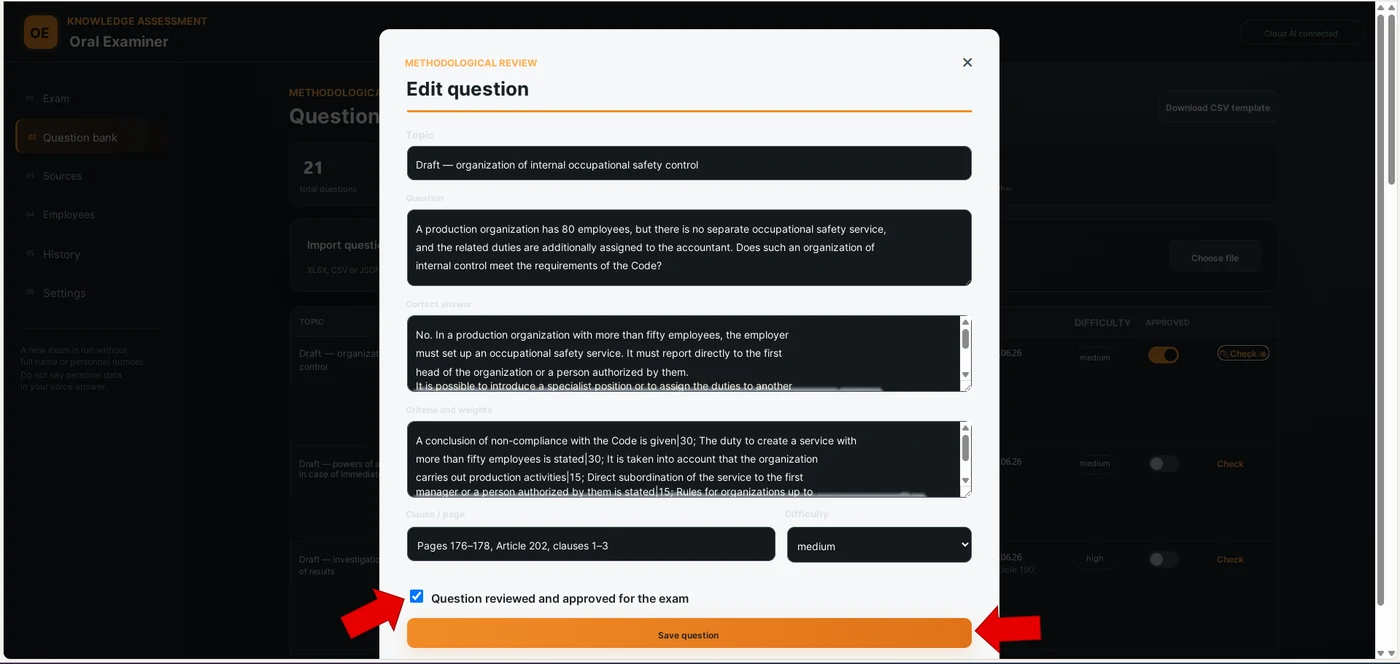
C'est une autre différence fondamentale avec la première version. Il n'est plus nécessaire de préparer à la main, à l'avance, exactement 300 questions. On peut charger dans le programme une source réglementaire : Word, PDF, RTF, ODT, TXT ou Markdown. L'IA sélectionne alors des passages substantiels répartis sur l'ensemble du document et crée des projets de questions, des réponses de référence et de 2 à 8 critères d'évaluation pondérés.
Mais une question générée automatiquement n'entre pas directement dans l'examen officiel. Elle reçoit le statut de projet. Le spécialiste doit vérifier la formulation, la réponse de référence, les critères et le renvoi à la source, et seulement ensuite valider la question. Seules les questions validées sont utilisées pour l'examen.
On peut aussi importer une banque préparée à l'avance au format CSV ou XLSX. Chaque question conserve le thème, la langue, la source, le niveau de difficulté, la réponse de référence et les critères. Différents domaines d'évaluation peuvent ainsi être gérés dans une seule application, et non dans des agents conversationnels distincts.
Le tirage au sort a lui aussi changé. Au lieu de notre ancienne formule fondée sur l'heure, le programme utilise le générateur cryptographique de nombres aléatoires du système et sélectionne le nombre voulu de questions validées. C'est plus simple, plus fiable, et l'IA n'a plus à simuler le hasard.
Voir l'annexe : Prompt 4 — génération de projets de questions à partir d'une source réglementaire, avec revue méthodologique obligatoire ; Prompt 9 — regroupement de plusieurs domaines d'examen dans une seule interface.
L'examen en pratique : question à voix haute — réponse à voix haute
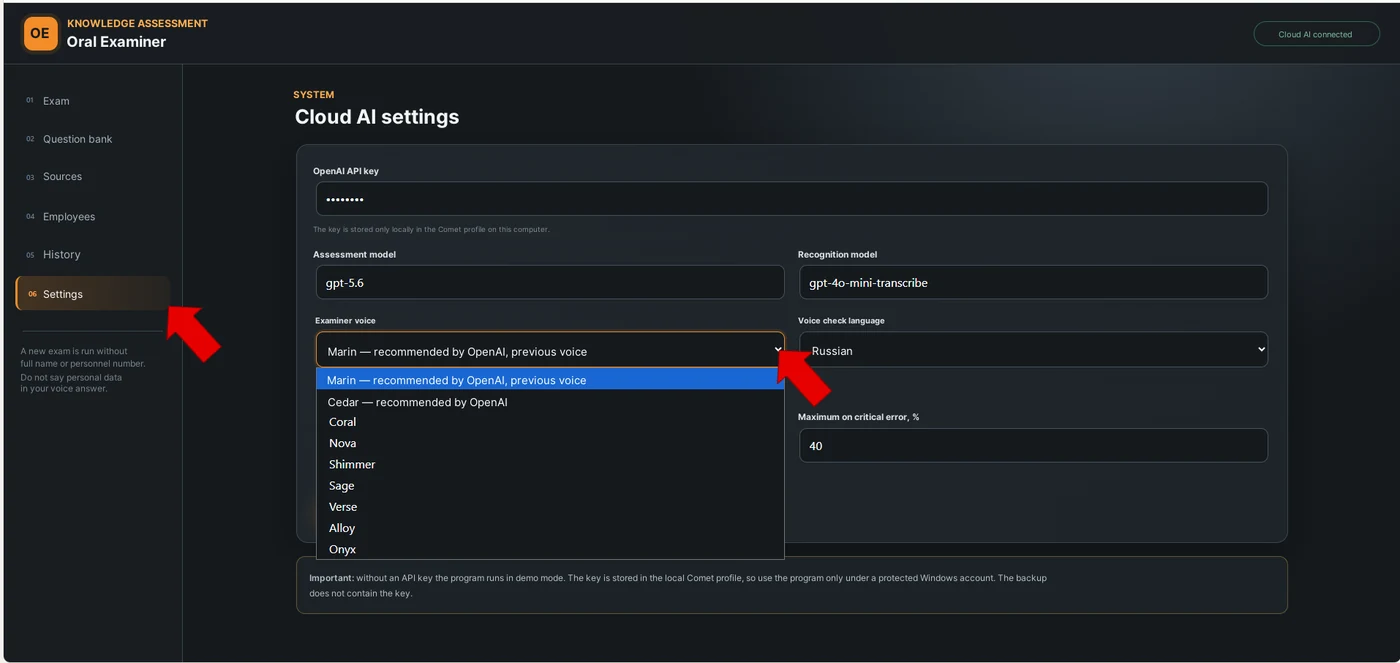
La personne examinée choisit le russe ou le kazakh. La question peut être lue à l'écran ou écoutée. Chaque langue dispose de ses propres consignes de synthèse vocale, afin que l'élocution soit naturelle et correcte, sans accent étranger superflu.
L'accès au microphone est demandé une seule fois pour tout l'examen. La réponse peut démarrer manuellement, d'un clic sur un bouton, ou automatiquement après 30 secondes, une, deux ou trois minutes de préparation. Après l'enregistrement, le système reconnaît la parole, affiche la transcription et permet de vérifier le texte avant l'évaluation.
Répondre avec ses propres mots n'est pas un défaut. L'évaluateur ne regarde pas la formulation littérale, mais le sens. Pour chaque critère, plusieurs états sont possibles : entièrement traité, partiellement traité, absent ou contraire à l'exigence. Un algorithme calcule ensuite le pourcentage selon des pondérations définies à l'avance. En cas d'erreur critique dangereuse, un plafonnement distinct de la note maximale peut s'appliquer.
Ainsi, le modèle génératif est chargé de comprendre le sens, tandis que le pourcentage final est calculé de manière déterministe à partir de la structure des critères. C'est une séparation essentielle : l'IA ne doit pas « inventer une note » librement.
Voir l'annexe : Prompt 5 — évaluation sémantique de la réponse selon des critères ; Prompt 6 — calcul programmatique distinct du pourcentage. Le modèle détermine ainsi le contenu de la réponse, tandis que le score final est calculé de manière déterministe.
La vidéo « L'examen oral dans la version navigateur » se trouve à la fin de l'article.
La vidéo montre le résultat final : le lancement de l'examen, la réponse orale, l'évaluation, la génération et le téléchargement du procès-verbal, l'historique et l'export qui suit. La logique pas à pas pour créer une telle application commence avec le Prompt 3.
Le procès-verbal et l'historique sont désormais générés automatiquement
À la fin de l'examen, le spécialiste obtient un procès-verbal Word prêt à l'emploi. On y retrouve les questions, les transcriptions des réponses, les notes, les sources réglementaires, les points forts, les éléments manquants et les erreurs. Le champ du nom complet reste vide, le code RSS est conservé.
En parallèle, chaque examen est enregistré dans l'historique local. En fin de journée, le spécialiste choisit une date et clique sur « Exporter Excel pour la date ». Un tableau unique est généré pour tous les examens : date, heure, RSS, poste, service, langue, nombre de questions, seuil de réussite, pourcentage final, résultat et statut.
Cet export Excel peut déjà alimenter un formulaire cumulatif, puis un tableau de bord interactif. Nous avons donc retrouvé le principe utilisé dans nos publications précédentes : d'abord une opération isolée, puis l'accumulation de données structurées, et enfin l'analyse décisionnelle.
Voir l'annexe : Prompt 7 — structure du procès-verbal Word et de l'export Excel journalier, sans nom complet ni matricule.
Où cela peut être utilisé
Un tel examinateur ne se limite pas à la sécurité industrielle. Selon la même logique, on peut évaluer les connaissances sur les exigences de santé et sécurité au travail, les règles sectorielles, les consignes, les règlements technologiques, les normes internes et tout autre document pour lequel il importe non pas de choisir la bonne lettre, mais d'expliquer l'exigence avec ses propres mots.
Il peut servir de contrôle préalable avant le passage devant la commission, d'élément de formation, d'examen oral sur des domaines précis ou d'outil de contrôle ponctuel de la compréhension des exigences. Mais lorsque la législation ou les procédures internes exigent une commission et des personnes habilitées, la décision finale reste entre les mains des humains.
Le principal changement par rapport au premier pilote : nous sommes passés d'une série d'agents conversationnels IA distincts et d'un report manuel des résultats à un processus unique et reproductible : source → question validée → réponse orale → évaluation sémantique → procès-verbal → Excel → analyse.
Ce qui, à mon avis, est le plus important ici
La partie la plus précieuse du projet, ce n'est ni la voix ni la belle interface. C'est le changement de la logique même de l'évaluation des connaissances.
Le test demande : « Sauras-tu reconnaître la bonne réponse ? » L'examen oral demande : « Sauras-tu expliquer toi-même ce qu'il faut faire, et pourquoi ? »
L'IA rend ce format applicable à grande échelle. Elle ne supprime pas la responsabilité de la commission et ne remplace pas les exigences réglementaires. Elle permet de poser les questions de la même manière, d'analyser le sens de la réponse de la même manière et de mettre immédiatement en évidence les lacunes concrètes à combler.
Annexe : prompts accompagnant l'article
La logique historique de la première version + des prompts actualisés pour l'examinateur portable dans le navigateur
L'annexe sépare volontairement l'ancienne et la nouvelle approche. Les premiers prompts montrent l'évolution. Les suivants décrivent une architecture actuelle plus pratique, où la source, la génération de la banque, la revue méthodologique, la réponse orale, l'évaluation, Word et Excel sont séparés.
Prompt 1. Examinateur historique NotebookLM + Gemini avec banque de 300 questions
Lien avec l'article : sections « Deuxième étape : NotebookLM comme base de connaissances, Gemini Bot comme examinateur » et « Comment fonctionnait notre premier générateur de nombres aléatoires ».
RÔLE
Tu es un examinateur exigeant chargé d'évaluer les connaissances des exigences en matière de sécurité industrielle, de protection civile et de santé et sécurité au travail.
Travaille uniquement à partir de la base réglementaire connectée et de la banque de questions validée. N'utilise ni Internet ni des connaissances externes. N'invente pas d'exigences.

LANGUE
L'examen se déroule dans la langue choisie : RU ou KZ. Ne mélange pas les langues.

STRUCTURE
L'examen comporte 3 questions. Pose une seule question à la fois. La question suivante — uniquement après la réponse à la précédente et son évaluation.
Seuil de réussite : 70%.

CHOIX DE LA QUESTION 1
Après la saisie des données, relève l'heure locale :
H — heures ; M — minutes ; S — secondes ; MS — millisecondes.
Si une valeur est égale à 0, remplace-la par 1.
R1 = H × M × S × MS.
Tant que R1 > 300 : R1 = R1 / 300.
INDEX1 = ceil(R1). Si INDEX1 = 0, utilise 1.
Pose la question n° INDEX1 de la banque validée de 300 questions.

QUESTION 2
Après avoir reçu la réponse à la question 1, relève de nouveau H, M, S, MS et refais le calcul.
Si le nouveau numéro a déjà été utilisé, augmente-le de 1. Si le numéro devient >300, utilise 1.

QUESTION 3
Après avoir reçu la réponse à la question 2, répète la même procédure. N'autorise aucune répétition des questions déjà posées.

ÉVALUATION DE LA RÉPONSE
Évalue le sens, pas la formulation mot pour mot.
1. Exactitude — jusqu'à 60%.
2. Exhaustivité — jusqu'à 25%.
3. Logique — jusqu'à 15%.
En cas d'affirmation dangereuse, d'action interdite ou de contradiction critique avec une exigence réglementaire, le résultat de la question ne doit pas dépasser 30%.
Pour chaque question, indique :
- le numéro et la formulation ;
- la source réglementaire ;
- ce qui est correctement traité ;
- ce qui n'est pas mentionné ;
- ce qui est dit de manière erronée ;
- le pourcentage obtenu pour la question.

RÉSULTAT FINAL
RESULT = (Q1 + Q2 + Q3) / 3.
Arrondis le résultat à l'entier.
≥70% — ADMIS.
<70% — NON ADMIS.
Après la troisième réponse, établis le procès-verbal final.
Prompt 2. Préparation d'une banque de questions d'examen à partir d'un texte réglementaire
Lien avec l'article : la banque historique de 300 questions de la deuxième étape. Ce prompt est utile si la banque est préparée à l'avance à partir d'un texte réglementaire.
Je charge un texte réglementaire.
Il faut préparer une banque de questions pour un examen oral.

Règles :
1. Travaille uniquement à partir du document chargé.
2. N'utilise pas de connaissances externes.
3. Ne demande pas les numéros d'articles et d'alinéas pour tester la mémoire — vérifie la compréhension pratique des exigences.
4. Répartis les questions sur l'ensemble du document, et pas seulement sur les premières sections.
5. Élimine les doublons et les questions presque identiques.
6. Pour chaque question, prépare une réponse de référence et un renvoi à la source.
7. Dans la réponse de référence, fais ressortir les éléments obligatoires sans lesquels la réponse ne peut pas être considérée comme complète.
8. Signale séparément les erreurs critiques — les affirmations qui pourraient conduire à une action dangereuse.

Format du tableau :
N° | Thème | Question | Réponse de référence | Éléments obligatoires | Erreur critique | Document | Article/alinéa | Page | Langue

Prépare jusqu'à 300 questions. Si le texte réglementaire ne contient pas assez de matière pour 300 questions réellement différentes, ne crée pas de répétitions artificielles : arrête-toi au nombre effectivement justifié.
Prompt 3. Prompt maître pour le vibe coding d'un examinateur HTML portable
Lien avec l'article : section « Troisième étape : l'examinateur portable dans le navigateur ». C'est le prompt principal pour le lecteur qui souhaite reproduire la version actuelle.
Je ne suis pas programmeur. Guide-moi pas à pas dans la création d'un examinateur oral IA portable.
Ne me donne pas 20 actions d'un coup. À chaque étape :
1. Explique ce que nous faisons et pourquoi.
2. Donne une seule action concrète ou un seul bloc de code/fichier prêt à l'emploi.
3. Attends ma capture d'écran ou mon résultat.
4. Vérifie la capture d'écran et seulement ensuite passe à la suite.

ARCHITECTURE CIBLE
- application HTML/JavaScript portable ;
- lancement sous Windows sans Python, Node.js ni droits d'administrateur ;
- stockage local de la banque de questions, des sources et de l'historique ;
- ni nom complet ni matricule dans le flux de l'examen ;
- code RSS pseudonyme obligatoire, du type RSS 1256 ;
- langues russe et kazakhe ;
- import de la banque de questions depuis XLSX/CSV ;
- chargement de sources réglementaires DOC/DOCX/PDF/RTF/ODT/TXT/MD ;
- génération de projets de questions à partir de secteurs de la source répartis aléatoirement ;
- chaque question générée doit être vérifiée et validée par un spécialiste avant l'examen ;
- chaque question conserve le thème, la formulation, la réponse de référence, 2 à 8 critères pondérés, la source et le renvoi à l'alinéa ;
- seules les questions validées sont utilisées pour l'examen ;
- le tirage au sort des questions se fait par programme, via un générateur cryptographique, et non via le « hasard » du modèle ;
- le nombre de questions et le seuil de réussite sont paramétrables ;
- réponse orale au microphone ;
- mode de démarrage de la réponse : manuel ou automatique après 30/60/120/180 secondes de préparation ;
- accès au microphone demandé une seule fois pour tout l'examen ;
- reconnaissance vocale par un modèle infonuagique ;
- évaluation sémantique de la réponse selon des critères ;
- calcul déterministe du pourcentage selon les pondérations des critères ;
- en cas d'erreur critique, application d'un plafond de note paramétrable ;
- lecture vocale naturelle de la question en RU/KZ, voix du système en secours ;
- procès-verbal Word automatique ;
- historique local ;
- export Excel de tous les examens pour la date choisie ;
- copie de sauvegarde de la base locale sans la clé API.

SÉCURITÉ
Sépare clairement le volet local et le volet infonuagique. Explique quelles données partent dans le nuage. N'y transmets ni le nom complet ni le matricule. Dans l'interface vocale, affiche un avertissement explicite demandant de ne pas prononcer de données personnelles.

Commence par l'architecture et la structure des fichiers. N'écris le code qu'après ma confirmation.
Prompt 4. Génération de projets de questions à partir d'une source réglementaire pour la nouvelle version
Lien avec l'article : section « Comment la banque de questions est désormais constituée » — génération de projets de questions à partir des sources réglementaires chargées.
Tu produis uniquement des PROJETS de questions d'examen. Aucune question créée n'est considérée comme validée automatiquement.

Entrée :
- texte réglementaire ;
- langue RU ou KZ ;
- nombre de projets de questions demandé ;
- nombre aléatoire/seed généré par le programme.

Tâche :
1. À l'aide du seed, choisis des secteurs substantiels répartis sur l'ensemble du document, si possible non consécutifs.
2. Travaille uniquement à partir du document.
3. À partir de chaque secteur, formule une question ayant une réelle portée pratique.
4. Ne demande pas le numéro d'alinéa comme une fin en soi.
5. Prépare une réponse de référence concise.
6. Prépare de 2 à 8 critères d'évaluation. Chaque critère doit vérifier un élément de sens distinct.
7. Attribue des pondérations aux critères de sorte que leur somme soit exactement égale à 100.
8. Indique le thème, la difficulté, la page/l'article/l'alinéa ou tout autre renvoi à la source.
9. Ne reprends pas en double des questions issues de passages voisins.
10. Si un secteur ne contient pas d'exigence suffisante pour une question substantielle, ignore-le et choisis-en un autre.

Renvoie un résultat structuré :
Thème | Question | Réponse de référence | Critères pondérés | Source | Renvoi | Difficulté | Langue

Statut de chaque résultat : PROJET, REVUE MÉTHODOLOGIQUE REQUISE.
Prompt 5. Évaluation sémantique d'une réponse orale selon des critères
Lien avec l'article : section « L'examen en pratique : question à voix haute — réponse à voix haute » — le modèle détermine dans quelle mesure le sens de chaque critère a été traité.
Tu es un examinateur exigeant mais objectif en santé et sécurité au travail et en sécurité industrielle.

Évalue le sens, pas la correspondance mot pour mot.
Accepte les synonymes et les formulations familières s'ils traduisent sans ambiguïté l'exigence réglementaire.
Travaille uniquement à partir de la question, de la réponse de référence, des critères et de l'extrait réglementaire fournis.
N'ajoute pas d'exigences tirées de ta mémoire ou d'Internet.

Pour CHAQUE critère, renvoie exactement un statut :
- FULL — entièrement traité ;
- PARTIAL — une part essentielle est traitée, mais il reste une lacune ;
- MISSING — l'élément est absent ;
- INCORRECT — la réponse contredit l'exigence.

Pour chaque critère, cite un bref élément de preuve tiré de la réponse du travailleur et ajoute une explication.

CRITICAL_ERROR = true uniquement lorsque la réponse contient une affirmation ou une action dangereuse qui crée un risque inacceptable et contredit une exigence réglementaire.
N'utilise pas critical_error pour une simple réponse incomplète.

Établis séparément :
- WELL_SAID — ce qui est bien traité ;
- PARTLY_SAID — ce qui est partiellement traité ;
- MISSING — ce qui n'est pas dit ;
- INCORRECT — ce qui est dit de manière erronée ;
- SUMMARY — une brève conclusion dans la langue de l'examen.

Ne calcule pas le pourcentage final « à vue d'œil ». Le pourcentage doit être calculé par un algorithme, selon les pondérations des critères, une fois tes statuts reçus.
Prompt 6. Logique programmatique de calcul déterministe du score
Lien avec l'article : la même section « L'examen en pratique : question à voix haute — réponse à voix haute » — le pourcentage est calculé par programme, et non attribué « à vue d'œil » par le modèle.
Mets en œuvre le calcul du score NON PAS par une évaluation libre du modèle, mais par programme.

Chaque critère a une pondération weight exprimée en pourcentage.
Coefficients :
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = somme(weight × coefficient) sur l'ensemble des critères.
Borne le résultat à l'intervalle 0–100 et arrondis à 0,1.

Si l'évaluateur IA a renvoyé critical_error=true :
SCORE = min(SCORE, CRITICAL_CAP), où CRITICAL_CAP est défini dans les paramètres (par exemple 40%).

Après toutes les questions :
TOTAL_SCORE = moyenne arithmétique des scores obtenus aux questions.
PASSED = TOTAL_SCORE >= seuil de réussite fixé.

Important :
- le modèle détermine le statut sémantique du critère ;
- le programme calcule le pourcentage ;
- le modèle ne doit pas attribuer de lui-même un score final arbitraire.
Prompt 7. Procès-verbal Word et export Excel journalier sans données personnelles
Lien avec l'article : section « Le procès-verbal et l'historique sont désormais générés automatiquement » — procès-verbal Word et export Excel journalier.
Améliore l'examinateur oral.

PROCÈS-VERBAL WORD
À la fin de l'examen, génère automatiquement un fichier .docx.
Le procès-verbal doit contenir :
- la date ;
- le code RSS ;
- le poste/métier ;
- le service ;
- la langue ;
- le seuil de réussite ;
- le résultat final ADMIS/NON ADMIS ;
- chaque question ;
- la transcription de la réponse ;
- le pourcentage obtenu pour la question ;
- la source réglementaire et le renvoi ;
- ce qui est bien traité ;
- ce qui n'est pas dit ;
- les erreurs.

Laisser vides les champs « Nom complet » et « Objet de l'évaluation des connaissances », à remplir localement après le téléchargement.
Nom du fichier : Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL POUR UNE DATE
Dans la section « Historique », ajouter un sélecteur de date et un bouton « Exporter Excel pour la date ».
Colonnes :
N° | Date de l'examen | Heure de début | Code RSS | Poste/métier | Service | Langue | Nombre de questions | Seuil de réussite % | Score final % | Résultat | Statut | Heure de fin | Identifiant de l'examen.

Ne pas inclure le nom complet ni le matricule.
Générer le fichier Excel uniquement à partir de l'historique local de l'ordinateur utilisé.
La correspondance RSS <-> nom complet ne doit être rapprochée des résultats qu'hors ligne, au sein du périmètre de l'entreprise.
Prompt 8. Audit des données personnelles et frontières hors ligne/infonuagique
Lien avec l'article : sections « Troisième étape : l'examinateur portable dans le navigateur » et « Données personnelles : un code RSS au lieu du nom complet ».
Réalise un audit technique de l'application d'examinateur oral.
Il faut distinguer honnêtement les opérations locales et les opérations infonuagiques.

Vérifie et décris :
1. Quelles données sont stockées dans IndexedDB/localStorage.
2. Quelles données sont envoyées au modèle infonuagique lors de la transcription.
3. Quelles données sont envoyées lors de l'évaluation sémantique.
4. Quelles données sont envoyées lors de la génération de projets de questions.
5. Si le nom complet, le matricule, la liste des travailleurs ou la table de correspondance RSS <-> nom complet sont transmis.
6. Où est stockée la clé API.
7. Si la copie de sauvegarde contient la clé API.
8. Ce qui subsiste après la fermeture complète de l'application.
9. Comment supprimer l'historique local et les sources.
10. Quels risques subsistent pendant l'exploitation pilote.

Exigence concernant la formulation du résultat :
ne qualifie pas l'application d'« entièrement hors ligne » si la reconnaissance vocale, l'évaluation, la TTS ou la génération de questions utilisent une API infonuagique.
Formulation correcte : « environnement local portable, avec base de données locale et volet IA infonuagique maîtrisé ».
Prompt 9. Ajout de plusieurs domaines d'examen dans une seule interface
Lien avec l'article : section « Comment la banque de questions est désormais constituée » — plusieurs règles et domaines dans un seul examinateur, sans passer d'un agent conversationnel à l'autre.
Améliore la banque de questions et l'écran de lancement de l'examen afin qu'il ne soit plus nécessaire de créer un agent conversationnel distinct pour chaque règle.

Chaque question possède déjà un champ « Thème/domaine ».
Ajoute à l'écran de l'examen un choix de domaines :
- un seul bloc thématique ;
- plusieurs blocs thématiques à la fois ;
- le mode « Tous les domaines sélectionnés ».

Au lancement de l'examen :
1. filtre uniquement les questions validées ;
2. tiens compte de la langue choisie ;
3. tiens compte des domaines choisis ;
4. tire au sort le nombre de questions défini à l'aide du générateur cryptographique du programme ;
5. dans la mesure du possible, répartis les questions de manière égale entre les domaines choisis ;
6. n'autorise aucune répétition ;
7. si les questions sont insuffisantes pour la sélection choisie, interromps le lancement et affiche un message clair.

Dans le procès-verbal Word et dans Excel, enregistre en plus les domaines d'examen choisis.
Comment utiliser l'annexe de l'article
La numérotation ci-dessous est synchronisée avec le texte de la publication. Dans l'article, à côté de l'étape correspondante, figurent des renvois directs « Voir Prompt … », et ici, sous chaque prompt, il est indiqué à quelle section de l'article il se rapporte.
- Prompt 1 — version historique : montre comment fonctionnaient le premier examinateur et notre propre générateur de numéro pour une banque de 300 questions.
- Prompt 2 — préparation d'une banque de questions étendue à partir des textes réglementaires.
- Prompt 3 — la requête principale pour le lecteur qui souhaite reproduire la version navigateur actuelle grâce au vibe coding.
- Prompt 4 — génération de projets de questions à partir de la source chargée.
- Prompt 5–6 — séparation entre l'évaluation du sens par l'IA et le calcul programmatique du pourcentage.
- Prompt 7 — Word et Excel automatiques.
- Prompt 8 — vérification obligatoire des frontières entre volet local et volet infonuagique.
- Prompt 9 — regroupement de plusieurs domaines d'examen dans une seule interface.
Commentaires 2
🤝