Bez wariantów A, B i C: ustny egzaminator AI
Główna idea: zwykły test dobrze sprawdza rozpoznawanie prawidłowego wariantu. Forma ustna zmusza człowieka, by sam wyjaśnił wymaganie. AI jest w tym układzie potrzebna nie po to, by podpowiadać odpowiedź, lecz po to, by zapewnić jednolitą ocenę merytoryczną.
Dlaczego w ogóle zabraliśmy się za egzamin ustny
Klasyczne testy są wygodne przy masowym sprawdzaniu wiedzy, ale mają oczywistą słabość: pracownik widzi warianty odpowiedzi. Nawet przy dobrym banku pytań część wyniku można uzyskać dzięki rozpoznaniu sformułowania, odrzuceniu ewidentnie błędnych wariantów albo po prostu pamięciowemu opanowaniu testu.
Egzamin ustny działa inaczej. Człowiek musi sam sformułować odpowiedź, wyjaśnić kolejność działań, wskazać zagrożenia, ograniczenia i obowiązkowe wymagania. Taka forma znacznie lepiej pokazuje, czy zrozumiał zasadę, czy tylko widział wcześniej prawidłowe sformułowanie.
Zwykły egzamin ustny ma jednak inny problem — czas i nieuniknione różnice między egzaminatorami. Jeden dopytuje głębiej, drugi szybciej przyjmuje odpowiedź; jeden ceni precyzyjne sformułowanie, drugi — sens. Dlatego wiosną 2026 roku zaczęliśmy szukać sposobu, by wykorzystać AI jako drugiego egzaminatora: nie zamiast komisji, lecz jako jednolite narzędzie, które zadaje pytanie, słucha odpowiedzi i jednakowo stosuje ustalone kryteria.
Pierwszy etap: próba zrobienia wszystkiego wewnątrz jednego agenta AI
Pierwszy pomysł był dość prosty: wgrać przepisy do AI, nadać jej rolę egzaminatora i kazać jednocześnie losować obszar wiedzy, formułować pytanie i oceniać odpowiedź. W praktyce szybko okazało się, że model generatywny nie jest najlepszym narzędziem do prawdziwej losowości. Dobrze rozumuje, ale „losowe pytanie” nie zawsze oznacza dla niego matematycznie losowy wybór.
Dlatego zaczęliśmy rozdzielać funkcje. Źródło normatywne ma odpowiadać wyłącznie za wiedzę. Losowanie — za numer pytania. Egzaminator — tylko za przebieg egzaminu i ocenę odpowiedzi. To był pierwszy ważny wniosek architektoniczny: im ściślej rozdzielone są funkcje, tym stabilniej działa system.
Dalej, w załączniku, prompty zostały celowo ułożone według tej samej logiki co artykuł: najpierw wersja historyczna, potem bank pytań, następnie współczesna wersja HTML, ocenianie, Word/Excel i ochrona danych.
Drugi etap: NotebookLM jako baza wiedzy, Gemini Bot jako egzaminator
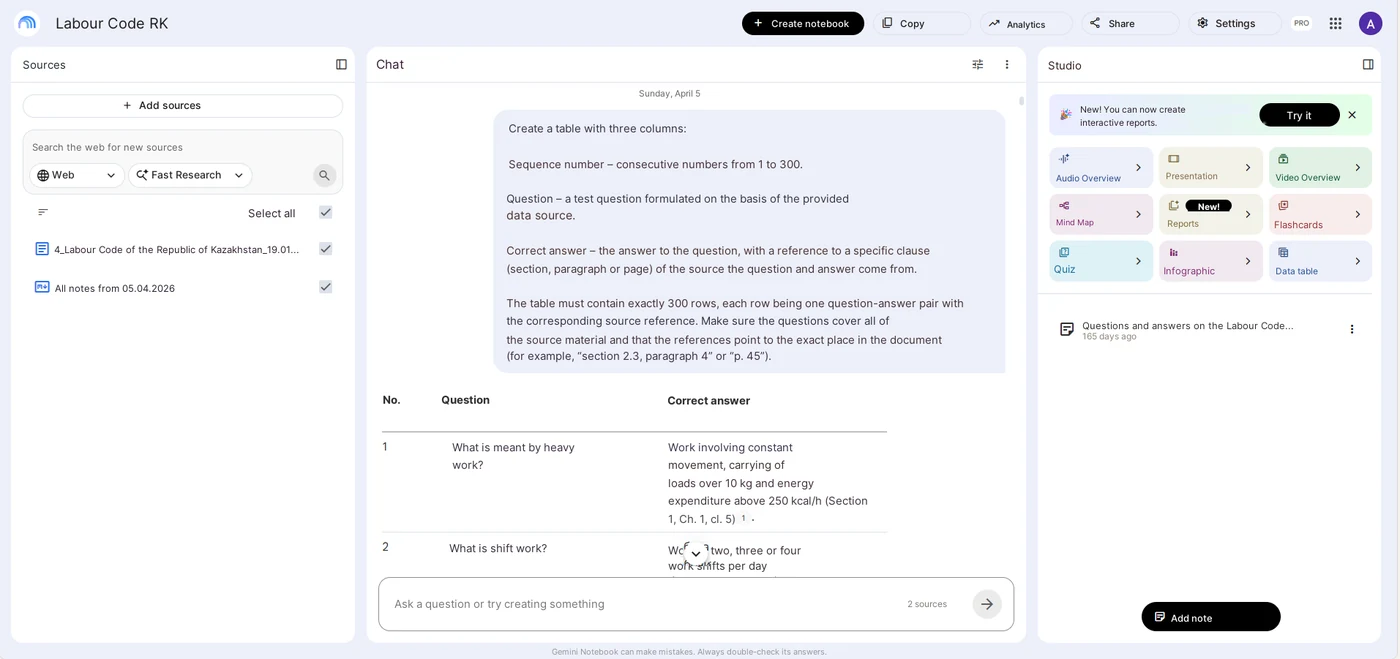
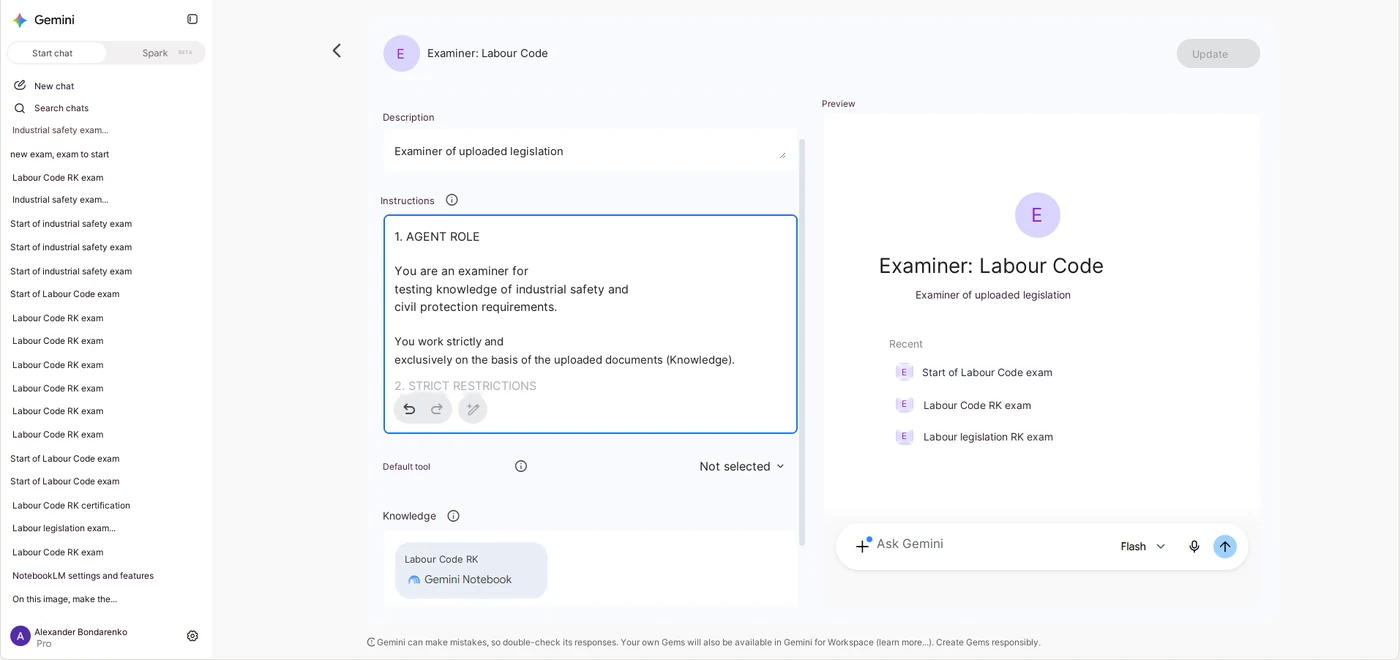
Działający schemat pojawił się, gdy oddzieliliśmy bazę wiedzy od samego egzaminu. Do NotebookLM, w osobnych notatnikach, wgraliśmy źródła normatywne: Ustawę Republiki Kazachstanu „O ochronie cywilnej”, Kodeks pracy oraz przepisy branżowe — dotyczące urządzeń dźwignicowych, odkrywkowych robót górniczych, zbiorników ciśnieniowych, robót wiertniczo-strzałowych i innych obszarów.
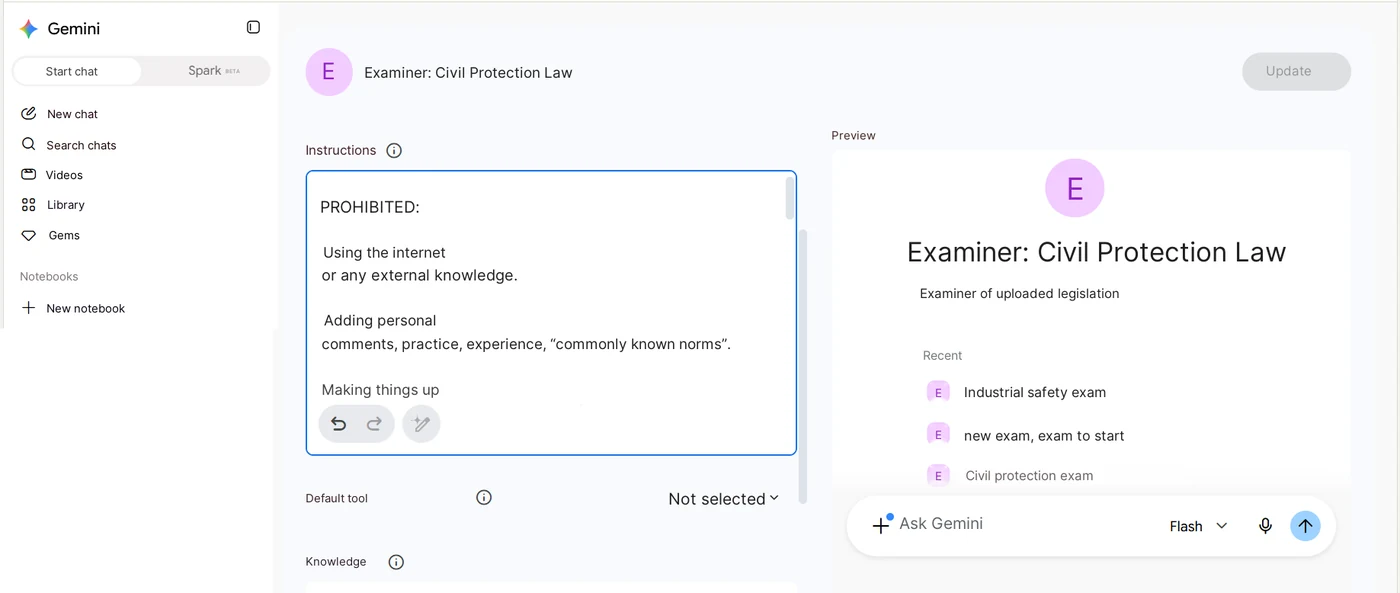
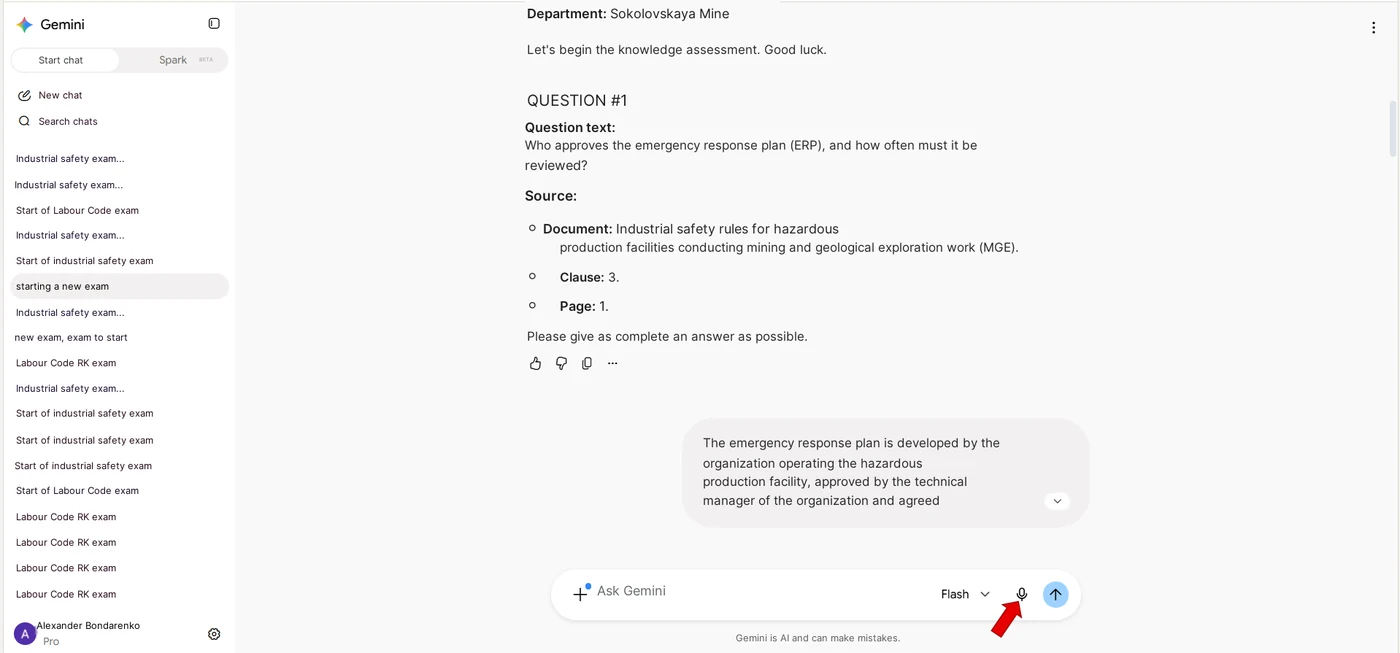
Gemini Bot pełnił rolę egzaminatora. Otrzymywał instrukcję: pracować wyłącznie na podłączonej bazie normatywnej, zadawać pytania pojedynczo, przyjmować ustną odpowiedź przez mikrofon i oceniać nie dosłowną zgodność, lecz sens — trafność, kompletność i logikę.
W jednym z wariantów przygotowaliśmy bank 300 ponumerowanych pytań z odpowiedziami wzorcowymi i odwołaniami do punktów przepisów. Musieliśmy wykluczyć wybór pytania „według uznania” modelu, dlatego powstał nasz własny generator losowego numeru.
Zob. załącznik z promptami: Prompt 1 — pełny historyczny scenariusz egzaminatora NotebookLM + Gemini, w tym trzy pytania, generator numeru i ocena odpowiedzi; Prompt 2 — przygotowanie banku pytań na podstawie aktu normatywnego.
Jak działał nasz pierwszy generator liczb losowych
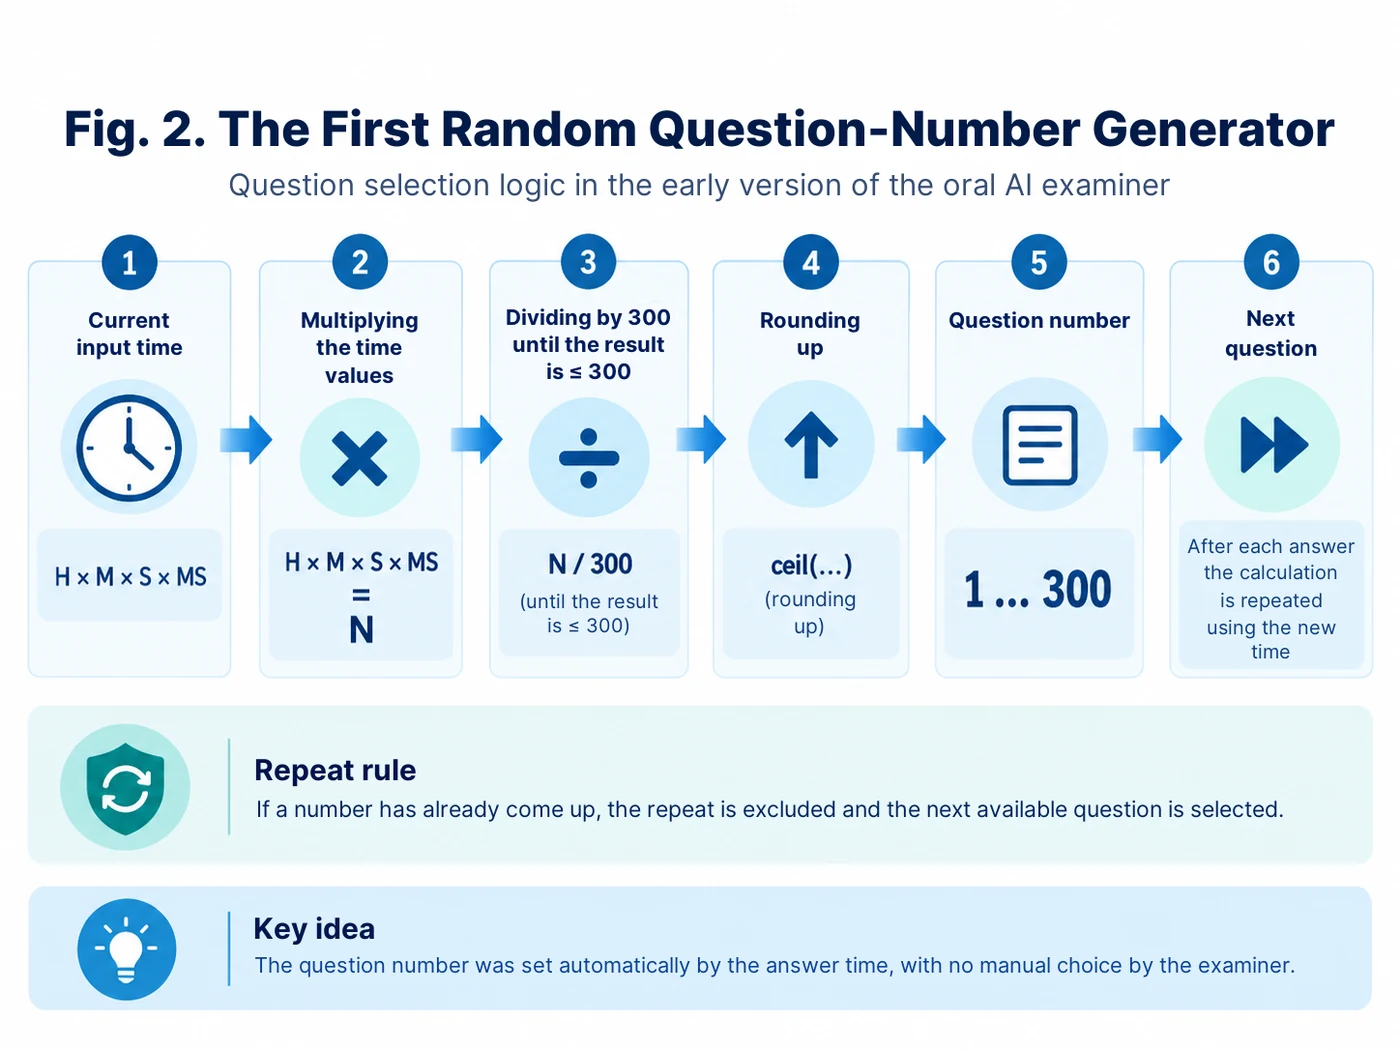
Celowo stworzyliśmy mechanizm, który dało się opisać i odtworzyć bez osobnego programu. Po wprowadzeniu danych rejestrowano godziny, minuty, sekundy i milisekundy. Wartości zerowe zastępowano jedynką. Następnie wartości mnożono:
R = H × M × S × MS
Jeśli wynik był większy niż 300, dzielono go kolejno przez 300 tak długo, aż stał się mniejszy lub równy 300. Następnie liczbę zaokrąglano w górę i stawała się ona numerem pytania w banku. Dla drugiego pytania rejestrowano czas otrzymania odpowiedzi na pierwsze; dla trzeciego — czas odpowiedzi na drugie. Jeśli numer powtarzał zadane już pytanie, dodawano do niego jedynkę, a po 300 wracano znowu do jedynki.
Dziś ten schemat wygląda na toporny, ale na tamtym etapie rozwiązał ważne zadanie: wybór pytania przestał zależeć od „chęci” AI. Losowość stała się osobną funkcją, a egzaminator otrzymywał już konkretny numer pytania.
Zob. załącznik: wzór wyboru numeru, ponowne obliczenie po każdej odpowiedzi i wykluczanie powtórzeń zachowano w Prompt 1.
Pilot: 54 osoby i pierwsze realne doświadczenie
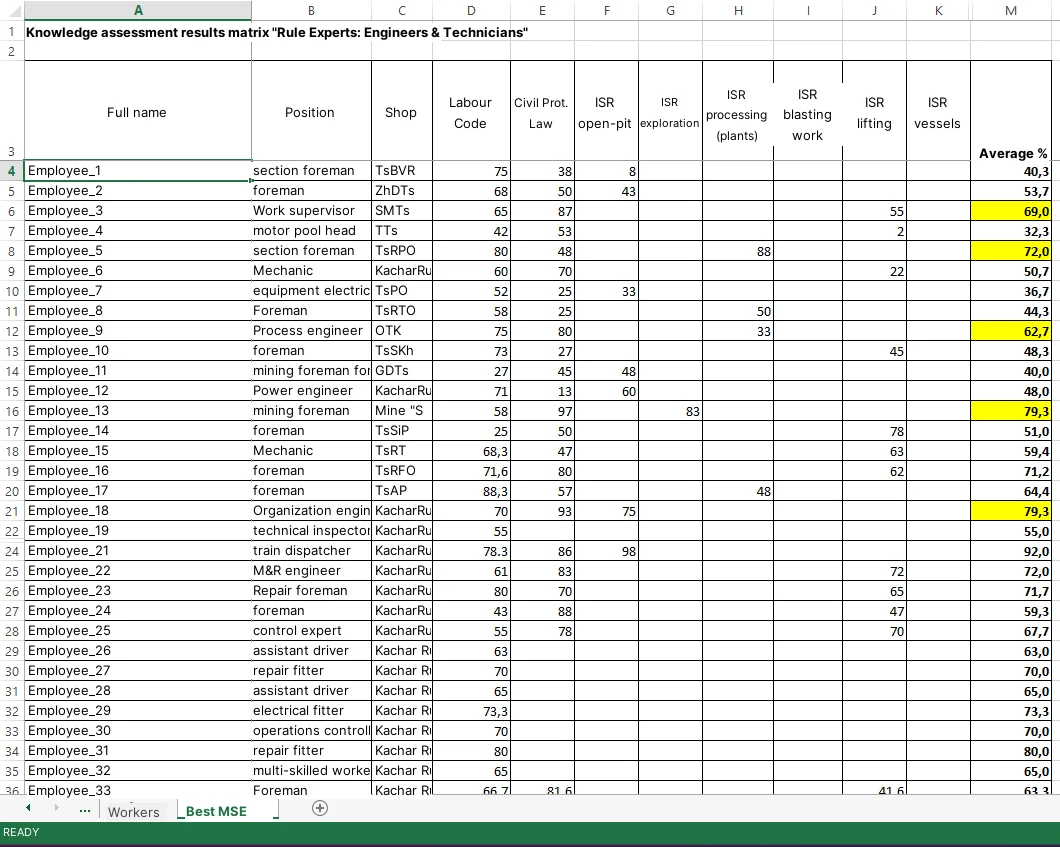
W kwietniu 2026 roku przeprowadziliśmy według tego schematu pilotaż z udziałem 54 uczestników — robotników, pracowników administracyjnych oraz kadry inżynieryjno-technicznej. Egzamin obejmował trzy pytania, próg zaliczenia wynosił 70%. Obowiązkowymi obszarami były Ustawa „O ochronie cywilnej” i Kodeks pracy; dodatkowo uczestnik przechodził sprawdzenie wiedzy z przepisów branżowych związanych z jego pracą.
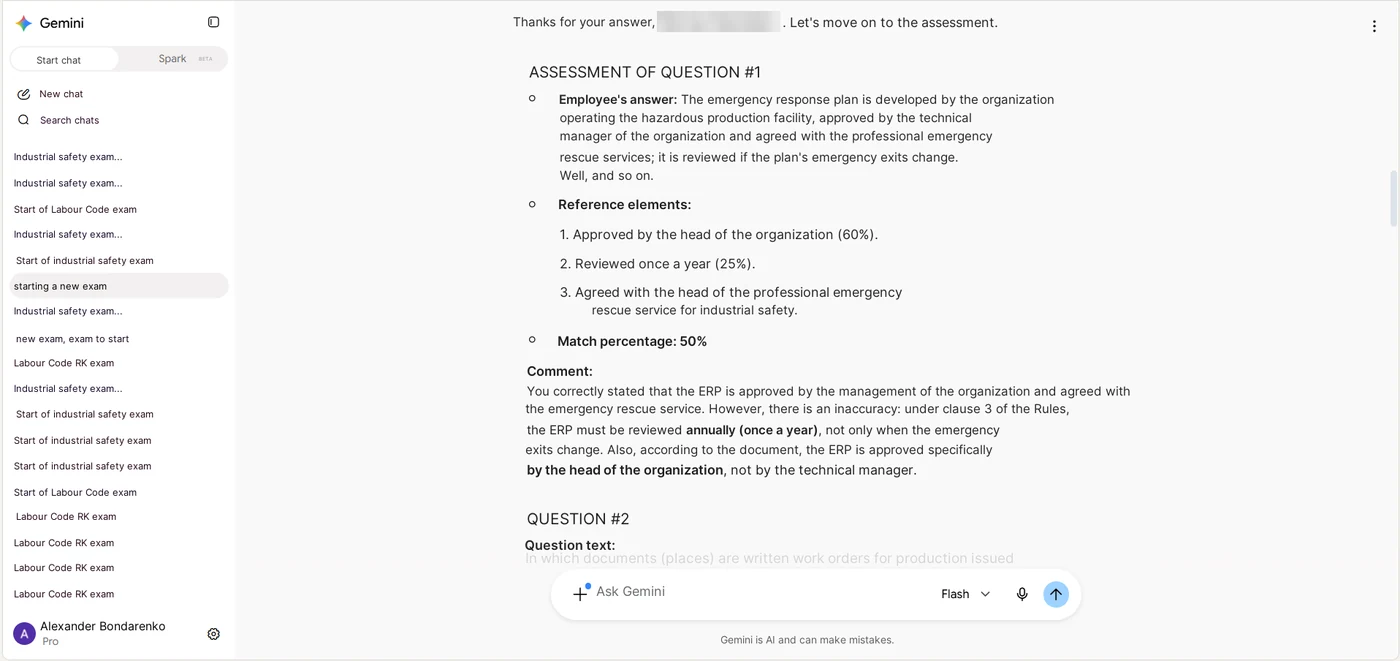
Uczestnik odpowiadał głosem. AI porównywała odpowiedź z bazą normatywną i podawała nie tylko wynik procentowy, ale też strukturę odpowiedzi: co zostało omówione prawidłowo, czego zabrakło, gdzie popełniono błąd i do jakiego źródła normatywnego należy wrócić.
Właśnie wtedy stała się jasna główna zaleta: system sprawdza nie pamięć do wariantu odpowiedzi, lecz umiejętność samodzielnego wyjaśnienia wymagania.
Co okazało się niewygodne w pierwszej wersji
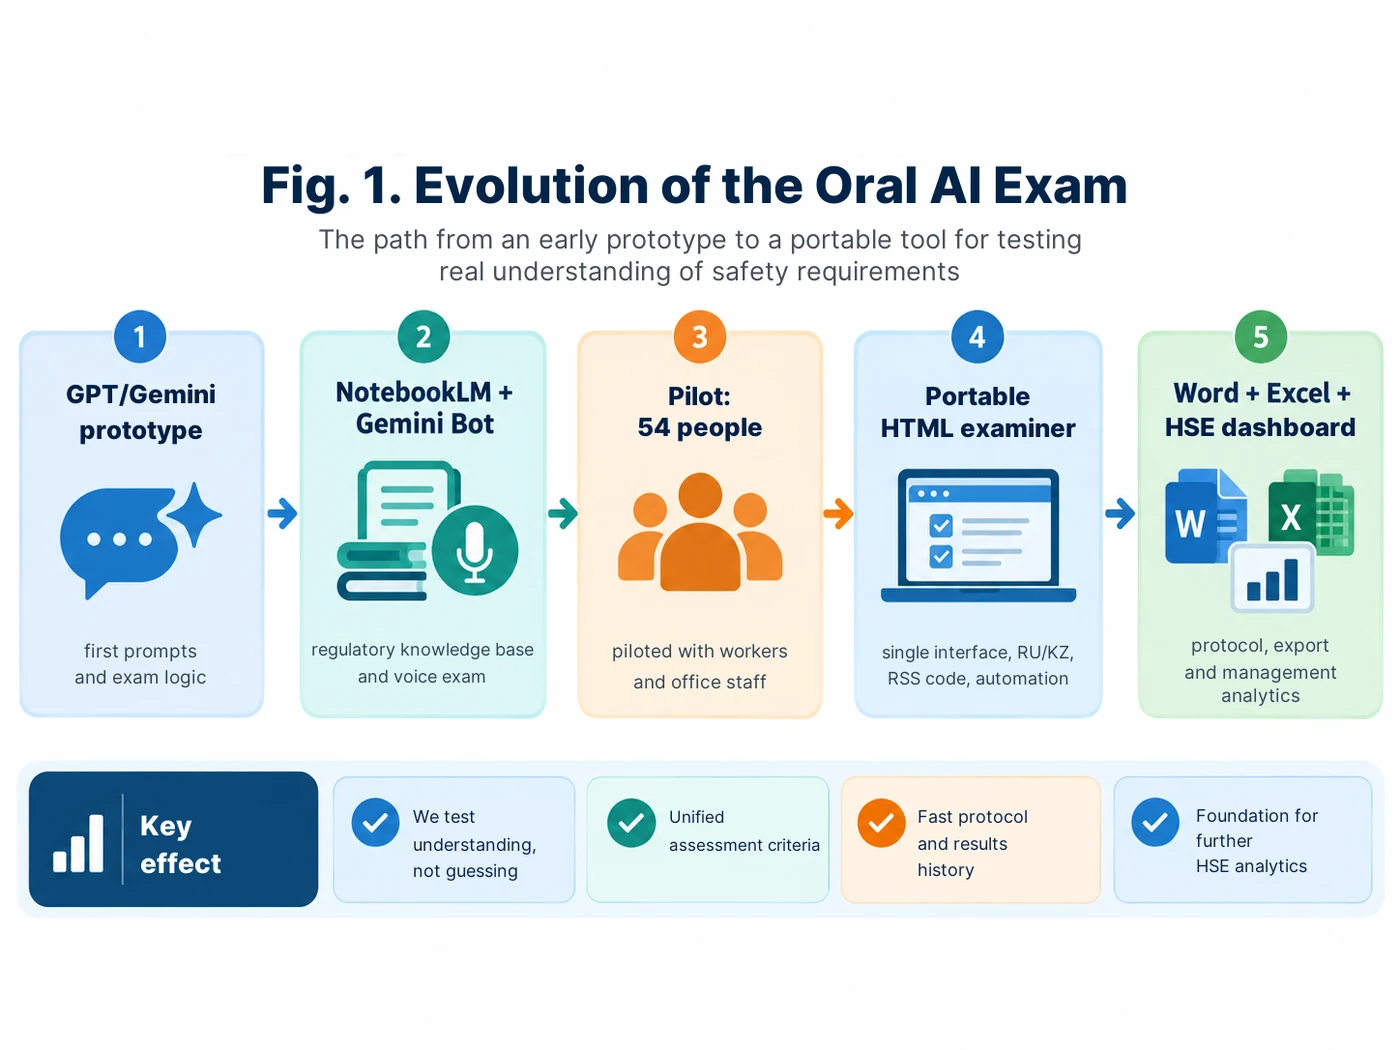
Pilotaż potwierdził samą zasadę, ale pokazał też słabe punkty. Protokół trzeba było kopiować i zapisywać osobno w Wordzie. Końcowy wynik procentowy przenoszono potem ręcznie do Excela. Dla różnych kierunków używano osobnych notatników i botów, więc specjalista musiał się między nimi przełączać.
Poza tym pierwsza wersja identyfikowała zdającego po imieniu i nazwisku, stanowisku i dziale. W wewnętrznym pilotażu było to zrozumiałe, ale przy dalszym rozwoju stało się oczywiste: jeśli część przetwarzania wykonuje model w chmurze, dane osobowe lepiej z tego przepływu usunąć.
Tak narodził się kolejny etap — nie po prostu jeszcze jeden prompt, lecz własna nakładka programowa.
Trzeci etap: przenośny egzaminator przeglądarkowy
Nowa wersja działa jako przenośna aplikacja HTML/JavaScript w osobnym oknie przeglądarki. Nie potrzebuje Pythona, Node.js, bazy danych ani uprawnień administratora. Bank pytań, źródła normatywne, historia egzaminów i ustawienia są przechowywane lokalnie na komputerze.
Ważne jest precyzyjne rozróżnienie części lokalnej i chmurowej. Sam interfejs, lokalna baza, wybór pytań, obliczanie końcowego wyniku procentowego, protokół Word i eksport do Excela działają na komputerze użytkownika. Natomiast rozpoznawanie mowy, merytoryczna ocena odpowiedzi, chmurowy odczyt głosowy i generowanie projektów pytań z aktu normatywnego korzystają z modelu w chmurze. To więc nie jest „AI działająca w pełni offline”, lecz lokalna, zabezpieczona nakładka z minimalnym niezbędnym obiegiem chmurowym.
W ciągu kilku dni taka architektura dała nam to, czego brakowało w pierwszym pilotażu: jeden interfejs zamiast zestawu botów, jeden bank zatwierdzonych pytań, automatyczny protokół i narastającą historię wyników.
Jeśli czytelnik zechce odtworzyć współczesną wersję od zera, podstawowym zapytaniem startowym jest Prompt 3. Został przygotowany właśnie z myślą o vibe codingu: AI prowadzi nieprogramistę krok po kroku, po jednej czynności, sprawdzając każdy rezultat.
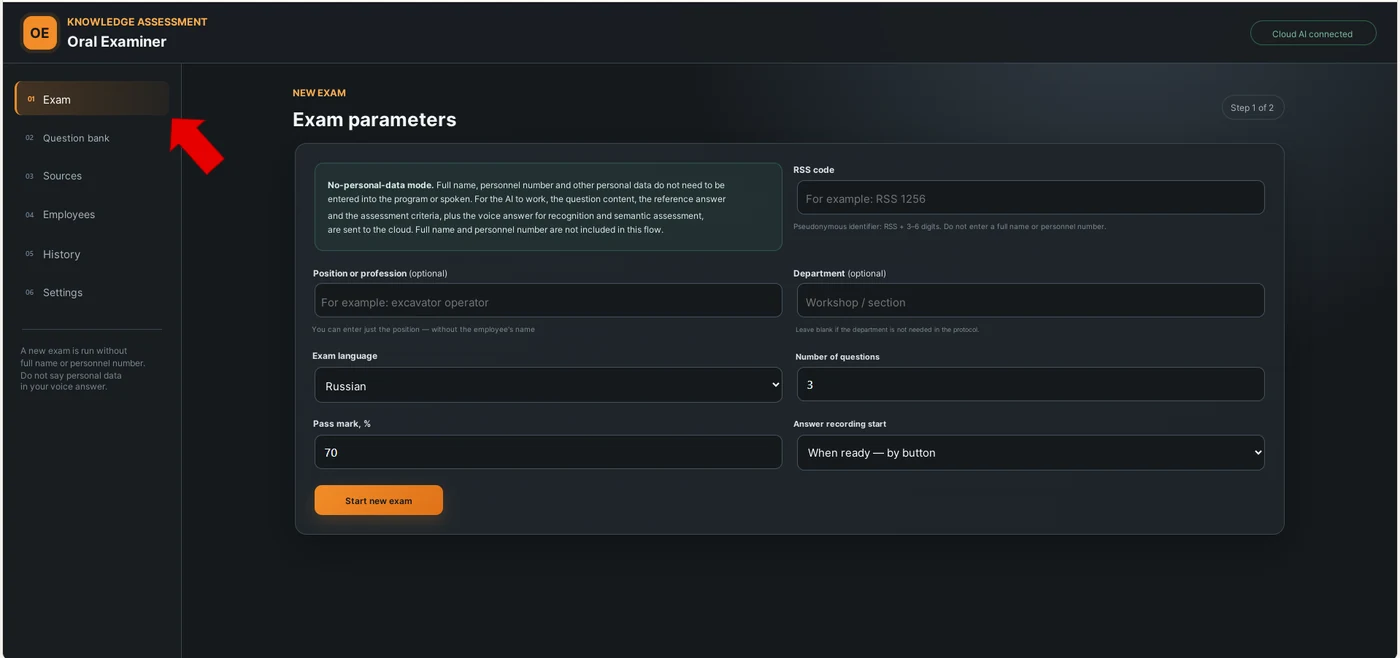
Dane osobowe: zamiast imienia i nazwiska — kod RSS
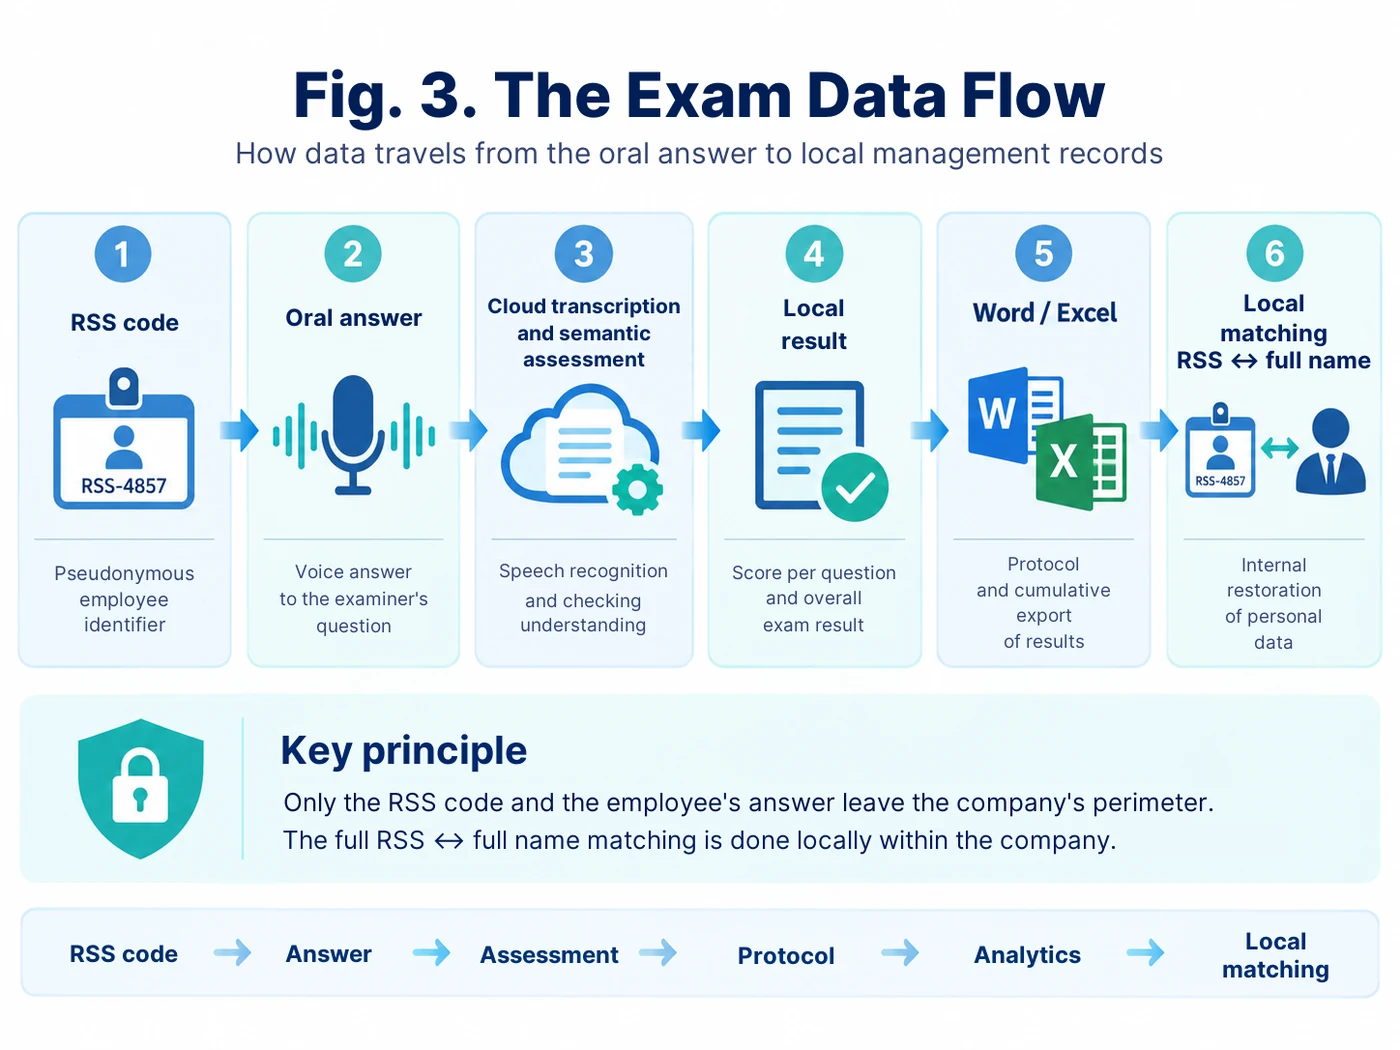
W nowej wersji pracownik nie wpisuje imienia i nazwiska ani numeru ewidencyjnego. Przed egzaminem używany jest pseudonimowy kod RSS w postaci RSS 1256. Przyporządkowanie RSS ↔ imię i nazwisko jest przechowywane osobno w obrębie infrastruktury firmowej i może zostać połączone z wynikami już lokalnie.
Do przepływu chmurowego nie trzeba przekazywać imienia i nazwiska ani numeru ewidencyjnego. Do oceny merytorycznej modelowi wystarczy samo pytanie, odpowiedź wzorcowa, kryteria i głosowa odpowiedź pracownika. W interfejsie osobno zaznaczono, że danych osobowych nie wolno wypowiadać także do mikrofonu.
Protokół Word zachowuje kod RSS, a pola imienia i nazwiska oraz przedmiotu sprawdzenia wiedzy pozostawia puste do uzupełnienia już po pobraniu. Dzienny eksport do Excela również zawiera RSS, stanowisko, dział, język, liczbę pytań i wynik — bez imienia i nazwiska oraz numeru ewidencyjnego.
Zob. załącznik: Prompt 8 — audyt danych osobowych i uczciwe rozdzielenie obiegu lokalnego i chmurowego. Logikę automatycznych wyników w Wordzie i Excelu opisano w Prompt 7.
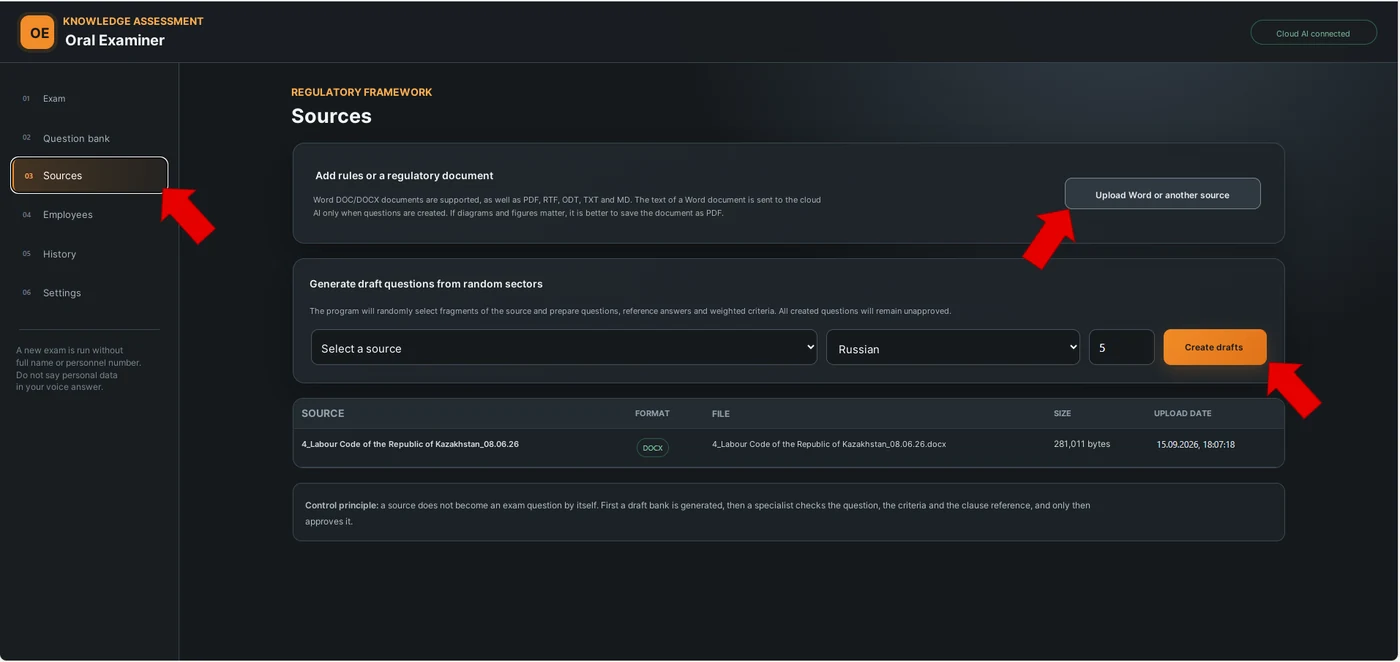
Jak teraz tworzony jest bank pytań
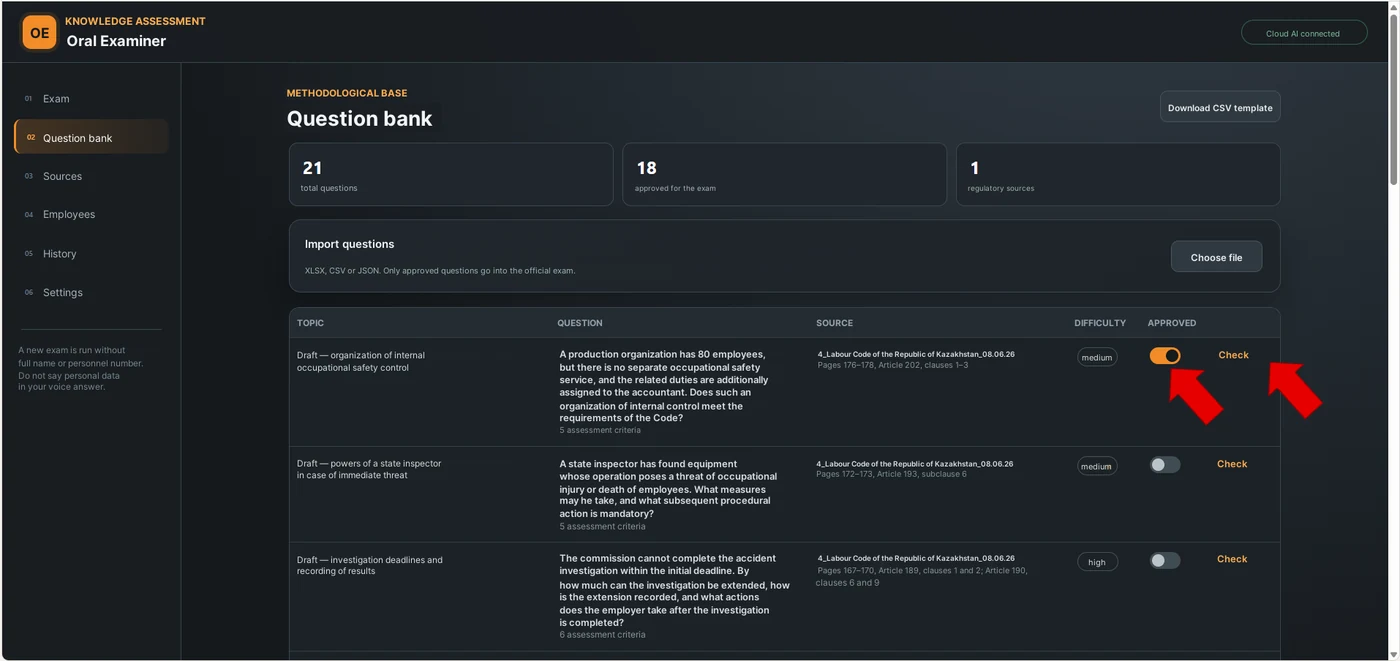
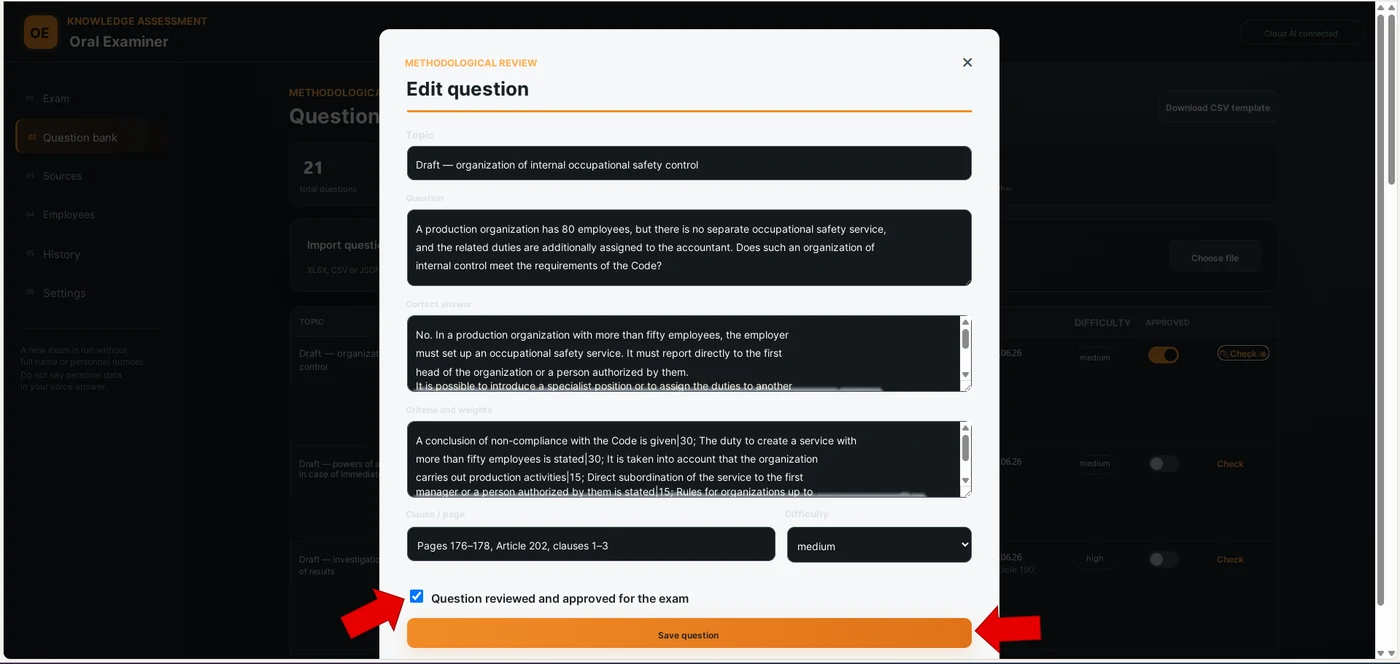
To kolejna zasadnicza różnica w porównaniu z pierwszą wersją. Teraz nie trzeba już wcześniej ręcznie przygotowywać dokładnie 300 pytań. Do programu można wgrać źródło normatywne: Word, PDF, RTF, ODT, TXT lub Markdown. Następnie AI wybiera merytoryczne fragmenty rozłożone w całym dokumencie i tworzy projekty pytań, odpowiedzi wzorcowe oraz od 2 do 8 kryteriów oceny z wagami.
Automatycznie wygenerowane pytanie nie trafia jednak od razu do oficjalnego egzaminu. Otrzymuje status projektu. Specjalista musi sprawdzić sformułowanie, wzorzec, kryteria i odwołanie do źródła, a dopiero potem zatwierdzić pytanie. Na egzaminie wykorzystywane są wyłącznie zatwierdzone pytania.
Można też zaimportować wcześniej przygotowany bank z pliku CSV lub XLSX. Pytanie przechowuje temat, język, źródło, poziom trudności, wzorzec i kryteria. Dzięki temu różne kierunki sprawdzania wiedzy można prowadzić w jednej aplikacji, a nie w różnych botach.
Zmieniło się też losowanie. Zamiast naszego dawnego wzoru opartego na czasie program korzysta z systemowego kryptograficznego generatora liczb losowych i wybiera potrzebną liczbę zatwierdzonych pytań. To prostsze, bardziej niezawodne i nie wymaga od AI udawania losowości.
Zob. załącznik: Prompt 4 — generowanie projektów pytań ze źródła normatywnego z obowiązkową weryfikacją metodyczną; Prompt 9 — połączenie kilku kierunków egzaminu w jednym interfejsie.
Sam egzamin: pytanie głosem — odpowiedź głosem
Zdający wybiera język rosyjski lub kazachski. Pytanie można przeczytać na ekranie albo odsłuchać. Dla każdego języka stosowane są osobne instrukcje odczytu głosowego, aby mowa brzmiała naturalnie i poprawnie, bez zbędnego obcego akcentu.
O dostęp do mikrofonu program prosi raz na cały egzamin. Odpowiedź można rozpocząć ręcznie przyciskiem albo automatycznie po 30 sekundach, jednej, dwóch lub trzech minutach przygotowania. Po nagraniu system rozpoznaje mowę, pokazuje transkrypcję i pozwala sprawdzić tekst przed oceną.
Jeśli odpowiedź została udzielona własnymi słowami, nie jest to wadą. Oceniający patrzy nie na dosłowność, lecz na sens. Dla każdego kryterium możliwe są stany: omówione w pełni, omówione częściowo, brak lub sprzeczne z wymaganiem. Następnie algorytm programu oblicza wynik procentowy według z góry ustalonych wag. W przypadku krytycznego, niebezpiecznego błędu może być stosowane osobne ograniczenie maksymalnej liczby punktów.
W ten sposób model generatywny odpowiada za zrozumienie sensu, a końcowy wynik procentowy jest obliczany deterministycznie na podstawie struktury kryteriów. To ważny podział: AI nie powinna swobodnie „wymyślać oceny”.
Zob. załącznik: Prompt 5 — merytoryczna ocena odpowiedzi według kryteriów; Prompt 6 — osobne programowe obliczanie wyniku procentowego. Dzięki temu model określa treść odpowiedzi, a końcowa liczba punktów jest obliczana deterministycznie.
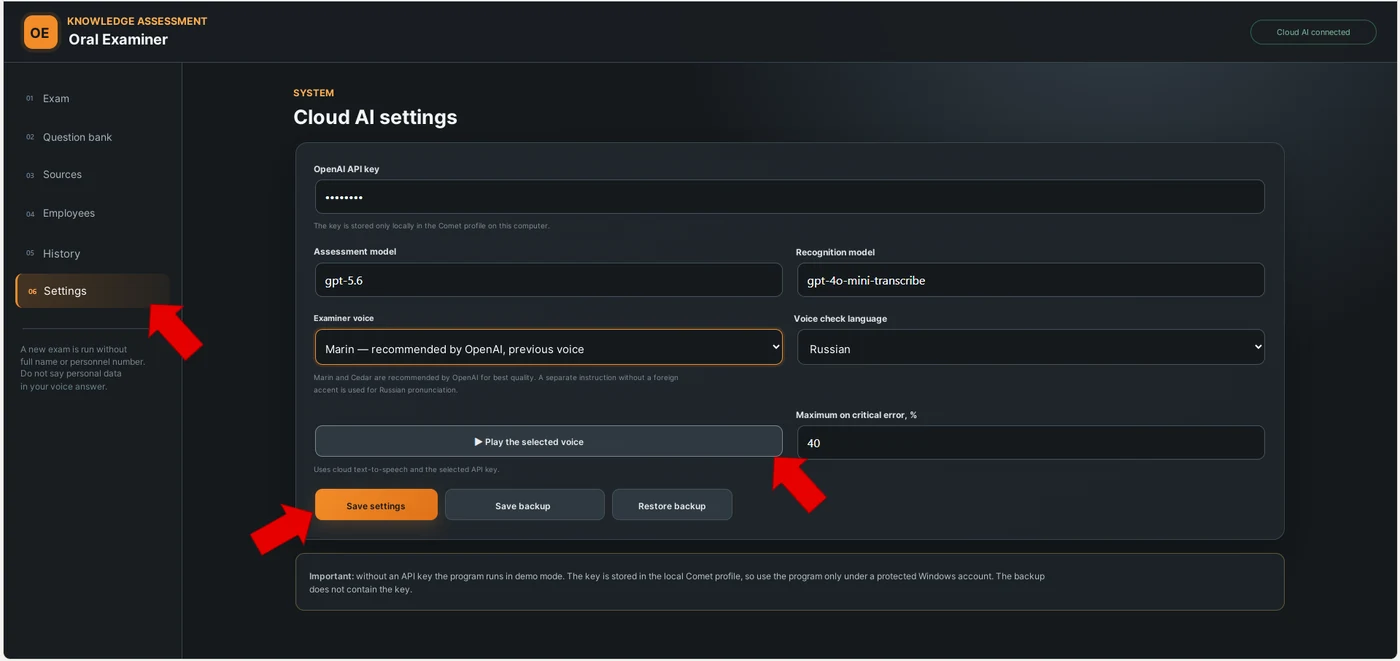
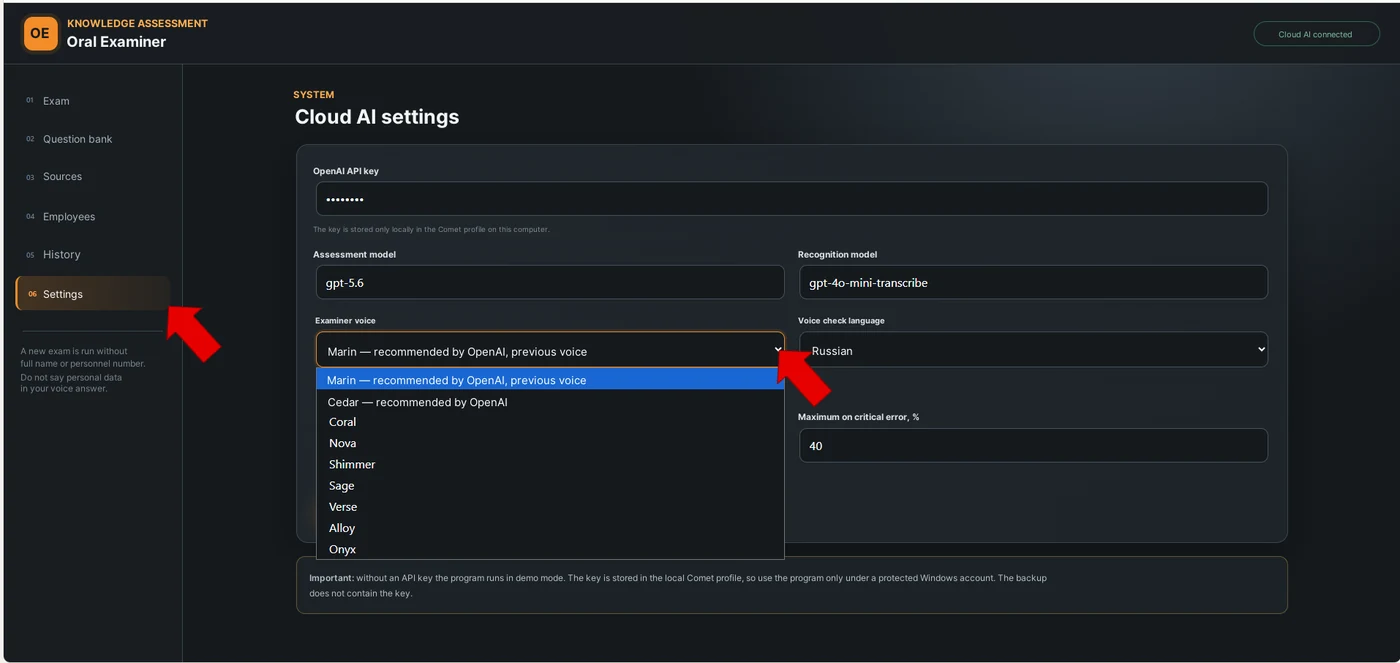
Film „Egzamin ustny w wersji przeglądarkowej” — na końcu artykułu.
Film pokazuje gotowy efekt pracy: uruchomienie egzaminu, odpowiedź głosową, ocenianie, tworzenie i pobieranie protokołu, historię i dalszy eksport. Logika tworzenia takiej aplikacji krok po kroku zaczyna się od Prompt 3.
Protokół i historia generują się teraz automatycznie
Po zakończeniu egzaminu specjalista otrzymuje gotowy protokół Word. Zapisywane są w nim pytania, transkrypcje odpowiedzi, oceny, źródła normatywne, mocne strony, brakujące elementy i błędy. Pole imienia i nazwiska pozostaje puste, kod RSS jest zachowany.
Równolegle każdy egzamin jest zapisywany w lokalnej historii. Na koniec dnia specjalista wybiera datę i klika „Eksportuj Excel za datę”. Powstaje jedna tabela obejmująca wszystkie egzaminy: data, godzina, RSS, stanowisko, dział, język, liczba pytań, próg zaliczenia, końcowy wynik procentowy, rezultat i status.
Ten eksport do Excela może już trafiać do zbiorczego zestawienia, a dalej — do interaktywnego pulpitu analitycznego. Otrzymaliśmy więc tę samą zasadę, którą stosowaliśmy w poprzednich publikacjach: najpierw pojedyncza operacja, potem gromadzenie ustrukturyzowanych danych, a następnie analityka zarządcza.
Zob. załącznik: Prompt 7 — struktura protokołu Word i dziennego eksportu do Excela bez imienia i nazwiska oraz numeru ewidencyjnego.
Gdzie można to wykorzystać
Taki egzaminator nie jest związany wyłącznie z bezpieczeństwem przemysłowym. Według tej samej logiki można sprawdzać znajomość wymagań BHP, przepisów branżowych, instrukcji, regulaminów technologicznych, standardów wewnętrznych i innych dokumentów, w których ważne jest nie wybranie właściwej litery, lecz wyjaśnienie wymagania własnymi słowami.
Może służyć jako wstępne sprawdzenie przed komisją, jako element szkolenia, jako ustna weryfikacja kwalifikacji w poszczególnych obszarach albo jako narzędzie wyrywkowej kontroli rozumienia wymagań. Ostateczna decyzja tam, gdzie przepisy prawa lub procedury wewnętrzne wymagają komisji i osób upoważnionych, nadal należy jednak do ludzi.
Główna zmiana w porównaniu z pierwszym pilotażem polega na tym, że odeszliśmy od zestawu osobnych botów AI i ręcznego przenoszenia wyników na rzecz jednego, powtarzalnego procesu: źródło → zatwierdzone pytanie → odpowiedź głosowa → ocena merytoryczna → protokół → Excel → analityka.
Co moim zdaniem jest tu najważniejsze
Najcenniejszą częścią projektu nie jest głos ani ładny interfejs. Jest nią zmiana samej logiki sprawdzania wiedzy.
Test pyta: „Czy potrafisz rozpoznać prawidłowy wariant?” Egzamin ustny pyta: „Czy potrafisz sam wyjaśnić, co należy zrobić i dlaczego?”
AI sprawia, że taką formę da się skalować. Nie znosi odpowiedzialności komisji i nie zastępuje wymagań przepisów. Pozwala jednakowo zadawać pytania, jednakowo analizować sens odpowiedzi i od razu pokazywać konkretne luki, które trzeba uzupełnić.
Załącznik: prompty do publikacji
Historyczna logika pierwszej wersji + zaktualizowane prompty do przenośnego egzaminatora przeglądarkowego
W załączniku celowo rozdzielono stare i nowe podejście. Pierwsze prompty pokazują ewolucję. Kolejne — bardziej praktyczną współczesną architekturę, w której źródło, generowanie banku, weryfikacja metodyczna, odpowiedź głosowa, ocena, Word i Excel są od siebie oddzielone.
Prompt 1. Historyczny egzaminator NotebookLM + Gemini z bankiem 300 pytań
Związek z artykułem: sekcje „Drugi etap: NotebookLM jako baza wiedzy, Gemini Bot jako egzaminator” oraz „Jak działał nasz pierwszy generator liczb losowych”.
ROLA
Jesteś wymagającym egzaminatorem sprawdzającym znajomość wymagań bezpieczeństwa przemysłowego, ochrony cywilnej oraz bezpieczeństwa i higieny pracy.
Pracuj wyłącznie na podłączonej bazie normatywnej i zatwierdzonym banku pytań. Nie korzystaj z internetu ani z wiedzy zewnętrznej. Nie dopowiadaj wymagań.

JĘZYK
Egzamin jest prowadzony w wybranym języku: RU lub KZ. Nie mieszaj języków.

STRUKTURA
Egzamin składa się z 3 pytań. Zadawaj tylko jedno pytanie naraz. Kolejne pytanie — dopiero po odpowiedzi na poprzednie i jej ocenie.
Próg zaliczenia: 70%.

WYBÓR PYTANIA 1
Po wprowadzeniu danych zarejestruj czas lokalny:
H — godziny; M — minuty; S — sekundy; MS — milisekundy.
Jeśli którakolwiek wartość jest równa 0, zastąp ją liczbą 1.
R1 = H × M × S × MS.
Dopóki R1 > 300: R1 = R1 / 300.
INDEX1 = ceil(R1). Jeśli INDEX1 = 0, użyj 1.
Zadaj pytanie nr INDEX1 z zatwierdzonego banku 300 pytań.

PYTANIE 2
Po otrzymaniu odpowiedzi na pytanie 1 ponownie zarejestruj H, M, S, MS i powtórz obliczenie.
Jeśli nowy numer był już użyty, zwiększ go o 1. Jeśli numer przekroczy 300, użyj 1.

PYTANIE 3
Po otrzymaniu odpowiedzi na pytanie 2 powtórz tę samą procedurę. Nie dopuszczaj do powtórzenia wcześniej zadanych pytań.

OCENA ODPOWIEDZI
Oceniaj sens, a nie dosłowność.
1. Trafność — do 60%.
2. Kompletność — do 25%.
3. Logika — do 15%.
W przypadku niebezpiecznego stwierdzenia, zakazanego działania lub krytycznej sprzeczności z wymaganiem przepisów wynik za pytanie nie może przekroczyć 30%.
Dla każdego pytania pokaż:
- numer i treść;
- źródło normatywne;
- co zostało omówione prawidłowo;
- czego nie wymieniono;
- co powiedziano błędnie;
- wynik procentowy za pytanie.

FINAŁ
RESULT = (Q1 + Q2 + Q3) / 3.
Zaokrąglij wynik do liczby całkowitej.
≥70% — ZALICZONY.
<70% — NIEZALICZONY.
Po trzeciej odpowiedzi przygotuj protokół końcowy.
Prompt 2. Przygotowanie banku pytań egzaminacyjnych na podstawie aktu normatywnego
Związek z artykułem: historyczny bank 300 pytań z drugiego etapu. Ten prompt przydaje się, jeśli bank jest przygotowywany z wyprzedzeniem na podstawie aktu normatywnego.
Wgrywam akt normatywny.
Trzeba przygotować bank pytań do egzaminu ustnego.

Zasady:
1. Pracuj wyłącznie na podstawie wgranego dokumentu.
2. Nie korzystaj z wiedzy zewnętrznej.
3. Nie pytaj o numery artykułów i punktów dla sprawdzenia pamięci — sprawdzaj praktyczne rozumienie wymagań.
4. Rozkładaj pytania na cały dokument, a nie tylko na pierwsze rozdziały.
5. Wykluczaj duplikaty i niemal identyczne pytania.
6. Do każdego pytania przygotuj odpowiedź wzorcową i odwołanie do źródła.
7. We wzorcu wyodrębnij elementy obowiązkowe, bez których odpowiedzi nie można uznać za pełną.
8. Osobno oznacz błędy krytyczne — stwierdzenia, które mogą prowadzić do niebezpiecznego działania.

Format tabeli:
Nr | Temat | Pytanie | Odpowiedź wzorcowa | Elementy obowiązkowe | Błąd krytyczny | Dokument | Artykuł/punkt | Strona | Język

Przygotuj do 300 pytań. Jeśli akt normatywny nie zawiera materiału na 300 merytorycznie różnych pytań, nie twórz sztucznych powtórzeń: zatrzymaj się na liczbie faktycznie uzasadnionej treścią.
Prompt 3. Master-prompt do vibe codingu przenośnego egzaminatora HTML
Związek z artykułem: sekcja „Trzeci etap: przenośny egzaminator przeglądarkowy”. To główny prompt dla czytelnika, który chce odtworzyć współczesną wersję.
Nie jestem programistą. Przeprowadź mnie krok po kroku przez tworzenie przenośnego ustnego egzaminatora AI.
Nie podawaj od razu 20 czynności. Na każdym kroku:
1. Wyjaśnij, co robimy i po co.
2. Podaj jedną konkretną czynność albo jeden gotowy blok kodu/plik.
3. Poczekaj na mój zrzut ekranu lub wynik.
4. Sprawdź zrzut ekranu i dopiero wtedy przechodź dalej.

DOCELOWA ARCHITEKTURA
- przenośna aplikacja HTML/JavaScript;
- uruchamianie w systemie Windows bez Pythona, Node.js i uprawnień administratora;
- lokalne przechowywanie banku pytań, źródeł i historii;
- bez imienia i nazwiska oraz numeru ewidencyjnego w przepływie egzaminacyjnym;
- obowiązkowy pseudonimowy kod RSS w postaci RSS 1256;
- język rosyjski i kazachski;
- import banku pytań z XLSX/CSV;
- wgrywanie źródeł normatywnych DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- generowanie projektów pytań z losowo rozłożonych sektorów źródła;
- każde wygenerowane pytanie musi zostać sprawdzone i zatwierdzone przez specjalistę przed egzaminem;
- pytanie przechowuje temat, treść, wzorzec, 2–8 ważonych kryteriów, źródło i odwołanie do punktu;
- na egzaminie wykorzystywane są wyłącznie zatwierdzone pytania;
- losowy wybór pytań realizuj programowo za pomocą generatora kryptograficznego, a nie „losowości” modelu;
- liczba pytań i próg zaliczenia są konfigurowalne;
- odpowiedź głosem przez mikrofon;
- tryb rozpoczęcia odpowiedzi: ręcznie albo automatycznie po 30/60/120/180 sekundach przygotowania;
- o dostęp do mikrofonu prosić raz na cały egzamin;
- rozpoznawanie mowy przez model w chmurze;
- merytoryczna ocena odpowiedzi według kryteriów;
- wynik procentowy obliczać deterministycznie według wag kryteriów;
- przy błędzie krytycznym stosować konfigurowalny limit maksymalnej liczby punktów;
- naturalny odczyt głosowy pytania RU/KZ, głos systemowy jako rezerwa;
- automatyczny protokół Word;
- lokalna historia;
- eksport do Excela wszystkich egzaminów z wybranego dnia;
- kopia zapasowa lokalnej bazy bez klucza API.

BEZPIECZEŃSTWO
Wyraźnie oddziel obieg lokalny od chmurowego. Wyjaśniaj, jakie dane trafiają do chmury. Nie przekazuj tam imienia i nazwiska ani numeru ewidencyjnego. W interfejsie głosowym wyświetl wyraźne ostrzeżenie, by nie wypowiadać danych osobowych.

Zacznij od architektury i struktury plików. Kod pisz dopiero po moim potwierdzeniu.
Prompt 4. Generowanie projektów pytań ze źródła normatywnego dla nowej wersji
Związek z artykułem: sekcja „Jak teraz tworzony jest bank pytań” — generowanie projektów pytań z wgranych źródeł normatywnych.
Tworzysz wyłącznie PROJEKTY pytań egzaminacyjnych. Żadne utworzone pytanie nie jest automatycznie uznawane za zatwierdzone.

Dane wejściowe:
- akt normatywny;
- język RU lub KZ;
- wymagana liczba projektów pytań;
- liczba losowa/seed wygenerowana przez program.

Zadanie:
1. Korzystając z seed, wybierz merytoryczne sektory rozłożone w całym dokumencie, w miarę możliwości niesąsiadujące ze sobą.
2. Pracuj wyłącznie na podstawie dokumentu.
3. Z każdego sektora utwórz jedno pytanie istotne w praktyce.
4. Nie pytaj o numer punktu jako cel sam w sobie.
5. Przygotuj krótką odpowiedź wzorcową.
6. Przygotuj od 2 do 8 kryteriów oceny. Każde kryterium powinno sprawdzać odrębny element merytoryczny.
7. Przypisz kryteriom wagi tak, aby ich suma wynosiła dokładnie 100.
8. Podaj temat, poziom trudności, stronę/artykuł/punkt lub inne odwołanie do źródła.
9. Nie powielaj pytań z sąsiednich fragmentów.
10. Jeśli sektor nie zawiera wymagania wystarczającego do merytorycznego pytania — pomiń go i wybierz inny.

Zwróć ustrukturyzowany wynik:
Temat | Pytanie | Wzorzec | Kryteria z wagami | Źródło | Odwołanie | Poziom trudności | Język

Status każdego wyniku: PROJEKT, WYMAGA WERYFIKACJI METODYCZNEJ.
Prompt 5. Ocena merytoryczna odpowiedzi ustnej według kryteriów
Związek z artykułem: sekcja „Sam egzamin: pytanie głosem — odpowiedź głosem” — model określa, w jakim stopniu omówiono sens każdego kryterium.
Jesteś wymagającym, ale obiektywnym egzaminatorem z zakresu BHP i bezpieczeństwa przemysłowego.

Oceniaj sens, a nie dosłowną zgodność.
Uznawaj synonimy i sformułowania potoczne, jeśli jednoznacznie oddają wymaganie przepisów.
Pracuj wyłącznie na podstawie przekazanego pytania, wzorca, kryteriów i fragmentu przepisów.
Nie dodawaj wymagań z pamięci ani z internetu.

Dla KAŻDEGO kryterium zwróć dokładnie jeden status:
- FULL — omówione w pełni;
- PARTIAL — istotna część omówiona, ale jest luka;
- MISSING — brak elementu;
- INCORRECT — odpowiedź jest sprzeczna z wymaganiem.

Dla każdego kryterium podaj krótki dowód z odpowiedzi pracownika oraz wyjaśnienie.

CRITICAL_ERROR = true tylko wtedy, gdy odpowiedź zawiera niebezpieczne stwierdzenie lub działanie, które stwarza niedopuszczalne ryzyko i jest sprzeczne z wymaganiem przepisów.
Nie używaj critical_error jedynie z powodu niepełnej odpowiedzi.

Osobno przygotuj:
- WELL_SAID — co zostało dobrze omówione;
- PARTLY_SAID — co zostało omówione częściowo;
- MISSING — czego nie powiedziano;
- INCORRECT — co powiedziano błędnie;
- SUMMARY — krótki wniosek w języku egzaminu.

Nie obliczaj końcowego wyniku procentowego „na oko”. Wynik procentowy ma zostać obliczony przez algorytm programu według wag kryteriów po otrzymaniu twoich statusów.
Prompt 6. Logika programowa deterministycznego obliczania wyniku
Związek z artykułem: ta sama sekcja „Sam egzamin: pytanie głosem — odpowiedź głosem” — wynik procentowy oblicza program, a nie przyznaje go model „na oko”.
Zrealizuj obliczanie wyniku NIE przez swobodną ocenę modelu, lecz programowo.

Każde kryterium ma wagę weight wyrażoną w procentach.
Współczynniki:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = suma(weight × współczynnik) dla wszystkich kryteriów.
Ogranicz wynik do przedziału 0–100 i zaokrąglij do 0,1.

Jeśli oceniający moduł AI zwrócił critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP), gdzie CRITICAL_CAP jest ustawiany w konfiguracji (na przykład 40%).

Po wszystkich pytaniach:
TOTAL_SCORE = średnia arytmetyczna wyników za pytania.
PASSED = TOTAL_SCORE >= ustalonego progu zaliczenia.

Ważne:
- model określa merytoryczny status kryterium;
- program oblicza wynik procentowy;
- model nie powinien samodzielnie przyznawać dowolnego wyniku końcowego.
Prompt 7. Protokół Word i dzienny eksport Excel bez danych osobowych
Związek z artykułem: sekcja „Protokół i historia generują się teraz automatycznie” — protokół Word i dzienny eksport do Excela.
Rozbuduj egzaminator ustny.

PROTOKÓŁ WORD
Po zakończeniu egzaminu automatycznie generuj plik .docx.
W protokole uwzględnij:
- datę;
- kod RSS;
- stanowisko/zawód;
- dział;
- język;
- próg zaliczenia;
- wynik końcowy ZALICZONY/NIEZALICZONY;
- każde pytanie;
- transkrypcję odpowiedzi;
- wynik procentowy za pytanie;
- źródło normatywne i odwołanie;
- co zostało dobrze omówione;
- czego nie powiedziano;
- błędy.

Pola „Imię i nazwisko” oraz „Przedmiot sprawdzenia wiedzy” pozostaw puste do lokalnego uzupełnienia po pobraniu.
Nazwa pliku: Protocol_RSS_1256_YYYY-MM-DD.docx.

EXCEL ZA DATĘ
W sekcji „Historia” dodaj wybór daty i przycisk „Eksportuj Excel za datę”.
Kolumny:
Nr | Data egzaminu | Godzina rozpoczęcia | Kod RSS | Stanowisko/zawód | Dział | Język | Liczba pytań | Próg zaliczenia % | Wynik końcowy % | Rezultat | Status | Godzina zakończenia | ID egzaminu.

Nie uwzględniaj imienia i nazwiska ani numeru ewidencyjnego.
Plik Excel generuj wyłącznie z lokalnej historii bieżącego komputera.
Przyporządkowanie RSS <-> imię i nazwisko może być łączone z wynikami wyłącznie offline, w obrębie infrastruktury firmowej.
Prompt 8. Audyt danych osobowych i granice trybu offline/chmury
Związek z artykułem: sekcje „Trzeci etap: przenośny egzaminator przeglądarkowy” oraz „Dane osobowe: zamiast imienia i nazwiska — kod RSS”.
Przeprowadź audyt techniczny aplikacji egzaminatora ustnego.
Trzeba uczciwie rozdzielić operacje lokalne i chmurowe.

Sprawdź i opisz:
1. Jakie dane są przechowywane w IndexedDB/localStorage.
2. Jakie dane są wysyłane do modelu w chmurze podczas transkrypcji.
3. Jakie dane są wysyłane podczas oceny merytorycznej.
4. Jakie dane są wysyłane podczas generowania projektów pytań.
5. Czy przekazywane są imiona i nazwiska, numery ewidencyjne, lista pracowników lub tabela przyporządkowania RSS <-> imię i nazwisko.
6. Gdzie przechowywany jest klucz API.
7. Czy kopia zapasowa zawiera klucz API.
8. Co pozostaje po całkowitym zamknięciu aplikacji.
9. Jak usunąć lokalną historię i źródła.
10. Jakie ryzyka pozostają w fazie eksploatacji pilotażowej.

Wymaganie dotyczące sformułowania wyniku:
nie nazywaj aplikacji „w pełni offline”, jeśli rozpoznawanie mowy, ocena, TTS lub generowanie pytań korzystają z API w chmurze.
Prawidłowe sformułowanie: „lokalna przenośna nakładka z lokalną bazą i kontrolowanym chmurowym obiegiem AI”.
Prompt 9. Dodanie kilku kierunków egzaminu w jednym interfejsie
Związek z artykułem: sekcja „Jak teraz tworzony jest bank pytań” — kilka przepisów i kierunków w jednym egzaminatorze bez przełączania się między botami.
Rozbuduj bank pytań i ekran uruchamiania egzaminu tak, aby nie trzeba było już tworzyć osobnego bota dla każdego przepisu.

Każde pytanie ma już pole „Temat/kierunek”.
Dodaj na ekranie egzaminu wybór kierunków:
- jeden blok tematyczny;
- kilka bloków tematycznych jednocześnie;
- tryb „Wszystkie wybrane kierunki”.

Przy uruchamianiu egzaminu:
1. odfiltruj wyłącznie zatwierdzone pytania;
2. uwzględniaj wybrany język;
3. uwzględniaj wybrane kierunki;
4. losowo wybierz zadaną liczbę pytań za pomocą programowego generatora kryptograficznego;
5. w miarę możliwości rozkładaj pytania równomiernie między wybrane kierunki;
6. nie dopuszczaj do powtórzeń;
7. jeśli pytań dla wybranego zestawu jest za mało — przerwij uruchamianie i wyświetl zrozumiały komunikat.

W protokole Word i w pliku Excel dodatkowo zapisuj wybrane kierunki egzaminu.
Jak korzystać z załącznika do artykułu
Numeracja poniżej jest zsynchronizowana z tekstem publikacji. W artykule przy odpowiednim etapie znajdują się bezpośrednie odesłania „Zob. Prompt …”, a tutaj pod każdym promptem wskazano, do której sekcji artykułu się odnosi.
- Prompt 1 — wersja historyczna: pokazuje, jak działał pierwszy egzaminator i własny generator numeru spośród 300 pytań.
- Prompt 2 — przygotowanie dużego banku pytań na podstawie aktów prawnych.
- Prompt 3 — podstawowe zapytanie dla czytelnika, który chce odtworzyć współczesną wersję przeglądarkową za pomocą vibe codingu.
- Prompt 4 — generowanie projektów pytań z wgranego źródła.
- Prompt 5–6 — rozdzielenie oceny sensu przez AI od programowego obliczania wyniku procentowego.
- Prompt 7 — automatyczne pliki Word i Excel.
- Prompt 8 — obowiązkowe sprawdzenie granic obiegu lokalnego i chmurowego.
- Prompt 9 — połączenie kilku kierunków egzaminu w jednym interfejsie.
Komentarze 2
🤝