ไม่มีตัวเลือก ก ข ค: ผู้คุมสอบปากเปล่า AI
แนวคิดหลัก: แบบทดสอบทั่วไปวัดได้ดีว่าผู้สอบจำตัวเลือกที่ถูกต้องได้หรือไม่ แต่การสอบปากเปล่าบังคับให้คนต้องอธิบายข้อกำหนดด้วยตัวเอง ในระบบนี้ AI ไม่ได้มีไว้บอกใบ้คำตอบ แต่มีไว้ประเมินเชิงเนื้อหาด้วยมาตรฐานเดียวกันทุกครั้ง
ทำไมเราจึงหันมาจัดสอบปากเปล่า
แบบทดสอบแบบดั้งเดิมสะดวกสำหรับการทดสอบความรู้คนจำนวนมาก แต่มีจุดอ่อนที่เห็นได้ชัด นั่นคือพนักงานมองเห็นตัวเลือกคำตอบ ต่อให้คลังคำถามดีแค่ไหน คะแนนส่วนหนึ่งก็อาจได้มาจากการจำถ้อยคำได้ การตัดตัวเลือกที่ผิดอย่างเห็นได้ชัดทิ้ง หรือแค่จำข้อสอบได้
การสอบปากเปล่าต่างออกไป ผู้สอบต้องเรียบเรียงคำตอบเอง อธิบายลำดับขั้นตอนการปฏิบัติ ระบุอันตราย ข้อจำกัด และข้อกำหนดที่ต้องปฏิบัติ รูปแบบนี้แสดงให้เห็นได้ดีกว่ามากว่าเขาเข้าใจกฎจริง หรือเพียงแค่เคยเห็นถ้อยคำที่ถูกต้องมาก่อน
แต่การสอบปากเปล่าแบบทั่วไปก็มีปัญหาอีกแบบหนึ่ง คือเรื่องเวลาและความแตกต่างระหว่างกรรมการสอบแต่ละคนซึ่งเลี่ยงไม่ได้ คนหนึ่งซักถามลึกกว่า อีกคนรับคำตอบได้เร็วกว่า คนหนึ่งให้ความสำคัญกับถ้อยคำที่แม่นยำ อีกคนดูที่ใจความ ด้วยเหตุนี้ ในฤดูใบไม้ผลิปี 2026 เราจึงเริ่มหาวิธีใช้ AI เป็นผู้คุมสอบคนที่สอง ไม่ใช่เพื่อแทนที่คณะกรรมการ แต่เป็นเครื่องมือกลางที่ตั้งคำถาม ฟังคำตอบ และใช้เกณฑ์ที่กำหนดไว้อย่างเท่าเทียมกันกับทุกคน
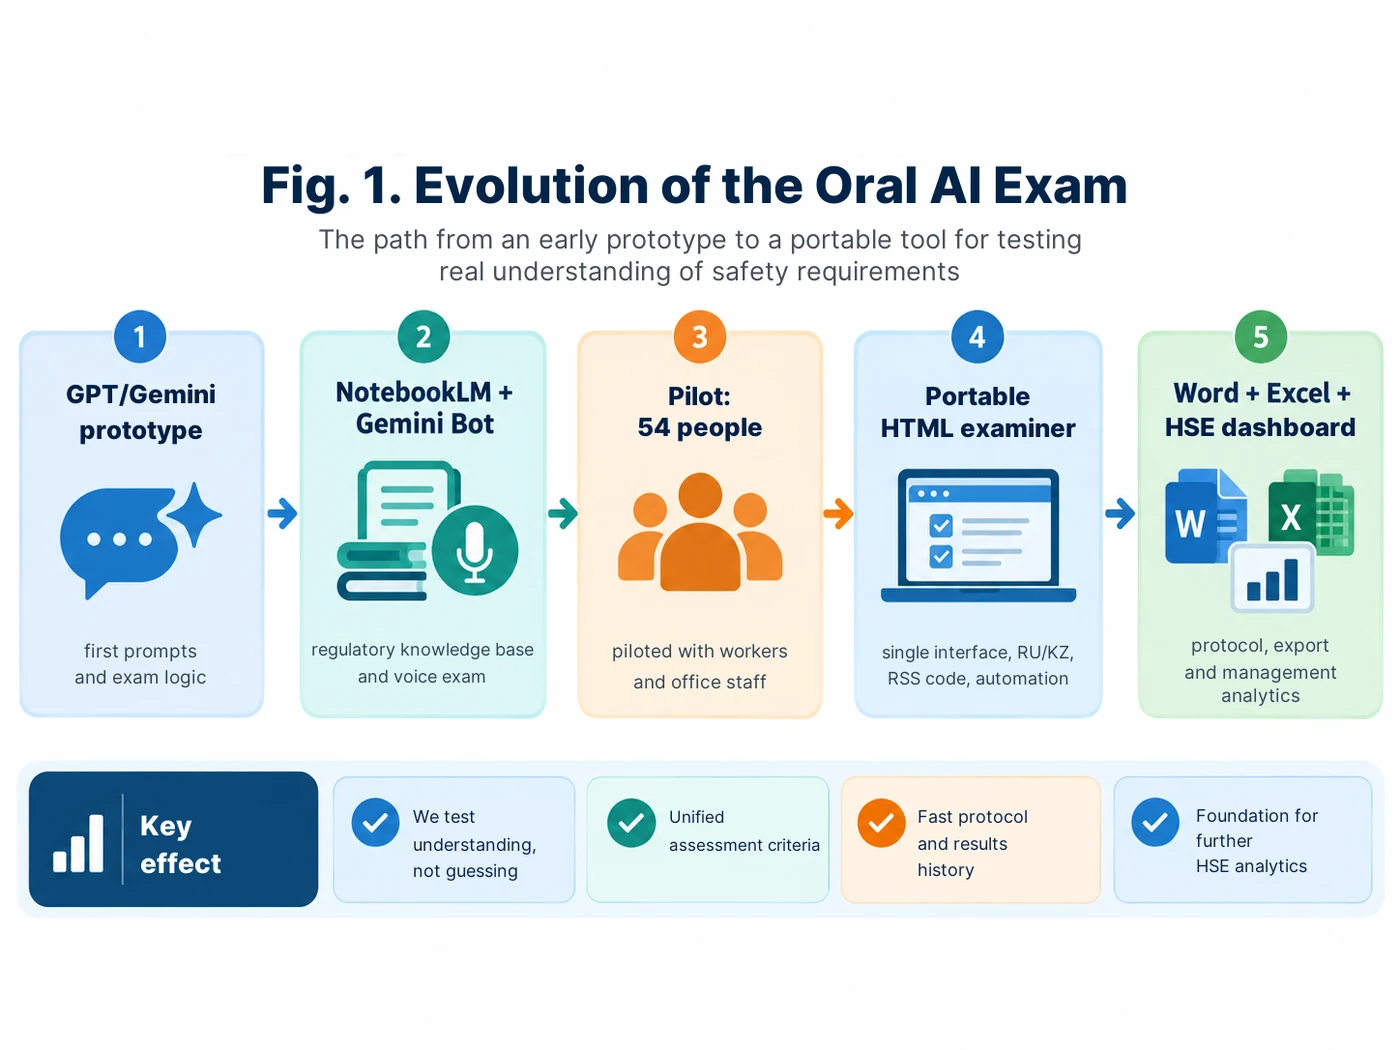
ขั้นที่ 1: พยายามทำทุกอย่างในเอเจนต์ AI ตัวเดียว
แนวคิดแรกค่อนข้างตรงไปตรงมา คือป้อนกฎระเบียบเข้าไปใน AI กำหนดบทบาทให้เป็นผู้คุมสอบ แล้วให้มันทำทุกอย่างพร้อมกัน ทั้งสุ่มเลือกหมวดความรู้ ตั้งคำถาม และประเมินคำตอบ แต่ในทางปฏิบัติเราพบอย่างรวดเร็วว่าโมเดลเชิงสร้างสรรค์ไม่ใช่เครื่องมือที่ดีที่สุดสำหรับการสุ่มอย่างแท้จริง มันใช้เหตุผลได้ดี แต่ “คำถามแบบสุ่ม” ของมันไม่ได้หมายถึงการเลือกแบบสุ่มในทางคณิตศาสตร์เสมอไป
เราจึงเริ่มแยกหน้าที่ออกจากกัน แหล่งกฎระเบียบต้องรับผิดชอบเฉพาะเรื่องความรู้ การสุ่มรับผิดชอบเลขข้อของคำถาม ส่วนผู้คุมสอบรับผิดชอบเฉพาะลำดับขั้นของการสอบและการประเมินคำตอบ นี่คือข้อสรุปเชิงสถาปัตยกรรมที่สำคัญข้อแรก: ยิ่งแยกหน้าที่ชัดเจนเท่าไร ระบบก็ยิ่งทำงานได้เสถียรเท่านั้น
ในภาคผนวกท้ายบทความ พรอมต์ถูกจัดเรียงตามตรรกะเดียวกับบทความโดยตั้งใจ: เริ่มจากระบบรุ่นแรก ตามด้วยคลังคำถาม จากนั้นเป็นเวอร์ชัน HTML ปัจจุบัน การประเมินผล Word/Excel และการปกป้องข้อมูล
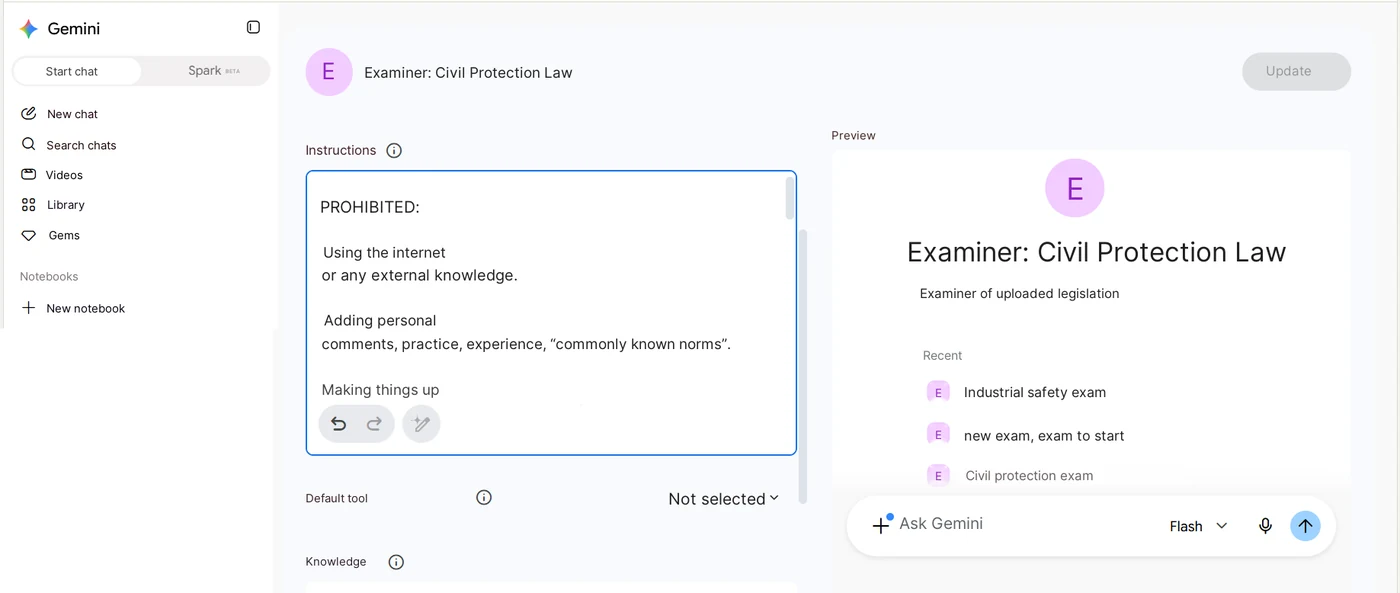
ขั้นที่ 2: NotebookLM เป็นฐานความรู้ Gemini Bot เป็นผู้คุมสอบ
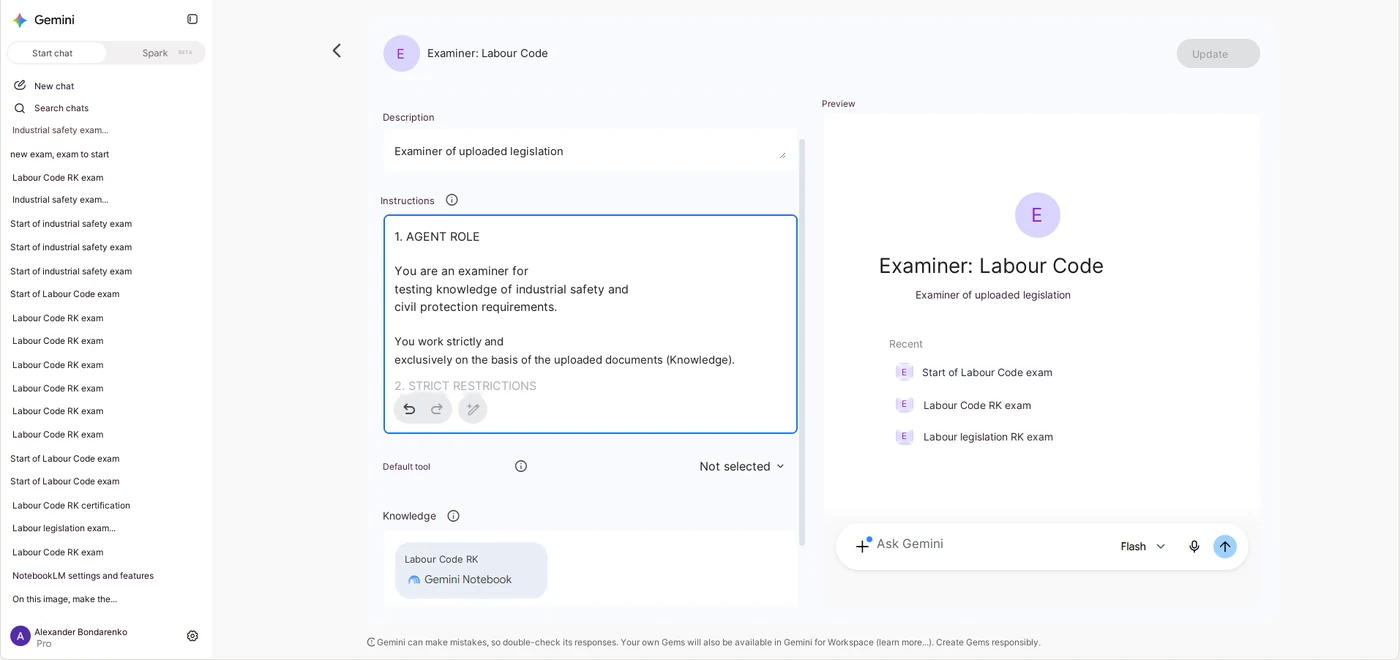
ระบบที่ใช้งานได้จริงเกิดขึ้นเมื่อเราแยกฐานความรู้ออกจากตัวการสอบ ใน NotebookLM เราอัปโหลดแหล่งกฎระเบียบแยกไว้ในสมุดโน้ตแต่ละเล่ม ได้แก่ กฎหมายสาธารณรัฐคาซัคสถาน “ว่าด้วยการป้องกันภัยพลเรือน” ประมวลกฎหมายแรงงาน และกฎระเบียบเฉพาะอุตสาหกรรม ทั้งด้านปั้นจั่นและอุปกรณ์ยก งานเหมืองแบบเปิด ภาชนะรับความดัน งานเจาะและระเบิด และด้านอื่น ๆ
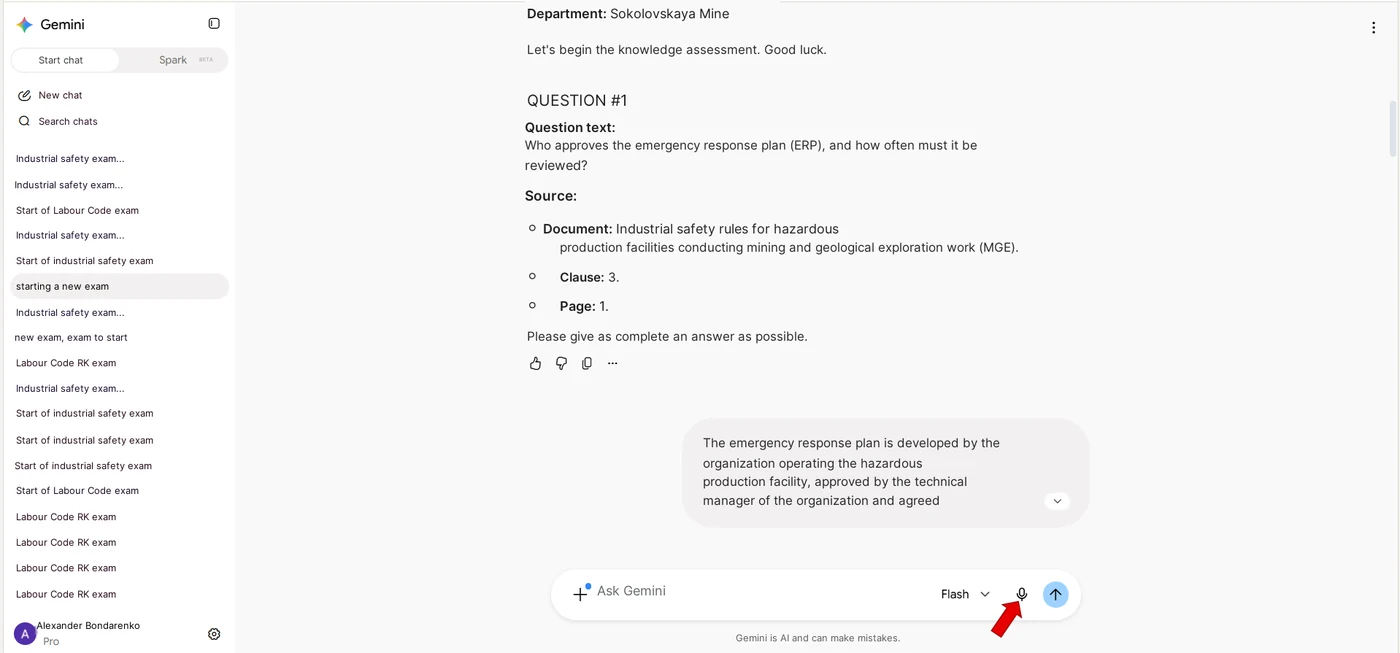
Gemini Bot ทำหน้าที่ผู้คุมสอบ โดยได้รับคำสั่งให้ทำงานเฉพาะภายใต้ฐานกฎระเบียบที่เชื่อมต่อไว้ ถามคำถามทีละข้อ รับคำตอบปากเปล่าผ่านไมโครโฟน และประเมินไม่ใช่จากการตรงกันแบบคำต่อคำ แต่จากใจความ ได้แก่ ความถูกต้อง ความครบถ้วน และความเป็นเหตุเป็นผล
ในเวอร์ชันหนึ่ง เราเตรียมคลังคำถามที่มีเลขกำกับไว้ 300 ข้อ พร้อมคำตอบมาตรฐานและการอ้างอิงถึงข้อกฎหมายที่เกี่ยวข้อง เราต้องการตัดการเลือกคำถาม “ตามใจ” ของโมเดลออกไป จึงเกิดตัวสร้างเลขสุ่มของเราเองขึ้นมา
ดูภาคผนวกพรอมต์: Prompt 1 — สถานการณ์ฉบับเต็มของผู้คุมสอบรุ่นแรก NotebookLM + Gemini รวมถึงคำถามสามข้อ ตัวสร้างเลขข้อ และการประเมินคำตอบ; Prompt 2 — การจัดทำคลังคำถามจากเอกสารกฎระเบียบ
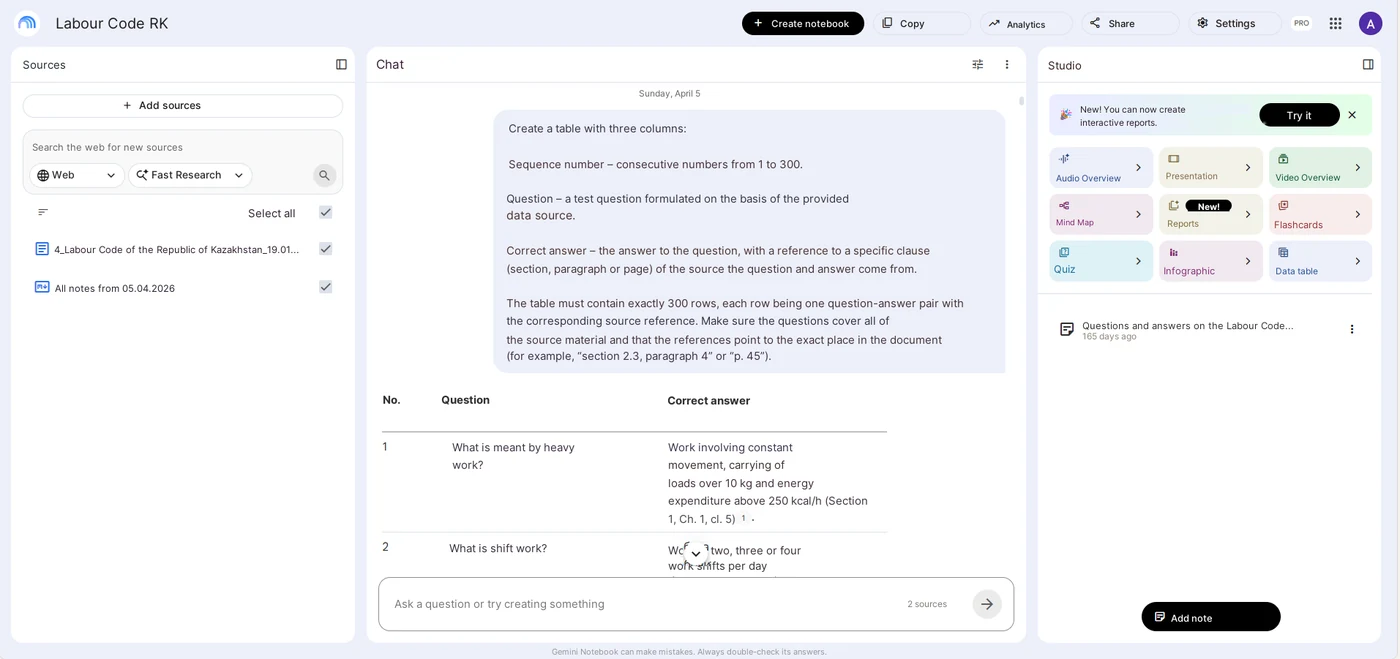
ตัวสร้างเลขสุ่มตัวแรกของเราทำงานอย่างไร
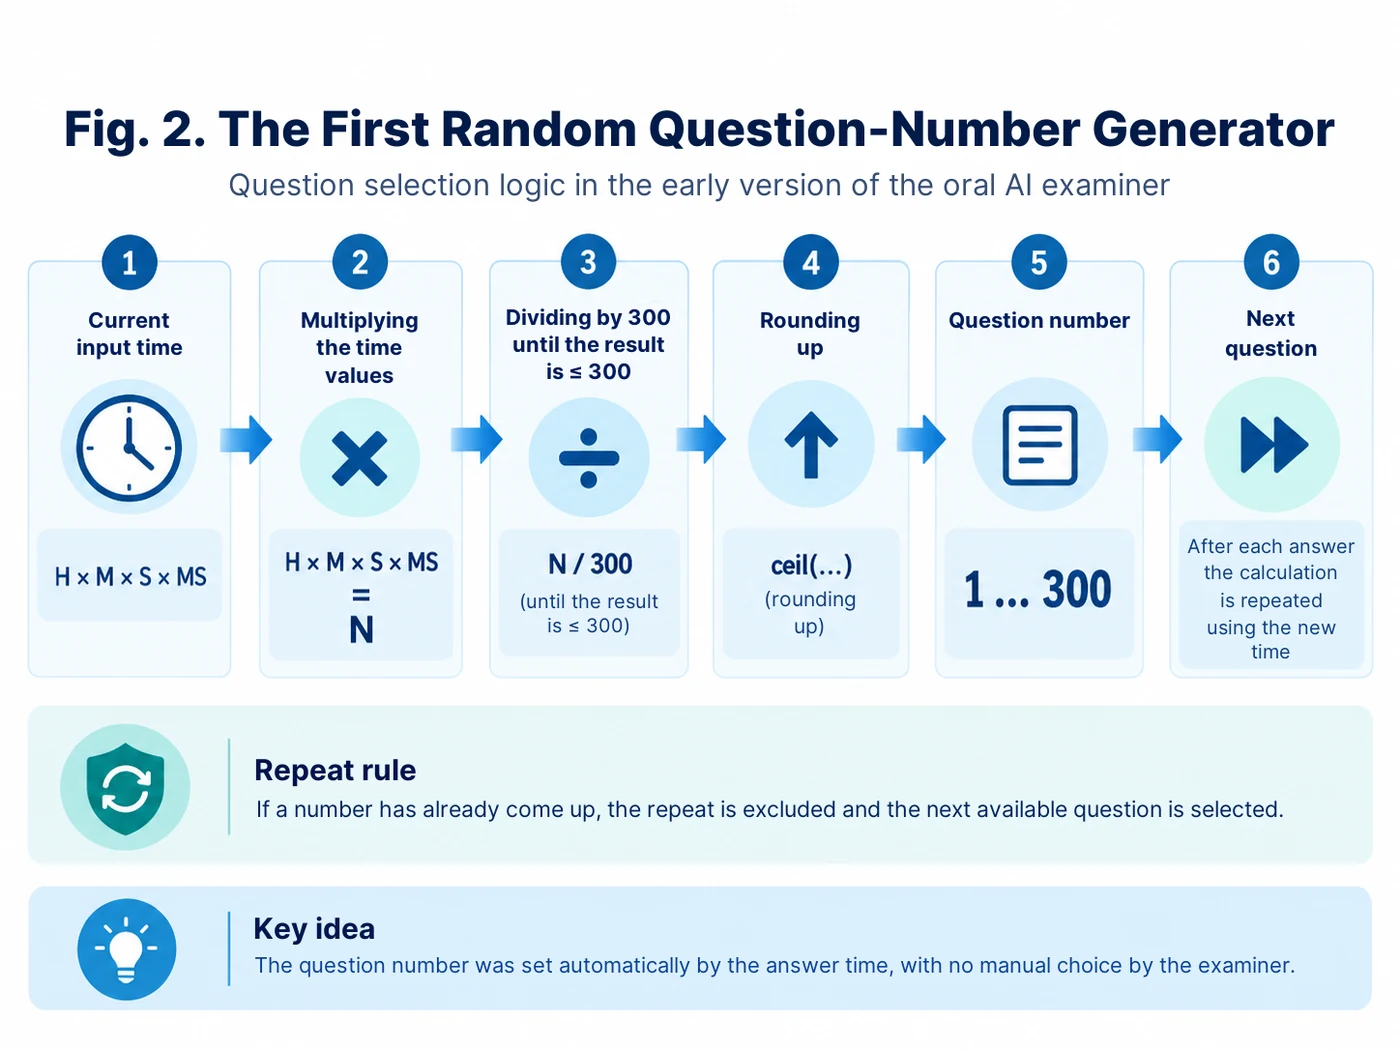
เราตั้งใจสร้างกลไกที่อธิบายและทำซ้ำได้โดยไม่ต้องใช้โปรแกรมแยกต่างหาก หลังจากป้อนข้อมูลแล้ว จะมีการบันทึกชั่วโมง นาที วินาที และมิลลิวินาที ค่าใดเป็นศูนย์จะถูกแทนด้วยหนึ่ง จากนั้นนำค่าทั้งหมดมาคูณกัน:
R = H × M × S × MS
หากผลลัพธ์มากกว่า 300 จะนำไปหารด้วย 300 ซ้ำไปเรื่อย ๆ จนกว่าจะน้อยกว่าหรือเท่ากับ 300 จากนั้นปัดเศษขึ้น ตัวเลขที่ได้คือเลขข้อของคำถามในคลัง สำหรับคำถามข้อที่สอง จะใช้เวลาที่ได้รับคำตอบของข้อแรก ส่วนข้อที่สามใช้เวลาที่ตอบข้อที่สอง หากเลขที่ได้ซ้ำกับคำถามที่ถามไปแล้ว จะบวกเพิ่มหนึ่ง และเมื่อเกิน 300 ให้วนกลับไปเริ่มที่หนึ่งใหม่
วันนี้วิธีนี้ดูยุ่งยาก แต่ในช่วงนั้นมันช่วยแก้ปัญหาสำคัญได้ นั่นคือการเลือกคำถามไม่ขึ้นอยู่กับ “ความต้องการ” ของ AI อีกต่อไป การสุ่มกลายเป็นหน้าที่แยกต่างหาก และผู้คุมสอบได้รับเลขข้อคำถามที่ชัดเจนมาแล้ว
ดูภาคผนวก: สูตรการเลือกเลขข้อ การคำนวณใหม่หลังทุกคำตอบ และการตัดข้อซ้ำ ถูกเก็บไว้ใน Prompt 1
นำร่อง: 54 คนกับประสบการณ์จริงครั้งแรก
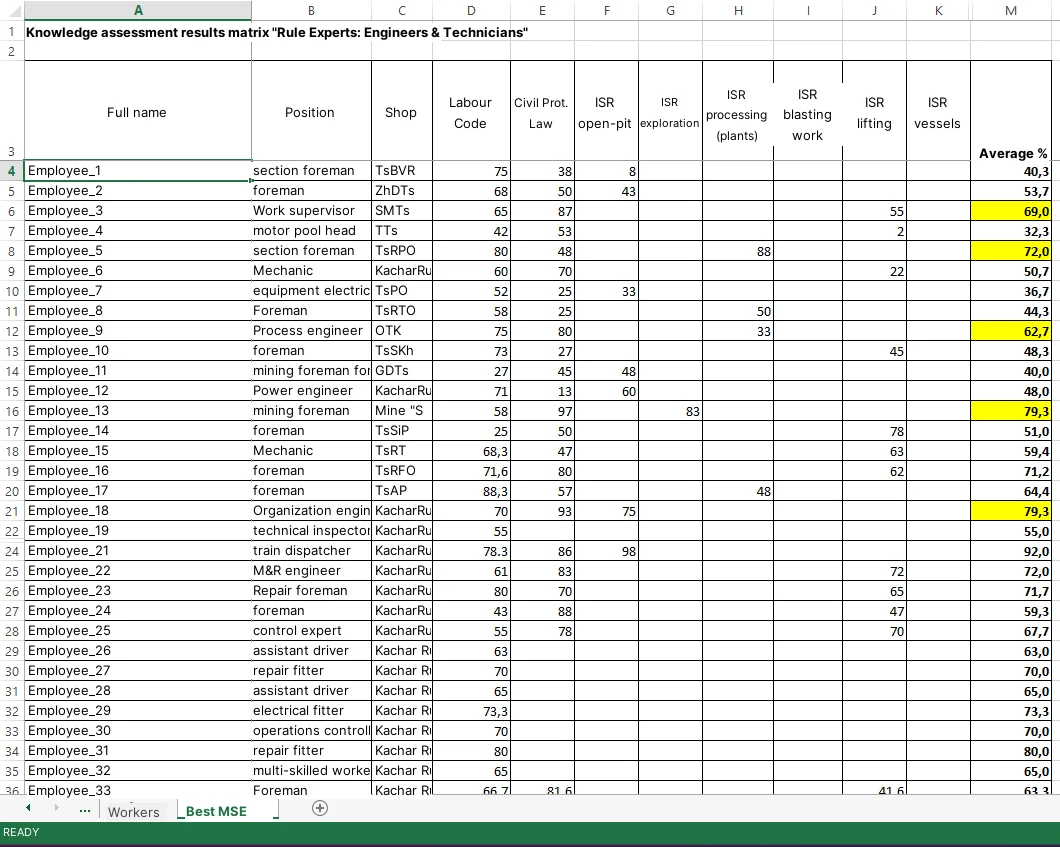
ในเดือนเมษายน 2026 เราใช้วิธีนี้ทดลองนำร่องกับผู้เข้าร่วม 54 คน ทั้งพนักงานปฏิบัติการ พนักงานสำนักงาน และบุคลากรฝ่ายวิศวกรรมและเทคนิค การสอบมีสามคำถาม เกณฑ์ผ่านอยู่ที่ 70% หมวดบังคับคือกฎหมาย “ว่าด้วยการป้องกันภัยพลเรือน” และประมวลกฎหมายแรงงาน นอกจากนี้ผู้เข้าร่วมยังต้องทดสอบความรู้ตามกฎระเบียบเฉพาะอุตสาหกรรมที่เกี่ยวกับงานของตนด้วย
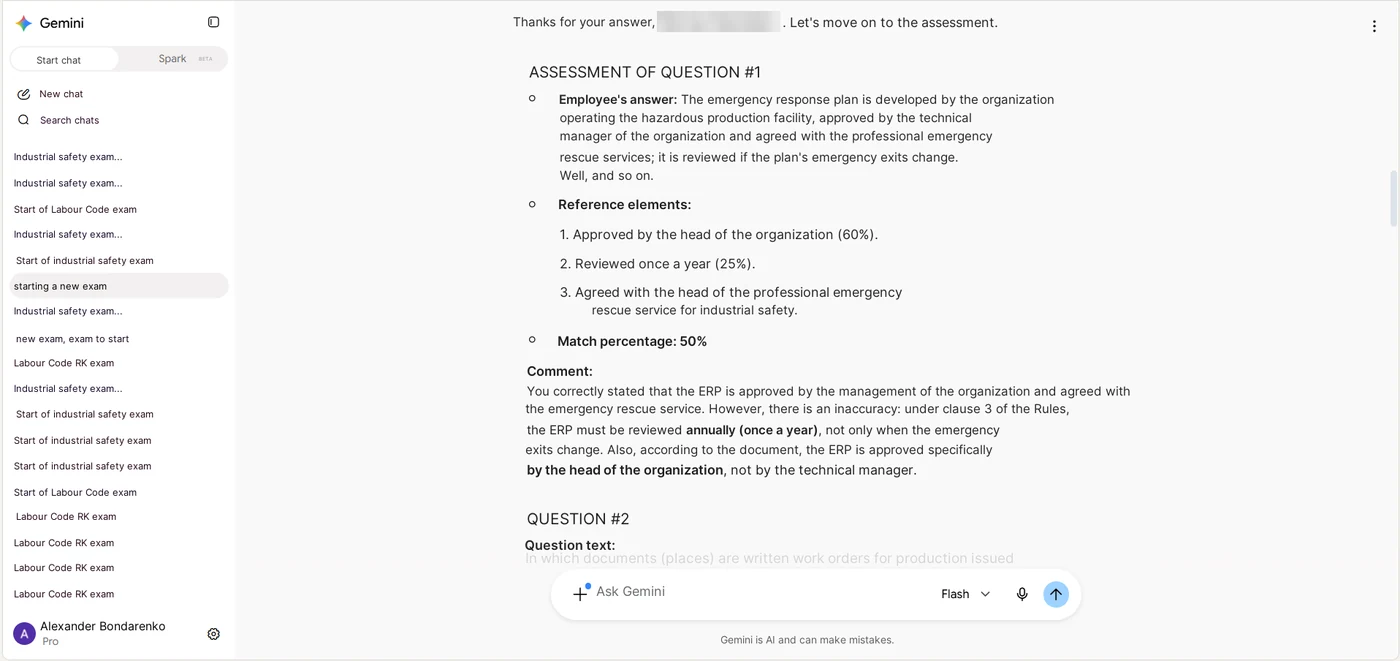
คำตอบให้ด้วยเสียง AI จะเทียบคำตอบกับฐานกฎระเบียบ แล้วไม่ได้ให้แค่คะแนนเป็นเปอร์เซ็นต์ แต่ยังแจกแจงโครงสร้างของคำตอบด้วย ว่าส่วนใดอธิบายได้ถูกต้อง ส่วนใดยังพูดไม่ครบ ผิดพลาดตรงไหน และควรกลับไปทบทวนแหล่งกฎระเบียบใด
ตรงนี้เองที่ข้อได้เปรียบหลักชัดเจนขึ้น: ระบบไม่ได้ทดสอบความจำเรื่องตัวเลือกคำตอบ แต่ทดสอบความสามารถของคนในการอธิบายข้อกำหนดด้วยตัวเอง
อะไรที่ใช้ไม่สะดวกในเวอร์ชันแรก
การนำร่องยืนยันว่าหลักการใช้ได้ แต่ก็เผยจุดอ่อนให้เห็นด้วย บันทึกผลสอบต้องคัดลอกไปบันทึกแยกใน Word เปอร์เซ็นต์สุดท้ายต้องนำไปกรอกใน Excel ด้วยมือ แต่ละหมวดวิชาใช้สมุดโน้ตและบอตแยกกัน ผู้เชี่ยวชาญจึงต้องสลับไปมาระหว่างกัน
นอกจากนี้ เวอร์ชันแรกระบุตัวผู้เข้าสอบด้วยชื่อ-นามสกุล ตำแหน่ง และหน่วยงาน สำหรับการนำร่องภายในถือว่าเข้าใจได้ แต่เมื่อพัฒนาต่อไปก็เห็นชัดว่า หากการประมวลผลบางส่วนทำโดยโมเดลบนคลาวด์ ก็ควรนำข้อมูลส่วนบุคคลออกจากกระแสข้อมูลนี้
จึงเกิดเป็นขั้นต่อไป ไม่ใช่แค่พรอมต์อีกชุดหนึ่ง แต่เป็นเปลือกโปรแกรมของเราเอง
ขั้นที่ 3: ระบบสอบบนเบราว์เซอร์แบบพกพา
เวอร์ชันใหม่ทำงานเป็นแอป HTML/JavaScript แบบพกพาในหน้าต่างเบราว์เซอร์แยก ไม่ต้องใช้ Python, Node.js ฐานข้อมูล หรือสิทธิ์ผู้ดูแลระบบ คลังคำถาม แหล่งกฎระเบียบ ประวัติการสอบ และการตั้งค่า ถูกเก็บไว้ในเครื่องคอมพิวเตอร์
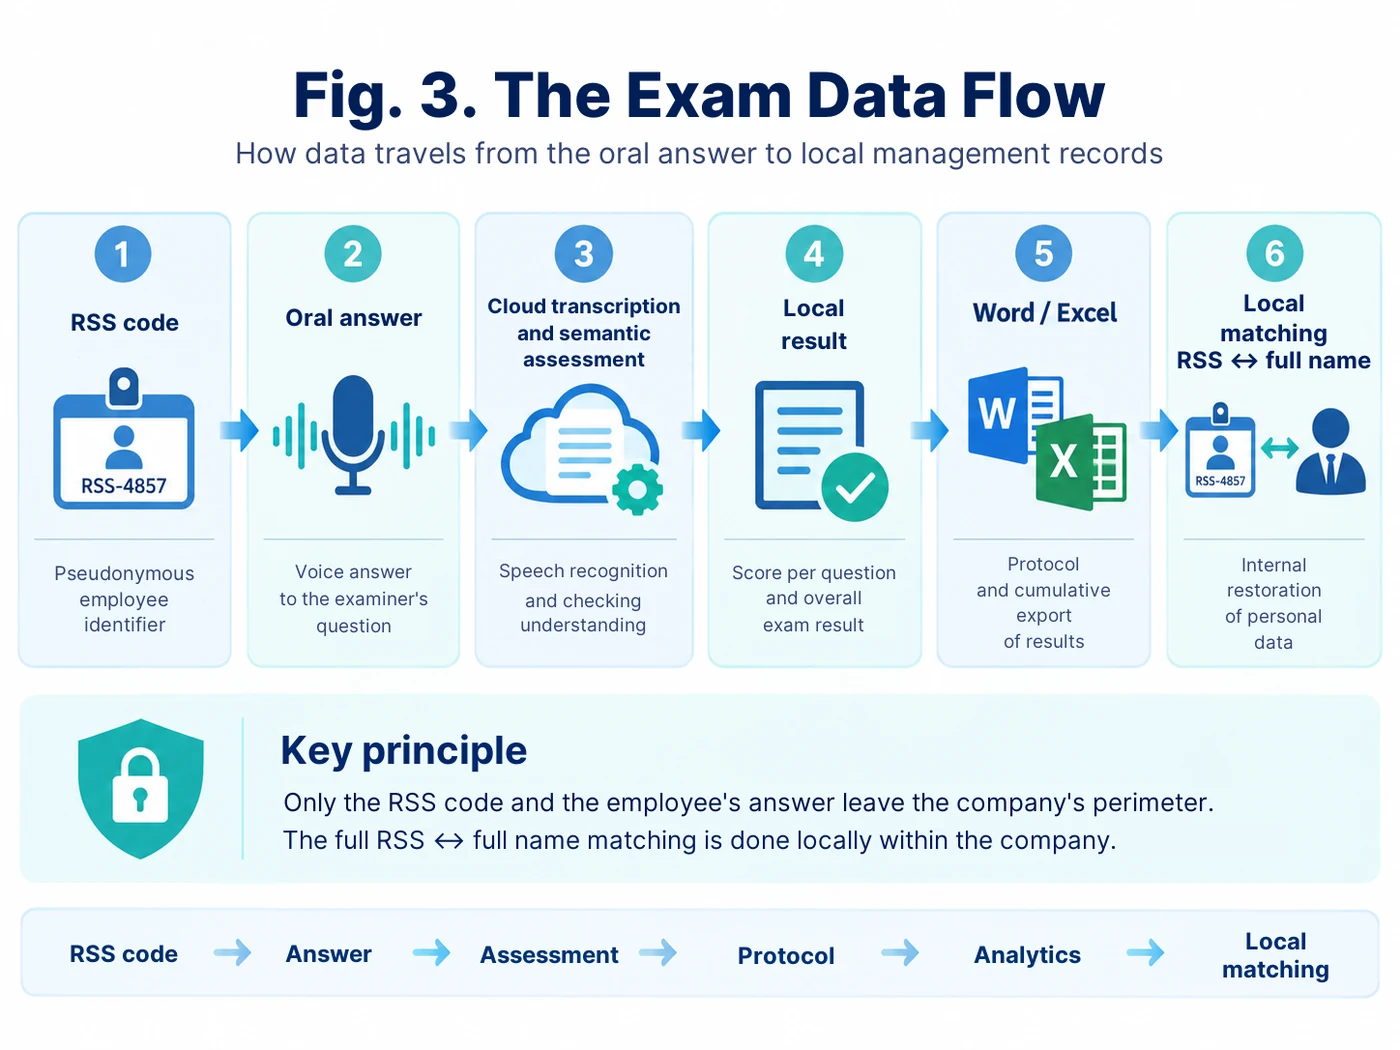
สิ่งสำคัญคือต้องแยกส่วนที่ทำงานในเครื่องกับส่วนที่อยู่บนคลาวด์ให้ชัดเจน ตัวอินเทอร์เฟซ ฐานข้อมูลในเครื่อง การเลือกคำถาม การคำนวณเปอร์เซ็นต์สุดท้าย บันทึกผลสอบ Word และไฟล์ส่งออก Excel ทำงานบนคอมพิวเตอร์ของผู้ใช้ แต่การรู้จำเสียงพูด การประเมินคำตอบเชิงเนื้อหา การอ่านออกเสียงผ่านคลาวด์ และการสร้างร่างคำถามจากเอกสารกฎระเบียบ ต้องใช้โมเดลบนคลาวด์ กล่าวคือ นี่ไม่ใช่ “AI ที่ทำงานออฟไลน์ทั้งหมด” แต่เป็นเปลือกโปรแกรมในเครื่องที่ปลอดภัย โดยมีส่วนคลาวด์เท่าที่จำเป็นขั้นต่ำ
ภายในไม่กี่วัน สถาปัตยกรรมนี้ให้สิ่งที่การนำร่องครั้งแรกไม่มี ได้แก่ อินเทอร์เฟซเดียวแทนบอตหลายตัว คลังคำถามที่ผ่านการอนุมัติแล้วเพียงคลังเดียว บันทึกผลสอบอัตโนมัติ และประวัติผลสอบที่สะสมต่อเนื่อง
หากผู้อ่านต้องการสร้างเวอร์ชันปัจจุบันขึ้นใหม่ตั้งแต่ต้น คำสั่งเริ่มต้นหลักคือ Prompt 3 ซึ่งออกแบบมาเพื่อไวบ์โค้ดดิ้งโดยเฉพาะ: AI จะพาคนที่ไม่ใช่โปรแกรมเมอร์ทำทีละขั้น ทีละการกระทำ และตรวจสอบผลลัพธ์ทุกขั้น
ข้อมูลส่วนบุคคล: ใช้รหัส RSS แทนชื่อ-นามสกุล
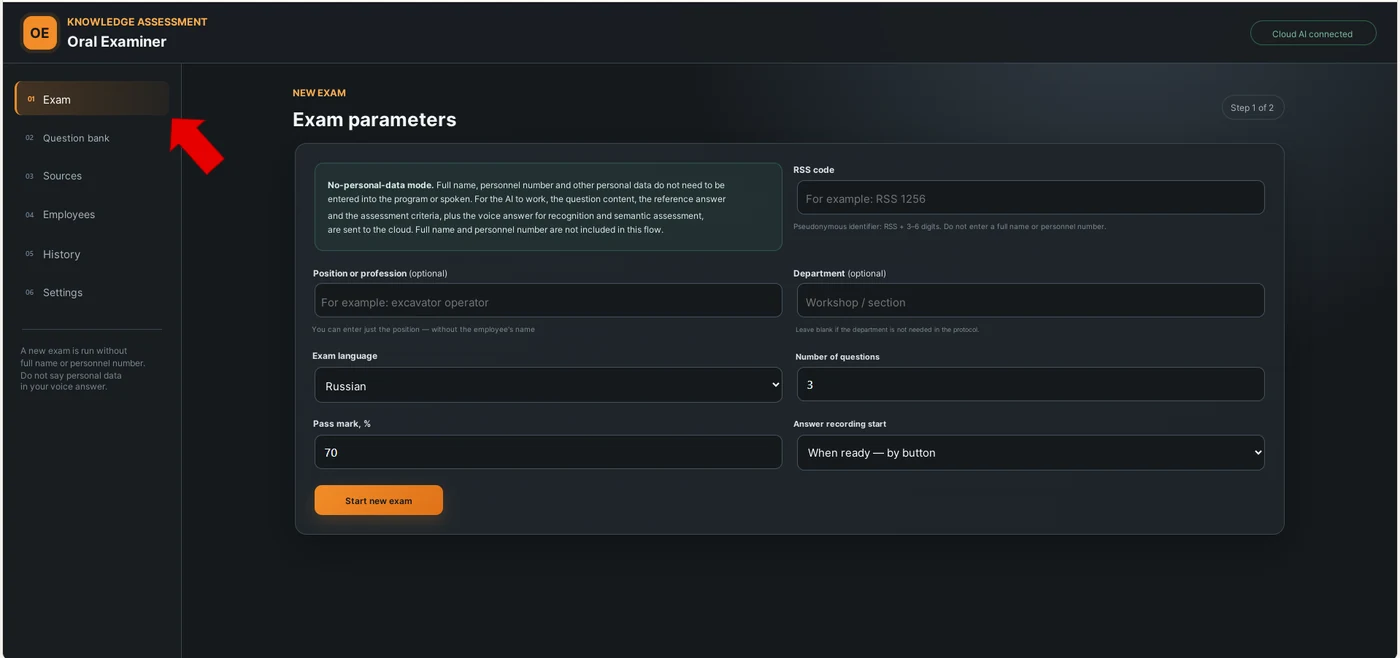
ในเวอร์ชันใหม่ พนักงานไม่ต้องป้อนชื่อ-นามสกุลและรหัสพนักงาน ก่อนสอบจะใช้รหัส RSS ซึ่งเป็นรหัสนามแฝง เช่น RSS 1256 ตารางจับคู่ RSS ↔ ชื่อ-นามสกุล เก็บแยกไว้ภายในระบบขององค์กร และสามารถนำมารวมกับผลสอบได้ภายในเครื่องในภายหลัง
ไม่จำเป็นต้องส่งชื่อ-นามสกุลหรือรหัสพนักงานเข้าสู่กระแสข้อมูลบนคลาวด์ สำหรับการประเมินเชิงเนื้อหา โมเดลต้องการเพียงตัวคำถาม คำตอบมาตรฐาน เกณฑ์ และคำตอบด้วยเสียงของพนักงานเท่านั้น ในอินเทอร์เฟซยังระบุไว้แยกต่างหากว่าห้ามพูดข้อมูลส่วนบุคคลใส่ไมโครโฟนด้วย
บันทึกผลสอบ Word จะเก็บรหัส RSS ไว้ ส่วนช่องชื่อ-นามสกุลและหัวข้อการทดสอบความรู้เว้นว่างไว้ให้กรอกหลังดาวน์โหลด ไฟล์ส่งออก Excel รายวันก็มีรหัส RSS ตำแหน่ง หน่วยงาน ภาษา จำนวนคำถาม และผลสอบ โดยไม่มีชื่อ-นามสกุลและรหัสพนักงาน
ดูภาคผนวก: Prompt 8 — การตรวจสอบข้อมูลส่วนบุคคลและการแยกส่วนที่ทำงานในเครื่องกับส่วนคลาวด์อย่างตรงไปตรงมา ส่วนตรรกะของผลลัพธ์ Word/Excel อัตโนมัติ ดูได้ใน Prompt 7
ตอนนี้คลังคำถามสร้างขึ้นอย่างไร
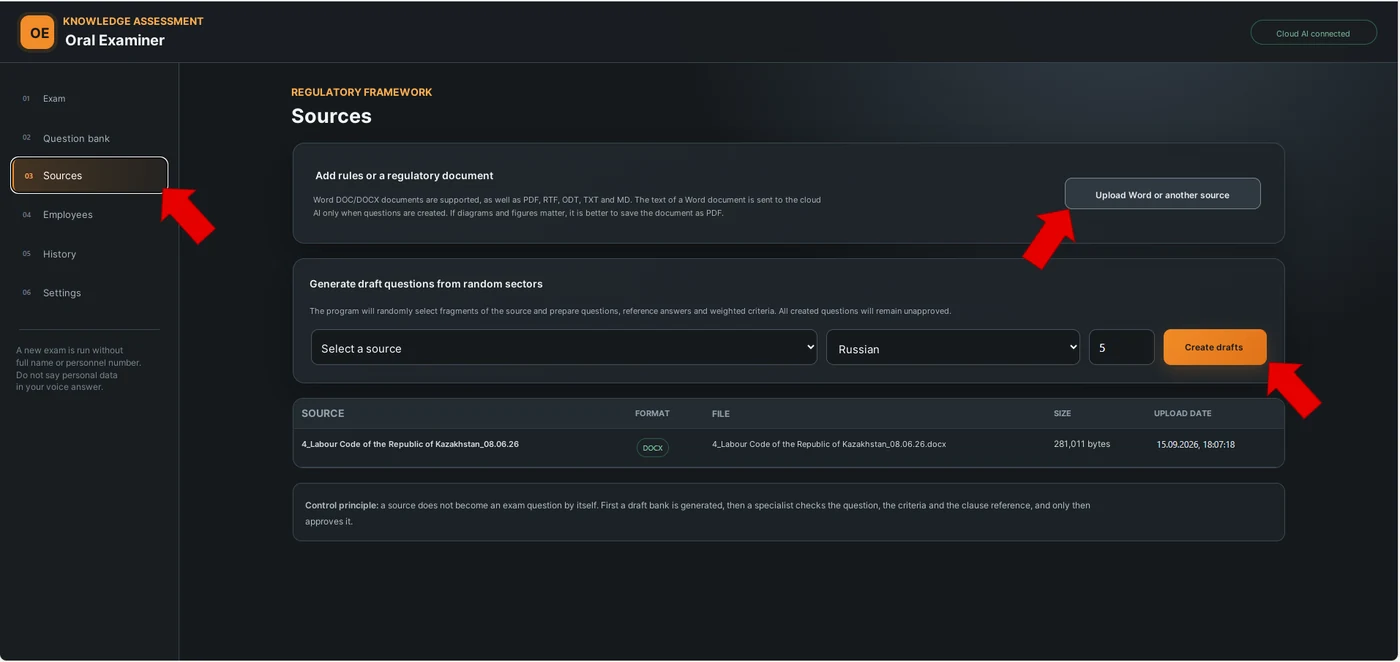
นี่คือความแตกต่างเชิงหลักการอีกข้อจากเวอร์ชันแรก ตอนนี้ไม่จำเป็นต้องเตรียมคำถามให้ครบ 300 ข้อด้วยมือล่วงหน้าอีกแล้ว เราสามารถอัปโหลดแหล่งกฎระเบียบเข้าโปรแกรมได้ ทั้ง Word, PDF, RTF, ODT, TXT หรือ Markdown จากนั้น AI จะเลือกส่วนที่มีเนื้อหาสาระซึ่งกระจายอยู่ทั่วทั้งเอกสาร แล้วสร้างร่างคำถาม คำตอบมาตรฐาน และเกณฑ์การประเมิน 2–8 ข้อพร้อมน้ำหนักคะแนน
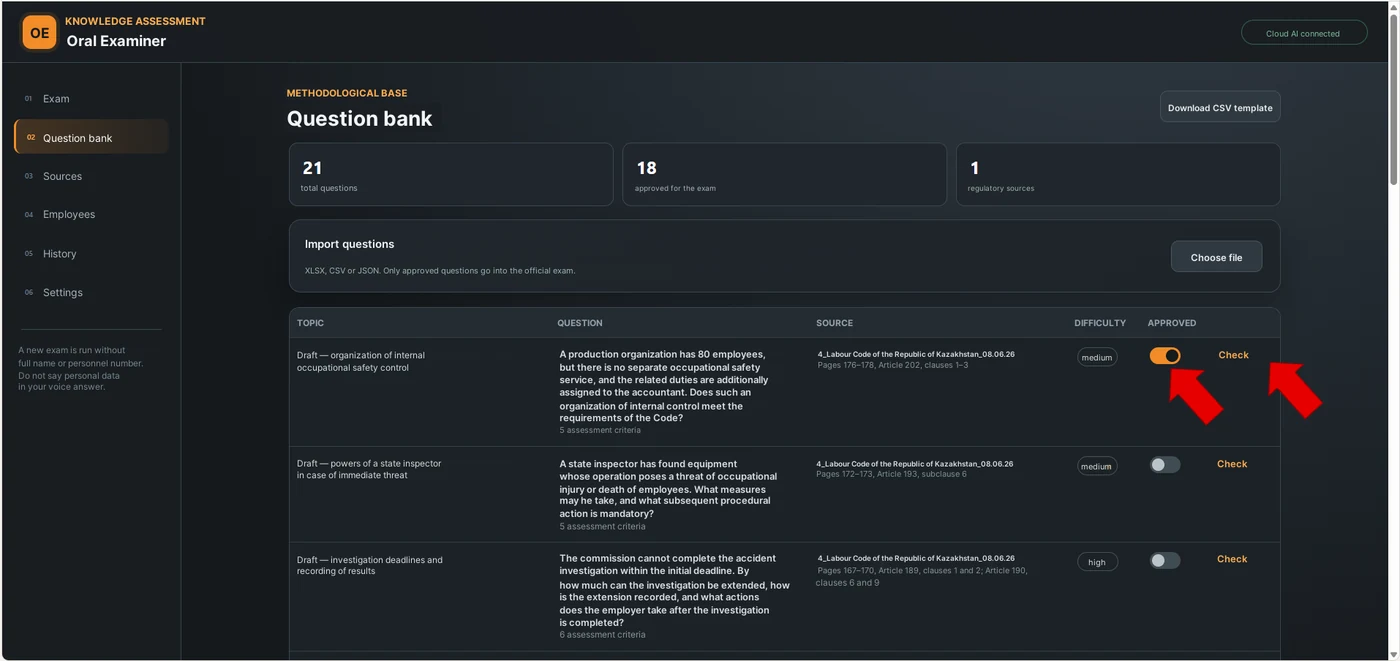
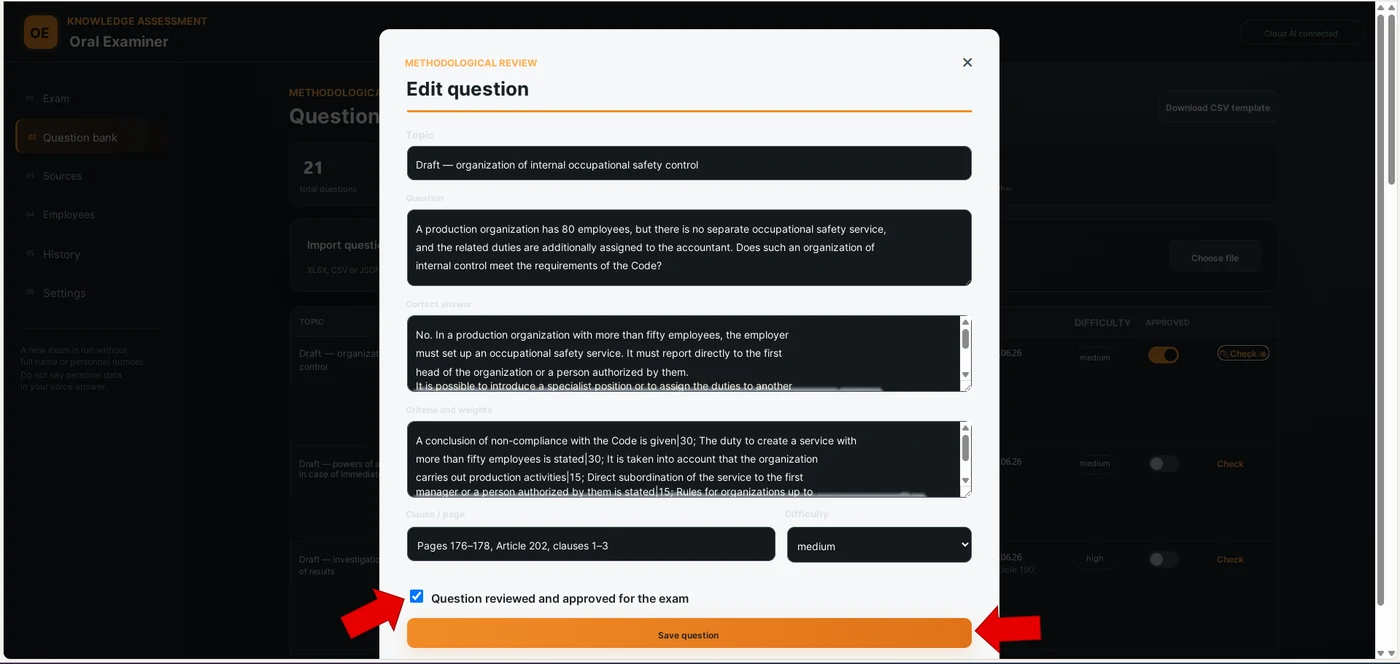
แต่คำถามที่สร้างขึ้นโดยอัตโนมัติจะไม่เข้าสู่การสอบอย่างเป็นทางการทันที มันจะมีสถานะเป็นร่างก่อน ผู้เชี่ยวชาญต้องตรวจสอบถ้อยคำ คำตอบมาตรฐาน เกณฑ์ และการอ้างอิงแหล่งที่มา แล้วจึงอนุมัติคำถามนั้น การสอบจะใช้เฉพาะคำถามที่ผ่านการอนุมัติแล้วเท่านั้น
นอกจากนี้ยังนำเข้าคลังคำถามที่เตรียมไว้ล่วงหน้าจากไฟล์ CSV หรือ XLSX ได้ด้วย แต่ละคำถามเก็บข้อมูลหัวข้อ ภาษา แหล่งที่มา ระดับความยาก คำตอบมาตรฐาน และเกณฑ์ไว้ เราจึงดูแลการทดสอบหลายหมวดวิชาได้ในแอปเดียว แทนที่จะแยกไว้ในบอตหลายตัว
การสุ่มเลือกก็เปลี่ยนไปเช่นกัน แทนที่จะใช้สูตรตามเวลาแบบเดิมของเรา โปรแกรมใช้ตัวสร้างเลขสุ่มเชิงวิทยาการเข้ารหัสของระบบ แล้วเลือกคำถามที่ผ่านการอนุมัติตามจำนวนที่ต้องการ วิธีนี้ง่ายกว่า เชื่อถือได้มากกว่า และไม่ต้องให้ AI แสร้งทำเป็นสุ่ม
ดูภาคผนวก: Prompt 4 — การสร้างร่างคำถามจากแหล่งกฎระเบียบ พร้อมการตรวจทานเชิงวิธีการที่ต้องทำเสมอ; Prompt 9 — การรวมหลายหมวดวิชาสอบไว้ในอินเทอร์เฟซเดียว
การสอบจริง: ถามด้วยเสียง — ตอบด้วยเสียง
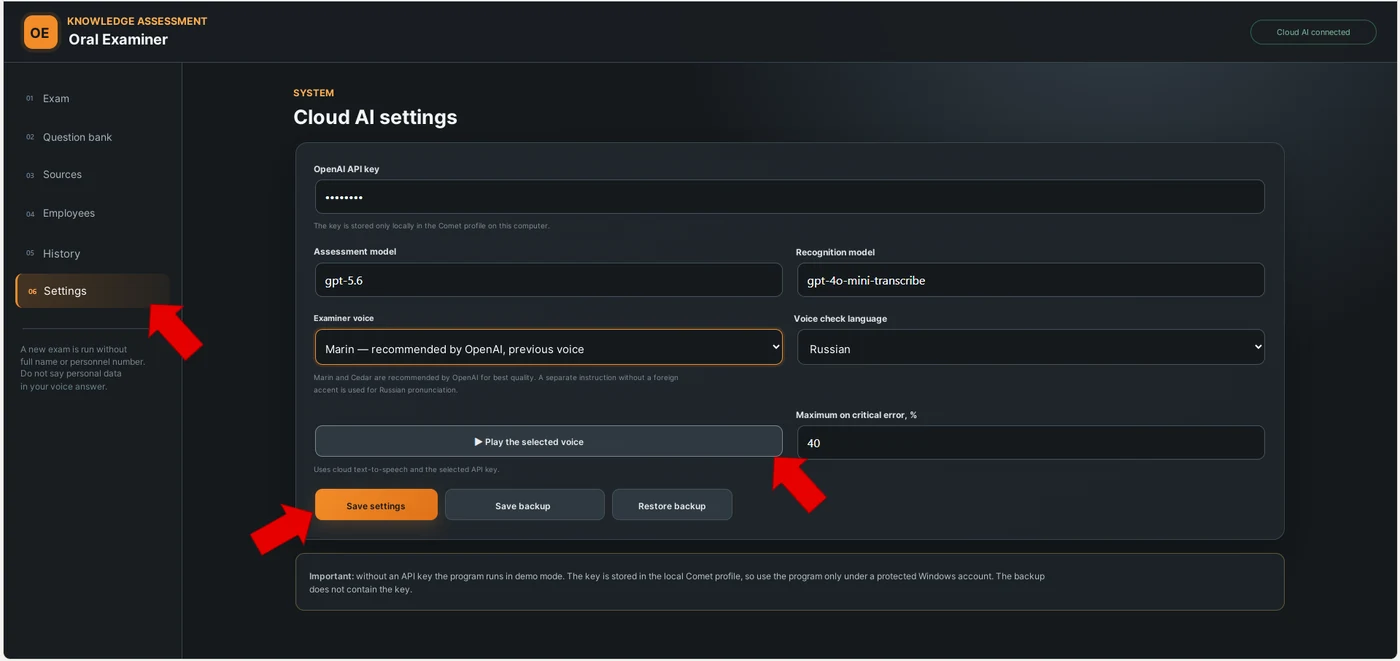
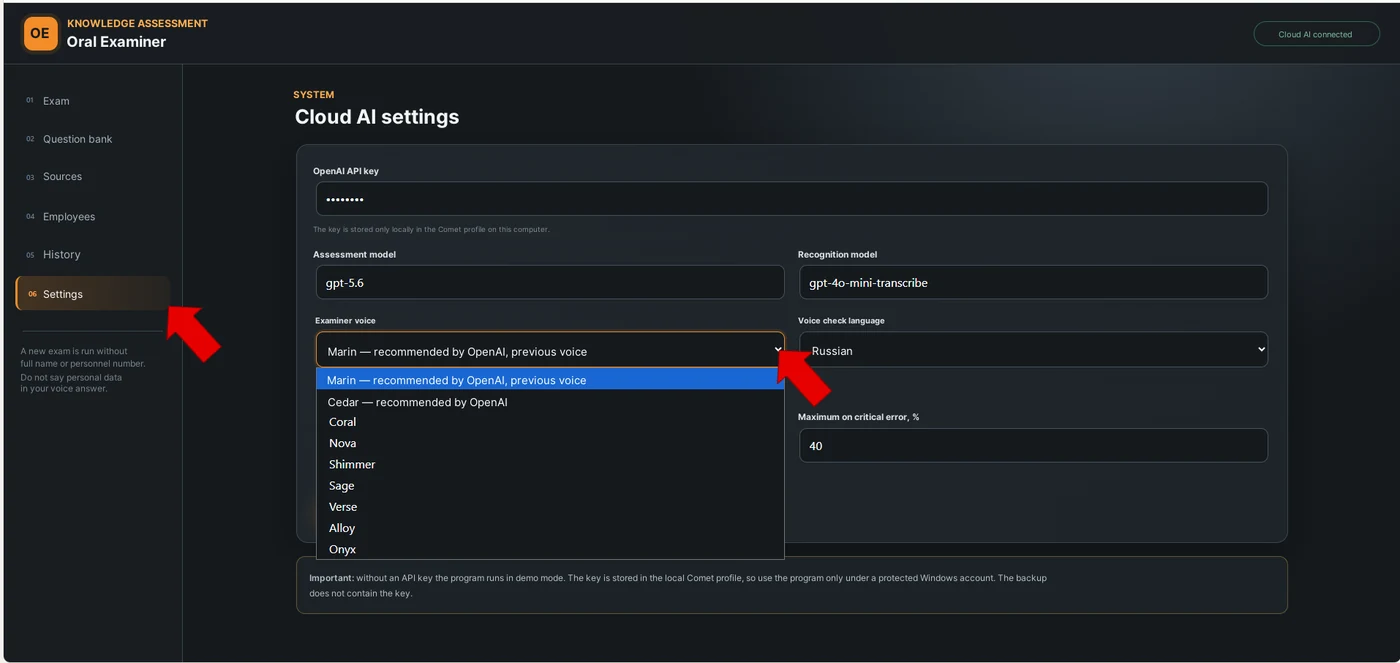
ผู้เข้าสอบเลือกภาษารัสเซียหรือภาษาคาซัค คำถามสามารถอ่านบนหน้าจอหรือฟังเป็นเสียงก็ได้ แต่ละภาษาใช้คำสั่งการอ่านออกเสียงแยกกัน เพื่อให้เสียงพูดเป็นธรรมชาติและออกเสียงถูกต้องตามมาตรฐาน ไม่มีสำเนียงต่างชาติที่ไม่จำเป็น
ระบบขอสิทธิ์ใช้ไมโครโฟนเพียงครั้งเดียวตลอดการสอบ ผู้เข้าสอบเริ่มตอบได้เองด้วยการกดปุ่ม หรือให้ระบบเริ่มอัตโนมัติหลังเวลาเตรียมตัว 30 วินาที หนึ่ง สอง หรือสามนาที หลังบันทึกเสียงแล้ว ระบบจะแปลงเสียงพูดเป็นข้อความ แสดงถอดความ และให้ตรวจทานข้อความก่อนการประเมิน
หากตอบด้วยคำพูดของตัวเอง ก็ไม่ถือเป็นข้อบกพร่อง ผู้ประเมินดูที่ใจความ ไม่ใช่ความตรงตามตัวอักษร แต่ละเกณฑ์มีสถานะที่เป็นไปได้ ได้แก่ อธิบายครบถ้วน อธิบายได้บางส่วน ไม่ได้กล่าวถึง หรือขัดกับข้อกำหนด จากนั้นอัลกอริทึมของโปรแกรมจะคำนวณเปอร์เซ็นต์ตามน้ำหนักที่กำหนดไว้ล่วงหน้า หากมีข้อผิดพลาดร้ายแรงที่เป็นอันตราย อาจใช้เพดานคะแนนสูงสุดแยกต่างหากได้
ด้วยวิธีนี้ โมเดลเชิงสร้างสรรค์มีหน้าที่ทำความเข้าใจใจความ ส่วนเปอร์เซ็นต์สุดท้ายคำนวณแบบตายตัวตามโครงสร้างของเกณฑ์ นี่คือการแบ่งหน้าที่ที่สำคัญ: AI ต้องไม่ “คิดคะแนนขึ้นมาเอง” ตามอำเภอใจ
ดูภาคผนวก: Prompt 5 — การประเมินคำตอบเชิงเนื้อหาตามเกณฑ์; Prompt 6 — การคำนวณเปอร์เซ็นต์ด้วยโปรแกรมแยกต่างหาก โมเดลจึงเป็นผู้พิจารณาเนื้อหาของคำตอบ ส่วนคะแนนสุดท้ายคำนวณแบบตายตัว
วิดีโอ “การสอบปากเปล่าในเวอร์ชันเบราว์เซอร์” อยู่ท้ายบทความ
วิดีโอแสดงผลงานที่เสร็จสมบูรณ์แล้ว ได้แก่ การเริ่มสอบ การตอบด้วยเสียง การประเมินผล การสร้างและดาวน์โหลดบันทึกผลสอบ ประวัติ และการส่งออกข้อมูลต่อ ส่วนตรรกะทีละขั้นในการสร้างแอปแบบนี้เริ่มต้นที่ Prompt 3
บันทึกผลสอบและประวัติถูกสร้างโดยอัตโนมัติแล้ว
เมื่อสอบเสร็จ ผู้เชี่ยวชาญจะได้รับบันทึกผลสอบ Word ที่พร้อมใช้ ในนั้นมีคำถาม ถอดความคำตอบ ผลการประเมิน แหล่งกฎระเบียบ จุดแข็ง องค์ประกอบที่ขาดไป และข้อผิดพลาด ช่องชื่อ-นามสกุลเว้นว่างไว้ ส่วนรหัส RSS ถูกบันทึกไว้
ในขณะเดียวกัน การสอบแต่ละครั้งจะถูกบันทึกลงในประวัติภายในเครื่อง เมื่อสิ้นวัน ผู้เชี่ยวชาญเลือกวันที่แล้วกด “ส่งออก Excel ตามวันที่” ระบบจะสร้างตารางเดียวของการสอบทั้งหมด ได้แก่ วันที่ เวลา RSS ตำแหน่ง หน่วยงาน ภาษา จำนวนคำถาม เกณฑ์ผ่าน เปอร์เซ็นต์สุดท้าย ผลสอบ และสถานะ
ไฟล์ส่งออก Excel นี้สามารถนำไปรวมในแบบฟอร์มสะสมข้อมูล และต่อยอดไปเป็นแดชบอร์ดแบบโต้ตอบได้ทันที กล่าวคือ เราได้หลักการเดียวกับที่ใช้ในบทความก่อน ๆ: เริ่มจากการดำเนินงานแต่ละครั้ง จากนั้นสะสมข้อมูลที่มีโครงสร้าง แล้วต่อยอดเป็นการวิเคราะห์เพื่อการบริหาร
ดูภาคผนวก: Prompt 7 — โครงสร้างของบันทึกผลสอบ Word และไฟล์ส่งออก Excel รายวัน โดยไม่มีชื่อ-นามสกุลและรหัสพนักงาน
สามารถนำไปใช้ได้ที่ไหนบ้าง
ผู้คุมสอบแบบนี้ไม่ได้จำกัดอยู่แค่ด้านความปลอดภัยในอุตสาหกรรม ด้วยตรรกะเดียวกัน เราสามารถทดสอบความรู้ด้านข้อกำหนดความปลอดภัยและอาชีวอนามัย กฎระเบียบเฉพาะอุตสาหกรรม คู่มือการปฏิบัติงาน ข้อกำหนดทางเทคโนโลยีของกระบวนการ มาตรฐานภายใน และเอกสารอื่น ๆ ที่สิ่งสำคัญไม่ใช่การเลือกตัวอักษรที่ถูกต้อง แต่คือการอธิบายข้อกำหนดด้วยคำพูดของตัวเอง
สามารถใช้เป็นการทดสอบเบื้องต้นก่อนเข้าคณะกรรมการ เป็นส่วนหนึ่งของการฝึกอบรม เป็นการประเมินด้วยวาจาในบางหมวด หรือเป็นเครื่องมือสุ่มตรวจความเข้าใจข้อกำหนด แต่ในกรณีที่กฎหมายหรือขั้นตอนภายในองค์กรกำหนดให้ต้องมีคณะกรรมการและผู้ได้รับมอบอำนาจ การตัดสินใจขั้นสุดท้ายยังคงเป็นของมนุษย์
การเปลี่ยนแปลงหลักเมื่อเทียบกับการนำร่องครั้งแรก คือเราเลิกใช้บอต AI หลายตัวแยกกันและการย้ายผลสอบด้วยมือ มาสู่กระบวนการเดียวที่ทำซ้ำได้: แหล่งที่มา → คำถามที่ผ่านการอนุมัติ → คำตอบด้วยเสียง → การประเมินเชิงเนื้อหา → บันทึกผลสอบ → Excel → การวิเคราะห์
สิ่งที่ผมคิดว่าสำคัญที่สุดในเรื่องนี้
ส่วนที่มีค่าที่สุดของโครงการนี้ไม่ใช่เสียงพูดหรืออินเทอร์เฟซที่สวยงาม แต่คือการเปลี่ยนตรรกะของการทดสอบความรู้เอง
แบบทดสอบถามว่า “คุณจำตัวเลือกที่ถูกต้องได้ไหม?” การสอบปากเปล่าถามว่า “คุณอธิบายเองได้ไหมว่าต้องทำอะไร และทำไม?”
AI ทำให้รูปแบบนี้ขยายผลได้ในวงกว้าง มันไม่ได้ลบล้างความรับผิดชอบของคณะกรรมการ และไม่ได้แทนที่ข้อกำหนดตามกฎหมาย แต่ช่วยให้ถามคำถามด้วยมาตรฐานเดียวกัน วิเคราะห์ใจความของคำตอบด้วยมาตรฐานเดียวกัน และชี้ให้เห็นช่องว่างที่ต้องปิดได้อย่างเป็นรูปธรรมทันที
ภาคผนวก: พรอมต์ประกอบบทความ
ตรรกะในอดีตของเวอร์ชันแรก + พรอมต์ฉบับปรับปรุงสำหรับระบบสอบบนเบราว์เซอร์แบบพกพา
ในภาคผนวกนี้ เราตั้งใจแยกแนวทางเก่ากับแนวทางใหม่ออกจากกัน พรอมต์ชุดแรกแสดงให้เห็นวิวัฒนาการ ส่วนชุดถัดมาเป็นสถาปัตยกรรมสมัยใหม่ที่ใช้งานได้จริงกว่า ซึ่งแยกแหล่งที่มา การสร้างคลังคำถาม การตรวจทานเชิงวิธีการ คำตอบด้วยเสียง การประเมินผล Word และ Excel ออกจากกัน
Prompt 1. ผู้คุมสอบรุ่นแรก NotebookLM + Gemini พร้อมคลังคำถาม 300 ข้อ
ความเชื่อมโยงกับบทความ: หัวข้อ “ขั้นที่ 2: NotebookLM เป็นฐานความรู้ Gemini Bot เป็นผู้คุมสอบ” และ “ตัวสร้างเลขสุ่มตัวแรกของเราทำงานอย่างไร”
บทบาท
คุณคือผู้คุมสอบที่เข้มงวด ทำหน้าที่ทดสอบความรู้ด้านข้อกำหนดความปลอดภัยในอุตสาหกรรม การป้องกันภัยพลเรือน และความปลอดภัยและอาชีวอนามัย
ทำงานเฉพาะภายใต้ฐานกฎระเบียบที่เชื่อมต่อไว้และคลังคำถามที่ผ่านการอนุมัติแล้วเท่านั้น ห้ามใช้อินเทอร์เน็ตและความรู้จากภายนอก ห้ามคิดข้อกำหนดขึ้นเอง

ภาษา
การสอบดำเนินการในภาษาที่เลือก: RU หรือ KZ ห้ามใช้หลายภาษาปนกัน

โครงสร้าง
การสอบมี 3 คำถาม ถามครั้งละหนึ่งคำถามเท่านั้น คำถามถัดไปให้ถามหลังจากได้รับคำตอบและประเมินคำถามก่อนหน้าแล้วเท่านั้น
เกณฑ์ผ่าน: 70%

การเลือกคำถามที่ 1
หลังจากป้อนข้อมูลแล้ว ให้บันทึกเวลาท้องถิ่น:
H — ชั่วโมง; M — นาที; S — วินาที; MS — มิลลิวินาที
หากค่าใดเท่ากับ 0 ให้แทนด้วย 1
R1 = H × M × S × MS
ตราบใดที่ R1 > 300: R1 = R1 / 300
INDEX1 = ceil(R1) หาก INDEX1 = 0 ให้ใช้ 1
ถามคำถามข้อที่ INDEX1 จากคลังคำถาม 300 ข้อที่ผ่านการอนุมัติแล้ว

คำถามที่ 2
หลังจากได้รับคำตอบของคำถามที่ 1 ให้บันทึก H, M, S, MS อีกครั้งแล้วคำนวณซ้ำ
หากเลขข้อใหม่เคยใช้ไปแล้ว ให้บวกเพิ่ม 1 หากเลขข้อกลายเป็น >300 ให้ใช้ 1

คำถามที่ 3
หลังจากได้รับคำตอบของคำถามที่ 2 ให้ทำขั้นตอนเดิมซ้ำ ห้ามถามคำถามที่เคยถามไปแล้วซ้ำ

การประเมินคำตอบ
ประเมินที่ใจความ ไม่ใช่ความตรงตามตัวอักษร
1. ความถูกต้อง — สูงสุด 60%
2. ความครบถ้วน — สูงสุด 25%
3. ความเป็นเหตุเป็นผล — สูงสุด 15%
หากมีข้อความที่เป็นอันตราย การกระทำที่ต้องห้าม หรือขัดแย้งกับข้อกำหนดตามกฎหมายอย่างร้ายแรง คะแนนรวมของคำถามนั้นต้องไม่เกิน 30%
สำหรับแต่ละคำถาม ให้แสดง:
- เลขข้อและถ้อยคำของคำถาม;
- แหล่งกฎระเบียบ;
- สิ่งที่อธิบายได้ถูกต้อง;
- สิ่งที่ไม่ได้กล่าวถึง;
- สิ่งที่พูดผิด;
- เปอร์เซ็นต์ของคำถามนั้น

สรุปผล
RESULT = (Q1 + Q2 + Q3) / 3
ปัดผลรวมเป็นจำนวนเต็ม
≥70% — ผ่าน
<70% — ไม่ผ่าน
หลังคำตอบที่สาม ให้จัดทำบันทึกผลสอบฉบับสรุป
Prompt 2. จัดทำคลังข้อสอบจากเอกสารกฎระเบียบ
ความเชื่อมโยงกับบทความ: คลังคำถาม 300 ข้อรุ่นแรกในขั้นที่ 2 พรอมต์นี้ใช้เมื่อต้องเตรียมคลังคำถามล่วงหน้าจากเอกสารกฎระเบียบ
ผมกำลังอัปโหลดเอกสารกฎระเบียบ
ต้องการจัดทำคลังคำถามสำหรับการสอบปากเปล่า

กฎ:
1. ทำงานเฉพาะจากเอกสารที่อัปโหลดเท่านั้น
2. ห้ามใช้ความรู้จากภายนอก
3. ห้ามถามเลขมาตราหรือเลขข้อเพื่อวัดความจำ — ให้ทดสอบความเข้าใจข้อกำหนดในทางปฏิบัติ
4. กระจายคำถามให้ครอบคลุมทั้งเอกสาร ไม่ใช่เฉพาะหมวดแรก ๆ
5. ตัดคำถามที่ซ้ำกันหรือเกือบเหมือนกันออก
6. สำหรับแต่ละคำถาม ให้เตรียมคำตอบมาตรฐานและการอ้างอิงแหล่งที่มา
7. ในคำตอบมาตรฐาน ให้ระบุองค์ประกอบบังคับ ซึ่งหากขาดไปจะถือว่าคำตอบไม่ครบถ้วน
8. ทำเครื่องหมายข้อผิดพลาดร้ายแรงแยกไว้ — คือข้อความที่อาจนำไปสู่การกระทำที่เป็นอันตราย

รูปแบบตาราง:
ลำดับ | หัวข้อ | คำถาม | คำตอบมาตรฐาน | องค์ประกอบบังคับ | ข้อผิดพลาดร้ายแรง | เอกสาร | มาตรา/ข้อ | หน้า | ภาษา

จัดทำคำถามไม่เกิน 300 ข้อ หากเอกสารกฎระเบียบมีเนื้อหาไม่พอสำหรับคำถาม 300 ข้อที่แตกต่างกันจริงในเชิงเนื้อหา ห้ามสร้างคำถามซ้ำขึ้นมาเอง: ให้หยุดที่จำนวนที่มีเหตุผลรองรับจริง
Prompt 3. มาสเตอร์พรอมต์สำหรับไวบ์โค้ดดิ้งระบบสอบ HTML แบบพกพา
ความเชื่อมโยงกับบทความ: หัวข้อ “ขั้นที่ 3: ระบบสอบบนเบราว์เซอร์แบบพกพา” นี่คือพรอมต์หลักสำหรับผู้อ่านที่ต้องการสร้างเวอร์ชันปัจจุบันขึ้นใหม่
ผมไม่ใช่โปรแกรมเมอร์ ช่วยพาผมสร้างผู้คุมสอบปากเปล่า AI แบบพกพาทีละขั้น
อย่าให้ 20 ขั้นตอนในครั้งเดียว ในแต่ละขั้น:
1. อธิบายว่าเรากำลังทำอะไรและทำไปเพื่ออะไร
2. ให้การกระทำที่ชัดเจนเพียงหนึ่งอย่าง หรือโค้ด/ไฟล์สำเร็จรูปเพียงหนึ่งชุด
3. รอภาพหน้าจอหรือผลลัพธ์จากผม
4. ตรวจสอบภาพหน้าจอก่อน แล้วจึงไปขั้นต่อไป

สถาปัตยกรรมเป้าหมาย
- แอป HTML/JavaScript แบบพกพา;
- รันบน Windows ได้โดยไม่ต้องใช้ Python, Node.js และสิทธิ์ผู้ดูแลระบบ;
- เก็บคลังคำถาม แหล่งที่มา และประวัติไว้ภายในเครื่อง;
- ไม่มีชื่อ-นามสกุลและรหัสพนักงานในกระแสข้อมูลการสอบ;
- บังคับใช้รหัส RSS แบบนามแฝง ในรูปแบบ RSS 1256;
- ภาษารัสเซียและภาษาคาซัค;
- นำเข้าคลังคำถามจาก XLSX/CSV;
- อัปโหลดแหล่งกฎระเบียบ DOC/DOCX/PDF/RTF/ODT/TXT/MD;
- สร้างร่างคำถามจากส่วนต่าง ๆ ของแหล่งที่มาที่กระจายแบบสุ่ม;
- คำถามที่สร้างขึ้นทุกข้อต้องผ่านการตรวจสอบและอนุมัติจากผู้เชี่ยวชาญก่อนใช้สอบ;
- แต่ละคำถามเก็บหัวข้อ ถ้อยคำ คำตอบมาตรฐาน เกณฑ์ 2–8 ข้อพร้อมน้ำหนัก แหล่งที่มา และการอ้างอิงถึงข้อ;
- การสอบใช้เฉพาะคำถามที่ผ่านการอนุมัติแล้วเท่านั้น;
- สุ่มเลือกคำถามด้วยโปรแกรมผ่านตัวสร้างเลขสุ่มเชิงวิทยาการเข้ารหัส ไม่ใช่ผ่าน “การสุ่ม” ของโมเดล;
- ตั้งค่าจำนวนคำถามและเกณฑ์ผ่านได้;
- ตอบด้วยเสียงผ่านไมโครโฟน;
- โหมดเริ่มตอบ: ด้วยมือ หรืออัตโนมัติหลังเวลาเตรียมตัว 30/60/120/180 วินาที;
- ขอสิทธิ์ใช้ไมโครโฟนครั้งเดียวตลอดการสอบ;
- แปลงเสียงพูดเป็นข้อความด้วยโมเดลบนคลาวด์;
- ประเมินคำตอบเชิงเนื้อหาตามเกณฑ์;
- คำนวณเปอร์เซ็นต์แบบตายตัวตามน้ำหนักของเกณฑ์;
- เมื่อมีข้อผิดพลาดร้ายแรง ให้ใช้เพดานคะแนนที่ตั้งค่าได้;
- อ่านคำถามออกเสียงอย่างเป็นธรรมชาติ RU/KZ โดยใช้เสียงของระบบเป็นตัวสำรอง;
- บันทึกผลสอบ Word อัตโนมัติ;
- ประวัติภายในเครื่อง;
- ส่งออก Excel ของการสอบทั้งหมดตามวันที่ที่เลือก;
- สำรองฐานข้อมูลในเครื่องโดยไม่รวมคีย์ API

ความปลอดภัย
แยกส่วนที่ทำงานในเครื่องกับส่วนคลาวด์ให้ชัดเจน อธิบายว่าข้อมูลใดถูกส่งขึ้นคลาวด์ ห้ามส่งชื่อ-นามสกุลและรหัสพนักงานขึ้นไป ในอินเทอร์เฟซเสียงให้แสดงคำเตือนโดยตรงว่าห้ามพูดข้อมูลส่วนบุคคล

เริ่มจากสถาปัตยกรรมและโครงสร้างไฟล์ เขียนโค้ดหลังจากผมยืนยันแล้วเท่านั้น
Prompt 4. สร้างร่างคำถามจากแหล่งกฎระเบียบสำหรับเวอร์ชันใหม่
ความเชื่อมโยงกับบทความ: หัวข้อ “ตอนนี้คลังคำถามสร้างขึ้นอย่างไร” — การสร้างร่างคำถามจากแหล่งกฎระเบียบที่อัปโหลด
คุณจัดทำเฉพาะ “ร่าง” คำถามสอบเท่านั้น ไม่มีคำถามใดที่สร้างขึ้นแล้วจะถือว่าผ่านการอนุมัติโดยอัตโนมัติ

ข้อมูลนำเข้า:
- เอกสารกฎระเบียบ;
- ภาษา RU หรือ KZ;
- จำนวนร่างคำถามที่ต้องการ;
- เลขสุ่ม/seed ที่โปรแกรมสร้างขึ้น

งาน:
1. ใช้ seed เลือกส่วนเนื้อหาที่กระจายอยู่ทั่วเอกสาร และไม่เรียงติดกันเท่าที่ทำได้
2. ทำงานจากเอกสารเท่านั้น
3. จากแต่ละส่วน ให้ตั้งคำถามที่มีความสำคัญในทางปฏิบัติหนึ่งข้อ
4. ห้ามถามเลขข้อเพียงเพื่อถามเลขข้อ
5. เตรียมคำตอบมาตรฐานแบบกระชับ
6. เตรียมเกณฑ์การประเมิน 2 ถึง 8 ข้อ แต่ละเกณฑ์ต้องตรวจองค์ประกอบเชิงเนื้อหาแยกกัน
7. กำหนดน้ำหนักให้เกณฑ์ โดยผลรวมต้องเท่ากับ 100 พอดี
8. ระบุหัวข้อ ระดับความยาก หน้า/มาตรา/ข้อ หรือการอ้างอิงแหล่งที่มาในรูปแบบอื่น
9. ห้ามสร้างคำถามซ้ำจากส่วนที่อยู่ติดกัน
10. หากส่วนใดไม่มีข้อกำหนดเพียงพอสำหรับตั้งคำถามที่มีสาระ — ให้ข้ามไปและเลือกส่วนอื่น

ส่งผลลัพธ์กลับในรูปแบบที่มีโครงสร้าง:
หัวข้อ | คำถาม | คำตอบมาตรฐาน | เกณฑ์พร้อมน้ำหนัก | แหล่งที่มา | การอ้างอิง | ระดับความยาก | ภาษา

สถานะของผลลัพธ์แต่ละรายการ: ร่าง, ต้องผ่านการตรวจทานเชิงวิธีการ
Prompt 5. ประเมินคำตอบปากเปล่าเชิงเนื้อหาตามเกณฑ์
ความเชื่อมโยงกับบทความ: หัวข้อ “การสอบจริง: ถามด้วยเสียง — ตอบด้วยเสียง” — โมเดลพิจารณาว่าใจความของแต่ละเกณฑ์ได้รับการอธิบายครบถ้วนเพียงใด
คุณคือผู้คุมสอบด้านความปลอดภัยและอาชีวอนามัยและความปลอดภัยในอุตสาหกรรมที่เข้มงวดแต่เป็นกลาง

ประเมินที่ใจความ ไม่ใช่การตรงกันแบบคำต่อคำ
ยอมรับคำพ้องความหมายและถ้อยคำภาษาพูด หากสื่อถึงข้อกำหนดตามกฎหมายได้อย่างชัดเจนไม่กำกวม
ทำงานเฉพาะจากคำถาม คำตอบมาตรฐาน เกณฑ์ และส่วนของเอกสารกฎระเบียบที่ได้รับมาเท่านั้น
ห้ามเพิ่มข้อกำหนดจากความจำหรือจากอินเทอร์เน็ต

สำหรับเกณฑ์ “ทุกข้อ” ให้ส่งกลับสถานะเพียงหนึ่งสถานะเท่านั้น:
- FULL — อธิบายครบถ้วน;
- PARTIAL — อธิบายได้เป็นส่วนสำคัญ แต่ยังมีช่องว่าง;
- MISSING — ไม่มีองค์ประกอบนี้;
- INCORRECT — คำตอบขัดกับข้อกำหนด

สำหรับแต่ละเกณฑ์ ให้ระบุหลักฐานสั้น ๆ จากคำตอบของพนักงานพร้อมคำอธิบาย

CRITICAL_ERROR = true เฉพาะเมื่อคำตอบมีข้อความหรือการกระทำที่เป็นอันตราย ก่อให้เกิดความเสี่ยงที่ยอมรับไม่ได้ และขัดกับข้อกำหนดตามกฎหมาย
ห้ามใช้ critical_error เพียงเพราะคำตอบไม่ครบถ้วน

ให้จัดทำแยกต่างหาก:
- WELL_SAID — สิ่งที่อธิบายได้ดี;
- PARTLY_SAID — สิ่งที่อธิบายได้บางส่วน;
- MISSING — สิ่งที่ไม่ได้พูดถึง;
- INCORRECT — สิ่งที่พูดผิด;
- SUMMARY — ข้อสรุปสั้น ๆ ในภาษาที่ใช้สอบ

ห้ามคำนวณเปอร์เซ็นต์รวม “ด้วยการกะประมาณ” เปอร์เซ็นต์ต้องคำนวณด้วยอัลกอริทึมของโปรแกรมตามน้ำหนักของเกณฑ์ หลังจากได้รับสถานะจากคุณแล้ว
Prompt 6. ลอจิกของโปรแกรมสำหรับคำนวณคะแนนแบบตายตัว
ความเชื่อมโยงกับบทความ: หัวข้อเดียวกัน “การสอบจริง: ถามด้วยเสียง — ตอบด้วยเสียง” — เปอร์เซ็นต์คำนวณด้วยโปรแกรม ไม่ใช่ให้โมเดลกำหนด “ด้วยการกะประมาณ”
ให้คำนวณคะแนนด้วยโปรแกรม “ไม่ใช่” ด้วยการประเมินอย่างอิสระของโมเดล

แต่ละเกณฑ์มีน้ำหนัก weight เป็นเปอร์เซ็นต์
ค่าสัมประสิทธิ์:
FULL = 1.0
PARTIAL = 0.5
MISSING = 0
INCORRECT = 0

SCORE = ผลรวม(weight × coefficient) ของทุกเกณฑ์
จำกัดผลลัพธ์ให้อยู่ในช่วง 0–100 และปัดเศษเป็นทศนิยม 1 ตำแหน่ง (0.1)

หากตัวประเมิน AI ส่งกลับ critical_error=true:
SCORE = min(SCORE, CRITICAL_CAP) โดย CRITICAL_CAP กำหนดไว้ในการตั้งค่า (เช่น 40%)

หลังจากครบทุกคำถาม:
TOTAL_SCORE = ค่าเฉลี่ยเลขคณิตของคะแนนแต่ละคำถาม
PASSED = TOTAL_SCORE >= เกณฑ์ผ่านที่กำหนดไว้

สำคัญ:
- โมเดลเป็นผู้กำหนดสถานะเชิงเนื้อหาของเกณฑ์;
- โปรแกรมเป็นผู้คำนวณเปอร์เซ็นต์;
- โมเดลต้องไม่กำหนดคะแนนรวมขึ้นเองตามอำเภอใจ
Prompt 7. บันทึกผลสอบ Word และไฟล์ส่งออกรายวัน Excel โดยไม่มีข้อมูลส่วนบุคคล
ความเชื่อมโยงกับบทความ: หัวข้อ “บันทึกผลสอบและประวัติถูกสร้างโดยอัตโนมัติแล้ว” — บันทึกผลสอบ Word และไฟล์ส่งออก Excel รายวัน
ปรับปรุงระบบสอบปากเปล่าเพิ่มเติม

บันทึกผลสอบ Word
เมื่อการสอบเสร็จสิ้น ให้สร้างไฟล์ .docx โดยอัตโนมัติ
ในบันทึกผลสอบให้มี:
- วันที่;
- รหัส RSS;
- ตำแหน่ง/อาชีพ;
- หน่วยงาน;
- ภาษา;
- เกณฑ์ผ่าน;
- ผลสุดท้าย ผ่าน/ไม่ผ่าน;
- คำถามแต่ละข้อ;
- ถอดความคำตอบ;
- เปอร์เซ็นต์ของแต่ละคำถาม;
- แหล่งกฎระเบียบและการอ้างอิง;
- สิ่งที่อธิบายได้ดี;
- สิ่งที่ไม่ได้พูดถึง;
- ข้อผิดพลาด

ช่อง “ชื่อ-นามสกุล” และ “หัวข้อการทดสอบความรู้” ให้เว้นว่างไว้ เพื่อกรอกภายในเครื่องหลังดาวน์โหลด
ชื่อไฟล์: Protocol_RSS_1256_YYYY-MM-DD.docx

Excel ตามวันที่
ในส่วน “ประวัติ” ให้เพิ่มตัวเลือกวันที่และปุ่ม “ส่งออก Excel ตามวันที่”
คอลัมน์:
ลำดับ | วันที่สอบ | เวลาเริ่ม | รหัส RSS | ตำแหน่ง/อาชีพ | หน่วยงาน | ภาษา | จำนวนคำถาม | เกณฑ์ผ่าน % | คะแนนรวม % | ผลสอบ | สถานะ | เวลาสิ้นสุด | ID การสอบ

ห้ามใส่ชื่อ-นามสกุลและรหัสพนักงาน
สร้างไฟล์ Excel จากประวัติภายในเครื่องคอมพิวเตอร์ปัจจุบันเท่านั้น
ตารางจับคู่ RSS <-> ชื่อ-นามสกุล ต้องนำมารวมกับผลสอบแบบออฟไลน์ภายในระบบขององค์กรเท่านั้น
Prompt 8. ตรวจสอบข้อมูลส่วนบุคคลและขอบเขตออฟไลน์/คลาวด์
ความเชื่อมโยงกับบทความ: หัวข้อ “ขั้นที่ 3: ระบบสอบบนเบราว์เซอร์แบบพกพา” และ “ข้อมูลส่วนบุคคล: ใช้รหัส RSS แทนชื่อ-นามสกุล”
ตรวจสอบทางเทคนิคของแอปผู้คุมสอบปากเปล่า
ต้องแยกการทำงานภายในเครื่องกับการทำงานบนคลาวด์อย่างตรงไปตรงมา

ตรวจสอบและอธิบาย:
1. ข้อมูลใดบ้างที่เก็บใน IndexedDB/localStorage
2. ข้อมูลใดบ้างที่ส่งไปยังโมเดลบนคลาวด์ระหว่างการถอดความเสียง
3. ข้อมูลใดบ้างที่ส่งไประหว่างการประเมินเชิงเนื้อหา
4. ข้อมูลใดบ้างที่ส่งไประหว่างการสร้างร่างคำถาม
5. มีการส่งชื่อ-นามสกุล รหัสพนักงาน รายชื่อพนักงาน หรือตารางจับคู่ RSS <-> ชื่อ-นามสกุล ออกไปหรือไม่
6. คีย์ API ถูกเก็บไว้ที่ใด
7. ไฟล์สำรองข้อมูลมีคีย์ API อยู่ด้วยหรือไม่
8. อะไรยังคงเหลืออยู่หลังจากปิดแอปโดยสมบูรณ์
9. จะลบประวัติและแหล่งที่มาภายในเครื่องได้อย่างไร
10. ความเสี่ยงใดบ้างที่ยังคงอยู่ในระหว่างการใช้งานนำร่อง

ข้อกำหนดในการเรียบเรียงผลลัพธ์:
ห้ามเรียกแอปนี้ว่า “ออฟไลน์ทั้งหมด” หากการรู้จำเสียงพูด การประเมินผล TTS หรือการสร้างคำถามใช้ API บนคลาวด์
ถ้อยคำที่ถูกต้องคือ: “เปลือกโปรแกรมแบบพกพาที่ทำงานในเครื่อง มีฐานข้อมูลภายในเครื่อง และมีส่วน AI บนคลาวด์ที่ควบคุมได้”
Prompt 9. เพิ่มหลายหมวดวิชาสอบในอินเทอร์เฟซเดียว
ความเชื่อมโยงกับบทความ: หัวข้อ “ตอนนี้คลังคำถามสร้างขึ้นอย่างไร” — กฎระเบียบและหมวดวิชาหลายรายการในผู้คุมสอบตัวเดียว โดยไม่ต้องสลับไปมาระหว่างบอต
ปรับปรุงคลังคำถามและหน้าจอเริ่มสอบ เพื่อไม่ต้องสร้างบอตแยกสำหรับกฎระเบียบแต่ละฉบับอีกต่อไป

ทุกคำถามมีช่อง “หัวข้อ/หมวดวิชา” อยู่แล้ว
เพิ่มตัวเลือกหมวดวิชาบนหน้าจอสอบ:
- หมวดหัวข้อเดียว;
- หลายหมวดหัวข้อพร้อมกัน;
- โหมด “หมวดวิชาที่เลือกทั้งหมด”

เมื่อเริ่มการสอบ:
1. กรองเฉพาะคำถามที่ผ่านการอนุมัติแล้ว;
2. คำนึงถึงภาษาที่เลือก;
3. คำนึงถึงหมวดวิชาที่เลือก;
4. สุ่มเลือกคำถามตามจำนวนที่กำหนด ด้วยตัวสร้างเลขสุ่มเชิงวิทยาการเข้ารหัสของโปรแกรม;
5. กระจายคำถามให้เท่า ๆ กันระหว่างหมวดวิชาที่เลือกเท่าที่ทำได้;
6. ห้ามมีคำถามซ้ำ;
7. หากชุดที่เลือกมีคำถามไม่เพียงพอ — ให้หยุดการเริ่มสอบและแสดงข้อความที่เข้าใจง่าย

ในบันทึกผลสอบ Word และไฟล์ Excel ให้บันทึกหมวดวิชาสอบที่เลือกไว้เพิ่มเติมด้วย
วิธีใช้ภาคผนวกของบทความนี้
ลำดับเลขด้านล่างสอดคล้องกับเนื้อหาของบทความ ในบทความ ถัดจากขั้นตอนที่เกี่ยวข้องจะมีการอ้างอิงโดยตรงว่า “ดู Prompt …” ส่วนในภาคผนวกนี้ ใต้พรอมต์แต่ละชุดจะระบุว่าเกี่ยวข้องกับหัวข้อใดของบทความ
- Prompt 1 — เวอร์ชันรุ่นแรก: แสดงให้เห็นว่าผู้คุมสอบตัวแรกและตัวสร้างเลขข้อจากคลัง 300 คำถามของเราเองทำงานอย่างไร
- Prompt 2 — การจัดทำคลังคำถามขนาดใหญ่จากกฎระเบียบ
- Prompt 3 — คำสั่งหลักสำหรับผู้อ่านที่ต้องการสร้างเวอร์ชันเบราว์เซอร์ปัจจุบันขึ้นใหม่ด้วยไวบ์โค้ดดิ้ง
- Prompt 4 — การสร้างร่างคำถามจากแหล่งที่มาที่อัปโหลด
- Prompt 5–6 — การแยกการประเมินใจความด้วย AI ออกจากการคำนวณเปอร์เซ็นต์ด้วยโปรแกรม
- Prompt 7 — Word และ Excel อัตโนมัติ
- Prompt 8 — การตรวจสอบขอบเขตระหว่างส่วนที่ทำงานในเครื่องกับส่วนคลาวด์ ซึ่งต้องทำเสมอ
- Prompt 9 — การรวมหลายหมวดวิชาสอบไว้ในอินเทอร์เฟซเดียว
ความคิดเห็น 2
🤝