Du fichier Excel anonymisé à l’analyse HSE de pilotage. Étape 2 : créer un tableau de bord HSE interactif et autonome avec le vibe coding
L’IA aide à construire l’enveloppe logicielle sur un modèle Excel anonymisé, tandis que la véritable base de travail est chargée dans le HTML terminé en local, sur l’ordinateur de l’utilisateur.
Introduction
Dans la première publication, j’ai montré comment nous avions résolu la question de la préparation sécurisée des données : nous avons créé un outil de masquage local et appris à obtenir un modèle Excel anonymisé qui conserve la structure de la base de travail sans transmettre de données personnelles réelles à un environnement d’IA externe.
La question suivante se pose presque aussitôt : que faire ensuite de ce modèle ?
Notre objectif n’était pas simplement de construire quelques graphiques. Il nous fallait un véritable outil d’analyse, utilisable lors de la préparation des communications en cascade et des comités de sécurité : modifier la sélection, descendre d’un indicateur général vers l’unité, le secteur et l’enregistrement précis, voir les points de blocage et préparer rapidement les éléments pour l’échange avec les managers.
La condition principale de la première étape restait valable : pendant le développement externe, la base de travail réelle de l’entreprise n’est pas transmise à l’IA.
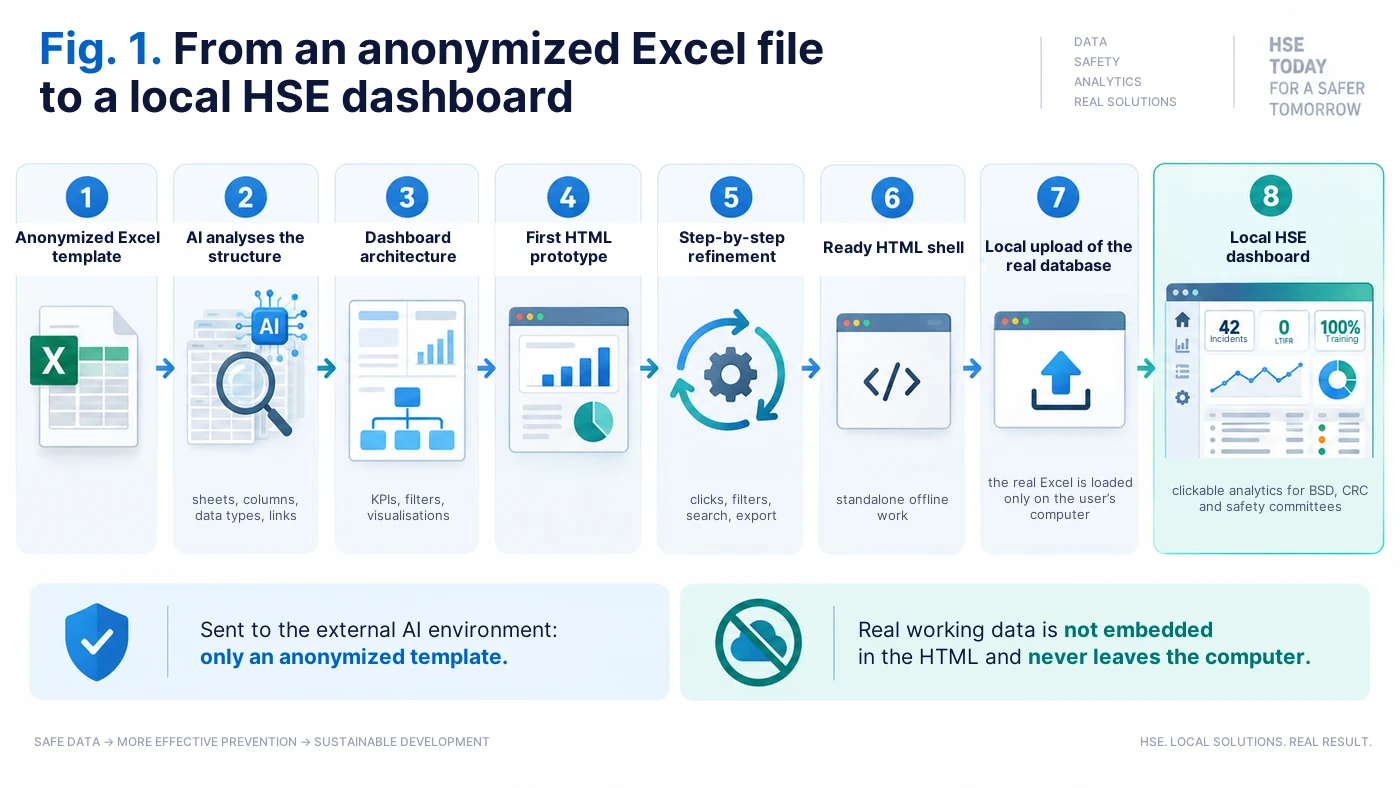
Pourquoi un tableau de bord maison était nécessaire
Nos données sources sont produites sous forme numérique depuis longtemps. Les dialogues comportementaux de sécurité (BSD) et le contrôle des risques critiques (CRC) sont réalisés par les managers et les spécialistes via l’application mobile d’entreprise CoLab. Le problème n’était donc pas l’absence de données, mais l’étape suivante : comment transformer rapidement un vaste ensemble d’enregistrements en analyse de gestion compréhensible.
Le système d’entreprise permet de réaliser une observation, de remplir les champs et de générer un export. En revanche, un développement analytique approfondi exige un travail informatique distinct. Avec un nombre limité de spécialistes, des délais et un budget contraints, de telles demandes peuvent attendre longtemps.
Les premiers tableaux de bord en ligne basés sur Superset couvrent les besoins quantitatifs de base. Pour le travail concret, ce n’est pas suffisant. Quand un manager voit que 500 contrôles ont été réalisés ou 70 écarts relevés, la question suivante est toujours la même : où exactement cela s’est-il produit, pourquoi, et quels enregistrements précis se cachent derrière ?
C’est pourquoi nous considérons le tableau de bord HTML autonome non pas comme un remplacement des systèmes informatiques de l’entreprise, mais comme un outil intermédiaire rapide. Il permet de tester l’analyse en pratique en peu de temps, de comprendre quels indicateurs sont réellement nécessaires et où il faut descendre jusqu’aux données primaires — et seulement ensuite de rédiger un cahier des charges plus précis pour une mise en œuvre industrielle.
Étape 1. Comprendre d’abord les données, et non écrire le programme
L’une des erreurs les plus fréquentes avec l’IA consiste à demander immédiatement : « Fais-moi un tableau de bord. » On obtient vite une jolie image, mais rien ne garantit qu’elle sera utilisable ensuite.
Notre première requête à l’IA a donc été différente. Nous chargions le modèle Excel anonymisé et demandions de ne rien programmer pour l’instant, mais d’analyser la structure du fichier : quelles feuilles, colonnes et types de données il contient, quels champs sont liés entre eux, ce qui peut servir de filtre, quels indicateurs peuvent être calculés et où la structure source peut comporter des erreurs.
Ainsi, l’IA intervient d’abord en analyste de données, et non en programmeur.
Pour les dialogues comportementaux de sécurité, par exemple, comptent la date, l’entreprise, l’atelier, le secteur, l’observateur, le salarié, le type de comportement, le processus, la description et le résultat. À la place d’un vrai nom, l’IA peut voir « Salarié_00001 ». Pour bâtir la logique du tableau de bord, le vrai nom ne lui est pas nécessaire.
Prompt 1 — analyse de la structure de la base anonymisée : voir l’annexe à la fin de l’article.
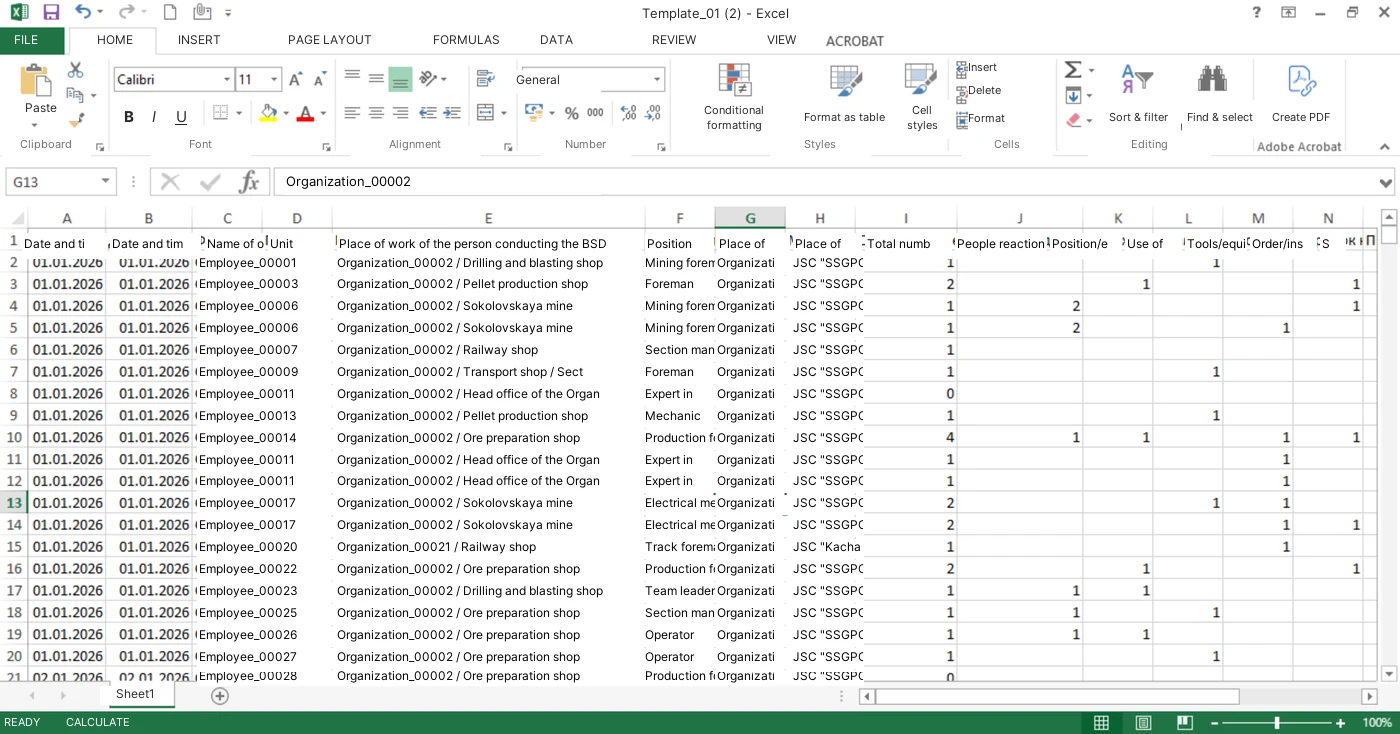
Dialogues comportementaux de sécurité : du chiffre global à l’enregistrement précis
L’étape suivante consiste à définir non pas une série de jolies visualisations, mais les questions de gestion auxquelles le tableau de bord doit répondre.
Pour les dialogues comportementaux, il nous importe de voir la dynamique, la structure des comportements relevés, les unités, les processus, la récurrence des écarts, le travail des observateurs et la possibilité de passer du chiffre global à l’enregistrement précis.
La logique se construit donc de haut en bas : entreprise → atelier → secteur → type de comportement → processus → enregistrement précis. Un clic sur une barre ou un secteur du graphique modifie la sélection et permet de voir exactement les enregistrements qui ont formé l’indicateur.
S’y ajoutent la recherche par salarié ou identifiant anonymisé, l’historique des écarts relevés, le classement des unités et des personnes réalisant les BSD, ainsi que l’export de la sélection courante vers Excel.
J’applique ici une règle simple : si, après avoir regardé un graphique, on ne voit pas quelle décision de gestion il aide à prendre, ce graphique n’a probablement pas sa place dans le tableau de bord.
Prompt 2 et Prompt 5 — structure du tableau de bord HSE et détail interactif : voir l’annexe à la fin de l’article.
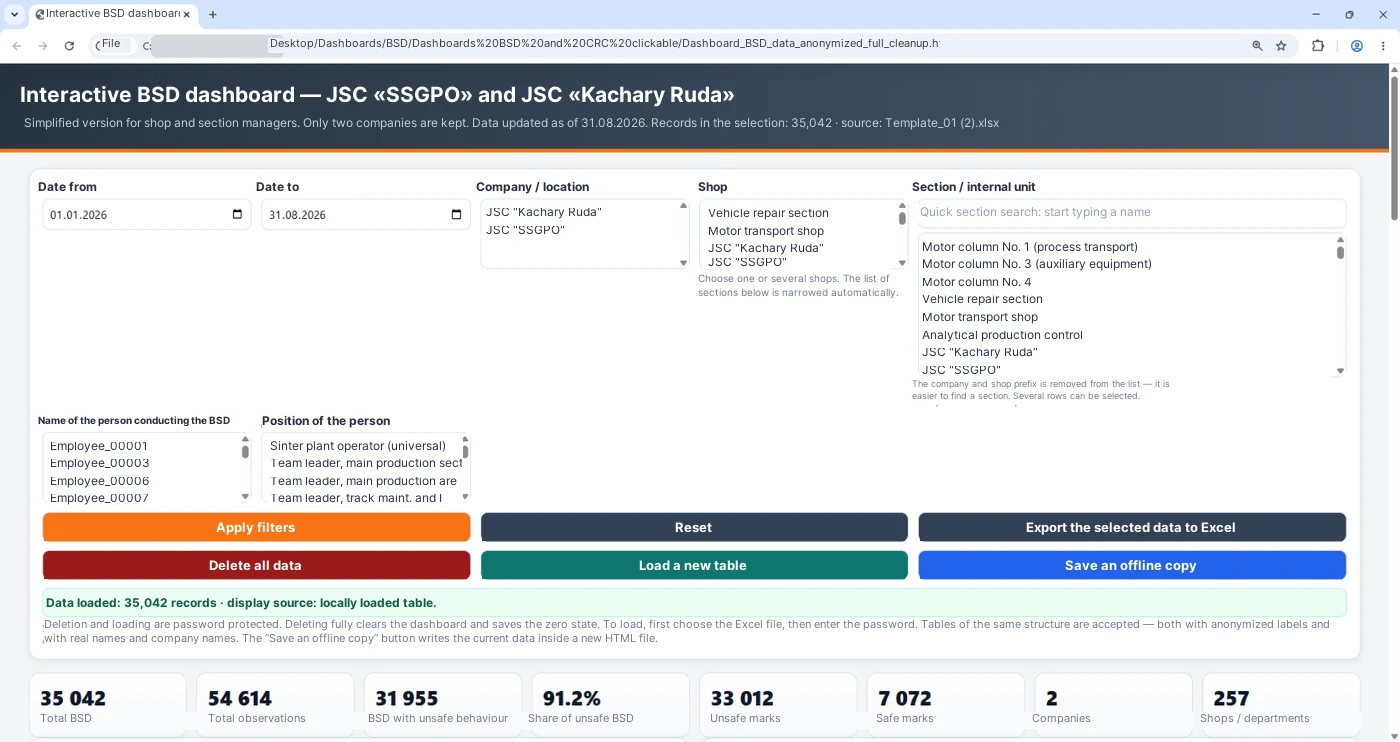
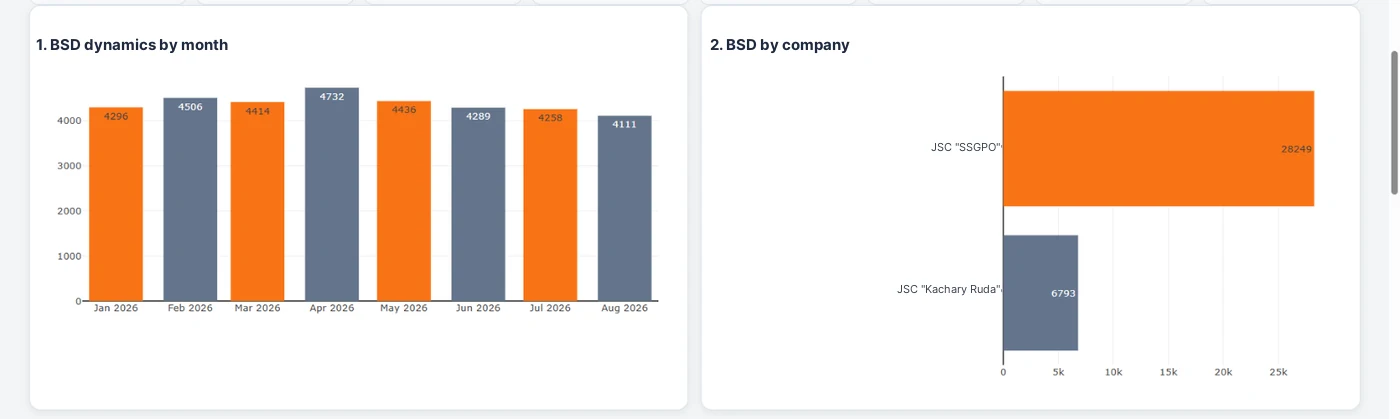
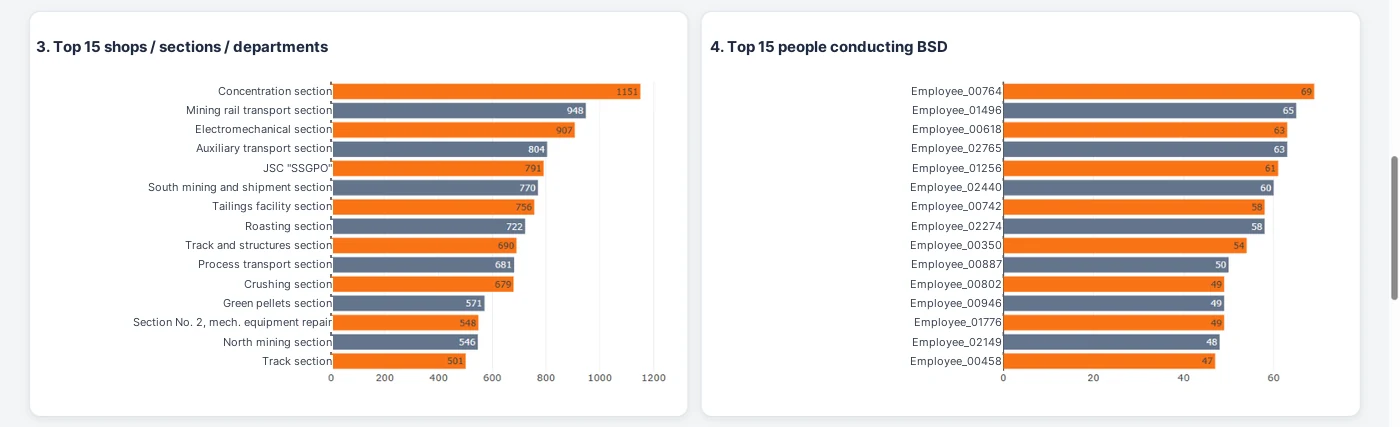
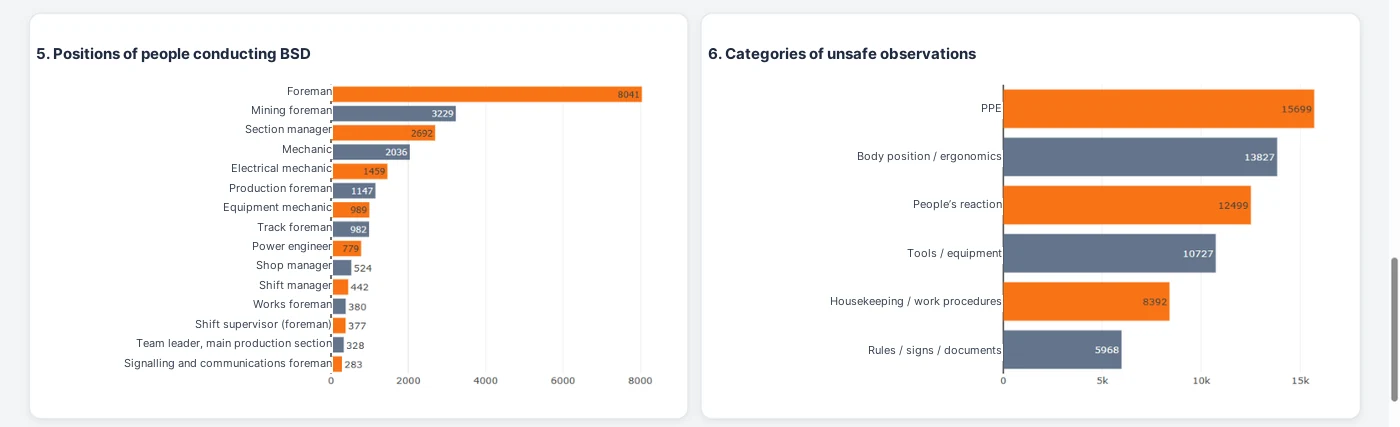
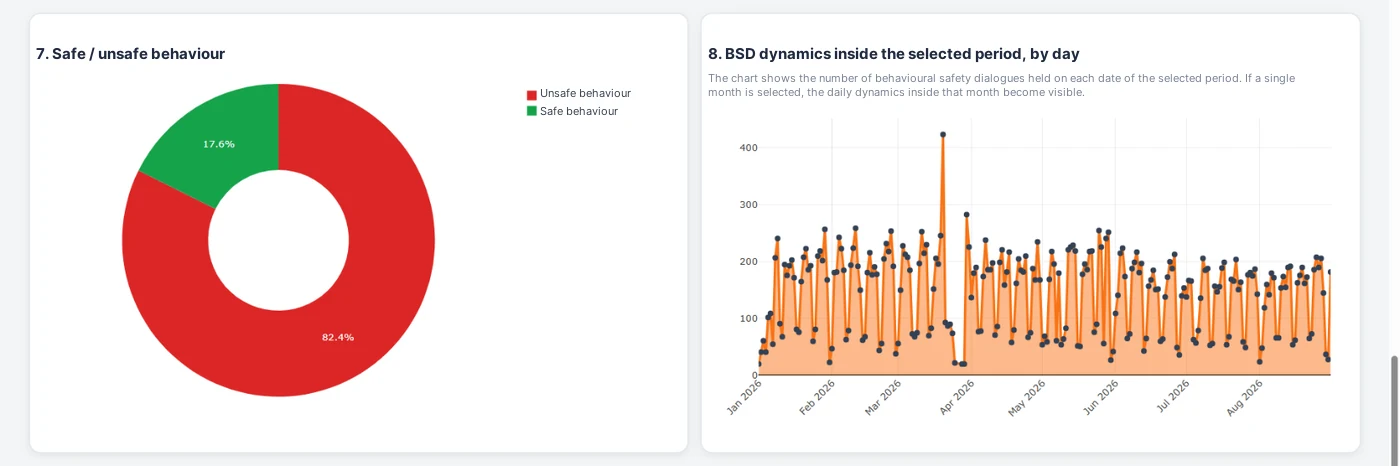
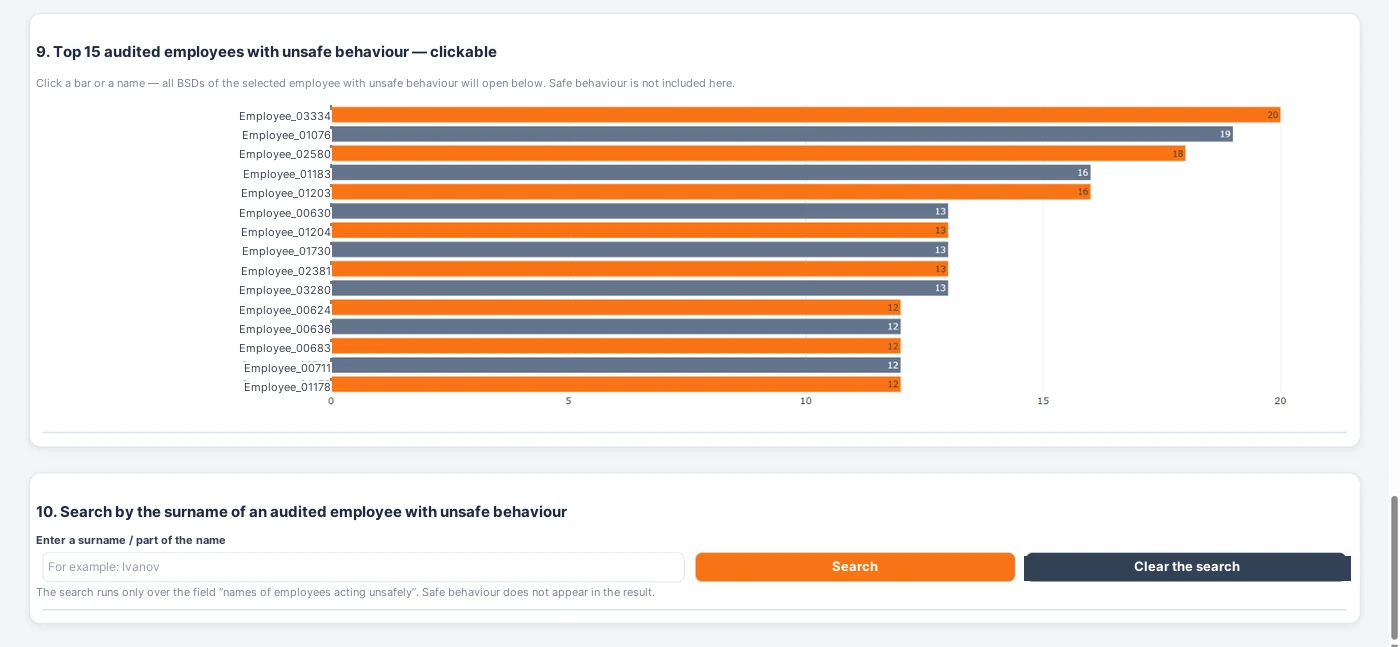
Ajout du relevé d’heures : voir la fréquence recommandée établie des BSD
Nous sommes ensuite allés un cran plus loin. Pour gagner du temps et éviter de créer un outil distinct, le même tableau de bord a été complété par le relevé de présence.
Pour le développement, nous avons d’abord utilisé un modèle anonymisé du relevé d’heures, puis — en local — le relevé réel. Cela a permis de voir non seulement le volume de BSD réalisés, mais aussi le respect de la fréquence recommandée établie.
En substance, nous comparions le nombre de postes réellement travaillés au volume de dialogues de sécurité réellement tenus. On a ainsi vu où la fréquence requise est respectée et où un retard apparaît.
Cette approche est particulièrement utile aux chefs d’atelier et de secteur : le tableau de bord montre non pas le volume global de travail, mais le respect réel de l’exigence, avec descente jusqu’à l’unité, au métier et au salarié précis.
Cette évolution n’a pas demandé de nouveau principe. Nous avons simplement développé la logique existante et raccordé un jeu de données supplémentaire.
Prompt 6 — analyse des BSD en tenant compte des postes réellement travaillés : voir l’annexe à la fin de l’article.
CRC : la même approche, mais pour le contrôle des risques critiques
La même logique s’applique au CRC. L’export source permet de voir combien de CRC ont été réalisés et combien d’entre eux comportaient des écarts. Mais le volume brut ne répond pas à la question essentielle : dans quelle mesure l’exigence est-elle réellement satisfaite à chaque poste ?
Pour cela, les données CRC et le relevé d’heures réel de la même période sont chargés en local dans le tableau de bord. Après rapprochement, on voit qui était effectivement en poste, combien de CRC il devait réaliser et combien il en a réellement réalisés.
En sortie, nous obtenons non seulement le nombre, mais aussi le taux de réalisation, le déficit, la liste des personnes en défaut et — si une base étendue est disponible — le rattachement au secteur, à l’atelier, au processus et aux causes des écarts.
Tous les graphiques restent cliquables : depuis l’indicateur global, on peut descendre plus profond — vers l’unité, puis le secteur, puis le métier et enfin la fiche d’un salarié précis ou d’un enregistrement précis.
Je ne présente pas de captures CRC dans cet article pour ne pas surcharger le propos. Techniquement, le principe est le même que pour les BSD.
Prompt 7 — CRC et relevé d’heures réel : calcul de la réalisation et descente jusqu’au salarié : voir l’annexe à la fin de l’article.
Étape 2. Premier prototype et améliorations successives
Une fois la structure des données et la logique d’analyse claires, on peut passer directement au vibe coding.
La tâche se formule alors de façon assez précise : créer un unique fichier HTML autonome, qui s’ouvre dans un navigateur ordinaire, contient des indicateurs, des filtres, des graphiques interactifs et un tableau des enregistrements sources, et fonctionne sans installer de logiciel supplémentaire.
À ce stade, le programme continue de n’utiliser que des données anonymisées.
La première version n’est presque jamais la version finale. On choisit une entreprise — et la liste des ateliers reste générale. On clique sur un graphique — et il n’y a pas de descente jusqu’à l’enregistrement. On ajoute une fonction — et l’une des visualisations cesse de fonctionner correctement. Cela fait partie du développement.
Au lieu de réécrire toute l’application, la demande est formulée point par point : « Rends les filtres dépendants », « Ajoute le détail au clic », « Corrige uniquement le graphique n° 6, ne change pas le reste de la logique ».
C’est précisément là que le vibe coding est particulièrement utile à un spécialiste qui n’est pas développeur. Il faut expliquer avec précision non pas comment écrire une fonction, mais comment le programme doit se comporter pour l’utilisateur.
Prompt 3, Prompt 5 et Prompt 8 — création du premier HTML, détail et correction des défauts : voir l’annexe à la fin de l’article.
Étape 3. Retirer le modèle et charger les données réelles en local
Une fois l’interface et la logique éprouvées sur le modèle anonymisé, les données de démonstration sont retirées de la version finale. Le HTML reste une enveloppe logicielle.
On y ajoute un bouton de chargement Excel. L’utilisateur ouvre le HTML terminé sur l’ordinateur de l’entreprise, choisit la base de travail à jour, puis le navigateur lit le fichier et calcule les indicateurs au sein de la session locale.
Le schéma final est donc simple : le HTML terminé et le fichier Excel de travail sont sur le même ordinateur ; les données de travail sont chargées dans le programme en local et ne sont plus transmises à l’environnement d’IA externe.
Sur la capture publiée, les vrais noms sont masqués. C’est important : l’article doit montrer le principe de fonctionnement, pas divulguer des données personnelles.
Prompt 4 — chargement local de la base Excel de travail : voir l’annexe à la fin de l’article.
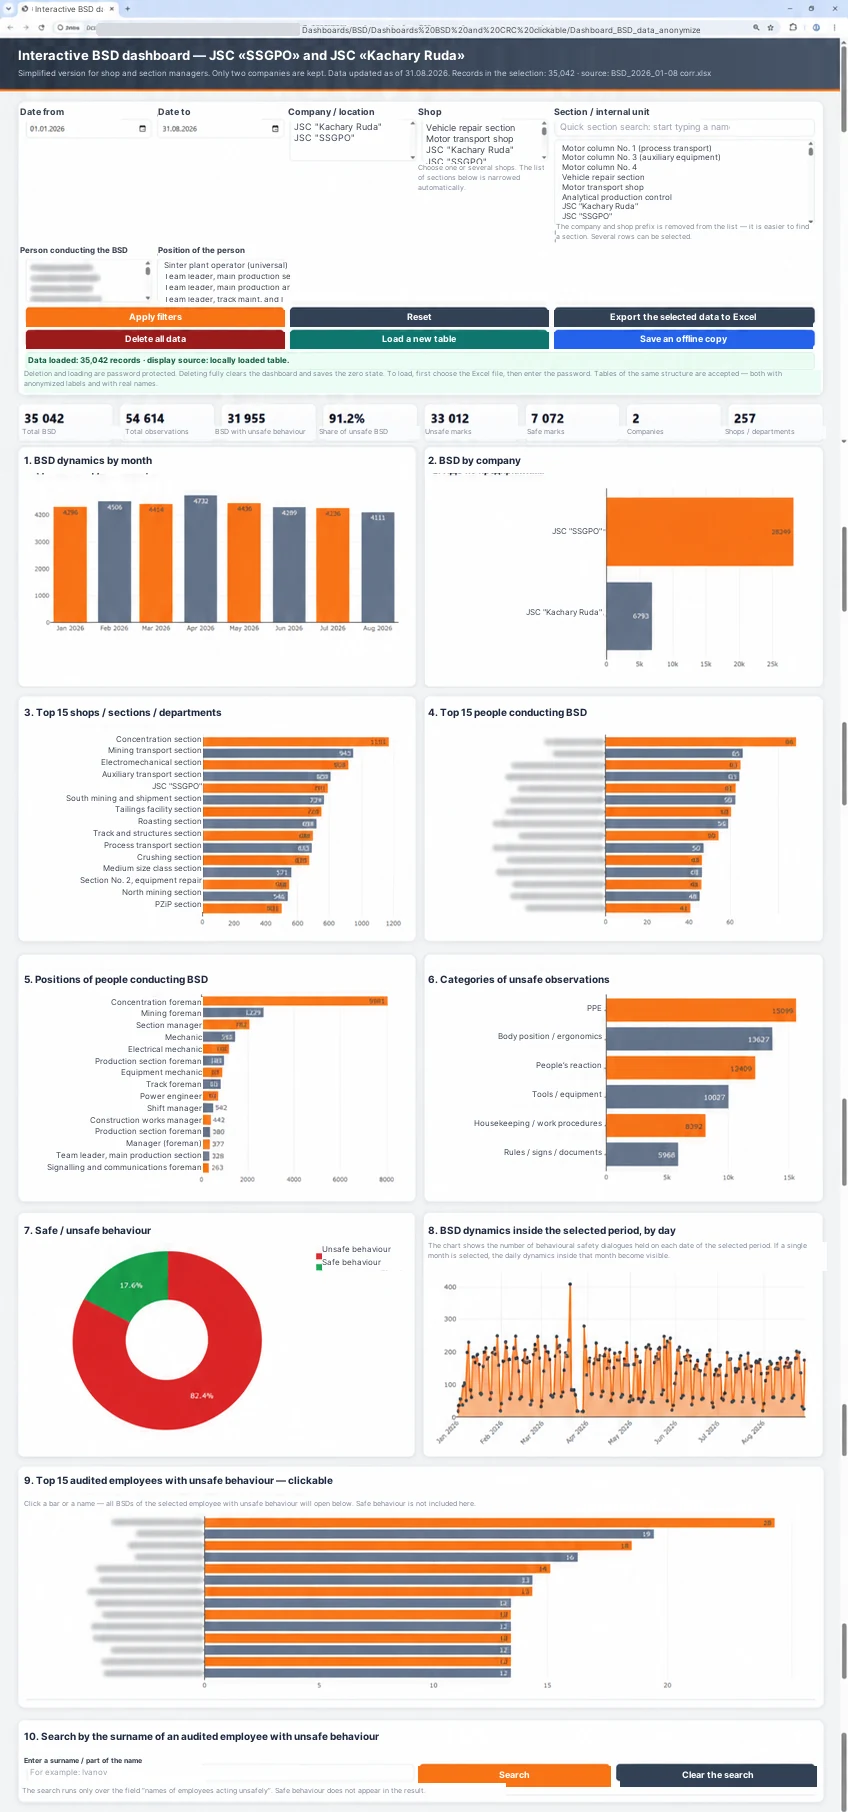
Chargement, ajout, réinitialisation et copie hors ligne
Les fonctions destinées à l’utilisateur ont demandé une attention particulière. En pratique, il est important non seulement d’ouvrir le tableau de bord, mais aussi de gérer rapidement son état.
Des actions distinctes ont donc été ajoutées : charger un nouveau tableau, effacer les données jusqu’à zéro, enregistrer une copie hors ligne et réinitialiser les filtres sans supprimer la base. Ce sont des scénarios différents et ils doivent être clairs pour l’utilisateur au premier coup d’œil.
J’ai également enregistré une courte vidéo de démonstration qui montre comment le tableau de bord fonctionne sur le modèle anonymisé, comment s’effectue une réinitialisation complète et comment les données réelles sont ensuite chargées. Une telle annexe vidéo répond aux questions plus vite que n’importe quelle description écrite.
Annexe vidéo 1. Capture d’écran : du modèle à la base de travail — la vidéo se trouve à la fin de l’article.
De l’analyse à la discussion managériale
La valeur principale du tableau de bord n’apparaît pas à l’écran, mais en réunion.
Les vues obtenues servent à préparer les communications en cascade et les comités de santé et sécurité au travail : du niveau des unités jusqu’au comité central de l’entreprise, qui se tient chaque mois.
Au niveau du secteur, on voit les enregistrements précis et les salariés. Au niveau de l’atelier — les problèmes récurrents. Plus haut — la comparaison des unités et les zones systémiques qui exigent l’attention des dirigeants.
Ce n’est donc plus la simple formule « réalisation : 82 % » qui est présentée au comité, mais un tableau bien plus concret : quels secteurs créent le déficit, à quels postes l’exigence n’est pas respectée, quels types d’écarts se répètent et quels enregistrements doivent être analysés avec le responsable.
Le tableau de bord montre où chercher. La cause et la décision de gestion restent du ressort des personnes.
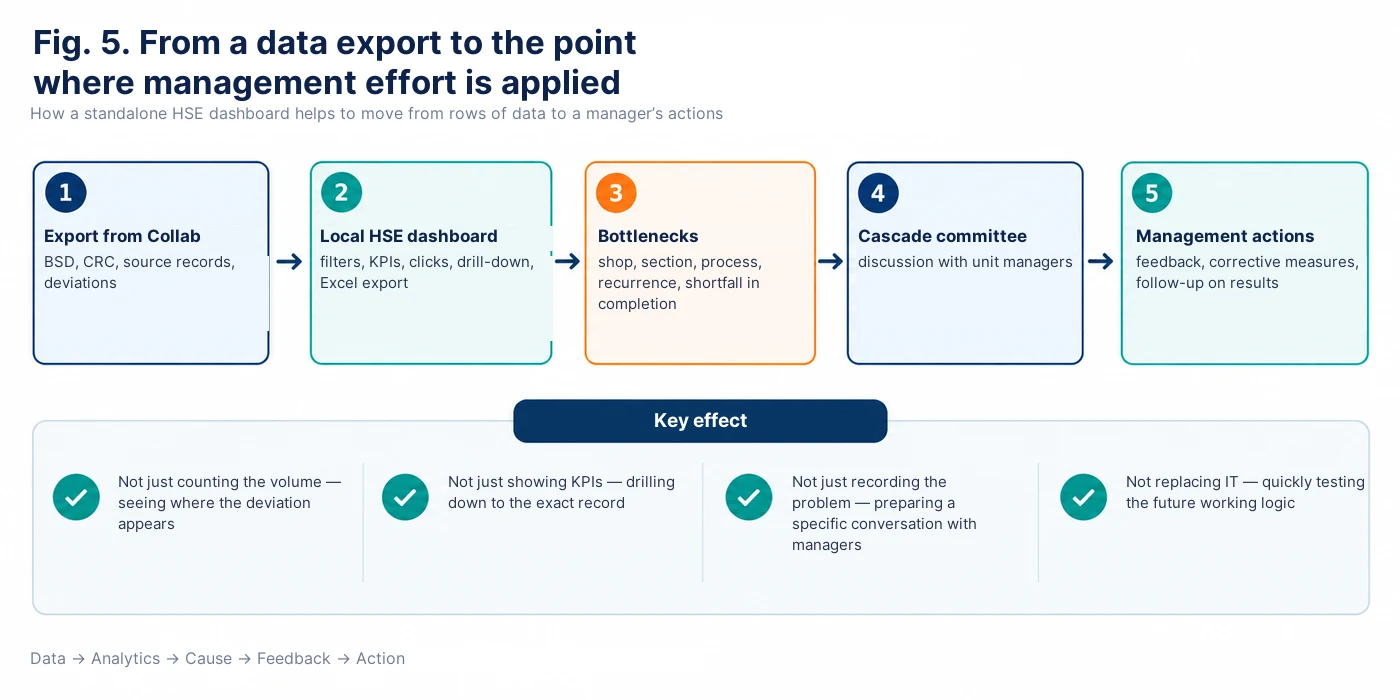
Outil provisoire ou futur système industriel
Pour nous, le tableau de bord HTML autonome n’est pas une finalité et n’entre pas en concurrence avec l’architecture informatique de l’entreprise.
Sa mission est de parcourir rapidement le chemin d’une idée de terrain à un prototype analytique fonctionnel. Pendant que la solution industrielle est développée, les unités peuvent déjà utiliser l’outil pour analyser, et les spécialistes obtiennent un retour concret sur les indicateurs réellement nécessaires.
Si le prototype a prouvé son utilité, sa logique est bien plus facile à transmettre aux développeurs pour une mise en œuvre ultérieure en JavaScript, dans Superset ou dans un autre environnement d’entreprise avec intégration automatique des données.
Autrement dit, le vibe coding ne remplace pas l’informatique. Il lève une partie de l’incertitude avant même le début du grand développement : on sait d’avance quels filtres sont nécessaires, jusqu’où doit fonctionner la descente, quelles données relier et quel résultat de gestion l’utilisateur doit obtenir.
Le résultat obtenu
Au final, le modèle Excel anonymisé devient un pont technique entre la base de travail réelle et l’IA. L’IA voit la structure des données, aide à concevoir la logique et l’interface, écrit et améliore le code. La base réelle n’apparaît dans l’outil qu’une fois le HTML terminé déjà présent sur l’ordinateur de l’utilisateur.
Pour un spécialiste sécurité, cela raccourcit nettement le chemin de l’idée au prototype fonctionnel.
L’avantage principal n’est pas que l’IA sache tracer des graphiques. L’essentiel est de pouvoir transformer beaucoup plus vite une question de terrain en outil d’analyse, de voir le point de blocage et d’orienter l’attention du dirigeant là où une action est réellement nécessaire.
Dans la prochaine publication, je souhaite passer de l’analyse des données à une autre direction : montrer comment l’IA est progressivement devenue, d’un simple assistant, un « second expert » qui évalue la qualité des minutes sécurité et des dialogues comportementaux selon plusieurs critères indépendants.
Prompts prêts à l’emploi pour créer un tableau de bord HSE autonome BSD et CRC
Règle pratique : seul un modèle anonymisé vérifié est transmis à l’environnement d’IA externe. Les fichiers Excel de travail réels, les relevés d’heures et les données personnelles sont raccordés ensuite, en local, dans l’enveloppe HTML terminée.
Comment les prompts se rattachent à l’article
| Section de l’article | Prompt |
|---|---|
| Étape 1. Analyse de la base anonymisée | Prompt 1 |
| Architecture BSD et questions de gestion | Prompt 2 |
| Création du premier HTML autonome | Prompt 3 |
| Suppression du modèle et chargement local de la base réelle | Prompt 4 |
| Cliquabilité, filtres et descente jusqu’à l’enregistrement | Prompt 5 |
| BSD + relevé d’heures : fréquence recommandée établie | Prompt 6 |
| CRC + relevé d’heures : régularité de la réalisation et écarts | Prompt 7 |
| Correction des défauts et vérification de l’autonomie | Prompt 8 |
Prompt 1. Analyse de la structure du fichier Excel anonymisé
Je charge un modèle Excel anonymisé d’une base HSE de travail.

Ne programme rien pour l’instant.

Analyse :
1. les feuilles du fichier ;
2. les en-têtes de colonnes ;
3. les types de données ;
4. les champs obligatoires et facultatifs ;
5. les liens hiérarchiques entre l’entreprise, l’atelier, le secteur et les autres niveaux ;
6. les champs utilisables comme filtres ;
7. les champs utilisables pour les indicateurs, les classements et les visualisations ;
8. les champs pouvant servir d’identifiant anonymisé stable d’un salarié ;
9. les problèmes potentiels de la base source : valeurs vides, orthographes différentes d’une même unité, formats de date hétérogènes, doublons, mélange de texte et de nombres, noms de colonnes ambigus.

Pour la base BSD, détermine séparément où se trouvent :
- la date et l’heure ;
- l’entreprise ;
- l’atelier ;
- le secteur / l’unité interne ;
- la personne réalisant le BSD ;
- le poste de cette personne ;
- le salarié / l’identifiant anonymisé ;
- le type de comportement sûr ou dangereux ;
- le processus / le type de travaux ;
- la description de l’observation ;
- le résultat ou la réaction.

Après l’analyse :
- décris brièvement la structure des données ;
- propose les liens entre champs qu’il faut préserver ;
- énumère les points litigieux à confirmer avec l’utilisateur ;
- ne propose l’architecture du futur tableau de bord qu’après confirmation.

N’essaie pas de reconstituer les valeurs anonymisées et ne tire aucune conclusion sur l’identité d’un salarié précis.
Prompt 2. Architecture du tableau de bord des dialogues comportementaux de sécurité
À partir de la structure confirmée du fichier Excel anonymisé, propose l’architecture d’un tableau de bord HSE autonome consacré aux dialogues comportementaux de sécurité.

Principe directeur : chaque visualisation doit répondre à une question de gestion précise. N’ajoute pas de graphiques pour la décoration.

Prévois :
1. les indicateurs clés sur le volume de BSD et d’observations ;
2. des filtres par période ;
3. une hiérarchie dépendante entreprise → atelier → secteur / unité interne ;
4. un filtre par personne réalisant le BSD ;
5. un filtre par poste de cette personne ;
6. la dynamique des BSD par mois et/ou par jour ;
7. la comparaison des entreprises ;
8. le TOP des unités / secteurs ;
9. le TOP des personnes réalisant les BSD ;
10. la structure des comportements sûrs et dangereux ;
11. les catégories d’observations dangereuses ;
12. l’analyse des processus / types de travaux ;
13. un classement des salariés dont le comportement dangereux a été relevé à plusieurs reprises ;
14. la recherche par salarié ou identifiant anonymisé ;
15. l’historique des BSD du salarié sélectionné ;
16. la possibilité de voir si un même type de comportement dangereux s’est répété chez un salarié à des dates différentes, avec des responsables différents ou dans des secteurs différents ;
17. l’export de la sélection courante vers Excel.

Pour chaque visualisation, indique séparément :
- à quelle question du dirigeant elle répond ;
- quels champs sont utilisés ;
- vers quoi doit mener le clic sur un élément du graphique.

Décris d’abord l’architecture avec des mots. Ne produis pas encore de code.
Prompt 3. Création du premier HTML autonome
À partir de l’architecture validée, crée la première version autonome du tableau de bord HSE interactif.

Exigences :
1. Le résultat est un fichier HTML unique.
2. Le fichier s’ouvre dans un navigateur ordinaire, sans installation de logiciel supplémentaire.
3. Au stade du développement, utilise uniquement des données de démonstration anonymisées.
4. Ajoute les indicateurs validés, les filtres, les classements, la recherche, les graphiques interactifs et un tableau des enregistrements sources.
5. N’utilise pas de backend.
6. N’utilise pas d’API externes.
7. Ne charge pas de bibliothèques depuis un CDN.
8. Toutes les bibliothèques nécessaires doivent se trouver à l’intérieur du HTML.
9. Le tableau de bord doit s’ouvrir et fonctionner pleinement sans connexion Internet.
10. N’ajoute ni télémétrie, ni analyse d’audience, ni requêtes réseau.
11. Organise le code de manière à pouvoir, plus tard, supprimer le jeu de démonstration et raccorder un fichier Excel réel en local.
12. Ne modifie pas sans nécessité les identifiants anonymisés existants des salariés.

Après la création :
- énumère les fonctions réalisées ;
- énumère les limites de la première version ;
- indique quelles fonctions doivent être vérifiées manuellement avant de poursuivre.
Prompt 4. Chargement local de la base de travail, réinitialisation et copie hors ligne
Fais évoluer le tableau de bord HSE autonome existant.

Objectif : une fois le développement terminé, les données de démonstration doivent être supprimées du HTML et la base de travail réelle ne doit être raccordée qu’en local, sur l’ordinateur de l’utilisateur.

Ajoute les fonctions suivantes.

1. « Charger un nouveau tableau »
- l’utilisateur choisit un fichier Excel sur son ordinateur ;
- le fichier est lu par le navigateur uniquement en local ;
- les données sont chargées dans la mémoire de la session courante ;
- les indicateurs, filtres, graphiques, classements et tableaux sont entièrement reconstruits ;
- la structure est déterminée par les en-têtes de colonnes, non par des numéros de colonnes figés ;
- en l’absence d’un champ obligatoire, un message d’erreur compréhensible est affiché.

2. « Appliquer les filtres »
- recalculer toutes les visualisations sur la sélection courante.

3. « Réinitialiser »
- vider uniquement les filtres sélectionnés ;
- rétablir l’affichage de toute la base chargée ;
- ne pas supprimer les données elles-mêmes.

4. « Effacer toutes les données »
- supprimer totalement le jeu de travail chargé de l’état courant de l’application ;
- vider les indicateurs, graphiques, classements, tableaux, noms / identifiants et listes de filtres ;
- ramener le HTML à l’état d’enveloppe logicielle vide.

5. « Exporter les données sélectionnées vers Excel »
- exporter uniquement la sélection filtrée en cours.

6. « Enregistrer une copie hors ligne »
- n’enregistrer qu’après une action explicite de l’utilisateur ;
- si la base de travail courante est intégrée à la copie, afficher un avertissement indiquant que le HTML enregistré contient des données de travail et doit être conservé comme un fichier confidentiel ;
- aucune information ne doit être envoyée sur le réseau lors de l’enregistrement.

Si une fonction d’ajout de nouvelles données est introduite plus tard :
- vérifier d’abord la structure ;
- ne pas créer de doublons automatiquement ;
- indiquer à l’utilisateur combien d’enregistrements seront ajoutés et combien seront rejetés.

Supprime totalement le jeu de démonstration de la version finale.
Prompt 5. Filtres dépendants, cliquabilité et descente jusqu’à l’enregistrement
Fais évoluer le tableau de bord HTML existant sans le réécrire entièrement.

Il faut :
1. Rendre les filtres dépendants :
   entreprise → atelier → secteur / unité interne.
2. Après le choix d’une entreprise, ne conserver que les ateliers qui lui appartiennent.
3. Après le choix d’un atelier, ne conserver que ses secteurs.
4. Tenir compte de la période choisie, de la personne réalisant le BSD et de son poste.
5. Rendre cliquables les principaux graphiques et classements.
6. Au clic sur une barre, un secteur, un point, une ligne de classement ou un salarié, appliquer la sélection correspondante à tout le tableau de bord.
7. Afficher les enregistrements sources qui ont formé l’indicateur sélectionné.
8. Ajouter la possibilité de remonter d’un niveau ou de réinitialiser le détail courant.
9. Ajouter la recherche par salarié / identifiant anonymisé.
10. Pour le salarié sélectionné, afficher l’historique des BSD sur la période choisie : dates, unités, personnes ayant réalisé les BSD, types de comportement, processus et enregistrements sources.
11. Afficher séparément les salariés dont le comportement dangereux a été relevé à plusieurs reprises.
12. Permettre de voir la répétition d’un même type de comportement dangereux, même s’il a été relevé par des responsables ou des spécialistes différents et dans des secteurs différents.
13. Exporter la sélection courante vers Excel.
14. Ne pas modifier sans nécessité les fonctions qui marchent déjà.

Après l’évolution, effectue une vérification de non-régression :
- tous les filtres ;
- les clics sur les graphiques ;
- la recherche ;
- le détail ;
- l’export ;
- le retour à la sélection complète.
Prompt 6. BSD + relevé d’heures réel : respect de la fréquence recommandée établie
Ajoute au tableau de bord existant un mode d’analyse des BSD tenant compte des postes réellement travaillés.

Sources :
- l’export des BSD depuis Collab ;
- le relevé du temps de travail pour la même période.

Au stade du développement, utilise uniquement un modèle anonymisé du relevé d’heures. Le relevé réel ne doit être raccordé que plus tard, en local.

IMPORTANT :
n’invente pas toi-même la norme de réalisation des BSD. Avant le calcul, l’utilisateur doit fixer la fréquence recommandée établie, par exemple :
- X BSD pour N postes réellement travaillés ;
- X BSD par période calendaire / de reporting ;
- une autre règle de l’entreprise.

Logique :
1. Détermine les postes réellement travaillés d’après le relevé d’heures.
2. Ne compte pas les congés, arrêts maladie et autres absences comme des postes réellement travaillés.
3. Rapproche le jeu de BSD et le relevé d’heures par l’identifiant stable du salarié, l’entreprise, l’atelier, le secteur, le métier et la période — selon les champs disponibles.
4. Ne mélange pas des noms / identifiants et métiers identiques appartenant à des unités différentes.
5. À partir de la fréquence fixée par l’utilisateur, calcule le nombre attendu de BSD pour le temps réellement travaillé.
6. Affiche :
   - les postes réellement travaillés ;
   - la fréquence recommandée établie ;
   - le nombre réel de BSD ;
   - l’écart par rapport à la fréquence recommandée ;
   - le taux de réalisation ;
   - les unités et salariés en retard.
7. Ajoute une descente :
   entreprise → atelier → secteur → métier → salarié précis → ses enregistrements BSD.
8. Permets d’exporter la liste des salariés / unités présentant un écart.

Si la structure du relevé d’heures ou la règle de fréquence sont ambiguës, montre d’abord les cas litigieux et demande confirmation. N’effectue pas le calcul avant confirmation.
Prompt 7. CRC + relevé d’heures réel : régularité de la réalisation et écarts
Ajoute au tableau de bord un mode distinct d’analyse du contrôle des risques critiques (CRC).

Sources :
- l’export des CRC depuis Collab ;
- le relevé réel du temps de travail pour la même période.

Au stade du développement, utilise des modèles anonymisés. Les jeux réels ne doivent être raccordés qu’en local.

Logique :
1. Détermine les postes réellement travaillés par chaque salarié.
2. Ne compte pas les congés, arrêts maladie et autres absences comme des postes de travail.
3. N’invente pas toi-même la norme / la régularité exigée des CRC. Obtiens-la de l’utilisateur en paramètre.
4. Si, pour un processus donné, l’exigence « 1 CRC par poste réellement travaillé » est confirmée, ne l’utilise qu’après confirmation de l’utilisateur.
5. Rapproche les CRC des postes réellement travaillés par l’identifiant stable, l’entreprise, l’atelier, le secteur, le métier, la date et/ou le poste.
6. Ne mélange pas des métiers et identifiants identiques appartenant à des unités différentes.
7. Pour chaque salarié, affiche :
   - les postes réellement travaillés ;
   - le nombre de CRC ;
   - les postes / périodes où un CRC manque au regard de la règle fixée ;
   - l’écart ;
   - le taux de réalisation.
8. Ajoute une descente :
   entreprise → atelier → secteur → métier → salarié → poste précis / enregistrement CRC précis.
9. Permets d’exporter la liste des salariés ou des postes présentant un écart.
10. Si l’export CRC contient des dangers identifiés, des risques critiques, des descriptions d’écarts ou des causes, affiche en plus :
   - la récurrence par secteur ;
   - la récurrence par processus ;
   - la récurrence par salarié ;
   - les enregistrements sources au clic.

Si la structure des données est ambiguë, montre d’abord les règles de rapprochement et les cas litigieux. N’effectue pas le calcul final avant confirmation de l’utilisateur.
Prompt 8. Diagnostic des défauts et autocontrôle technique
Effectue une vérification du tableau de bord HTML autonome existant.

Ne réécris pas d’emblée toute l’application.

Si une erreur est apparue après la dernière évolution :
1. Trouve la cause précise.
2. Corrige uniquement la partie nécessaire.
3. Ne supprime ni ne réécris sans raison les fonctions qui marchent déjà.
4. Après la correction, effectue une vérification de non-régression.

Vérifie impérativement les scénarios suivants :
- ouverture du HTML sans Internet ;
- chargement d’un fichier Excel de test anonymisé ;
- filtres dépendants ;
- clics et descente ;
- recherche par salarié ;
- export de la sélection choisie ;
- réinitialisation des filtres ;
- suppression complète des données ;
- nouveau chargement d’un autre tableau ;
- enregistrement d’une copie hors ligne.

Après la vérification fonctionnelle, réalise un audit de l’autonomie et des canaux possibles de transmission / stockage :
- fetch ;
- XMLHttpRequest ;
- WebSocket ;
- EventSource ;
- sendBeacon ;
- script src externes ;
- CDN ;
- CSS et polices externes ;
- API ;
- iframe ;
- Service Worker ;
- localStorage ;
- sessionStorage ;
- IndexedDB ;
- cookies ;
- télémétrie et analytique.

La version finale doit :
- fonctionner pleinement sans connexion Internet ;
- ne pas envoyer sur le réseau le contenu des fichiers Excel chargés ;
- ne pas enregistrer la base de travail de façon masquée sans action explicite de l’utilisateur ;
- lors d’une réinitialisation complète, supprimer les données de travail de l’état courant de l’interface.

Pour finir, fournis un bref rapport :
1. ce qui a été vérifié ;
2. quels défauts ont été trouvés ;
3. ce qui a été corrigé ;
4. quelles limites ou quels risques subsistent.
Ordre d’utilisation recommandé
- Exécuter le Prompt 1 et vérifier si l’IA a bien compris la structure du fichier Excel anonymisé.
- Après confirmation de la structure, exécuter le Prompt 2.
- Exécuter le Prompt 3 et obtenir la première version HTML autonome.
- Au fil des évolutions, utiliser le Prompt 5 pour les filtres, les clics et la descente.
- Une fois la logique prête, exécuter le Prompt 4 : supprimer les données de démonstration et organiser le chargement local de la base de travail, les réinitialisations, l’export et la copie hors ligne.
- Si une analyse de la fréquence recommandée des BSD est nécessaire, ajouter le Prompt 6.
- Pour les CRC et le rapprochement avec le relevé d’heures réel, utiliser le Prompt 7.
- Après des modifications importantes et avant la publication / la remise aux utilisateurs, exécuter le Prompt 8.