L'IA comme second expert : des causeries sécurité à l'évaluation automatisée des BSD
Causeries sécurité → évaluation numérique → Make → dialogues de sécurité comportementale automatisés
Idée principale : l'IA ne remplace pas le manager ou le spécialiste de la sécurité. Elle devient un « second expert » unifié qui applique les mêmes critères, donne un feedback personnalisé et permet de mettre à l'échelle le contrôle qualité sur des centaines et des milliers de conversations réelles.
Pourquoi nous avons commencé à évaluer la conversation, et non le fait qu'elle ait eu lieu
En santé et sécurité au travail, il est facile de compter les faits : la causerie sécurité a eu lieu, le dialogue de sécurité comportementale a été enregistré, la fiche a été remplie. Il est beaucoup plus difficile de répondre à la question de savoir avec quelle qualité le manager a mené la conversation elle-même et s'il a atteint son objectif.
La causerie sécurité dans notre méthodologie est une partie obligatoire de la réunion de relève de quart d'une durée de 5 à 10 minutes. Le manager doit aborder un sujet d'actualité spécifique et établir un lien clair : danger → conséquences → mesures de sécurité. De plus, non seulement le monologue du contremaître est important, mais aussi le dialogue avec les travailleurs : questions, réponses et implication dans la discussion.
C'est pourquoi la tâche initiale n'était pas de « vérifier la présence d'un enregistrement », mais plutôt : est-il possible d'apprendre à l'IA à évaluer uniformément la qualité réelle de ces conversations et à donner au manager un feedback concret ?
Étape 1. D'abord la méthodologie, ensuite l'intelligence artificielle
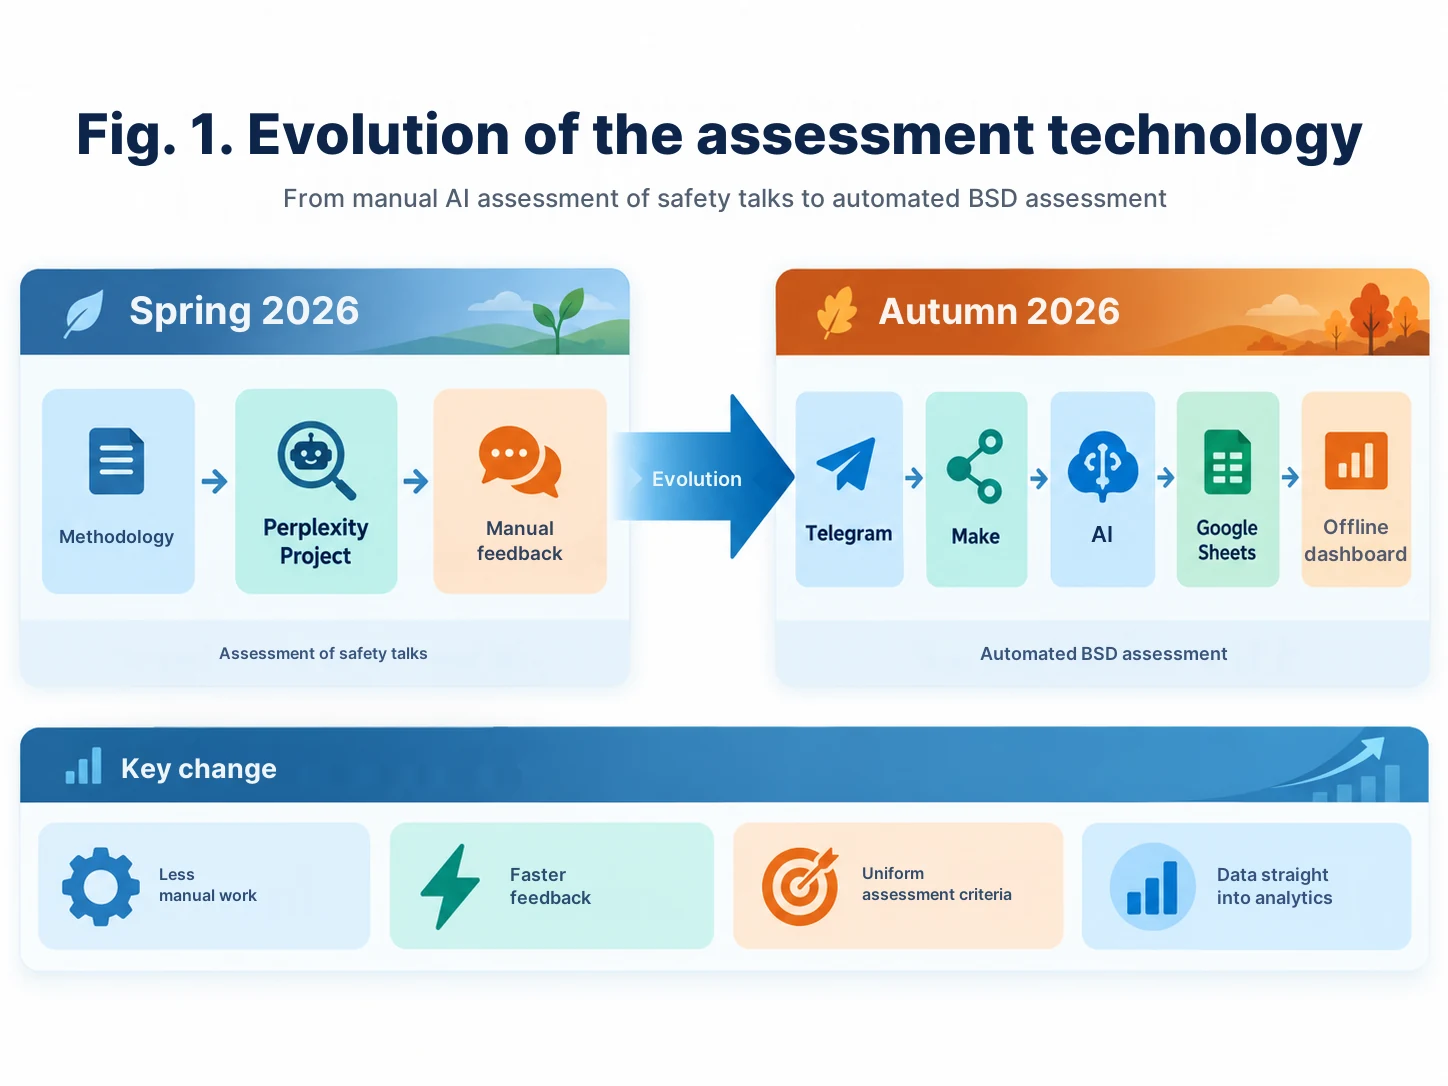
Au printemps 2026, nous avons commencé par les causeries sécurité. Avant le lancement de l'évaluation par l'IA, des recommandations méthodologiques et une vidéo de formation sur la façon de mener correctement une causerie sécurité ont été préparées. C'est seulement après cela que l'évaluateur numérique est apparu.
Comme premier circuit de travail, nous avons utilisé Perplexity Space — aujourd'hui, un environnement similaire dans Perplexity s'appelle Project. Nous avons chargé dans le projet le manuel méthodologique et la liste de contrôle d'évaluation, et nous avons préparé séparément un Prompt strict pour le modèle.
La tâche du Prompt différait fondamentalement d'une requête habituelle « évalue la présentation ». L'IA n'était autorisée à valider que ce qui avait été réellement dit dans l'audio. Si un élément est absent — 0 point. S'il est mentionné formellement — réalisation partielle. S'il est développé logiquement et complètement — réalisé.
Dans la liste de contrôle en vigueur, il y a sept critères : présentation et objectif ; danger spécifique ; logique « danger – conséquences – mesures » ; impulsion émotionnelle ; mesures de sécurité ; dialogue avec les travailleurs ; résumé final et lien avec les travaux en cours.
Prompt 1 — voir la version modernisée du Prompt pour Perplexity Project en annexe.
À quoi ressemblait le premier circuit, encore manuel
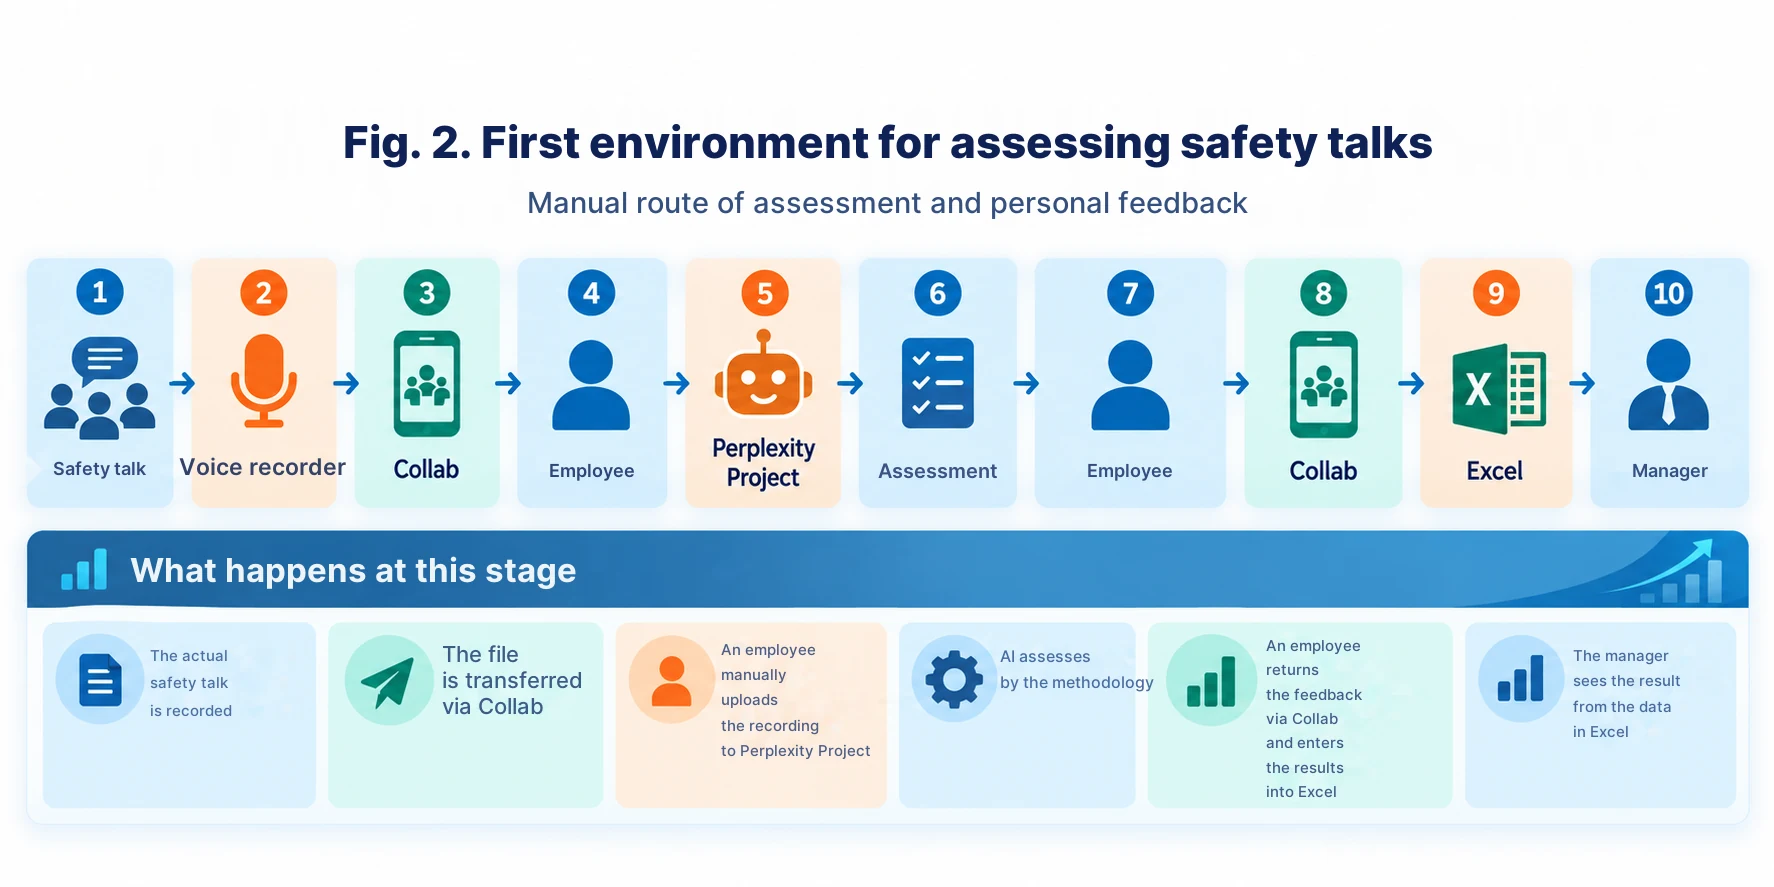
Le chef de quart enregistrait la causerie sécurité réalisée sur un dictaphone. Via l'application d'entreprise Collab, l'enregistrement était transmis à un employé désigné. L'employé chargeait l'audio dans Perplexity Project, obtenait l'évaluation et renvoyait un feedback personnalisé au manager également via Collab.
Simultanément, le résultat était saisi dans Excel : département, manager, évaluation, nombre de tentatives. À partir du tableau, nous construisions des analyses simples — résultats moyens des départements, dynamique et nombre de cycles répétés.
Nous avons adopté 80 % comme niveau de passage pour le cycle pratique. Si le résultat était inférieur, le manager réalisait la causerie sécurité suivante en tenant compte des remarques de l'IA. Il en résultait non seulement un contrôle, mais aussi un entraînement individuel directement sur le lieu de travail.
Nous n'avons pas seulement vérifié l'humain — nous avons d'abord vérifié l'IA elle-même
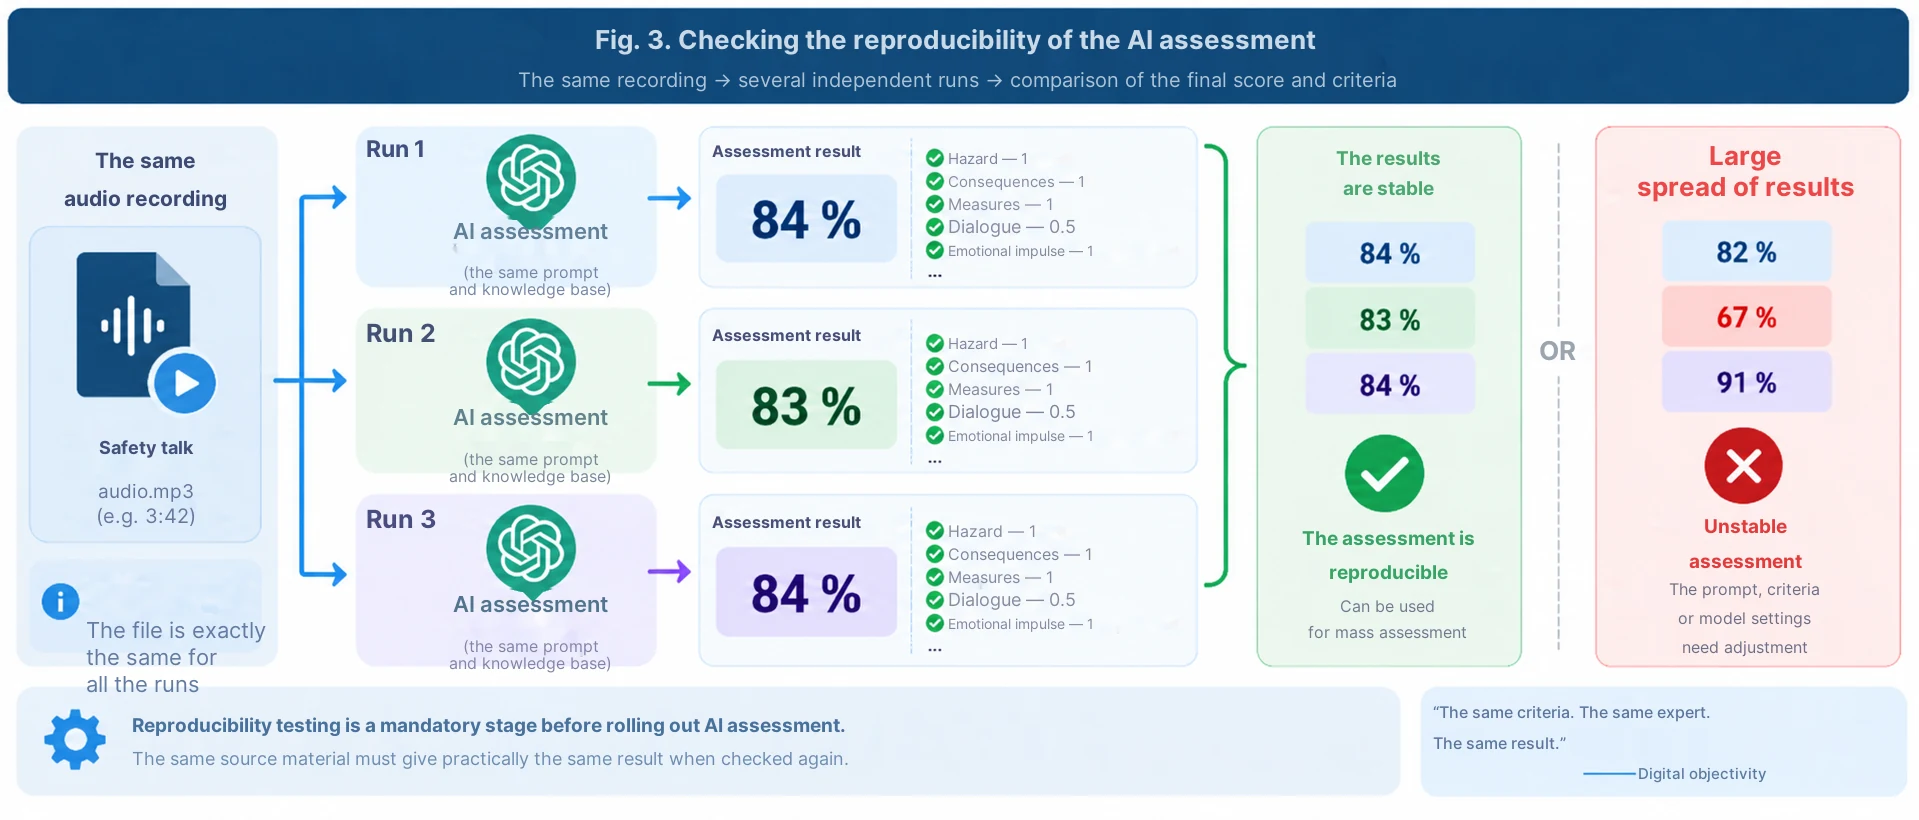
Pour moi, c'est l'un des éléments les plus importants de tout le système. Nous avons délibérément envoyé le même enregistrement audio pour évaluation à plusieurs reprises. Si le même document obtient 82 % aujourd'hui, 65 % une minute plus tard, puis 91 %, un tel expert numérique n'est pas encore prêt à évaluer des personnes.
C'est pourquoi nous avons visé la reproductibilité : un enregistrement identique doit donner une évaluation identique ou pratiquement identique. Si l'écart devenait notable, nous corrigions le Prompt, précisions les critères et supprimions les formulations ambiguës.
Pour ma part, j'appelle cela « l'objectivité numérique ». Cela ne signifie pas que l'IA détient la vérité absolue. Il s'agit d'autre chose : un expert unifié applique la même échelle à tout le monde et ne dépend pas de son humeur, de ses sympathies personnelles ou de qui exactement effectue la vérification aujourd'hui.
Prompt 2 — voir le protocole de vérification de la reproductibilité de l'évaluation en annexe.
Pourquoi le circuit manuel a cessé de convenir
Pour le pilote, le parcours manuel était pratique : recevoir le fichier, le charger, attendre le résultat, renvoyer le feedback et saisir la note dans Excel. Mais une telle approche a une limite naturelle.
Lorsque le volume se mesure déjà en centaines et en milliers d'enregistrements, nous commençons non pas à automatiser l'évaluation, mais à créer un nouveau travail administratif autour de l'évaluation. C'est pourquoi, lors du passage aux dialogues de sécurité comportementale (BSD), la tâche a été formulée différemment : retirer l'humain de la chaîne technique là où sa participation ne crée pas de valeur.
Étape 2. Le dialogue de sécurité comportementale est plus complexe qu'une causerie sécurité ordinaire
Un dialogue de sécurité comportementale n'est pas seulement une courte présentation. La méthodologie comprend l'observation du travail réel et une conversation avec la personne. Il est important que le manager identifie un comportement sûr ou dangereux, puis qu'il amène le travailleur, à l'aide de questions, à nommer lui-même le danger, les conséquences possibles et la méthode sûre pour effectuer le travail.
Si le travailleur travaille dangereusement, la partie clé de la conversation consiste à discuter des dangers et des conséquences, puis de la méthode de travail sûre et d'autres sources de danger. Si la personne travaille en toute sécurité, le manager doit le remarquer et renforcer le bon comportement, puis utiliser la conversation pour discuter d'autres questions de sécurité.
C'est précisément pourquoi le circuit d'évaluation des BSD doit vérifier non seulement les mots du manager, mais aussi la présence d'un véritable dialogue : des questions ont-elles été posées, le travailleur a-t-il répondu, les causes du comportement, les conséquences, les actions sûres et la conclusion de la conversation ont-ils été discutés.
Identifiant pseudonyme au lieu du nom de famille
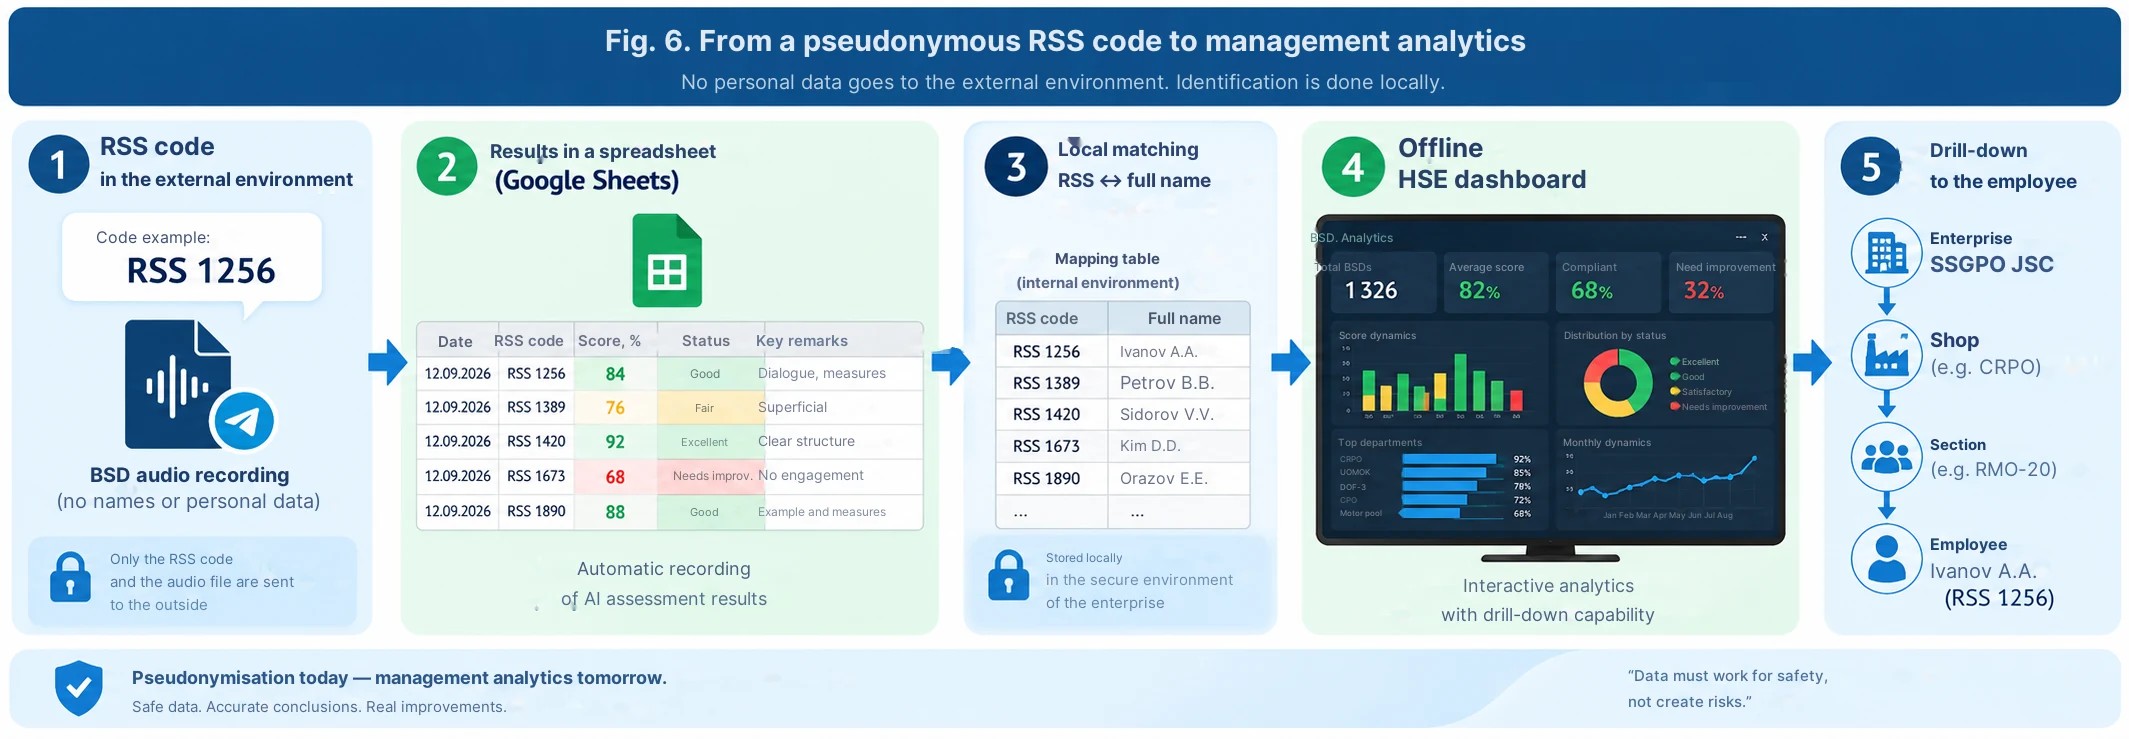
Lors de l'automatisation de masse, nous avons résolu séparément la question de l'identification. À l'intérieur du circuit d'entreprise ERGIS, un code spécial de type RSS 1256 est attribué à chaque participant. Ce n'est ni un numéro de matricule ni un nom de famille.
Avant de commencer l'enregistrement, le manager prononce son code RSS, après quoi il mène le BSD. Dans la conversation, il n'est pas nécessaire de mentionner des noms de famille ou des numéros de matricule. La correspondance « code RSS ↔ employé spécifique » reste au sein du circuit d'entreprise et est utilisée ultérieurement pour l'analyse locale.
Ici, il est plus correct de parler non pas d'anonymisation complète, mais de pseudonymisation : la voix de la personne reste présente dans le fichier audio. Mais le volume de données personnelles traversant le circuit automatisé est considérablement réduit.
Petit secret : je ne suis pas programmeur
Nous avons assemblé l'architecture de la nouvelle solution via Make. Je ne suis pas programmeur et, au début du travail, je l'ai écrit directement à ChatGPT.
La requête était simple : « Guide-moi étape par étape dans la création de cette automatisation. Donne-moi une action à la fois. Je vais l'exécuter dans Make et envoyer une capture d'écran. Après vérification, donne la commande suivante ».
Ensuite, c'est exactement ce qui s'est passé. ChatGPT expliquait quel module créer et quoi y remplir ; j'exécutais l'action et j'envoyais une capture d'écran ; après vérification, j'obtenais l'étape suivante. De la même manière, le bot Telegram a été créé et toute la chaîne a été connectée.
C'est une conclusion importante pour moi de la pratique du vibe-coding : un spécialiste n'a pas besoin de connaître à l'avance la syntaxe de l'API ou de Make. Mais il doit bien comprendre le processus de production, le résultat que l'utilisateur doit obtenir, et être capable de vérifier séquentiellement chaque étape.
Prompt 3 — voir le Prompt de départ « guide-moi étape par étape dans Make » en annexe.
Ce qui se passe maintenant : Telegram → Make → IA → résultat
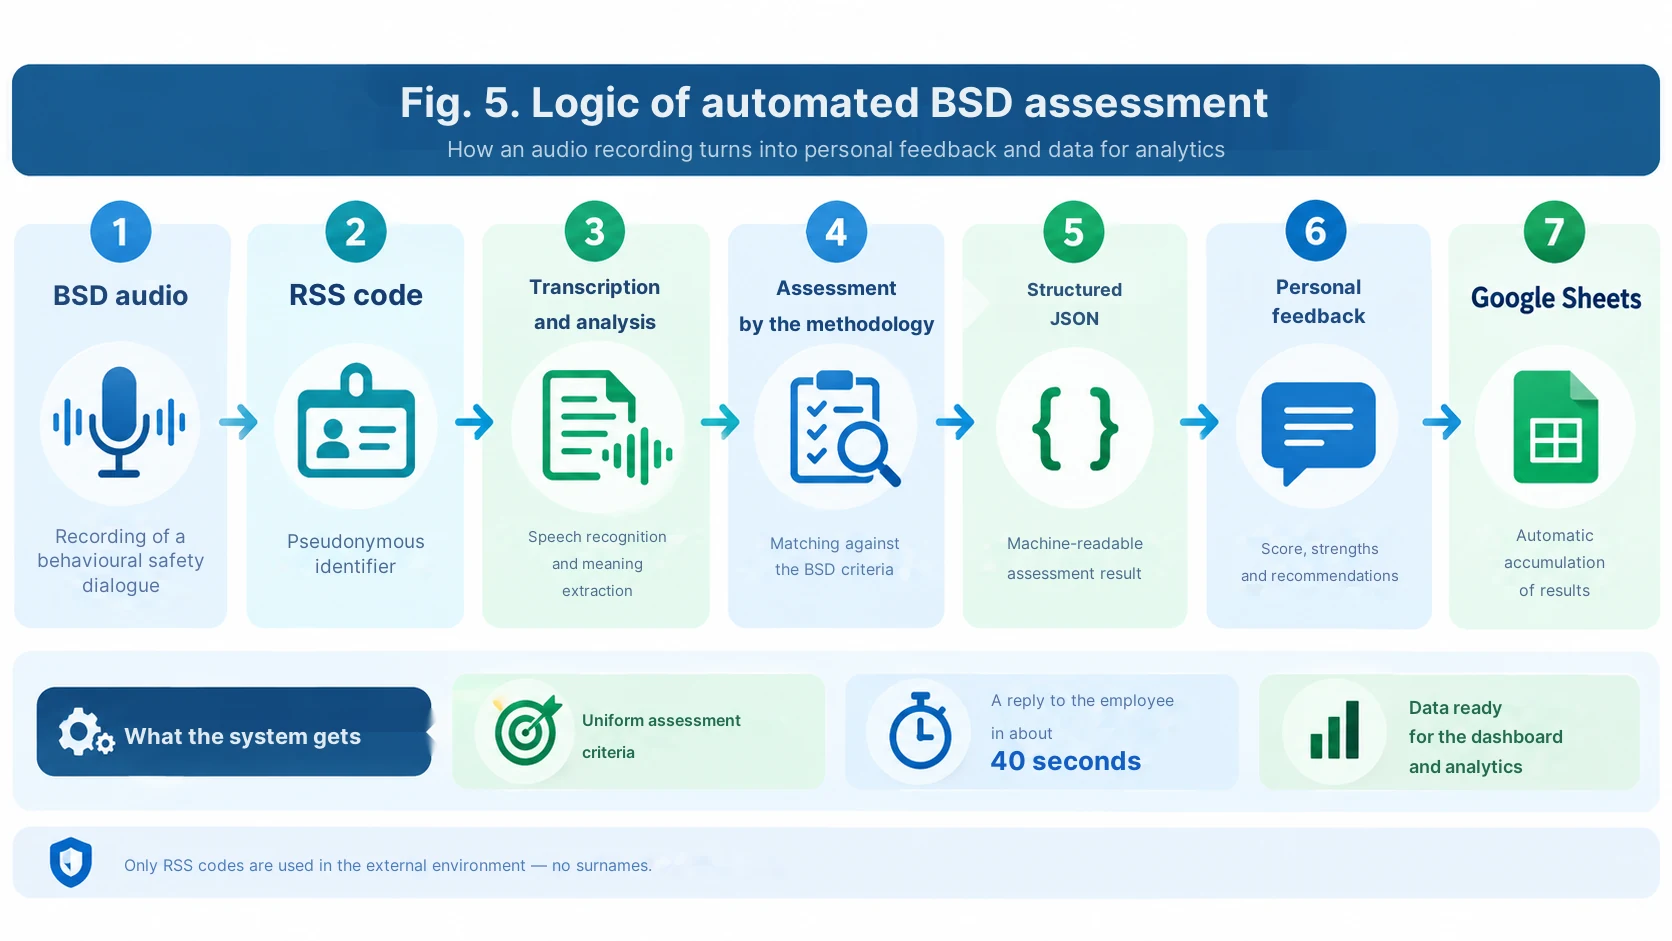
Le circuit actuel fonctionne presque sans opérateur manuel. Le manager envoie l'enregistrement audio au bot Telegram. Make reçoit le fichier, vérifie les données d'entrée et lance le parcours de traitement. L'IA analyse l'enregistrement selon la méthodologie définie, forme l'évaluation et le feedback. Le résultat est renvoyé à l'utilisateur et simultanément enregistré dans Google Sheets pour l'analyse globale.
Dans le pilote actuel, le feedback revient en quelques dizaines de secondes environ. Pour l'utilisateur, cela semble simple : il a envoyé l'audio — il a reçu une évaluation, les points forts, les erreurs spécifiques et ce qu'il faut changer la prochaine fois.
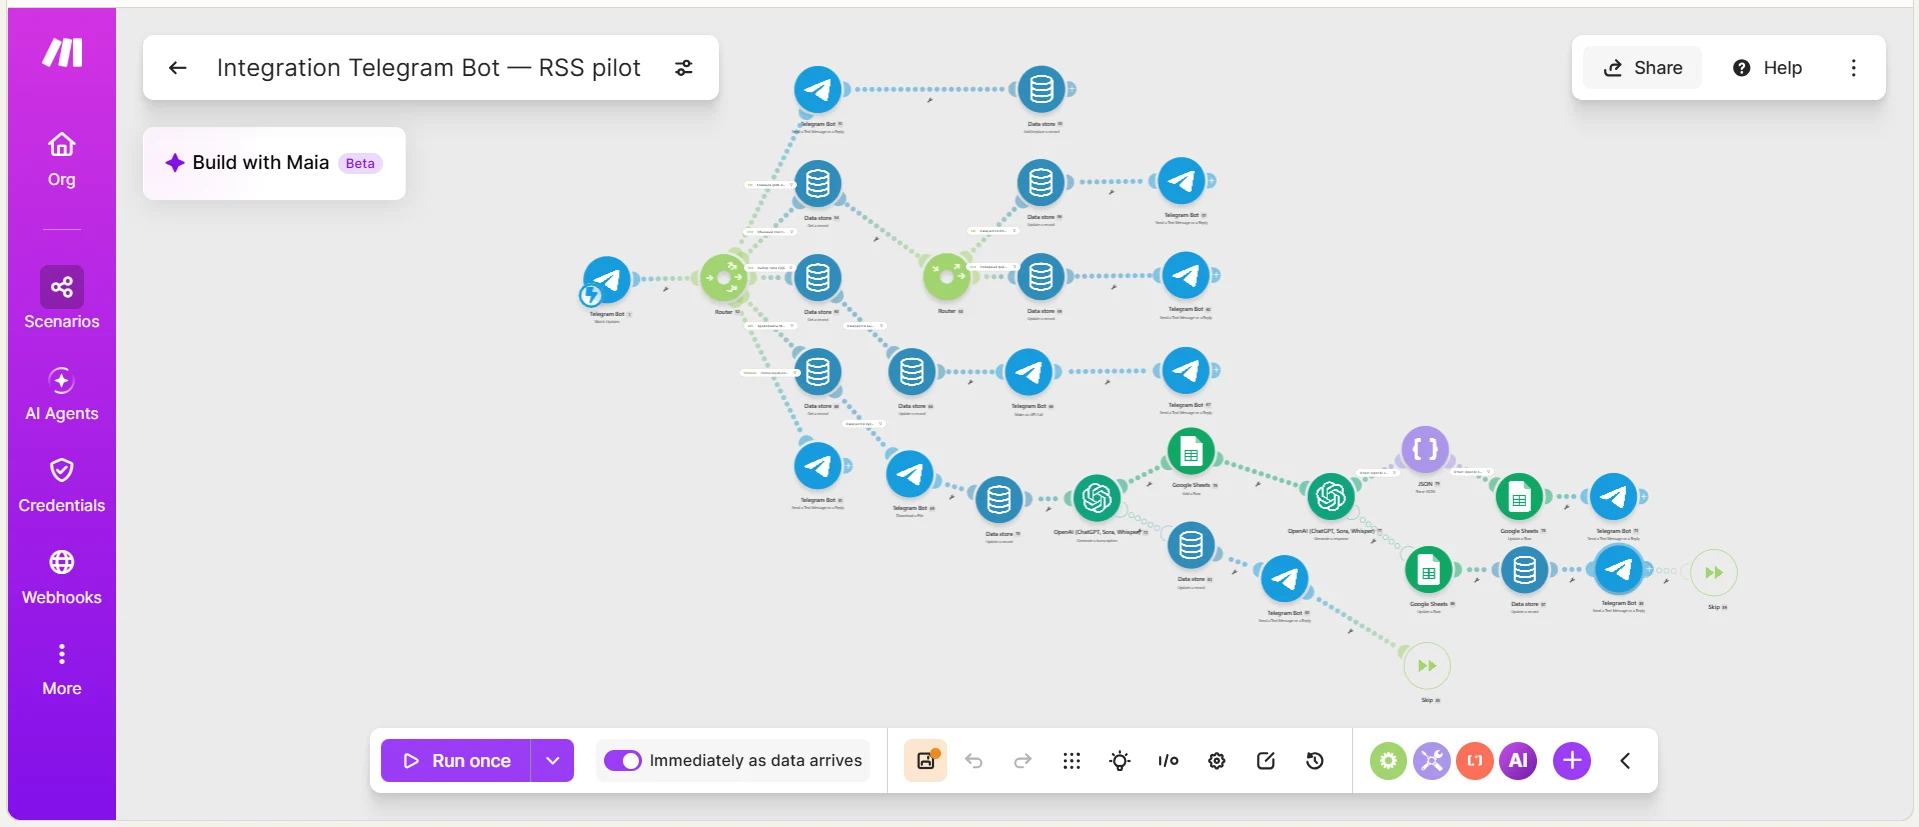
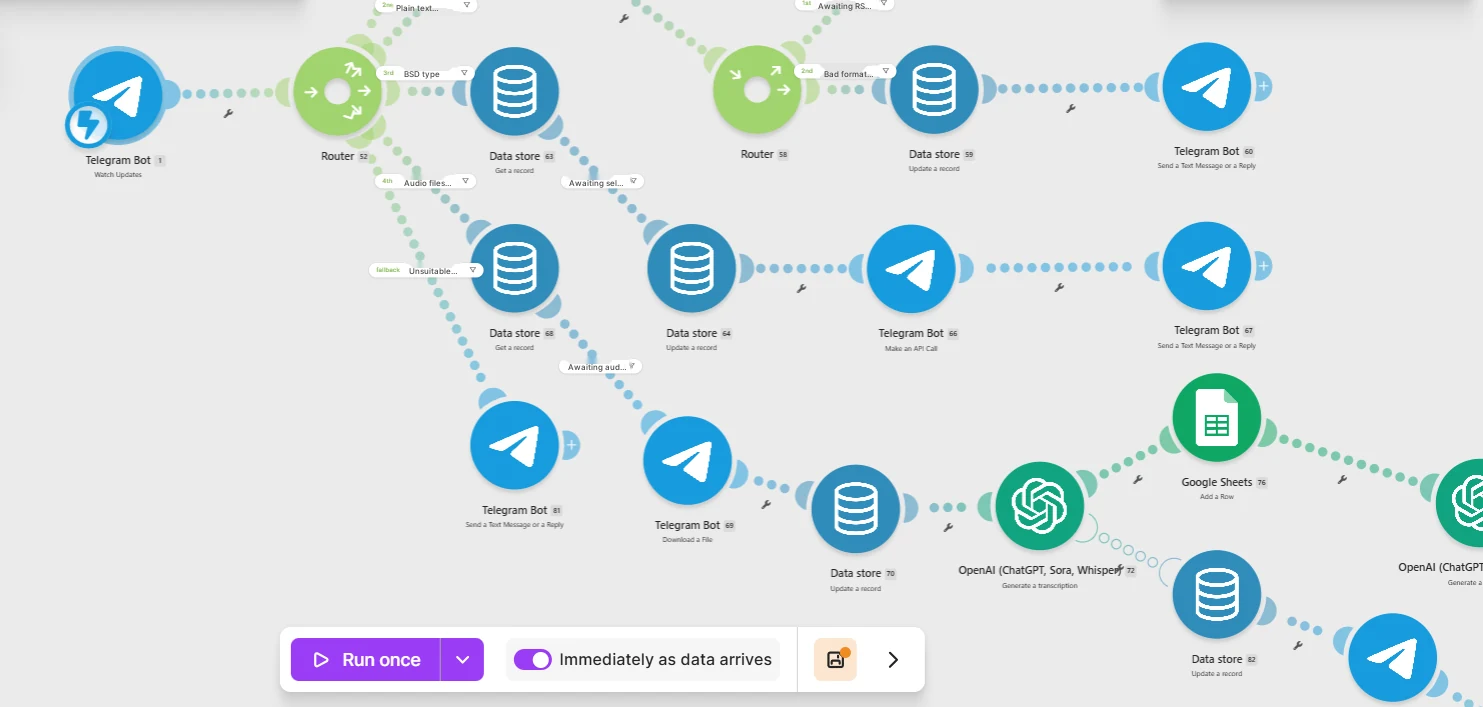
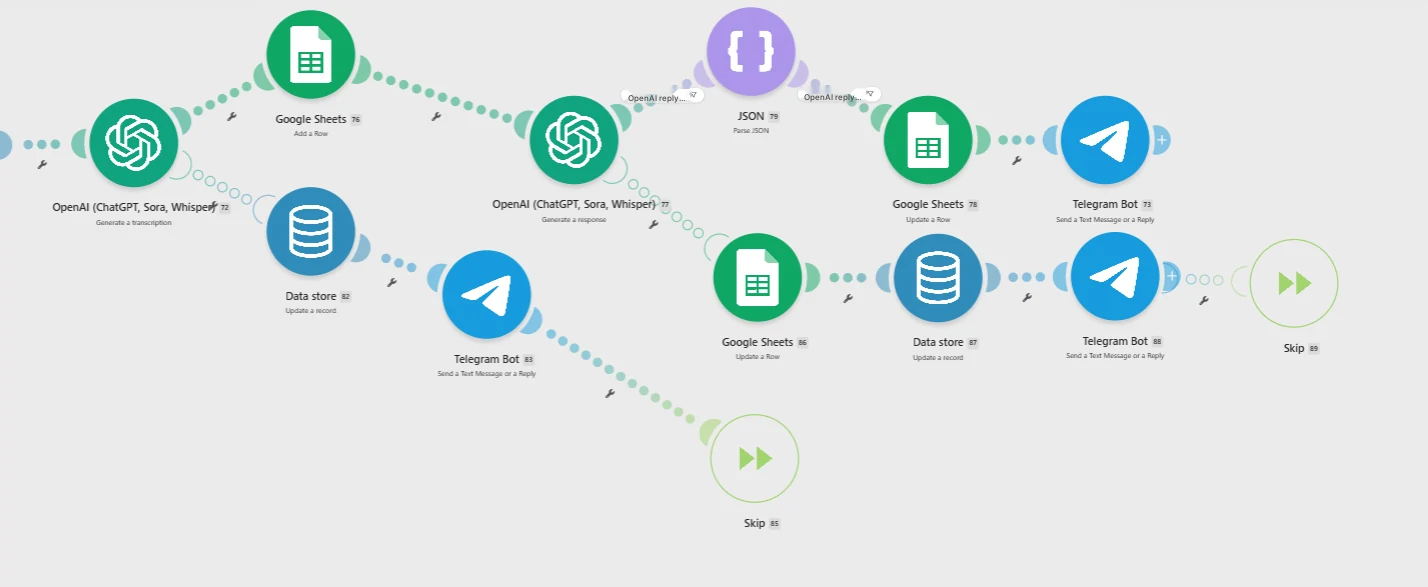
Sur le schéma de Make, on peut voir que derrière cette simplicité se cache un routage complet : Telegram, Data store, Router, OpenAI, Google Sheets, des vérifications et des messages de retour à l'utilisateur.
Est-ce un multi-agent ou non ?
Je n'utiliserais pas ici le mot « multi-agent » juste pour faire de l'effet. En pratique, nous avons un circuit d'experts en plusieurs étapes, dans lequel différentes parties du scénario remplissent différentes fonctions : réception et routage du fichier, extraction de l'identifiant, analyse du contenu, évaluation d'expert, formation du résultat structuré, enregistrement dans le tableau et feedback personnel.
Si plusieurs appels de modèles distincts fonctionnent avec des rôles système différents — par exemple, un analyse le dialogue, un deuxième vérifie la conformité à la méthodologie et formate le résultat — cela peut déjà être considéré comme une logique multi-agent ou à agents multiples. Si un seul appel de modèle remplit toutes les fonctions, il est plus honnête de parler d'un évaluateur IA multifonctionnel.
Dans l'annexe, j'ai donc divisé les prompts par fonctions, et je ne nomme pas chaque fonction comme un agent séparé.
Comment est structurée l'évaluation automatisée des BSD
Dans un scénario industriel, il est important de séparer deux tâches. La première est liée à l'expertise : évaluer le contenu de la conversation strictement par rapport à la méthodologie. La deuxième est technique : renvoyer le résultat dans un format que Make comprendra et pourra enregistrer dans Google Sheets.
C'est pourquoi une réponse JSON structurée est pratique pour l'automatisation : code RSS, score final, statut, points forts, zones d'amélioration, feedback court et critères d'évaluation individuels. Un tel format réduit le risque que l'automatisation « se casse » à cause d'un texte de modèle beau, mais imprévisible.
Dans le même temps, la règle stricte reste la même qu'au printemps : ne pas compter ce qui n'est pas dans l'enregistrement ; ne pas deviner les intentions ; ne pas inventer la bonne réponse à la place du manager. Si la transcription est incomplète, l'enregistrement doit être renvoyé pour un nouveau téléchargement, et ne pas recevoir une évaluation inventée.
Prompts 4–6 — évaluation du BSD, JSON structuré et formation du feedback, voir l'annexe.
De l'évaluation personnelle à la vision par départements
Après chaque évaluation, ce n'est plus seulement un feedback textuel qui s'accumule dans Google Sheets, mais un tableau structuré. On peut donc voir le nombre de BSD réalisés, le résultat moyen, les principales erreurs répétées, la dynamique et les résultats par codes RSS pseudonymisés.
L'étape suivante nous est déjà familière depuis le deuxième article : associer localement le code RSS avec le nom complet dans le périmètre de l'entreprise et charger le résultat dans un tableau de bord HSE autonome. Le manager voit alors l'image de l'entreprise, de l'atelier et du site et, si nécessaire, descend jusqu'au travailleur spécifique.
Autrement dit, le circuit d'évaluation externe peut fonctionner sans les noms de famille, et le tableau de gestion complet n'est restauré qu'à l'intérieur de l'entreprise.
Comment cette idée peut être répétée sans notre architecture
Le sens de l'approche n'est pas lié à une seule marque d'IA. Dans la version la plus simple, on peut créer un Perplexity Project avec la méthodologie et le prompt d'évaluation. On peut utiliser ChatGPT avec une instruction constante et une base de connaissances chargée. On peut construire un schéma autour de Google NotebookLM / Gemini Notebook comme source de matériaux méthodologiques, et effectuer l'évaluation avec un modèle séparé. Pour un flux massif, il est plus pratique d'utiliser Make ou une autre plateforme d'automatisation avec Telegram, OpenAI et des tableaux.
Les éléments clés restent les mêmes : méthodologie approuvée → prompt strict → vérification de la reproductibilité → échelle compréhensible → feedback personnel → accumulation structurée du résultat.
Ce qui a changé en quelques mois
Au printemps, un employé transférait manuellement les fichiers audio dans l'IA et renvoyait le résultat. Aujourd'hui, nous construisons un circuit capable de recevoir et d'évaluer environ 1300 enregistrements de BSD sans opérateur distinct sur chaque fichier.
Mais le principal changement n'est même pas dans la vitesse. Nous avons obtenu la possibilité d'appliquer les mêmes critères à un grand nombre de conversations réelles et de transformer chaque évaluation en un court cycle d'apprentissage individuel.
L'IA dans ce schéma n'est pas un inspecteur qui cherche un coupable. Elle est à la fois un deuxième expert et un coach numérique : elle consigne la non-conformité à la méthodologie, explique ce qu'il faut exactement améliorer, et permet de vérifier cela dès la conversation suivante.
Conclusion
Quand nous avons commencé, la tâche ressemblait à une expérience : l'IA pourra-t-elle évaluer une causerie sécurité. Le résultat est une technologie qui peut être mise à l'échelle sur les dialogues comportementaux, la formation et d'autres types de communications sur la sécurité.
Pour moi, le résultat le plus précieux n'est pas le chiffre automatique. La valeur réside dans le fait que le manager reçoit un feedback presque immédiatement après une conversation réelle, et l'entreprise reçoit simultanément un ensemble de données sur les éléments de la méthodologie qui sont vraiment difficiles pour les personnes.
C'est précisément à cet endroit que l'IA commence à fonctionner non pas à la place du système de gestion de la sécurité, mais à l'intérieur de celui-ci — comme un deuxième expert uniforme.
Prompts pour l'article « L'IA comme deuxième expert »
Causeries sécurité, vérification de la reproductibilité, Make et évaluation automatisée des BSD
Ceci est la version publiable des prompts. Elle est basée sur une méthodologie réelle et notre architecture de travail, mais avant l'application dans une autre entreprise, les critères et les seuils doivent être remplacés par les exigences locales approuvées.
Prompt 1. Évaluation modernisée de la causerie sécurité dans Perplexity Project
C'est une version publiable améliorée du prompt actuel. J'ai corrigé les contradictions internes : la liste de contrôle contient désormais vraiment 7 critères, et le seuil de réussite est le même partout — 80 %.
Tu agis en tant qu'expert en santé, sécurité au travail et sécurité industrielle, effectuant une évaluation de contrôle de la qualité de l'animation d'un toolbox talk par le chef de quart.

SOURCES ET PRIORITÉ
1. Enregistrement audio du toolbox talk.
2. Guide méthodologique approuvé de l'entreprise.
3. Liste de contrôle d'évaluation approuvée.
En cas de conflit de formulation, guide-toi sur la liste de contrôle et la méthodologie approuvées. N'ajoute pas tes propres critères.

ÉTAPE 1. TRANSCRIPTION COMPLÈTE
- Obtiens d'abord une transcription complète de l'audio, et non un résumé court.
- Pour Perplexity Project, utilise l'outil disponible de lecture du fichier audio joint en mode complet (READ / context budget maximal disponible).
- Marque les fragments inaudibles [inaudible].
- Si moins de 80 % de la parole est reconnue de manière cohérente ou si une partie substantielle de l'enregistrement est manquante, réponds seulement : « Données insuffisantes. Rechargez le fichier. » et arrête-toi.
- N'inclus pas la transcription complète dans le rapport final.

ÉTAPE 2. ÉVALUATION D'EXPERT
N'évalue que ce qui a été réellement dit dans la transcription complète.
Il est interdit :
- d'inventer les intentions du contremaître ;
- de valider ce qui n'est pas dans l'enregistrement ;
- d'améliorer les formulations pour la personne évaluée ;
- de compenser un élément manquant par une bonne impression générale.

ÉCHELLE POUR CHAQUE CRITÈRE
Accompli = 1 point.
Partiellement = 0,5 point.
Non accompli = 0 point.
Règle :
- absent de l'audio → 0 ;
- mentionné formellement, sans développement → 0,5 ;
- développé de manière logique et correcte → 1.

LISTE DE CONTRÔLE — ÉVALUE LES 7 POINTS SANS OMISSION
1. Présentation de soi et de l'objectif du toolbox talk.
2. Nom du danger spécifique / du sujet actuel.
3. Logique « danger → conséquences → mesures de sécurité ».
4. Impulsion émotionnelle par le biais de conséquences réelles/potentielles ou d'un exemple pertinent.
5. Mesures de sécurité spécifiques.
6. Dialogue avec les travailleurs : questions, réponses, implication.
7. Résumé final et lien avec les travaux en cours / à venir.

FORMAT DE RÉPONSE
1. Tableau :
N° | Critère | Ce qui a été réellement dit | Évaluation | Point

2. Résultat :
Obtenu : X sur 7.
Pourcentage : (X/7)*100, arrondi à 1 décimale.

3. Statut du cycle :
- si le résultat est >=80% : « Niveau de passage atteint » ;
- si le résultat est <80% : « Niveau de passage non atteint. Un nouveau toolbox talk est recommandé après l'étude du feedback ».

4. Points forts — 2 à 5 points spécifiques, tirés uniquement de l'enregistrement.
5. Domaines d'amélioration — spécifiquement sur les critères non accomplis/partiellement accomplis.
6. Feedback au contremaître — 3 à 5 phrases : style professionnel, exigeant, axé sur le développement.

CONTRÔLE AVANT LA RÉPONSE
Avant la réponse finale, vérifie à nouveau :
- la somme des points correspond au tableau ;
- le pourcentage est calculé correctement ;
- aucun des 7 critères n'est omis ;
- aucune affirmation n'est basée sur ce qui n'était pas dans l'audio.
Commentaire : Le principe principal est conservé depuis la version initiale : d'abord une transcription complète, puis une évaluation uniquement sur ce qui a été réellement dit. Dans Perplexity, le nom exact de l'outil de lecture de fichier peut changer, c'est pourquoi il est préférable de décrire la fonction dans la version publique plutôt que de lier strictement le lecteur au nom search_files_v2.
Prompt 2. Vérification de la reproductibilité (« objectivité numérique »)
Ce Prompt est utilisé après plusieurs passages indépendants du même enregistrement.
Je valide la reproductibilité de l'évaluateur IA.

J'ai les résultats de N évaluations indépendantes DU MÊME enregistrement audio selon la même liste de contrôle.
Je te transmettrai les tableaux finaux/JSON de chaque passage.

Ta tâche :
1. Comparer le pourcentage final entre les passages.
2. Comparer le point pour chaque critère.
3. Mettre en évidence les critères pour lesquels le modèle change le plus souvent de décision.
4. Calculer :
   - le pourcentage final minimum ;
   - le pourcentage final maximum ;
   - l'écart en points de pourcentage ;
   - le pourcentage final moyen.
5. Ne pas réévaluer l'enregistrement initial lui-même et ne pas choisir la « bonne » évaluation — analyser uniquement la stabilité de l'évaluateur.

CRITÈRE POUR LE PILOTE
- différence de 0 à 2 p.p. — reproductibilité élevée ;
- 2,1 à 5 p.p. — acceptable, mais vérifier les critères litigieux ;
- plus de 5 p.p. — le Prompt/les critères nécessitent des améliorations.

Fournis la sortie au format :
- Niveau de reproductibilité ;
- Où l'écart se produit ;
- Ce qui doit exactement être rendu plus univoque dans le Prompt ;
- S'il faut répéter le test après la correction.

Ne l'appelle pas objectivité absolue. Utilise le terme « reproductibilité de l'évaluation ».
Commentaire : Le seuil d'écart dans l'exemple est une ligne directrice de travail pour la publication, et non une norme d'entreprise approuvée. Il peut être supprimé ou remplacé par le tien.
Prompt 3. ChatGPT comme mentor étape par étape pour Make
C'est le même principe qui permet à une personne sans compétences en programmation de reproduire la solution.
Je ne suis pas programmeur et je n'ai jamais construit de scénarios dans Make auparavant.
Aide-moi à créer une automatisation sur le principe « une action à la fois ».

OBJECTIF
Le bot Telegram reçoit un enregistrement audio de dialogue de sécurité comportementale (BSD). Ensuite, Make doit :
1. recevoir le fichier ;
2. vérifier le type d'entrée ;
3. extraire/obtenir l'audio ;
4. transmettre le matériel à l'IA pour analyse ;
5. obtenir un résultat strictement structuré ;
6. écrire le résultat dans Google Sheets ;
7. envoyer à l'utilisateur un court feedback personnel ;
8. traiter correctement les erreurs, les fichiers en double et les formats non pris en charge.

RÈGLES DE NOTRE TRAVAIL
- Ne donne qu'UNE SEULE étape suivante par message.
- Écris le nom exact du module Make qui doit être ajouté.
- Écris ce qu'il faut sélectionner dans chaque champ obligatoire.
- Si une variable du module précédent est requise — indique son origine exacte.
- Après chaque étape, arrête-toi et demande-moi d'envoyer une capture d'écran.
- D'après ma capture d'écran, vérifie d'abord si tout est fait correctement. S'il y a une erreur — nous la corrigeons et alors seulement nous continuons.
- Ne saute pas les étapes et n'envoie pas tout le scénario d'un coup.
- Explique avec des mots simples, sans supposer que je connais les API, JSON ou la programmation.
- S'il y a plusieurs façons, choisis la plus simple et la plus fiable pour le pilote et explique brièvement pourquoi.

RESTRICTIONS
- l'identifiant de l'utilisateur dans le circuit d'évaluation est un code pseudonymisé du type RSS 1234 ;
- les noms de famille et les numéros d'employé ne sont pas nécessaires ;
- le résultat pour le tableau doit être structuré ;
- la personne sur Telegram ne reçoit qu'un feedback compréhensible, sans JSON technique.

Commence par la première étape : la création/connexion du bot Telegram et du premier module d'entrée Make.
Prompt 4. Cœur de l'évaluation BSD pour OpenAI/ChatGPT dans Make
Il s'agit d'une version de publication universelle du bloc d'évaluation. Elle renvoie spécifiquement du JSON — de cette façon, Make écrit plus facilement le résultat dans le tableau et achemine la réponse.
SYSTEM ROLE
Tu es un évaluateur expert de la qualité des dialogues de sécurité comportementale (BSD). Tu n'évalues QUE le contenu de la transcription fournie et tu appliques la méthodologie approuvée de l'entreprise.

IMPORTANT
Si l'entreprise a fourni une liste de contrôle approuvée distincte — elle a priorité sur la structure exemplaire ci-dessous.
N'invente pas de critères qui ne sont pas dans la méthodologie.

PRINCIPES DE BASE DE LA MÉTHODOLOGIE QUI DOIVENT ÊTRE VÉRIFIÉS D'APRÈS L'AUDIO
- il y a une vraie conversation avec le travailleur, et non un monologue/une inspection ;
- des questions sont posées au travailleur ;
- le travailleur nomme/discute lui-même le danger et les conséquences possibles si la situation est dangereuse ;
- la manière sûre d'effectuer le travail est discutée ;
- d'autres sources de danger et mesures de sécurité sont discutées ;
- lors d'un travail sûr, le responsable note et renforce une action sûre spécifique ;
- la communication est respectueuse ;
- la conversation se termine par une conclusion claire/un remerciement ;
- ne pas valider l'observation visuelle si elle ne peut pas être confirmée par l'audio.

ENTRÉE
- transcript: transcription complète ;
- rss_id: identifiant pseudonymisé du type RSS 1234 ;
- methodology_context: extraits/règles de la méthodologie approuvée ;
- optional_checklist: liste de contrôle locale approuvée, s'il y en a une.

RÈGLES D'ÉVALUATION
1. Utilise uniquement les faits du transcript.
2. Ne devine pas les intentions.
3. Ne reconstitue pas les noms complets d'après la voix/le contexte.
4. Si le transcript est manifestement incomplet ou incohérent — quality_status="insufficient_data" et ne donne pas d'évaluation finale.
5. Si une liste de contrôle locale est appliquée, évalue tous ses points sans omission.
6. Pour chaque conclusion, conserve un court evidence — une phrase/un contenu de la transcription confirmant la décision.

SORTIE — UNIQUEMENT JSON, SANS MARKDOWN ET SANS TEXTE AVANT/APRÈS
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3 à 5 phrases compréhensibles pour le responsable",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

VÉRIFIE AVANT DE RÉPONDRE
- le JSON est valide ;
- rss_id n'est pas modifié ;
- le point final correspond à la somme des critères ;
- evidence ne contient pas de faits inventés ;
- si les données sont insuffisantes, il n'y a pas d'overall_score_percent inventé.
Commentaire : Comme une liste de contrôle à points distincte et approuvée pour le BSD n'est pas consignée dans les documents fournis, je ne fais pas passer une échelle inventée pour la norme de l'entreprise. Dans la version de travail, vous devez insérer votre liste de contrôle réelle.
Prompt 5. Module séparé de feedback dans Telegram
Si un deuxième appel au modèle est utilisé dans le scénario, il est avantageux de le limiter uniquement au formatage de l'évaluation terminée. Cela augmente la stabilité : le deuxième module ne doit pas « repenser » les points à nouveau.
Tu reçois le JSON PRÊT de l'évaluation d'expert du BSD de l'étape précédente.
Ne réévalue pas l'enregistrement et ne modifie pas les points.

Génère une réponse courte pour l'utilisateur pour Telegram.

FORMAT
RSS : <code>
Évaluation : <pourcentage ou « non évalué — pas assez de données »>

Ce qui a été bien fait :
• 2–4 points courts de strengths

Ce qu'il faut améliorer :
• 2–4 points précis de improvements

Pour le prochain BSD :
<1–2 actions les plus précises possibles>

RÈGLES
- 700–1200 caractères maximum ;
- ton professionnel et respectueux ;
- pas de JSON technique ;
- pas de noms de famille ;
- ne pas inventer de nouvelles remarques ;
- ne pas utiliser de slogans de motivation ;
- si quality_status=insufficient_data — demander de réenregistrer/recharger l'audio et ne pas afficher l'évaluation.
Prompt 6. Normalisation du résultat avant Google Sheets
Cette étape est utile si Google Sheets doit recevoir la même structure indépendamment de la longueur du texte de l'évaluation.
Vérifie la ligne de données avant l'enregistrement dans Google Sheets.

Champs attendus :
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

RÈGLES
1. N'ajoute pas de nom complet ni de numéro de matricule.
2. rss_id doit correspondre au modèle : RSS + espace + 3–6 chiffres.
3. overall_score_percent doit être un nombre de 0–100 ou vide si insufficient_data.
4. Convertis les tableaux en chaînes courtes séparées par « ; ».
5. Si un champ obligatoire est manquant — renvoie error=true et liste les missing_fields.
6. Si tout est correct — error=false.

SORTIE UNIQUEMENT JSON :
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Audit du scénario Make terminé d'après une capture d'écran
Convient comme Prompt final pour vérifier le scénario avant un essai pilote massif.
Je t'enverrai une capture d'écran de mon scénario Make.
Effectue un audit technique comme un mentor en automatisation no-code.

Vérifie d'après la capture d'écran et ma description :
1. l'ordre des modules ;
2. les itinéraires du Router ;
3. le traitement d'un message non pris en charge ;
4. le stockage de l'état temporaire dans le Data store ;
5. la réception et le transfert du fichier audio ;
6. l'appel de l'IA ;
7. l'analyse du JSON ;
8. l'enregistrement dans Google Sheets ;
9. l'envoi du résultat dans Telegram ;
10. la branche d'erreur et de nouvelle tentative ;
11. le risque de doublons lors d'un nouveau lancement ;
12. le risque qu'un utilisateur reçoive le résultat d'un autre.

Ne propose pas une refonte complète si l'architecture actuelle fonctionne.
Liste d'abord :
- ce qui est déjà bien ;
- les 3 risques les plus critiques ;
- quelle est LA prochaine étape à faire en premier.
Après cela, arrête-toi et attends ma capture d'écran/confirmation.
Séquence pratique pour le lecteur
- Charger la méthodologie approuvée et la liste de contrôle dans le Project/agent choisi.
- Configurer le Prompt 1 et le vérifier sur plusieurs enregistrements de référence.
- Faire passer le même enregistrement plusieurs fois et appliquer le Prompt 2 pour évaluer la reproductibilité.
- Si une automatisation est requise — commencer par le Prompt 3 et assembler Make un module à la fois avec la vérification des captures d'écran.
- Dans Make, utiliser le Prompt 4 comme noyau expert et exiger un JSON strict.
- Si nécessaire, séparer le feedback de l'utilisateur dans le Prompt 5.
- Avant l'enregistrement dans Google Sheets, normaliser les données du Prompt 6.
- Avant le lancement massif, vérifier tout le schéma avec le Prompt 7.
Commentaires 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!