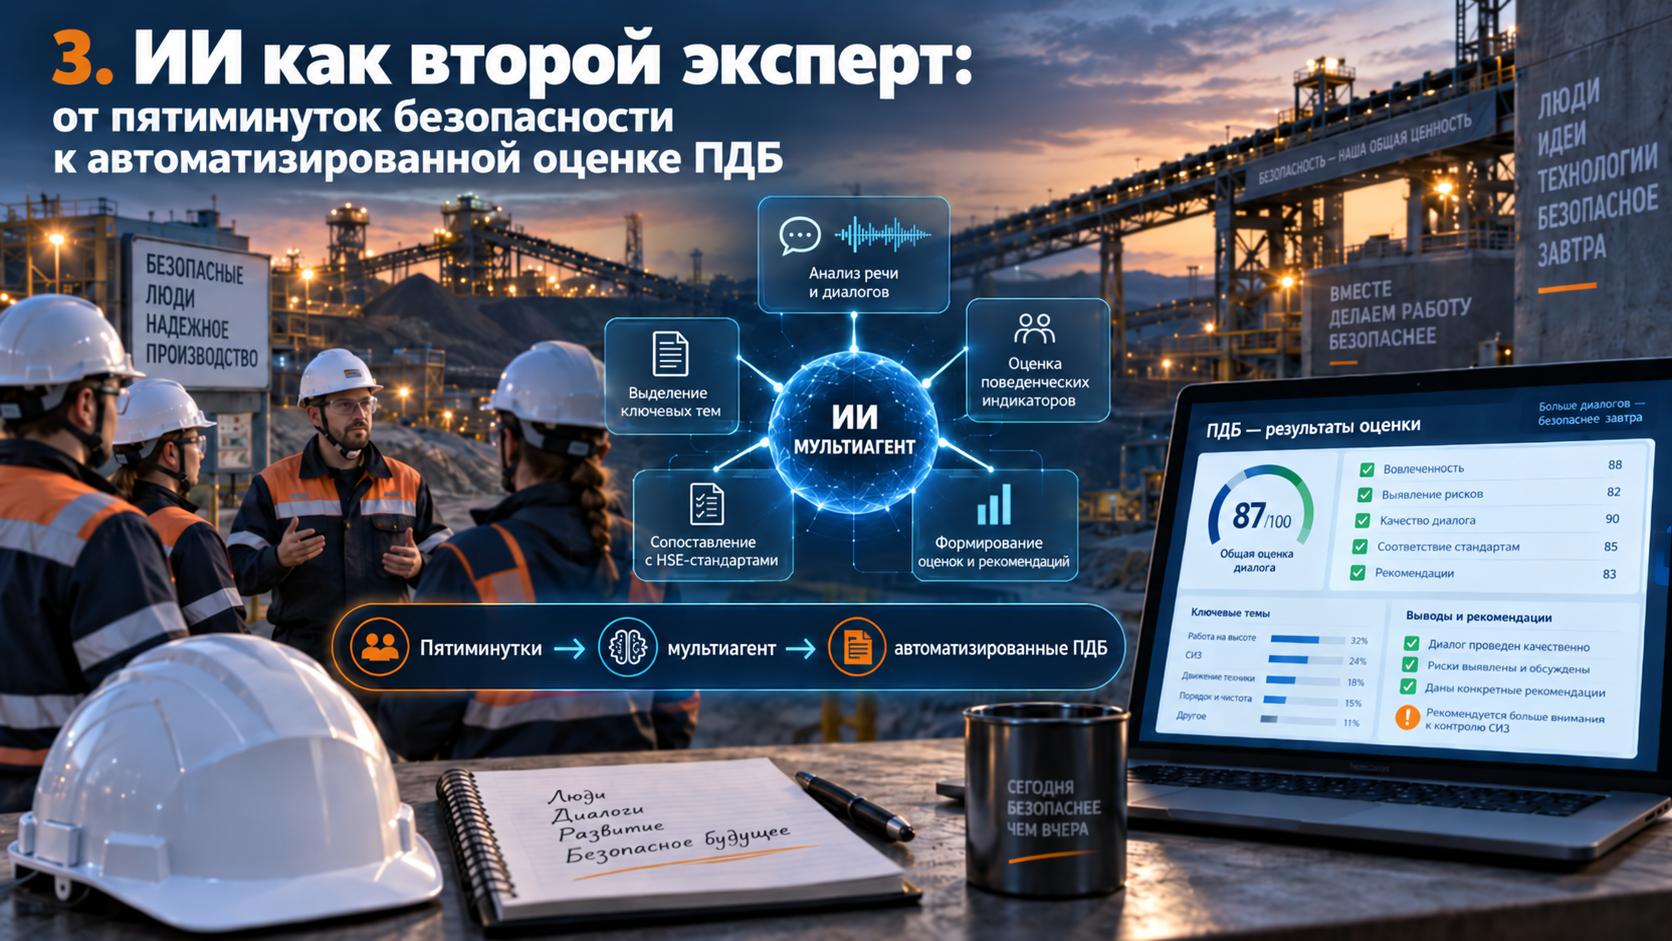
AI ในฐานะผู้เชี่ยวชาญคนที่สอง: จากการสนทนาความปลอดภัยสู่การประเมิน BSD แบบอัตโนมัติ
การพูดคุยเรื่องความปลอดภัย → การประเมินทางดิจิทัล → Make → การสนทนาพฤติกรรมความปลอดภัยอัตโนมัติ
แนวคิดหลัก: AI ไม่ได้มาแทนที่หัวหน้ากะหรือผู้เชี่ยวชาญด้านความปลอดภัย แต่มันกลายเป็น "ผู้เชี่ยวชาญคนที่สอง" เพียงหนึ่งเดียว ที่ใช้เกณฑ์เดียวกัน ให้ข้อเสนอแนะส่วนบุคคล และช่วยให้สามารถขยายการควบคุมคุณภาพไปยังการสนทนาจริงหลายร้อยหลายพันครั้ง
ทำไมเราถึงเริ่มประเมินที่บทสนทนา แทนที่จะประเมินแค่ข้อเท็จจริงว่าได้จัดทำหรือไม่
ในงานอาชีวอนามัยและความปลอดภัยทางอุตสาหกรรม การนับข้อเท็จจริงเป็นเรื่องง่าย: มีการจัดพูดคุยเรื่องความปลอดภัย มีการบันทึกการสนทนาพฤติกรรมความปลอดภัย มีการกรอกแบบฟอร์ม แต่มันยากกว่ามากที่จะตอบคำถามว่าหัวหน้างานดำเนินการสนทนาอย่างมีคุณภาพเพียงใดและบรรลุเป้าหมายหรือไม่
การพูดคุยเรื่องความปลอดภัยในวิธีการของเราเป็นส่วนบังคับของการประชุมก่อนเริ่มกะซึ่งใช้เวลา 5–10 นาที หัวหน้ากะจะต้องพิจารณาหัวข้อที่เกี่ยวข้องเฉพาะหนึ่งหัวข้อและสร้างความเชื่อมโยงที่ชัดเจน: อันตราย → ผลกระทบ → มาตรการความปลอดภัย ในขณะเดียวกัน ไม่เพียงแต่การพูดฝ่ายเดียวของโฟร์แมนเท่านั้นที่สำคัญ แต่รวมถึงการสนทนากับพนักงานด้วย: การตั้งคำถาม การตอบคำถาม และการมีส่วนร่วมในการอภิปราย
ดังนั้นงานเริ่มต้นจึงไม่ใช่ "การตรวจสอบว่ามีการบันทึกหรือไม่" แต่เป็นอย่างอื่น: เราสามารถสอน AI ให้ประเมินคุณภาพที่แท้จริงของการสนทนาเหล่านั้นในมาตรฐานเดียวกันและให้ข้อเสนอแนะที่ตรงประเด็นแก่หัวหน้างานได้หรือไม่?
ระยะที่ 1 วิธีการมาก่อน จากนั้นจึงเป็นปัญญาประดิษฐ์
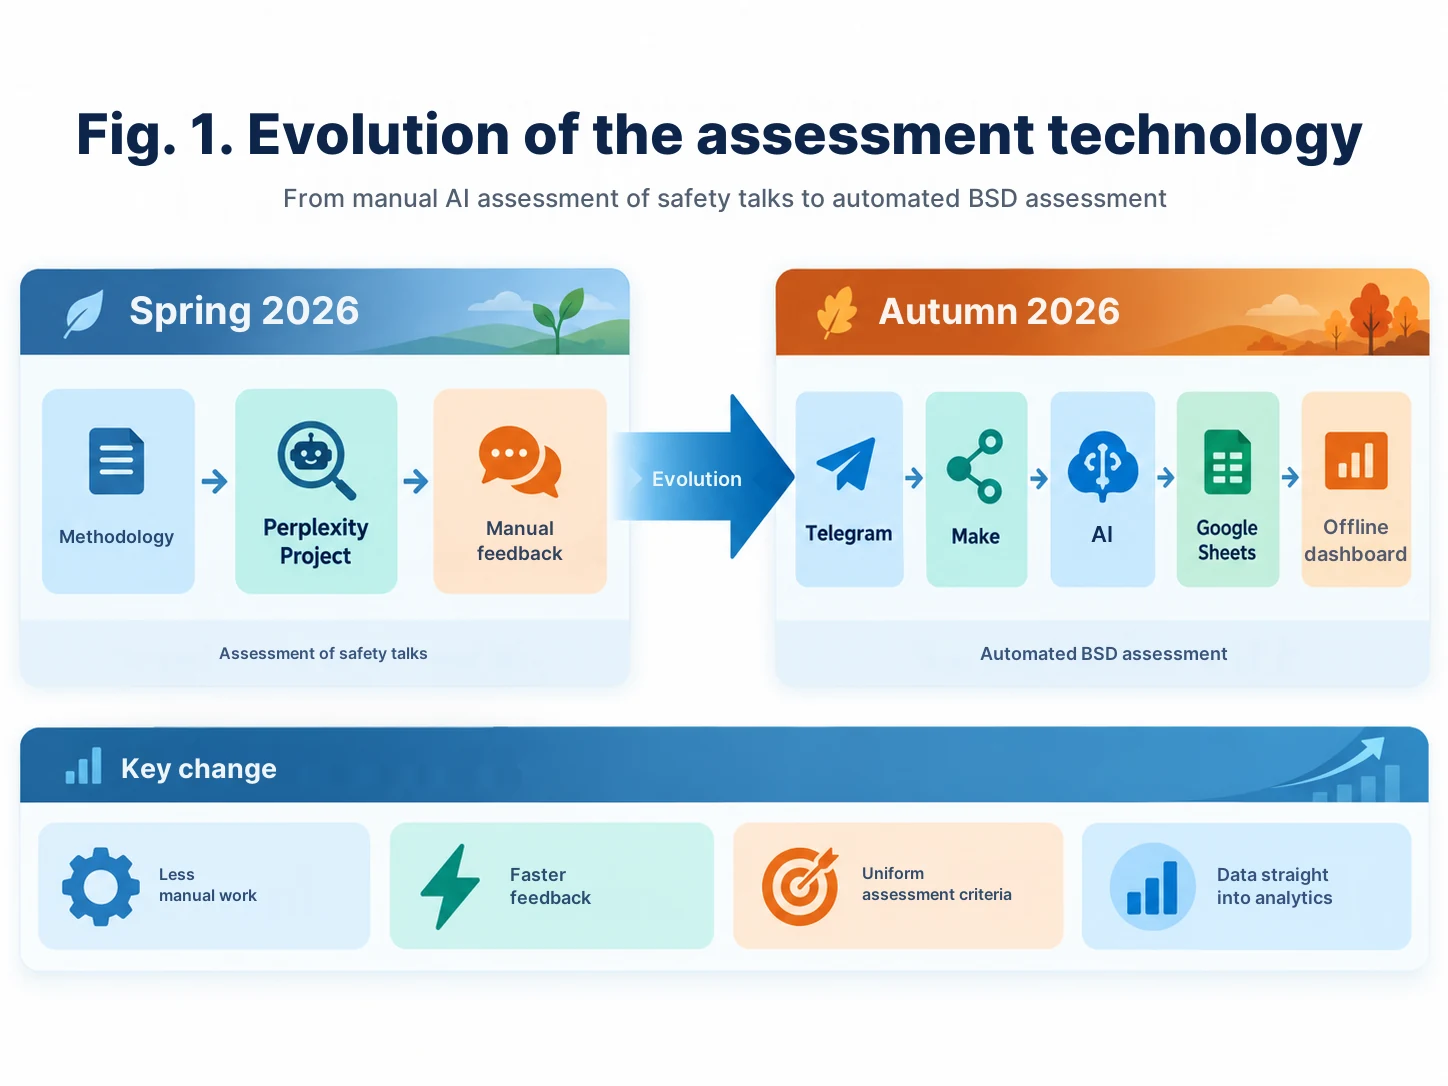
ในฤดูใบไม้ผลิปี 2026 เราเริ่มต้นด้วยการพูดคุยเรื่องความปลอดภัย ก่อนที่จะเปิดตัวการประเมินด้วย AI เราได้เตรียมคำแนะนำด้านวิธีการและวิดีโอการฝึกอบรมเกี่ยวกับวิธีดำเนินการพูดคุยเรื่องความปลอดภัยอย่างถูกต้อง หลังจากนั้นตัวประเมินผลดิจิทัลจึงถือกำเนิดขึ้น
เราใช้ Perplexity Space เป็นโครงสร้างการทำงานแรกของเรา — ปัจจุบันสภาพแวดล้อมที่คล้ายกันใน Perplexity เรียกว่า Project เราได้อัปโหลดคู่มือวิธีการและรายการตรวจสอบการประเมินลงในโปรเจกต์ และได้เตรียม Prompt ที่เข้มงวดแยกต่างหากสำหรับโมเดล
งานของ Prompt แตกต่างจากคำขอ "ประเมินการพูด" ทั่วไปโดยสิ้นเชิง AI ได้รับอนุญาตให้นับเฉพาะสิ่งที่พูดจริงๆ ในเสียงเท่านั้น หากไม่มีองค์ประกอบใด — 0 คะแนน หากมีการกล่าวถึงอย่างเป็นทางการ — ดำเนินการบางส่วน หากอธิบายอย่างมีเหตุผลและครบถ้วน — ดำเนินการเสร็จสมบูรณ์
ในรายการตรวจสอบปัจจุบันมีเจ็ดเกณฑ์: การแนะนำตัวและเป้าหมาย; อันตรายที่เฉพาะเจาะจง; ตรรกะ "อันตราย – ผลกระทบ – มาตรการความปลอดภัย"; แรงกระตุ้นทางอารมณ์; มาตรการความปลอดภัย; การสนทนากับพนักงาน; บทสรุปสุดท้ายและความเชื่อมโยงกับงานที่ทำ
Prompt 1 — เวอร์ชันปรับปรุงของ Prompt สำหรับ Perplexity Project ดูได้ในภาคผนวก
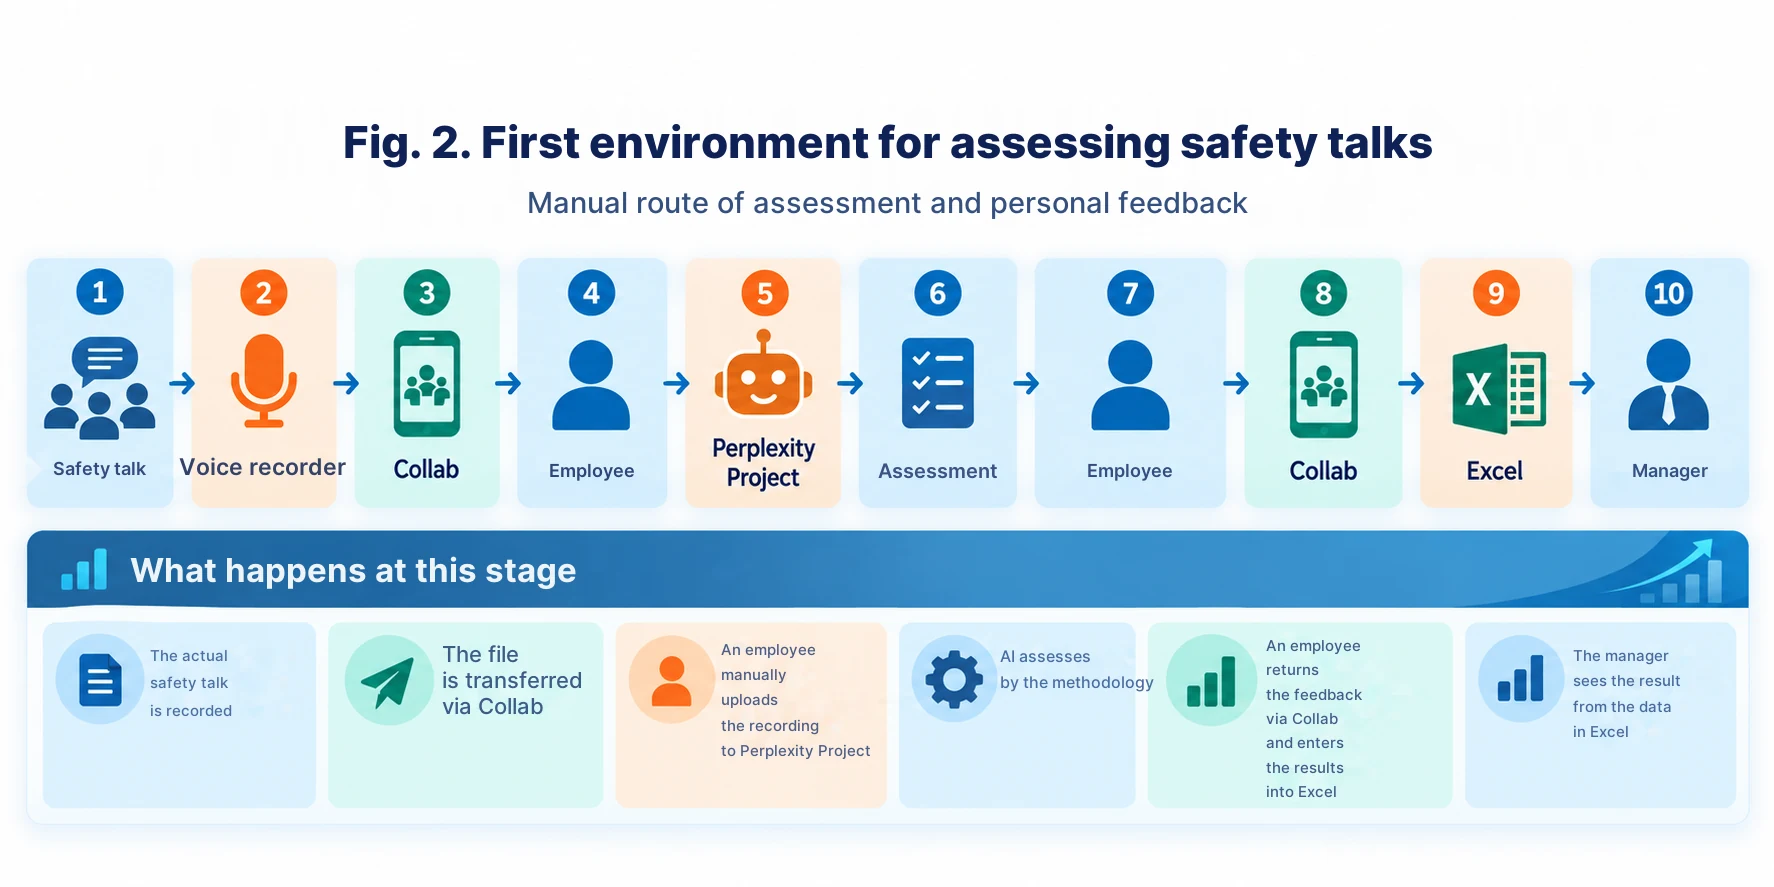
โครงสร้างการทำงานแบบแมนนวลแรกสุดมีหน้าตาอย่างไร
หัวหน้ากะจะบันทึกการพูดคุยเรื่องความปลอดภัยที่จัดขึ้นลงในเครื่องบันทึกเสียง ไฟล์บันทึกจะถูกส่งไปยังพนักงานที่ได้รับมอบหมายผ่านแอปพลิเคชันขององค์กรที่ชื่อ Collab พนักงานจะอัปโหลดไฟล์เสียงลงใน Perplexity Project รับผลการประเมิน และส่งคืนข้อเสนอแนะส่วนบุคคลไปยังหัวหน้ากะผ่าน Collab เช่นกัน
ในเวลาเดียวกัน ผลลัพธ์จะถูกป้อนลงใน Excel: แผนก หัวหน้ากะ คะแนน จำนวนครั้งที่พยายาม จากตารางนี้ เราได้สร้างการวิเคราะห์อย่างง่าย — ผลลัพธ์เฉลี่ยของแผนก แนวโน้ม และจำนวนรอบของการทำซ้ำ
เรายอมรับ 80% เป็นระดับผ่านสำหรับรอบปฏิบัติ หากผลลัพธ์ต่ำกว่านั้น หัวหน้ากะจะดำเนินการพูดคุยเรื่องความปลอดภัยครั้งต่อไปโดยคำนึงถึงข้อสังเกตของ AI ไม่ได้เป็นเพียงแค่การควบคุม แต่ยังเป็นการฝึกอบรมรายบุคคลที่หน้างานโดยตรงอีกด้วย
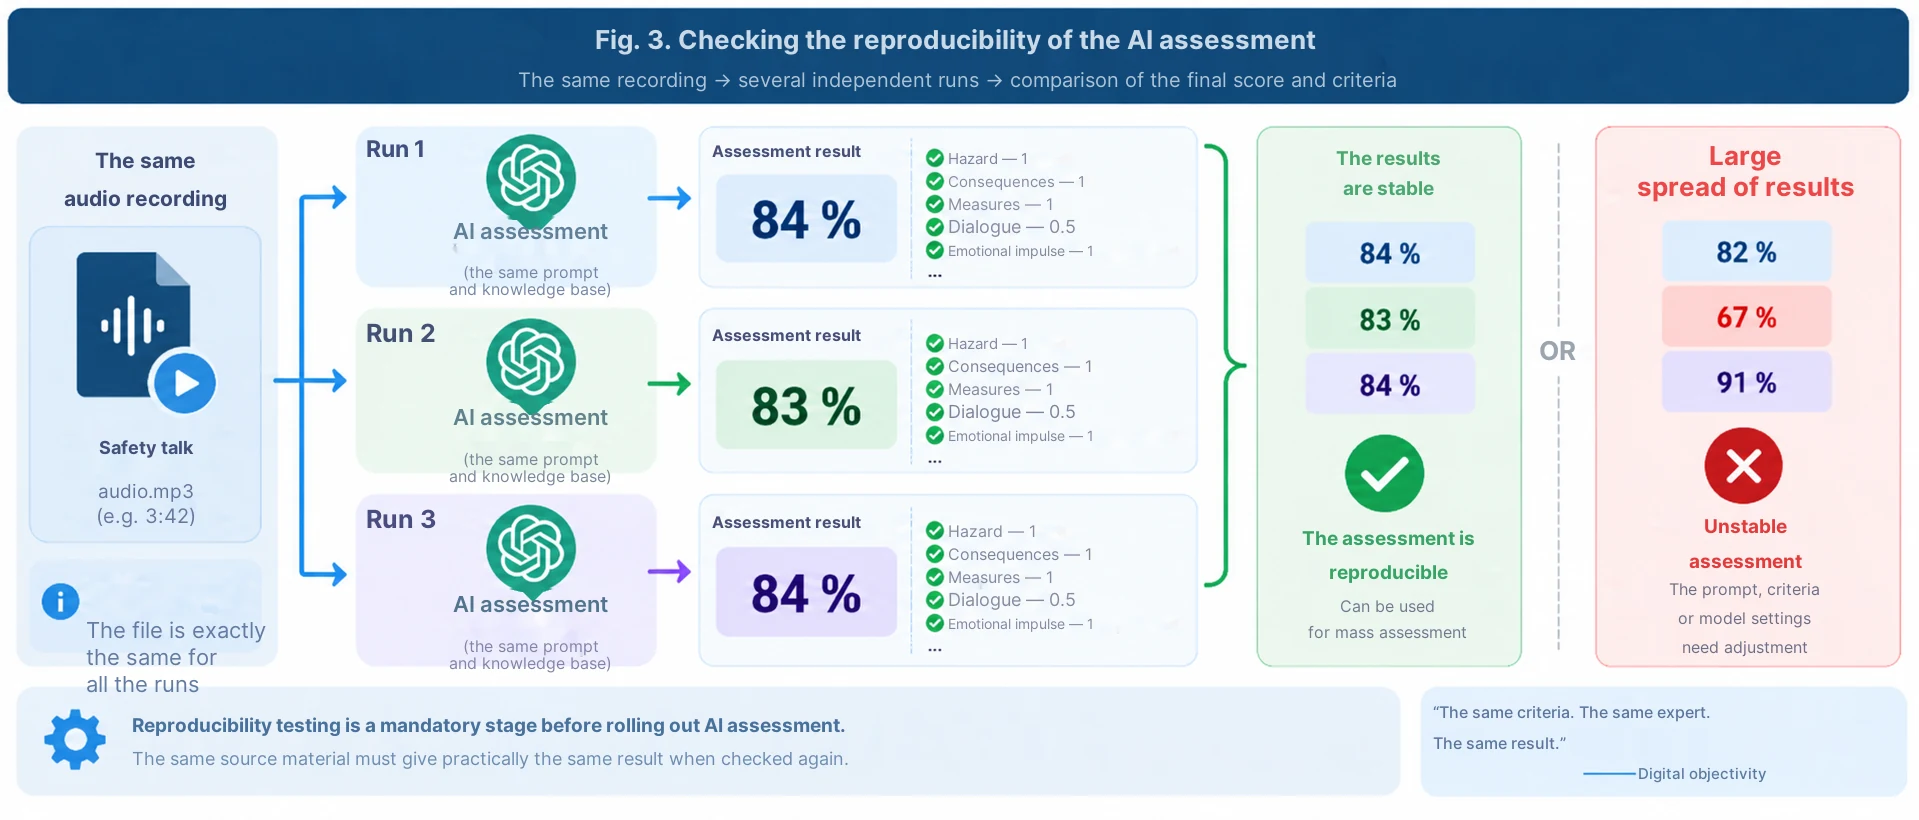
เราไม่ได้ทดสอบแค่มนุษย์เท่านั้น — ตอนแรกเราทดสอบตัว AI เองด้วย
สำหรับผม นี่คือหนึ่งในองค์ประกอบที่สำคัญที่สุดของกระบวนการทั้งหมด เราตั้งใจส่งไฟล์เสียงเดียวกันไปประเมินหลายครั้ง หากเนื้อหาเดียวกันได้คะแนน 82% ในวันนี้ แล้วอีกนาทีต่อมาได้ 65% และหลังจากนั้นได้ 91% ผู้เชี่ยวชาญด้านดิจิทัลแบบนี้ยังไม่พร้อมที่จะประเมินผู้คน
ดังนั้นเราจึงบรรลุถึงความสามารถในการทำซ้ำ: การบันทึกเดียวกันจะต้องให้คะแนนเท่ากันหรือเกือบเท่ากัน หากพบความคลาดเคลื่อนที่ชัดเจน เราจะปรับแก้ Prompt ระบุเกณฑ์ให้ชัดเจนขึ้น และลบข้อความที่กำกวมออก
สำหรับตัวผมเอง ผมเรียกสิ่งนี้ว่า "ความเป็นกลางทางดิจิทัล" นี่ไม่ได้หมายความว่า AI มีความจริงที่สมบูรณ์แบบ มันเป็นอีกเรื่องหนึ่ง: ผู้เชี่ยวชาญคนเดียวใช้มาตราส่วนเดียวกันกับทุกคน และไม่ขึ้นอยู่กับอารมณ์ ความชอบส่วนตัว หรือใครก็ตามที่เป็นผู้ทำการประเมินในวันนี้
Prompt 2 — โปรโตคอลเพื่อตรวจสอบความสามารถในการทำซ้ำของการประเมิน ดูได้ในภาคผนวก
ทำไมโครงสร้างแบบแมนนวลถึงไม่ตอบโจทย์อีกต่อไป
สำหรับโครงการนำร่อง เส้นทางแบบแมนนวลนั้นสะดวก: รับไฟล์ อัปโหลด รอผล ส่งข้อเสนอแนะกลับ และป้อนคะแนนลงใน Excel แต่วิธีการนี้มีขีดจำกัดตามธรรมชาติ
เมื่อปริมาณถูกวัดเป็นร้อยและพันไฟล์บันทึก เราไม่ได้เริ่มที่จะประเมินแบบอัตโนมัติ แต่เริ่มสร้างงานธุรการใหม่รอบๆ การประเมิน ดังนั้นในการเปลี่ยนไปสู่การสนทนาพฤติกรรมความปลอดภัย (BSD) งานจึงถูกกำหนดแตกต่างออกไป: ให้นำคนออกจากห่วงโซ่ทางเทคนิคในจุดที่การมีส่วนร่วมของพวกเขาไม่ได้สร้างมูลค่า
ระยะที่ 2 การสนทนาพฤติกรรมความปลอดภัยซับซ้อนกว่าการพูดคุยเรื่องความปลอดภัยทั่วไป
การสนทนาพฤติกรรมความปลอดภัย (BSD) ไม่ใช่แค่การพูดสั้นๆ วิธีการนี้รวมถึงการสังเกตการทำงานจริงและการสนทนากับบุคคล เป็นสิ่งสำคัญที่หัวหน้างานจะต้องเห็นพฤติกรรมที่ปลอดภัยหรืออันตราย จากนั้นผ่านการตั้งคำถาม เพื่อให้พนักงานระบุอันตราย ผลกระทบ และวิธีที่ปลอดภัยในการปฏิบัติงานด้วยตนเอง
หากพนักงานทำงานอย่างเป็นอันตราย ส่วนสำคัญของการสนทนาคือการอภิปรายถึงอันตรายและผลกระทบ จากนั้นจึงเป็นวิธีการทำงานที่ปลอดภัยและแหล่งที่มาของอันตรายอื่นๆ หากบุคคลนั้นทำงานอย่างปลอดภัย หัวหน้างานจะต้องสังเกตและเสริมสร้างพฤติกรรมที่ถูกต้อง จากนั้นจึงใช้การสนทนาเพื่ออภิปรายปัญหาด้านความปลอดภัยอื่นๆ
นี่คือเหตุผลที่โครงสร้างการประเมินของ BSD ต้องตรวจสอบไม่เพียงแต่คำพูดของหัวหน้างานเท่านั้น แต่รวมถึงการมีอยู่ของบทสนทนาที่แท้จริง: มีการถามคำถามหรือไม่ พนักงานตอบหรือไม่ มีการอภิปรายสาเหตุของพฤติกรรม ผลกระทบ การดำเนินการที่ปลอดภัย และบทสรุปของการสนทนาหรือไม่
ตัวระบุที่เป็นนามแฝงแทนนามสกุล
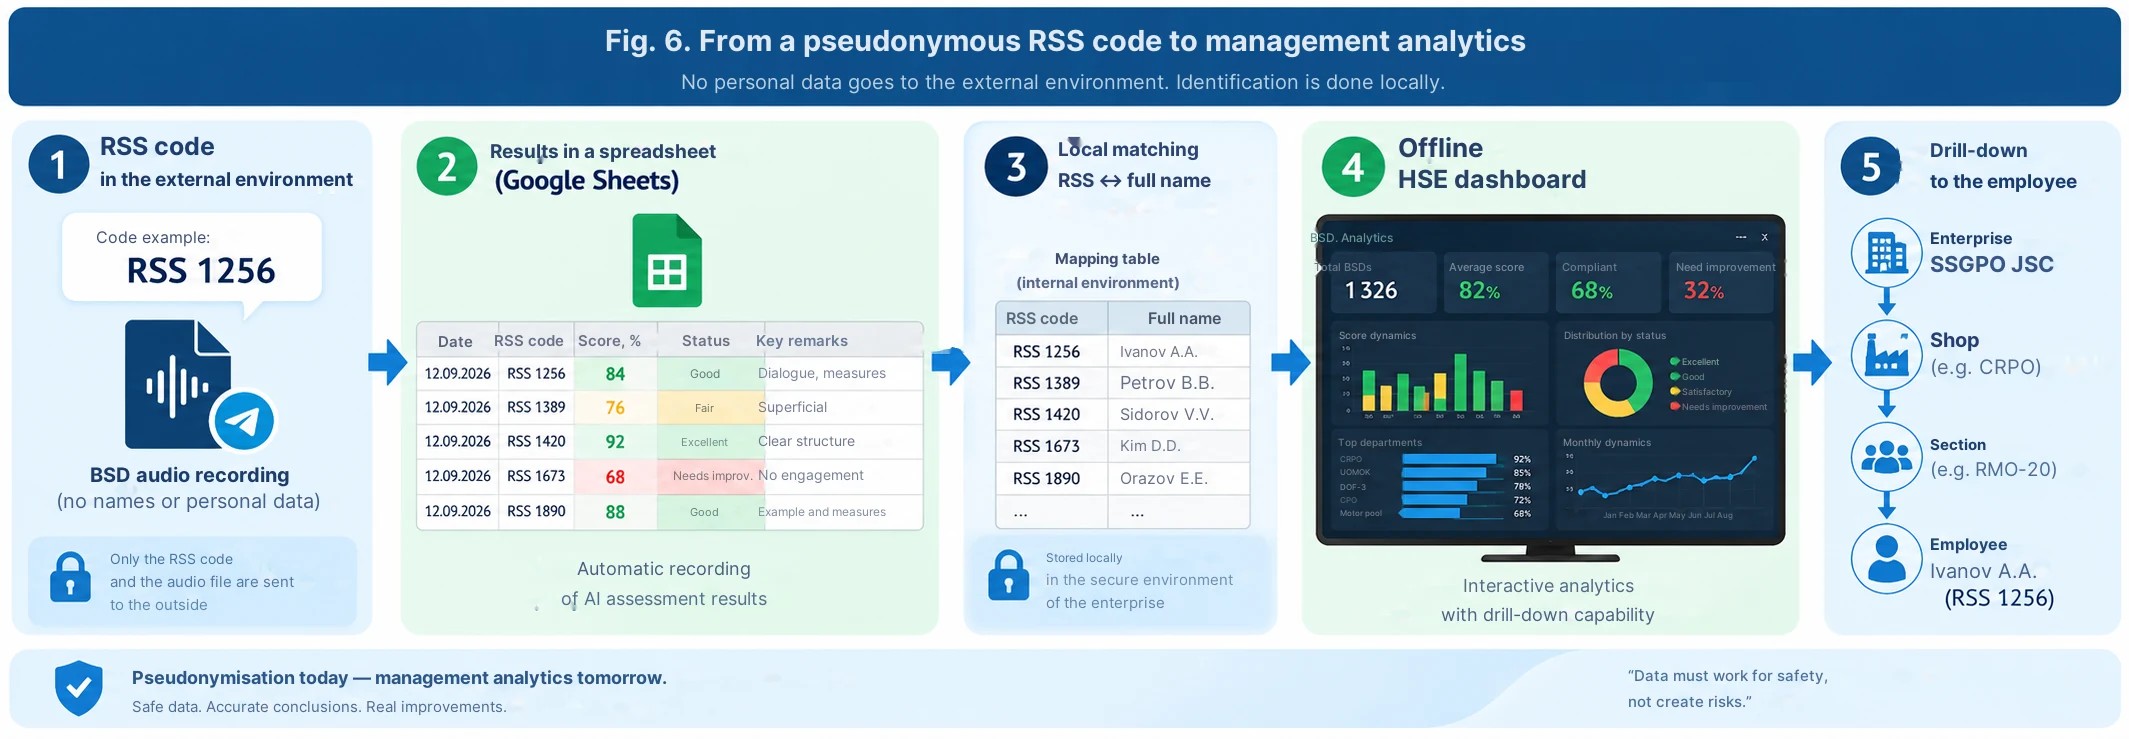
ระหว่างการทำระบบอัตโนมัติจำนวนมาก เราได้แก้ปัญหาการระบุตัวตนแยกต่างหาก ภายในขอบเขตองค์กร ERGIS ผู้เข้าร่วมแต่ละคนจะได้รับรหัสพิเศษในรูปแบบ RSS 1256 นี่ไม่ใช่หมายเลขพนักงานหรือนามสกุล
ก่อนเริ่มการบันทึกเสียง หัวหน้างานจะพูดรหัส RSS ของตนเอง หลังจากนั้นจึงทำการสนทนาพฤติกรรมความปลอดภัย (BSD) ในการสนทนาไม่จำเป็นต้องระบุนามสกุลหรือหมายเลขพนักงาน ความสัมพันธ์ระหว่าง "รหัส RSS ↔ พนักงานเฉพาะบุคคล" จะอยู่ภายในขอบเขตองค์กรและจะใช้ในภายหลังสำหรับการวิเคราะห์ข้อมูลในเครื่อง
ในที่นี้ควรพูดว่าไม่ใช่การทำให้ข้อมูลไม่สามารถระบุตัวตนได้โดยสมบูรณ์ แต่เป็นการใช้นามแฝง: ในไฟล์เสียงยังคงมีเสียงของบุคคลอยู่ แต่ปริมาณของข้อมูลส่วนบุคคลที่ผ่านระบบอัตโนมัติจะลดลงอย่างมาก
ความลับเล็กๆ: ผมไม่ใช่โปรแกรมเมอร์
เราสร้างสถาปัตยกรรมของโซลูชันใหม่ผ่าน Make ผมไม่ใช่โปรแกรมเมอร์ และในช่วงเริ่มต้นของการทำงาน ผมได้บอก ChatGPT ในเรื่องนี้โดยตรง
คำขอนั้นเรียบง่าย: "แนะนำฉันในการสร้างระบบอัตโนมัตินี้ทีละขั้นตอน ให้ดำเนินการทีละหนึ่งการกระทำ ฉันจะดำเนินการใน Make และส่งภาพหน้าจอ หลังจากที่ตรวจสอบแล้ว ให้คำสั่งถัดไป"
และสิ่งที่เกิดขึ้นต่อไปก็เป็นไปตามนั้น ChatGPT อธิบายว่าควรสร้างโมดูลไหนและต้องกรอกอะไรบ้าง; ผมดำเนินการและส่งภาพหน้าจอ; หลังจากได้รับการตรวจสอบ ผมก็จะได้รับขั้นตอนถัดไป บอท Telegram ถูกสร้างขึ้นในลักษณะเดียวกันและเชื่อมโยงเครือข่ายทั้งหมด
นี่เป็นข้อสรุปที่สำคัญสำหรับผมจากการปฏิบัติแบบ vibe-coding: ผู้เชี่ยวชาญไม่จำเป็นต้องรู้ syntax ของ API หรือ Make ล่วงหน้า แต่เขาต้องเข้าใจกระบวนการผลิตเป็นอย่างดี รวมถึงผลลัพธ์ที่ผู้ใช้ควรจะได้รับ และสามารถตรวจสอบแต่ละขั้นตอนตามลำดับได้
Prompt 3 — Prompt เริ่มต้น "แนะนำฉันทีละขั้นตอนผ่าน Make" ดูได้ในภาคผนวก
สิ่งที่เกิดขึ้นในตอนนี้: Telegram → Make → AI → ผลลัพธ์
โครงสร้างสมัยใหม่ทำงานเกือบจะไม่มีผู้ปฏิบัติงานแบบแมนนวล หัวหน้างานส่งไฟล์เสียงไปยังบอท Telegram จากนั้น Make จะรับไฟล์ ตรวจสอบข้อมูลนำเข้า และเริ่มเส้นทางการประมวลผล AI จะวิเคราะห์การบันทึกตามวิธีการที่กำหนด สร้างการประเมินและข้อเสนอแนะ ผลลัพธ์จะถูกส่งกลับไปยังผู้ใช้ และในเวลาเดียวกันก็บันทึกลงใน Google Sheets สำหรับการวิเคราะห์ทั่วไป
ในโครงการนำร่องปัจจุบัน ข้อเสนอแนะจะถูกส่งกลับในเวลาประมาณหลายสิบวินาที สำหรับผู้ใช้มันดูเรียบง่าย: ส่งไฟล์เสียง — ได้รับการประเมิน จุดแข็ง ข้อผิดพลาดเฉพาะจุด และสิ่งที่ควรเปลี่ยนในครั้งต่อไป
ในแผนภาพของ Make คุณสามารถเห็นว่าเบื้องหลังความเรียบง่ายนี้มีเส้นทางที่สมบูรณ์ซ่อนอยู่: Telegram, Data store, Router, OpenAI, Google Sheets, การตรวจสอบ และข้อความส่งกลับถึงผู้ใช้
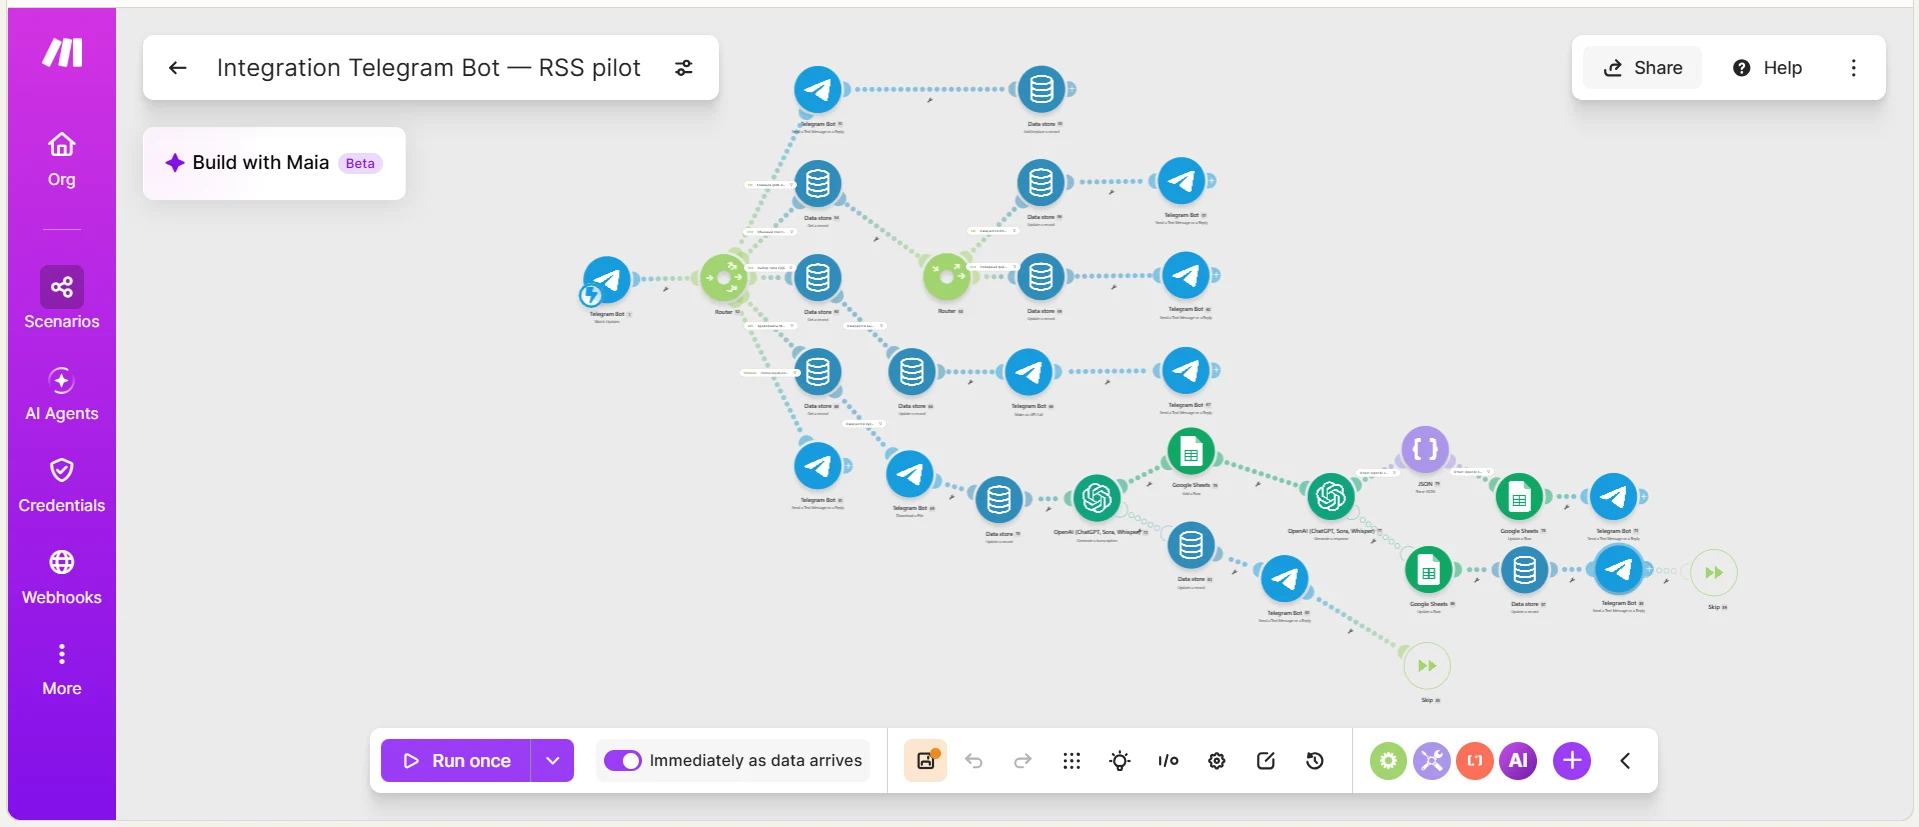
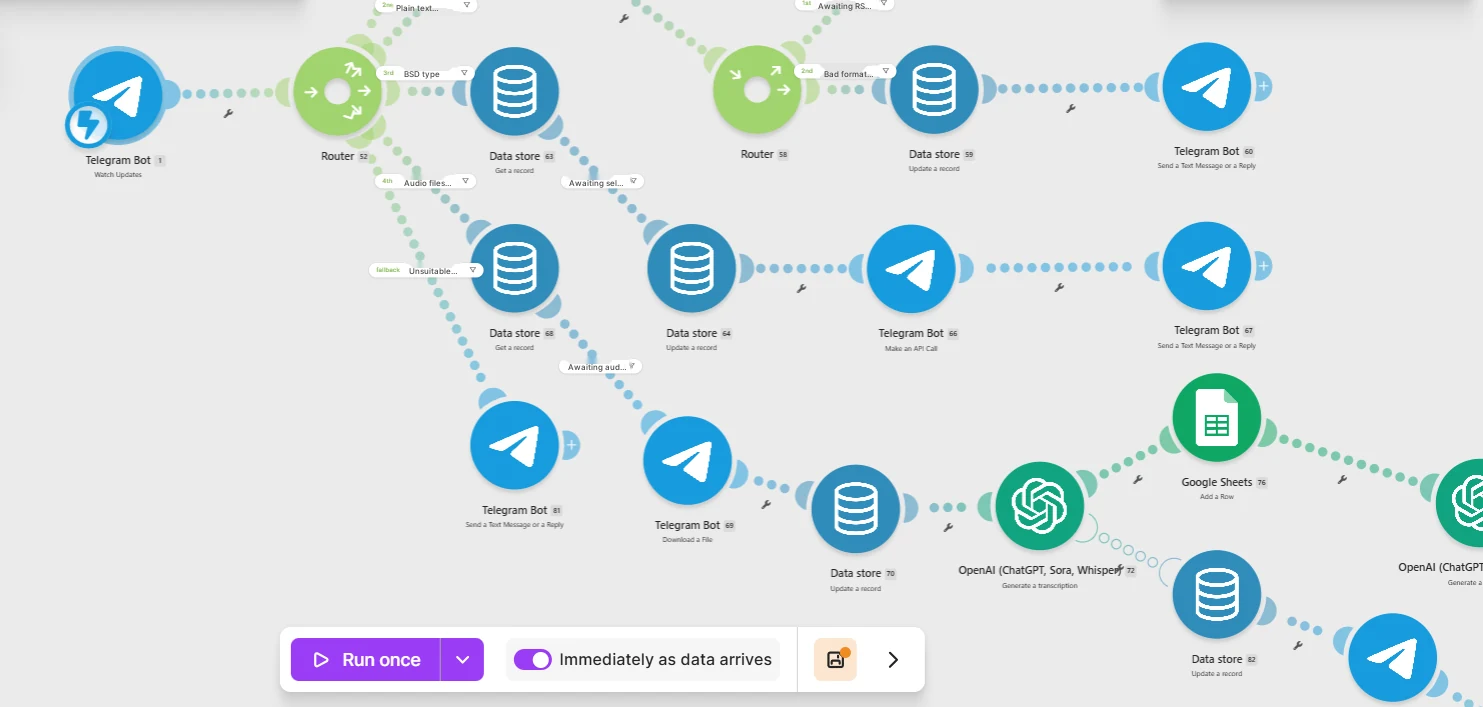
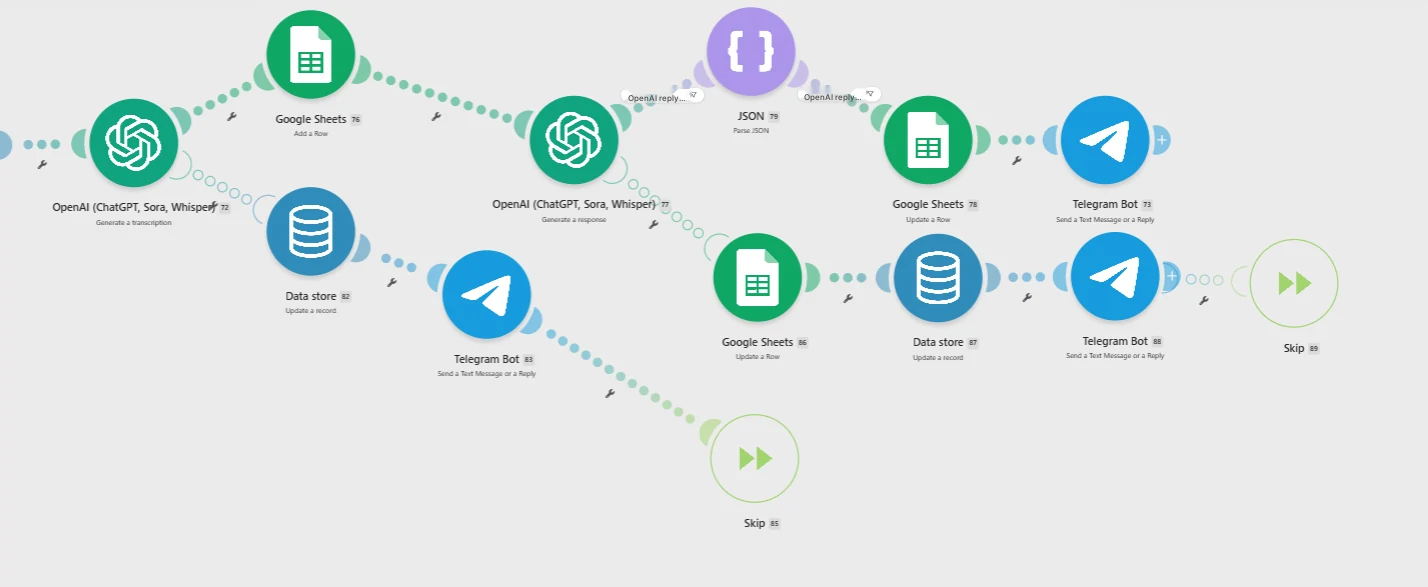
นี่คือระบบมัลติเอเจนต์หรือไม่?
ผมจะไม่ใช้คำว่า "มัลติเอเจนต์" ที่นี่เพียงเพื่อให้ดูเท่เท่านั้น ในทางปฏิบัติ เรามีกระบวนการของผู้เชี่ยวชาญแบบหลายขั้นตอน ซึ่งส่วนต่างๆ ของซีนาริโอทำหน้าที่ต่างกัน: การรับและกำหนดเส้นทางไฟล์, การดึงรหัสประจำตัว, การวิเคราะห์เนื้อหา, การประเมินโดยผู้เชี่ยวชาญ, การสร้างผลลัพธ์ที่มีโครงสร้าง, การบันทึกลงในตาราง และการให้ข้อเสนอแนะรายบุคคล
หากการเรียกโมเดลแยกกันหลายๆ ครั้งทำงานโดยมีบทบาทของระบบที่ต่างกัน — ตัวอย่างเช่น ตัวหนึ่งวิเคราะห์บทสนทนา ตัวที่สองควบคุมความสอดคล้องกับระเบียบวิธีและจัดรูปแบบผลลัพธ์ — สิ่งนี้ก็สามารถมองว่าเป็นตรรกะแบบมัลติเอเจนต์หรือหลายเอเจนต์ได้ หากการเรียกโมเดลเพียงครั้งเดียวทำหน้าที่ทั้งหมด จะซื่อสัตย์กว่าถ้าเรียกมันว่าผู้ประเมิน AI แบบอเนกประสงค์
ในภาคผนวก ผมจึงแบ่ง Prompt ตามฟังก์ชันการทำงาน แทนที่จะเรียกแต่ละฟังก์ชันว่าเป็นเอเจนต์แยกต่างหาก
การประเมิน BSD อัตโนมัติทำงานอย่างไร
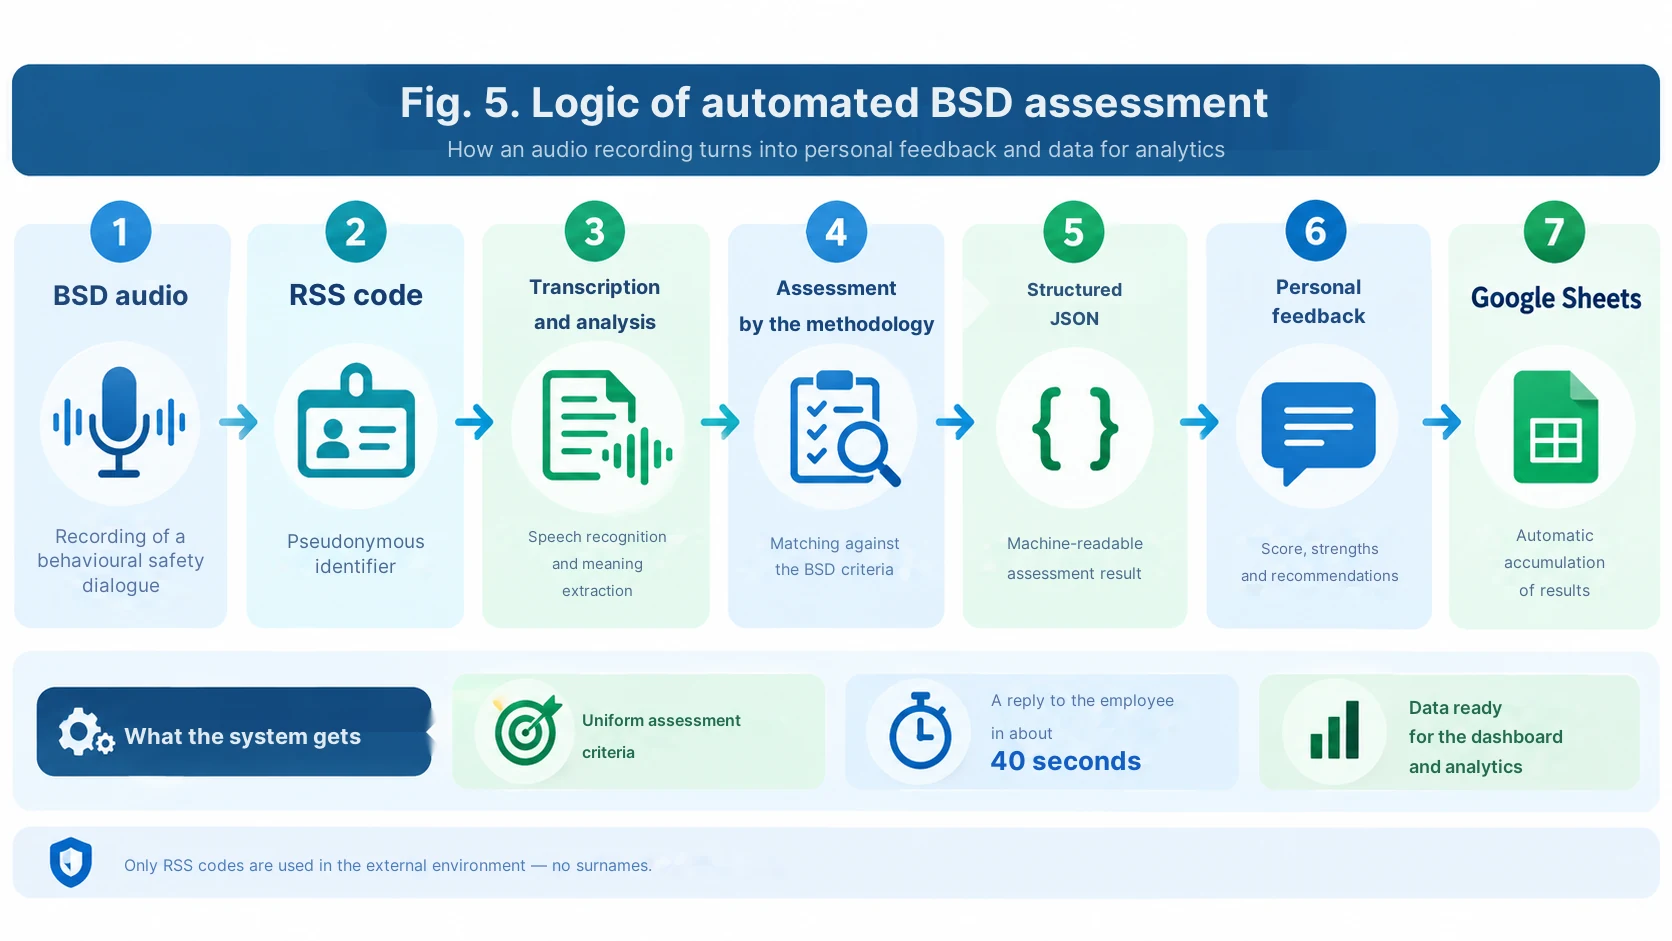
ในซีนาริโอทางอุตสาหกรรม สิ่งสำคัญคือต้องแยกงานออกเป็นสองส่วน ส่วนแรก — ด้านผู้เชี่ยวชาญ: ประเมินเนื้อหาของการสนทนาอย่างเคร่งครัดตามระเบียบวิธี ส่วนที่สอง — ด้านเทคนิค: ส่งคืนผลลัพธ์ในรูปแบบที่ Make จะเข้าใจและสามารถบันทึกลงใน Google Sheets ได้
ดังนั้น สำหรับการทำงานอัตโนมัติ การตอบกลับเป็น JSON ที่มีโครงสร้างจึงสะดวก: รหัส RSS, คะแนนรวม, สถานะ, จุดแข็ง, จุดที่ควรปรับปรุง, ข้อเสนอแนะสั้นๆ และเกณฑ์การประเมินแต่ละข้อ รูปแบบนี้ช่วยลดความเสี่ยงที่การทำงานอัตโนมัติจะ "พัง" เนื่องจากข้อความที่สวยงามแต่คาดเดาไม่ได้จากโมเดล
ในขณะเดียวกัน กฎที่เข้มงวดยังคงเหมือนเดิมกับช่วงฤดูใบไม้ผลิที่ผ่านมา: ไม่นับสิ่งที่ไม่ปรากฏในการบันทึก; ไม่คาดเดาเจตนา; ไม่เติมคำตอบที่ถูกต้องแทนหัวหน้างาน หากการถอดความไม่สมบูรณ์ — ควรส่งไฟล์บันทึกไปอัปโหลดซ้ำ แทนที่จะให้คะแนนที่แต่งขึ้นมาเอง
Prompts 4–6 — การประเมิน BSD, JSON ที่มีโครงสร้าง และการสร้างข้อเสนอแนะ ดูได้ในภาคผนวก
จากการประเมินรายบุคคลสู่ภาพรวมระดับแผนก
หลังจากการประเมินแต่ละครั้ง สิ่งที่สะสมใน Google Sheets จะไม่ใช่แค่ข้อเสนอแนะที่เป็นข้อความอีกต่อไป แต่เป็นชุดข้อมูลที่มีโครงสร้าง ดังนั้นเราจึงสามารถเห็นจำนวน BSD ที่จัดทำขึ้น, ผลลัพธ์เฉลี่ย, ข้อผิดพลาดหลักที่เกิดขึ้นซ้ำๆ, พลวัต และผลลัพธ์ตามรหัส RSS ที่ทำ pseudonymisation
ขั้นตอนต่อไปเราคุ้นเคยกันดีจากบทความที่สองแล้ว: จับคู่รหัส RSS กับชื่อ-นามสกุลแบบโลคัลในระบบภายในองค์กร และอัปโหลดผลลัพธ์ลงในแดชบอร์ด HSE แบบออฟไลน์ จากนั้นหัวหน้างานก็จะเห็นภาพรวมขององค์กร โรงงาน และพื้นที่ทำงาน และหากจำเป็น ก็สามารถเจาะลึกลงไปถึงตัวพนักงานแต่ละคนได้
กล่าวง่ายๆ คือ ระบบการประเมินภายนอกสามารถทำงานได้โดยไม่ต้องใช้นามสกุล และภาพรวมด้านการจัดการที่สมบูรณ์จะถูกกู้คืนภายในองค์กรเท่านั้น
แนวคิดนี้สามารถนำไปทำซ้ำโดยไม่ใช้สถาปัตยกรรมของเราได้อย่างไร
สาระสำคัญของแนวทางนี้ไม่ได้ผูกติดอยู่กับแบรนด์ AI เพียงแบรนด์เดียว ในรูปแบบที่ง่ายที่สุด คุณสามารถสร้าง Perplexity Project ที่มีระเบียบวิธีและ Prompt สำหรับประเมิน คุณสามารถใช้ ChatGPT พร้อมคำแนะนำแบบถาวรและฐานความรู้ที่อัปโหลดไว้ คุณสามารถสร้างโครงร่างโดยใช้ Google NotebookLM / Gemini เป็นแหล่งข้อมูลสำหรับระเบียบวิธี และทำการประเมินด้วยโมเดลอื่นต่างหาก สำหรับกระแสงานจำนวนมาก การใช้ Make หรือแพลตฟอร์มการทำงานอัตโนมัติอื่นๆ ร่วมกับ Telegram, OpenAI และระบบตารางจะสะดวกกว่า
องค์ประกอบหลักยังคงเหมือนเดิม: ระเบียบวิธีที่ได้รับอนุมัติ → Prompt ที่เข้มงวด → การตรวจสอบ reproducibility → มาตรวัดที่เข้าใจง่าย → ข้อเสนอแนะรายบุคคล → การสะสมผลลัพธ์ที่มีโครงสร้าง
มีอะไรเปลี่ยนแปลงไปบ้างในช่วงไม่กี่เดือนที่ผ่านมา
เมื่อฤดูใบไม้ผลิ พนักงานคนหนึ่งต้องย้ายไฟล์เสียงเข้า AI ด้วยตนเองและส่งคืนผลลัพธ์ วันนี้เราสร้างระบบที่สามารถรับและประเมินไฟล์บันทึก BSD ได้ประมาณ 1,300 รายการ โดยไม่ต้องมีเจ้าหน้าที่แยกต่างหากสำหรับแต่ละไฟล์
แต่การเปลี่ยนแปลงที่สำคัญที่สุดไม่ใช่เรื่องความเร็ว เราได้รับความสามารถในการใช้เกณฑ์เดียวกันกับบทสนทนาจริงจำนวนมาก และเปลี่ยนการประเมินแต่ละครั้งให้เป็นวงจรการเรียนรู้สั้นๆ ระดับบุคคล
AI ในโครงร่างนี้ ไม่ใช่ผู้ตรวจสอบที่คอยจับผิด แต่เป็นทั้งผู้เชี่ยวชาญคนที่สองและโค้ชดิจิทัลในเวลาเดียวกัน: มันบันทึกความไม่สอดคล้องกับระเบียบวิธี อธิบายอย่างชัดเจนว่าต้องปรับปรุงอะไร และเปิดโอกาสให้ตรวจสอบสิ่งนี้ได้ในการสนทนาครั้งถัดไป
บทสรุป
เมื่อเราเริ่มต้น งานนี้ฟังดูเหมือนการทดลอง: AI จะสามารถประเมินการพูดคุยเรื่องความปลอดภัย (toolbox talk) ได้หรือไม่ ผลลัพธ์ที่ได้คือเทคโนโลยีที่สามารถขยายขนาดไปสู่การสนทนาเชิงพฤติกรรม การฝึกอบรม และการสื่อสารด้านความปลอดภัยประเภทอื่นๆ
สำหรับผม ผลลัพธ์ที่มีค่าที่สุดไม่ใช่ตัวเลขอัตโนมัติ คุณค่าอยู่ที่การที่หัวหน้างานได้รับข้อเสนอแนะแทบจะในทันทีหลังจากการสนทนาจริง และในขณะเดียวกันองค์กรก็ได้รับชุดข้อมูลจำนวนมากเกี่ยวกับองค์ประกอบของระเบียบวิธีที่ผู้คนมักมองว่าเป็นเรื่องยาก
และ ณ จุดนี้นี่เองที่ AI เริ่มทำงาน โดยไม่ได้มาแทนที่ระบบจัดการด้านความปลอดภัย แต่ทำงานอยู่ภายในระบบนั้น — ในฐานะผู้เชี่ยวชาญคนที่สองที่มีมาตรฐานเดียวกัน
Prompt สำหรับบทความ "AI ในฐานะผู้เชี่ยวชาญคนที่สอง"
การพูดคุยเรื่องความปลอดภัย (toolbox talk), การตรวจสอบ reproducibility, Make และการประเมิน BSD อัตโนมัติ
นี่คือเวอร์ชันตีพิมพ์ของ Prompt ซึ่งอิงตามระเบียบวิธีจริงและสถาปัตยกรรมการทำงานของเรา แต่ก่อนที่จะนำไปใช้ในองค์กรอื่น จำเป็นต้องเปลี่ยนเกณฑ์และเกณฑ์ขั้นต่ำให้เป็นไปตามข้อกำหนดท้องถิ่นที่ได้รับอนุมัติ
Prompt 1. การประเมินการพูดคุยเรื่องความปลอดภัย (toolbox talk) ฉบับปรับปรุงใหม่ใน Perplexity Project
นี่คือเวอร์ชันตีพิมพ์ฉบับปรับปรุงของ Prompt ที่ใช้งานอยู่ ผมได้แก้ไขข้อขัดแย้งภายในแล้ว: ตอนนี้เช็คลิสต์มี 7 เกณฑ์อย่างแท้จริง และเกณฑ์ผ่านขั้นต่ำอยู่ที่ 80% เท่ากันทั้งหมด
คุณรับบทเป็นผู้เชี่ยวชาญด้านอาชีวอนามัยและความปลอดภัยทางอุตสาหกรรม ซึ่งทำหน้าที่ประเมินคุณภาพการจัดการพูดคุยเรื่องความปลอดภัยโดยหัวหน้ากะ

แหล่งข้อมูลและลำดับความสำคัญ
1. บันทึกเสียงการพูดคุยเรื่องความปลอดภัย
2. คู่มือระเบียบวิธีที่ได้รับการอนุมัติขององค์กร
3. รายการตรวจสอบ (เช็คลิสต์) การประเมินที่ได้รับการอนุมัติ
หากมีข้อขัดแย้งของถ้อยคำ ให้ยึดตามรายการตรวจสอบและระเบียบวิธีที่ได้รับการอนุมัติ ห้ามเพิ่มเกณฑ์ของคุณเอง

ขั้นตอนที่ 1. การถอดความฉบับเต็ม
- ขั้นแรก ให้รับการถอดความเสียงฉบับเต็ม ไม่ใช่บทสรุปแบบย่อ
- สำหรับ Perplexity Project ให้ใช้เครื่องมืออ่านไฟล์เสียงที่แนบมาในโหมดเต็มรูปแบบ (READ / context budget สูงสุดที่ใช้ได้)
- ทำเครื่องหมายส่วนที่ฟังไม่ออกว่า [ฟังไม่ออก]
- หากตรวจจับเสียงพูดได้ต่อเนื่องน้อยกว่า 80% หรือส่วนสำคัญของบันทึกหายไป ให้ตอบเพียงว่า: «ข้อมูลไม่เพียงพอ โปรดอัปโหลดไฟล์อีกครั้ง» และหยุดการทำงาน
- ห้ามแสดงการถอดความฉบับเต็มในรายงานสรุปผล

ขั้นตอนที่ 2. การประเมินโดยผู้เชี่ยวชาญ
ประเมินเฉพาะสิ่งที่ได้ยินจริงในการถอดความฉบับเต็มเท่านั้น
ข้อห้าม:
- ห้ามคิดเอาเองถึงเจตนาของโฟร์แมน;
- ห้ามนับรวมสิ่งที่ไม่มีในบันทึกเสียง;
- ห้ามปรับปรุงถ้อยคำแทนผู้ถูกประเมิน;
- ห้ามชดเชยองค์ประกอบที่ขาดหายไปด้วยความประทับใจโดยรวมที่ดี

เกณฑ์การให้คะแนนสำหรับแต่ละเกณฑ์ประเมิน
ทำได้สมบูรณ์ = 1 คะแนน
ทำได้บางส่วน = 0,5 คะแนน
ไม่ได้ทำ = 0 คะแนน
กฎ:
- ไม่มีในเสียง → 0;
- กล่าวถึงตามแบบแผน แต่ไม่มีการอธิบาย → 0,5;
- อธิบายอย่างสมเหตุสมผลและถูกต้อง → 1.

รายการตรวจสอบ — ประเมินทั้ง 7 ข้อโดยห้ามข้าม
1. การแนะนำตัวและเป้าหมายของการพูดคุยเรื่องความปลอดภัย
2. การระบุชื่ออันตรายเฉพาะ / หัวข้อที่เป็นประเด็น
3. ตรรกะ «อันตราย → ผลกระทบ → มาตรการความปลอดภัย»
4. แรงกระตุ้นทางอารมณ์ผ่านผลกระทบที่เกิดขึ้นจริง/ที่อาจเกิดขึ้น หรือตัวอย่างที่เหมาะสม
5. มาตรการความปลอดภัยที่ชัดเจน
6. การสนทนากับคนงาน: คำถาม, คำตอบ, การมีส่วนร่วม
7. บทสรุปและการเชื่อมโยงกับงานปัจจุบัน / งานที่กำลังจะมาถึง

รูปแบบคำตอบ
1. ตาราง:
ลำดับ | เกณฑ์ประเมิน | สิ่งที่ได้ยินจริง | การประเมิน | คะแนน

2. สรุปผล:
คะแนนที่ได้: X จาก 7
เปอร์เซ็นต์: (X/7)*100, ปัดเศษเป็น 1 ทศนิยม

3. สถานะรอบการทำงาน:
- หากผลลัพธ์ >=80%: «ผ่านเกณฑ์ระดับที่กำหนด»
- หากผลลัพธ์ <80%: «ไม่ผ่านเกณฑ์ระดับที่กำหนด แนะนำให้จัดการพูดคุยเรื่องความปลอดภัยซ้ำหลังจากศึกษาข้อเสนอแนะ»

4. จุดแข็ง — ระบุ 2–5 ข้อที่ชัดเจน จากบันทึกเท่านั้น
5. ส่วนที่ต้องปรับปรุง — ระบุเจาะจงตามเกณฑ์ที่ไม่ได้ทำ/ทำได้บางส่วน
6. ข้อเสนอแนะถึงโฟร์แมน — 3–5 ประโยค: สไตล์ความเป็นมืออาชีพ, มีความคาดหวังสูง, เชิงพัฒนา

การตรวจสอบก่อนตอบ
ก่อนส่งคำตอบสุดท้าย ให้ตรวจสอบอีกครั้ง:
- ผลรวมคะแนนตรงกับในตาราง;
- คำนวณเปอร์เซ็นต์อย่างถูกต้อง;
- ไม่มีข้อใดใน 7 เกณฑ์ที่ถูกข้ามไป;
- ไม่มีข้อความใดอ้างอิงจากสิ่งที่ไม่มีในเสียง
ความคิดเห็น: หลักการสำคัญยังคงเดิมจากเวอร์ชันดั้งเดิม: ถอดความฉบับเต็มก่อน จากนั้นประเมินเฉพาะสิ่งที่ได้ยินจริงเท่านั้น ใน Perplexity ชื่อเฉพาะของเครื่องมืออ่านไฟล์อาจเปลี่ยนแปลงได้ ดังนั้นในเวอร์ชันสาธารณะ การอธิบายฟังก์ชันการทำงานจึงดีกว่าการผูกมัดผู้อ่านไว้กับชื่อ search_files_v2 อย่างตายตัว
Prompt 2. การตรวจสอบความสามารถในการทำซ้ำ («ความเป็นกลางทางดิจิทัล»)
พรอมต์นี้จะใช้หลังจากรันบันทึกเดียวกันแยกกันหลายรอบแล้ว
ฉันกำลังตรวจสอบความถูกต้องของความสามารถในการทำซ้ำของ AI ผู้ประเมิน

ฉันมีผลลัพธ์ N รายการจากการประเมินอิสระของบันทึกเสียงเดียวกัน โดยใช้รายการตรวจสอบเดียวกัน
ฉันจะส่งตารางสรุปผล/JSON ของการรันแต่ละรอบให้คุณ

งานของคุณ:
1. เปรียบเทียบเปอร์เซ็นต์สรุปผลระหว่างรอบ
2. เปรียบเทียบคะแนนในแต่ละเกณฑ์
3. เน้นเกณฑ์ที่โมเดลเปลี่ยนการตัดสินใจบ่อยที่สุด
4. คำนวณ:
   - เปอร์เซ็นต์สรุปรวมขั้นต่ำ;
   - เปอร์เซ็นต์สรุปรวมสูงสุด;
   - พิสัยในหน่วยเปอร์เซ็นต์ (เปอร์เซ็นต์พอยต์);
   - เปอร์เซ็นต์สรุปรวมเฉลี่ย
5. ห้ามประเมินซ้ำจากบันทึกต้นฉบับ และห้ามเลือกการประเมินที่ «ถูกต้อง» — ให้วิเคราะห์เฉพาะความเสถียรของผู้ประเมินเท่านั้น

เกณฑ์สำหรับโครงการนำร่อง
- ส่วนต่าง 0–2 เปอร์เซ็นต์พอยต์ — ความสามารถในการทำซ้ำสูง;
- 2,1–5 เปอร์เซ็นต์พอยต์ — ยอมรับได้ แต่ต้องตรวจสอบเกณฑ์ที่มีข้อโต้แย้ง;
- มากกว่า 5 เปอร์เซ็นต์พอยต์ — พรอมต์/เกณฑ์ต้องได้รับการปรับปรุง

ให้ผลลัพธ์ในรูปแบบ:
- ระดับความสามารถในการทำซ้ำ;
- จุดที่เกิดความคลาดเคลื่อน;
- สิ่งที่ต้องทำให้ชัดเจนยิ่งขึ้นในพรอมต์;
- จำเป็นต้องทดสอบซ้ำหลังการปรับแก้หรือไม่

อย่าเรียกสิ่งนี้ว่าเป็นความเป็นกลางสัมบูรณ์ ให้ใช้คำว่า «ความสามารถในการทำซ้ำของการประเมิน»
ความคิดเห็น: เกณฑ์ส่วนต่างในตัวอย่าง เป็นแนวทางปฏิบัติสำหรับการเผยแพร่ ไม่ใช่มาตรฐานที่ได้รับการอนุมัติขององค์กร สามารถตัดออกหรือแทนที่ด้วยเกณฑ์ของคุณเองได้
Prompt 3. ChatGPT ในฐานะที่ปรึกษาทีละขั้นตอนสำหรับ Make
นี่คือหลักการที่ช่วยให้บุคคลที่ไม่มีทักษะการเขียนโปรแกรมสามารถทำตามโซลูชันได้
ฉันไม่ใช่โปรแกรมเมอร์และไม่เคยสร้างสคริปต์ใน Make มาก่อน
ช่วยฉันสร้างระบบอัตโนมัติตามหลักการ «ทำทีละขั้นตอน»

เป้าหมาย
บอต Telegram รับบันทึกเสียงการสนทนาด้านพฤติกรรมความปลอดภัย (BSD) จากนั้น Make ต้อง:
1. รับไฟล์;
2. ตรวจสอบประเภทข้อมูลเข้า;
3. สกัด/รับไฟล์เสียง;
4. ส่งข้อมูลไปยัง AI เพื่อวิเคราะห์;
5. รับผลลัพธ์ที่มีโครงสร้างตายตัว;
6. บันทึกผลลัพธ์ใน Google Sheets;
7. ส่งข้อเสนอแนะส่วนตัวสั้นๆ ให้ผู้ใช้;
8. จัดการข้อผิดพลาด ไฟล์ซ้ำ และรูปแบบไฟล์ที่ไม่รองรับอย่างถูกต้อง

กฎการทำงานของเรา
- ให้บอกขั้นตอนถัดไปเพียงหนึ่งขั้นตอนต่อข้อความ
- เขียนชื่อโมดูล Make ที่แน่นอนที่ต้องเพิ่ม
- เขียนบอกสิ่งที่ต้องเลือกในแต่ละช่องบังคับ
- หากต้องการตัวแปรจากโมดูลก่อนหน้า — ระบุแหล่งที่มาให้ชัดเจน
- หลังจากแต่ละขั้นตอน ให้หยุดและขอให้ฉันส่งภาพหน้าจอ
- ตรวจสอบจากภาพหน้าจอของฉันก่อนว่าทำถูกต้องหรือไม่ หากมีข้อผิดพลาด — ให้แก้ไขก่อนแล้วจึงดำเนินการต่อ
- ห้ามข้ามขั้นตอน และห้ามส่งสคริปต์ทั้งหมดมาในครั้งเดียว
- อธิบายด้วยคำพูดง่ายๆ โดยไม่ต้องคาดเดาว่าฉันรู้เรื่อง API, JSON หรือการเขียนโปรแกรม
- หากมีหลายวิธี ให้เลือกวิธีที่ง่ายและเชื่อถือได้ที่สุดสำหรับโครงการนำร่อง และอธิบายสั้นๆ ว่าทำไม

ข้อจำกัด
- รหัสผู้ใช้ในวงจรการประเมิน — เป็นรหัสนามแฝงแบบ RSS 1234;
- นามสกุลและรหัสพนักงานไม่จำเป็น;
- ผลสรุปสำหรับตารางต้องมีโครงสร้าง;
- บุคคลใน Telegram จะได้รับเฉพาะข้อเสนอแนะที่เข้าใจง่าย โดยไม่มี JSON ทางเทคนิค

เริ่มจากขั้นตอนแรก: การสร้าง/เชื่อมต่อบอต Telegram และโมดูลอินพุตแรกของ Make
Prompt 4. แกนหลักการประเมิน BSD สำหรับ OpenAI/ChatGPT ใน Make
นี่คือบล็อกการประเมินเวอร์ชันใช้งานทั่วไปสำหรับเผยแพร่ มันถูกกำหนดให้ส่งคืน JSON โดยเฉพาะ — เพื่อให้ Make บันทึกผลลัพธ์ลงในตารางและกำหนดเส้นทางคำตอบได้ง่ายขึ้น
SYSTEM ROLE
คุณคือผู้เชี่ยวชาญด้านการประเมินคุณภาพการสนทนาด้านพฤติกรรมความปลอดภัย (BSD) คุณจะประเมินเฉพาะเนื้อหาของการถอดความที่ให้มาเท่านั้น และใช้ระเบียบวิธีที่ได้รับการอนุมัติขององค์กร

สำคัญ
หากองค์กรส่งรายการตรวจสอบที่ได้รับการอนุมัติแยกต่างหากมาให้ — ให้ใช้รายการตรวจสอบนั้นแทนโครงสร้างตัวอย่างด้านล่าง
ห้ามคิดเกณฑ์ที่ไม่มีในระเบียบวิธีขึ้นเอง

หลักการพื้นฐานของระเบียบวิธีที่ต้องตรวจสอบจากเสียง
- มีการสนทนาจริงกับคนงาน ไม่ใช่การพูดคนเดียว/การตรวจตรา;
- มีการตั้งคำถามกับคนงาน;
- คนงานระบุ/อภิปรายถึงอันตรายและผลกระทบที่อาจเกิดขึ้นด้วยตนเอง หากสถานการณ์นั้นเป็นอันตราย;
- มีการพูดคุยถึงวิธีปฏิบัติงานอย่างปลอดภัย;
- มีการพูดคุยถึงแหล่งที่มาของอันตรายและมาตรการความปลอดภัยอื่นๆ;
- ในการทำงานอย่างปลอดภัย หัวหน้ากะจะสังเกตเห็นและส่งเสริมการกระทำที่ปลอดภัยอย่างเจาะจง;
- การสื่อสารเป็นไปด้วยความเคารพ;
- การสนทนาจบลงด้วยข้อสรุปที่ชัดเจน/การกล่าวขอบคุณ;
- ห้ามนับรวมการสังเกตทางสายตา หากไม่สามารถยืนยันได้จากเสียง

ข้อมูลเข้า
- transcript: การถอดความฉบับเต็ม;
- rss_id: รหัสนามแฝงแบบ RSS 1234;
- methodology_context: ข้อความที่ตัดตอนมา/กฎระเบียบของระเบียบวิธีที่ได้รับการอนุมัติ;
- optional_checklist: รายการตรวจสอบระดับท้องถิ่นที่ได้รับการอนุมัติ หากมี

กฎการประเมิน
1. ใช้เฉพาะข้อเท็จจริงจาก transcript เท่านั้น
2. ห้ามคาดเดาเจตนา
3. ห้ามระบุชื่อเต็มจากเสียง/บริบท
4. หาก transcript ไม่สมบูรณ์หรือไม่ต่อเนื่องอย่างชัดเจน — quality_status="insufficient_data" และห้ามให้คะแนนสรุป
5. หากใช้รายการตรวจสอบระดับท้องถิ่น ให้ประเมินทุกข้อโดยห้ามข้าม
6. สำหรับแต่ละข้อสรุป ให้บันทึก evidence สั้นๆ — วลี/เนื้อหาจากการถอดความที่ยืนยันการตัดสินใจ

ผลลัพธ์ — เฉพาะ JSON เท่านั้น ไม่มี MARKDOWN และไม่มีข้อความก่อนหน้า/หลังจากนั้น
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 ประโยคที่หัวหน้ากะสามารถเข้าใจได้",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

ตรวจสอบก่อนตอบ
- JSON ถูกต้อง;
- rss_id ไม่ถูกเปลี่ยนแปลง;
- คะแนนสรุปตรงกับผลรวมของเกณฑ์ประเมิน;
- evidence ไม่มีข้อเท็จจริงที่สร้างขึ้นเอง;
- หากข้อมูลไม่เพียงพอ ห้ามกำหนด overall_score_percent ขึ้นมาเอง
ความคิดเห็น: เนื่องจากไม่มีการระบุรายการตรวจสอบการให้คะแนนสำหรับการสนทนาเชิงพฤติกรรมความปลอดภัย (BSD) ที่ได้รับการอนุมัติแยกต่างหากในเอกสารที่ให้มา ผมจึงไม่ใช้เกณฑ์การให้คะแนนที่คิดขึ้นเองเป็นมาตรฐานขององค์กร ในเวอร์ชันใช้งานจริง คุณต้องใส่รายการตรวจสอบจริงของคุณลงไป
Prompt 5. โมดูลข้อเสนอแนะแยกต่างหากใน Telegram
หากมีการเรียกใช้โมเดลครั้งที่สองในสคริปต์ ควรจำกัดให้ทำหน้าที่แค่จัดรูปแบบการประเมินที่เสร็จแล้วเท่านั้น สิ่งนี้จะช่วยเพิ่มความเสถียร: โมดูลที่สองไม่ควร «ตีความ» คะแนนใหม่อีกครั้ง
คุณได้รับ JSON การประเมิน BSD โดยผู้เชี่ยวชาญที่เสร็จสมบูรณ์จากขั้นตอนก่อนหน้า
ห้ามประเมินการบันทึกใหม่และห้ามเปลี่ยนคะแนน

สร้างคำตอบสั้นๆ สำหรับผู้ใช้ใน Telegram

รูปแบบ
RSS: <รหัส>
การประเมิน: <เปอร์เซ็นต์ หรือ «ไม่ได้ประเมิน — ข้อมูลไม่เพียงพอ»>

สิ่งที่ทำได้ดี:
• 2–4 ข้อสั้นๆ จาก strengths

สิ่งที่ต้องปรับปรุง:
• 2–4 ข้อเฉพาะเจาะจงจาก improvements

สำหรับ BSD ครั้งต่อไป:
<1–2 การกระทำที่เฉพาะเจาะจงที่สุด>

กฎเกณฑ์
- ความยาวสูงสุด 700–1200 ตัวอักษร;
- น้ำเสียงเป็นทางการและให้ความเคารพ;
- ไม่มี JSON ทางเทคนิค;
- ไม่มีนามสกุล;
- ไม่คิดค้นข้อเสนอแนะใหม่ขึ้นเอง;
- ไม่ใช้คำขวัญสร้างแรงบันดาลใจ;
- หาก quality_status=insufficient_data — ให้ขอให้บันทึกใหม่/อัปโหลดเสียงใหม่ และไม่แสดงผลการประเมิน
Prompt 6. การทำให้ผลลัพธ์เป็นมาตรฐานก่อนส่งไปยัง Google Sheets
ขั้นตอนนี้มีประโยชน์หากต้องการให้ Google Sheets ได้รับโครงสร้างที่เหมือนกันเสมอ ไม่ว่าข้อความการประเมินจะมีความยาวเท่าใดก็ตาม
ตรวจสอบแถวข้อมูลก่อนบันทึกลงใน Google Sheets

ฟิลด์ที่คาดหวัง:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

กฎเกณฑ์
1. ห้ามเพิ่มชื่อ-นามสกุล และรหัสพนักงาน
2. rss_id ต้องตรงตามรูปแบบ: RSS + เว้นวรรค + ตัวเลข 3–6 หลัก
3. overall_score_percent ต้องเป็นตัวเลข 0–100 หรือเว้นว่างไว้หากเป็น insufficient_data
4. แปลงอาร์เรย์เป็นสตริงสั้นๆ คั่นด้วย «; »
5. หากฟิลด์บังคับขาดหายไป — ให้ส่งคืน error=true และระบุ missing_fields
6. หากทุกอย่างถูกต้อง — error=false

ผลลัพธ์เป็น JSON เท่านั้น:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. การตรวจสอบสคริปต์ Make ที่เสร็จสมบูรณ์จากภาพหน้าจอ
เหมาะสำหรับใช้เป็น Prompt สุดท้ายในการตรวจสอบสคริปต์ก่อนเปิดใช้งานนำร่องแบบกลุ่มใหญ่
ผมจะส่งภาพหน้าจอสคริปต์ Make ของผมไปให้คุณ
ดำเนินการตรวจสอบทางเทคนิคในฐานะผู้ฝึกสอนด้านระบบอัตโนมัติแบบ no-code

ตรวจสอบจากภาพหน้าจอและคำอธิบายของผม:
1. ลำดับของโมดูล;
2. เส้นทางของ Router;
3. การจัดการข้อความที่ไม่รองรับ;
4. การจัดเก็บสถานะชั่วคราวใน Data store;
5. การรับและการส่งต่อไฟล์เสียง;
6. การเรียกใช้ AI;
7. การแยกวิเคราะห์ JSON;
8. การบันทึกลงใน Google Sheets;
9. การส่งผลลัพธ์ไปยัง Telegram;
10. สาขาข้อผิดพลาดและการลองใหม่;
11. ความเสี่ยงของการซ้ำซ้อนเมื่อรันซ้ำ;
12. ความเสี่ยงที่ผู้ใช้รายหนึ่งจะได้รับผลลัพธ์ของผู้ใช้อีกราย

ไม่ต้องเสนอให้สร้างโครงสร้างใหม่ทั้งหมดหากสถาปัตยกรรมปัจจุบันทำงานได้อยู่แล้ว
ระบุสิ่งต่อไปนี้ก่อน:
- สิ่งที่ทำได้ดีอยู่แล้ว;
- ความเสี่ยงที่สำคัญที่สุด 3 ประการ;
- ขั้นตอนต่อไปขั้นตอนเดียวที่ต้องทำเป็นอันดับแรก
หลังจากนั้นให้หยุดและรอภาพหน้าจอ/การยืนยันจากผม
ลำดับขั้นตอนการปฏิบัติสำหรับผู้อ่าน
- อัปโหลดระเบียบวิธีและรายการตรวจสอบที่ได้รับการอนุมัติลงใน Project/เอเจนต์ที่เลือก
- ตั้งค่า Prompt 1 และทดสอบกับบันทึกมาตรฐานหลายๆ รายการ
- รันบันทึกเดียวกันหลายๆ ครั้ง แล้วใช้ Prompt 2 เพื่อประเมินความสามารถในการทำซ้ำ
- หากต้องการระบบอัตโนมัติ — ให้เริ่มต้นด้วย Prompt 3 และประกอบ Make ทีละโมดูลพร้อมตรวจสอบด้วยภาพหน้าจอ
- ใน Make ให้ใช้ Prompt 4 เป็นแกนหลักระดับผู้เชี่ยวชาญ และกำหนดให้ผลลัพธ์ต้องเป็น JSON ที่เคร่งครัด
- หากจำเป็น ให้แยกข้อเสนอแนะของผู้ใช้ออกมาไว้ใน Prompt 5
- ก่อนบันทึกลงใน Google Sheets ให้ทำให้ข้อมูลเป็นมาตรฐานด้วย Prompt 6
- ก่อนเปิดใช้งานแบบกลุ่มใหญ่ ให้ตรวจสอบแผนผังทั้งหมดด้วย Prompt 7
ความคิดเห็น 8
ขอขอบคุณ อเล็กซานเดอร์ บอนดาเรนโก สำหรับบทความนี้ มีหลายอย่างให้ ต้องคิด AI เป็นหัวข้อที่กำลังเป็นที่นิยมและน่าสนใจมากในขณะนี้ เพื่อนร่วมงานได้ทำผลงาน ที่ยอดเยี่ยมมาก
โซลูชันที่นำเสนอช่วยลด ภาระงานที่มากเกินไปอย่างเรื้อรังของแผนกอาชีวอนามัยและความปลอดภัยและความปลอดภัยทางอุตสาหกรรม และปลดปล่อยพนักงานอย่างน้อยหนึ่งคนจากงานประจำ ในความเห็นของฉัน ประโยชน์หลัก คือระบบทำงานเป็น "เครื่องจำลอง ดิจิทัล"
อย่างไรก็ตาม เมื่อชั่งน้ำหนัก "ข้อดี" และ "ข้อเสีย" ทั้งหมดแล้ว ฉันไม่แนะนำ ให้ขยายขนาดการประเมินด้วย AI ของการประชุมความปลอดภัยห้านาที และโดยเฉพาะอย่างยิ่ง บทสนทนาความปลอดภัย เชิงพฤติกรรม
ดังนั้น การประเมินด้วย AI:
อย่ารีบเร่งที่จะมองหา "ผู้เชี่ยวชาญคนที่สอง" ใน AI หากมีปัญหากับคนแรก
อีวาน ขอบคุณสำหรับข้อเสนอแนะที่เป็นประโยชน์
ผมเห็นด้วยกับความเสี่ยงของ "การแสดงหน้าไมโครโฟน": หากเปลี่ยน AI ให้เป็นเพียงเครื่องมือควบคุมเพื่อการประเมินผล ก็แทบจะไม่มีประโยชน์อะไร
แต่บางทีในบทความ ผมอาจจะไม่ได้เปิดเผยเส้นทางในอนาคตของเราอย่างครบถ้วน การประเมินผลด้วยเครื่องบันทึกเสียงในเดือนเมษายน ถือเป็น เครื่องจำลองดิจิทัล สำหรับเราเป็นหลัก
AI ไม่เพียงแค่ให้คะแนนเท่านั้น แต่ยังให้ข้อเสนอแนะด้วย: สิ่งใดที่ทำได้ดี สิ่งใดที่ต้องปรับปรุง วิธีการดึงดูดพนักงานให้มีส่วนร่วม และการสื่อสารเรื่องความเสี่ยงอย่างดีที่สุด
ใช่ คนเราสามารถเตรียมตัวและจัดการบรรยายสรุปห้านาทีที่เป็นแบบอย่างได้ แต่ในขั้นตอนนี้เราเชื่อมั่นในสิ่งสำคัญที่สุด: ผู้จัดการของเรารู้และสามารถดำเนินการได้อย่างถูกต้อง!
วันนี้เรากำลังก้าวไปไกลกว่านั้นแล้ว การบรรยายสรุปห้านาทีจะได้รับการประเมินอย่างเป็นระบบจากบันทึกของกล้องวงจรปิดในสถานที่ที่มีการออกใบอนุญาตทำงาน และในที่ที่ไม่มีกล้อง จะใช้เครื่องบันทึก "Revizor" นี่ไม่ใช่การบันทึกที่เตรียมไว้เป็นพิเศษอีกต่อไป แต่เป็นงานประจำวันตามปกติ (และยังมาพร้อมกับข้อเสนอแนะส่วนบุคคลพร้อมคำแนะนำ)
ดังนั้น AI สำหรับเราจึงไม่ใช่ผู้จัดการตัวแทนและไม่ใช่ "ผู้ควบคุมดูแลทางดิจิทัล" แต่เป็นเครื่องมือสำหรับเรียนรู้และข้อเสนอแนะอย่างต่อเนื่อง สิ่งนี้มีความสำคัญอย่างยิ่งสำหรับผู้เชี่ยวชาญที่มีความสามารถทางเทคนิคสูง ซึ่งไม่ใช่เรื่องง่ายเสมอไปที่จะพูดคุยกับผู้คนอย่างกระชับ ชัดเจน และน่าเชื่อถือ
เมื่อพูดถึงการสนทนาเชิงพฤติกรรม ทุกอย่างซับซ้อนขึ้นจริงๆ และที่นี่เรายังคงค้นหารูปแบบที่เหมาะสมที่สุด แต่หลักการยังคงเหมือนเดิม: AI ไม่ควรแทนที่การสนทนาสด — แต่ควรช่วยผู้จัดการให้ดำเนินการได้ดีขึ้น
และเกณฑ์หลักสำหรับเราไม่ใช่การประเมินอัลกอริทึม แต่เป็นการเปลี่ยนแปลงพฤติกรรมที่แท้จริงของผู้คน!
เพื่อให้แน่ใจว่าเครื่องมือนี้เข้ากันได้กับรากฐานทางสังคมและจิตวิทยาของวัฒนธรรมความปลอดภัย โค้ช AI (เช่นเดียวกับเครื่องมือควบคุมทางดิจิทัลอื่น ๆ อีกมากมาย) จะต้องไม่ถูกผูกติดกับ KPI ในการให้โบนัสของผู้บริหาร ทางเลือกที่ดีที่สุดและดูเหมือนจะเป็นทางเลือกเดียวที่มีประสิทธิภาพในการใช้งานก็คือ เครื่องมือเพื่อการพัฒนาตนเองที่เป็นความลับ ตามที่คุณได้กล่าวถึง
จากประสบการณ์ของผม สิ่งสำคัญอย่างยิ่ง คือการสร้างแรงจูงใจที่ถูกต้อง:
อิวาน ผมขอขอบคุณคุณสำหรับคำพูดที่อบอุ่นและการสนทนาที่มีสาระ
ผมเห็นด้วยอย่างยิ่ง: วัฒนธรรมความปลอดภัยที่ยั่งยืนไม่สามารถสร้างขึ้นได้ "ด้วยการบังคับ" โดยเฉพาะอย่างยิ่งเมื่อพูดถึงพฤติกรรมและการมีส่วนร่วมส่วนตัวของผู้บริหาร
เรากำลังพยายามทำงานมากขึ้นผ่านการยอมรับและแรงจูงใจเชิงบวก ตัวอย่างเช่น ทุกเดือนจากผลการประเมินทางดิจิทัล เราจะเลือกการบรรยายสรุปความปลอดภัยห้านาทีที่ดีที่สุดหกรายการ วิเคราะห์ในวิดีโอแยกต่างหากว่ามีอะไรที่ทำได้ดีบ้าง และมอบรางวัลใบประกาศเกียรติคุณแก่หัวหน้าคนงานจากมือของประธานเจ้าหน้าที่บริหารที่คณะกรรมการกลางด้านอาชีวอนามัยและความปลอดภัยในการทำงาน — ด้วยตนเองต่อหน้าผู้ชมจำนวนมาก (300) ของผู้บริหารและผู้เชี่ยวชาญ
ด้วยผู้บริหาร ผู้เชี่ยวชาญ และพนักงานออฟฟิศ 1,300 คน นี่เป็นการแข่งขันที่จริงจังพอสมควรและที่สำคัญคือการยอมรับต่อสาธารณชนถึงแนวปฏิบัติที่ดี
ตอนนี้เราเริ่มขยายแนวทางนี้ไปยังองค์กรผู้รับเหมาด้วยเช่นกัน
ผมขอขอบคุณคุณสำหรับการแลกเปลี่ยนความคิดเห็น
ผมก็ติดตามสิ่งพิมพ์ของคุณและแนวปฏิบัติของเพื่อนร่วมงานอย่างใกล้ชิดเช่นกัน
ท้ายที่สุดแล้ว เราทุกคนกำลังทำสิ่งเดียวกัน — ค้นหาวิธีที่ใช้ได้ผลในการพัฒนาวัฒนธรรมความปลอดภัยและทำให้มันมีชีวิตชีวาอย่างแท้จริง ไม่ใช่แค่เป็นทางการ!!!
เป็นเครื่องมือที่น่าสนใจ
ฉันมีคำถามเกี่ยวกับความลับ: ข้อมูลที่โหลดลงในบอทนั้นปลอดภัยสำหรับบริษัทมากน้อยเพียงใด? ตอนนี้หลายคนใช้มัน แต่มีข้อสงสัยว่าการใช้ AI แบบเปิดโดยไม่มีบริการคลาวด์ในพื้นที่นั้นไม่ค่อยมีความสัมพันธ์กับปัญหาข้อมูลรั่วไหล..
ฝ่ายรักษาความปลอดภัยและทนายความมีปฏิกิริยาอย่างไรต่อโครงการนี้? หรืออย่างไรก็ตาม คุณปกป้องข้อมูลของคุณที่อัปโหลดไปยังบอท Telegram ด้วยวิธีใดวิธีหนึ่งหรือไม่? (บางทีฉันอาจจะเข้าใจกลไกไม่ถูกต้องทั้งหมดหรือพลาดประเด็นนี้ไปที่ไหนสักแห่ง)
คุณอิริน่า ขอบคุณครับ คำถามนี้ตรงประเด็นอย่างยิ่ง!
ในเวอร์ชันเริ่มต้นที่ใช้ Make เราได้ลดทอนข้อมูลส่วนบุคคลอย่างจงใจ: ชื่อ-นามสกุล, รหัสพนักงาน, ตำแหน่ง และตัวระบุอื่น ๆ จะไม่ถูกส่งไปยังระบบคลาวด์ — มีเพียงรหัสสุ่มส่วนบุคคลและบันทึกเสียงเท่านั้น ในขณะเดียวกัน สิ่งสำคัญที่ต้องทำความเข้าใจคือ: เสียงเองก็จัดเป็นข้อมูลส่วนบุคคลเช่นกัน ดังนั้นแนวทางนี้จึงไม่สามารถแก้ไขปัญหาความลับได้อย่างสมบูรณ์ ในวิดีโอของบทความ คุณสามารถดูได้ว่าแบบแผนนี้ถูกสร้างขึ้นมาอย่างไร
ในเวลาเดียวกัน ทีมงานอาชีวอนามัยและความปลอดภัย และความปลอดภัยทางอุตสาหกรรมของเรา ได้พัฒนาตัวเลือกที่สอง — ซึ่งอยู่ภายในขอบเขตองค์กรของเราอย่างสมบูรณ์แบบบน AI ภายในของเราที่ชื่อ Fire หลังจากคณะกรรมการกลางด้านอาชีวอนามัยและความปลอดภัย ซึ่งจัดขึ้นเมื่อสองวันที่แล้ว นี่คือทิศทางที่เราตัดสินใจก้าวต่อไป
ตอนนี้ Fire ได้ทำการแยกแทร็กเสียงจากบันทึกของกล้องวงจรปิดแบบอยู่กับที่หรือเครื่องบันทึกวิดีโอ, ถอดความการประชุมห้านาที, ดำเนินการประเมินตามเกณฑ์ที่กำหนด, สร้างข้อเสนอแนะ และถ่ายโอนผลลัพธ์ไปยังแดชบอร์ด เมื่อประมวลผลบันทึกเดิมซ้ำ เราจะได้รับการประเมินที่เสถียรตามกฎเกณฑ์เดียวกัน
นอกจากนี้ เป้าหมายในที่นี้ไม่ใช่เพื่อ «ให้คะแนน» ผู้จัดการ เรามีวิศวกรและบุคลากรทางเทคนิคประมาณ 1,300 คน และระบบช่วยให้เรามองเห็นความเป็นระบบอย่างชัดเจน: ว่าบุคคลนั้นสามารถจัดการประชุมห้านาทีเชิงสาธิตได้อย่างยอดเยี่ยมไม่เพียงแค่ครั้งเดียว แต่ทำได้อย่างมีคุณภาพสูงในทุก ๆ กะงานจริง ๆ ในจุดที่จำเป็น — เพื่อจัดการฝึกอบรมเพิ่มเติม, บางจุดเพื่อแก้ไขการสื่อสารกับผู้คน, บางจุดเพื่อดูแนวปฏิบัติที่ดีอย่างยั่งยืน
ตามหลักการเดียวกัน ตั้งแต่วันที่ 1 ตุลาคม ได้มีการเปิดตัวขอบเขตภายในที่สองเพื่อประเมินบทสนทนาเชิงพฤติกรรมด้านความปลอดภัย
ดังนั้น คุณหยิบยกหัวข้อการรั่วไหลของข้อมูลขึ้นมาได้อย่างถูกต้องที่สุด: สำหรับ AI บนคลาวด์ นี่คือปัญหาที่แท้จริง
เราเริ่มต้นด้วยการทำให้ไม่สามารถระบุตัวตนได้มากที่สุด และตอนนี้เรากำลังเปลี่ยนไปสู่การประมวลผลภายในขอบเขตองค์กรที่ได้รับการปกป้อง
ขอบคุณสำหรับคำตอบที่ละเอียดขนาดนี้ค่ะ ตอนนี้ทุกอย่างชัดเจนแล้ว ฉันได้จดบันทึกประสบการณ์ของคุณไว้แล้วค่ะ