L'IA come secondo esperto: dai briefing sulla sicurezza alla valutazione automatizzata dei BSD
Toolbox talk → valutazione digitale → Make → dialoghi comportamentali automatizzati
Idea principale: l'IA non sostituisce il responsabile o lo specialista della sicurezza. Diventa un unico "secondo esperto" che applica gli stessi criteri, fornisce un feedback personale e permette di scalare il controllo qualità su centinaia e migliaia di conversazioni reali.
Perché abbiamo iniziato a valutare la conversazione e non il fatto che sia avvenuta
Nella salute e sicurezza sul lavoro è facile calcolare i fatti: un toolbox talk è stato tenuto, un dialogo comportamentale è stato registrato, una scheda è stata compilata. È molto più difficile rispondere alla domanda su quanto il responsabile abbia condotto bene la conversazione stessa e se abbia raggiunto l'obiettivo.
Il toolbox talk nella nostra metodologia è una parte obbligatoria della riunione di inizio turno della durata di 5–10 minuti. Il responsabile deve esaminare un argomento attuale specifico e costruire un collegamento chiaro: pericolo → conseguenze → misure di sicurezza. In questo contesto, non è importante solo il monologo del caposquadra, ma anche il dialogo con i lavoratori: domande, risposte e coinvolgimento nella discussione.
Pertanto, il compito iniziale non era "verificare la presenza di una registrazione", ma diverso: è possibile insegnare all'IA a valutare in modo uniforme la qualità reale di tali conversazioni e a fornire al responsabile un feedback specifico?
Fase 1. Prima la metodologia, poi l'intelligenza artificiale
Nella primavera del 2026 abbiamo iniziato con i toolbox talk. Prima del lancio della valutazione con IA, sono state preparate linee guida metodologiche e un video di formazione su come condurre correttamente un toolbox talk. Solo dopo è apparso il valutatore digitale.
Come primo ambiente di lavoro abbiamo utilizzato Perplexity Space: oggi un ambiente analogo in Perplexity si chiama Project. Nel progetto abbiamo caricato il manuale metodologico e la checklist di valutazione, e per il modello abbiamo preparato separatamente un prompt rigoroso.
Il compito del prompt differiva fondamentalmente da una normale richiesta "valuta il discorso". All'IA era consentito conteggiare solo ciò che veniva realmente pronunciato nell'audio. Se un elemento è assente: 0 punti. Se menzionato formalmente: esecuzione parziale. Se sviluppato in modo logico e completo: completato.
Nella checklist attuale ci sono sette criteri: presentazione e obiettivo; pericolo specifico; logica "pericolo – conseguenze – misure"; impulso emotivo; misure di sicurezza; dialogo con i lavoratori; riepilogo finale e collegamento con i lavori da eseguire.
Prompt 1: per una versione modernizzata del prompt per Perplexity Project, vedere l'appendice.
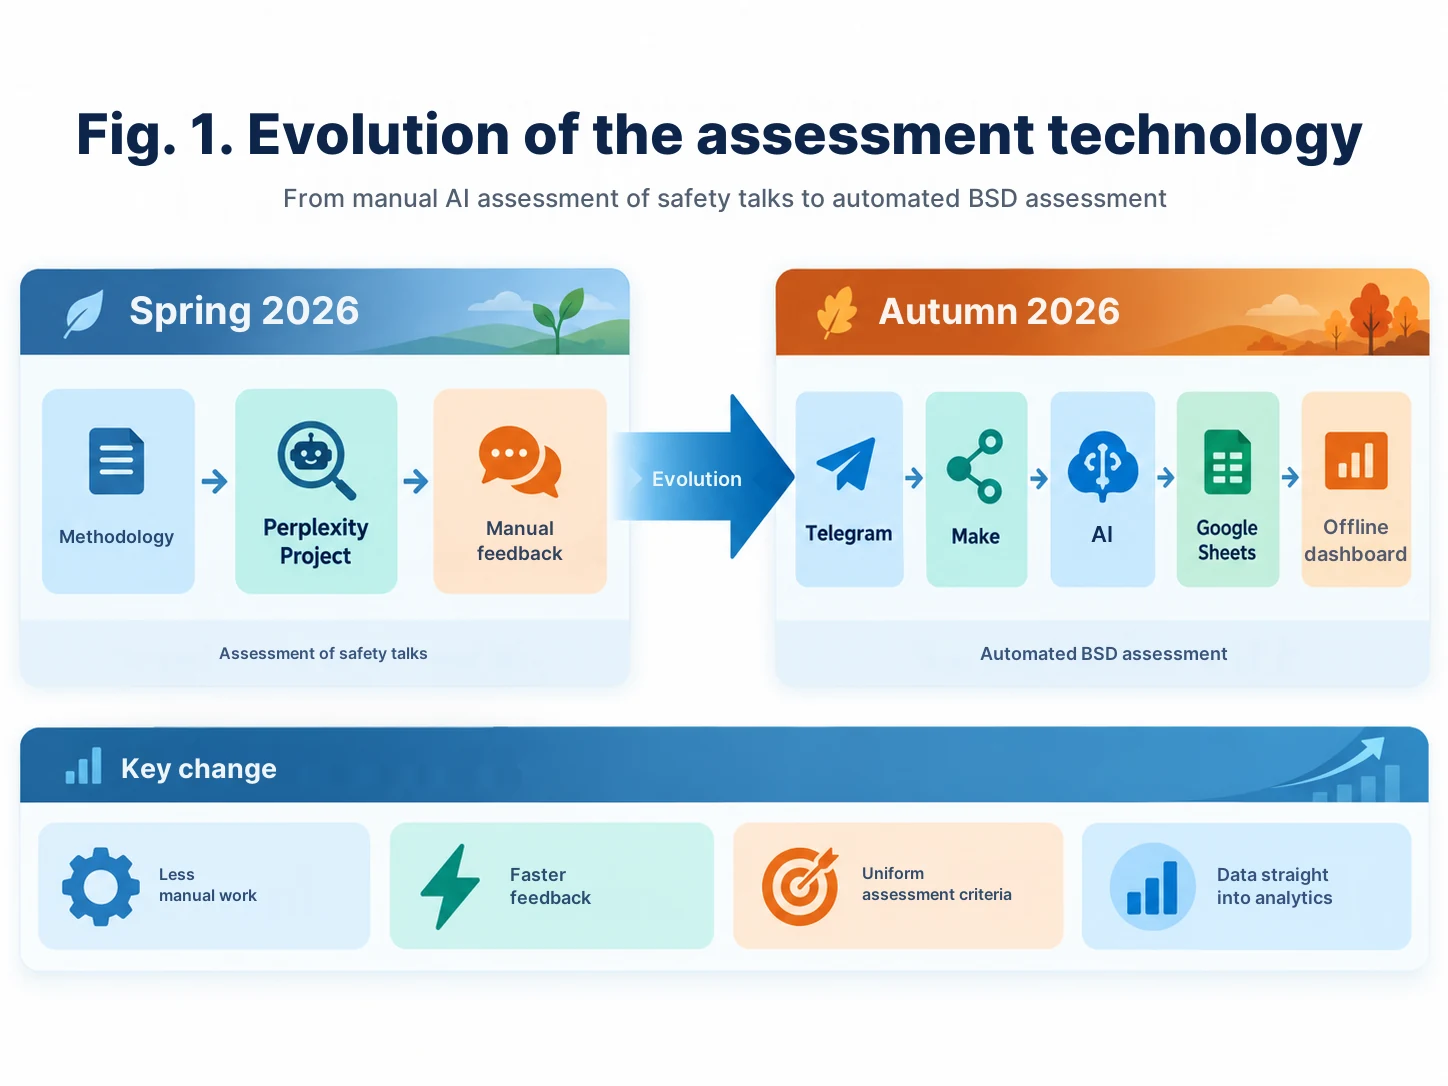
Come appariva il primo ambiente, ancora manuale
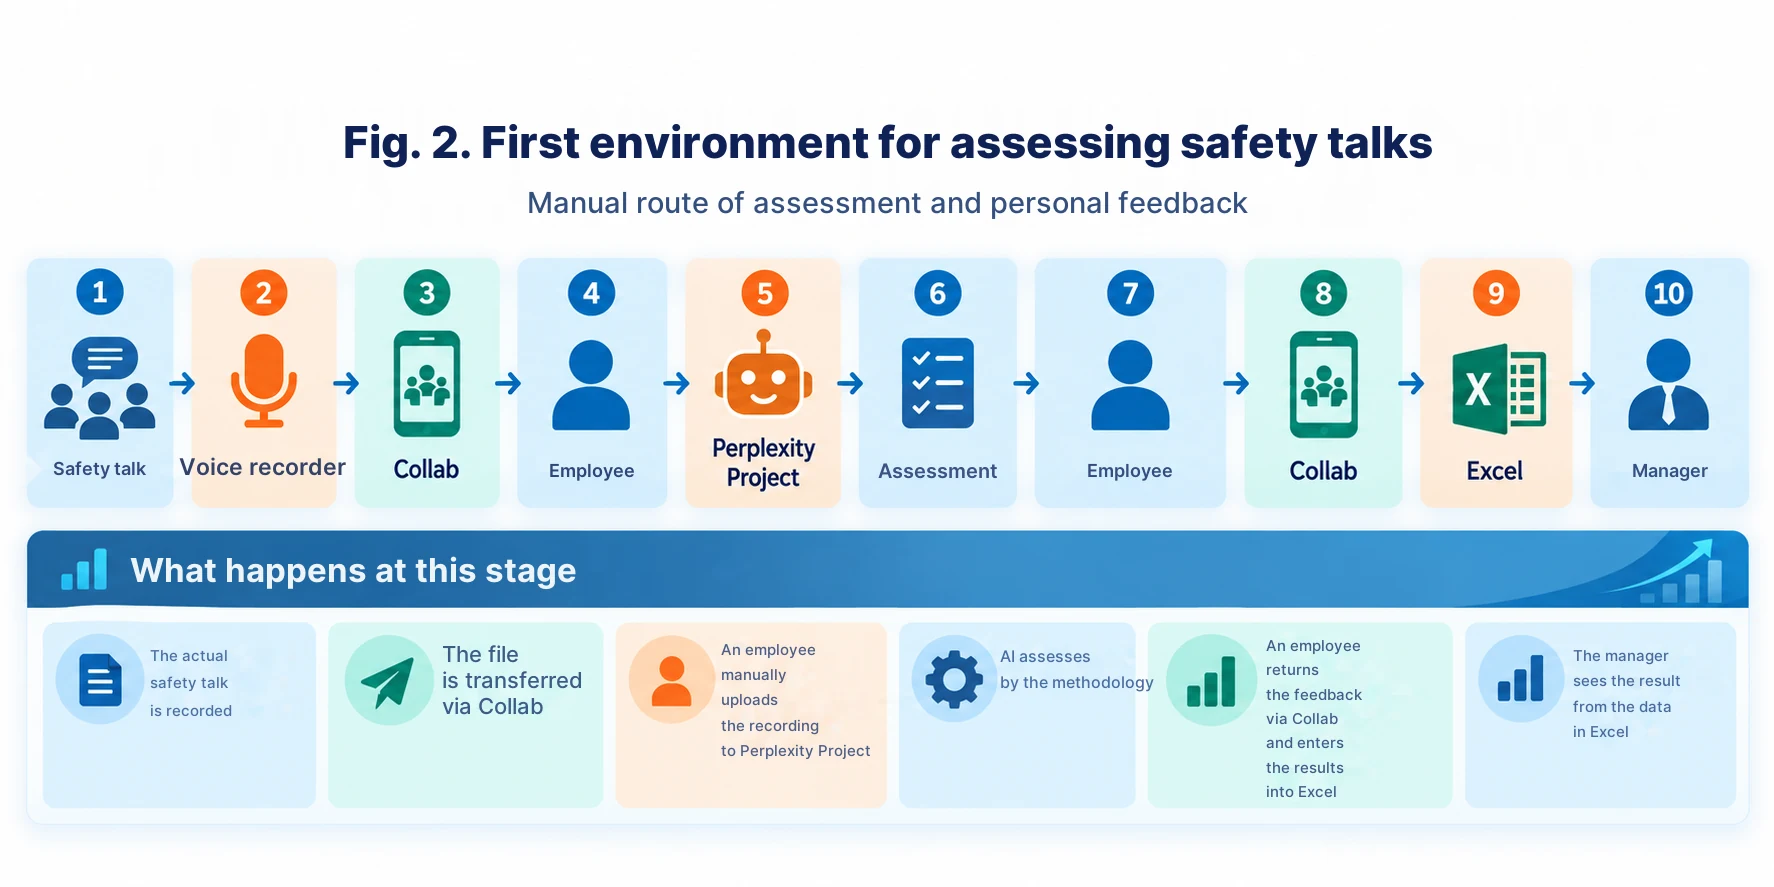
Il capoturno registrava il toolbox talk condotto su un dittafono. Tramite l'applicazione aziendale Collab, la registrazione veniva trasmessa a un dipendente designato. Il dipendente caricava l'audio in Perplexity Project, otteneva una valutazione e restituiva un feedback personale al responsabile, sempre tramite Collab.
Contemporaneamente, il risultato veniva inserito in Excel: reparto, responsabile, valutazione, numero di tentativi. Sulla base della tabella costruivamo semplici analisi: i risultati medi dei reparti, le dinamiche e il numero di cicli ripetuti.
Abbiamo stabilito l'80% come livello di superamento per il ciclo pratico. Se il risultato era inferiore, il responsabile conduceva il toolbox talk successivo tenendo già conto delle osservazioni dell'IA. Il risultato non era solo un controllo, ma anche una formazione individuale direttamente sul posto di lavoro.
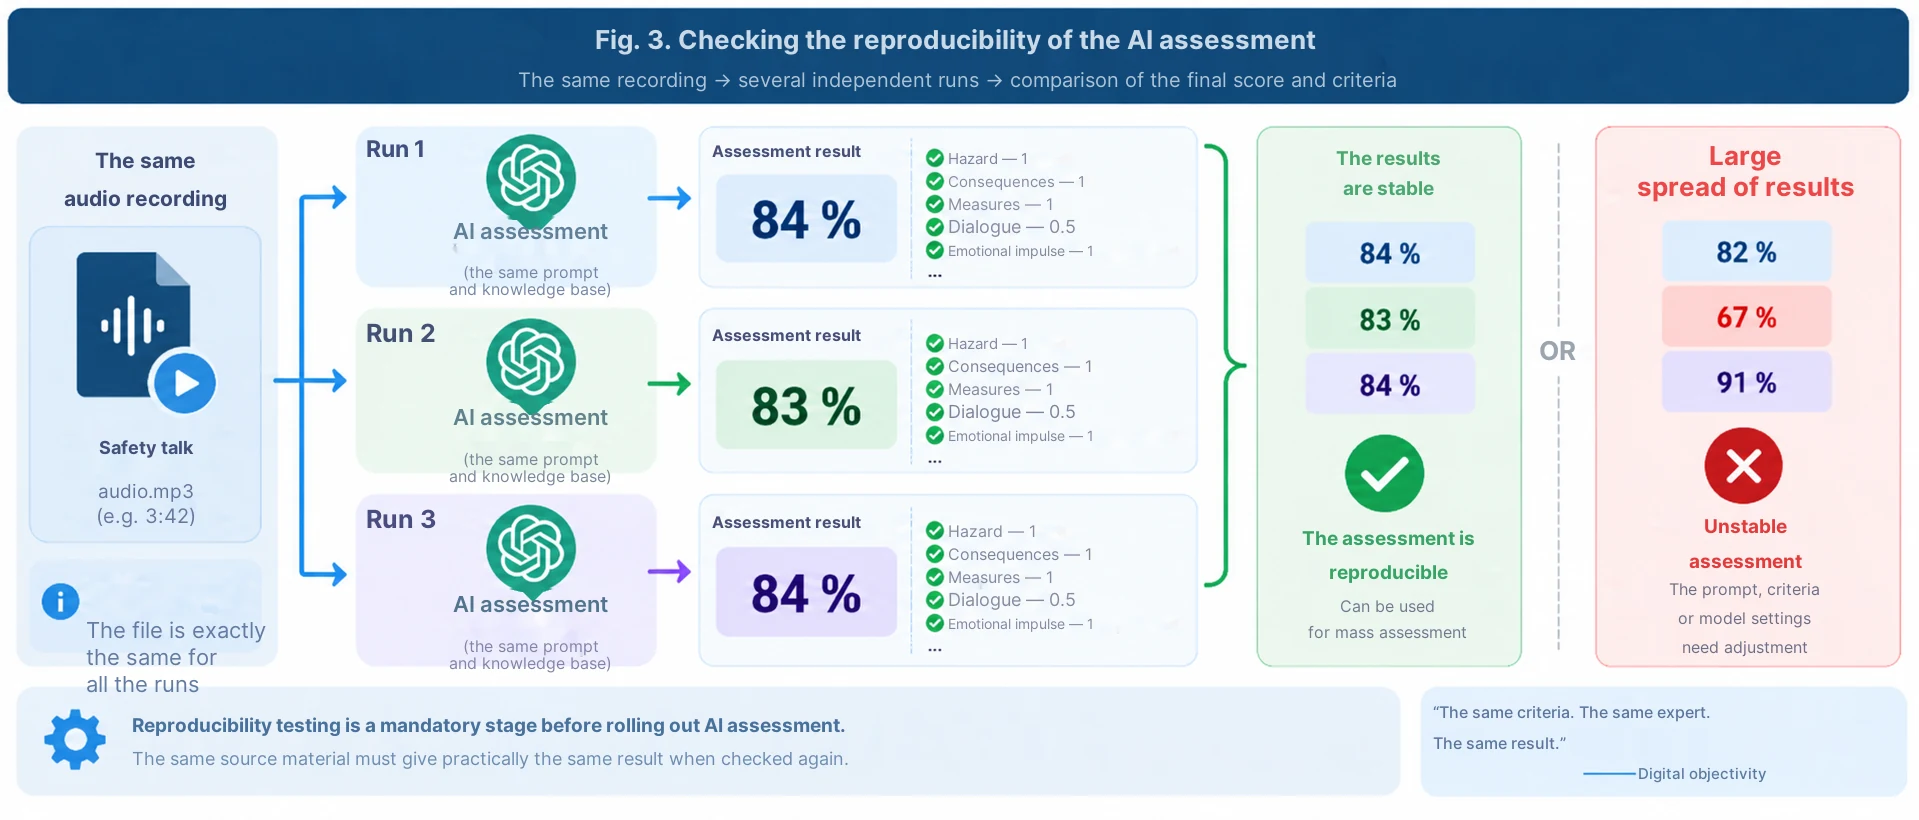
Non controllavamo solo l'essere umano: prima abbiamo controllato l'IA stessa
Per me questo è uno degli elementi più importanti dell'intero schema. Abbiamo inviato intenzionalmente la stessa registrazione audio per la valutazione più volte. Se lo stesso materiale oggi ottiene l'82%, un minuto dopo il 65% e poi il 91%, un tale esperto digitale non è ancora pronto a valutare le persone.
Pertanto, abbiamo cercato la riproducibilità: la stessa registrazione deve dare una valutazione identica o quasi identica. Se la discrepanza diventava evidente, correggevamo il prompt, chiarivamo i criteri e rimuovevamo le formulazioni ambigue.
Personalmente, la chiamo "oggettività digitale". Questo non significa che l'IA possieda la verità assoluta. Il punto è un altro: un unico esperto applica la stessa scala a tutti e non dipende dall'umore, dalle simpatie personali o da chi sta conducendo il controllo oggi.
Prompt 2: per il protocollo di verifica della riproducibilità della valutazione, vedere l'appendice.
Perché lo schema manuale non andava più bene
Per il progetto pilota, il percorso manuale era conveniente: ricevere il file, caricarlo, attendere il risultato, restituire il feedback e inserire il punteggio in Excel. Ma questo approccio ha un limite naturale.
Quando il volume si misura in centinaia e migliaia di registrazioni, non iniziamo ad automatizzare la valutazione, ma a creare un nuovo lavoro amministrativo attorno ad essa. Pertanto, nel passaggio ai dialoghi comportamentali di sicurezza, il compito è stato formulato diversamente: rimuovere l'essere umano dalla catena tecnica laddove la sua partecipazione non crea valore.
Fase 2. Il dialogo comportamentale è più complesso di un normale toolbox talk
Il dialogo comportamentale di sicurezza (BSD) non è solo un breve discorso. La metodologia include l'osservazione del lavoro reale e una conversazione con la persona. Per il responsabile è importante vedere il comportamento sicuro o pericoloso, e poi attraverso domande far sì che il lavoratore stesso nomini il pericolo, le possibili conseguenze e il modo sicuro per eseguire il lavoro.
Se il lavoratore lavora in modo pericoloso, la parte chiave della conversazione è discutere i pericoli e le conseguenze, poi il modo sicuro di lavorare e altre fonti di pericolo. Se la persona lavora in modo sicuro, il responsabile deve notare e rafforzare il comportamento corretto, per poi utilizzare la conversazione per discutere altre questioni di sicurezza.
Proprio per questo l'ambiente di valutazione del BSD deve verificare non solo le parole del responsabile, ma anche la presenza di un vero dialogo: se sono state fatte domande, se il lavoratore ha risposto, se sono state discusse le cause del comportamento, le conseguenze, le azioni sicure e la conclusione della conversazione.
Identificatore pseudonimo invece del cognome
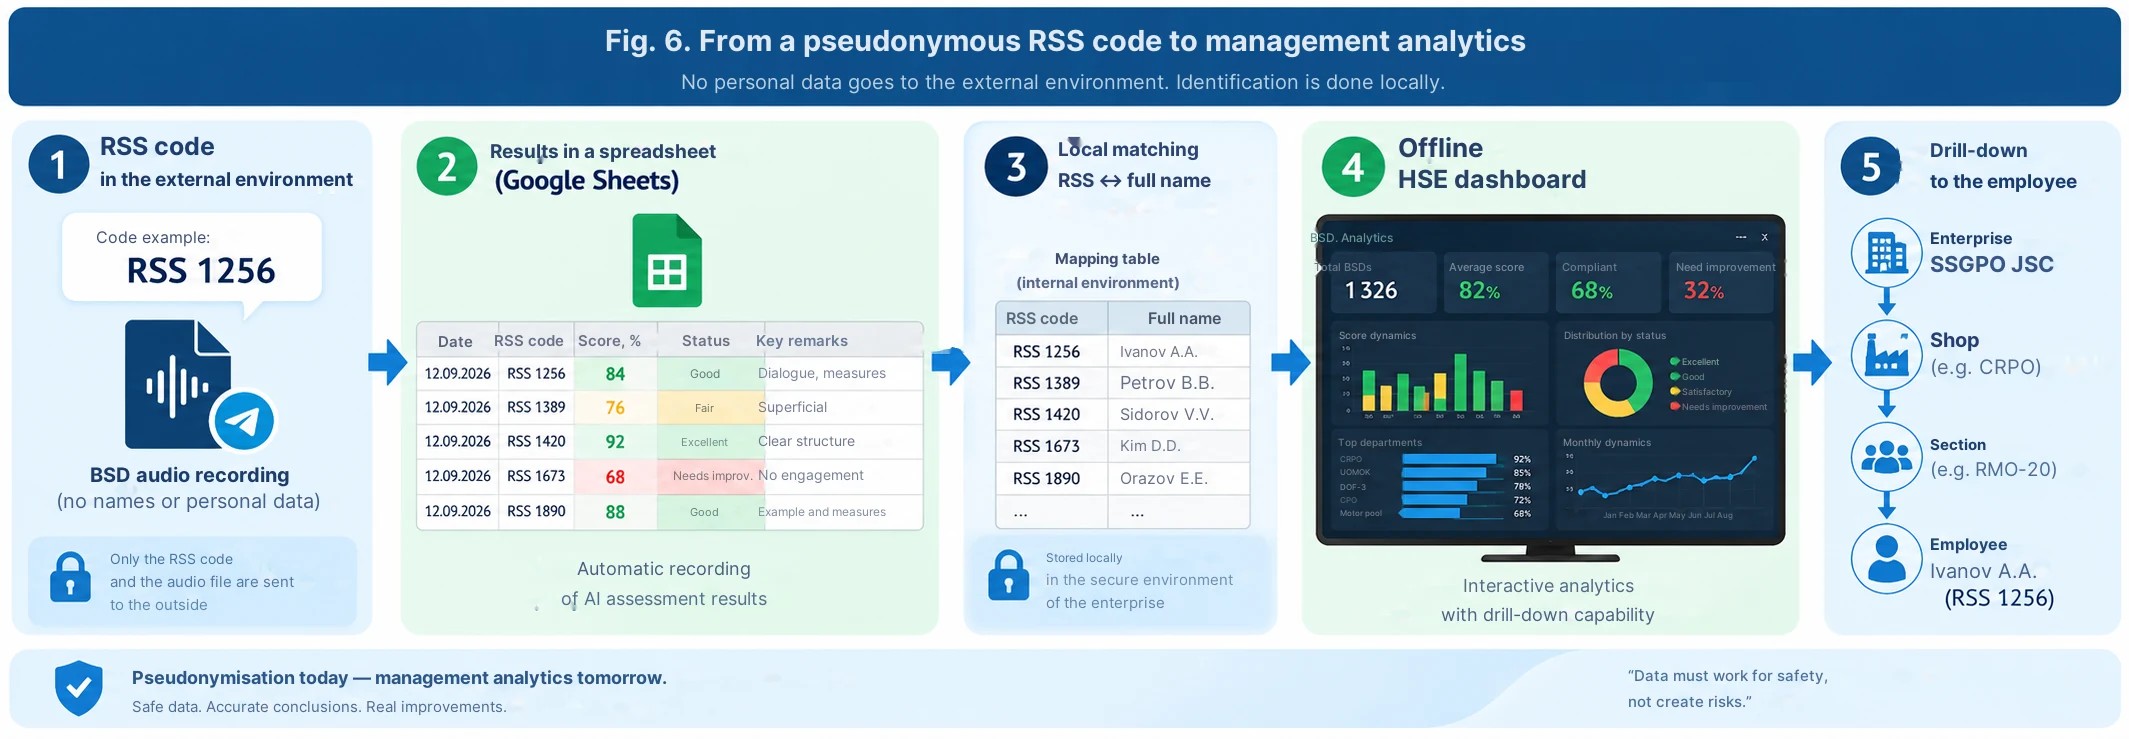
Con l'automazione di massa, abbiamo risolto separatamente la questione dell'identificazione. All'interno dell'ambiente aziendale ERGIS, a ogni partecipante viene assegnato un codice speciale del tipo RSS 1256. Non si tratta di un numero di matricola né di un cognome.
Prima di iniziare la registrazione, il responsabile pronuncia il proprio codice RSS, dopodiché conduce il BSD. Nella conversazione non c'è bisogno di nominare cognomi o numeri di matricola. La corrispondenza "codice RSS ↔ dipendente specifico" rimane all'interno dell'ambiente aziendale e viene utilizzata successivamente nell'analisi locale.
Qui è più corretto parlare non di completa anonimizzazione, ma di pseudonimizzazione: nel file audio rimane comunque la voce della persona. Ma il volume dei dati personali che passano attraverso l'ambiente automatizzato diminuisce significativamente.
Un piccolo segreto: non sono un programmatore
Abbiamo costruito l'architettura della nuova soluzione tramite Make. Non sono un programmatore e all'inizio del lavoro l'ho scritto esplicitamente a ChatGPT.
La richiesta era semplice: "Guidami attraverso la creazione di questa automazione passo dopo passo. Dammi un'azione alla volta. La eseguirò in Make e ti invierò uno screenshot. Dopo la verifica, dammi il comando successivo".
In seguito è andata esattamente così. ChatGPT spiegava quale modulo creare e cosa compilare al suo interno; io eseguivo l'azione e inviavo lo screenshot; dopo la verifica, ricevevo il passaggio successivo. Allo stesso modo è stato creato il bot di Telegram ed è stata collegata l'intera catena.
Questa è per me una conclusione importante della pratica del vibe coding: lo specialista non deve necessariamente conoscere in anticipo la sintassi dell'API o di Make. Ma deve avere una buona comprensione del processo produttivo, del risultato che l'utente deve ottenere e saper verificare in modo sequenziale ogni fase.
Prompt 3: per il prompt iniziale "guidami passo dopo passo attraverso Make", vedere l'appendice.
Cosa succede ora: Telegram → Make → IA → risultato
L'ambiente moderno funziona quasi senza operatore manuale. Il responsabile invia la registrazione audio al bot di Telegram. Make riceve il file, controlla i dati di input e avvia il percorso di elaborazione. L'IA analizza la registrazione secondo la metodologia specificata, formula la valutazione e il feedback. Il risultato viene restituito all'utente e contemporaneamente registrato in Google Sheets per l'analisi generale.
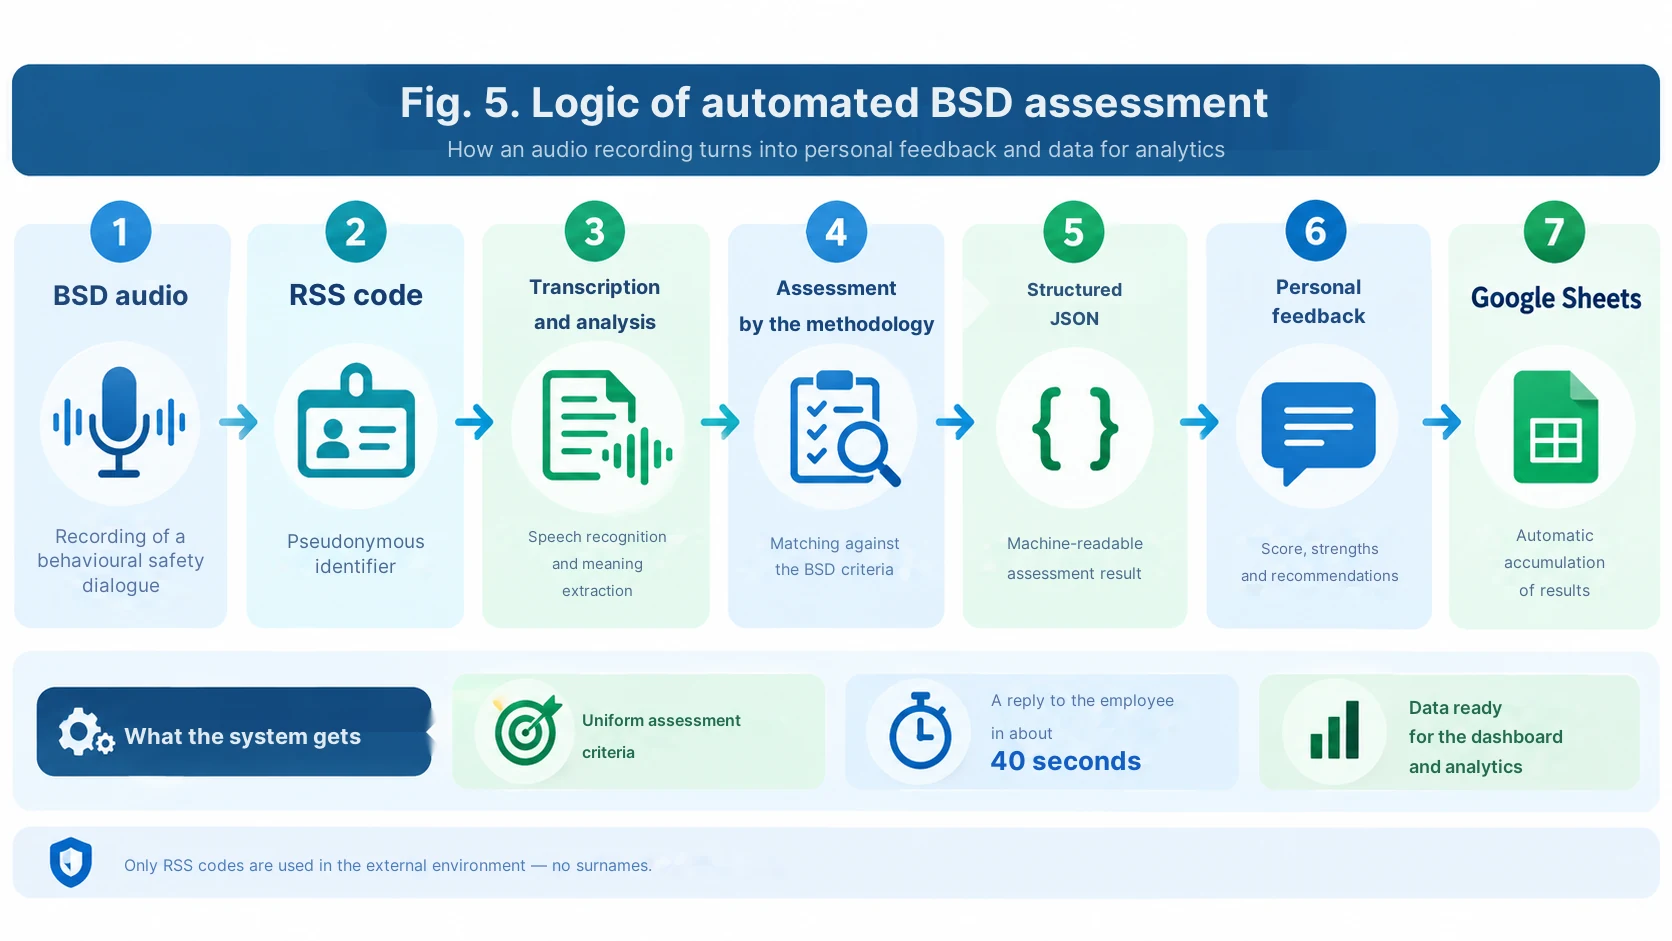
Nell'attuale progetto pilota il feedback viene restituito in circa decine di secondi. Per l'utente sembra semplice: ha inviato l'audio, ha ricevuto una valutazione, i punti di forza, gli errori specifici e cosa cambiare la volta successiva.
Dallo schema di Make si nota che dietro questa semplicità si nasconde un vero e proprio instradamento: Telegram, Data store, Router, OpenAI, Google Sheets, controlli e messaggi di ritorno all'utente.
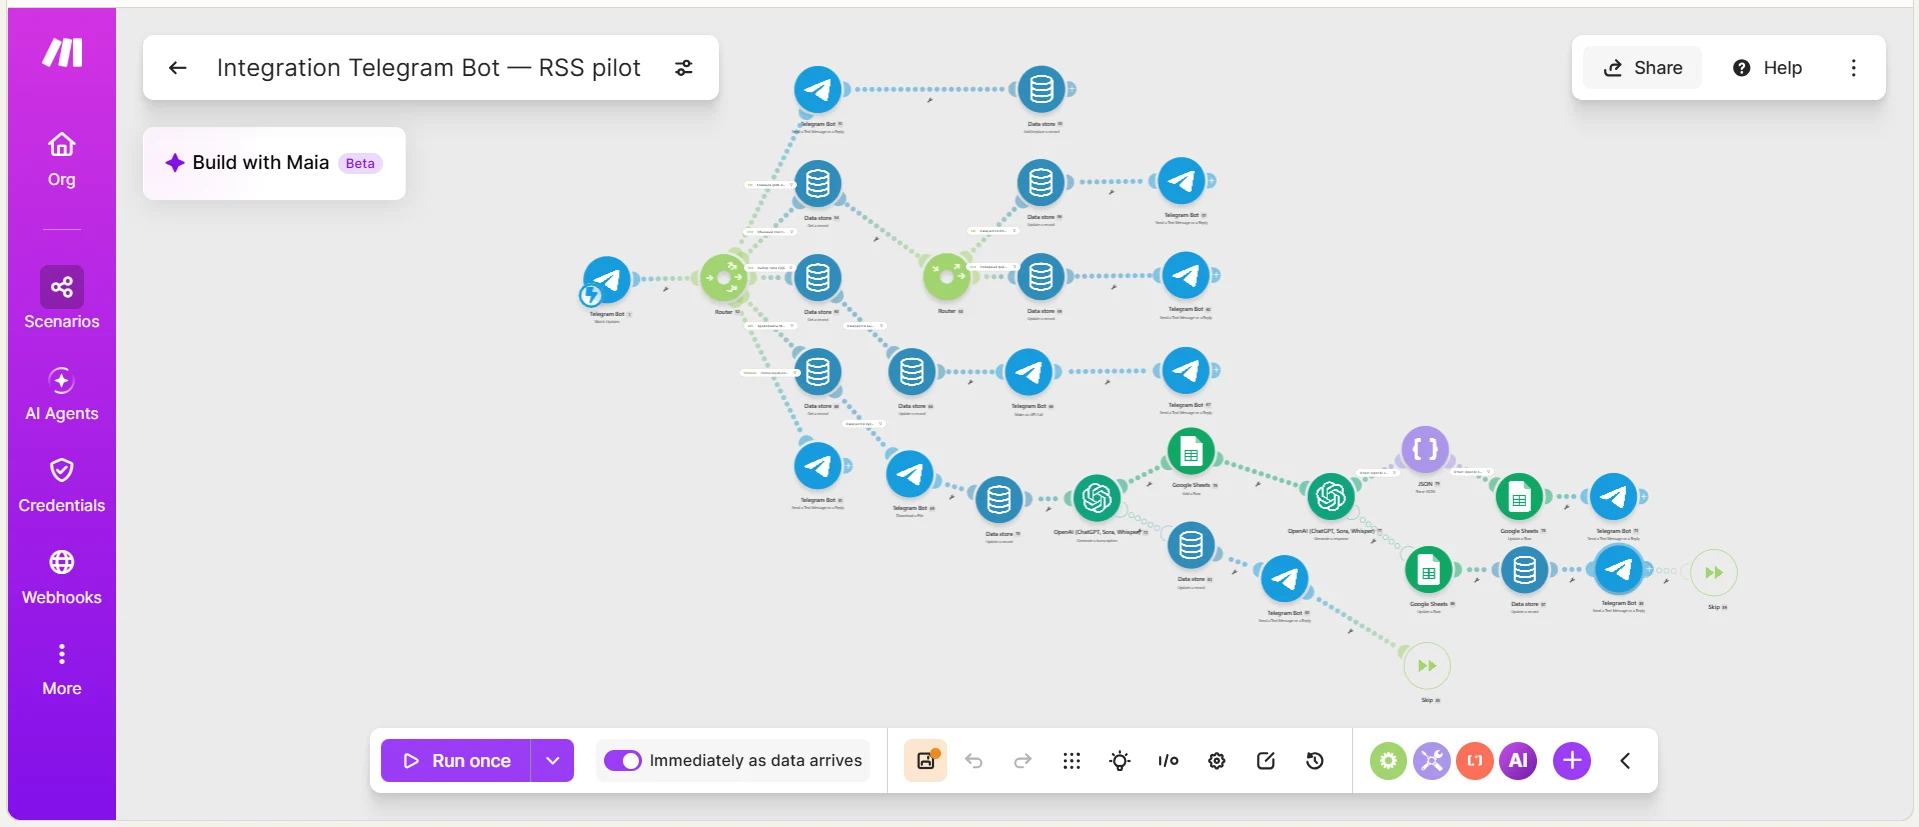
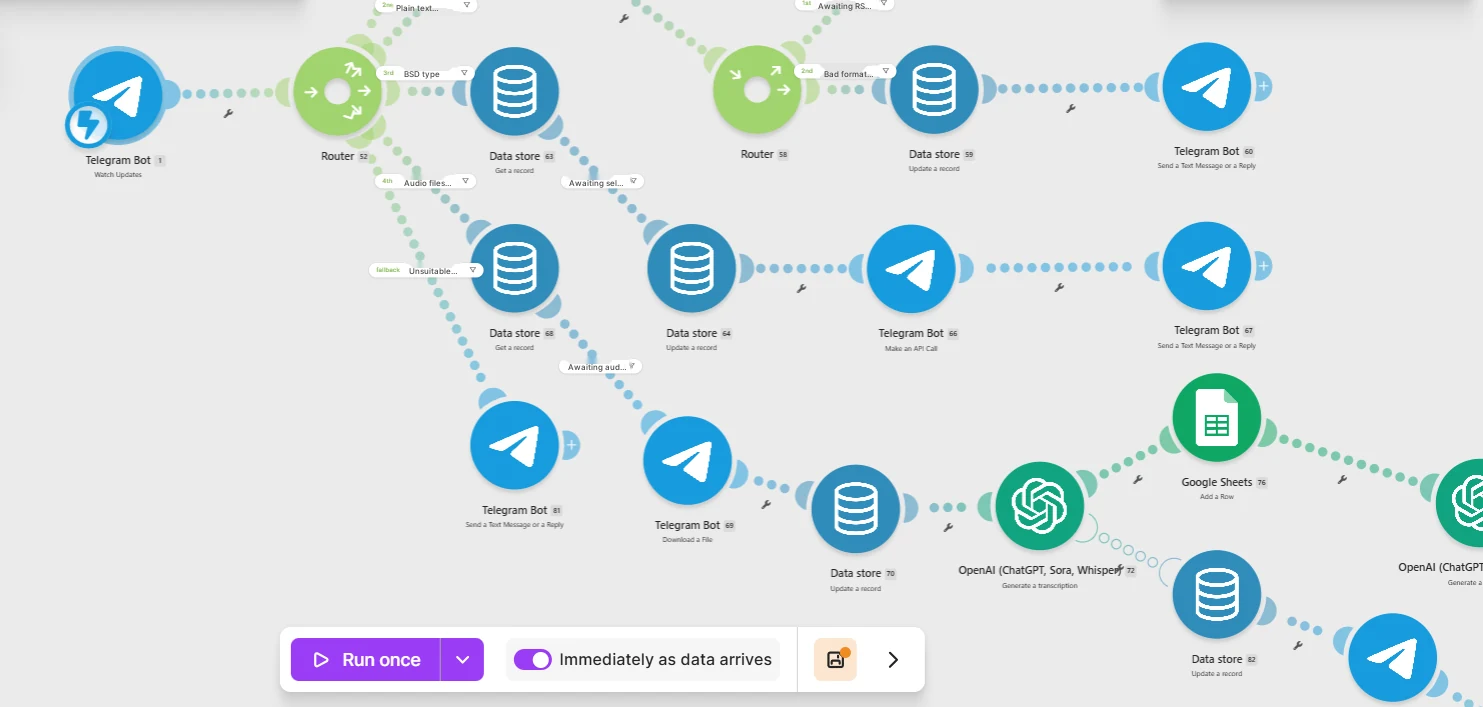
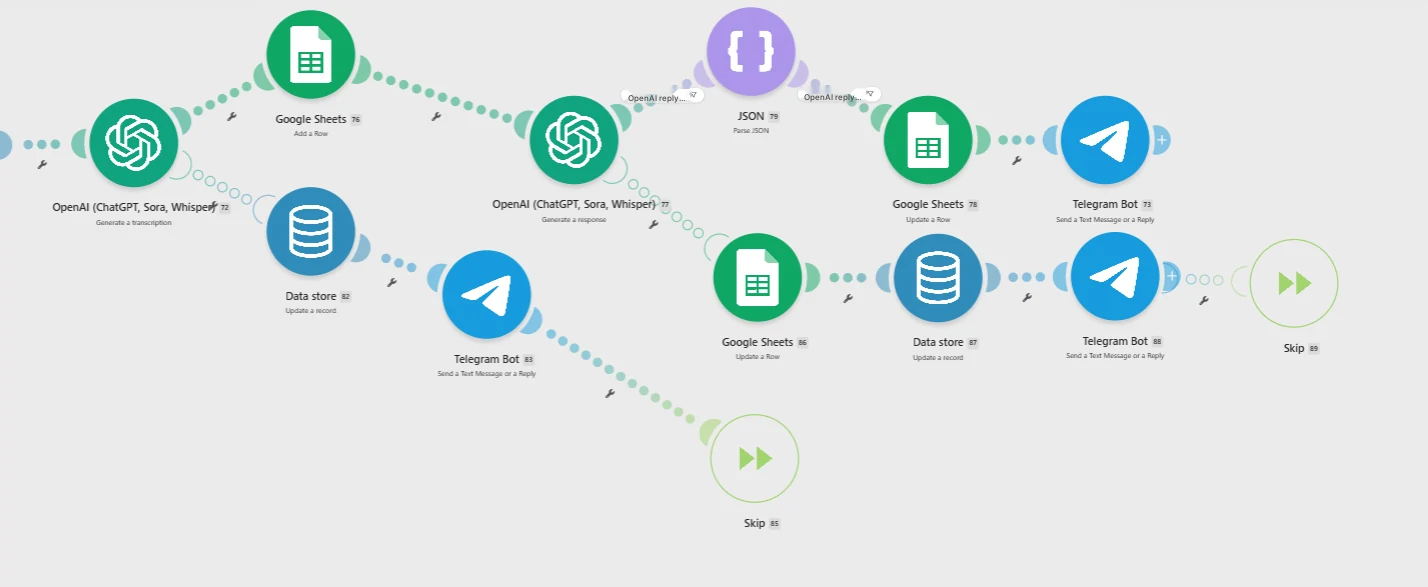
È un multi-agente o no?
Qui non userei la parola «multi-agente» solo per fare effetto. In pratica abbiamo un circuito esperto multi-fase, in cui diverse parti dello scenario svolgono funzioni diverse: ricezione e instradamento del file, estrazione dell'identificatore, analisi del contenuto, valutazione esperta, generazione del risultato strutturato, registrazione in tabella e feedback personale.
Se più chiamate distinte al modello operano con ruoli di sistema diversi — ad esempio, una analizza il dialogo, una seconda controlla la conformità alla metodologia e formatta il risultato — questo può già essere considerato come una logica multi-agente o ad agenti multipli. Se una singola chiamata al modello svolge tutte le funzioni, è più corretto parlare di un valutatore IA multifunzionale.
Nell'appendice ho quindi suddiviso i Prompt per funzione, piuttosto che chiamare ogni funzione un agente separato.
Come è strutturata la valutazione automatizzata dei BSD
Nello scenario industriale è importante separare due compiti. Il primo è quello esperto: valutare il contenuto della conversazione rigorosamente rispetto alla metodologia. Il secondo è quello tecnico: restituire il risultato in un formato che Make possa comprendere e registrare in Google Sheets.
Pertanto, per l'automazione è comoda una risposta JSON strutturata: codice RSS, punteggio finale, stato, punti di forza, aree di miglioramento, un breve feedback e i singoli criteri di valutazione. Tale formato riduce il rischio che l'automazione «si rompa» a causa di un testo del modello bello ma imprevedibile.
Allo stesso tempo, la regola ferrea rimane la stessa della primavera: non conteggiare ciò che non è presente nella registrazione; non indovinare le intenzioni; non inventare la risposta corretta al posto del responsabile. Se la trascrizione è incompleta, la registrazione deve essere ricaricata e non ricevere una valutazione inventata.
Prompts 4–6 — valutazione dei BSD, JSON strutturato e generazione del feedback: vedi appendice.
Dalla valutazione personale al quadro per reparti
Dopo ogni valutazione, in Google Sheets non si accumula più solo un feedback testuale, ma un set di dati strutturato. Perciò è possibile vedere il numero di BSD effettuati, il risultato medio, i principali errori ricorrenti, le dinamiche e i risultati in base ai codici RSS pseudonimizzati.
Il passo successivo ci è già noto dal secondo articolo: mappare localmente il codice RSS con il nome e cognome all'interno del perimetro aziendale e caricare il risultato in una dashboard HSE autonoma. In questo modo, il responsabile vede il quadro per stabilimento, reparto e settore e, se necessario, entra nel dettaglio del singolo lavoratore.
In altre parole, il circuito di valutazione esterno può funzionare senza il cognome, mentre il quadro gestionale completo viene ricostruito solo all'interno dell'azienda.
Come replicare questa idea senza la nostra architettura
Il senso dell'approccio non è vincolato a un singolo brand di IA. Nella variante più semplice, è possibile creare un Perplexity Project con la metodologia e un Prompt di valutazione. Si può usare ChatGPT con un'istruzione costante e una base di conoscenza caricata. Si può costruire uno schema attorno a Google NotebookLM / Gemini Notebook come fonte di materiali metodologici, eseguendo la valutazione con un modello separato. Per un flusso di massa è più comodo usare Make o un'altra piattaforma di automazione con Telegram, OpenAI e i fogli di calcolo.
Gli elementi chiave rimangono gli stessi: metodologia approvata → Prompt rigido → verifica della riproducibilità → scala comprensibile → feedback personale → accumulazione strutturata dei risultati.
Cosa è cambiato in pochi mesi
In primavera, un singolo dipendente trasferiva manualmente i file audio all'IA e restituiva il risultato. Oggi stiamo costruendo un circuito in grado di ricevere e valutare circa 1300 registrazioni di BSD senza un operatore dedicato per ogni file.
Ma il cambiamento principale non sta nemmeno nella velocità. Abbiamo acquisito la capacità di applicare gli stessi criteri a un gran numero di conversazioni reali e di trasformare ogni valutazione in un breve ciclo di apprendimento individuale.
In questo schema, l'IA non è un ispettore che cerca il colpevole. È al tempo stesso un secondo esperto e un digital coach: rileva la non conformità alla metodologia, spiega cosa c'è esattamente da migliorare e permette di verificarlo già nella conversazione successiva.
Conclusione
Quando abbiamo iniziato, il compito suonava come un esperimento: l'IA riuscirà a valutare un toolbox talk? Il risultato è stata una tecnologia che può essere scalata ai dialoghi comportamentali, alla formazione e ad altri tipi di comunicazioni sulla sicurezza.
Per me il risultato più prezioso non è il numero automatico. Il valore sta nel fatto che il responsabile riceve il feedback quasi subito dopo la conversazione reale, mentre l'azienda ottiene simultaneamente un set di dati su quali elementi della metodologia siano davvero difficili per le persone.
È proprio a questo punto che l'IA inizia a lavorare non al posto del sistema di gestione della sicurezza, ma al suo interno, come un secondo esperto uniforme.
Prompt per l'articolo «L'IA come secondo esperto»
Toolbox talk, verifica della riproducibilità, Make e valutazione automatizzata dei BSD
Questa è la versione per la pubblicazione dei Prompt. Si basa su una metodologia reale e sulla nostra architettura di lavoro, ma prima dell'applicazione in un'altra azienda i criteri e le soglie devono essere sostituiti con i requisiti locali approvati.
Prompt 1. Valutazione modernizzata del toolbox talk in Perplexity Project
Questa è una versione per la pubblicazione migliorata del Prompt attuale. Ho corretto le contraddizioni interne: la checklist ora contiene effettivamente 7 criteri e la soglia di superamento è unica ovunque: 80%.
Agisci come un esperto di salute sul lavoro e sicurezza industriale, eseguendo una valutazione di controllo della qualità di un safety talk condotto dal supervisore del turno.

FONTI E PRIORITÀ
1. Registrazione audio del safety talk.
2. Manuale metodologico approvato dell'azienda.
3. Checklist di valutazione approvata.
In caso di conflitto tra le diciture, fai riferimento alla checklist e alla metodologia approvate. Non aggiungere i tuoi criteri.

FASE 1. TRASCRIZIONE COMPLETA
- Ottieni prima una trascrizione completa dell'audio, non un breve summary.
- Per Perplexity Project utilizza lo strumento disponibile di lettura del file audio allegato in modalità completa (READ / massimo context budget disponibile).
- Contrassegna i frammenti incomprensibili con [incomprensibile].
- Se meno dell'80% del discorso è riconosciuto in modo coerente o manca una parte sostanziale della registrazione, rispondi solo: «Dati insufficienti. Ricarica il file.» e fermati.
- Non includere la trascrizione completa nel report finale.

FASE 2. VALUTAZIONE ESPERTA
Valuta solo ciò che è stato effettivamente detto nella trascrizione completa.
È vietato:
- indovinare le intenzioni del caposquadra;
- accreditare cose non presenti nella registrazione;
- migliorare le frasi al posto della persona valutata;
- compensare un elemento mancante con un'impressione generale buona.

SCALA PER OGNI CRITERIO
Soddisfatto = 1 punto.
Parzialmente = 0,5 punti.
Non soddisfatto = 0 punti.
Regola:
- assente nell'audio → 0;
- menzionato formalmente, senza elaborazione → 0,5;
- elaborato in modo logico e corretto → 1.

CHECKLIST — VALUTA TUTTI E 7 I PUNTI SENZA OMISSIONI
1. Presentazione di sé e dell'obiettivo del safety talk.
2. Nome del pericolo specifico / tema attuale.
3. Logica «pericolo → conseguenze → misure di sicurezza».
4. Impulso emotivo tramite conseguenze reali/potenziali o un esempio appropriato.
5. Misure di sicurezza specifiche.
6. Dialogo con i lavoratori: domande, risposte, coinvolgimento.
7. Riassunto finale e collegamento con i lavori in corso / imminenti.

FORMATO DI RISPOSTA
1. Tabella:
N. | Criterio | Cosa è stato effettivamente detto | Valutazione | Punteggio

2. Risultato:
Ottenuto: X su 7.
Percentuale: (X/7)*100, arrotondato a 1 decimale.

3. Stato del ciclo:
- se il risultato è >=80%: «Livello di superamento raggiunto»;
- se il risultato è <80%: «Livello di superamento non raggiunto. Si raccomanda un safety talk ripetuto dopo aver studiato il feedback».

4. Punti di forza — 2–5 punti specifici, solo dalla registrazione.
5. Aree di miglioramento — specificamente in base ai criteri non soddisfatti/parzialmente soddisfatti.
6. Feedback al caposquadra — 3–5 frasi: stile professionale, esigente, focalizzato sullo sviluppo.

CONTROLLO PRIMA DELLA RISPOSTA
Prima della risposta finale controlla ancora una volta:
- la somma dei punti coincide con la tabella;
- la percentuale è calcolata correttamente;
- nessuno dei 7 criteri è stato omesso;
- nessuna affermazione si basa su qualcosa che non era nell'audio.
Commento: Rispetto alla versione originale, è stato mantenuto il principio principale: prima la trascrizione completa, poi la valutazione basata solo su ciò che è stato effettivamente detto. In Perplexity il nome specifico dello strumento di lettura dei file potrebbe cambiare, quindi nella versione pubblica è meglio descrivere la funzione piuttosto che legare rigidamente il lettore al nome search_files_v2.
Prompt 2. Verifica della riproducibilità («oggettività digitale»)
Questo Prompt viene utilizzato dopo diverse esecuzioni indipendenti della stessa registrazione.
Sto convalidando la riproducibilità dell'IA valutatrice.

Ho i risultati di N valutazioni indipendenti della STESSA registrazione audio utilizzando la stessa checklist.
Ti fornirò le tabelle/JSON finali di ogni esecuzione.

Il tuo compito:
1. Confrontare la percentuale finale tra le esecuzioni.
2. Confrontare il punteggio per ciascun criterio.
3. Evidenziare i criteri su cui il modello cambia decisione più spesso.
4. Calcolare:
   - la percentuale finale minima;
   - la percentuale finale massima;
   - l'intervallo in punti percentuali;
   - la percentuale finale media.
5. Non ricalcolare la registrazione originale e non scegliere la valutazione «corretta» — analizza solo la stabilità del valutatore.

CRITERIO PER IL PILOTA
- differenza 0–2 p.p. — alta riproducibilità;
- 2,1–5 p.p. — accettabile, ma verificare i criteri controversi;
- oltre 5 p.p. — il prompt/i criteri richiedono una revisione.

Fornisci l'output nel formato:
- Livello di riproducibilità;
- Dove si verifica la variazione;
- Cosa esattamente nel prompt deve essere reso più inequivocabile;
- Se è necessario ripetere il test dopo la correzione.

Non chiamarla oggettività assoluta. Usa il termine «riproducibilità della valutazione».
Commento: La soglia di variazione nell'esempio è un riferimento pratico per la pubblicazione, non una norma aziendale approvata. Può essere rimossa o sostituita con la propria.
Prompt 3. ChatGPT come mentore passo dopo passo su Make
Questo è lo stesso principio che consente a una persona senza competenze di programmazione di replicare la soluzione.
Non sono un programmatore e non ho mai costruito scenari in Make prima d'ora.
Aiutami a creare un'automazione basata sul principio «un'azione alla volta».

OBIETTIVO
Un bot Telegram riceve una registrazione audio di un dialogo di sicurezza comportamentale (BSD). Successivamente Make deve:
1. ottenere il file;
2. verificare il tipo di input;
3. estrarre/ottenere l'audio;
4. inviare il materiale all'IA per l'analisi;
5. ricevere un risultato rigorosamente strutturato;
6. scrivere il risultato in Google Sheets;
7. inviare all'utente un breve feedback personale;
8. gestire correttamente gli errori, i file ripetuti e il formato non supportato.

REGOLE DEL NOSTRO LAVORO
- Fornisci solo UN passaggio successivo per messaggio.
- Scrivi il nome esatto del modulo Make da aggiungere.
- Scrivi cosa selezionare in ogni campo obbligatorio.
- Se è necessaria una variabile dal modulo precedente, indica la sua esatta origine.
- Dopo ogni passaggio, fermati e chiedimi di inviare uno screenshot.
- Dal mio screenshot, prima controlla se tutto è stato fatto correttamente. Se c'è un errore, correggiamolo e solo allora procediamo.
- Non saltare le fasi e non inviare l'intero scenario in una volta sola.
- Spiega in modo semplice, senza presupporre che io conosca le API, JSON o la programmazione.
- Se ci sono più modi, scegli il più semplice e affidabile per il pilota e spiega brevemente il perché.

RESTRIZIONI
- l'identificatore dell'utente nel circuito di valutazione è un codice pseudonimizzato del tipo RSS 1234;
- i cognomi e i numeri di matricola non sono necessari;
- il risultato per la tabella deve essere strutturato;
- la persona in Telegram riceve solo un feedback comprensibile, senza JSON tecnico.

Inizia con il primo passaggio: creazione/collegamento del bot Telegram e del primo modulo di input di Make.
Prompt 4. Nucleo di valutazione del BSD per OpenAI/ChatGPT in Make
Questa è una versione universale per la pubblicazione del blocco di valutazione. Restituisce intenzionalmente JSON, in modo che Make possa scrivere più facilmente il risultato nella tabella e indirizzare la risposta.
SYSTEM ROLE
Sei un valutatore esperto della qualità dei dialoghi di sicurezza comportamentali (BSD). Valuti SOLO il contenuto della trascrizione fornita e applichi la metodologia approvata dall'azienda.

IMPORTANTE
Se l'azienda ha fornito una checklist approvata separata, essa ha la priorità sulla struttura di esempio sottostante.
Non inventare criteri che non sono presenti nella metodologia.

PRINCIPI FONDAMENTALI DELLA METODOLOGIA DA VERIFICARE TRAMITE L'AUDIO
- c'è una conversazione reale con il lavoratore, non un monologo/ispezione;
- vengono poste domande al lavoratore;
- il lavoratore stesso nomina/discute il pericolo e le possibili conseguenze, se la situazione è pericolosa;
- viene discusso il modo sicuro per eseguire il lavoro;
- vengono discusse altre fonti di pericolo e misure di sicurezza;
- durante un lavoro sicuro, il supervisore nota e rinforza un'azione sicura specifica;
- la comunicazione è rispettosa;
- la conversazione si conclude con un riassunto/ringraziamento chiaro;
- non accreditare l'osservazione visiva se non può essere confermata dall'audio.

INPUT
- transcript: trascrizione completa;
- rss_id: identificatore pseudonimizzato del tipo RSS 1234;
- methodology_context: estratti/regole della metodologia approvata;
- optional_checklist: checklist locale approvata, se presente.

REGOLE DI VALUTAZIONE
1. Usa solo fatti tratti da transcript.
2. Non indovinare le intenzioni.
3. Non ricostruire il nome completo dalla voce/dal contesto.
4. Se il transcript è chiaramente incompleto o incoerente — quality_status="insufficient_data" e non assegnare un overall_score_percent.
5. Se viene applicata una checklist locale, valuta tutti i suoi punti senza omissioni.
6. Per ogni conclusione, salva una breve evidence — frase/contenuto dalla trascrizione che conferma la decisione.

OUTPUT — SOLO JSON, NESSUN MARKDOWN E NESSUN TESTO PRIMA/DOPO
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 frasi, comprensibili al supervisore del turno",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

PRIMA DI RISPONDERE CONTROLLA
- il JSON è valido;
- rss_id non è cambiato;
- il punteggio totale corrisponde alla somma dei criteri;
- evidence non contiene fatti inventati;
- se i dati sono insufficienti, non c'è un overall_score_percent inventato.
Commento: Poiché nei materiali forniti non è registrata una checklist separata a punti approvata per il BSD, non presento una scala inventata come norma aziendale. Nella versione di lavoro è necessario inserire la vostra checklist effettiva.
Prompt 5. Modulo di feedback separato in Telegram
Se nello scenario viene utilizzata una seconda chiamata del modello, è vantaggioso limitarla solo alla formattazione della valutazione pronta. Questo aumenta la stabilità: il secondo modulo non deve «ripensare» di nuovo i punti.
Ricevi il JSON PRONTO della valutazione esperta del BSD dal passaggio precedente.
Non rivalutare la registrazione e non modificare i punti.

Genera una breve risposta per l'utente per Telegram.

FORMATO
RSS: <codice>
Valutazione: <percentuale o «non valutato — dati insufficienti»>

Cosa è stato fatto bene:
• 2–4 punti brevi da strengths

Cosa migliorare:
• 2–4 punti specifici da improvements

Per il prossimo BSD:
<1–2 azioni il più specifiche possibile>

REGOLE
- 700–1200 caratteri al massimo;
- tono professionale e rispettoso;
- senza JSON tecnico;
- senza cognomi;
- non inventare nuove osservazioni;
- non usare slogan motivazionali;
- se quality_status=insufficient_data — chiedere di registrare nuovamente/ricaricare l'audio e non mostrare la valutazione.
Prompt 6. Normalizzazione del risultato prima di Google Sheets
Questo passaggio è utile se Google Sheets deve ricevere la stessa struttura indipendentemente dalla lunghezza del testo della valutazione.
Verifica la riga di dati prima di scriverla in Google Sheets.

Campi previsti:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

REGOLE
1. Non aggiungere nome e cognome né numero di matricola.
2. rss_id deve corrispondere al modello: RSS + spazio + 3–6 cifre.
3. overall_score_percent deve essere un numero 0–100 oppure vuoto con insufficient_data.
4. Converti gli array in stringhe brevi separate da «; ».
5. Se manca un campo obbligatorio — restituisci error=true ed elenca i missing_fields.
6. Se tutto è corretto — error=false.

OUTPUT SOLO JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Audit dello scenario Make pronto tramite screenshot
Adatto come Prompt finale per verificare lo scenario prima del progetto pilota di massa.
Ti invierò uno screenshot del mio scenario Make.
Conduci un audit tecnico come un mentore di automazione no-code.

Verifica tramite lo screenshot e la mia descrizione:
1. l'ordine dei moduli;
2. i percorsi del Router;
3. la gestione dei messaggi non supportati;
4. l'archiviazione dello stato temporaneo nel Data store;
5. la ricezione e la trasmissione del file audio;
6. la chiamata all'IA;
7. il parsing JSON;
8. la scrittura in Google Sheets;
9. l'invio del risultato in Telegram;
10. il ramo di errore e del nuovo tentativo;
11. il rischio di duplicati in caso di riavvio;
12. il rischio che un utente riceva il risultato di un altro.

Non proporre una ricostruzione completa se l'architettura attuale funziona.
Prima elenca:
- cosa va già bene;
- i 3 rischi più critici;
- quale UNICO passaggio successivo deve essere fatto per primo.
Dopodiché fermati e aspetta il mio screenshot/conferma.
Sequenza pratica per il lettore
- Caricare la metodologia e la checklist approvate nel Project/agente scelto.
- Configurare il Prompt 1 e testarlo su diverse registrazioni di riferimento.
- Elaborare la stessa registrazione più volte e applicare il Prompt 2 per valutare la riproducibilità.
- Se è richiesta l'automazione — iniziare con il Prompt 3 e assemblare Make un modulo alla volta con verifica degli screenshot.
- In Make usare il Prompt 4 come nucleo esperto e richiedere un JSON rigoroso.
- Se necessario, separare il feedback dell'utente nel Prompt 5.
- Prima della scrittura in Google Sheets normalizzare i dati con il Prompt 6.
- Prima del lancio di massa verificare l'intero schema con il Prompt 7.
Commenti 8
Grazie ad Alexander Bondarenko per l'articolo, c'è molto su cui riflettere. L'IA è un argomento molto di tendenza e interessante in questo momento. I colleghi hanno svolto un grande lavoro.
La soluzione proposta aiuta a ridurre il sovraccarico cronico del dipartimento di salute e sicurezza sul lavoro e sicurezza industriale e a liberare almeno un dipendente dalla routine. A mio parere, il vantaggio chiave è che il sistema funziona come un "simulatore digitale".
Tuttavia, soppesando tutti i "pro" e i "contro", non consiglierei di scalare la valutazione dell'IA delle riunioni di sicurezza di cinque minuti e, a maggior ragione, dei dialoghi di sicurezza comportamentale.
Quindi, la valutazione dell'IA:
Non abbia fretta di cercare un "secondo esperto" nell'IA, se ci sono problemi con il primo.
Ivan, grazie per il riscontro costruttivo.
Sono d'accordo con il rischio del "teatro al microfono": se l'IA viene trasformata semplicemente in uno strumento di controllo al fine di valutare, ci saranno pochi benefici.
Ma, forse, nell'articolo non ho rivelato completamente il nostro percorso futuro. La valutazione con dittafono di aprile è stata per noi principalmente un simulatore digitale.
L'IA non si è limitata a dare un voto, ma ha fornito un riscontro: cosa è stato fatto bene, cosa deve essere migliorato, come coinvolgere al meglio i lavoratori e trasmettere i rischi.
Sì, una persona poteva prepararsi e condurre una riunione di cinque minuti esemplare. Ma con questa fase ci siamo convinti della cosa principale: i nostri dirigenti sanno e sono in grado di condurla correttamente!
Oggi andiamo già oltre. Le riunioni di cinque minuti vengono valutate sistematicamente in base alle registrazioni delle telecamere fisse nei luoghi di rilascio dei permessi di lavoro, e dove non ci sono telecamere si utilizzano i registratori "Revizor". Questa non è più una registrazione appositamente preparata, ma il normale lavoro quotidiano (è inoltre accompagnata da un riscontro individuale con raccomandazioni).
Pertanto, per noi l'IA non è un sostituto del dirigente e non è un "sorvegliante digitale", ma uno strumento costante di apprendimento e riscontro. Questo è particolarmente importante per gli specialisti tecnicamente forti, per i quali non è sempre facile parlare in modo breve, chiaro e convincente con le persone.
Con i dialoghi comportamentali, tutto è davvero più complicato, e qui stiamo ancora cercando il modello ottimale. Ma il principio rimane lo stesso: l'IA non deve sostituire una conversazione dal vivo — deve aiutare il dirigente a condurla meglio.
E il criterio principale per noi non è la valutazione dell'algoritmo, ma il cambiamento nel comportamento reale delle persone!
Per garantire la sua compatibilità con i fondamenti socio-psicologici della cultura della sicurezza, il coach IA (come molti altri strumenti di controllo digitale) deve essere slegato dai KPI per i bonus dei dirigenti. La migliore e, a quanto pare, l'unica opzione efficace per il suo utilizzo è lo strumento riservato di autosviluppo, di cui Lei parla.
Nella mia esperienza, è criticamente importante creare la giusta motivazione:
Ivan, La ringrazio per le Sue parole calorose e per la discussione ricca di contenuti.
Sono completamente d'accordo: una cultura della sicurezza sostenibile non si può costruire "con la forza", specialmente quando si tratta del comportamento e del coinvolgimento personale dei dirigenti.
Noi stiamo proprio cercando di lavorare di più attraverso il riconoscimento e la motivazione positiva. Ad esempio, ogni mese, in base ai risultati di una valutazione digitale, scegliamo i sei migliori briefing sulla sicurezza di cinque minuti, analizziamo in un video separato cosa esattamente è stato fatto bene, e premiamo i capisquadra con attestati di merito dalle mani del direttore generale presso il Comitato Centrale per la Salute e Sicurezza sul Lavoro — di persona davanti a un vasto pubblico (300) di dirigenti e specialisti.
Con 1300 dirigenti, specialisti e impiegati, questa è già una concorrenza piuttosto seria e, cosa importante, un riconoscimento pubblico delle buone pratiche.
Ora stiamo iniziando a estendere questo approccio anche alle aziende appaltatrici.
La ringrazio per lo scambio di opinioni.
Anche io seguo con attenzione le Sue pubblicazioni e le pratiche dei colleghi.
In fin dei conti, stiamo tutti portando avanti una causa comune — cerchiamo modi funzionanti per sviluppare la cultura della sicurezza e renderla veramente viva, non formale!!!
Uno strumento interessante.
Ho una domanda sulla riservatezza: quanto sono sicure per l'azienda le informazioni che vengono caricate nel bot? Ora molti lo usano, ma ci sono dubbi che l'uso aperto dell'IA senza servizi cloud locali non sia molto correlato al problema della perdita di dati..
Come hanno reagito il servizio di sicurezza e gli avvocati a questo progetto? O comunque Lei protegge in qualche modo i Suoi dati caricati nel bot Telegram? (forse non ho capito del tutto bene il meccanismo o mi è sfuggito questo punto da qualche parte).
Irina, La ringrazio, la domanda è assolutamente pertinente!
Nella versione iniziale con Make, abbiamo deliberatamente ridotto al minimo i dati personali: nomi completi, numeri di matricola, posizioni e altri identificatori non vanno nel cloud — ma solo un codice casuale individuale e la registrazione audio. Allo stesso tempo, è importante capire: anche la voce stessa appartiene ai dati personali, quindi questo approccio non risolve completamente il problema della riservatezza. Nel video dell'articolo, Lei può vedere esattamente come è stato costruito questo schema.
Parallelamente, il nostro team per la salute e sicurezza sul lavoro e sicurezza industriale ha sviluppato una seconda opzione — già completamente all'interno del perimetro aziendale sulla nostra IA interna Fire. Dopo il comitato centrale per la salute e sicurezza sul lavoro, che si è tenuto due giorni fa, è proprio in questa direzione che abbiamo deciso di procedere.
Ora Fire estrae già la traccia audio dalle registrazioni di telecamere fisse o videoregistratori, trascrive la riunione di cinque minuti, effettua una valutazione secondo criteri definiti, genera feedback e trasferisce i risultati alla dashboard. Elaborando ripetutamente la stessa registrazione, otteniamo una valutazione stabile secondo le stesse regole.
Inoltre, l'obiettivo qui non è quello di «dare un voto» al manager. Abbiamo circa 1.300 ingegneri e tecnici, e il sistema ci permette di vedere esattamente la sistematicità: se una persona è in grado di condurre brillantemente una riunione dimostrativa di cinque minuti non solo una volta, ma lo fa davvero con alta qualità in ogni turno. Dove necessario — per fornire ulteriore formazione, da qualche parte per correggere la comunicazione con le persone, da qualche parte per vedere una buona pratica consolidata.
Seguendo lo stesso principio, dal 1° ottobre è stato lanciato un secondo perimetro interno per valutare i dialoghi comportamentali sulla sicurezza.
Pertanto, Lei ha sollevato il tema della fuga di dati in modo assolutamente corretto: per l'IA cloud, questo è un problema reale.
Abbiamo iniziato con la massima anonimizzazione e ora stiamo passando all'elaborazione all'interno di un perimetro aziendale protetto.
La ringrazio per una risposta così dettagliata. Ora è tutto chiaro. Ho preso nota della Sua esperienza