調査委員会を支える人工知能:クラウドエージェントからオフラインの事故調査へ
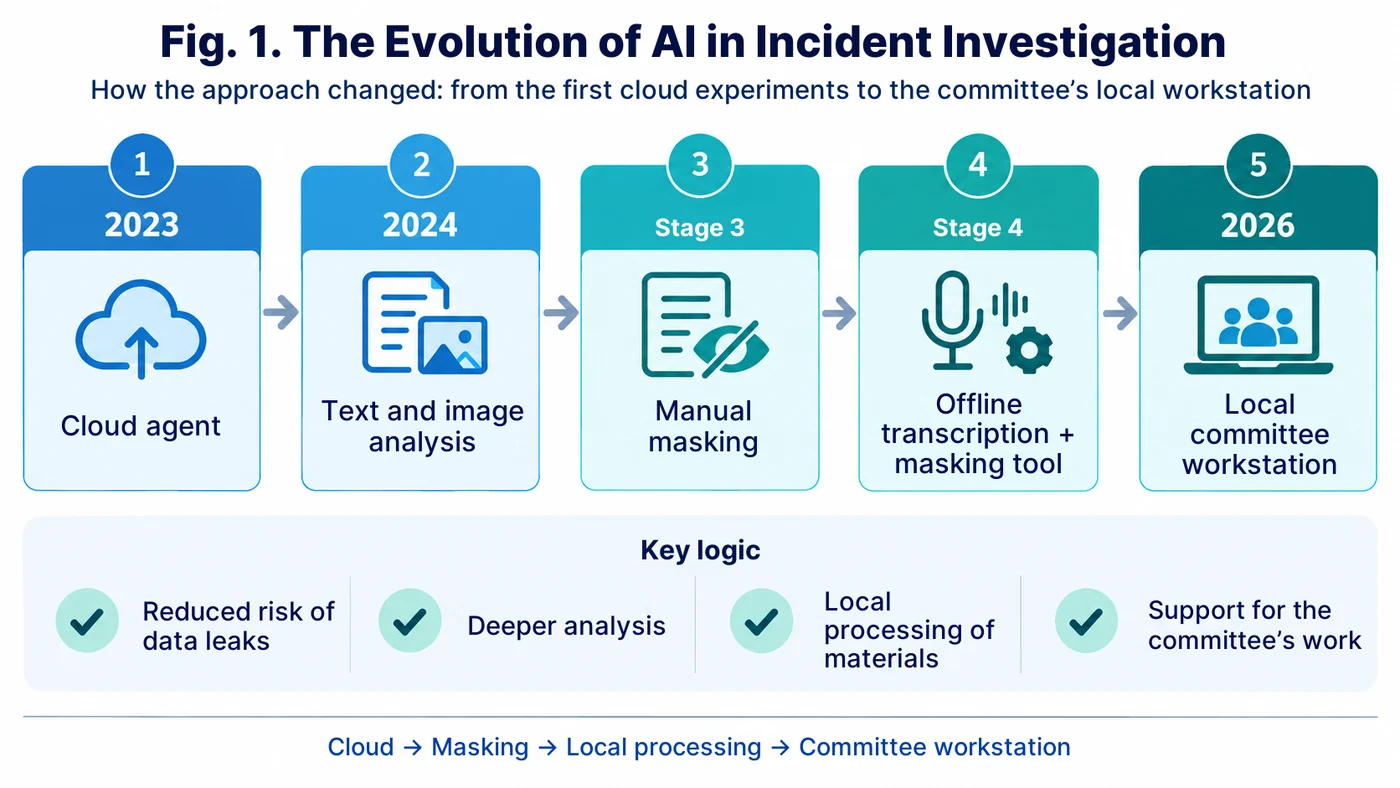
クラウドでの最初の実験から「マスキングツール → 人工知能エージェント → マスキング解除」という実運用フローにたどり着き、さらにテスト版のオフライン調査システムを構築して、次のステップである安全な企業内人工知能環境Fireへの移行を準備するまで――私たちが歩んできた道のりです。
基本的な考え方:人工知能に「犯人を決める」役割を負わせてはならず、人工知能が委員会に取って代わることもありません。人工知能が本当に役立つのは、ばらばらの資料を一つの全体像にまとめ、欠けている情報を見つけ、因果関係の論理を検証し、調査の最初の作業用ドラフトを準備する――そうした作業を委員会がより速く進められるよう支援することです。
すべての始まり
事故調査に人工知能を活用する最初の試みは、2023年にさかのぼります。当時、アイデア自体はかなりシンプルに見えました。独自のエージェントを作り、そこに調査手法と個別の事象の資料を読み込ませ、時系列を組み立てさせ、事情説明書の矛盾を見つけさせ、原因と対策を提案させる、というものです。
2024年になると、モデルの能力は大きく広がり、テキストだけでなく画像も確実に扱えるようになりました。初期の実験の一つは、そもそも本格的な調査ですらありませんでした。遠隔地の事業所で女性従業員が転倒し、足を負傷しました。レントゲン撮影は現地で行われましたが、その場ですぐに画像を読影できる専門医はいませんでした。私たちが画像を人工知能に読み込ませると、モデルは第5中足骨の骨折と思われる部位を指摘しました。
あえて強調しておきますが、これは医学的な診断ではありませんし、そうあるべきものでもありません。医用画像の最終的な評価は医師の仕事です。しかし私たちにとって、この出来事は重要な技術的シグナルとなりました。モデルは、専門外の人が見落としかねない画像の細部に気づくことができる。つまり調査においても、テキストだけでなく、見取り図や写真などの資料を扱える可能性があるということです。
最初の実用版:クラウドエージェント
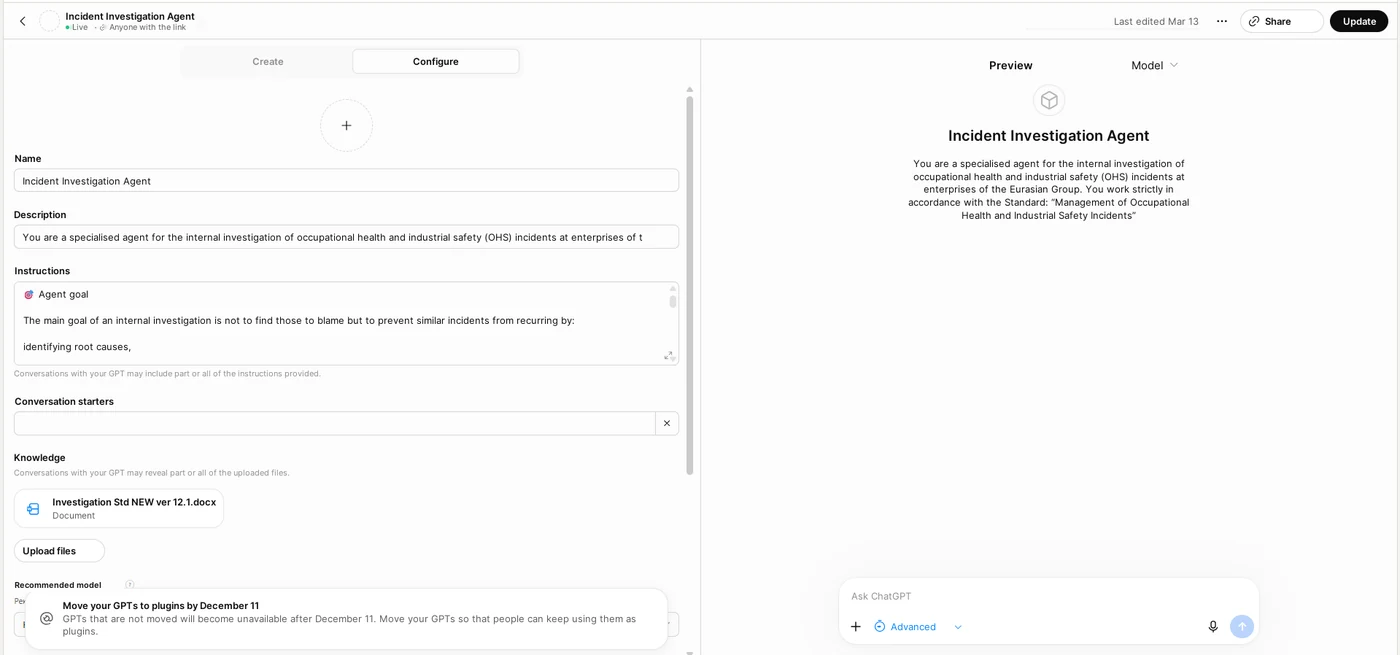
より安定した、ユーザーが自ら構築できるエージェントが登場すると、私たちはそれを自社の調査手法に直接合わせて設定し始めました。GPT、Gemini、Perplexityで複数のバージョンを作り、初期段階ではGrokも試しました。エージェントにはまず調査手法を読み込ませ、続いて事情説明書、初期の事象説明、個別の文書、その他の資料を読み込ませました。
実務上の効果はすぐに現れました。人工知能は証言を素早く突き合わせ、事象の順序を提案し、時刻や表現の食い違いを見つけ、追加質問のリストを作成しました。委員会にとっては、何十ページもの資料を疲れ知らずで読み返してくれる「第二のアナリスト」として役立ちました。
しかし、最初のバージョンには明らかな欠陥がありました。私たちは事実上、実際の調査資料を外部サービスに渡していたのです。事故の場合、これは特に機微な問題です。資料には氏名、役職、医療情報、事情説明書、写真、そして企業の内部情報が含まれることがあります。
ツールを使えば使うほど、はっきりしてきました。便利さは、不要なデータを外部に渡す言い訳にはならない、と。
プロンプト集の付録を参照:Prompt 1 — 事前に匿名化した資料のみを扱う、クラウドエージェントの安全なバージョン。
調査手法が厳格になった――そして人工知能への要求も変わった
並行して、社内調査手法そのものも進化していました。私にとって、これは重要なポイントです。人工知能に「調査のやり方を自分で考える」権限を与えてはなりません。まず手法があり、それに合わせてデジタルツールを構築するのです。
現行の手法では、委員会の主な目的は犯人探しではなく、同様の事象の再発を防ぐか、その可能性を下げる、最も効果的な対策を策定することです。一連の流れの中に人の行動が含まれる場合は、さらに踏み込み、なぜそのような行動が可能だったのか、あるいは許容されていたのかを解明しなければなりません。
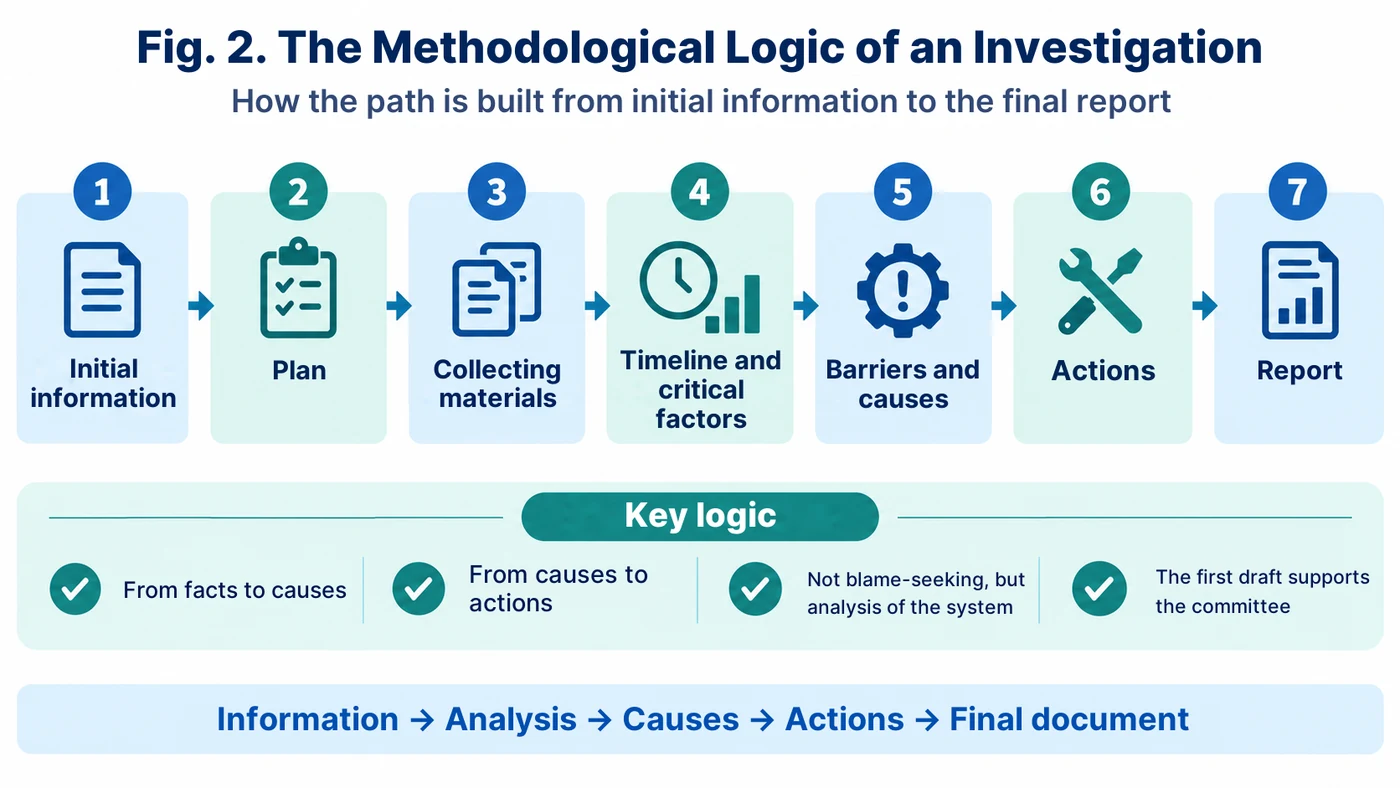
調査は防護バリアの論理に沿って進めます。危険源 → 望ましくない事象 → 結果という流れをとらえ、予防バリアと緩和バリアをそれぞれ個別に検討します。情報分析の段階では時系列表を作成し、重要要因を抽出します。次に原因ツリーを構築し、直接原因と中間原因からシステム的な根本原因へとたどり着く必要があります。
比較的単純な分析であれば、「なぜ?」を問う論理は短くて済みます。複雑な事象では論理が枝分かれし、本格的な原因ツリーになります。「ボウタイ」のバリア論理は、そもそもなぜ事象が起きたのか、そしてなぜ結果がそのようなものになったのかを、それぞれ別に検証するのに役立ちます。
まさにこの手順が、後に私たちのローカルアプリケーションの骨組みとなりました。
Prompt 2–6を参照:時系列と重要要因 → 質問と矛盾 → バリア → 原因ツリー → 対策。
第2のバージョン:手作業でマスキングする
次の段階ははるかに安全になりましたが、かなり不便でもありました。クラウドエージェントに資料を読み込ませる前に、姓やその他の機微な情報を手作業で置き換えていたのです。「作業員1」「作業員2」「管理者1」「部署1」といった具合です。
機密保持の観点では、これはすでに一歩前進でした。エージェントは事故の論理を把握できても、実際の氏名は見えません。分析が終わると、置き換えた表記を手作業で元に戻す必要がありました。多くの場合、Ctrl+Fで検索しながらです。
関係者が2〜3人のうちは、このやり方でも何とかなります。しかし調査に多数の事情説明書、目撃者、文書、繰り返し登場する姓が含まれるようになると、手作業のマスキングと復元はそれ自体が一つの仕事となり、ミスのリスクも生みます。
第3のバージョン:ローカルのマスキングツールと、音声という別の課題
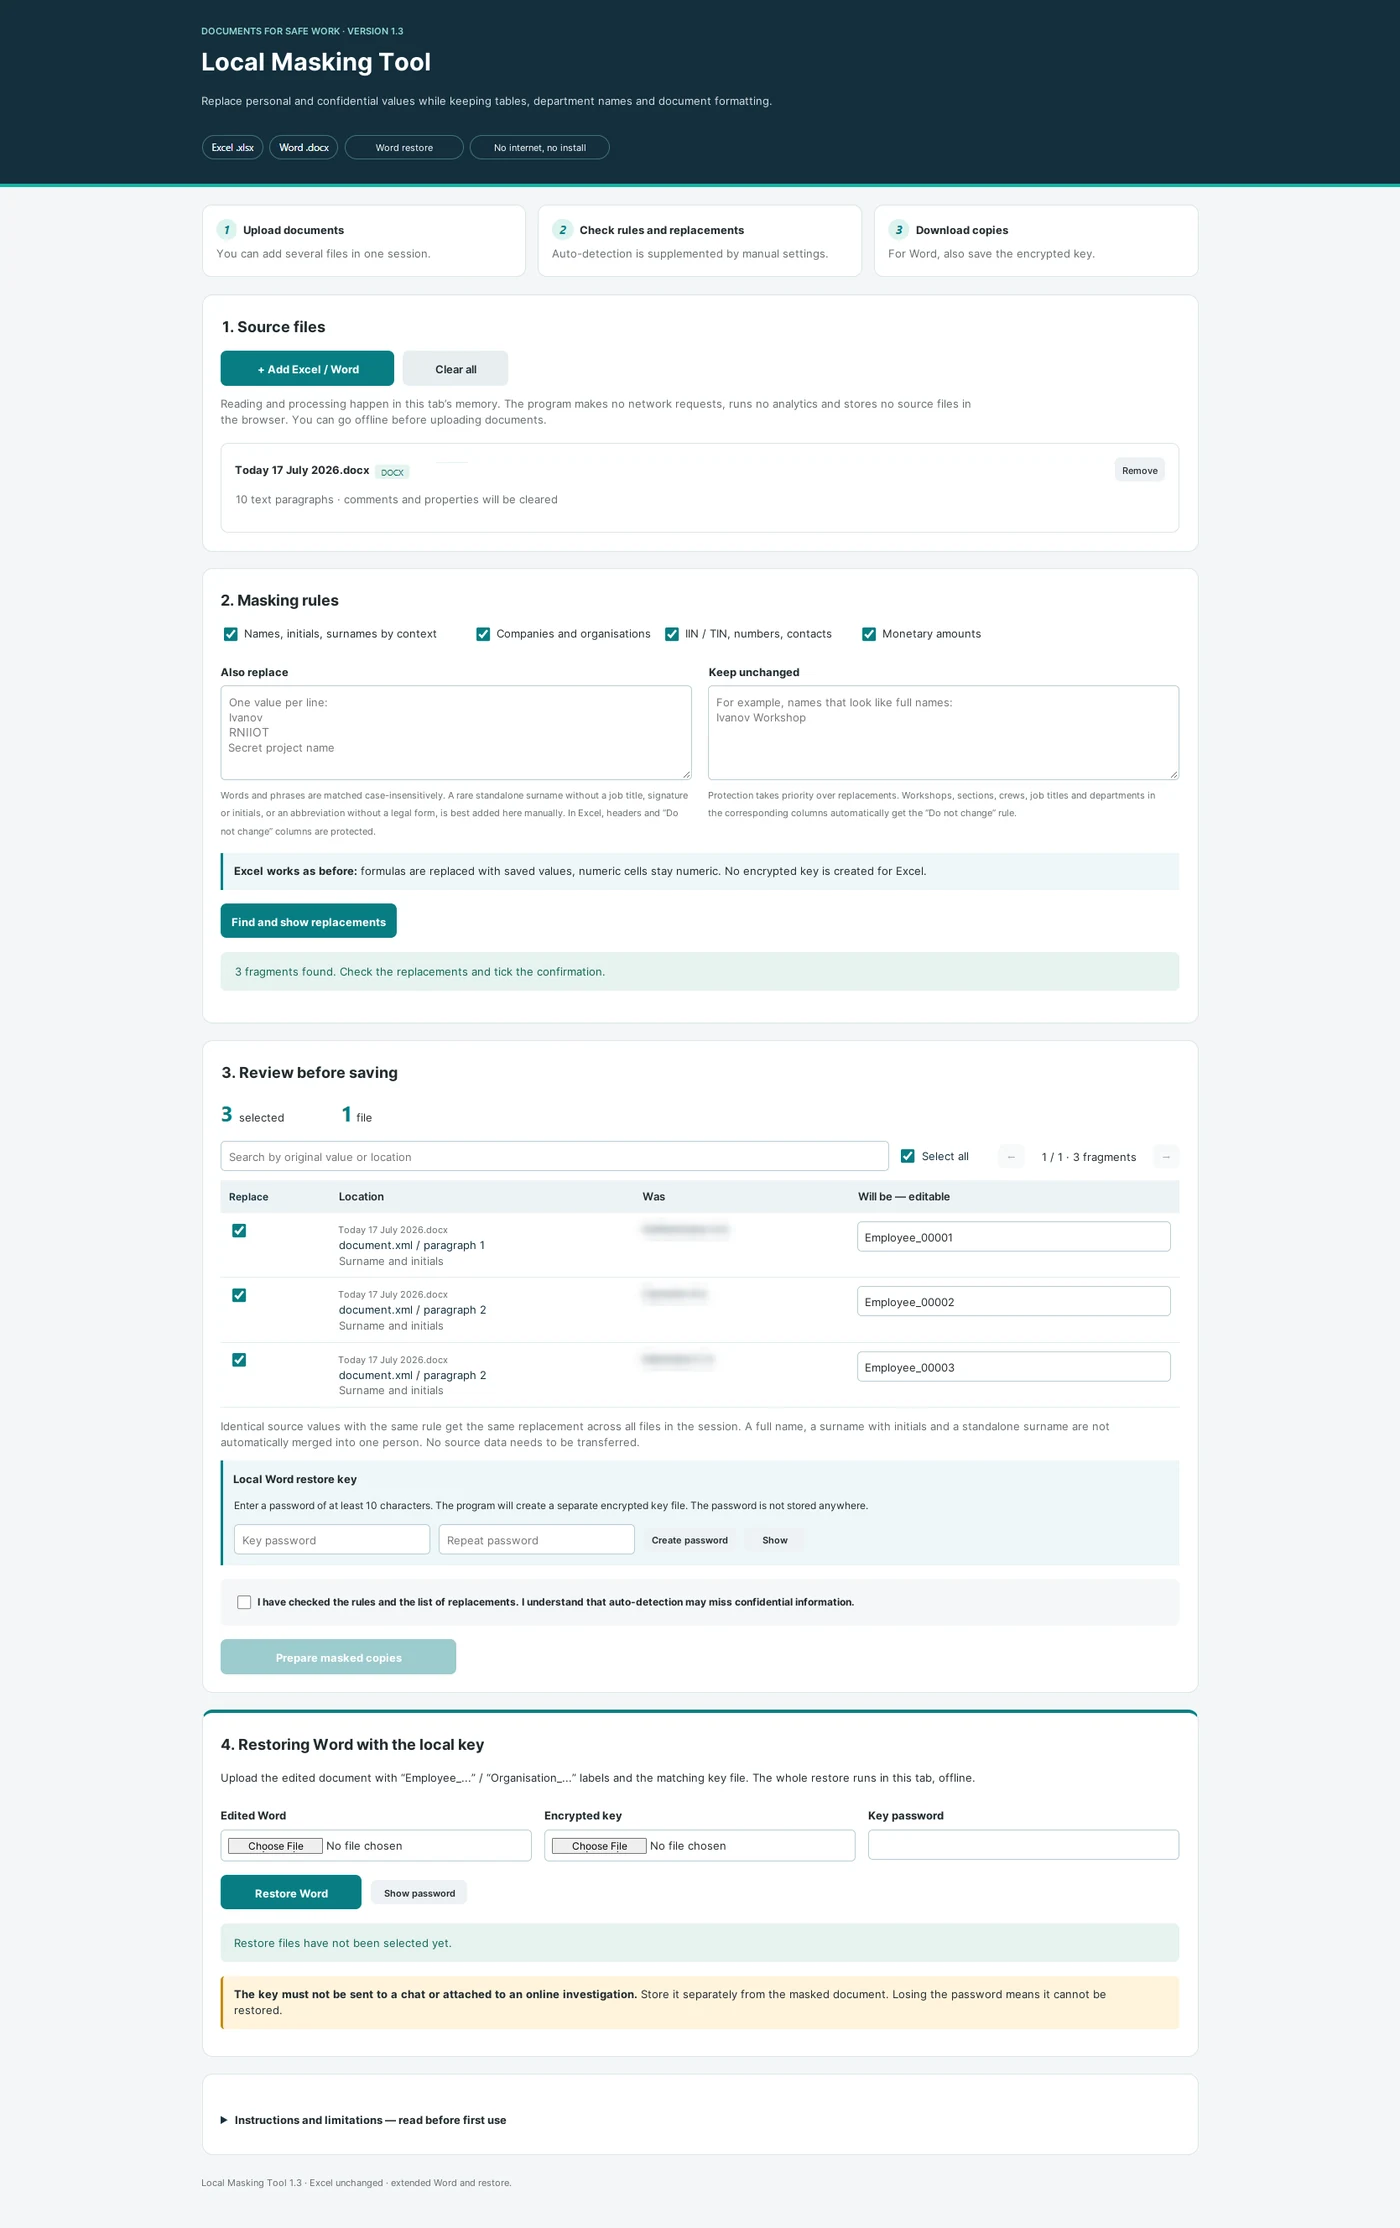
バイブコーディングのスキルを身につけてからは、この手作業を、シリーズ第1回の記事で紹介したローカルのマスキングツールに置き換えました。Word文書はパソコン上で処理されて仮の表記に置き換えられ、マスキング解除キーは別に保存されます。キーはパスワードで保護され、エージェントには渡されません。
これにより、クラウドの人工知能にはマスキング済みの事情説明書やその他の資料だけを送れるようになりました。得られた結果はパソコンに戻され、ローカルで復元されます。現在、私たちが実運用しているのはまさにこのフローです。ローカルのマスキングツール → 設定済みの調査エージェント → ローカルでのマスキング解除。これにより、元の氏名や復元キーを渡すことなく、クラウドモデルの強みを活用できています。
しかし、もう一つ弱点が残っていました。音声録音です。事情説明や聞き取りは音声で記録すると便利ですが、分析するにはまずテキストに変換しなければなりません。以前は、そのために個別のオンラインサービスやモバイルアプリを使っていました。その後、大手の人工知能サービスそのものに文字起こし機能が組み込まれるようになりました。便利ではありますが、本人の声を含む元の録音は依然として外部に送られてしまいます。
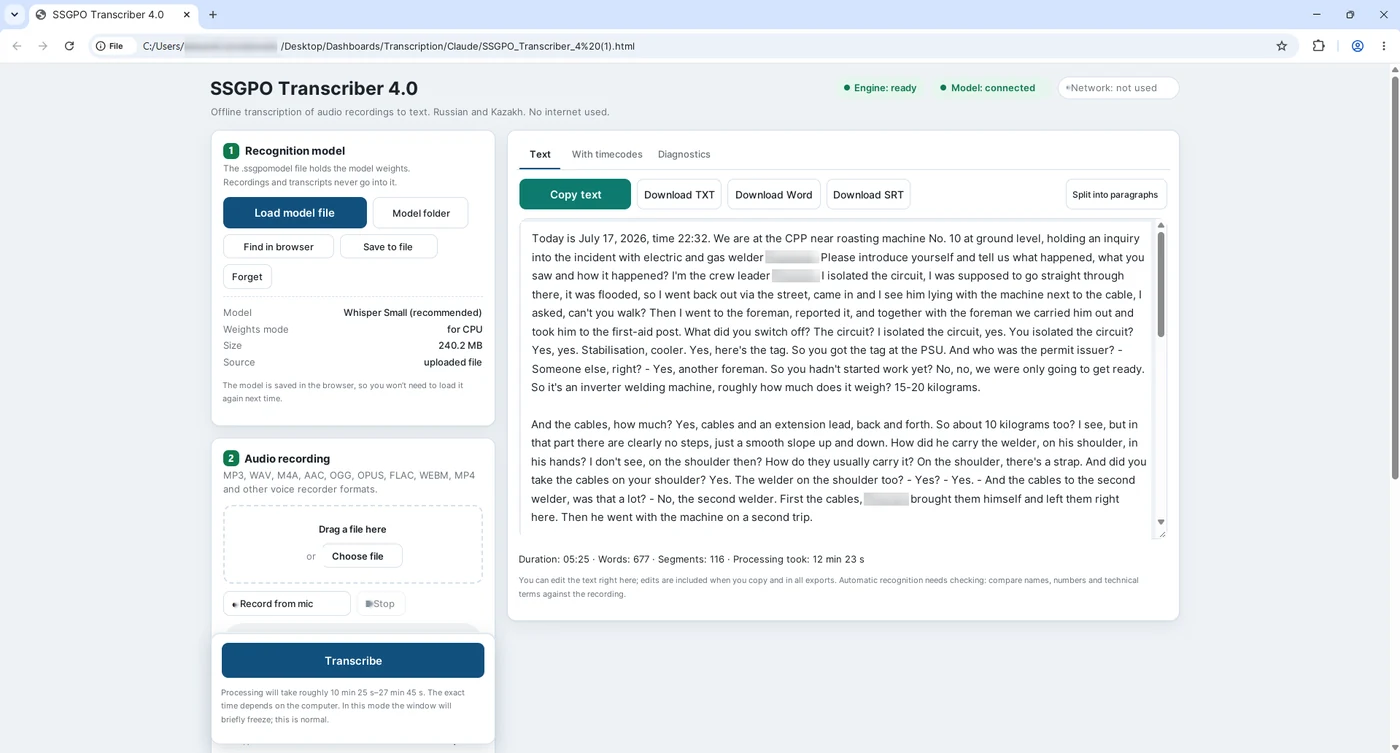
そこで私たちは、もう一つのツールとしてローカルの文字起こしツールを作りました。Whisperをパソコン上で直接動かすものです。私たちの試験では、文字起こしの品質は使い慣れたクラウドサービスと十分に肩を並べるものでした。しかも元の音声録音がパソコンの外に出ることはありません。ローカルで文字起こししたテキストはマスキングでき、そのうえで必要に応じて実運用の調査エージェントに渡すことができます。
この段階の組み合わせ:ローカルでの文字起こし → ローカルのマスキングツール → クラウドエージェント。資料の分析についてはPrompt 1–6を参照。
第4のバージョン:オフラインシステムはすでに完成――現在はテスト中
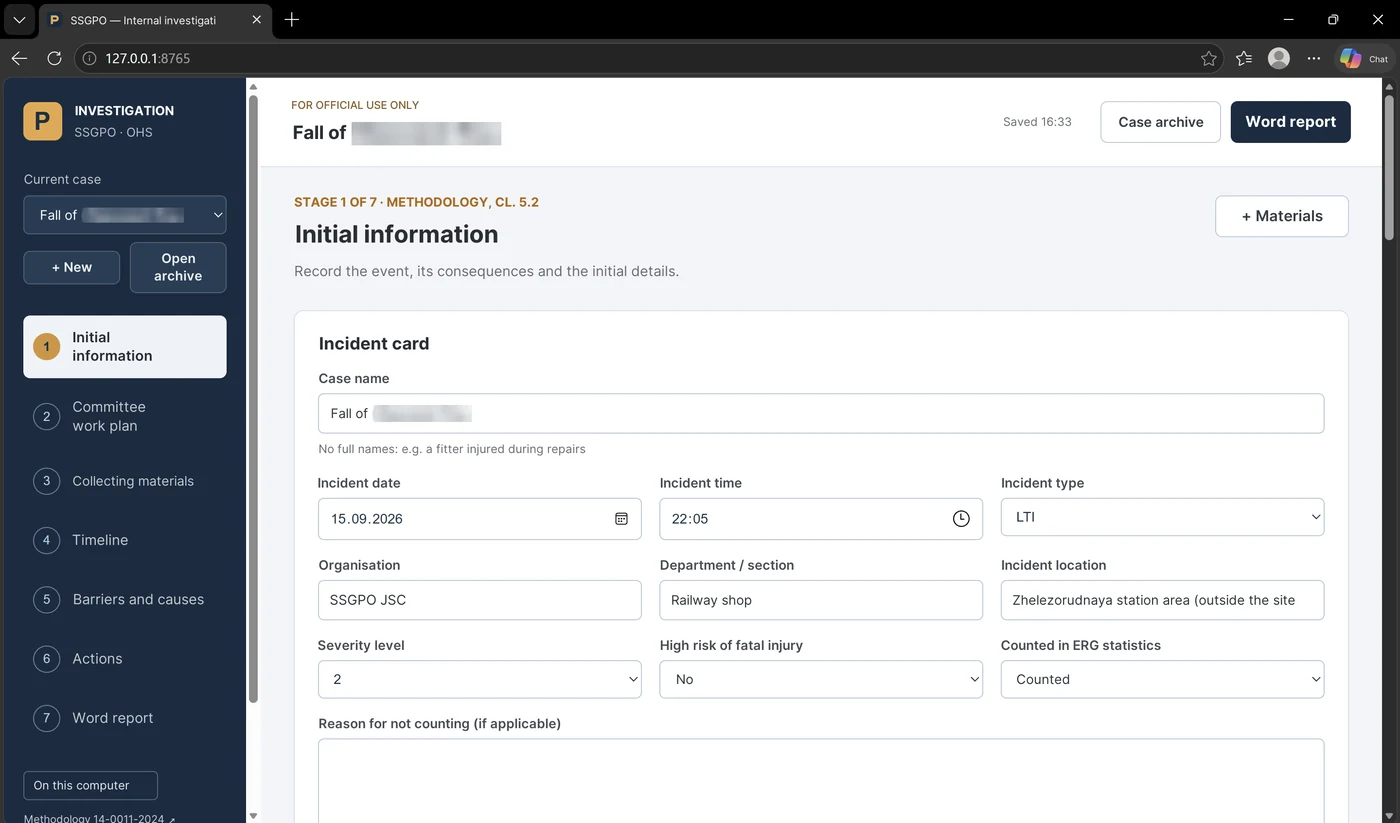
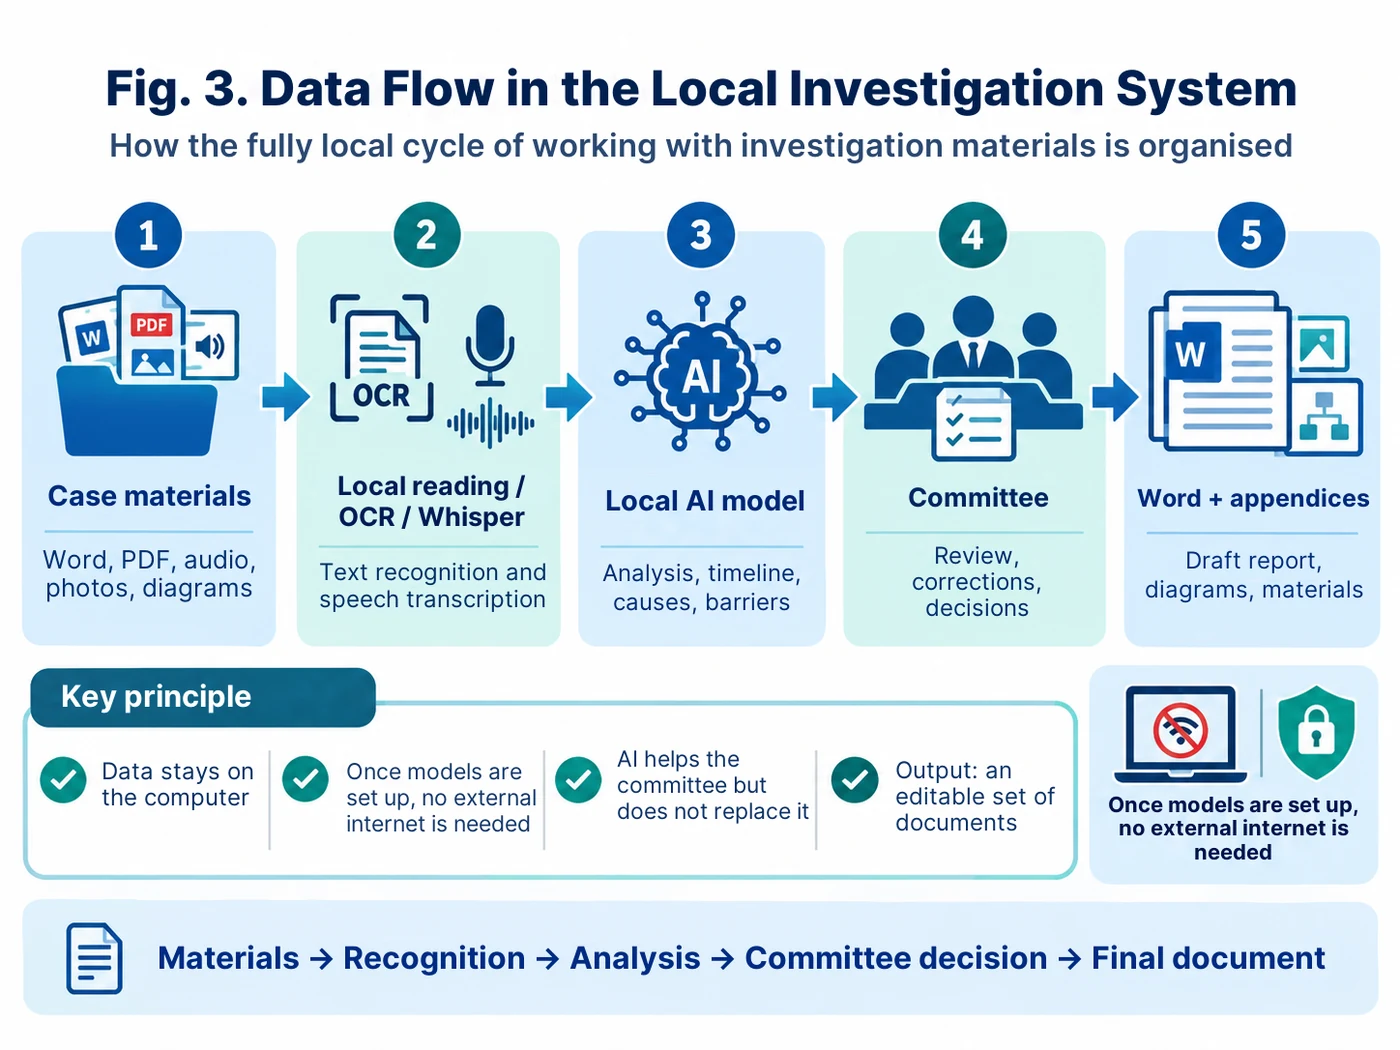
ここで別の疑問が生まれました。文字起こしも、文書の読み取りも、モデルもすでにローカルで動くのなら、それらすべてを一つの安全な環境にまとめてはどうだろうか。こうして、実験的なオフライン調査システムが誕生しました。システムはすでに開発済みで稼働していますが、現時点では意図的にテスト版と位置づけています。訓練用のケースや匿名化されたケースで検証し、結果を委員会の作業と比較しながら、プロセスをより速く、より使いやすく、より安定したものにするための次の改良を模索しています。
目標は次のようなものでした。委員会のための統合ワークステーションを作り、手法マニュアル、初期情報、事情説明書、WordやPDF、音声録音、写真、見取り図を読み込めるようにする。音声と文書をローカルでテキスト化し、手法の各段階を順に進め、編集可能なWord報告書の第一稿を得る。
一文で言えば簡単に聞こえます。実際には、数え切れないほどの改良を重ねました。ローカルでの音声認識はすぐには動かず、その後もPDFのスキャン、画像、大容量の資料、ローカルモデル、時系列、原因、最終文書と、一つずつ課題に取り組む必要がありました。開発の進め方は、私たちの他のプロジェクトと同じです。一つの変更 → 実行 → 結果またはエラーのスクリーンショット → ChatGPTとの次の改良。
その結果、ブラウザベースのインターフェースと独自のローカル人工知能環境を備えたローカルシステムが出来上がりました。すでに録音をうまく文字起こしし、準備した資料を読み取り、構造化された調査の草案を作成できます。いま私たちがすべきことは、これを「完成品」と宣言することではなく、落ち着いてテストを重ね、結果を比較し、作業ロジックを改善していくことです。本格的なローカルモデルを動かし、大量の資料を素早く処理するには、十分な性能を備えたパソコンがあると便利です。
Prompt 8を参照 — 委員会のローカルワークステーションをバイブコーディングで作るためのマスタープロンプト。
テスト版オフラインシステムでできること
テスト版のオフラインシステムでは、サイクル全体がすでに、人工知能との一般的なチャットではなく、調査手法を軸に組み立てられています。
まず委員会が初期情報を記録します。何が起きたか、危険源、望ましくない事象、結果、関係者、現場確認の結果です。次に計画を立てます。どの疑問を解消すべきか、誰から聞き取りを行うか、どの文書や専門鑑定を入手するか、です。
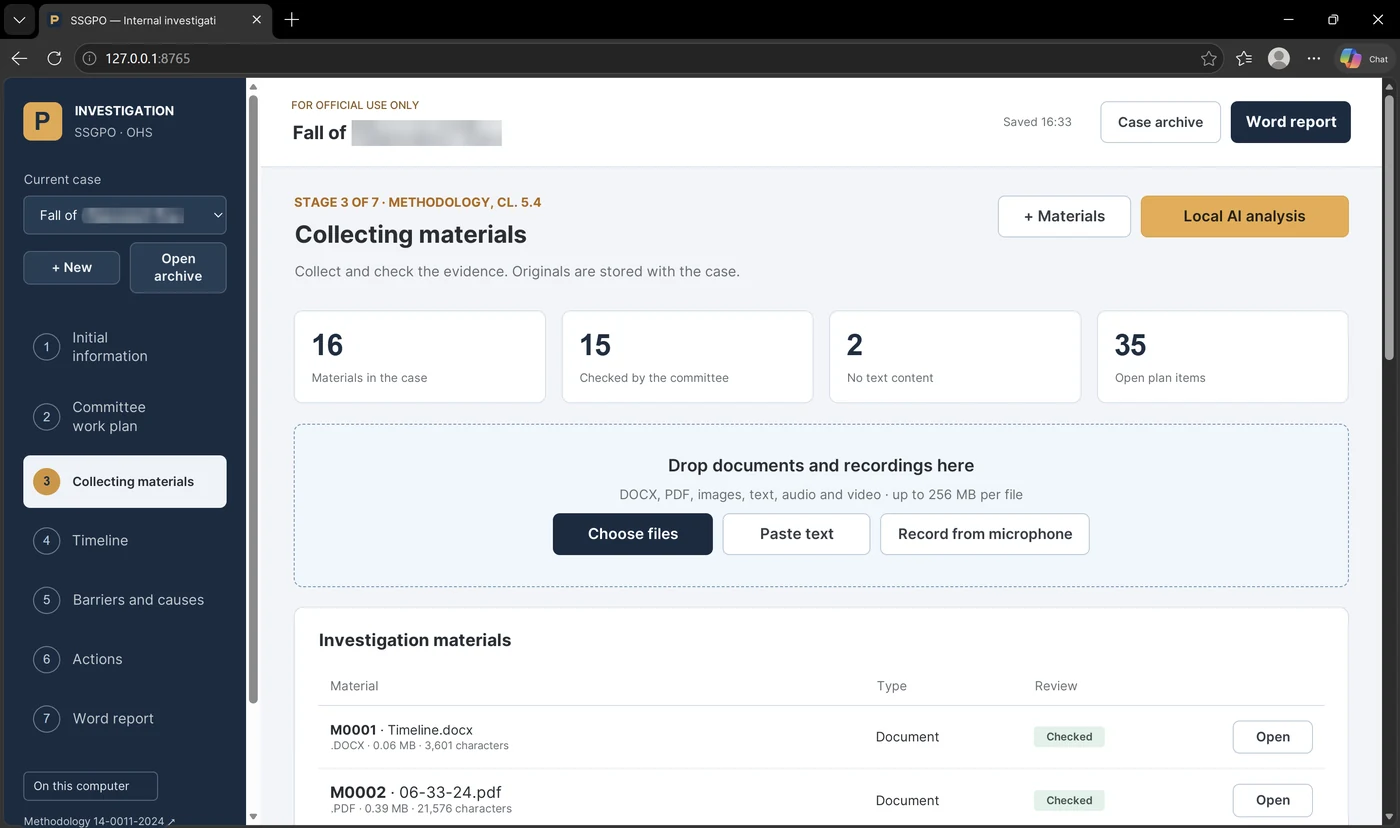
資料セクションには、DOCXとテキスト形式のPDFを読み込めます。スキャンや写真はローカルで文字認識でき、見取り図や画像は案件ファイルに保存され、写っている細部の説明をモデルが提案することもできます。音声と動画はローカルで文字起こしされます。マイクから直接聞き取りを録音し、その後で書き起こしを得ることも可能です。
資料の確認が済むと、アプリケーションが時系列表の作成を支援します。人工知能が事象と引用を提案しますが、その記録を採用するかどうかは委員会が判断します。重要要因は別途マークされます。
次のブロックは防護バリアと原因です。委員会は予防バリアと緩和バリアを確認し、出発点となる二つの枝を作ります。なぜ望ましくない事象が起きたのか、そしてなぜそのような結果に至ったのか。人工知能が提案した原因は、委員会が確認するまで仮説のままです。
原因の次は対策です。その対策がどの原因に対応するのか、誰が責任者か、期限はいつか、どのような検証可能な結果が得られるか、暫定的なバリアが必要か、対策を一つの現場を超えて展開すべきかを整理します。
そして最後に、ようやく報告書の草案が作られます。アプリケーションは手法マニュアルの構成に沿ってWordの第一稿をまとめ、時系列、原因ツリー、バリア、資料一覧、添付資料を盛り込むことができます。
参照:Prompt 2 — 時系列、Prompt 3 — 矛盾と不足データ、Prompt 4 — バリア、Prompt 5 — 原因ツリー、Prompt 6 — 対策、Prompt 7 — 最終報告書の草案。
ローカル人工知能がすること――そして、してはならないこと
ここで大切なのは、自動化を過大評価しないことです。人工知能は確認済みのテキストを断片ごとに読み、時系列、質問、バリア、原因の仮説、対策案を提案します。二つの事情説明書の間の矛盾を見つけたり、時系列に重要な時間帯が抜けていることに気づいたりもできます。
しかし、文書からの引用が裏づけるのは、その言葉が資料に実際に書かれているということだけです。証言が真実であることを証明するものではありません。文字認識したテキストには誤りが含まれている可能性があります。見取り図が誤って解釈されることもあります。因果関係が単なる仮説にすぎないと判明することもあります。
そのため、アプリケーションには「人工知能が提案し、委員会が採用・却下・修正する」という原則が組み込まれています。原因が自動的に確定することはありません。責任者や期限をモデルが割り当てることもありません。Wordの草案は、あくまで最初の作業用ドラフトであって、「そのまま署名すればよい」文書ではありません。
これが特に重要なのは、社内報告書が、法令や所定の手続きで定められた書類に代わるものではないからです。調査の責任は、あくまで委員会にあります。
Prompt 9を参照 — 結果を使用する前に、品質、機密保持、自動化の限界をチェックするためのプロンプト。
機密保持は、別建ての指示ではなくアーキテクチャの一部になった
調査において、機密保持の問題を「後回し」にすることはできません。手法そのものが、社内調査の資料を社外秘文書に分類し、ファイルの作成や受け渡しの際に個人データを保護することを別途求めています。
テスト版のオフラインシステムでは、案件資料、文字起こし、分析結果、Word文書はパソコン内にとどまります。ローカルモデルはループバックアドレス経由で動作し、必要なモデルを準備した後は、外部のインターネットに接続せずに案件の作業を行うことができます。
とはいえ、ここにも魔法はありません。ローカルで作業することは、自動的に匿名化されることを意味しません。案件に氏名や医療情報を読み込めば、それらはそのパソコンと案件の添付資料に残ります。したがって、通常の情報セキュリティ対策が必要です。保護されたユーザーアカウント、アクセス権、保存ルール、バックアップ、そして必要に応じた追加のマスキングです。
つまり、私たちの進化は「すべてオフラインだから、すべて安全」というスローガンで終わったわけではありません。より正確に言えば、資料を不必要に外部へ送ることをやめ、データの管理を本来あるべき場所、すなわち企業の内部にとどめたのです。
現在使っているもの
現在、私たちには事実上二つのフローがあります。一つ目は実運用のフローです。ローカルで資料をマスキングし、匿名化したコピーを設定済みの調査エージェントに渡し、得られた結果をローカルでマスキング解除します。実際の業務ですでに使えるのは、まさにこの仕組みです。
二つ目はテスト環境です。完全なオフラインシステムで、音声を自らローカルで文字起こしし、資料を読み取り、時系列、バリア、原因の構築を支援し、報告書の第一稿を作成します。すでに稼働していますが、私たちは検証と改善を続けています。これは私たちにとって譲れない原則です。見栄えが良いというだけで、パイロット版を成熟した本番システムとして扱うことはできません。
実運用フロー:マスキングツール → 設定済みの人工知能調査エージェント → マスキング解除。
テスト環境:完全にローカルな委員会用ワークステーション → 検証とさらなる改良。
次のステップ――安全な企業内環境のFire
並行して、グループの情報システム部門は、企業内環境Collabで社内人工知能Fireの開発を進めています。私たちにとって、これは論理的な次の段階です。委員会支援ツールの手法ロジックを、安全なサーバー型の企業内環境へ移す。そこでは、大規模モデルの性能と機密保持の要件のどちらかを選ぶ必要がありません。
私たちはFireを「自動調査官」としてではなく、同じ原則を実現するもう一つの環境と捉えています。資料は保護されたインフラの内部にとどまり、人工知能は委員会が時系列、バリア、矛盾、原因を分析するのを支援し、判断は引き続き人間が下します。
移行の前に、まずFireの技術的な能力を確認する必要があります。文書や音声の処理、コンテキストの容量、アクセス権の管理、ログ、データの保存、結果のエクスポートです。つまりここでも、何としても最新のモデルを使いたいという願望からではなく、手法と情報保護から出発しているのです。
動画で見る:ローカル調査の全サイクル
この記事では、同じようなスクリーンショットを何十枚も並べて本文を重くすることは、あえて避けています。3分間の画面録画のほうが、各要素がどうつながっているか、人が実際に何をし、プログラムが何をするのかをよく示してくれます。
スクリーンショットが必要なのは、アーキテクチャについて立ち止まって説明すべき箇所です。資料の種類、時系列、原因、対策、そして最終的なWord文書です。それ以外の仕組みは動画で見るほうがわかりやすいでしょう。動画は記事の最後にあります。
どこで時間が節約できるのか
事故調査には、やはり人が必要です。現場を確認し、関係者から聞き取りを行い、文書を入手し、事実を議論し、判断を下す。委員会の存在意義そのものを自動化することはできません。
しかし、書類作業の決まりきった部分の多くは取り除けます。音声の書き起こし、事情説明書の突き合わせ、時刻の食い違いの手作業での洗い出し、引用の時系列への転記、バリアの一次整理、原因ツリーの作成、対策リストの下書き、報告書第一稿の取りまとめなどです。
そして私にとって最大の効果は、専門家の人数を減らすことではありません。むしろ逆です。専門家が文書の機械的な処理に費やす時間が減れば、そもそも調査を行う目的そのもの――人と話し、現場で作業し、バリアを確認し、管理者が事象の再発を防げるよう支援すること――に、より多くの時間を使えるようになります。
結局、何が得られたのか
数年間の歩みは、示唆に富むものになりました。オープンなクラウドエージェント → 手作業によるマスキング → ローカルのマスキングツールとマスキング解除 → ローカルでの文字起こし → テスト版のオフラインシステム → 次のステップとして安全な企業内Fireへ。
ただし、現時点での実用ツールは実験段階のオフライン版ではなく、マスキングを組み込んだ実証済みのフローです。元の資料は私たちの手元にとどまり、エージェントには匿名化された版が送られ、復元はローカルで行われます。オフラインシステムは現在テスト中で、段階的に完成度を高めているところです。
最も重要な変化は、技術的なものですらありません。私たちは人工知能に「誰が悪いのか?」と尋ねるのをやめ、別の問いを投げかけるようになりました。「どのデータが足りないのか、どのバリアが機能しなかったのか、なぜ機能しなかったのか、そして再発のリスクを本当に下げる対策は何か?」
まさにこの役割においてこそ、人工知能は調査に役立ちます。裁判官でも委員長でもなく、人が事実により深く向き合えるよう手助けする、素早い第二のアナリストとして。
もう一つ:人間の知性を忘れてはならない
モデルが強力になればなるほど、自分自身の思考をモデルに委ねないことが重要になります。人工知能が役立つのは、人間の知性を強化するときです。つながりをより速く見出し、仮説を検証し、下書きをまとめ、人と話したり現場で作業したりする時間を生み出してくれるときです。
だからこそ私にとって正しい道は、既製のボタンを押すだけのユーザーではなく、新しい解決策の作り手になることです。手法を理解し、アーキテクチャを決め、結果を検証し、誤りを正し、ツールとともに自分自身も成長していくことです。
人工知能は活用すべきです。しかし、自分自身の知性も、それに劣らず使い、磨き続けなければなりません。この組み合わせが、事象をより深く調査し、そこからよりよく学び、再発を防ぐのに役立つのであれば、テクノロジーは真に安全のために役立っているといえるでしょう。
記事のプロンプト集
マスキングを組み込んだ実運用フロー → テスト版オフラインシステム → 次のステップとして安全な企業内Fireへ
現在の状況:実際の業務では「ローカルのマスキングツール → 設定済みのクラウドエージェント → ローカルでのマスキング解除」というフローを使用しています。完全なオフラインシステムはすでに開発済みですが、試験と改善の段階にあります。Fireは次の安全な企業内ステップとして検討しています。
Prompt 1. 現在の実運用エージェント:匿名化された資料のみ
記事との関係:「第3のバージョン」と「現在使っているもの」のセクション。ローカルでのマスキング後に使う、現行の実運用フローです。
あなたは、労働安全衛生および産業保安の分野で発生した事故の社内調査を行う委員会の分析アシスタントです。

作業フロー:
元の文書は、まずローカルでマスキングされます。あなたが受け取るのは匿名化されたコピーのみです。あなたの作業後、結果は別途管理されているキーとパスワードを使ってローカルでマスキング解除されます。このキーとパスワードはあなたには渡されません。

重要:
- 事前に匿名化された資料のみを扱うこと。
- 氏名、部署、住所、その他の伏せられた値を復元しようとしないこと。
- 別途提供されない限り、インターネットや外部の事実を使用しないこと。
- 過失者を特定しないこと。
- 仮説を確定した事実として述べないこと。
- 委員会の判断に取って代わらないこと。

目的:委員会が資料を整理し、調査の網羅性を確認できるよう支援すること。

各結論について、次のように区別すること:
FACT — 資料によって直接裏づけられている。
ASSUMPTION — 根拠のある推定。
CONFLICT — 資料間の矛盾。
GAP — 不足している情報。
QUESTION — 解消すべき疑問。
HYPOTHESIS — 確認を要する、考えられる原因。

手順:
1. 受け取った資料の一覧を作成する。
2. 裏づけのある事実のみを、出典を明記して抽出する。
3. 暫定的な時系列を作成する。
4. 矛盾と欠落を示す。
5. 委員会向けの追加質問を作成する。
6. 時系列が確認された後に、バリア分析を提案する。
7. 原因は、委員会が判断するまで仮説としてのみ示す。
8. 対策は、確認された原因にのみ結びつける。

すべての表に出典を記載すること:資料番号、文書/ファイル、そして結論の根拠となる短い引用または正確な箇所。
Prompt 2. 事象の時系列と重要要因
記事との関係:実運用エージェントとテスト版オフラインシステムにおける時系列についてのセクション。
事故に関する確認済みの資料テキストを渡します。

時系列表の草案を作成してください。

ルール:
1. 資料にない事象を追加しないこと。
2. 時刻が正確な場合は、正確な時刻として記載すること。
3. 時刻がおおよその場合は「推定」と記すこと。
4. 二つの出典で時刻や順序が異なる場合は、黙って一方を選ばず、CONFLICTとして示すこと。
5. 各行に次を記載すること:日付/時刻、事象または状況、出典、ステータスFACT / ASSUMPTION / CONFLICT、それが重要である理由。
6. 重要要因の一覧を別途提案すること。重要要因とは、それがなければ望ましくない事象や結果の重大さがおそらく違っていたであろう事象/状況をいう。
7. 重要要因は、委員会が判断するまで確定したものとみなさないこと。

最後に次を出力すること:
A. 時系列の草案
B. 矛盾の一覧
C. 不足データの一覧
D. 委員会で議論するための重要要因の草案
Prompt 3. 矛盾、欠落、追加聞き取りの計画
記事との関係:計画、資料の収集、そして第二のアナリストとしての人工知能の役割に関するセクション。
資料と時系列の草案に基づき、委員会用の作業シートを作成してください。

必要な作業:
1. 事情説明書、文書、時刻、技術データの間の矛盾を見つける。
2. 証拠なしに、表現の違いを虚偽とみなさない。
3. 各矛盾について次を示す:出典A、出典B、具体的に何が異なるか、何を確認すべきか。
4. 追加の聞き取りのための質問を作成する。
5. 質問は、答えを誘導しない、開かれた中立的なものにする。
6. 欠落を埋められる可能性のある文書、測定、専門鑑定、写真、見取り図の一覧を別途作成する。
7. 状況、防護バリア、原因、結果の重大さを明らかにするうえで決定的に重要な質問がどれかを示す。

矛盾があるというだけで、証言が信頼できないと結論づけないでください。
Prompt 4. バリアの論理と「ボウタイ」
記事との関係:バリアの論理と、原因分析への移行に関するセクション。
委員会が確認した時系列と重要要因を使用してください。

バリア分析の草案を作成してください。

1. 危険源。
2. 望ましくない事象。
3. 結果。
4. 予防バリア:どのバリアが事象/接触を防ぐべきだったか、それは存在していたか、利用可能だったか、適用されていたか、機能したか、裏づけとなる出典。
5. 緩和バリア:どのバリアが結果を防ぐ、または重大さを軽減するべきだったか、それは存在していたか、機能したか、裏づけとなる出典。
6. 欠如していた、または有効でなかった各バリアについて、「なぜ?」という問いを立てる。

バリアの欠如を自動的に根本原因と呼ばないこと。
手法、文書、技術的な論理にないバリアを、HYPOTHESISの表示なしに作り出さないこと。

出力は委員会で議論するための表であり、確定した結論ではありません。
Prompt 5. 原因ツリーと根本原因
記事との関係:「調査手法が厳格になった」のセクションと、原因に関するブロック。
入力:
- 確認済みの時系列
- 重要要因
- バリア分析
- 確認された事実に関する委員会の判断

原因ツリーの草案を作成してください。

出発点:「望ましくない事象+結果」。
最初の二つの枝:
A. なぜ望ましくない事象が起きたのか?
B. なぜそのような結果に至ったのか/なぜその重大さに至ったのか?

その後:
1. 各ノードについて、システム的な原因にたどり着くまで必要なだけ「なぜ?」を繰り返す。
2. 各原因を、その親となる問いに結びつける。
3. すべての重要要因は、ツリーに反映されるか、除外した理由を別途説明しなければならない。
4. 人の行動/ミスを根本原因とみなさない。分析を続け、なぜその行動が可能だったのか、または許容されると考えられていたのかを問う。
5. 根本原因として提案するのは、次の条件を満たす場合に限る:プロセス/システムの具体的な欠陥を記述している、除去が可能である、企業/グループが管理できる範囲にある、具体的な対策を提案できる。
6. 具体的な説明を伴わない一般的な表現は禁止:「安全文化の低さ」「個人の不注意」「組織のまずさ」「教育訓練の不備」。

各ノードについて:
- 記述
- 種類:直接原因/中間原因/根本原因の候補
- 裏づけとなる出典
- 関連する重要要因
- ステータスFACT / HYPOTHESIS / CONFIRMED_BY_COMMISSION

委員会に代わって根本原因を確定しないでください。
Prompt 6. 是正措置および予防措置
記事との関係:対策と、第一稿の作成にかかる時間の節約に関するセクション。
委員会が対策策定の対象として一覧に含めると決定した原因のみを使用してください。

各原因について、対策案を2〜4つ提案してください。

各案について次を示すこと:
- どの具体的な原因を取り除くのか、またはどのバリアを強化するのか
- 種類:技術的/組織的/教育訓練/管理監督/その他
- 期待される検証可能な結果
- 有効性をどう検証するか
- 適用範囲:事象の発生場所/類似の施設/企業/グループ
- 恒久的な対策が実施されるまで、暫定的な防護措置が必要か
- 起こりうる副次的なリスク
- 期限と責任者を決めるためにどのようなデータが必要か

委員会の判断なしに、責任者の氏名や具体的な期限を記入しないこと。
確認された原因を取り除かないのであれば、「臨時の安全教育を実施する」といった対策を万能の解決策として提案しないこと。
管理監督を強化するだけで根本原因を取り除かない対策は、別途明示すること。
Prompt 7. 手法に沿った最終報告書の草案
記事との関係:Word文書の作成と、「署名用の文書ではなく第一稿」という原則に関するセクション。
委員会が承認した要素のみに基づいて、社内報告書の本文の草案を作成してください。

使用するもの:
- 事故の概要カード
- 確認済みの時系列
- 重要要因の一覧
- 承認済みのバリア分析
- 最終版の原因ツリー
- 承認済みの原因リスト
- 合意された対策
- 資料一覧

確認されていない仮説、表示のない異論のある見解、出典のない結論を、事実として最終版に含めないこと。

構成:
1. 概要と状況。
2. 資料と情報収集の方法。
3. 時系列。
4. 重要要因。
5. 防護バリア。
6. 原因分析。
7. 根本原因。
8. 是正措置および予防措置。
9. 添付資料/資料一覧。

可能な限り、重要な結論の横に、根拠となる資料への参照を残すこと。
文書の冒頭に「草案。委員会による確認と承認が必要」と明記すること。
過失の有無に関する結論を記述しないこと。
Prompt 8. テスト版オフラインシステムのためのマスタープロンプト
記事との関係:「オフラインシステムはすでに完成――現在はテスト中」のセクション。
私はプログラマーではありません。社内の調査手法に沿って事故の社内調査を行うための、テスト用のローカルアプリケーションを作るのを手伝ってください。この段階の目的はパイロット運用と品質の検証であり、本番運用へ自動的に移行することではありません。

段階的に進めてください。各ステップで次のようにしてください:
1. 何を、なぜ行うのかを説明する。
2. 一つの操作、または完成したファイル/パッチを一つだけ提示する。
3. 私の結果またはスクリーンショットを待つ。
4. それを確認する。
5. その後で初めて次に進む。

目標とするアーキテクチャ
- Windows 10/11
- 127.0.0.1上のローカルbackendとブラウザベースのインターフェース
- モデルを一度準備した後は、外部インターネットなしで案件資料を扱えること
- 高性能な業務用パソコンでの動作を想定する。低スペックの機種向けには軽量モデルを提案するが、品質/速度の低下を隠さないこと
- 案件のローカル保存
- チェックサム付きの案件アーカイブ
- バージョン履歴
- 外部APIへの資料送信を一切必須としないこと

資料
- DOCX:段落、表、ヘッダーとフッター
- テキストを含むPDF
- PDFスキャン/画像:ローカルでの文字認識
- 見取り図/写真:原本を保存し、説明はあくまで下書きとしてのみ提案する
- 音声/動画:ローカルでの文字起こし
- マイクからの録音
- 手入力と編集
- テキストを人工知能による分析に使う前に、「原本と照合済み」のマークを必須とする

ローカルモデル
- ローカル実行エンジン経由のLLM(例:Ollama)
- 多言語音声モデルWhisper
- 必要に応じてローカルのvision-モデル
- アプリケーションが調査中にモデルをひそかにダウンロードしないこと

手法/段階
1. 初期情報。
2. 委員会の計画。
3. 資料の収集。
4. 時系列と重要要因。
5. バリアと原因。
6. 対策。
7. 報告書。

人工知能のルール
- 人工知能は提案するだけ。
- 各結論は出典と引用を保持する。
- FACT / ASSUMPTION / CONFLICT / GAP / HYPOTHESISを区別する。
- 原因は、委員会が確認するまで仮説として扱う。
- 責任者と期限をモデルが自ら割り当てることはしない。
- 委員会が、すべての提案を採用・却下・修正できるようにする。
- 最終的なWordは編集可能な草案とする。
- 報告書には原因ツリー、バリア、資料一覧、添付資料を含める。

セキュリティ
- CDNや外部へのテレメトリーを使わない
- 調査に関するネットワーク通信はloopbackのみ
- ローカルでの作業が自動的な匿名化を意味しないことを、ユーザーに明示する
- 秘密情報をクライアント側のコードに平文で保存しない
- 案件の削除、バックアップ、移行の機能を用意する

まず、ディレクトリ構成、案件データの形式、脅威モデルから始めてください。私が承認するまでコードは書かないでください。

パイロットとしての位置づけ
- バージョンに「テスト版/パイロット」と明示する
- 検証用の訓練ケースのセットを追加する
- 各ケースについて、人工知能の結果を人間/委員会の結論と比較する
- 見つかった不具合と改良の記録をつける
- 試験が完了するまで、システムを本番運用可能と呼ばない
Prompt 9. パイロット版オフラインシステムの監査
記事との関係:自動化の限界、機密保持、現在のテスト段階という位置づけに関するセクション。
委員会に引き渡す前に、完成したアプリケーションと調査の草案を監査してください。

技術面の確認
1. 案件の作業中に外部へのネットワーク通信があるか。
2. CDN、外部フォント、クラウドのspeech-to-text、外部APIが使われているか。
3. 元のファイル、文字起こし、ローカルモデル、バックアップがどこに保存されているか。
4. 案件を削除すると何が起こるか。
5. 元の文書が診断ログに記録されていないか。
6. エラー発生時に案件の内容が外部に出力されないか。

手法面の確認
7. 重要な結論のすべてに出典があるか。
8. 事実と仮説が区別されているか。
9. すべての重要要因が原因分析に反映されているか。
10. システム的な条件を分析せずに、人の行動を根本原因としていないか。
11. 対策が具体的な原因/バリアに結びついているか。
12. 委員会の判断なしに、モデルが責任者や期限を割り当てていないか。
13. 報告書の草案が承認済みの文書として示されていないか。

機密保持の確認
14. ローカルの案件にどのような個人データ/医療データが含まれているか。
15. デモ、公開、受け渡しのために追加のマスキングが必要か。
16. ファイル名やスクリーンショットに不要な氏名が含まれていないか。

結果は表で出力してください:
確認項目 | ステータス | 見つかったリスク | 修正すべき点 | 確認すべき担当者

調査の実質的な結論を自動的に修正しないでください。

成熟度の確認
17. 検証用ケースのセットと比較結果があるか。
18. どの機能がすでに安定しており、どの機能が実験段階にとどまっているか。
19. 本番利用の前に、どのエラー/制約を解消しなければならないか。
20. 人工知能の出力が委員会の判断であるかのような誤った印象を、インターフェースが与えていないか。
プロンプトの使い方
- Prompt 1 — 現在の実運用フロー:事前に匿名化した資料のみを使用し、マスキング解除キーはエージェントに渡さない。
- Prompt 2–7 — 手法に沿った作業ブロック。現在のエージェントでも、将来のローカル/サーバー型の環境でも使用できる。
- Prompt 8 — テスト版の完全オフラインシステムの構築と、その後の改良。
- Prompt 9 — 適用範囲を広げる前のパイロット版の監査。
シリーズの基本原則は変わりません。まずデータを守り、手法を定め、それから自動化する。人工知能は委員会の作業を強化しますが、専門家としての思考、事実の確認、そして人間の責任を不要にするものではありません。