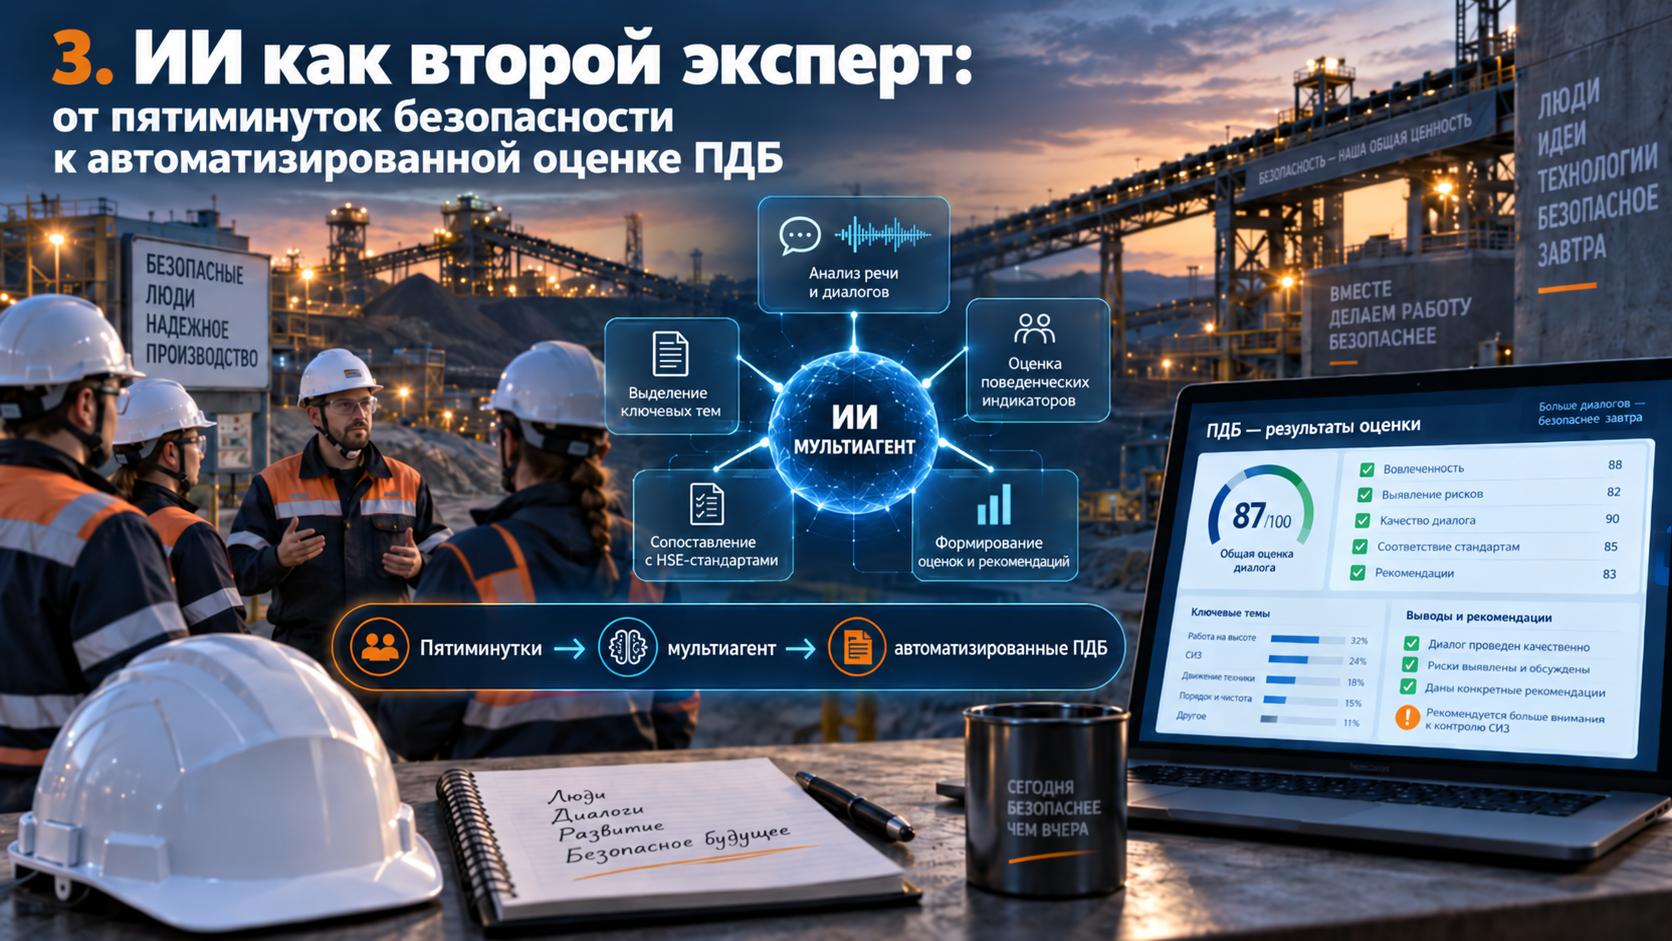
第2の専門家としてのAI:安全講話からBSDの自動評価まで
安全講話 → デジタル評価 → Make → 自動化された行動安全対話
主なアイデア:AIは管理者や安全専門家を置き換えるものではない。同じ基準を適用し、パーソナライズされたフィードバックを提供し、数百、数千の実際の対話へと品質管理を拡張できる単一の「第2の専門家」になる。
なぜそもそも実施の事実ではなく、対話そのものを評価し始めたのか
労働安全衛生において、事実は簡単に数えることができる:安全講話が実施されたか、行動安全対話が記録されたか、カードが記入されたかなどである。しかし、管理者が対話そのものをどれほど高品質に行い、目的を達成したかという質問に答えるのははるかに難しい。
私たちの手法における安全講話は、5〜10分間続くシフト交代時のミーティングの必須要素である。管理者は1つの具体的な最新のテーマを取り上げ、明確な関連性を構築しなければならない:危険源 → 起こりうる結果 → 安全対策。ここでは、職長のモノローグだけでなく、作業者との対話、つまり質問、回答、議論への参加も重要である。
したがって、当初の課題は「記録の有無を確認する」ことではなく、「このような対話の実際の品質を均一に評価し、管理者に具体的なフィードバックを提供するようにAIを訓練できるか?」というものだった。
ステップ1:まず手法、次にAI
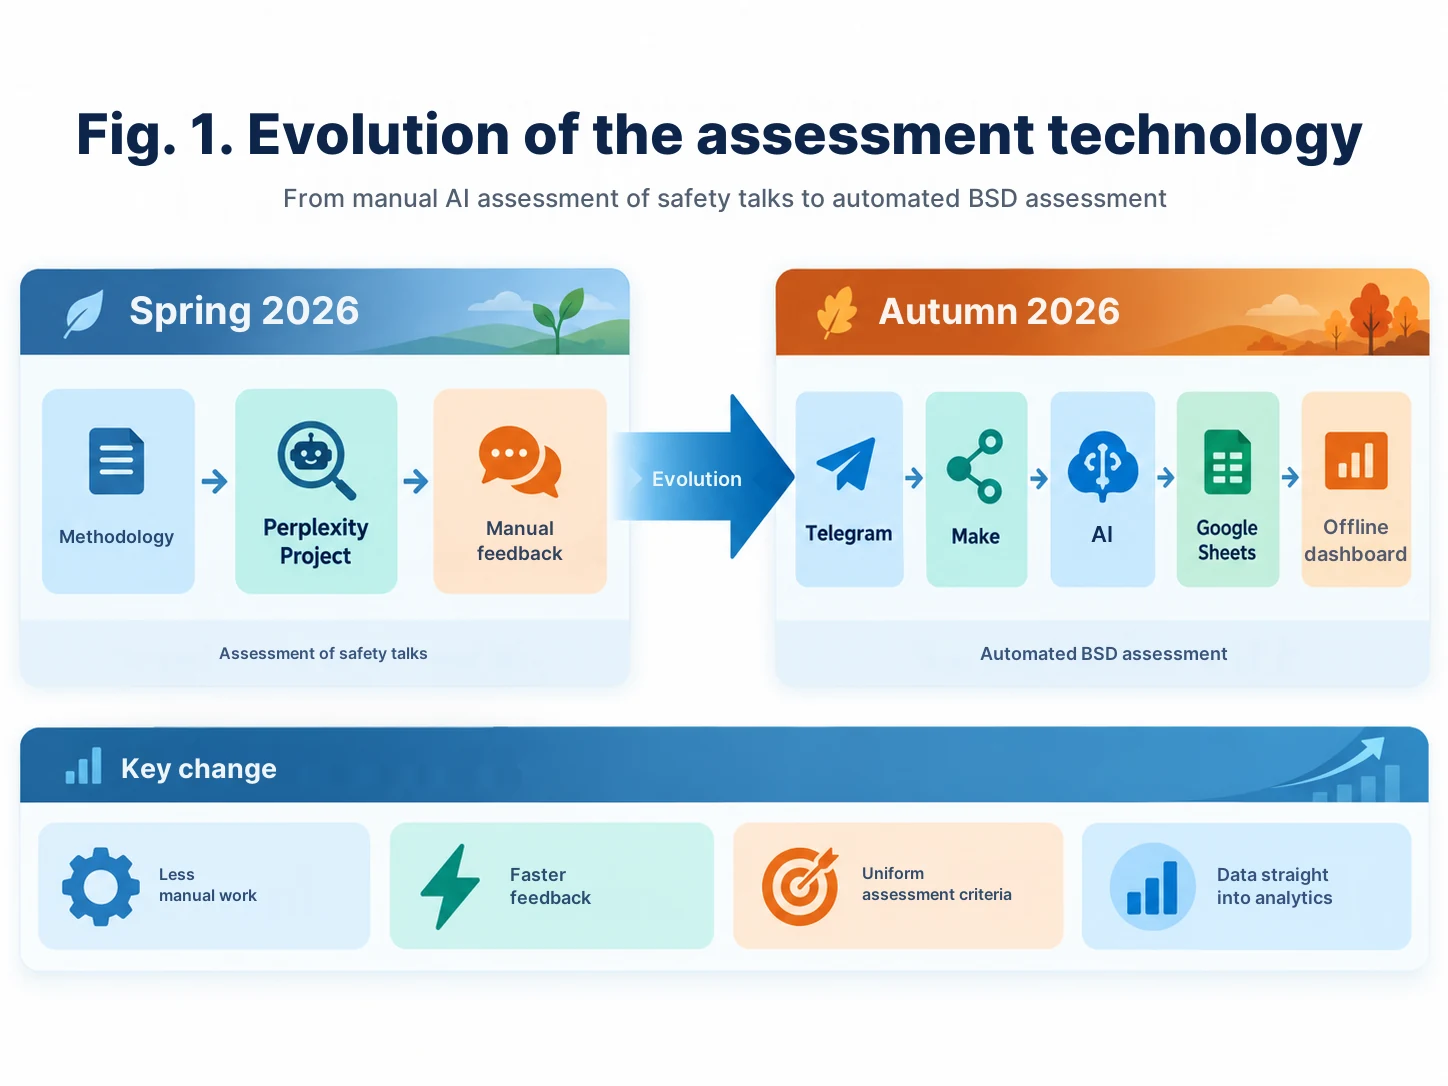
2026年の春、私たちは安全講話から始めた。AI評価を導入する前に、安全講話を適切に実施する方法に関する方法論的ガイドラインとトレーニングビデオが準備された。その後初めてデジタル評価者が登場した。
最初の作業環境として、私たちはPerplexity Spaceを使用した。現在、Perplexityの同様の環境はProjectと呼ばれている。Projectに方法論的ガイドと評価チェックリストをアップロードし、モデルのために個別に厳格なPromptを用意した。
Promptの目的は、「スピーチを評価して」という通常の要求とは根本的に異なっていた。AIは、音声で実際に話された内容のみを評価することが許可された。要素が欠落している場合は0点。形式的に言及されている場合は部分的な達成。論理的かつ完全に説明されている場合は達成である。
現在のチェックリストには7つの基準がある:自己紹介と目的、具体的な危険源、「危険源 – 結果 – 安全対策」の論理、感情的なインパルス、安全対策、作業者との対話、最終的な要約と実行中の作業との関連性。
Prompt 1 — Perplexity Project用のアップグレードされたPromptのバージョンについては、付録を参照。
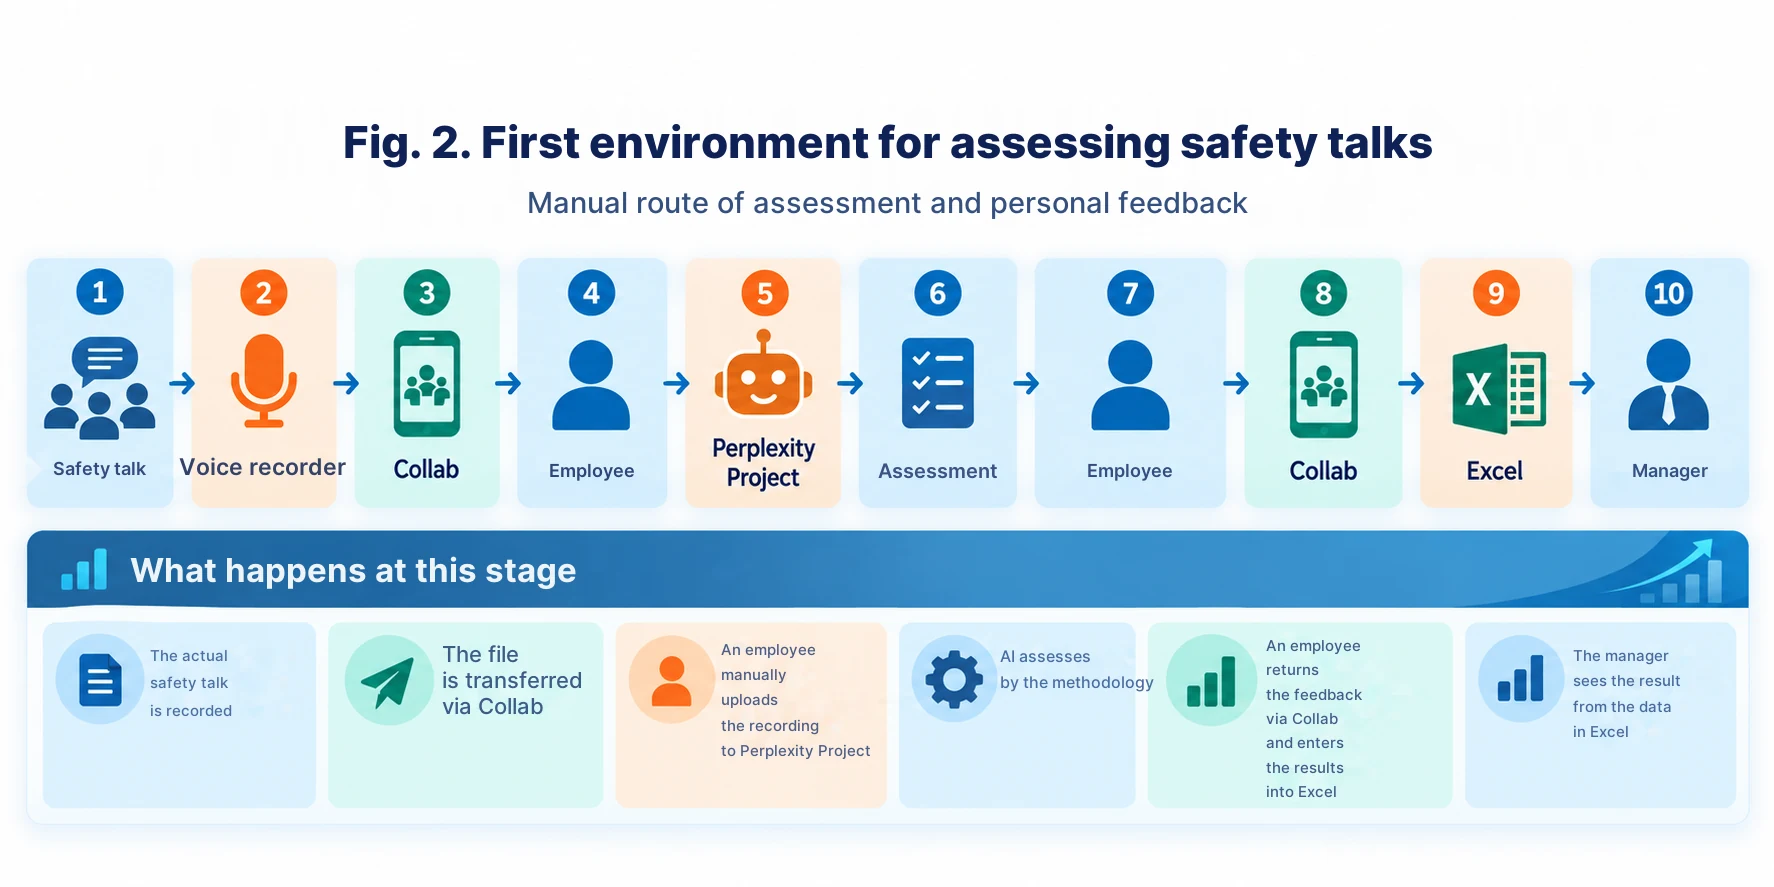
最初の、まだ手動だった環境はどのようなものだったか
シフトスーパーバイザーは実施した安全講話をボイスレコーダーに録音した。社内アプリのCollabを通じて、録音は担当の従業員に送信された。従業員は音声をPerplexity Projectにアップロードし、評価を受け取り、同じくCollabを通じてパーソナライズされたフィードバックを管理者に返した。
同時に、結果はExcelに記録された:部門、管理者、評価、試行回数。表に基づいて、部門の平均結果、推移、繰り返されたサイクルの数といった簡単な分析を作成した。
実践サイクルの合格レベルは80%に設定した。結果がそれより低い場合、管理者はAIの指摘を考慮に入れて次の安全講話を実施した。これは単なる管理だけでなく、職場での直接的な個別トレーニングとなった。
人間だけでなく、まずAIそのものをテストした
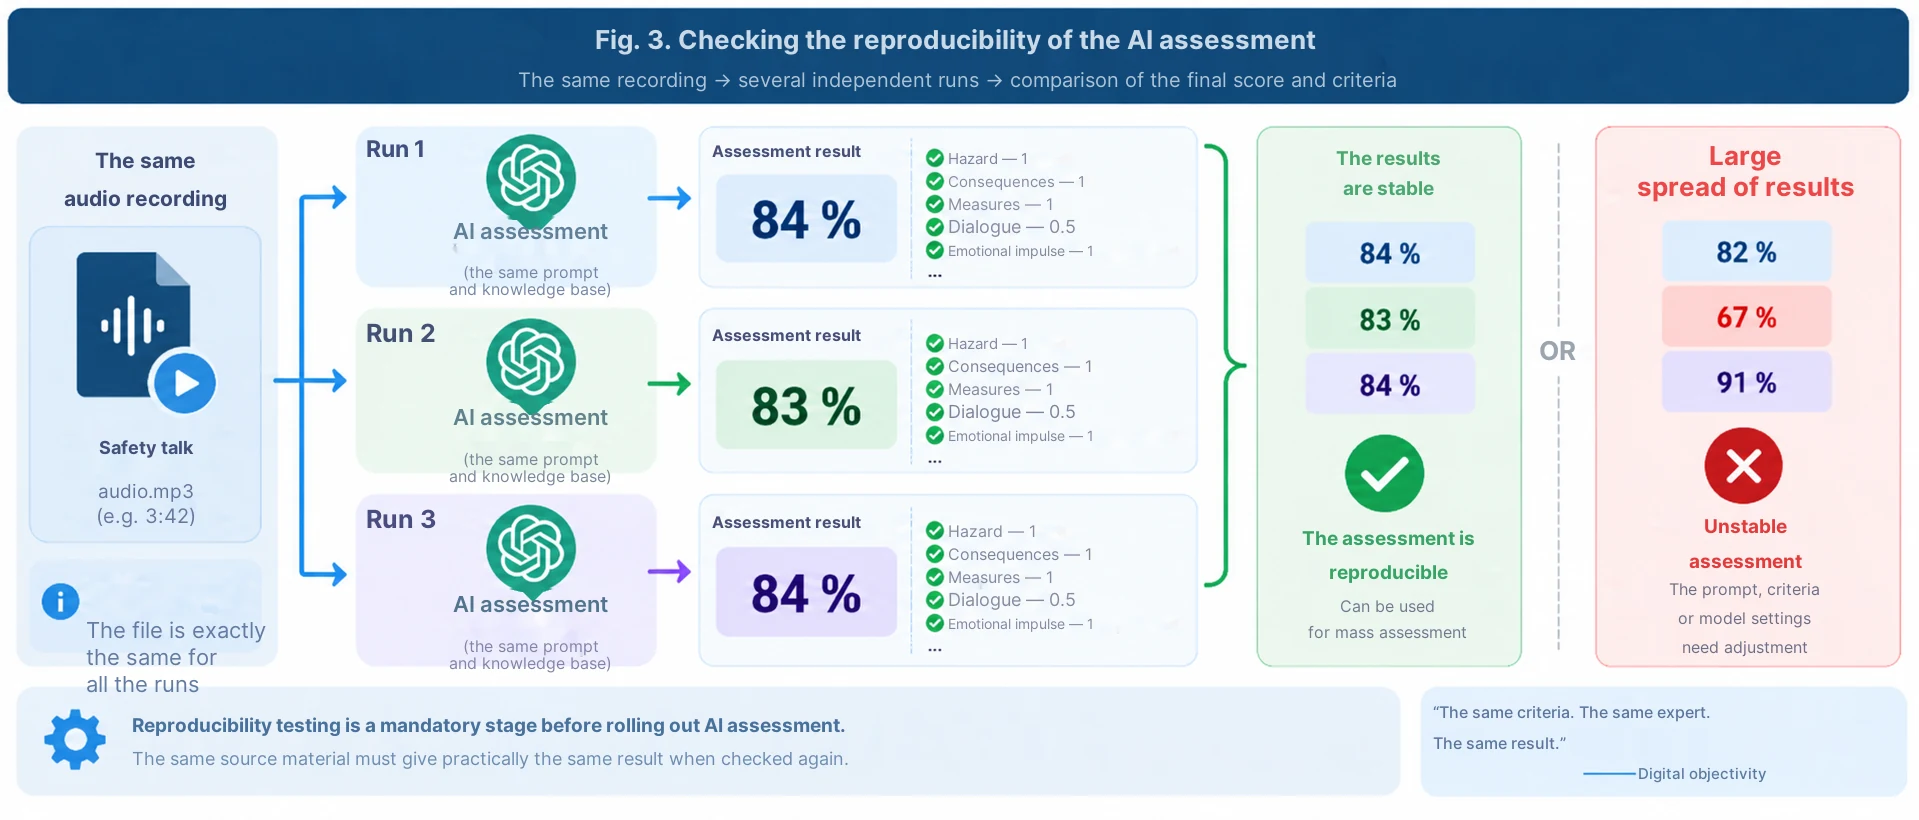
私にとって、これはシステム全体の最も重要な要素の1つである。私たちは全く同じ音声録音を意図的に複数回評価に送った。同じ素材が今日82%、1分後に65%、その後91%になるようでは、そのようなデジタル専門家はまだ人を評価する準備ができていない。
そのため、私たちは再現性を追求した:同じ録音は、同じかほぼ同じ評価を生成しなければならない。ばらつきが目立つようになった場合は、Promptを修正し、基準を明確にし、曖昧な表現を削除した。
私は個人的にこれを「デジタル客観性」と呼んでいる。これは、AIが絶対的な真実を持っているという意味ではない。そうではなく、単一の専門家が全員に同じ尺度を適用し、気分や個人的な好感、あるいは今日誰が検査を実施しているかに左右されないということだ。
Prompt 2 — 評価の再現性テストのプロトコルについては、付録を参照。
なぜ手動の仕組みが適さなくなったのか
パイロット版では、手動のルートが便利だった:ファイルを受け取り、アップロードし、結果を待ち、フィードバックを返し、Excelにスコアを記録する。しかし、このアプローチには自然な限界がある。
ボリュームが数百、数千の記録で測定されるようになると、私たちは評価を自動化するのではなく、評価の周りに新たな管理業務を作り出し始める。したがって、行動安全対話に移行する際、課題は異なる形で策定された:人間の参加が価値を生まない技術的チェーンから人間を排除することだ。
ステップ2:行動安全対話は通常の安全講話よりも複雑である
行動安全対話は、単なる短いスピーチではない。この手法には、実際の作業の観察と人との対話が含まれる。管理者が安全または危険な行動を確認し、質問を通じて、作業者自身に危険源、起こりうる結果、および安全な作業方法を挙げさせることが重要である。
作業者が危険な働き方をしている場合、対話の重要な部分は、危険源と結果について話し合い、次に安全な作業方法と他の危険源について話し合うことである。作業者が安全に働いている場合、管理者は正しい行動に気づき、それを強化し、その後、他の安全問題について話し合うために対話を利用しなければならない。
だからこそ、BSDの評価環境は、管理者の言葉だけでなく、真の対話の存在も確認しなければならない:質問はされたか、作業者は答えたか、行動の理由、結果、安全対策、そして対話の締めくくりについて話し合われたか。
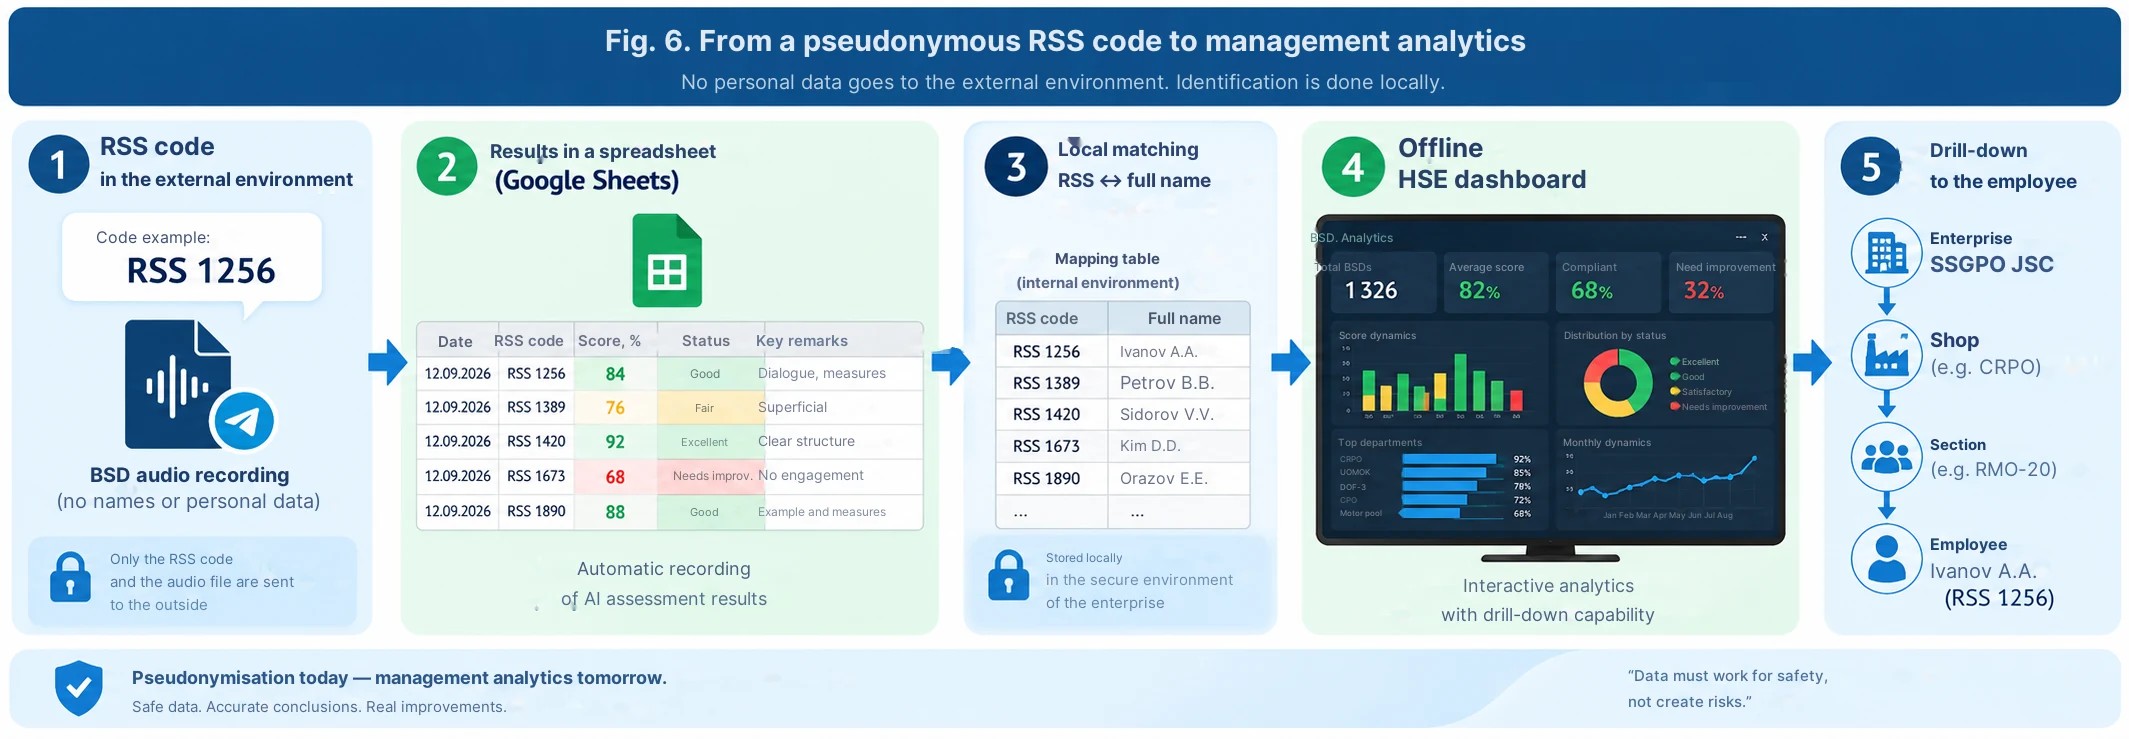
姓の代わりに仮名識別子を使用する
大規模な自動化において、私たちは識別問題を別途解決した。社内環境であるERGIS内では、各参加者にRSS 1256のような特別なコードが割り当てられる。これは社員番号でも姓でもない。
録音を開始する前に、管理者は自身のRSSコードを発音し、その後BSDを実施する。対話の中で姓や社員番号を呼ぶ必要はない。「RSSコード ↔ 特定の従業員」の対応関係は社内環境内にとどまり、後でローカルな分析時に使用される。
ここで、完全な匿名化ではなく、仮名化について話す方がより正確である:音声ファイルには依然として人間の声が残っているからだ。しかし、自動化された環境を通過する個人データの量は大幅に減少する。
小さな秘密:私はプログラマーではない
新しいソリューションのアーキテクチャはMakeを通じて構築した。私はプログラマーではないので、作業の最初にChatGPTにそのことを直接書いた。
リクエストはシンプルだった:「この自動化の作成を段階的に案内してください。一度に1つのアクションを出してください。私がそれをMakeで実行し、スクリーンショットを送ります。確認後、次のコマンドを指示してください」。
その後、まさにその通りに進んだ。ChatGPTは、どのモジュールを作成し、そこに何を入力するかを説明し、私はアクションを実行してスクリーンショットを送信し、確認後に次のステップを受け取った。同様に、Telegramボットが作成され、全体のチェーンが接続された。
これは、バイブコーディングの実践からの私にとって重要な結論である:専門家はAPIやMakeの構文を事前に知っている必要はない。しかし、生産プロセスやユーザーが得るべき結果をよく理解し、各段階を順番にチェックできる能力が必須である。
Prompt 3 — 「Makeを通じて段階的に案内してください」という初期Promptについては、付録を参照。
現在起きていること:Telegram → Make → AI → 結果
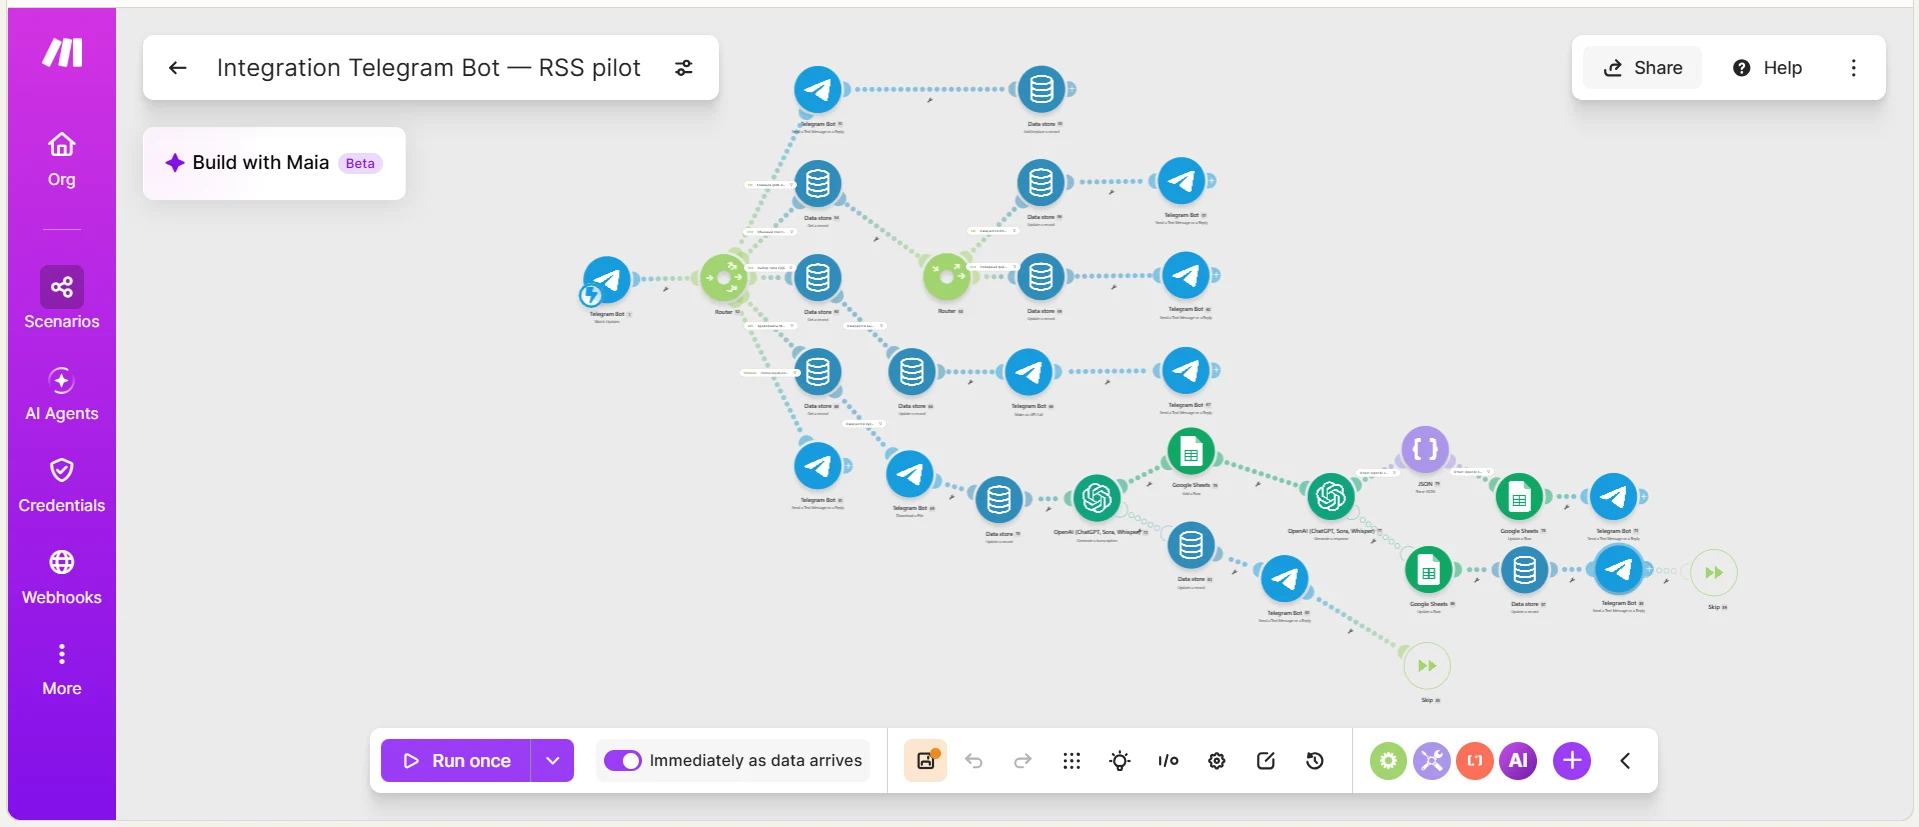
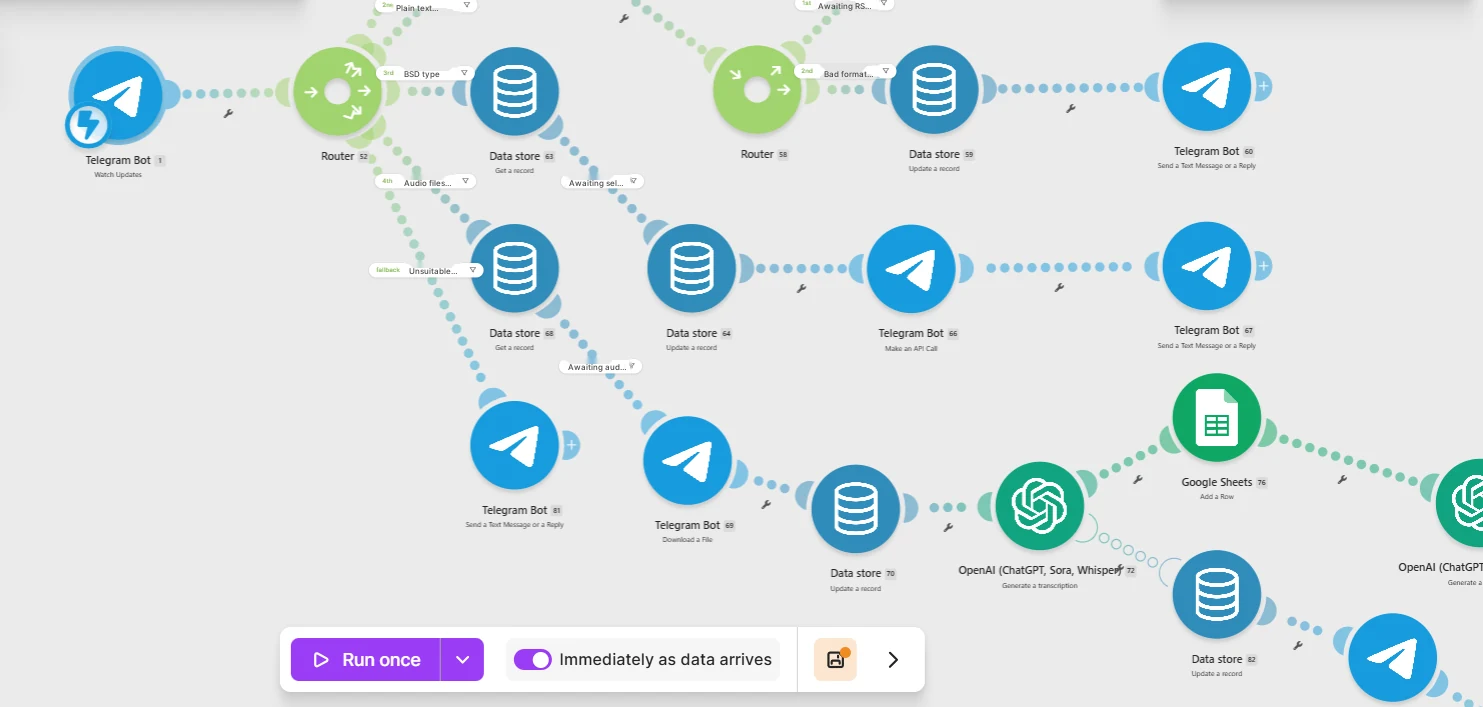
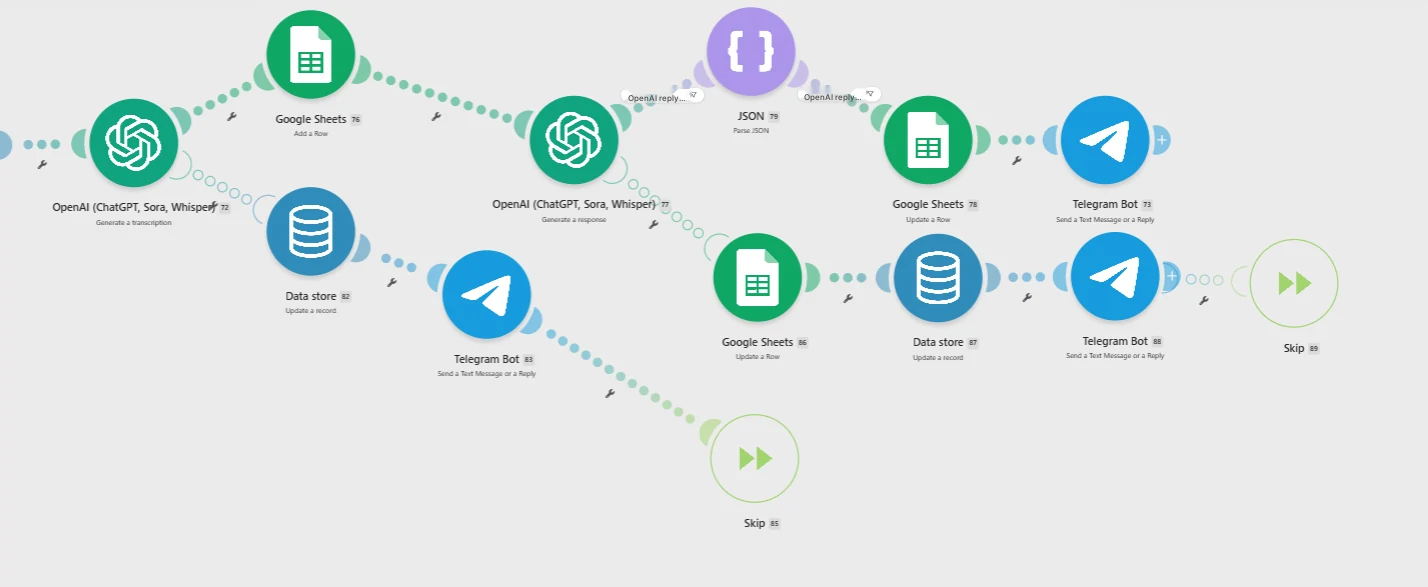
現在の環境は、手動オペレーターなしでほぼ機能している。管理者は音声録音をTelegramボットに送信する。Makeがファイルを受け取り、入力データを確認し、処理ルートを起動する。AIは指定された方法論に基づいて録音を分析し、評価とフィードバックを生成する。結果はユーザーに返されると同時に、全体的な分析のためにGoogle Sheetsに記録される。
現在のパイロット版では、フィードバックは数十秒で返される。ユーザーにとってそれはシンプルに見える:音声を送信すると、評価、強み、具体的な間違い、そして次回変更すべき点が受け取れる。
Makeの図を見ると、このシンプルさの裏には本格的なルーティングが隠されていることがわかる:Telegram、Data store、Router、OpenAI、Google Sheets、チェック、そしてユーザーへの返信メッセージである。
これはマルチエージェントか否か?
私はここで単なる演出のために「マルチエージェント」という言葉を使いたくありません。実際には、私たちのシステムは多段階のエキスパートループであり、シナリオの各部分が異なる機能を果たしています。ファイルの受信とルーティング、識別子の抽出、内容の分析、エキスパート評価、構造化された結果の作成、テーブルへの記録、そして個人的なフィードバックです。
もし複数の個別のモデル呼び出しが異なるシステムロールで機能する場合(例えば、一方が対話を分析し、もう一方が手法への適合性を管理して結果をフォーマットするなど)、それはすでにマルチエージェントまたは多エージェントロジックと見なすことができます。1つのモデル呼び出しがすべての機能を果たす場合は、多機能なAI評価者と呼ぶのが誠実です。
したがって、付録では各機能を個別のエージェントと呼ぶのではなく、機能ごとにプロンプトを分けています。
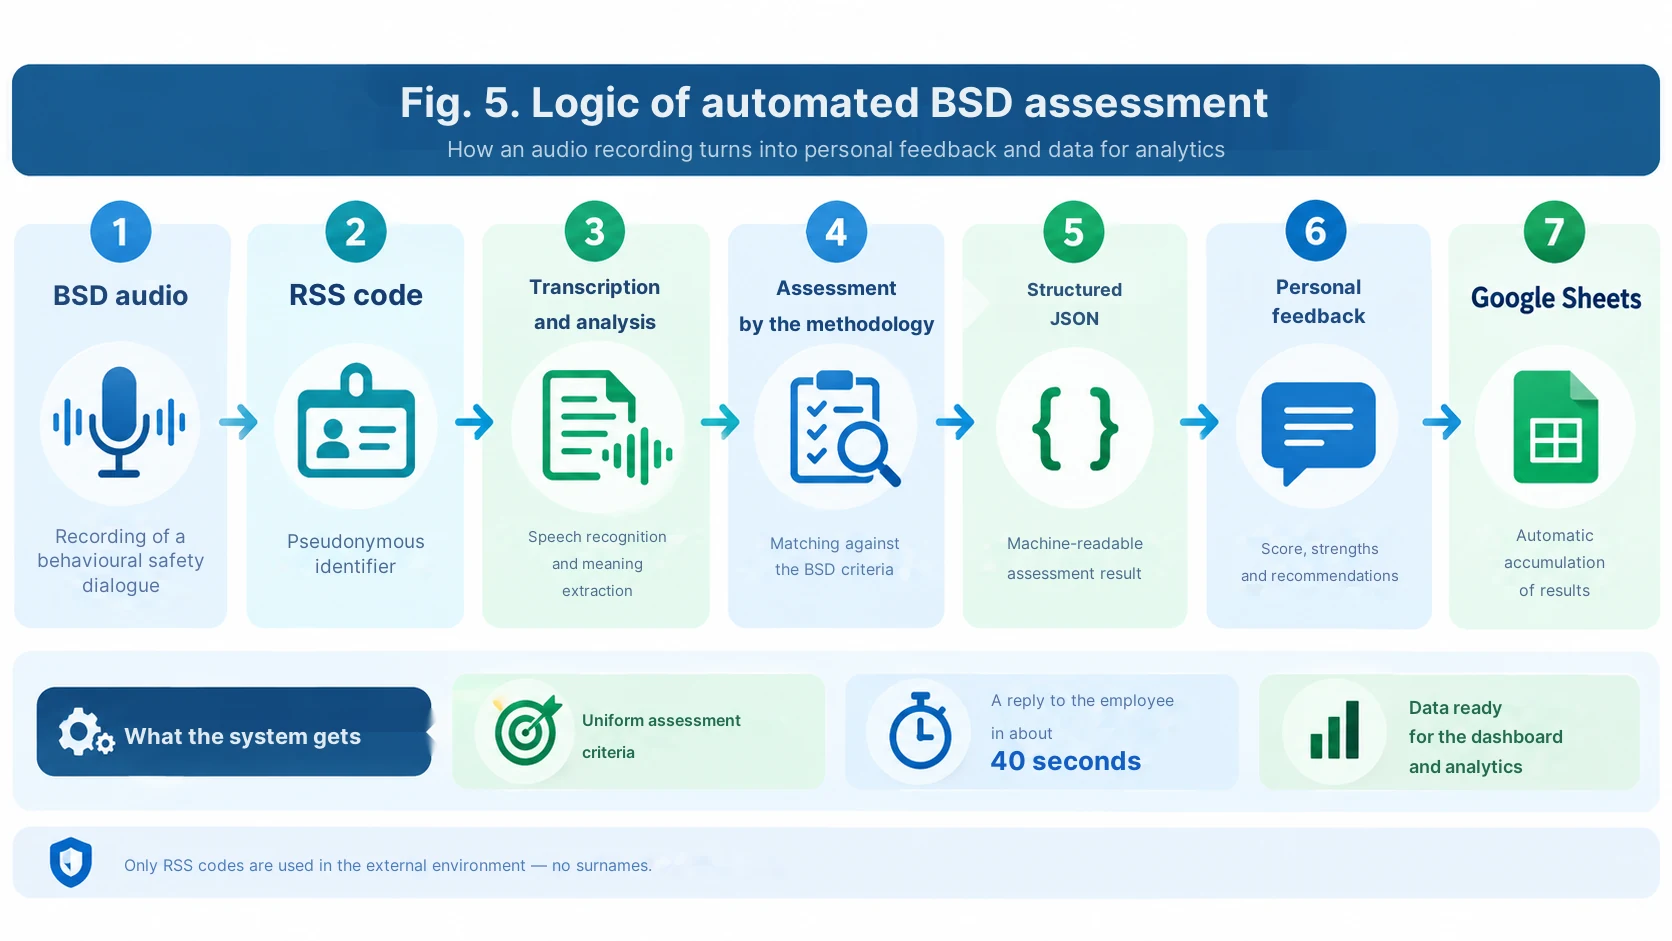
自動化されたBSD評価の仕組み
産業シナリオにおいては、2つのタスクを分けることが重要です。1つ目はエキスパートタスクであり、会話の内容を手法に厳密に照らし合わせて評価することです。2つ目は技術的なタスクであり、Makeが理解し、Google Sheetsに記録できる形式で結果を返すことです。
そのため、自動化には構造化されたJSONレスポンスが便利です。RSSコード、最終スコア、ステータス、強み、改善の余地がある領域、短いフィードバック、および個別の評価基準が含まれます。このようなフォーマットにより、モデルが生成する美しくても予測不可能なテキストのせいで自動化が「壊れる」リスクを軽減できます。
同時に、厳格なルールは春と同じままです。録音にないものはカウントしないこと、意図を推測しないこと、管理者の代わりに正しい答えを捏造しないことです。書き起こしが不完全な場合、記録は作り話の評価を受けるのではなく、再アップロードに回されるべきです。
Prompts 4–6 — BSDの評価、構造化されたJSON、およびフィードバックの作成については、付録を参照してください。
個人的な評価から部門別の状況へ
各評価の後、Google Sheetsには単なるテキストのフィードバックではなく、構造化された配列が蓄積されます。そのため、実施されたBSDの数、平均結果、主な繰り返されるエラー、推移、および仮名化されたRSSコードごとの結果を確認できます。
次のステップは、2番目の記事ですでにおなじみのものです。社内環境でローカルにRSSコードを氏名と照合し、結果をスタンドアロンのHSEダッシュボードにロードします。これにより、管理者は企業、工場、部門ごとの状況を把握し、必要に応じて特定の作業員までドリルダウンすることができます。
つまり、外部の評価ループは名字なしで機能し、完全な管理上の状況は企業内でのみ復元されるということです。
私たちのアーキテクチャなしでこのアイデアを再現する方法
このアプローチの意義は、特定のAIブランドに縛られるものではありません。最も単純なバリエーションとして、手法と評価用プロンプトを備えたPerplexity Projectを作成できます。永続的な指示とロードされたナレッジベースを持つChatGPTを使用することもできます。手法の資料源としてGoogle NotebookLM / Gemini Notebookを中心にスキームを構築し、評価は別のモデルで実行することもできます。大量の処理を行う場合は、Telegram、OpenAI、およびスプレッドシートと連携したMakeなどの自動化プラットフォームを使用する方が便利です。
重要な要素は同じままです。承認された手法 → 厳格なプロンプト → 再現性の確認 → 分かりやすい評価尺度 → 個人的なフィードバック → 結果の構造化された蓄積。
数ヶ月で何が変わったか
春には、1人の従業員が音声ファイルをAIに手動で転送し、結果を返していました。今日では、各ファイルに個別のオペレーターを配置することなく、約1300件のBSD記録を受信して評価できるループを構築しています。
しかし、最大の変更点はスピードでさえありません。私たちは、大量の実際の会話に同じ基準を適用し、各評価を短い個別の学習サイクルに変換する機能を手に入れました。
このスキームにおけるAIは、犯人探しをする検査官ではありません。それは第2のエキスパートであり、同時にデジタルコーチでもあります。手法との不一致を記録し、正確に何を改善すべきかを説明し、それを次の会話ですぐに確認できるようにします。
結論
私たちが始めたとき、そのタスクは実験のように聞こえました。AIはツールボックストークを評価できるのか、というものです。その結果、行動的対話、トレーニング、その他の安全に関するコミュニケーションへと拡張可能な技術が生まれました。
私にとって最も価値のある結果は、自動化された数字ではありません。価値があるのは、実際の会話の直後に管理者がフィードバックを受け取り、それと同時に企業が手法のどの要素が人々にとって本当に難しいのかに関するデータセットを取得することです。
まさにこの部分において、AIは安全管理システムの代わりとしてではなく、その内部で統一された第2のエキスパートとして機能し始めます。
記事「第2のエキスパートとしてのAI」のプロンプト
ツールボックストーク、再現性の確認、Make、および自動化されたBSD評価
これはプロンプトの公開バージョンです。これは実際の手法と私たちの作業アーキテクチャに基づいていますが、別の企業で適用する前に、基準と閾値を承認されたローカルな要件に置き換える必要があります。
Prompt 1. Perplexity Projectにおけるツールボックストークの最新化された評価
これは現在使用されているプロンプトの改良された公開バージョンです。内部の矛盾を修正しました。現在、チェックリストには実際に7つの基準が含まれており、合格閾値はすべて一律で80%となっています。
あなたは労働安全および産業保安の専門家として、シフトスーパーバイザーが実施するツールボックストークの品質の監査評価を行います。

情報源と優先順位
1. ツールボックストークの録音音声。
2. 承認された企業の実施ガイドライン。
3. 承認された評価チェックリスト。
表現に矛盾がある場合は、承認されたチェックリストとガイドラインに従ってください。独自の基準を追加しないでください。

ステップ 1. 完全な文字起こし
- まず、短い要約ではなく、音声の完全な文字起こしを取得してください。
- Perplexity Project の場合は、添付された音声ファイルをフルモードで読み取る利用可能なツール(READ / 利用可能な最大のコンテキストバジェット)を使用してください。
- 聞き取れない部分は [聞き取り不能] とマークしてください。
- 音声の首尾一貫した認識が80%未満の場合、または録音の重要な部分が欠落している場合は、「データが不十分です。ファイルを再アップロードしてください。」とだけ回答し、停止してください。
- 完全な文字起こしは最終レポートに出力しないでください。

ステップ 2. 専門家による評価
完全な文字起こしの中で実際に話されたことのみを評価してください。
禁止事項:
- 職長の意図を推測すること。
- 録音に含まれていないものをカウントすること。
- 評価対象者の代わりに表現を改善すること。
- 全体的な良い印象で欠落している要素を補うこと。

各基準の評価尺度
達成 = 1ポイント。
部分的に達成 = 0.5ポイント。
未達成 = 0ポイント。
ルール:
- 音声にない → 0;
- 形式的に言及されているが展開されていない → 0.5;
- 論理的かつ正確に展開されている → 1。

チェックリスト — 漏れなく全7項目を評価すること
1. 自己紹介とツールボックストークの目的。
2. 特定の危険要因 / 現在のトピックの名称。
3. 「危険要因 → 結果 → 安全対策」の論理。
4. 実際の/潜在的な結果や適切な例を通じた感情的な刺激。
5. 具体的な安全対策。
6. 作業員との対話:質問、回答、参加。
7. 最終的なまとめと現在/今後の作業との関連付け。

回答形式
1. 表:
番号 | 基準 | 実際に話された内容 | 評価 | ポイント

2. 合計:
獲得ポイント:7中X。
パーセンテージ:(X/7)*100、小数点第1位に丸める。

3. サイクルのステータス:
- 結果が >=80% の場合:「合格レベルに達しました」。
- 結果が <80% の場合:「合格レベルに達していません。フィードバックを確認した後にツールボックストークを再実施することを推奨します」。

4. 強み — 2〜5の具体的なポイント。録音からの内容のみ。
5. 改善領域 — 未達成/部分的に達成された基準について具体的に。
6. 職長へのフィードバック — 3〜5文:ビジネスライクで、要求水準が高く、成長を促すスタイル。

回答前の確認
最終回答の前に以下を再確認してください:
- 合計ポイントが表と一致していること。
- パーセンテージが正しく計算されていること。
- 7つの基準のいずれも省略されていないこと。
- 音声になかったことに基づく主張が1つもないこと。
コメント: 初期バージョンからの主要な原則が維持されています。つまり、最初に完全な文字起こしを行い、次に実際に話された内容のみに基づいて評価を行います。Perplexity ではファイル読み取りツールの具体的な名前が変わる可能性があるため、公開版では読者を search_files_v2 という名前に厳密に縛り付けるのではなく、機能を説明する方が適切です。
Prompt 2. 再現性(「デジタルな客観性」)の確認
この Prompt は、1つの録音に対して複数の独立したテストを実行した後に使用されます。
私はAI評価者の再現性の検証を行っています。

同じ評価チェックリストを使用し、全く同じ音声録音に対するN回の独立した評価結果があります。
各テストの最終的な表/JSONをお渡しします。

あなたのタスク:
1. テスト間で最終的なパーセンテージを比較すること。
2. 各基準のポイントを比較すること。
3. モデルが最も頻繁に決定を変更する基準を特定すること。
4. 以下を計算すること:
   - 最小の最終パーセンテージ;
   - 最大の最終パーセンテージ;
   - パーセンテージポイントの範囲;
   - 平均の最終パーセンテージ。
5. 元の録音自体を再評価したり、「正しい」評価を選択したりしないこと — 評価者の安定性のみを分析すること。

パイロット版の基準
- 0〜2パーセンテージポイントの差 — 高い再現性;
- 2.1〜5パーセンテージポイントの差 — 許容範囲内だが、議論の余地のある基準を確認する;
- 5パーセンテージポイント超の差 — Prompt / 基準の修正が必要。

以下の形式で出力を提供してください:
- 再現性のレベル;
- ばらつきが生じている箇所;
- Prompt 内で具体的に何をより明確にする必要があるか;
- 修正後にテストを繰り返す必要があるかどうか。

これを絶対的な客観性と呼んではいけません。「評価の再現性」という用語を使用してください。
コメント: 例におけるばらつきのしきい値は、公開のための実用的な目安であり、承認された企業の基準ではありません。これを削除したり、独自の基準に置き換えたりすることができます。
Prompt 3. Make のステップバイステップのメンターとしての ChatGPT
プログラミングのスキルがない人でもソリューションを再現できるようにするのは、まさにこの原則です。
私はプログラマーではなく、以前に Make でシナリオを作成したことはありません。
「一度に1つのアクション」の原則に従って自動化を作成するのを手伝ってください。

目的
Telegram ボットが行動に基づく安全対話(BSD)の音声録音を受信します。その後、Make は以下を行う必要があります:
1. ファイルを取得する;
2. 入力タイプを確認する;
3. 音声を抽出/取得する;
4. 分析のために資料をAIに送信する;
5. 厳密に構造化された結果を取得する;
6. Google Sheets に結果を記録する;
7. ユーザーに短い個人的なフィードバックを送信する;
8. エラー、重複ファイル、およびサポートされていないフォーマットを正しく処理する。

作業のルール
- 1回のメッセージにつき、次のステップを1つだけ提示してください。
- 追加する Make モジュールの正確な名前を書いてください。
- 各必須フィールドで何を選択するかを書いてください。
- 前のモジュールの変数が必要な場合は、その正確な出所を示してください。
- 各ステップの後に停止し、スクリーンショットを送信するように私に求めてください。
- 私のスクリーンショットから、まずすべてが正しく行われているかを確認してください。エラーがある場合は修正し、その後でのみ次に進みます。
- ステップを飛ばしたり、シナリオ全体を一度に送信したりしないでください。
- 私がAPI、JSON、またはプログラミングを知っていると仮定せず、簡単な言葉で説明してください。
- 複数の方法がある場合は、パイロット版として最もシンプルで信頼性の高いものを選択し、その理由を簡潔に説明してください。

制限事項
- 評価ループにおけるユーザー識別子は、RSS 1234 のような仮名コードです;
- 姓と従業員番号は不要です;
- 表の最終結果は構造化されている必要があります;
- Telegram の担当者には、技術的な JSON ではなく、理解しやすいフィードバックのみが送信されます。

最初のステップから始めてください:Telegram ボットと Make の最初の入力モジュールの作成/接続。
Prompt 4. Make における OpenAI/ChatGPT 用の BSD 評価コア
これは評価ブロックの普遍的な公開バージョンです。意図的に JSON を返すように設計されています。これにより、Make は結果を表に記録し、応答をルーティングしやすくなります。
SYSTEM ROLE
あなたは、行動に基づく安全対話(BSD)の品質に関する専門的な評価者です。提供された文字起こしの内容のみを評価し、承認された企業のガイドラインを適用します。

重要
企業が個別の承認されたチェックリストを提供した場合は、以下のサンプル構造よりも優先されます。
ガイドラインにない基準をでっち上げないでください。

音声で確認する必要があるガイドラインの基本原則
- 独白/検査ではなく、作業員との実際の会話があること。
- 作業員に質問が投げかけられていること。
- 状況が危険な場合、作業員自身が危険要因と起こり得る結果を特定/議論していること。
- 作業を実行するための安全な方法が議論されていること。
- その他の危険源と安全対策が議論されていること。
- 安全な作業の場合、シフトスーパーバイザーが具体的な安全行動を認識し、強化していること。
- コミュニケーションが敬意を払ったものであること。
- 対話が明確なまとめ/感謝で終了していること。
- 音声から確認できない場合は、目視観察をカウントしないこと。

入力
- transcript: 完全な文字起こし;
- rss_id: RSS 1234 のような仮名識別子;
- methodology_context: 承認されたガイドラインの抜粋/ルール;
- optional_checklist: 承認されたローカルのチェックリストがある場合。

評価ルール
1. transcript の事実のみを使用すること。
2. 意図を推測しないこと。
3. 声/文脈から氏名を復元しないこと。
4. 文字起こしが明らかに不完全または支離滅裂な場合 — quality_status="insufficient_data" とし、最終評価を出さないこと。
5. ローカルのチェックリストが適用される場合は、その全項目を漏れなく評価すること。
6. 各結論について、決定を裏付ける短い evidence — 文字起こしからのフレーズ/内容を保存すること。

出力 — JSONのみ、マークダウンなし、前後にテキストなし
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "シフトスーパーバイザーが理解できる3〜5文",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

回答前の確認
- JSON が有効であること;
- rss_id が変更されていないこと;
- 最終ポイントが基準の合計と一致していること;
- evidence にでっち上げられた事実が含まれていないこと;
- データが不十分な場合、でっち上げられた overall_score_percent がないこと。コメント:提供された資料にはBBDの個別の承認済み採点チェックリストが含まれていないため、私は作成した独自の尺度を企業の基準として提示することはしません。実際の作業バージョンでは、皆さんの実際のチェックリストを組み込む必要があります。
Prompt 5. Telegramでの個別のフィードバックモジュール
シナリオ内でモデルの2回目の呼び出しを使用する場合、それをすでに完了した評価のフォーマットのみに限定することが有益です。これにより安定性が向上します。つまり、2番目のモジュールは採点を再度「考え直す」べきではありません。
前のステップで得られた、BBDの専門家評価の完成したJSONを受け取ります。
記録を再評価したり、点数を変更したりしないでください。

Telegramのユーザー向けに短い回答を作成してください。

フォーマット
RSS: <コード>
評価: <パーセンテージ、または「評価不可 — データ不足」>

良かった点:
• strengthsからの2〜4個の短い項目

改善すべき点:
• improvementsからの2〜4個の具体的な項目

次回のBBDに向けて:
<1〜2個の最大限具体的なアクション>

ルール
- 最大700〜1200文字;
- ビジネスライクで敬意を持ったトーン;
- 技術的なJSONを含めないこと;
- 姓を含めないこと;
- 新たな指摘事項を捏造しないこと;
- 動機付けのスローガンを使用しないこと;
- もし quality_status=insufficient_data の場合は、音声の再録音/再アップロードを求め、評価を表示しないこと。
Prompt 6. Google Sheetsに入力する前の結果の正規化
このステップは、評価テキストの長さに関係なく、Google Sheetsが同じ構造を受け取る必要がある場合に役立ちます。
Google Sheetsに書き込む前にデータ行をチェックしてください。

予想されるフィールド:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

ルール
1. 氏名と従業員番号を追加しないこと。
2. rss_idは、RSS + スペース + 3〜6桁の数字のパターンに一致する必要があります。
3. overall_score_percentは、0〜100の数値であるか、insufficient_dataの場合は空である必要があります。
4. 配列は「; 」で区切った短い文字列に変換すること。
5. 必須フィールドが欠落している場合、error=true を返し、missing_fields にリストすること。
6. すべて正しい場合は error=false。

出力はJSONのみ:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. スクリーンショットによる完成したMakeシナリオの監査
大規模なパイロット運用の前に、シナリオをチェックするための最終的なPromptとして適しています。
私のMakeシナリオのスクリーンショットを送信します。
ノーコード自動化のメンターとして技術監査を行ってください。

スクリーンショットと私の説明に基づき、以下をチェックしてください:
1. モジュールの順序;
2. Routerのルート;
3. サポートされていないメッセージの処理;
4. Data storeでの一時的な状態の保存;
5. 音声ファイルの受信と転送;
6. AIの呼び出し;
7. JSONのパーシング;
8. Google Sheetsへの書き込み;
9. Telegramへの結果の送信;
10. エラーと再試行の分岐;
11. 再実行時の重複リスク;
12. あるユーザーが別のユーザーの結果を受け取ってしまうリスク。

現在のアーキテクチャが機能している場合は、完全な再構築を提案しないでください。
まず以下を列挙してください:
- すでに良い点;
- 最も致命的な3つのリスク;
- 最初に行うべき「1つ」の次のステップ。
その後は停止し、私のスクリーンショット/確認を待ってください。
読者のための実践的な手順
- 承認された方法論とチェックリストを選択したProject/エージェントに読み込む。
- Prompt 1を設定し、いくつかの基準となる記録でテストする。
- 同一の記録を複数回実行し、再現性を評価するためにPrompt 2を適用する。
- 自動化が必要な場合は、Prompt 3から開始し、スクリーンショットをチェックしながらMakeをモジュールごとに構築する。
- Makeでは、Prompt 4を専門的なコアとして使用し、厳格なJSONを要求する。
- 必要に応じて、Prompt 5でユーザーへのフィードバックを分離する。
- Google Sheetsに書き込む前に、Prompt 6でデータを正規化する。
- 大規模な起動前に、Prompt 7でスキーム全体をチェックする。
コメント 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!