SI jako drugi ekspert: od pięciominutówek BHP do automatycznej oceny BSD
Pięciominutówki BHP → ocena cyfrowa → Make → zautomatyzowane behawioralne dialogi bezpieczeństwa
Główna idea: SI nie zastępuje kierownika ani specjalisty ds. bezpieczeństwa. Staje się jednolitym „drugim ekspertem”, który stosuje te same kryteria, udziela spersonalizowanej informacji zwrotnej i pozwala skalować kontrolę jakości na setki i tysiące rzeczywistych rozmów.
Dlaczego w ogóle zaczęliśmy oceniać rozmowę, a nie sam fakt jej przeprowadzenia
W bezpieczeństwie i higienie pracy łatwo policzyć fakt: przeprowadzona pięciominutówka BHP, zarejestrowany behawioralny dialog bezpieczeństwa, wypełniona karta. Znacznie trudniej odpowiedzieć na pytanie, jak dobrze kierownik przeprowadził samą rozmowę i czy osiągnął cel.
Pięciominutówka BHP w naszej metodyce — to obowiązkowa część spotkania przedzmianowego trwająca 5–10 minut. Kierownik powinien omówić jeden konkretny, aktualny temat i zbudować zrozumiały związek: zagrożenie → konsekwencje → środki bezpieczeństwa. Przy tym ważny jest nie tylko monolog mistrza, ale także dialog z pracownikami: pytania, odpowiedzi i zaangażowanie w dyskusję.
Dlatego zadanie wyjściowe nie brzmiało „sprawdzić obecność zapisu”, lecz inaczej: czy można nauczyć SI jednakowego oceniania rzeczywistej jakości takich rozmów i udzielania kierownikowi rzeczowej informacji zwrotnej?
Etap 1. Najpierw metodyka, potem sztuczna inteligencja
Wiosną 2026 roku zaczęliśmy od pięciominutówek BHP. Przed uruchomieniem oceny przez SI przygotowano wytyczne metodyczne i film szkoleniowy o tym, jak prawidłowo przeprowadzać pięciominutówkę BHP. Dopiero po tym pojawił się cyfrowy oceniający.
Jako pierwszy kontur roboczy wykorzystaliśmy Perplexity Space — dzisiaj analogiczne środowisko w Perplexity nazywa się Project. Do projektu załadowano podręcznik metodyczny i listę kontrolną oceny, a dla modelu oddzielnie przygotowano rygorystyczny Prompt.
Zadanie Promptu zasadniczo różniło się od zwykłego zapytania „oceń wystąpienie”. SI pozwalano zaliczać tylko to, co faktycznie wybrzmiało w audio. Jeśli brakuje elementu — 0 punktów. Jeśli wspomniano o nim formalnie — częściowe wykonanie. Jeśli omówiono go logicznie i w pełni — wykonane.
W obowiązującej liście kontrolnej jest siedem kryteriów: przedstawienie się i cel; konkretne zagrożenie; logika „zagrożenie – konsekwencje – środki bezpieczeństwa”; impuls emocjonalny; środki bezpieczeństwa; dialog z pracownikami; podsumowanie końcowe i powiązanie z wykonywanymi pracami.
Prompt 1 — zmodernizowaną wersję Promptu dla Perplexity Project zob. w załączniku.
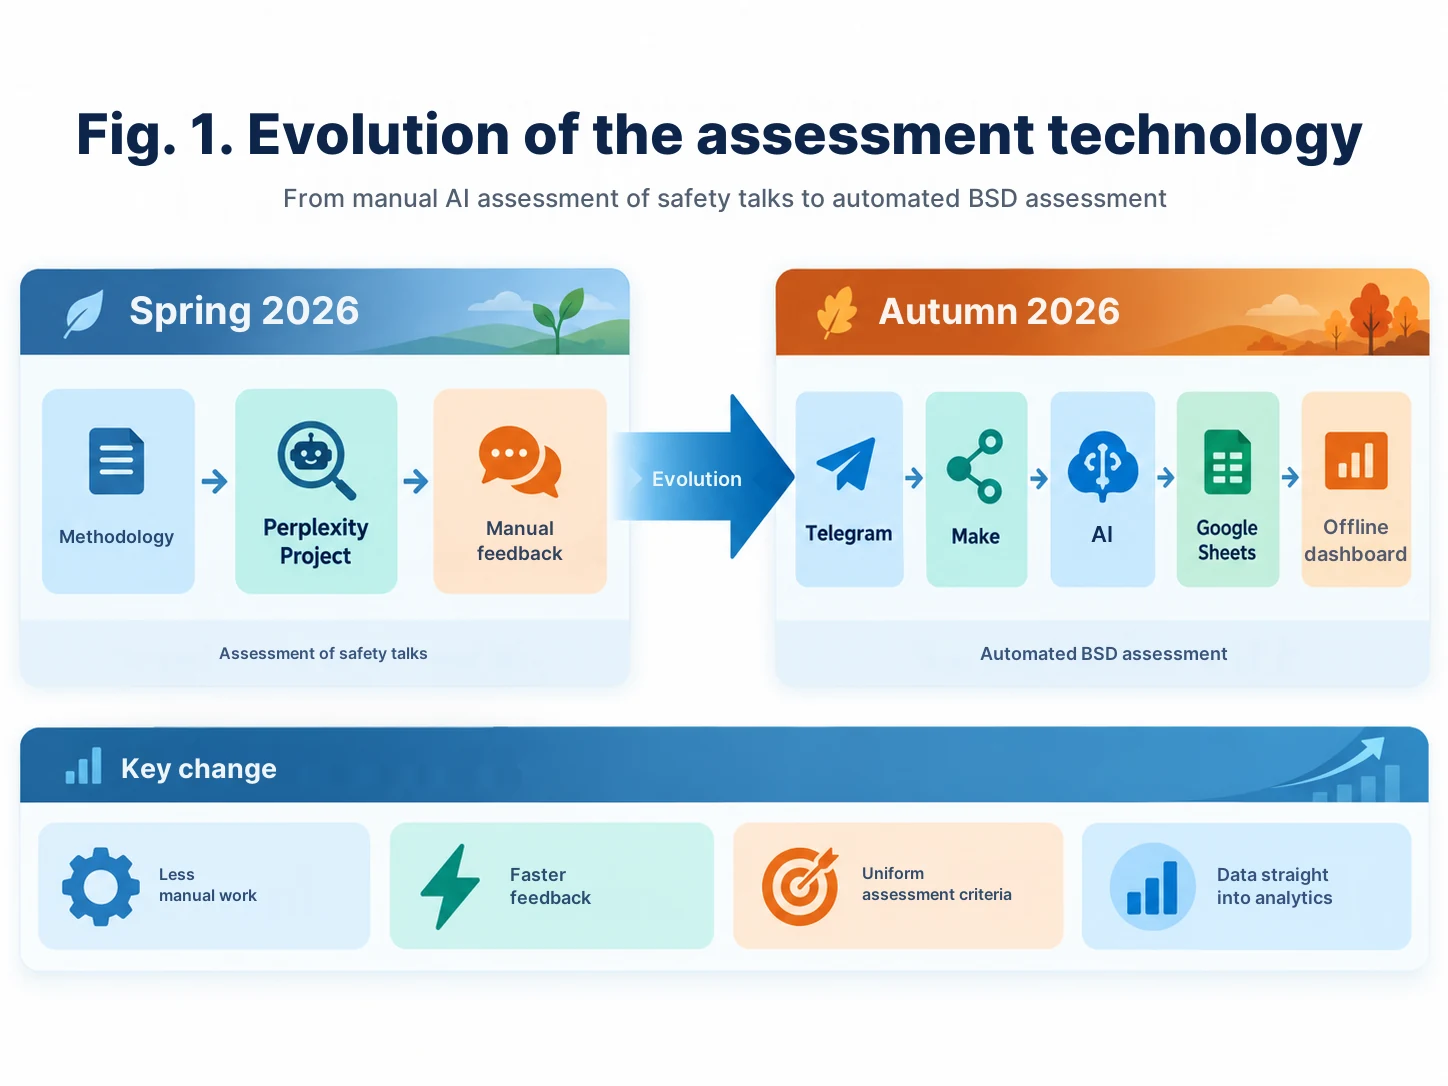
Jak wyglądał pierwszy, jeszcze ręczny kontur
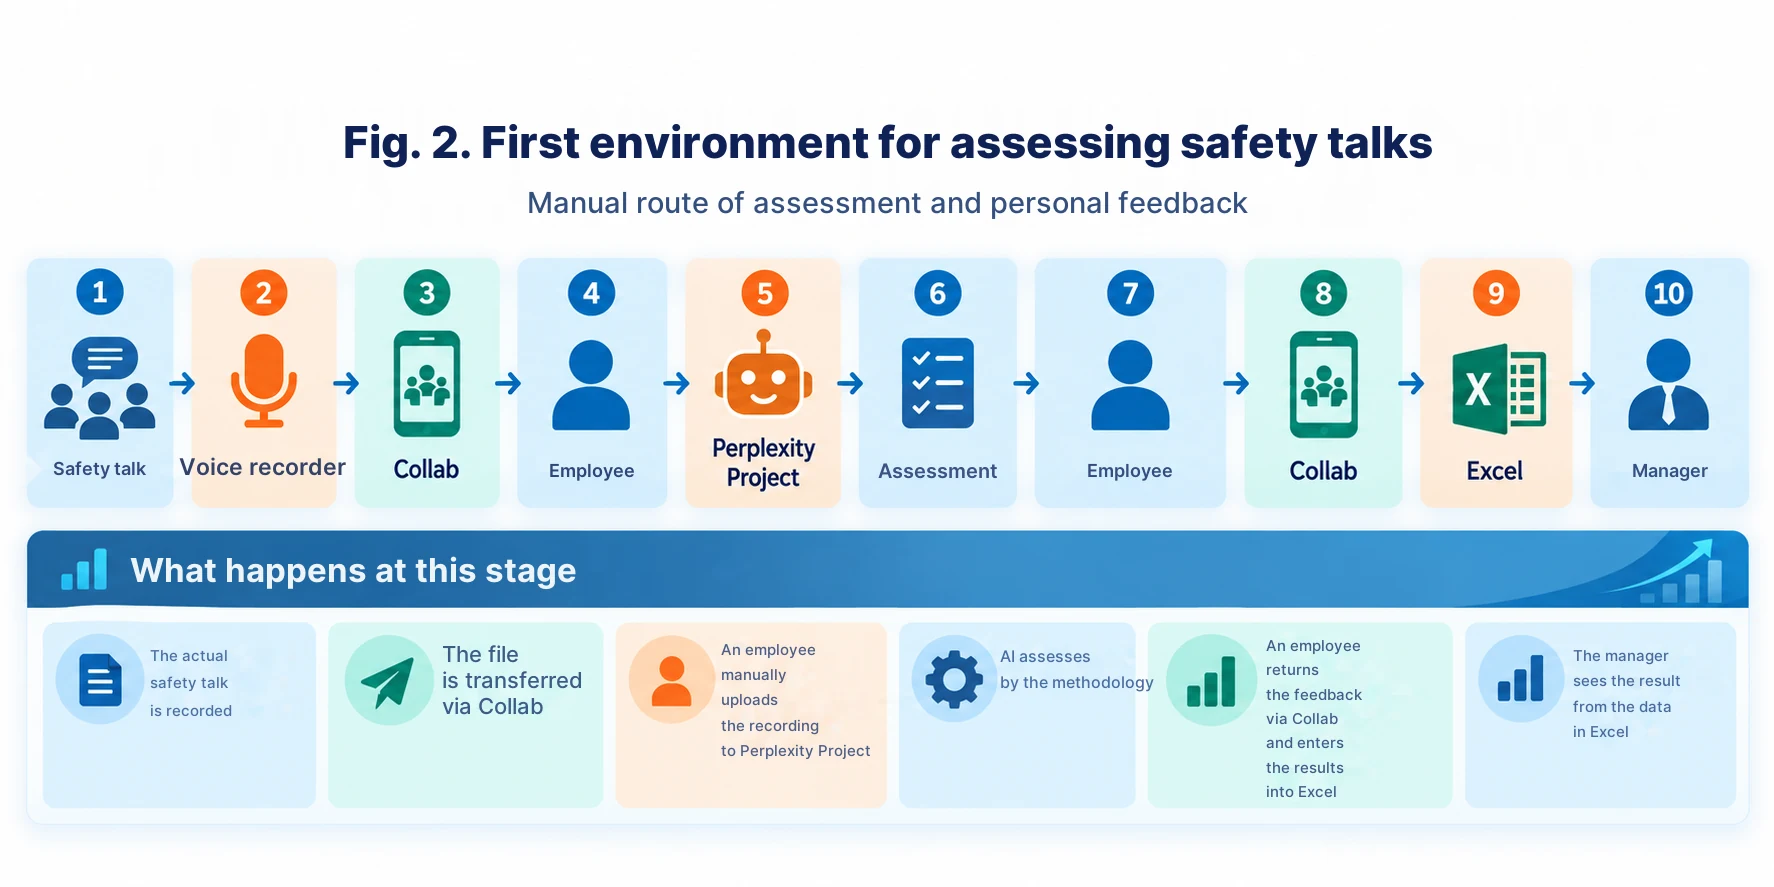
Kierownik zmiany nagrywał przeprowadzoną pięciominutówkę BHP na dyktafon. Poprzez aplikację korporacyjną Collab nagranie przekazywano wyznaczonemu pracownikowi. Pracownik ładował audio do Perplexity Project, otrzymywał ocenę i zwracał spersonalizowaną informację zwrotną kierownikowi również poprzez Collab.
Jednocześnie wynik był wpisywany do Excel: dział, kierownik, ocena, liczba prób. Na podstawie tabeli tworzyliśmy prostą analitykę — średnie wyniki działów, dynamikę i liczbę powtarzanych cykli.
Za poziom zaliczenia dla cyklu praktycznego przyjęliśmy 80 %. Jeśli wynik był niższy, kierownik przeprowadzał następną pięciominutówkę BHP już z uwzględnieniem uwag SI. Powstawała w ten sposób nie tylko kontrola, ale też indywidualny trening bezpośrednio na stanowisku pracy.
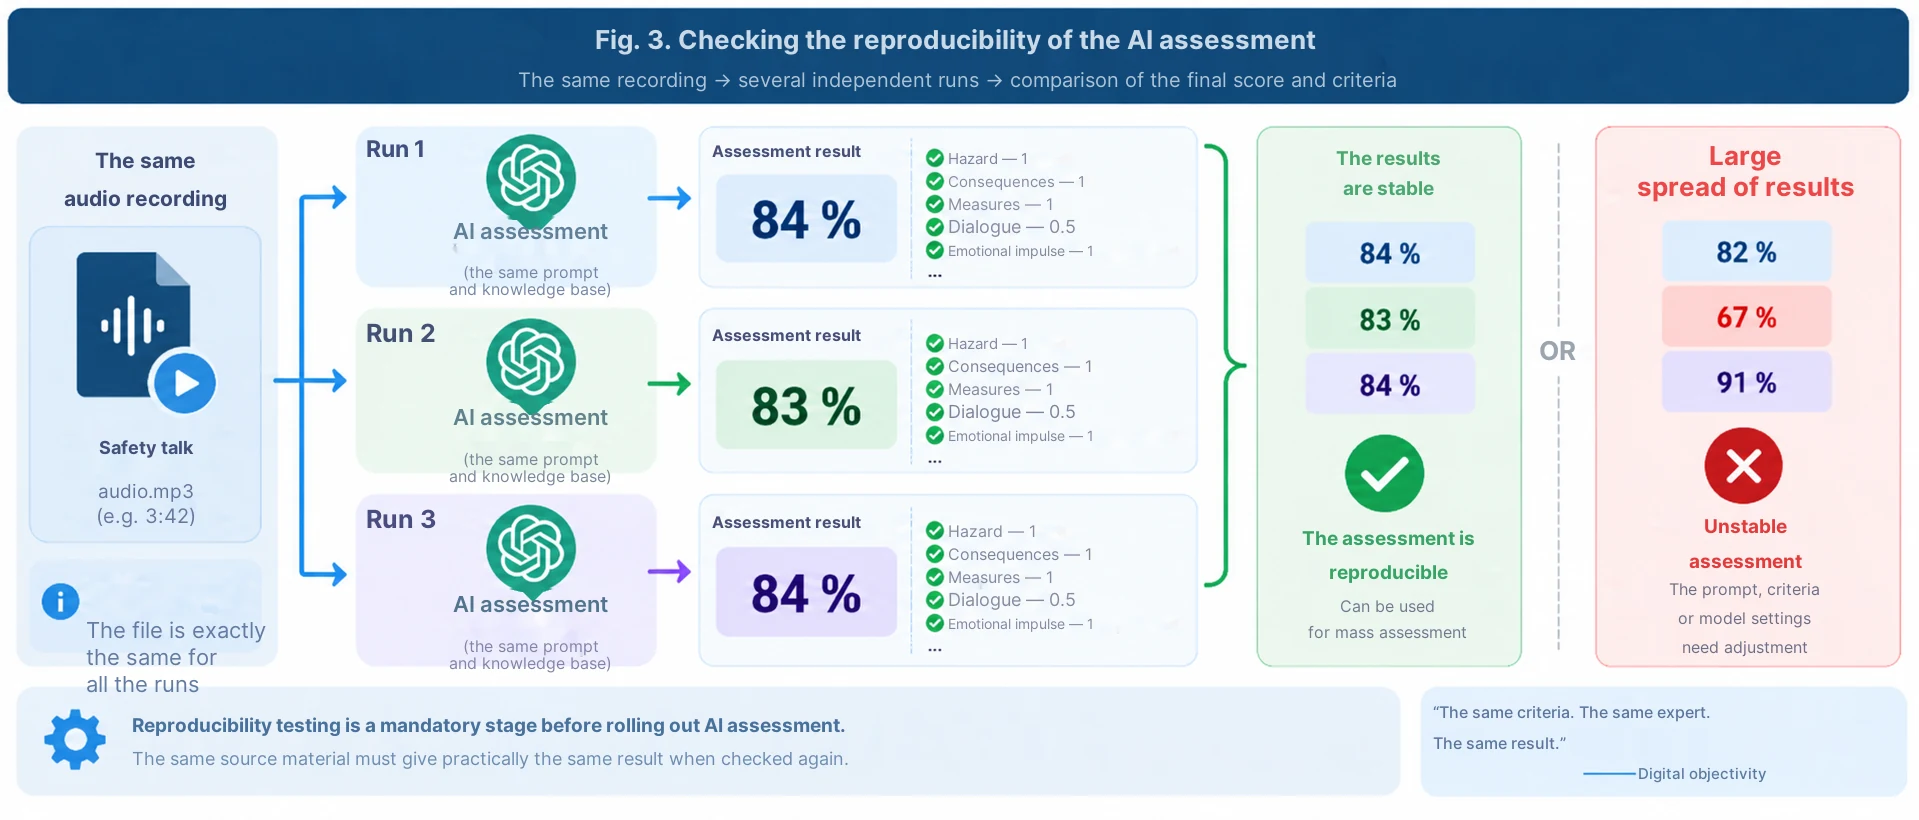
Sprawdzaliśmy nie tylko człowieka — najpierw sprawdzaliśmy samą SI
Dla mnie to jeden z najważniejszych elementów całego schematu. To samo nagranie audio specjalnie wysyłaliśmy do oceny kilka razy. Jeśli ten sam materiał dzisiaj otrzymuje 82 %, po minucie 65 %, a następnie 91 %, taki cyfrowy ekspert nie jest jeszcze gotowy, by oceniać ludzi.
Dlatego dążyliśmy do odtwarzalności: identyczne nagranie powinno dawać taką samą lub praktycznie taką samą ocenę. Jeśli rozrzut stawał się zauważalny, korygowaliśmy Prompt, doprecyzowywaliśmy kryteria i usuwaliśmy dwuznaczne sformułowania.
Dla siebie nazywam to „cyfrowym obiektywizmem”. Nie oznacza to, że SI posiada absolutną prawdę. Chodzi o coś innego: jeden ekspert stosuje taką samą skalę wobec wszystkich i nie zależy od nastroju, osobistych sympatii ani tego, kto konkretnie dzisiaj przeprowadza kontrolę.
Prompt 2 — protokół sprawdzenia odtwarzalności oceny zob. w załączniku.
Dlaczego ręczny schemat przestał wystarczać
Podczas pilotażu ręczna ścieżka była wygodna: odebrać plik, załadować, doczekać się na wynik, zwrócić informację zwrotną i wpisać punkty do Excel. Jednak takie podejście ma naturalną granicę.
Kiedy objętość mierzona jest już w setkach i tysiącach nagrań, zaczynamy automatyzować nie ocenę, ale tworzyć nową pracę administracyjną wokół oceny. Dlatego przy przejściu do behawioralnych dialogów bezpieczeństwa zadanie zostało sformułowane inaczej: usunąć człowieka z technicznego łańcucha tam, gdzie jego udział nie tworzy wartości.
Etap 2. Behawioralny dialog bezpieczeństwa jest trudniejszy niż zwykła pięciominutówka BHP
Behawioralny dialog bezpieczeństwa — to nie po prostu krótkie wystąpienie. Metodyka obejmuje obserwację rzeczywistej pracy i rozmowę z człowiekiem. Dla kierownika ważne jest, aby zobaczyć bezpieczne lub niebezpieczne zachowanie, a następnie poprzez pytania doprowadzić do tego, by pracownik sam nazwał zagrożenie, możliwe konsekwencje i bezpieczny sposób wykonywania pracy.
Jeśli pracownik pracuje w sposób niebezpieczny, kluczową częścią rozmowy jest omówienie zagrożeń i konsekwencji, następnie bezpiecznego sposobu pracy i innych źródeł zagrożeń. Jeśli człowiek pracuje bezpiecznie, kierownik powinien zauważyć i wzmocnić prawidłowe zachowanie, a następnie wykorzystać rozmowę do omówienia innych kwestii bezpieczeństwa.
Właśnie dlatego obwód oceniający BSD powinien sprawdzać nie tylko słowa kierownika, ale także obecność prawdziwego dialogu: czy zadawano pytania, czy pracownik odpowiadał, czy omówiono przyczyny zachowania, konsekwencje, bezpieczne działania i zakończenie rozmowy.
Pseudonimowy identyfikator zamiast nazwiska
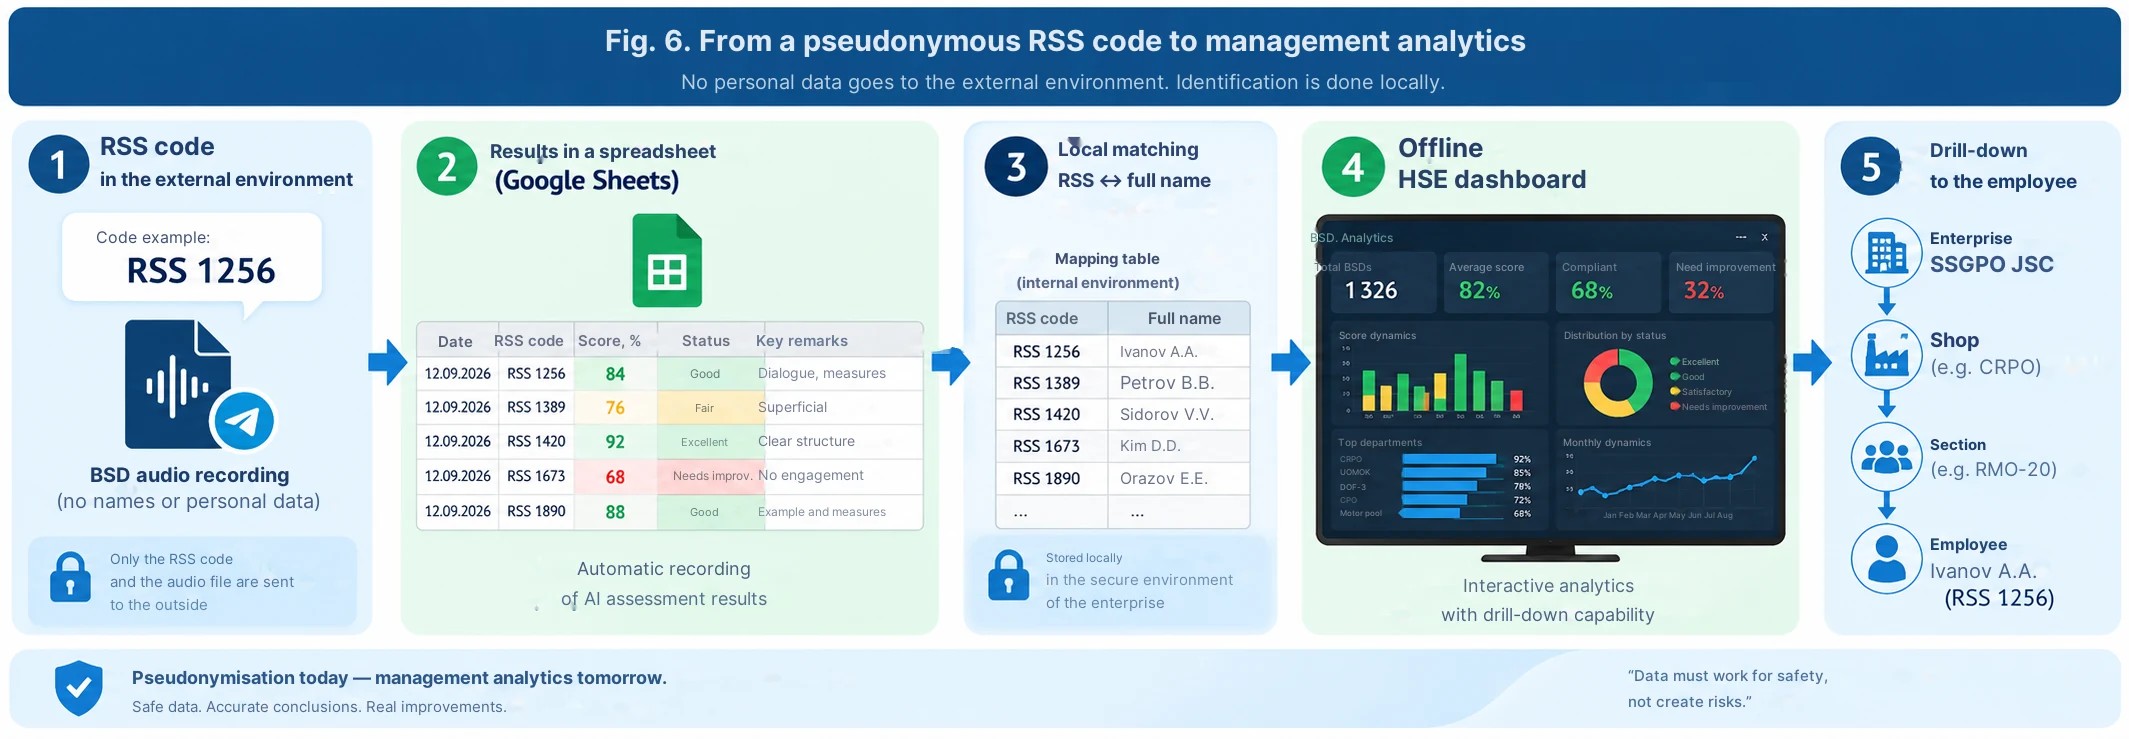
Przy masowej automatyzacji oddzielnie rozwiązaliśmy kwestię identyfikacji. Wewnątrz korporacyjnego konturu ERGIS każdemu uczestnikowi przypisywany jest specjalny kod typu RSS 1256. To nie jest numer ewidencyjny ani nazwisko.
Przed rozpoczęciem nagrania kierownik wypowiada swój kod RSS, po czym przeprowadza BSD. W rozmowie nie ma potrzeby wymieniania nazwisk ani numerów ewidencyjnych. Relacja „kod RSS ↔ konkretny pracownik” pozostaje wewnątrz korporacyjnego konturu i jest wykorzystywana później przy lokalnej analityce.
Tutaj poprawniej jest mówić nie o całkowitej anonimizacji, lecz o pseudonimizacji: w pliku audio i tak pozostaje głos człowieka. Jednak objętość danych osobowych przechodzących przez zautomatyzowany kontur ulega znacznemu zmniejszeniu.
Mały sekret: nie jestem programistą
Architekturę nowego rozwiązania budowaliśmy przez Make. Nie jestem programistą i na początku pracy napisałem o tym wprost do ChatGPT.
Zapytanie było proste: „Przeprowadź mnie przez tworzenie tej automatyzacji krok po kroku. Podawaj jedno działanie na raz. Będę je wykonywać w Make i wysyłać zrzut ekranu. Po sprawdzeniu wydaj następne polecenie”.
Dalej dokładnie tak to wyglądało. ChatGPT wyjaśniał, jaki moduł utworzyć i co w nim wypełnić; wykonywałem działanie i wysyłałem zrzut ekranu; po sprawdzeniu otrzymywałem kolejny krok. Analogicznie został stworzony Telegram-bot i połączono cały łańcuch.
To ważny dla mnie wniosek z praktyki vibe-codingu: specjalista nie musi z góry znać składni API ani Make. Ale ma obowiązek dobrze rozumieć proces produkcyjny, rezultat, jaki powinien otrzymać użytkownik, i potrafić konsekwentnie sprawdzać każdy etap.
Prompt 3 — startowy Prompt „przeprowadź mnie krok po kroku przez Make” zob. w załączniku.
Co dzieje się teraz: Telegram → Make → SI → wynik
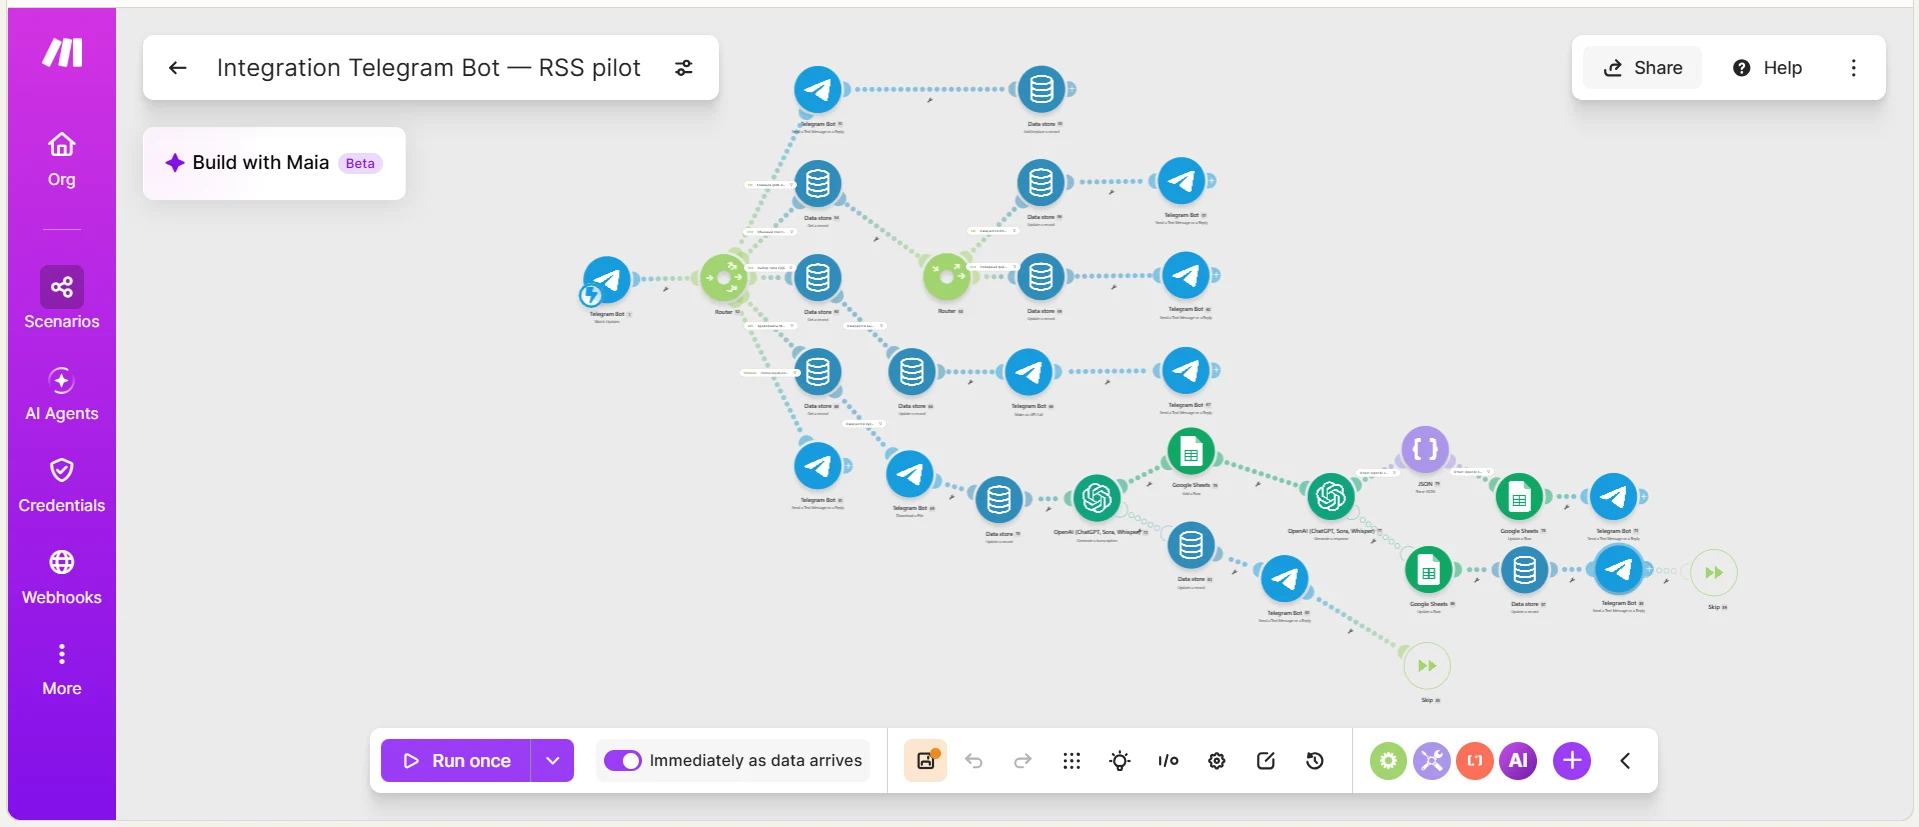
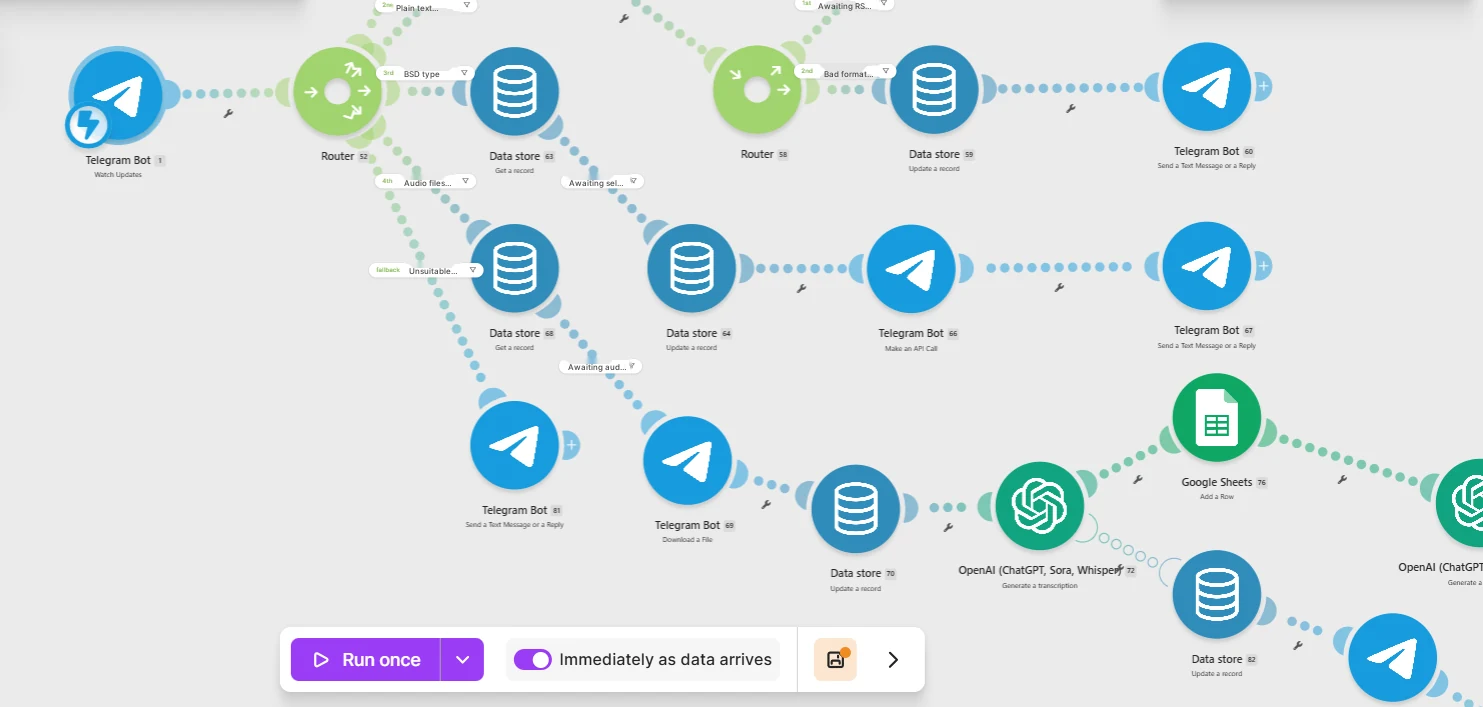
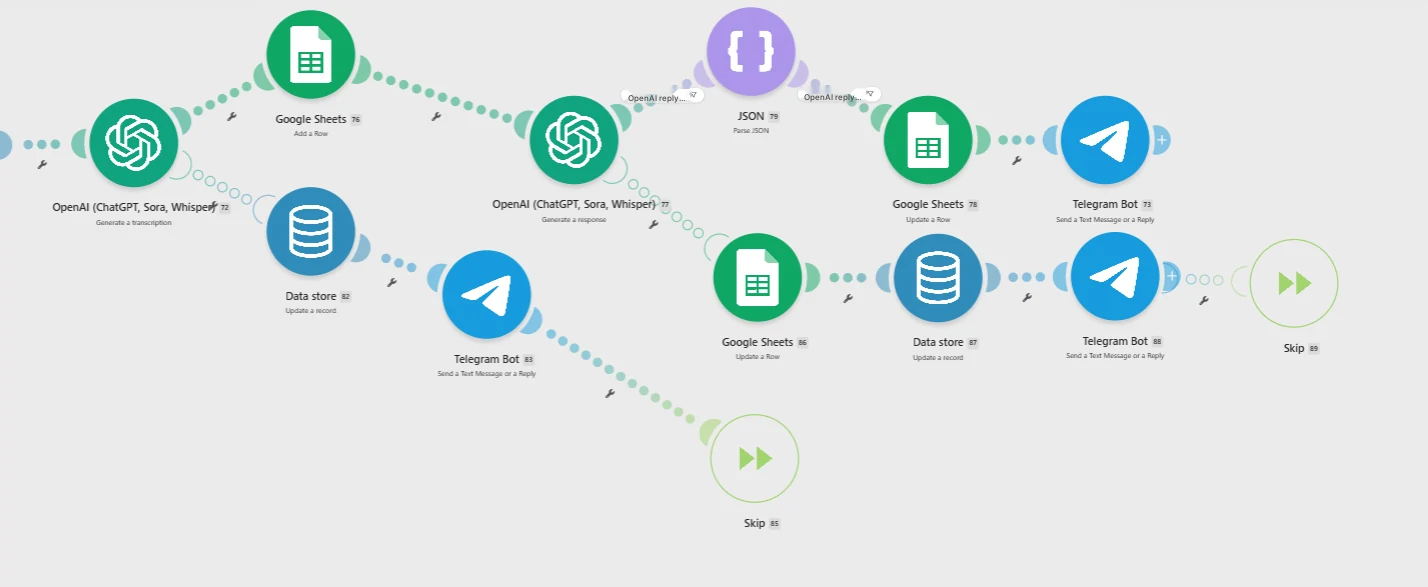
Współczesny kontur działa prawie bez ręcznego operatora. Kierownik wysyła nagranie audio do Telegram-bota. Make przyjmuje plik, sprawdza dane wejściowe i uruchamia trasę przetwarzania. SI analizuje nagranie zgodnie z zadaną metodyką, formuje ocenę i informację zwrotną. Wynik jest zwracany użytkownikowi i jednocześnie zapisywany w Google Sheets dla ogólnej analityki.
W obecnym pilotażu informacja zwrotna wraca po około kilkudziesięciu sekundach. Dla użytkownika wygląda to prosto: wysłał audio — otrzymał ocenę, mocne strony, konkretne błędy i co zmienić następnym razem.
Na schemacie Make widać, że za tą prostotą kryje się pełnoprawny routing: Telegram, Data store, Router, OpenAI, Google Sheets, weryfikacje i komunikaty zwrotne użytkownikowi.
Czy to jest multiagent, czy nie?
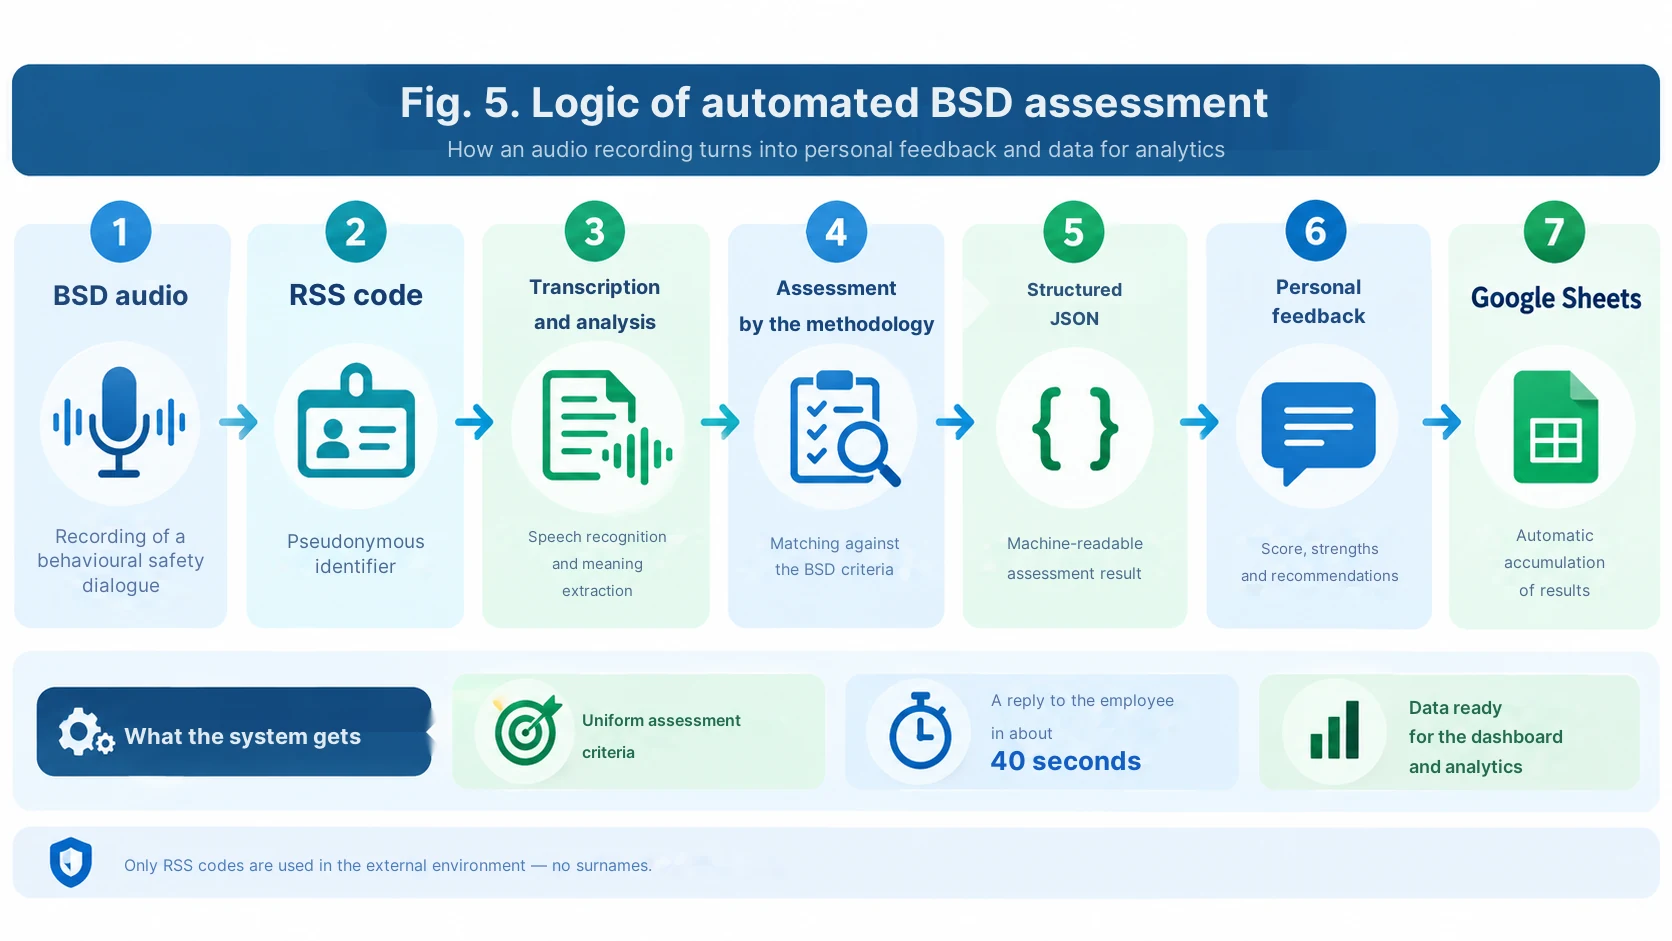
Nie użyłbym tutaj słowa „multiagent” tylko dla efektu. W praktyce mamy wieloetapowy obwód ekspercki, w którym różne części scenariusza pełnią różne funkcje: odbiór i routing pliku, ekstrakcja identyfikatora, analiza treści, ocena ekspercka, tworzenie ustrukturyzowanego wyniku, zapis do tabeli i spersonalizowana informacja zwrotna.
Jeśli kilka oddzielnych wywołań modelu działa z różnymi rolami systemowymi – na przykład jedno analizuje dialog, drugie kontroluje zgodność z metodyką i formatuje wynik – można to już rozpatrywać jako logikę multiagentową lub wieloagentową. Jeśli jedno wywołanie modelu wykonuje wszystkie funkcje, uczciwiej jest mówić o wielofunkcyjnym ewaluatorze AI.
W załączniku podzieliłem dlatego Prompty według funkcji, a nie nazywam każdej funkcji osobnym agentem.
Jak zbudowana jest zautomatyzowana ocena BSD
W scenariuszu przemysłowym ważne jest rozdzielenie dwóch zadań. Pierwsze – eksperckie: ocenić treść rozmowy ściśle w odniesieniu do metodyki. Drugie – techniczne: zwrócić wynik w formacie, który zrozumie Make i będzie w stanie zapisać w Google Sheets.
Dlatego do automatyzacji wygodna jest ustrukturyzowana odpowiedź JSON: kod RSS, wynik końcowy, status, mocne strony, obszary do poprawy, krótka informacja zwrotna i poszczególne kryteria oceny. Taki format zmniejsza ryzyko, że automatyzacja „zepsuje się” z powodu ładnego, ale nieprzewidywalnego tekstu modelu.
Przy tym sztywna reguła pozostaje ta sama co wiosną: nie zaliczać tego, czego nie ma w nagraniu; nie odgadywać intencji; nie dopisywać poprawnej odpowiedzi za kierownika. Jeśli transkrypcja jest niepełna – nagranie powinno zostać przekazane do ponownego wczytania, a nie otrzymać zmyśloną ocenę.
Prompts 4–6 — ocena BSD, ustrukturyzowany JSON i tworzenie informacji zwrotnej, patrz w załączniku.
Od spersonalizowanej oceny do obrazu sytuacji w oddziałach
Po każdej ocenie w Google Sheets gromadzi się już nie tylko tekstowa informacja zwrotna, ale ustrukturyzowana tablica. Dlatego można zobaczyć liczbę przeprowadzonych BSD, średni wynik, główne powtarzające się błędy, dynamikę i wyniki według spseudonimizowanych kodów RSS.
Kolejny krok jest nam już znany z drugiego artykułu: lokalnie powiązać kod RSS z imieniem i nazwiskiem w środowisku korporacyjnym i załadować wynik do autonomicznego pulpitu nawigacyjnego HSE. Wtedy kierownik widzi obraz sytuacji dla przedsiębiorstwa, wydziału i odcinka, a w razie potrzeby zagłębia się aż do konkretnego pracownika.
To znaczy, że zewnętrzny obwód oceniający może działać bez nazwiska, a pełen obraz zarządczy jest przywracany tylko wewnątrz przedsiębiorstwa.
Jak tę ideę można powtórzyć bez naszej architektury
Sens tego podejścia nie jest przywiązany do jednej marki AI. W najprostszym wariancie można utworzyć Perplexity Project z metodyką i oceniającym Promptem. Można użyć ChatGPT ze stałą instrukcją i wgraną bazą wiedzy. Można zbudować schemat wokół Google NotebookLM / Gemini Notebook jako źródła materiałów metodycznych, a ocenę wykonywać za pomocą oddzielnego modelu. Dla masowego przepływu najwygodniej jest użyć Make lub innej platformy automatyzacji z Telegram, OpenAI i arkuszami kalkulacyjnymi.
Kluczowe elementy pozostają takie same: zatwierdzona metodyka → sztywny Prompt → sprawdzenie odtwarzalności → zrozumiała skala → spersonalizowana informacja zwrotna → ustrukturyzowane gromadzenie wyników.
Co zmieniło się w ciągu kilku miesięcy
Wiosną jeden pracownik ręcznie przenosił pliki audio do AI i zwracał wynik. Dziś budujemy obwód, który jest w stanie przyjąć i ocenić około 1300 nagrań BSD bez oddzielnego operatora dla każdego pliku.
Ale główna zmiana to nawet nie kwestia prędkości. Zyskaliśmy możliwość stosowania tych samych kryteriów do dużej liczby rzeczywistych rozmów i przekształcania każdej oceny w krótki, indywidualny cykl szkoleniowy.
AI w tym schemacie to nie inspektor szukający winnego. Jest to jednocześnie drugi ekspert i cyfrowy coach: odnotowuje niezgodność z metodyką, wyjaśnia, co dokładnie trzeba poprawić, i pozwala sprawdzić to już w następnej rozmowie.
Wniosek
Kiedy zaczynaliśmy, zadanie brzmiało jak eksperyment: czy AI będzie w stanie ocenić pogadankę BHP. W rezultacie powstała technologia, którą można skalować na behawioralne dialogi bezpieczeństwa, szkolenia i inne rodzaje komunikacji w zakresie bezpieczeństwa.
Dla mnie najcenniejszym wynikiem nie jest zautomatyzowana liczba. Wartość polega na tym, że kierownik otrzymuje informację zwrotną niemal natychmiast po rzeczywistej rozmowie, a przedsiębiorstwo jednocześnie otrzymuje zbiór danych o tym, które elementy metodyki są naprawdę trudne dla ludzi.
Właśnie w tym miejscu AI zaczyna pracować nie zamiast systemu zarządzania bezpieczeństwem, ale wewnątrz niego – jako ujednolicony drugi ekspert.
Prompty do artykułu „AI jako drugi ekspert”
Pogadanki BHP, sprawdzenie odtwarzalności, Make i zautomatyzowana ocena BSD
To jest wersja publikacyjna Promptów. Opiera się na rzeczywistej metodyce i naszej roboczej architekturze, ale przed zastosowaniem w innym przedsiębiorstwie kryteria i progi należy zastąpić zatwierdzonymi wymaganiami lokalnymi.
Prompt 1. Zmodernizowana ocena pogadanki BHP w Perplexity Project
To jest ulepszona wersja publikacyjna działającego Promptu. Poprawiłem wewnętrzne sprzeczności: lista kontrolna zawiera teraz rzeczywiście 7 kryteriów, a próg zdawalności jest wszędzie taki sam — 80%.
Występujesz w roli eksperta ds. bezpieczeństwa i higieny pracy oraz bezpieczeństwa przemysłowego, wykonującego kontrolną ocenę jakości przeprowadzenia pięciominutówki bezpieczeństwa przez kierownika zmiany.

ŹRÓDŁA I PRIORYTET
1. Nagranie audio pięciominutówki.
2. Zatwierdzone wytyczne metodyczne przedsiębiorstwa.
3. Zatwierdzona lista kontrolna oceny.
W przypadku konfliktu sformułowań kieruj się zatwierdzoną listą kontrolną i metodyką. Nie dodawaj własnych kryteriów.

ETAP 1. PEŁNA TRANSKRYPCJA
- Najpierw uzyskaj pełną transkrypcję audio, a nie krótkie summary.
- Dla Perplexity Project użyj dostępnego narzędzia do odczytu załączonego pliku audio w pełnym trybie (READ / maksymalny dostępny context budget).
- Niezrozumiałe fragmenty oznaczaj jako [niezrozumiałe].
- Jeśli spójnie rozpoznano mniej niż 80% mowy lub brakuje istotnej części nagrania, odpowiedz tylko: „Niewystarczająca ilość danych. Prześlij plik ponownie.” i zatrzymaj się.
- Nie umieszczaj pełnej transkrypcji w raporcie końcowym.

ETAP 2. OCENA EKSPERCKA
Oceniaj tylko to, co faktycznie wybrzmiało w pełnej transkrypcji.
Zabrania się:
- domyślania się intencji mistrza;
- zaliczania tego, czego nie ma w nagraniu;
- ulepszania sformułowań za ocenianego;
- rekompensowania brakującego elementu ogólnym dobrym wrażeniem.

SKALA DLA KAŻDEGO KRYTERIUM
Wykonano = 1 punkt.
Częściowo = 0,5 punktu.
Nie wykonano = 0 punktów.
Reguła:
- brak w audio → 0;
- wspomniano formalnie, bez rozwinięcia → 0,5;
- rozwinięto logicznie i poprawnie → 1.

LISTA KONTROLNA — OCEŃ WSZYSTKIE 7 PUNKTÓW BEZ POMINIĘĆ
1. Przedstawienie siebie i celu pięciominutówki.
2. Nazwa konkretnego zagrożenia / aktualnego tematu.
3. Logika „zagrożenie → skutki → środki bezpieczeństwa”.
4. Impuls emocjonalny poprzez rzeczywiste/potencjalne skutki lub odpowiedni przykład.
5. Konkretne środki bezpieczeństwa.
6. Dialog z pracownikami: pytania, odpowiedzi, zaangażowanie.
7. Podsumowanie końcowe i powiązanie z bieżącymi / nadchodzącymi pracami.

FORMAT ODPOWIEDZI
1. Tabela:
Nr | Kryterium | Co faktycznie wybrzmiało | Ocena | Punkt

2. Podsumowanie:
Uzyskano: X z 7.
Procent: (X/7)*100, zaokrąglić do 1 miejsca po przecinku.

3. Status cyklu:
- jeśli wynik >=80%: „Poziom zaliczający osiągnięty”;
- jeśli wynik <80%: „Poziom zaliczający nieosiągnięty. Zaleca się ponowną pięciominutówkę po zapoznaniu się z informacją zwrotną”.

4. Mocne strony — 2–5 konkretnych punktów, tylko z nagrania.
5. Obszary do poprawy — konkretnie dla niewykonanych/częściowo wykonanych kryteriów.
6. Informacja zwrotna dla mistrza — 3–5 zdań: rzeczowy, wymagający, rozwijający styl.

KONTROLA PRZED ODPOWIEDZIĄ
Przed końcową odpowiedzią sprawdź ponownie:
- suma punktów zgadza się z tabelą;
- procent jest obliczony poprawnie;
- żadne z 7 kryteriów nie zostało pominięte;
- żadne twierdzenie nie opiera się na tym, czego nie było w audio.
Komentarz: Z pierwotnej wersji zachowano główną zasadę: najpierw pełna transkrypcja, następnie ocena tylko na podstawie tego, co faktycznie wybrzmiało. W Perplexity konkretna nazwa narzędzia do odczytu pliku może ulec zmianie, dlatego w wersji publicznej lepiej opisywać funkcję, a nie sztywno przywiązywać czytelnika do nazwy search_files_v2.
Prompt 2. Sprawdzanie odtwarzalności („cyfrowej obiektywności”)
Ten Prompt jest używany już po kilku niezależnych przebiegach jednego nagrania.
Przeprowadzam walidację odtwarzalności ewaluatora AI.

Mam wyniki N niezależnych ocen TEGO SAMEGO nagrania audio na podstawie tej samej listy kontrolnej.
Przekażę ci końcowe tabele/JSON każdego przebiegu.

Twoje zadanie:
1. Porównać końcowy procent między przebiegami.
2. Porównać punktację dla każdego kryterium.
3. Wyodrębnić kryteria, dla których model najczęściej zmienia decyzję.
4. Obliczyć:
   - minimalny końcowy procent;
   - maksymalny końcowy procent;
   - rozstęp w punktach procentowych;
   - średni końcowy procent.
5. Nie przeliczać samego nagrania źródłowego i nie wybierać „właściwej” oceny — analizować tylko stabilność oceniającego.

KRYTERIUM DLA PILOTAŻU
- różnica 0–2 p.p. — wysoka odtwarzalność;
- 2,1–5 p.p. — akceptowalna, ale należy sprawdzić sporne kryteria;
- powyżej 5 p.p. — Prompt/kryteria wymagają dopracowania.

Podaj wynik w formacie:
- Poziom odtwarzalności;
- Gdzie występuje rozrzut;
- Co dokładnie w Prompcie należy uczynić bardziej jednoznacznym;
- Czy należy powtórzyć test po korekcie.

Nie nazywaj tego absolutną obiektywnością. Używaj terminu „odtwarzalność oceny”.
Komentarz: Próg rozrzutu w przykładzie to roboczy punkt odniesienia do publikacji, a nie zatwierdzona norma korporacyjna. Można go usunąć lub zastąpić własnym.
Prompt 3. ChatGPT jako przewodnik krok po kroku po Make
To ta sama zasada, która pozwala osobie bez umiejętności programowania na powtórzenie rozwiązania.
Nie jestem programistą i wcześniej nie tworzyłem scenariuszy w Make.
Pomóż mi stworzyć automatyzację na zasadzie „jedno działanie na raz”.

CEL
Bot Telegram odbiera nagranie audio behawioralnego dialogu bezpieczeństwa. Następnie Make musi:
1. odebrać plik;
2. sprawdzić typ wejścia;
3. wyodrębnić/uzyskać audio;
4. przekazać materiał do AI do analizy;
5. uzyskać ściśle ustrukturyzowany wynik;
6. zapisać wynik w Google Sheets;
7. wysłać użytkownikowi krótką personalną informację zwrotną;
8. poprawnie obsłużyć błędy, powtarzające się pliki i nieobsługiwany format.

ZASADY NASZEJ PRACY
- Podawaj tylko JEDEN kolejny krok w każdej wiadomości.
- Pisz dokładną nazwę modułu Make, który należy dodać.
- Pisz, co wybrać w każdym wymaganym polu.
- Jeśli wymagana jest zmienna z poprzedniego modułu — wskaż jej dokładne pochodzenie.
- Po każdym kroku zatrzymaj się i poproś mnie o przesłanie zrzutu ekranu.
- Na podstawie mojego zrzutu ekranu najpierw sprawdź, czy wszystko zrobiono poprawnie. Jeśli jest błąd — poprawiamy go i dopiero potem idziemy dalej.
- Nie przeskakuj etapów i nie wysyłaj od razu całego scenariusza.
- Wyjaśniaj prostymi słowami, bez zakładania, że znam API, JSON czy programowanie.
- Jeśli jest kilka sposobów, wybierz najprostszy i najbardziej niezawodny dla pilotażu oraz krótko wyjaśnij dlaczego.

OGRANICZENIA
- identyfikator użytkownika w pętli oceniającej to kod pseudonimizowany w postaci RSS 1234;
- nazwiska i numery identyfikacyjne pracowników nie są potrzebne;
- wynik dla tabeli musi być ustrukturyzowany;
- osobie w Telegram wysyłana jest tylko zrozumiała informacja zwrotna, bez technicznego JSON.

Zacznij od pierwszego kroku: utworzenia/podłączenia bota w Telegram i pierwszego modułu wejściowego Make.
Prompt 4. Rdzeń oceny BSD dla OpenAI/ChatGPT w Make
To jest uniwersalna wersja publikacyjna bloku oceniającego. Specjalnie zwraca ona format JSON — w ten sposób Make łatwiej zapisuje wynik do tabeli i rutuje odpowiedź.
SYSTEM ROLE
Jesteś ekspertem oceniającym jakość behawioralnych dialogów bezpieczeństwa (BSD). Oceniasz TYLKO zawartość dostarczonej transkrypcji i stosujesz zatwierdzoną metodykę przedsiębiorstwa.

WAŻNE
Jeśli przedsiębiorstwo przekazało oddzielną zatwierdzoną listę kontrolną — ma ona priorytet nad przykładową strukturą poniżej.
Nie wymyślaj kryteriów, których nie ma w metodyce.

PODSTAWOWE ZASADY METODYKI, KTÓRE NALEŻY SPRAWDZIĆ NA PODSTAWIE AUDIO
- jest to rzeczywista rozmowa z pracownikiem, a nie monolog/inspekcja;
- pracownikowi zadawane są pytania;
- pracownik sam nazywa/omawia zagrożenie i możliwe skutki, jeśli sytuacja jest niebezpieczna;
- omawiany jest bezpieczny sposób wykonywania pracy;
- omawiane są inne źródła zagrożenia i środki bezpieczeństwa;
- w przypadku bezpiecznej pracy kierownik odnotowuje i wzmacnia konkretne bezpieczne działanie;
- komunikacja jest pełna szacunku;
- rozmowa kończy się zrozumiałym podsumowaniem/podziękowaniem;
- nie zaliczać obserwacji wizualnej, jeśli na podstawie audio nie można jej potwierdzić.

WEJŚCIE
- transcript: pełna transkrypcja;
- rss_id: kod pseudonimizowany w postaci RSS 1234;
- methodology_context: wyciągi/zasady zatwierdzonej metodyki;
- optional_checklist: zatwierdzona lokalna lista kontrolna, jeśli istnieje.

ZASADY OCENY
1. Używaj tylko faktów z transcript.
2. Nie zgaduj intencji.
3. Nie odtwarzaj imion i nazwisk na podstawie głosu/kontekstu.
4. Jeśli transkrypt jest ewidentnie niekompletny lub niespójny — quality_status="insufficient_data" i nie wystawiaj końcowej oceny.
5. Jeśli zastosowano lokalną listę kontrolną, oceń wszystkie jej punkty bez pominięć.
6. Dla każdego wniosku zachowaj krótkie evidence — frazę/zawartość z transkrypcji potwierdzającą decyzję.

WYJŚCIE — TYLKO JSON, BEZ MARKDOWN I BEZ TEKSTU PRZED/PO
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 zdań, zrozumiałych dla kierownika",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

PRZED ODPOWIEDZIĄ SPRAWDŹ
- JSON jest poprawny;
- rss_id nie zostało zmienione;
- końcowy punkt zgadza się z sumą kryteriów;
- evidence nie zawiera zmyślonych faktów;
- jeśli danych jest niewystarczająco, nie ma zmyślonego overall_score_percent.
Komentarz: Ponieważ oddzielna zatwierdzona punktowa lista kontrolna BSD nie została udokumentowana w dostarczonych materiałach, nie przedstawiam wymyślonej skali jako normy korporacyjnej. W wersji roboczej należy podstawić waszą rzeczywistą listę kontrolną.
Prompt 5. Oddzielny moduł informacji zwrotnej w Telegram
Jeśli w scenariuszu wykorzystywane jest drugie wywołanie modelu, korzystne jest ograniczenie go tylko do formatowania gotowej oceny. Zwiększa to stabilność: drugi moduł nie powinien od nowa „reinterpretować” punktacji.
Otrzymujesz GOTOWY JSON oceny eksperckiej BSD z poprzedniego kroku.
Nie oceniaj nagrania ponownie i nie zmieniaj punktacji.

Utwórz krótką odpowiedź dla użytkownika w Telegram.

FORMAT
RSS: <kod>
Ocena: <procent lub „nie oceniono — brak wystarczających danych”>

Co zrobiono dobrze:
• 2–4 krótkie punkty ze strengths

Co należy poprawić:
• 2–4 konkretne punkty z improvements

Na następny BSD:
<1–2 maksymalnie konkretne działania>

ZASADY
- maksymalnie 700–1200 znaków;
- rzeczowy i pełen szacunku ton;
- bez technicznego JSON;
- bez nazwisk;
- nie wymyślać nowych uwag;
- nie używać motywacyjnych haseł;
- jeśli quality_status=insufficient_data — poprosić o ponowne nagranie/przesłanie pliku audio i nie wyświetlać oceny.
Prompt 6. Normalizacja wyniku przed Google Sheets
Ten krok jest przydatny, jeśli Google Sheets ma otrzymywać identyczną strukturę niezależnie od długości tekstu oceny.
Sprawdź wiersz danych przed zapisem w Google Sheets.

Oczekiwane pola:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

ZASADY
1. Nie dodawaj imienia, nazwiska ani numeru ewidencyjnego.
2. rss_id musi pasować do wzorca: RSS + spacja + 3–6 cyfr.
3. overall_score_percent musi być liczbą 0–100 lub puste przy insufficient_data.
4. Tablice przekształć w krótkie ciągi znaków oddzielone „; ”.
5. Jeśli brakuje wymaganego pola — zwróć error=true i wymień missing_fields.
6. Jeśli wszystko jest poprawne — error=false.

WYNIK TYLKO JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Audyt gotowego scenariusza Make na podstawie zrzutu ekranu
Sprawdza się jako finałowy Prompt do weryfikacji scenariusza przed masowym pilotażem.
Prześlę ci zrzut ekranu mojego scenariusza Make.
Przeprowadź audyt techniczny jako mentor ds. automatyzacji no-code.

Sprawdź na podstawie zrzutu ekranu i mojego opisu:
1. kolejność modułów;
2. trasy Router;
3. obsługę nieobsługiwanej wiadomości;
4. przechowywanie stanu tymczasowego w Data store;
5. pobieranie i przekazywanie pliku audio;
6. wywołanie AI;
7. parsowanie JSON;
8. zapis w Google Sheets;
9. wysyłanie wyniku w Telegram;
10. gałąź błędu i ponownej próby;
11. ryzyko duplikatów przy ponownym uruchomieniu;
12. ryzyko, że jeden użytkownik otrzyma wynik drugiego.

Nie proponuj całkowitej przebudowy, jeśli obecna architektura działa.
Najpierw wymień:
- co już jest dobre;
- 3 najbardziej krytyczne ryzyka;
- jaki JEDEN następny krok należy wykonać w pierwszej kolejności.
Po tym zatrzymaj się i czekaj na mój zrzut ekranu/potwierdzenie.
Praktyczna sekwencja dla czytelnika
- Wgrać zatwierdzoną metodykę i listę kontrolną do wybranego Project/agenta.
- Skonfigurować Prompt 1 i sprawdzić go na kilku wzorcowych nagraniach.
- To samo nagranie przepuścić kilka razy i zastosować Prompt 2 do oceny odtwarzalności.
- Jeśli wymagana jest automatyzacja — zacząć od Prompt 3 i budować Make po jednym module z weryfikacją zrzutów ekranu.
- W Make użyć Prompt 4 jako rdzenia eksperckiego i wymagać ścisłego JSON.
- W razie potrzeby oddzielić informację zwrotną dla użytkownika w Prompt 5.
- Przed zapisem w Google Sheets znormalizować dane za pomocą Prompt 6.
- Przed masowym uruchomieniem sprawdzić cały schemat za pomocą Prompt 7.
Komentarze 8
Dziękuję Alexander Bondarenko za artykuł, jest nad czym pomyśleć. AI to obecnie bardzo modny i ciekawy temat. Koledzy wykonali świetną pracę.
Proponowane rozwiązanie pomaga zmniejszyć chroniczne przeciążenie działu bezpieczeństwa i higieny pracy oraz bezpieczeństwa przemysłowego i uwolnić co najmniej jednego pracownika od rutyny. Moim zdaniem kluczową korzyścią jest to, że system działa jak „cyfrowy symulator”.
Jednak, rozważając wszystkie „za” i „przeciw”, nie radziłbym skalować oceny AI pięciominutowych spotkań BHP, a tym bardziej behawioralnych dialogów bezpieczeństwa.
Tym samym ocena AI:
Proszę nie spieszyć się z szukaniem „drugiego eksperta” w AI, jeśli są problemy z pierwszym.
Ivan, dziękuję za merytoryczną informację zwrotną.
Zgadzam się z ryzykiem „teatru przed mikrofonem”: jeśli sztuczna inteligencja zostanie przekształcona po prostu w narzędzie kontroli dla samej oceny, przyniesie to niewiele korzyści.
Ale być może w artykule nie ujawniłem w pełni naszej dalszej drogi. Kwietniowa ocena za pomocą dyktafonu była dla nas przede wszystkim cyfrowym symulatorem.
Sztuczna inteligencja nie tylko wystawiała ocenę, ale przekazywała informację zwrotną: co zrobiono dobrze, co należy poprawić, jak najlepiej angażować pracowników i komunikować o ryzykach.
Tak, można było się przygotować i przeprowadzić pokazową pięciominutówkę. Ale na tym etapie przekonaliśmy się o najważniejszym: nasi kierownicy wiedzą i potrafią przeprowadzać ją prawidłowo!
Dzisiaj idziemy już dalej. Pięciominutówki są oceniane systematycznie na podstawie nagrań z kamer stacjonarnych w miejscach wydawania pozwoleń na pracę, a tam, gdzie nie ma kamer, stosuje się rejestratory „Revizor”. To już nie jest specjalnie przygotowane nagranie, ale zwykła codzienna praca (towarzyszy jej również indywidualna informacja zwrotna z rekomendacjami).
Dlatego sztuczna inteligencja dla nas to nie zastępstwo dla kierownika ani „cyfrowy nadzorca”, ale stałe narzędzie do uczenia się i udzielania informacji zwrotnej. Jest to szczególnie ważne dla specjalistów silnych pod względem technicznym, dla których nie zawsze jest łatwo rozmawiać z ludźmi zwięźle, zrozumiale i przekonująco.
W przypadku dialogów behawioralnych wszystko jest rzeczywiście bardziej skomplikowane i tutaj nadal szukamy optymalnego modelu. Ale zasada pozostaje ta sama: sztuczna inteligencja nie powinna zastępować rozmowy na żywo — powinna pomagać kierownikowi w lepszym jej przeprowadzeniu.
A głównym kryterium dla nas nie jest ocena algorytmu, ale zmiana rzeczywistego zachowania ludzi!
Aby zapewnić jego zgodność ze społeczno-psychologicznymi podstawami kultury bezpieczeństwa, trener AI (podobnie jak wiele innych cyfrowych narzędzi kontroli) musi zostać odłączony od wskaźników KPI premii dla kierowników. Najlepszą i najwyraźniej jedyną skuteczną opcją jego wykorzystania jest poufne narzędzie samorozwoju, o którym Pan mówi.
Z mojego doświadczenia wynika, że krytycznie ważne jest stworzenie odpowiedniej motywacji:
Panie Ivanie, dziękuję za ciepłe słowa i merytoryczną dyskusję.
Całkowicie się zgadzam: trwałej kultury bezpieczeństwa nie da się zbudować „pod przymusem”, zwłaszcza jeśli chodzi o zachowanie i osobiste zaangażowanie kierowników.
My właśnie staramy się pracować więcej poprzez uznanie i pozytywną motywację. Na przykład co miesiąc, na podstawie wyników oceny cyfrowej, wybieramy sześć najlepszych pięciominutówek bezpieczeństwa, analizujemy w osobnym filmie wideo, co dokładnie zostało zrobione dobrze, a mistrzów nagradzamy dyplomami honorowymi z rąk dyrektora generalnego na Centralnym Komitecie ds. Bezpieczeństwa i Higieny Pracy — osobiście przed dużą publicznością (300) kierowników i specjalistów.
Przy 1300 kierownikach, specjalistach i pracownikach biurowych to już dość poważna konkurencja i, co ważne, publiczne uznanie dobrej praktyki.
Obecnie zaczynamy rozszerzać to podejście również na organizacje podwykonawcze.
Dziękuję Panu za wymianę opinii.
Ja również uważnie śledzę Pana publikacje i praktyki kolegów.
W ostatecznym rozrachunku wszyscy robimy jedną wspólną sprawę — szukamy działających sposobów na rozwijanie kultury bezpieczeństwa i czynienie jej naprawdę żywą, a nie formalną!!!
Interesujące narzędzie.
Mam pytanie dotyczące poufności: na ile bezpieczne dla firmy są informacje, które są ładowane do bota? Teraz wielu z tego korzysta, ale są wątpliwości, czy otwarte wykorzystanie AI bez chmurowych usług lokalnych niezbyt koreluje z kwestią wycieku danych..
Jak na ten projekt zareagowała służba bezpieczeństwa, prawnicy? Czy jednak w jakiś sposób chronią Państwo swoje dane, ładowane do bota Telegram? (być może nie do końca dobrze zrozumiałam mechanizm lub gdzieś przeoczyłam ten moment).
Pani Irino, dziękuję, pytanie jest absolutnie trafione!
W początkowej wersji z Make celowo zminimalizowaliśmy dane osobowe: imiona i nazwiska, numery pracowników, stanowiska i inne identyfikatory nie trafiają do chmury — tylko indywidualny losowy kod i nagranie audio. Jednocześnie należy zrozumieć: sam głos również należy do danych osobowych, więc takie podejście nie rozwiązuje całkowicie kwestii poufności. Na filmie dołączonym do artykułu może Pani zobaczyć, jak dokładnie ten schemat został zbudowany.
Równolegle nasz zespół ds. bezpieczeństwa i higieny pracy oraz bezpieczeństwa przemysłowego opracował drugą opcję — już całkowicie wewnątrz obwodu korporacyjnego na naszej wewnętrznej sztucznej inteligencji Fire. Po centralnym komitecie ds. bezpieczeństwa i higieny pracy, który odbył się dwa dni temu, zdecydowaliśmy się pójść właśnie w tym kierunku.
Teraz Fire już pobiera ścieżkę dźwiękową z nagrań z kamer stacjonarnych lub wideorejestratorów, transkrybuje pięciominutowe spotkanie, przeprowadza ocenę według określonych kryteriów, generuje informację zwrotną i przesyła wyniki do pulpitu nawigacyjnego. Przy wielokrotnym przetwarzaniu tego samego nagrania otrzymujemy stabilną ocenę według tych samych zasad.
Co więcej, celem nie jest tu «wystawienie oceny» kierownikowi. Mamy około 1300 inżynierów i pracowników technicznych, a system pozwala nam dostrzec właśnie systematyczność: czy dana osoba potrafi nie tylko raz pięknie poprowadzić pokazowe pięciominutowe spotkanie, ale czy rzeczywiście robi to z wysoką jakością na każdej zmianie. Tam, gdzie to konieczne — aby doszkolić, gdzieś poprawić komunikację z ludźmi, gdzieś zobaczyć utrwaloną dobrą praktykę.
Zgodnie z tą samą zasadą, od 1 października uruchomiono drugi obwód wewnętrzny do oceny behawioralnych dialogów bezpieczeństwa.
Dlatego całkowicie słusznie poruszyła Pani temat wycieku danych: w przypadku chmurowej sztucznej inteligencji jest to rzeczywisty problem.
Zaczęliśmy od maksymalnej anonimizacji, a teraz przechodzimy do przetwarzania wewnątrz chronionego obwodu korporacyjnego.
dziękuję za tak szczegółową odpowiedź. Teraz wszystko jest jasne. Wzięłam pod uwagę Pana doświadczenie