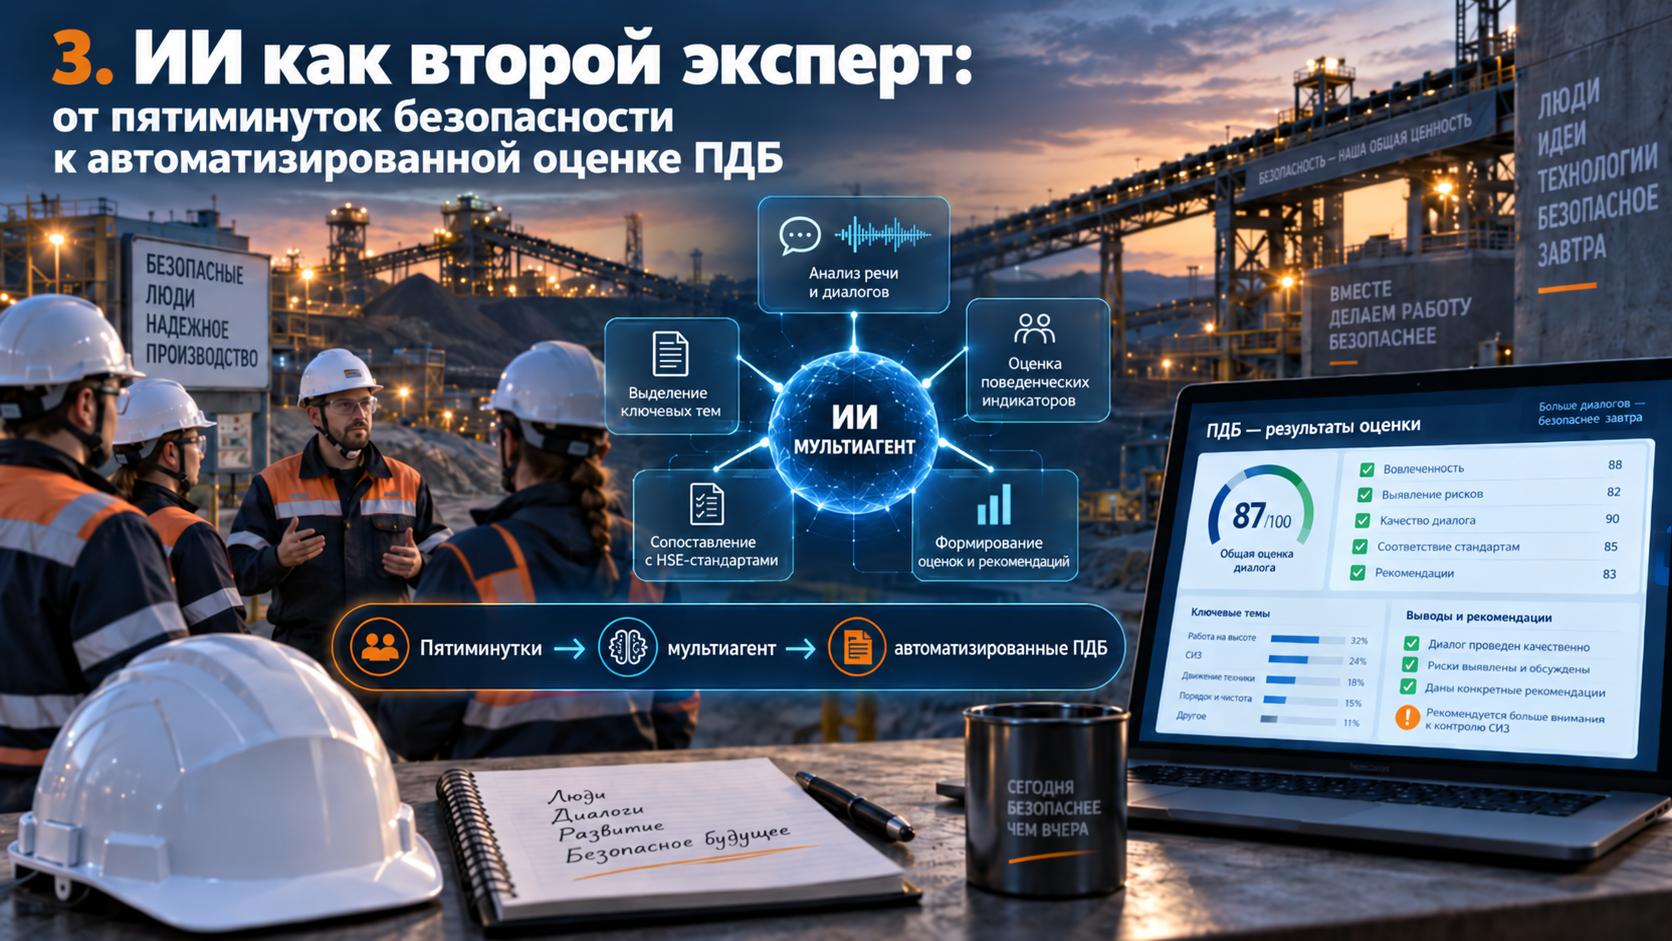
IA como segundo especialista: dos diálogos de segurança à avaliação automatizada de BSD
Diálogos de segurança → avaliação digital → Make → diálogos comportamentais de segurança automatizados
Ideia principal: A IA não substitui o gestor ou o especialista de segurança. Ela torna-se um "segundo especialista" unificado, que aplica exatamente os mesmos critérios, fornece feedback pessoal e permite escalar o controlo de qualidade para centenas e milhares de conversas reais.
Por que começámos a avaliar a conversa em vez do facto de ter sido realizada
Em saúde e segurança ocupacional e segurança industrial, é fácil contabilizar um facto: um diálogo de segurança foi realizado, um diálogo comportamental de segurança foi registado, um cartão foi preenchido. É muito mais difícil responder à questão de qual foi a qualidade com que o gestor conduziu a própria conversa e se ele atingiu o seu objetivo.
Um diálogo de segurança na nossa metodologia é uma parte obrigatória da reunião de troca de turno com a duração de 5–10 minutos. O gestor deve abordar um tópico atual específico e construir uma ligação clara: perigo → consequências → medidas de segurança. Neste caso, não é apenas o monólogo do encarregado que é importante, mas também o diálogo com os trabalhadores: perguntas, respostas e envolvimento na discussão.
Por isso, a tarefa inicial não era "verificar a existência da gravação", mas sim de outra forma: será que podemos ensinar a IA a avaliar de forma idêntica a qualidade real destas conversas e a dar ao gestor um feedback substantivo?
Etapa 1. Primeiro a metodologia, depois a inteligência artificial
Na primavera de 2026, começámos pelos diálogos de segurança. Antes de lançar a avaliação por IA, foram preparadas recomendações metodológicas e um vídeo de formação sobre como conduzir corretamente um diálogo de segurança. Só depois disso é que o avaliador digital surgiu.
Como primeiro ambiente de trabalho, utilizámos o Perplexity Space — hoje um ambiente semelhante no Perplexity chama-se Project. O manual metodológico e a checklist de avaliação foram carregados para o projeto, e um Prompt rigoroso foi preparado separadamente para o modelo.
A tarefa do Prompt era fundamentalmente diferente de um pedido normal para "avaliar o discurso". A IA só estava autorizada a contabilizar o que realmente foi dito no áudio. Se um elemento estiver ausente — 0 pontos. Se for mencionado formalmente — conclusão parcial. Se for exposto de forma lógica e completa — concluído.
Na checklist atual existem sete critérios: apresentação e objetivo; perigo específico; lógica "perigo – consequências – medidas de segurança"; impulso emocional; medidas de segurança; diálogo com os trabalhadores; resumo final e ligação com os trabalhos executados.
Prompt 1 — veja a versão modernizada do Prompt para o Perplexity Project no anexo.
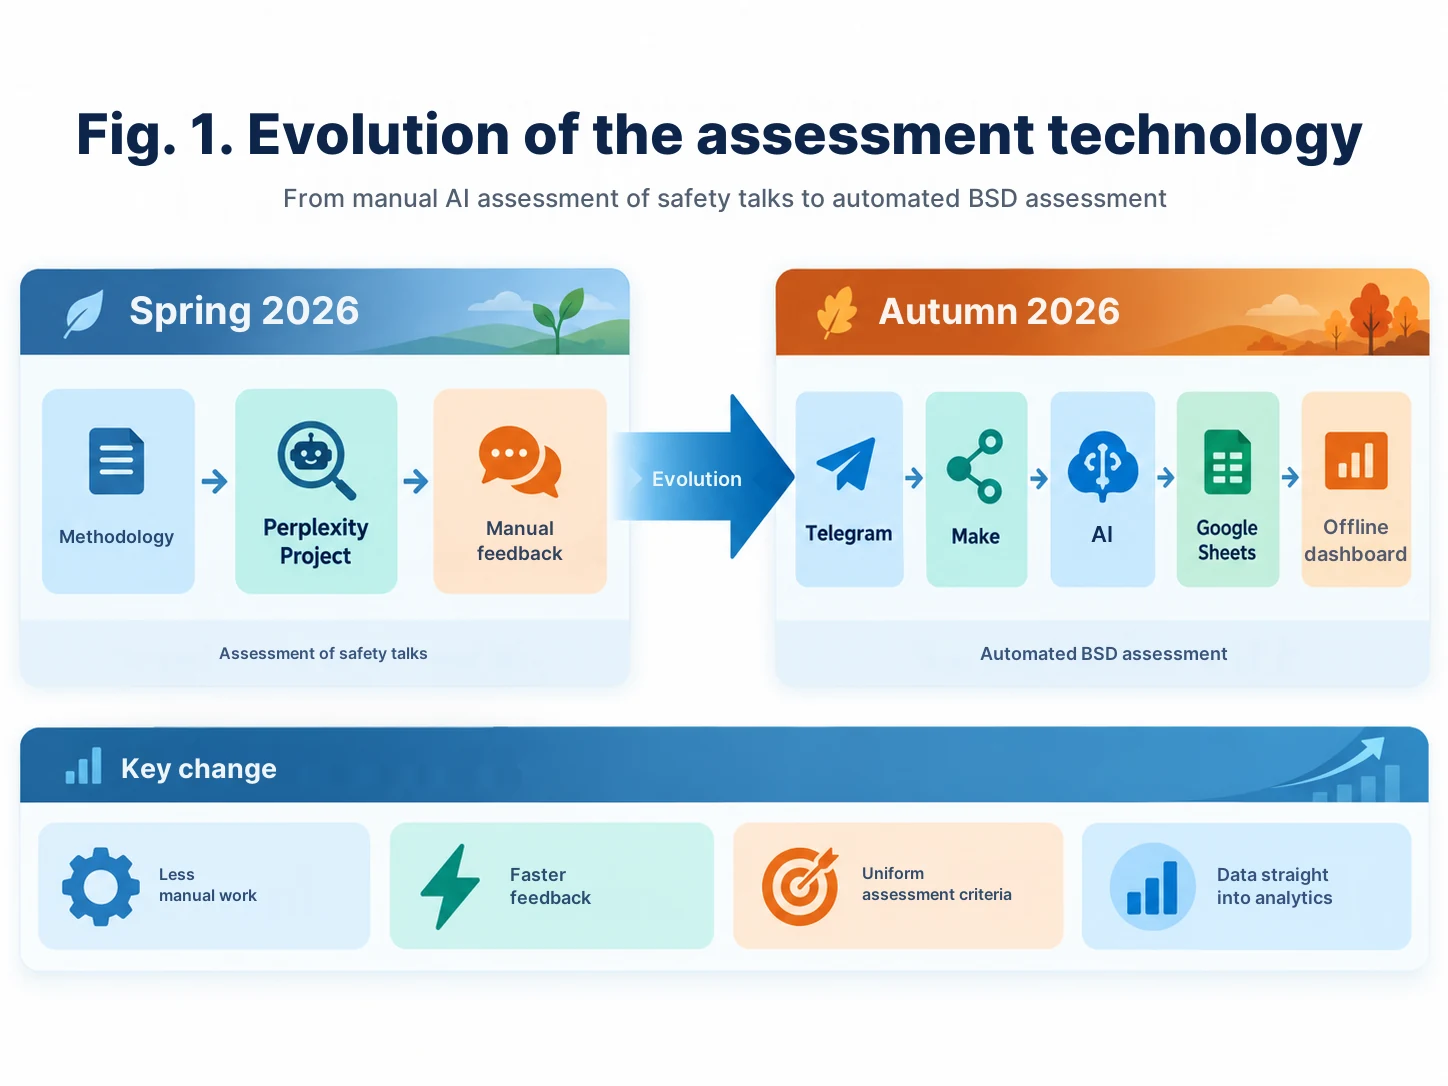
Como era o primeiro circuito, ainda manual
O supervisor de turno gravava o diálogo de segurança realizado num gravador de voz. Através da aplicação corporativa Collab, a gravação era transmitida a um funcionário designado. O funcionário carregava o áudio no Perplexity Project, recebia a avaliação e devolvia o feedback pessoal ao gestor também através do Collab.
Simultaneamente, o resultado era inserido no Excel: departamento, gestor, avaliação, número de tentativas. A partir da tabela, construíamos análises simples — resultados médios dos departamentos, dinâmica e número de ciclos repetidos.
Considerámos 80 % como o nível de aprovação para o ciclo prático. Se o resultado fosse inferior, o gestor conduzia o próximo diálogo de segurança já tendo em conta as observações da IA. O resultado era não apenas controlo, mas também um treino individual diretamente no local de trabalho.
Avaliávamos não apenas a pessoa — primeiro testávamos a própria IA
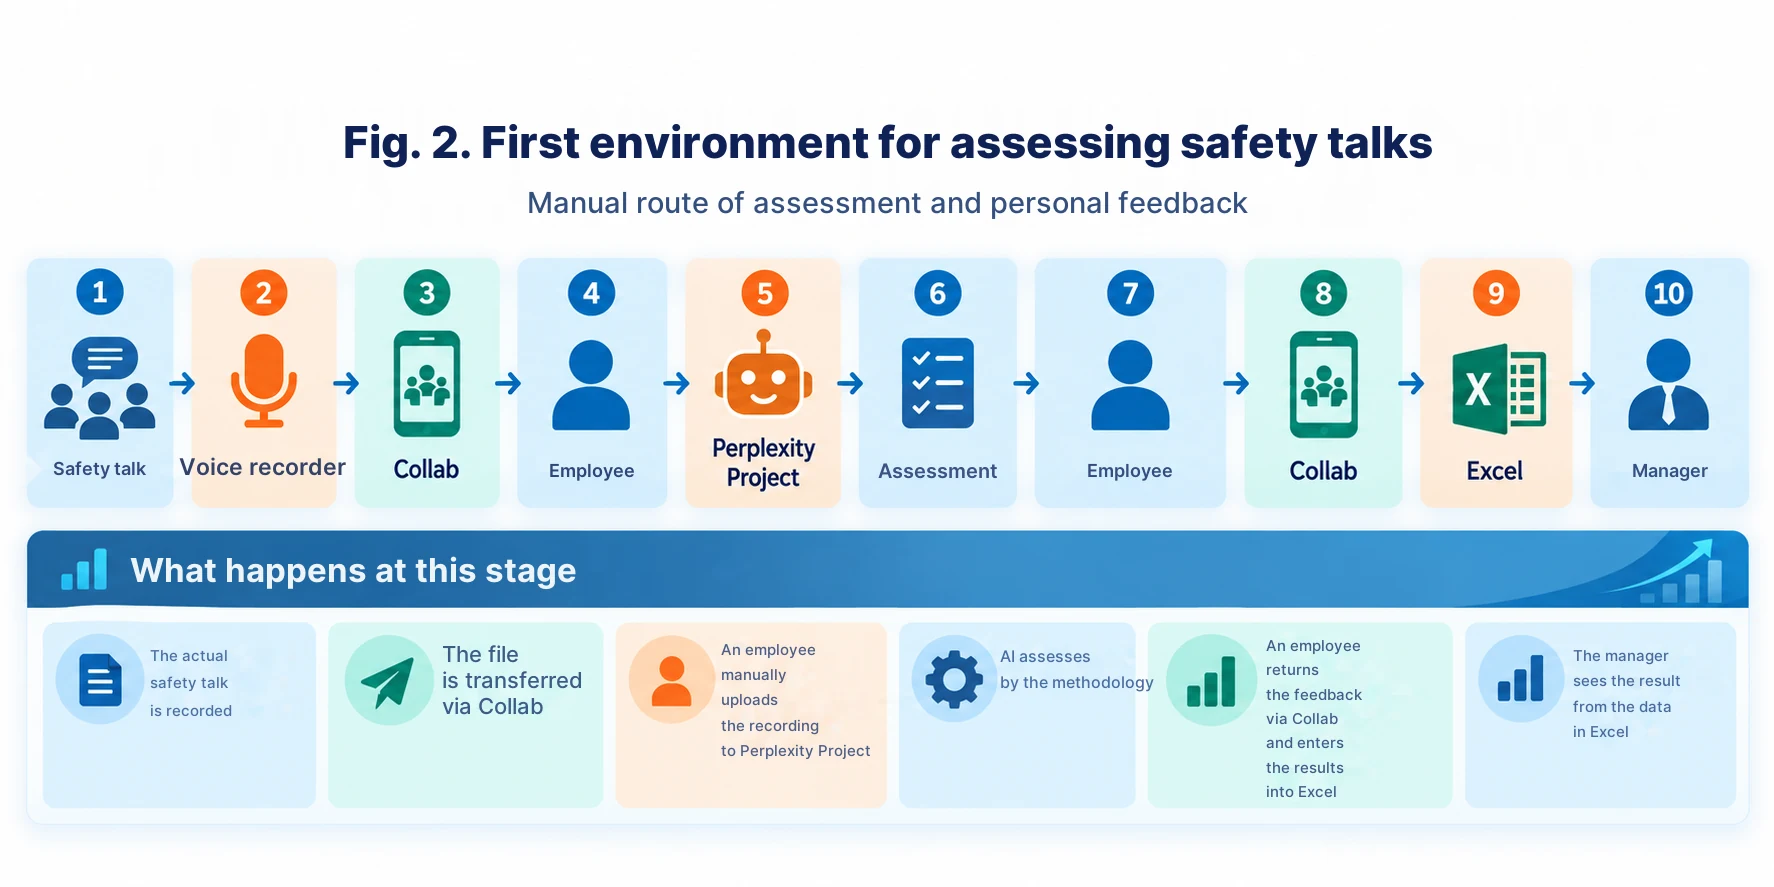
Para mim, este é um dos elementos mais importantes de todo o esquema. Enviávamos propositadamente a mesma gravação de áudio para avaliação várias vezes. Se o mesmo material recebe 82 % hoje, 65 % um minuto depois e, de seguida, 91 %, esse especialista digital ainda não está pronto para avaliar as pessoas.
Por isso, procurámos a reprodutibilidade: a mesma gravação deve gerar uma avaliação igual ou praticamente igual. Se a variação se tornasse visível, corrigíamos o Prompt, precisávamos os critérios e removíamos as formulações ambíguas.
Pessoalmente, chamo a isto "objetividade digital". Isto não significa que a IA possua a verdade absoluta. A questão é outra: um especialista unificado aplica a mesma escala a todos e não depende do humor, de simpatias pessoais ou de quem exatamente realiza a verificação hoje.
Prompt 2 — veja o protocolo de verificação da reprodutibilidade da avaliação no anexo.
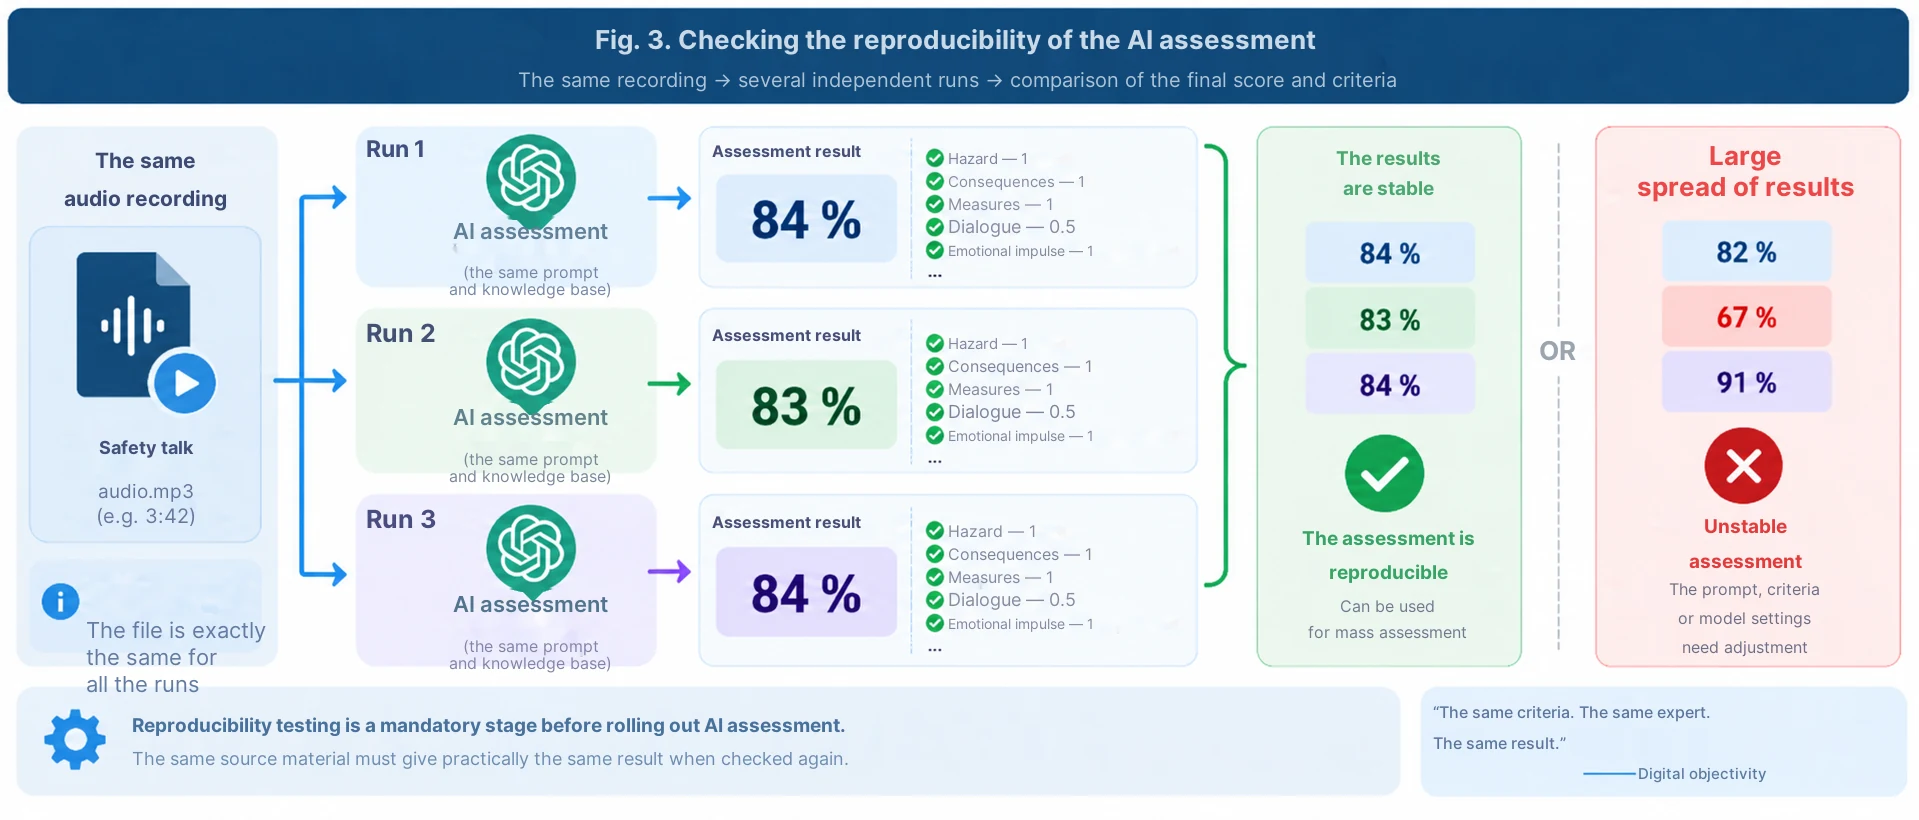
Porque o esquema manual deixou de nos satisfazer
Para o projeto-piloto, a rota manual era conveniente: receber o ficheiro, carregar, aguardar o resultado, devolver o feedback e inserir a pontuação no Excel. Mas esta abordagem tem um limite natural.
Quando o volume já se mede em centenas e milhares de gravações, começamos a automatizar não a avaliação, mas a criar um novo trabalho administrativo à volta da avaliação. Por isso, na transição para os diálogos comportamentais de segurança (BSD), a tarefa foi formulada de outra forma: retirar a pessoa da cadeia técnica onde a sua participação não cria valor.
Etapa 2. O diálogo comportamental é mais complexo do que o diálogo de segurança normal
Um diálogo comportamental de segurança (BSD) não é apenas um breve discurso. A metodologia inclui a observação do trabalho real e uma conversa com a pessoa. É importante para o gestor ver o comportamento seguro ou perigoso e, em seguida, através de perguntas, fazer com que o próprio trabalhador identifique o perigo, as possíveis consequências e o método seguro de realizar o trabalho.
Se o trabalhador estiver a trabalhar de forma perigosa, a parte principal da conversa é discutir os perigos e as consequências, em seguida, o método seguro de trabalho e outras fontes de perigo. Se a pessoa estiver a trabalhar em segurança, o gestor deve notar e reforçar o comportamento correto, e depois utilizar a conversa para debater outras questões de segurança.
É por isso que o circuito de avaliação do BSD não deve apenas verificar as palavras do gestor, mas também a existência de um verdadeiro diálogo: se foram feitas perguntas, se o trabalhador respondeu, se foram discutidas as causas do comportamento, as consequências, as ações seguras e a conclusão da conversa.
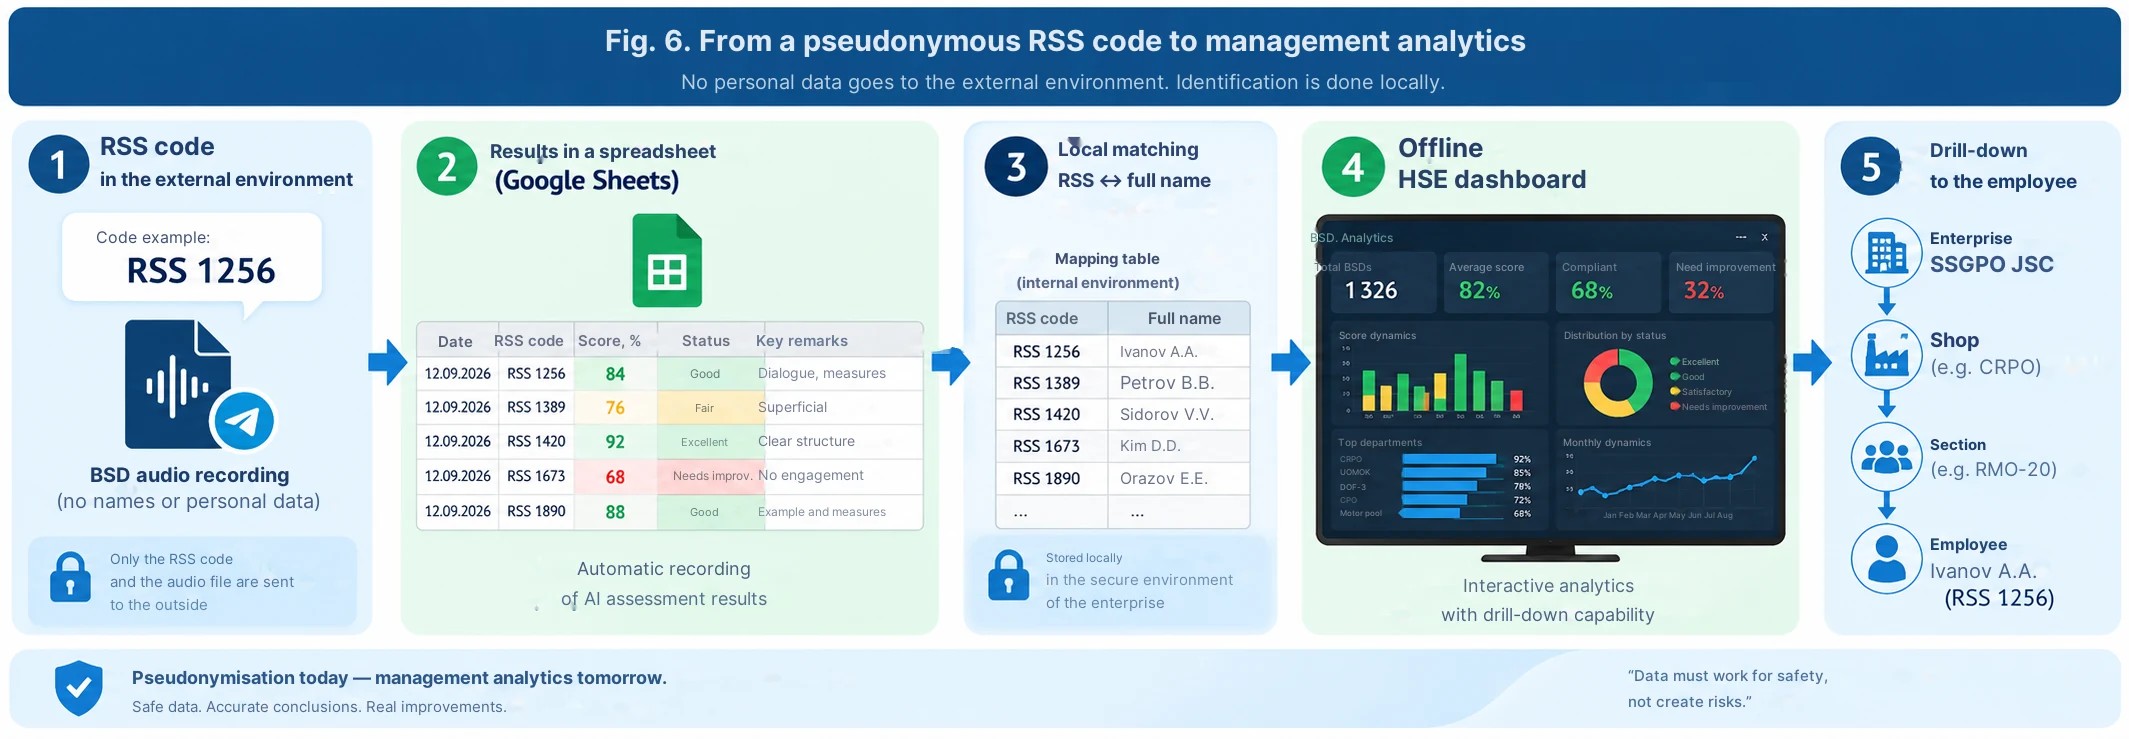
Identificador pseudónimo em vez do apelido
Na automatização em massa, resolvemos separadamente a questão da identificação. Dentro do circuito corporativo ERGIS, a cada participante é atribuído um código especial do tipo RSS 1256. Isto não é um número de funcionário e não é um apelido.
Antes de iniciar a gravação, o gestor pronuncia o seu código RSS, após o qual realiza o BSD. Na conversa, não há necessidade de mencionar apelidos ou números de funcionário. A correspondência "código RSS ↔ funcionário específico" permanece dentro do circuito corporativo e é utilizada posteriormente na análise local.
Aqui, é mais correto falar não de uma anonimização total, mas de uma pseudonimização: no ficheiro de áudio, a voz da pessoa permanece de qualquer forma. Mas o volume de dados pessoais que passa pelo circuito automatizado é substancialmente reduzido.
Pequeno segredo: eu não sou programador
A arquitetura da nova solução foi montada através do Make. Eu não sou programador e, no início do trabalho, escrevi isso diretamente ao ChatGPT.
O pedido foi simples: "Guia-me passo a passo na criação desta automatização. Vamos dar um passo de cada vez. Eu vou executá-lo no Make e enviar uma captura de ecrã. Após a verificação, dá-me o comando seguinte".
A partir daí, foi exatamente isso que aconteceu. O ChatGPT explicou que módulo criar e o que preencher nele; eu executei a ação e enviei a captura de ecrã; após a verificação, obtive o passo seguinte. Da mesma forma, foi criado o bot do Telegram e toda a cadeia foi interligada.
Esta é uma conclusão importante para mim da prática de vibe coding: o especialista não precisa de saber antecipadamente a sintaxe de uma API ou do Make. Mas tem a obrigação de compreender bem o processo de produção, o resultado que o utilizador deve obter, e saber testar sequencialmente cada etapa.
Prompt 3 — veja o Prompt inicial "guia-me passo a passo pelo Make" no anexo.
O que acontece agora: Telegram → Make → IA → resultado
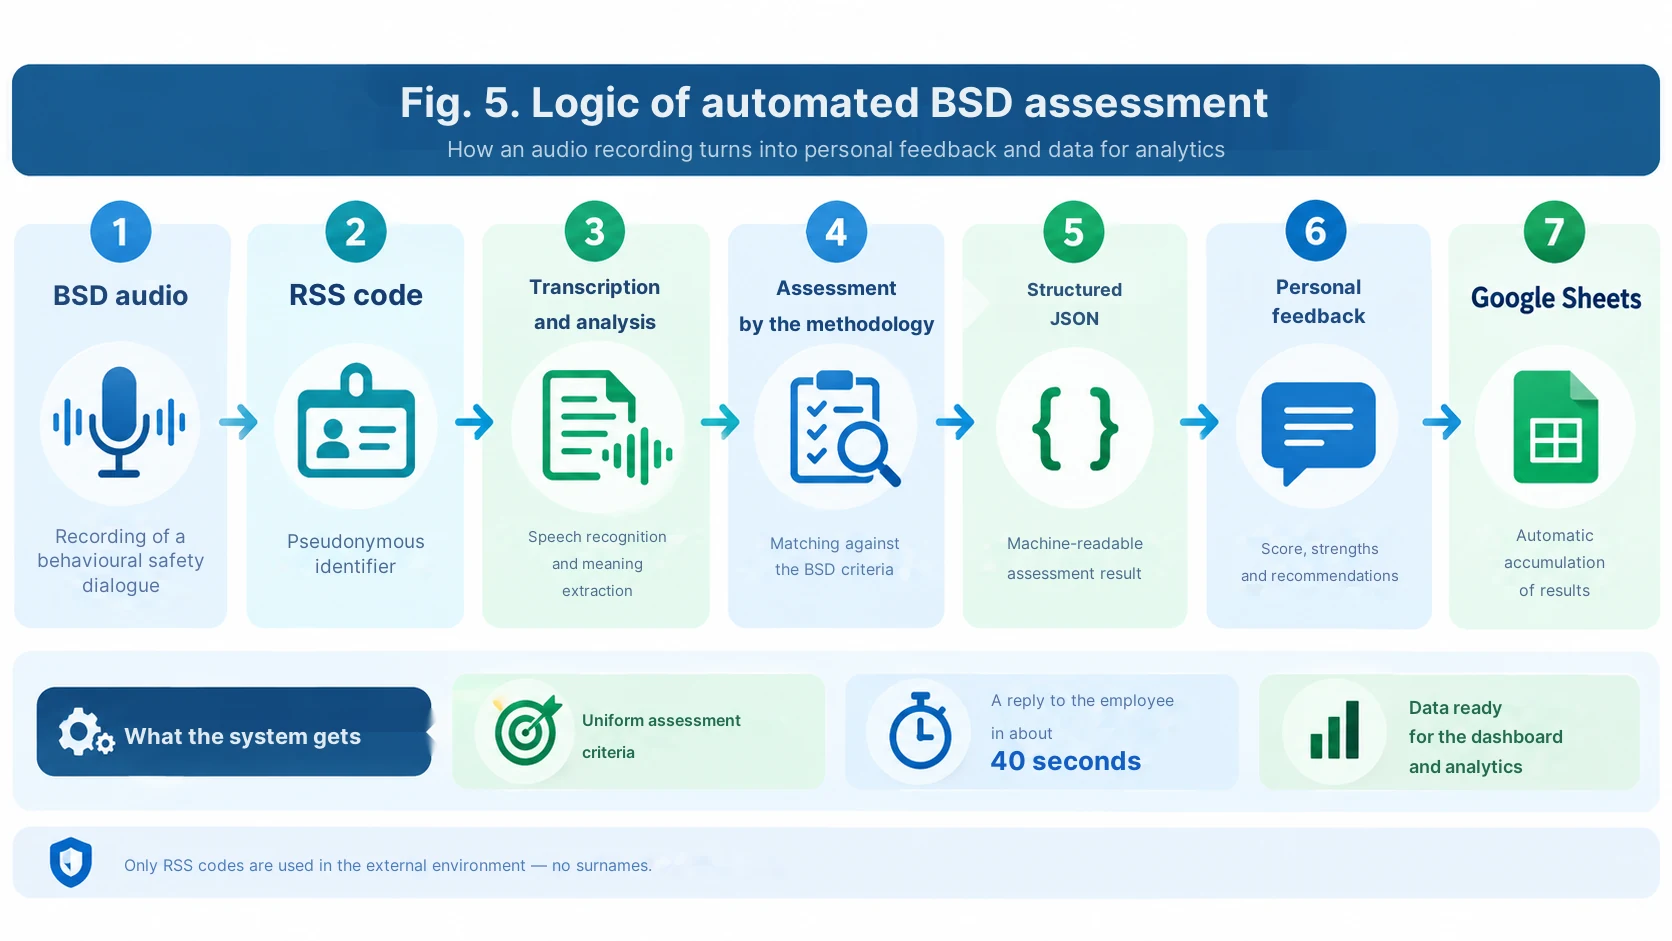
O circuito moderno funciona quase sem um operador manual. O gestor envia a gravação de áudio para o bot do Telegram. O Make recebe o ficheiro, verifica os dados de entrada e inicia a rota de processamento. A IA analisa a gravação de acordo com a metodologia especificada, gera uma avaliação e o feedback. O resultado regressa ao utilizador e é, em simultâneo, gravado no Google Sheets para análise geral.
No projeto-piloto atual, o feedback é devolvido em algumas dezenas de segundos. Para o utilizador, isto parece simples: enviou o áudio — recebeu a avaliação, os pontos fortes, os erros específicos e o que mudar na próxima vez.
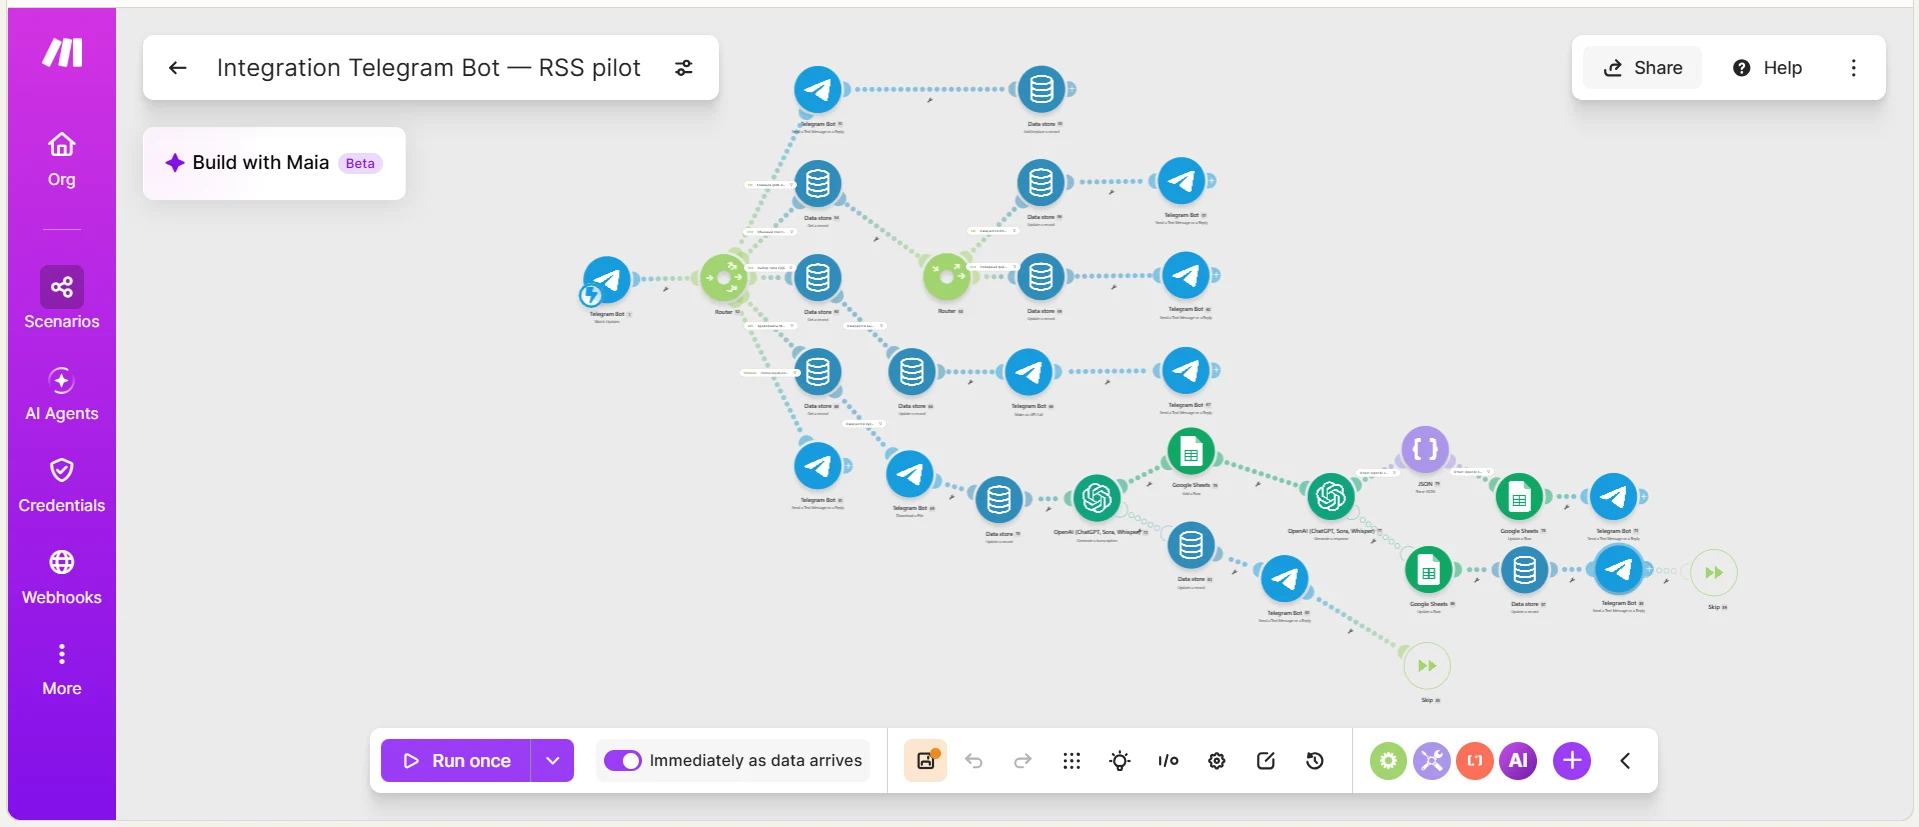
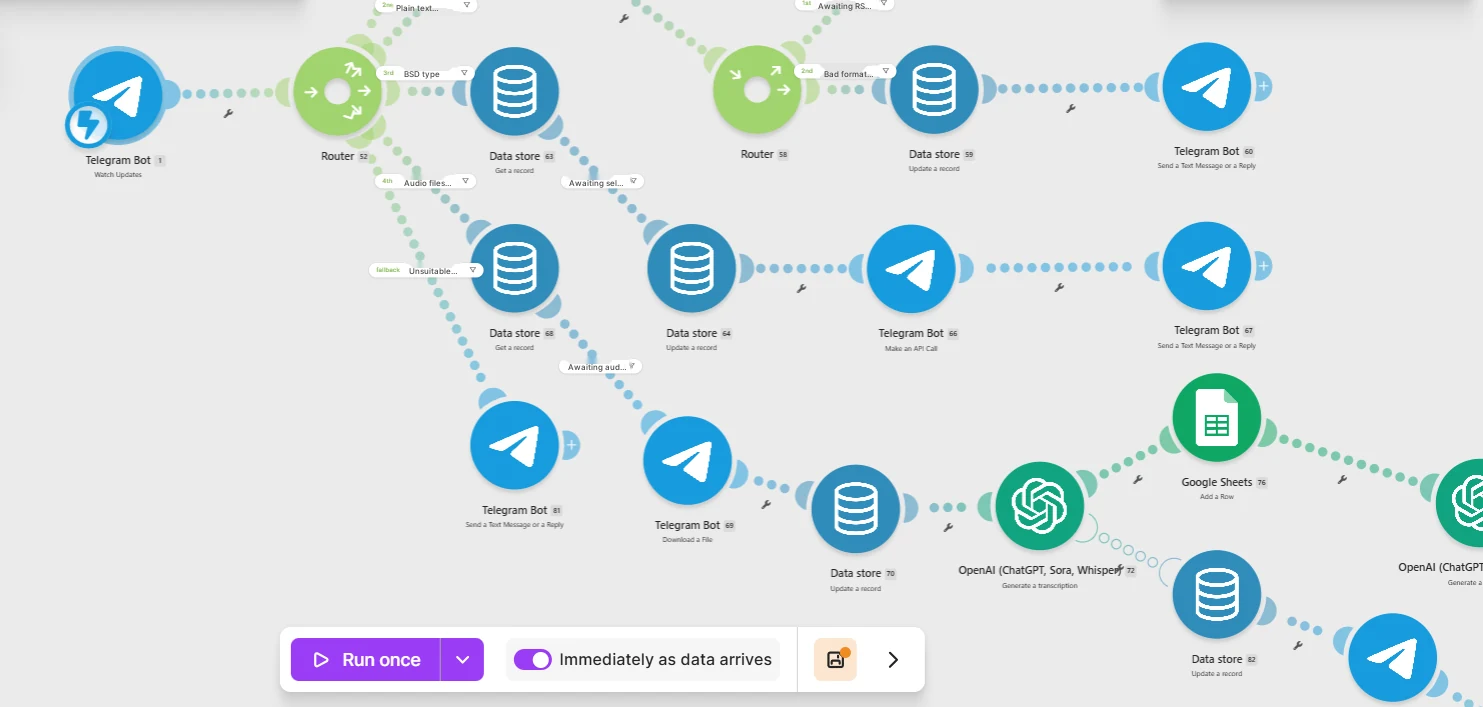
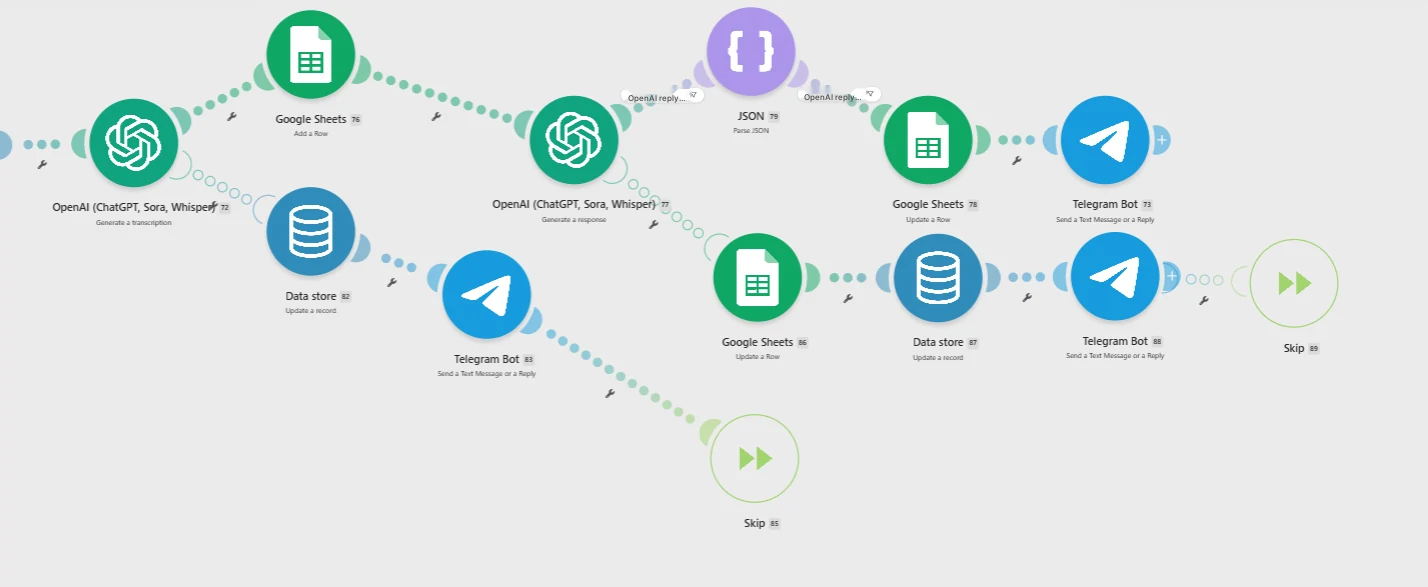
No esquema do Make, pode ver-se que por trás desta simplicidade esconde-se um roteamento completo: Telegram, Data store, Router, OpenAI, Google Sheets, verificações e mensagens de retorno ao utilizador.
É um multiagente ou não?
Eu não usaria aqui a palavra «multiagente» apenas por efeito. Na prática, temos um circuito especializado de várias etapas, no qual diferentes partes do cenário executam diferentes funções: recepção e roteamento do arquivo, extração do identificador, análise de conteúdo, avaliação especializada, formação do resultado estruturado, registro na planilha e feedback pessoal.
Se várias chamadas de modelo separadas trabalharem com diferentes funções de sistema — por exemplo, uma analisa o diálogo, a segunda controla a conformidade com a metodologia e formata o resultado, — isto já pode ser considerado como uma lógica de multiagente ou de vários agentes. Se uma única chamada de modelo executar todas as funções, é mais honesto falar de um avaliador de IA multifuncional.
Por isso, no apêndice, eu dividi os prompts por funções, em vez de chamar cada função de um agente separado.
Como funciona a avaliação automatizada do BSD
No cenário industrial, é importante separar duas tarefas. A primeira — a especializada: avaliar o conteúdo da conversa estritamente em relação à metodologia. A segunda — a técnica: retornar o resultado no formato que o Make entenda e consiga registrar no Google Sheets.
Por isso, para a automação, uma resposta JSON estruturada é conveniente: código RSS, pontuação final, status, pontos fortes, áreas de melhoria, um feedback curto e critérios de avaliação separados. Tal formato reduz o risco de que a automação «quebre» por causa de um texto bonito, mas imprevisível, do modelo.
Ao mesmo tempo, a regra rígida permanece a mesma que na primavera: não contabilizar o que não está na gravação; não adivinhar intenções; não preencher a resposta correta pelo gestor. Se a transcrição estiver incompleta — a gravação deve ir para um novo upload, e não receber uma avaliação inventada.
Prompts 4–6 — avaliação do BSD, JSON estruturado e formação de feedback, veja no apêndice.
Da avaliação pessoal ao panorama por departamentos
Após cada avaliação, acumula-se no Google Sheets não apenas um feedback em texto, mas um conjunto estruturado de dados. Por isso, é possível ver o número de BSD realizados, o resultado médio, os principais erros repetidos, a dinâmica e os resultados por códigos RSS pseudonimizados.
O próximo passo já nos é familiar a partir do segundo artigo: correlacionar localmente o código RSS com o nome completo no ambiente corporativo e carregar o resultado num dashboard autônomo de HSE. Assim, o gestor vê o panorama por empresa, departamento e setor e, se necessário, aprofunda-se até o trabalhador específico.
Ou seja, o circuito de avaliação externo pode funcionar sem o sobrenome, e o panorama gerencial completo só é restaurado dentro da empresa.
Como essa ideia pode ser replicada sem a nossa arquitetura
O sentido da abordagem não está atrelado a uma única marca de IA. Na variante mais simples, é possível criar um Perplexity Project com a metodologia e um prompt de avaliação. Pode-se usar o ChatGPT com uma instrução constante e uma base de conhecimento carregada. Pode-se construir um esquema em torno do Google NotebookLM / Gemini Notebook como fonte de materiais metodológicos, e realizar a avaliação com um modelo separado. Para um fluxo em massa, é mais conveniente usar o Make ou outra plataforma de automação com o Telegram, OpenAI e planilhas.
Os elementos-chave permanecem os mesmos: metodologia aprovada → prompt rígido → verificação de reprodutibilidade → escala compreensível → feedback pessoal → acúmulo estruturado do resultado.
O que mudou em alguns meses
Na primavera, um funcionário transferia manualmente os arquivos de áudio para a IA e retornava o resultado. Hoje, nós construímos um circuito que é capaz de receber e avaliar cerca de 1300 gravações de BSD sem um operador separado para cada arquivo.
Mas a principal mudança nem é na velocidade. Nós ganhamos a capacidade de aplicar os mesmos critérios a um grande número de conversas reais e transformar cada avaliação em um curto ciclo de aprendizado individual.
A IA nesse esquema — não é um inspetor que procura um culpado. Ela é simultaneamente um segundo especialista e um coach digital: registra a não conformidade com a metodologia, explica o que exatamente precisa ser melhorado e permite verificar isso já na próxima conversa.
Conclusão
Quando começamos, a tarefa soava como um experimento: a IA conseguirá avaliar um diálogo de segurança. Como resultado, surgiu uma tecnologia que pode ser escalada para diálogos comportamentais, treinamentos e outros tipos de comunicações de segurança.
Para mim, o resultado mais valioso — não é um número automático. O valor está no fato de que o gestor recebe o feedback quase imediatamente após uma conversa real, e a empresa simultaneamente recebe um conjunto de dados sobre quais elementos da metodologia são realmente difíceis para as pessoas.
É exatamente nesse ponto que a IA passa a atuar não no lugar do sistema de gestão de segurança, mas dentro dele — como um segundo especialista uniforme.
Prompts para o artigo «IA como um segundo especialista»
Diálogos de segurança, verificação de reprodutibilidade, Make e avaliação automatizada do BSD
Esta é a versão de publicação dos prompts. Ela é baseada na metodologia real e na nossa arquitetura de trabalho, mas, antes de aplicá-la em outra empresa, os critérios e limites precisam ser substituídos pelos requisitos locais aprovados.
Prompt 1. Avaliação modernizada do diálogo de segurança no Perplexity Project
Esta é uma versão de publicação melhorada do prompt atual. Eu corrigi contradições internas: o checklist agora contém de fato 7 critérios, e o limite de aprovação é o mesmo em todo lugar — 80%.
Você atua como um especialista em saúde ocupacional e segurança industrial, realizando uma avaliação de controle da qualidade da condução do diálogo de segurança pelo supervisor de turno.

FONTES E PRIORIDADE
1. Gravação de áudio do diálogo de segurança.
2. Manual metodológico aprovado pela empresa.
3. Checklist de avaliação aprovado.
Em caso de conflito de formulações, oriente-se pelo checklist aprovado e pela metodologia. Não adicione critérios próprios.

ETAPA 1. TRANSCRIÇÃO COMPLETA
- Primeiro obtenha a transcrição completa do áudio, e não um breve summary.
- Para o Perplexity Project, utilize a ferramenta disponível de leitura do arquivo de áudio anexado no modo completo (READ / context budget máximo disponível).
- Marque os trechos ininteligíveis como [ininteligível].
- Se menos de 80% da fala for reconhecida de forma coerente ou se faltar uma parte substancial da gravação, responda apenas: «Dados insuficientes. Recarregue o arquivo.» e pare.
- Não inclua a transcrição completa no relatório final.

ETAPA 2. AVALIAÇÃO ESPECIALIZADA
Avalie apenas o que foi realmente dito na transcrição completa.
É proibido:
- inventar as intenções do encarregado;
- contabilizar o que não está na gravação;
- melhorar as formulações pelo avaliado;
- compensar a falta de um elemento com uma boa impressão geral.

ESCALA PARA CADA CRITÉRIO
Cumprido = 1 ponto.
Parcialmente = 0,5 ponto.
Não cumprido = 0 pontos.
Regra:
- ausente no áudio → 0;
- mencionado formalmente, sem desenvolvimento → 0,5;
- desenvolvido de forma lógica e correta → 1.

CHECKLIST — AVALIE TODOS OS 7 PONTOS SEM OMISSÕES
1. Apresentação pessoal e objetivo do diálogo de segurança.
2. Nomeação do perigo específico / tema atual.
3. Lógica «perigo → consequências → medidas de segurança».
4. Impulso emocional através de consequências reais/potenciais ou um exemplo adequado.
5. Medidas de segurança específicas.
6. Diálogo com os trabalhadores: perguntas, respostas, envolvimento.
7. Resumo final e ligação com os trabalhos em curso / futuros.

FORMATO DE RESPOSTA
1. Tabela:
Nº | Critério | O que foi de fato dito | Avaliação | Ponto

2. Resultado:
Obtido: X de 7.
Porcentagem: (X/7)*100, arredondar para 1 casa decimal.

3. Status do ciclo:
- se o resultado for >=80%: «Nível de aprovação atingido»;
- se o resultado for <80%: «Nível de aprovação não atingido. Recomenda-se um novo diálogo de segurança após a análise do feedback».

4. Pontos fortes — 2–5 pontos específicos, apenas da gravação.
5. Áreas de melhoria — especificamente para os critérios não cumpridos/parcialmente cumpridos.
6. Feedback ao encarregado — 3–5 frases: estilo profissional, exigente e voltado para o desenvolvimento.

CONTROLE ANTES DA RESPOSTA
Antes da resposta final, verifique mais uma vez se:
- a soma dos pontos coincide com a tabela;
- a porcentagem está calculada corretamente;
- nenhum dos 7 critérios foi omitido;
- nenhuma afirmação é baseada em algo que não estava no áudio.
Comentário: Da versão original foi mantido o princípio fundamental: primeiro a transcrição completa, depois a avaliação apenas sobre o que foi de fato dito. No Perplexity o nome específico da ferramenta de leitura de arquivos pode mudar, por isso na versão pública é melhor descrever a função em vez de vincular rigidamente o leitor ao nome search_files_v2.
Prompt 2. Verificação de reprodutibilidade («objetividade digital»)
Este Prompt é utilizado após várias execuções independentes de uma mesma gravação.
Estou realizando a validação da reprodutibilidade do avaliador de IA.

Tenho os resultados de N avaliações independentes DA MESMA gravação de áudio usando o mesmo checklist.
Vou fornecer as tabelas finais/JSON de cada execução.

Sua tarefa:
1. Comparar a porcentagem final entre as execuções.
2. Comparar a pontuação de cada critério.
3. Destacar os critérios nos quais o modelo muda de decisão com mais frequência.
4. Calcular:
   - a porcentagem final mínima;
   - a porcentagem final máxima;
   - a amplitude em pontos percentuais;
   - a porcentagem final média.
5. Não reavaliar a gravação original e não escolher a avaliação «correta» — analisar apenas a estabilidade do avaliador.

CRITÉRIO PARA O PILOTO
- diferença de 0–2 p.p. — alta reprodutibilidade;
- 2,1–5 p.p. — aceitável, mas verificar critérios controversos;
- mais de 5 p.p. — Prompt/critérios precisam de ajustes.

Forneça a saída no formato:
- Nível de reprodutibilidade;
- Onde ocorre a variação;
- O que exatamente no Prompt precisa ser tornado mais inequívoco;
- Se o teste precisa ser repetido após o ajuste.

Não chame isso de objetividade absoluta. Use o termo «reprodutibilidade da avaliação».
Comentário: O limite de variação no exemplo é uma diretriz de trabalho para publicação, e não uma norma corporativa aprovada. Ele pode ser removido ou substituído pelo seu próprio.
Prompt 3. ChatGPT como mentor passo a passo no Make
Este é o próprio princípio que permite a uma pessoa sem habilidades de programação replicar a solução.
Não sou programador e nunca construí cenários no Make antes.
Ajude-me a criar uma automação com o princípio de «uma ação de cada vez».

OBJETIVO
O bot do Telegram recebe a gravação de áudio do diálogo comportamental de segurança. Em seguida, o Make deve:
1. receber o arquivo;
2. verificar o tipo de entrada;
3. extrair/obter o áudio;
4. transferir o material para a IA para análise;
5. receber um resultado rigorosamente estruturado;
6. gravar o resultado no Google Sheets;
7. enviar ao usuário um feedback pessoal curto;
8. tratar adequadamente os erros, arquivos duplicados e formato não suportado.

REGRAS DO NOSSO TRABALHO
- Dê apenas UM próximo passo por mensagem.
- Escreva o nome exato do módulo do Make que precisa ser adicionado.
- Escreva o que selecionar em cada campo obrigatório.
- Se for necessária uma variável do módulo anterior — indique sua origem exata.
- Após cada passo, pare e peça-me para enviar uma captura de tela.
- Pela minha captura de tela, primeiro verifique se tudo foi feito corretamente. Se houver um erro — nós o corrigimos e só então prosseguimos.
- Não pule etapas e não envie todo o cenário de uma vez.
- Explique em palavras simples, sem presumir que eu conheça API, JSON ou programação.
- Se houver várias maneiras, escolha a mais simples e confiável para o piloto e explique brevemente o porquê.

RESTRIÇÕES
- o identificador do usuário no circuito de avaliação é um código pseudonimizado do tipo RSS 1234;
- sobrenomes e números de matrícula não são necessários;
- o resultado para a tabela deve ser estruturado;
- a pessoa no Telegram recebe apenas um feedback claro, sem JSON técnico.

Comece com o primeiro passo: criação/conexão do bot do Telegram e do primeiro módulo de entrada do Make.
Prompt 4. Núcleo de avaliação do BSD para OpenAI/ChatGPT no Make
Esta é a versão de publicação universal do bloco de avaliação. Ela retorna especificamente um JSON — assim fica mais fácil para o Make registrar o resultado na tabela e encaminhar a resposta.
SYSTEM ROLE
Você é um avaliador especialista na qualidade de diálogos comportamentais de segurança (BSD). Você avalia APENAS o conteúdo da transcrição fornecida e aplica a metodologia aprovada pela empresa.

IMPORTANTE
Se a empresa forneceu um checklist local aprovado separadamente — ele tem prioridade sobre a estrutura de exemplo abaixo.
Não invente critérios que não estão na metodologia.

PRINCÍPIOS BÁSICOS DA METODOLOGIA QUE DEVEM SER VERIFICADOS NO ÁUDIO
- existe uma conversa real com o trabalhador, e não um monólogo/inspeção;
- são feitas perguntas ao trabalhador;
- o próprio trabalhador nomeia/discute o perigo e as possíveis consequências se a situação for perigosa;
- é discutida a maneira segura de realizar o trabalho;
- outras fontes de perigo e medidas de segurança são discutidas;
- no caso de um trabalho seguro, o supervisor destaca e reforça uma ação segura específica;
- a comunicação é respeitosa;
- a conversa termina com uma conclusão/agradecimento claro;
- não contabilize a observação visual se não for possível confirmá-la pelo áudio.

ENTRADA
- transcript: transcrição completa;
- rss_id: identificador pseudonimizado do tipo RSS 1234;
- methodology_context: trechos/regras da metodologia aprovada;
- optional_checklist: checklist local aprovado, se houver.

REGRAS DE AVALIAÇÃO
1. Use apenas os fatos do transcript.
2. Não adivinhe as intenções.
3. Não reconstrua nomes completos pela voz/contexto.
4. Se o transcript estiver claramente incompleto ou incoerente — quality_status="insufficient_data" e não emita a pontuação final.
5. Se um checklist local for aplicado, avalie todos os seus itens sem omissões.
6. Para cada conclusão, guarde um evidence curto — uma frase/conteúdo da transcrição que confirme a decisão.

SAÍDA — APENAS JSON, SEM MARKDOWN E SEM TEXTO ANTES/DEPOIS
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 frases, compreensíveis para o supervisor",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

ANTES DE RESPONDER, VERIFIQUE
- o JSON é válido;
- o rss_id não foi alterado;
- a pontuação final corresponde à soma dos critérios;
- o evidence não contém fatos inventados;
- se os dados forem insuficientes, não há um overall_score_percent inventado.
Comentário: Como um checklist de pontuação separado e aprovado para o Diálogo Comportamental de Segurança (BSD) não está definido nos materiais fornecidos, não apresento uma escala inventada como norma corporativa. Na versão de trabalho, você deve inserir o seu checklist real.
Prompt 5. Módulo separado de feedback no Telegram
Se o cenário usar uma segunda chamada do modelo, é vantajoso limitá-la apenas à formatação da avaliação pronta. Isso aumenta a estabilidade: o segundo módulo não deve "repensar" as pontuações novamente.
Você recebe um JSON PRONTO da avaliação especializada do BSD do passo anterior.
Não reavalie a gravação e não altere as pontuações.

Crie uma resposta curta para o usuário no Telegram.

FORMATO
RSS: <código>
Avaliação: <porcentagem ou «não avaliado — dados insuficientes»>

O que foi bem feito:
• 2–4 pontos curtos extraídos de strengths

O que melhorar:
• 2–4 pontos específicos extraídos de improvements

Para o próximo BSD:
<1–2 ações o mais específicas possível>

REGRAS
- máximo de 700–1200 caracteres;
- tom profissional e respeitoso;
- sem JSON técnico;
- sem sobrenomes;
- não invente novas observações;
- não use slogans motivacionais;
- se quality_status=insufficient_data — peça para regravar/reenviar o áudio e não mostre a avaliação.
Prompt 6. Normalização do resultado antes do Google Sheets
Este passo é útil se o Google Sheets deve receber a mesma estrutura independentemente do comprimento do texto da avaliação.
Verifique a linha de dados antes de gravar no Google Sheets.

Campos esperados:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

REGRAS
1. Não adicione nome completo e número de matrícula.
2. rss_id deve corresponder ao padrão: RSS + espaço + 3–6 dígitos.
3. overall_score_percent deve ser um número de 0–100 ou vazio em caso de insufficient_data.
4. Transforme os arrays em strings curtas separadas por «; ».
5. Se faltar um campo obrigatório — retorne error=true e liste os missing_fields.
6. Se tudo estiver correto — error=false.

SAÍDA APENAS JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Auditoria do cenário pronto do Make por screenshot
É adequado como o Prompt final para verificar o cenário antes de um piloto em massa.
Enviarei um screenshot do meu cenário do Make.
Realize uma auditoria técnica como um mentor de automação no-code.

Verifique pelo screenshot e pela minha descrição:
1. ordem dos módulos;
2. rotas do Router;
3. tratamento de mensagem não suportada;
4. armazenamento de estado temporário no Data store;
5. recebimento e envio do arquivo de áudio;
6. chamada de IA;
7. parsing de JSON;
8. gravação no Google Sheets;
9. envio do resultado para o Telegram;
10. ramificação de erro e nova tentativa;
11. risco de duplicatas na reinicialização;
12. risco de um usuário receber o resultado de outro.

Não proponha uma reestruturação completa se a arquitetura atual estiver funcionando.
Primeiro, liste:
- o que já está bom;
- os 3 riscos mais críticos;
- qual UM próximo passo deve ser feito primeiro.
Depois disso, pare e aguarde meu screenshot/confirmação.
Sequência prática para o leitor
- Carregar a metodologia aprovada e o checklist no Project/agente selecionado.
- Configurar o Prompt 1 e testá-lo em várias gravações de referência.
- Executar a mesma gravação várias vezes e aplicar o Prompt 2 para avaliar a reprodutibilidade.
- Se a automação for necessária — começar com o Prompt 3 e montar o Make módulo por módulo com a verificação de screenshots.
- No Make, usar o Prompt 4 como núcleo especialista e exigir JSON rigoroso.
- Se necessário, separar o feedback do usuário no Prompt 5.
- Antes de gravar no Google Sheets, normalizar os dados com o Prompt 6.
- Antes de um lançamento em massa, verificar todo o esquema com o Prompt 7.
Comentários 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!