ИИ как второй эксперт: от пятиминуток безопасности к автоматизированной оценке ПДБ
Пятиминутки → цифровая оценка → Make → автоматизированные поведенческие диалоги
Главная идея: ИИ не заменяет руководителя или специалиста по безопасности. Он становится единым «вторым экспертом», который применяет одни и те же критерии, даёт персональную обратную связь и позволяет масштабировать контроль качества на сотни и тысячи реальных разговоров.
Почему мы вообще начали оценивать разговор, а не факт проведения
В охране труда легко посчитать факт: проведена пятиминутка, зарегистрирован поведенческий диалог, заполнена карточка. Гораздо сложнее ответить на вопрос, насколько качественно руководитель провёл сам разговор и достиг ли он цели.
Пятиминутка безопасности в нашей методике — обязательная часть сменно-встречного собрания продолжительностью 5–10 минут. Руководитель должен рассмотреть одну конкретную актуальную тему и выстроить понятную связь: опасность → возможные последствия → меры безопасности. При этом важен не только монолог мастера, но и диалог с работниками: вопросы, ответы и вовлечение в обсуждение.
Поэтому исходная задача звучала не «проверить наличие записи», а иначе: можно ли научить ИИ одинаково оценивать реальное качество таких разговоров и давать руководителю предметную обратную связь?
Этап 1. Сначала методика, затем искусственный интеллект
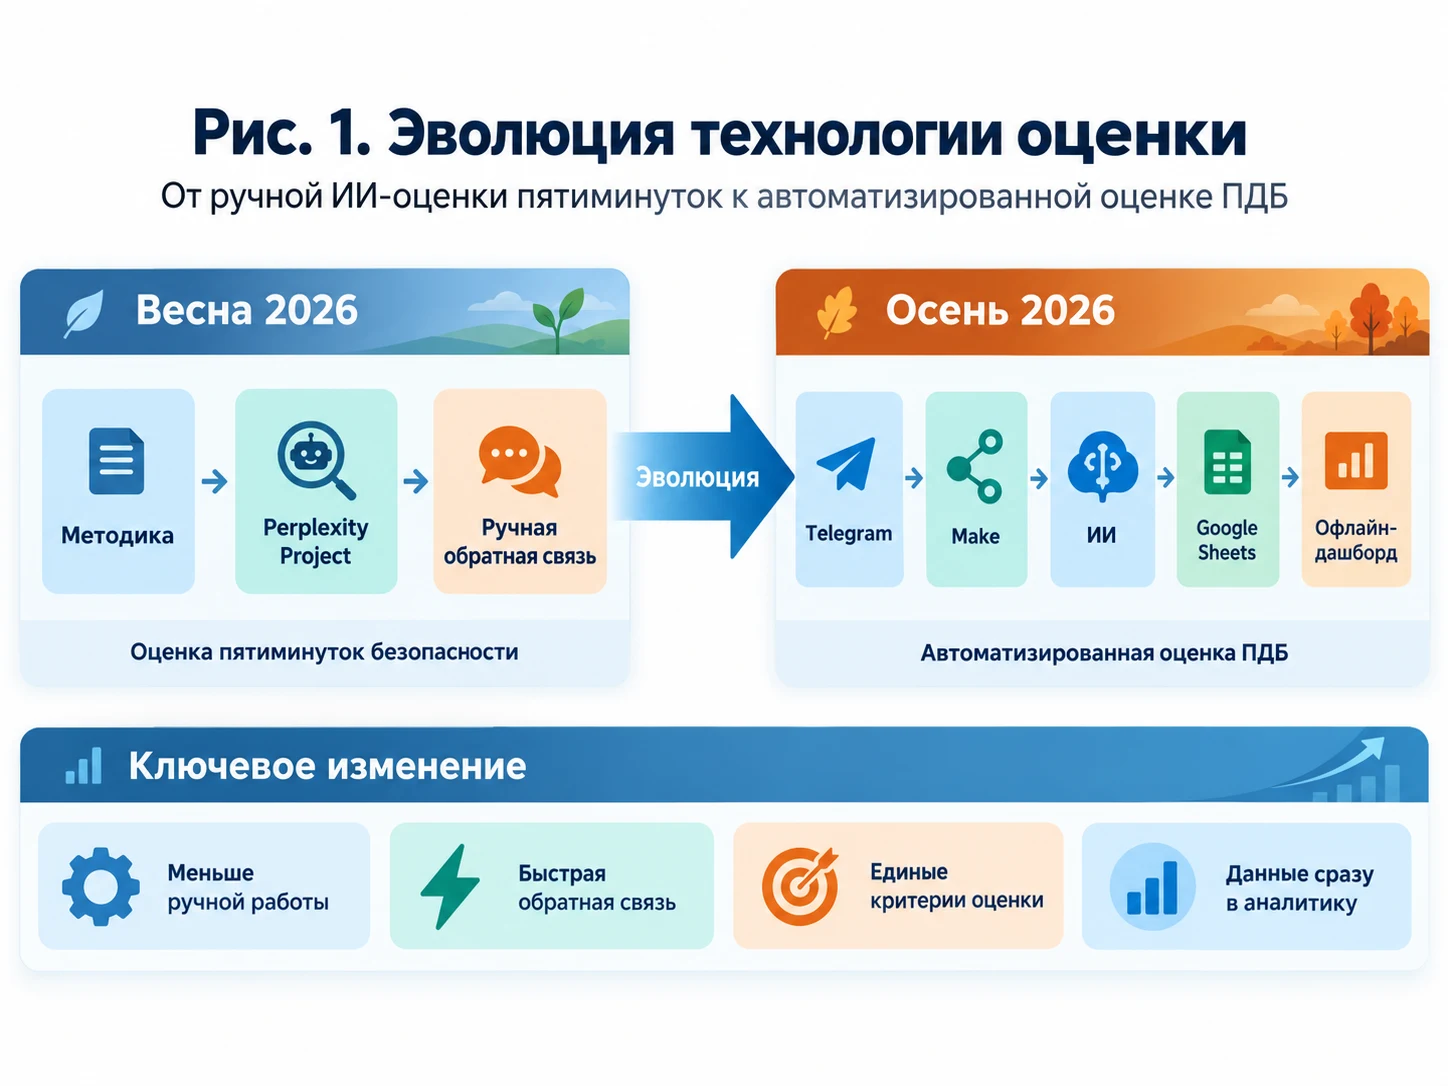
Весной 2026 года мы начали с пятиминуток безопасности. До запуска ИИ-оценки были подготовлены методические рекомендации и обучающий ролик о том, как правильно проводить пятиминутку. Только после этого появился цифровой оценщик.
В качестве первого рабочего контура мы использовали Perplexity Space — сегодня аналогичная среда в Perplexity называется Project. В проект загрузили методическое руководство и чек-лист оценки, а для модели отдельно подготовили жёсткий промпт.
Задача промпта принципиально отличалась от обычного запроса «оцени выступление». ИИ разрешалось засчитывать только то, что реально прозвучало в аудио. Если элемент отсутствует — 0 баллов. Если упомянут формально — частичное выполнение. Если раскрыт логично и полно — выполнено.
В действующем чек-листе семь критериев: представление и цель; конкретная опасность; логика «опасность – последствия – меры»; эмоциональный импульс; меры безопасности; диалог с рабочими; итоговое резюме и связь с выполняемыми работами.
Prompt 1 — модернизированная версия промпта для Perplexity Project см. в приложении.
Как выглядел первый, ещё ручной контур
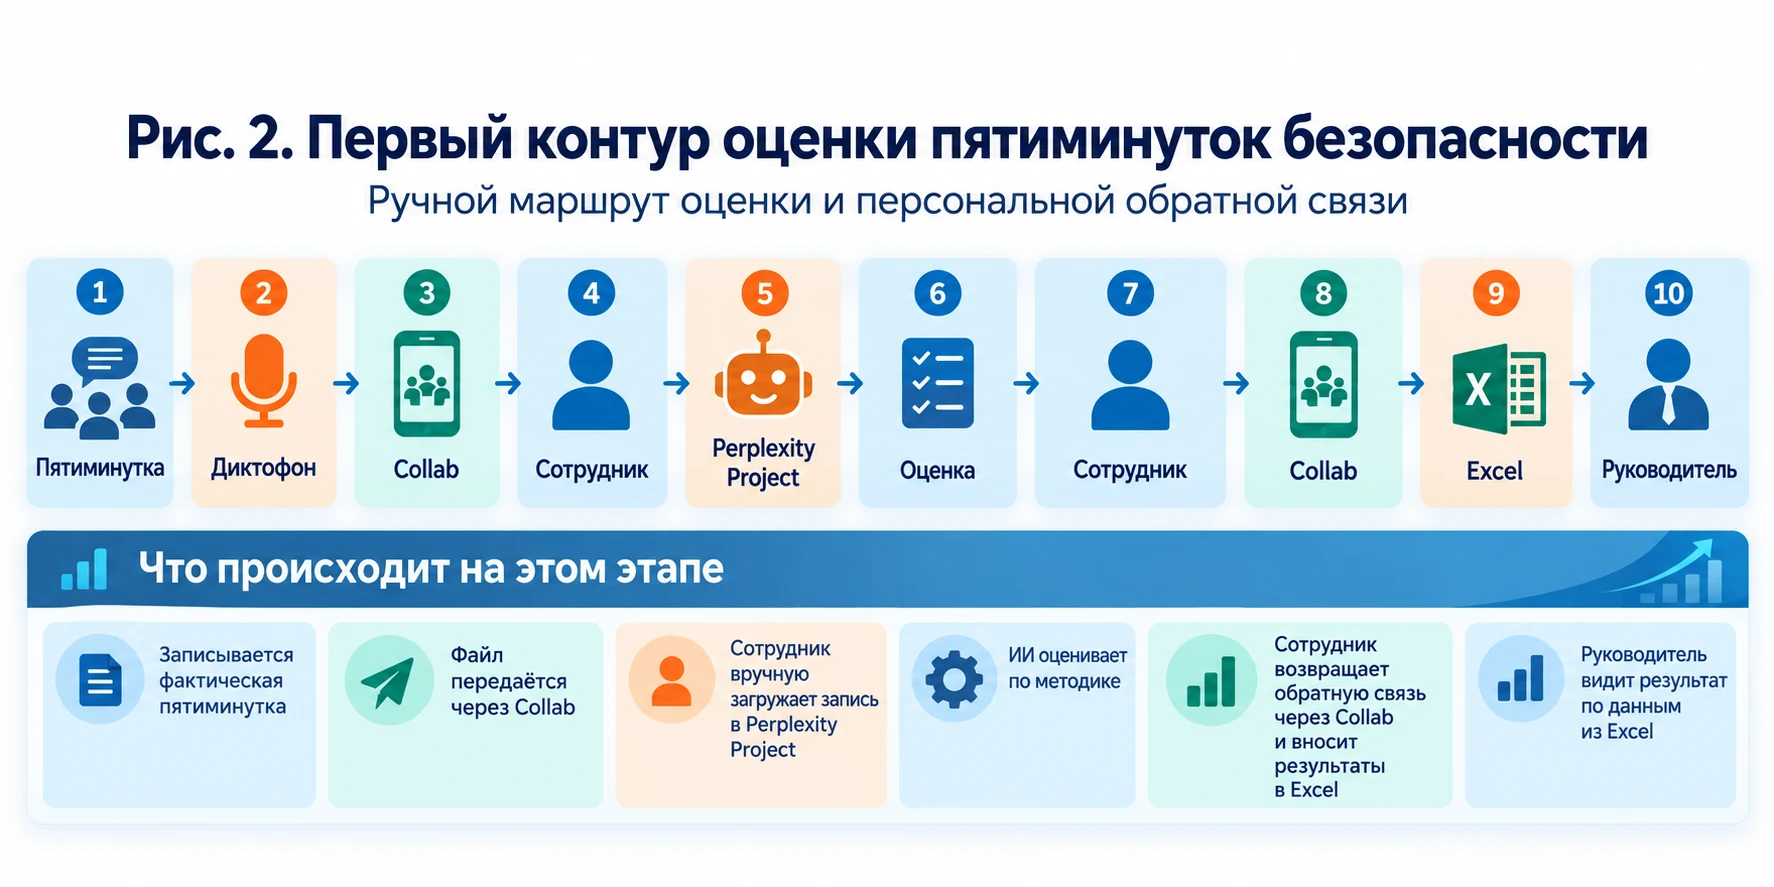
Руководитель смены записывал проведённую пятиминутку на диктофон. Через корпоративное приложение Collab запись передавалась назначенному сотруднику. Сотрудник загружал аудио в Perplexity Project, получал оценку и возвращал персональную обратную связь руководителю также через Collab.
Одновременно результат заносился в Excel: подразделение, руководитель, оценка, количество попыток. По таблице мы строили простую аналитику — средние результаты подразделений, динамику и количество повторных циклов.
Проходным уровнем для практического цикла мы приняли 80 %. Если результат был ниже, руководитель проводил следующую пятиминутку уже с учётом замечаний ИИ. Получался не только контроль, но и индивидуальная тренировка непосредственно на рабочем месте.
Проверяли не только человека — сначала проверяли самого ИИ
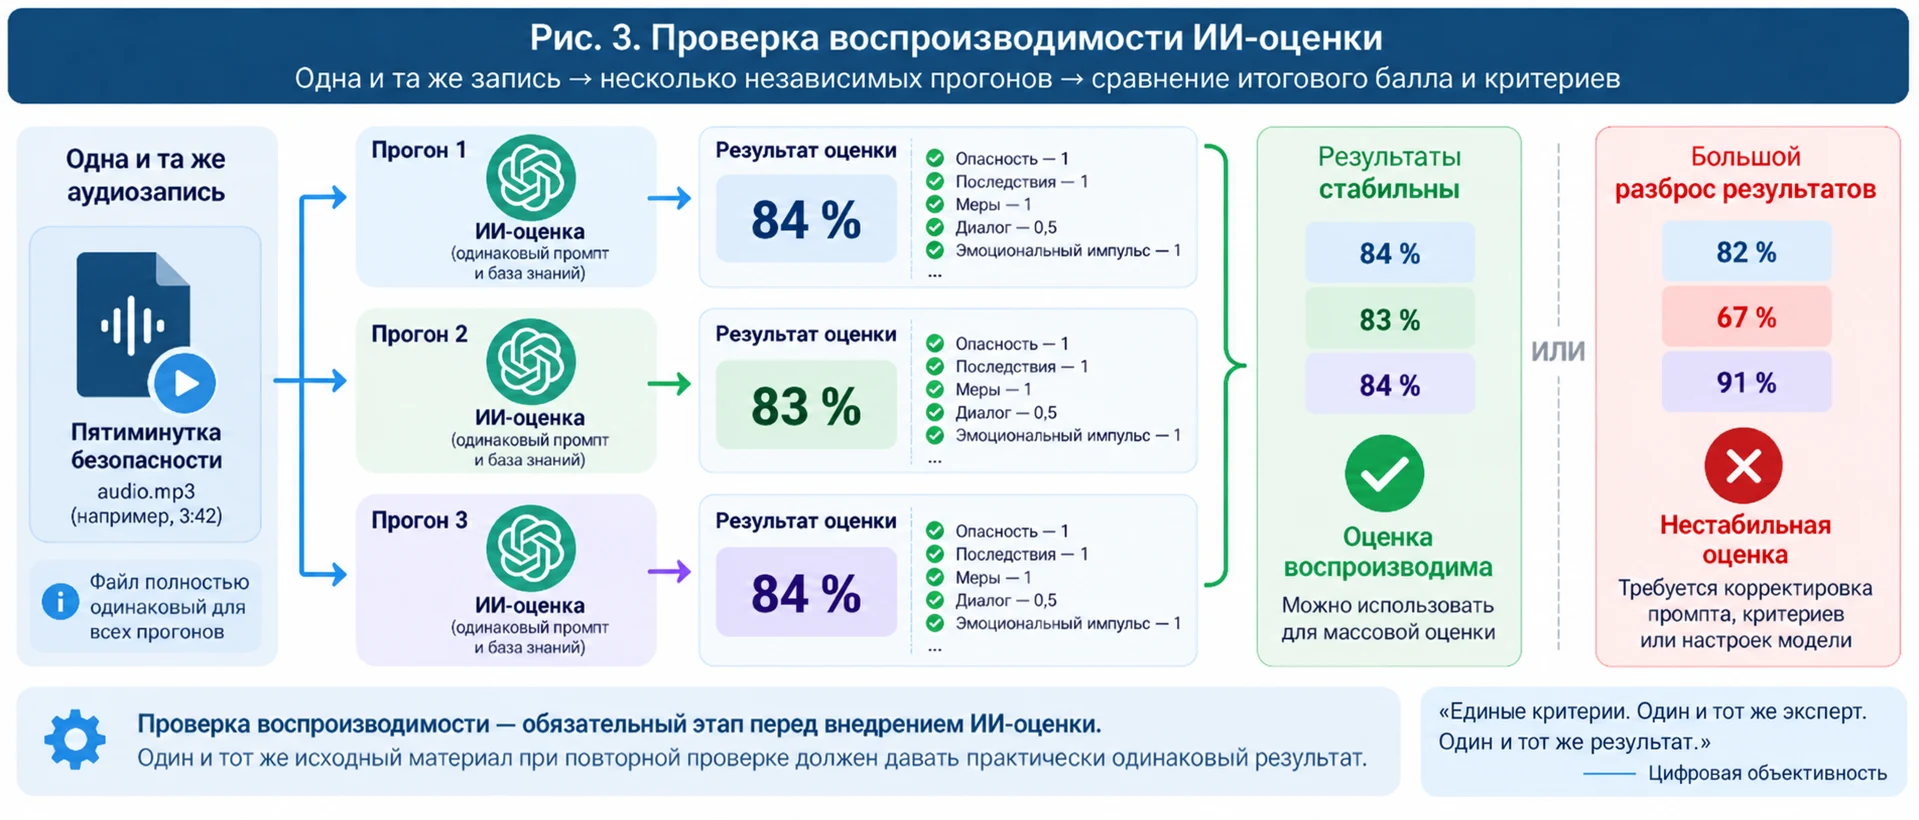
Для меня это один из самых важных элементов всей схемы. Одну и ту же аудиозапись мы специально отправляли на оценку несколько раз. Если один и тот же материал сегодня получает 82 %, через минуту 65 %, а затем 91 %, такой цифровой эксперт ещё не готов оценивать людей.
Поэтому мы добивались воспроизводимости: одинаковая запись должна давать одинаковую или практически одинаковую оценку. Если разброс становился заметным, корректировали промпт, уточняли критерии и убирали двусмысленные формулировки.
Для себя я называю это «цифровой объективностью». Это не означает, что ИИ обладает абсолютной истиной. Речь о другом: единый эксперт применяет одинаковую шкалу ко всем и не зависит от настроения, личных симпатий или того, кто именно сегодня проводит проверку.
Prompt 2 — протокол проверки воспроизводимости оценки см. в приложении.
Почему ручная схема перестала устраивать
Для пилота ручной маршрут был удобен: получить файл, загрузить, дождаться результата, вернуть обратную связь и занести балл в Excel. Но у такого подхода есть естественный предел.
Когда объём измеряется уже сотнями и тысячами записей, мы начинаем автоматизировать не оценку, а создавать новую административную работу вокруг оценки. Поэтому при переходе к поведенческим диалогам безопасности задача была сформулирована иначе: убрать человека из технической цепочки там, где его участие не создаёт ценности.
Этап 2. Поведенческий диалог сложнее обычной пятиминутки
Поведенческий диалог безопасности — это не просто короткое выступление. Методика включает наблюдение за реальной работой и беседу с человеком. Руководителю важно увидеть безопасное или опасное поведение, а затем через вопросы добиться того, чтобы работник сам назвал опасность, возможные последствия и безопасный способ выполнения работы.
Если работник работает опасно, ключевая часть беседы — обсудить опасности и последствия, затем безопасный способ работы и другие источники опасности. Если человек работает безопасно, руководитель должен заметить и подкрепить правильное поведение, а затем использовать разговор для обсуждения других вопросов безопасности.
Именно поэтому оценочный контур ПДБ должен проверять не только слова руководителя, но и наличие настоящего диалога: задавались ли вопросы, отвечал ли работник, обсуждались ли причины поведения, последствия, безопасные действия и завершение беседы.
Псевдонимный идентификатор вместо фамилии
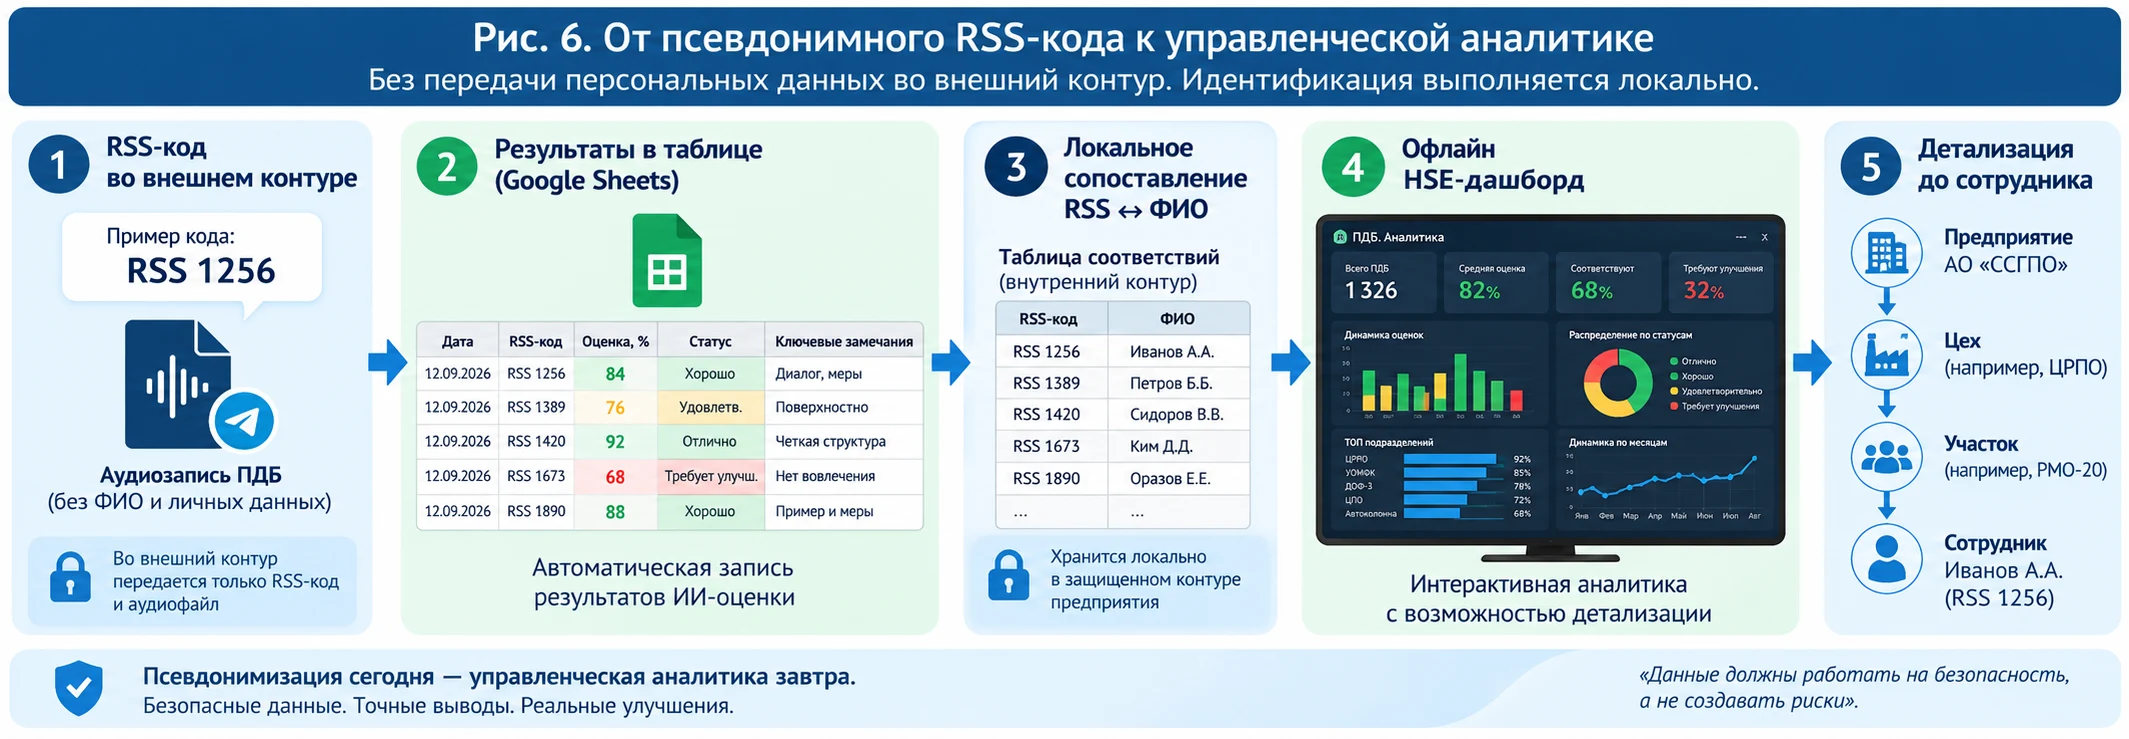
При массовой автоматизации мы отдельно решили вопрос идентификации. Внутри корпоративного контура ERGIS каждому участнику присваивается специальный код вида RSS 1256. Это не табельный номер и не фамилия.
Перед началом записи руководитель произносит свой RSS-код, после чего проводит ПДБ. В разговоре нет необходимости называть фамилии или табельные номера. Соответствие «RSS-код ↔ конкретный сотрудник» остаётся внутри корпоративного контура и используется позднее при локальной аналитике.
Здесь корректнее говорить не о полном обезличивании, а о псевдонимизации: в аудиофайле всё равно остаётся голос человека. Но объём персональных данных, проходящих через автоматизированный контур, существенно уменьшается.
Маленький секрет: я не программист
Архитектуру нового решения мы собирали через Make. Я не программист и в начале работы прямо написал об этом ChatGPT.
Запрос был простой: «Проведи меня через создание этой автоматизации пошагово. Давай одно действие за раз. Я буду выполнять его в Make и присылать скриншот. После проверки давай следующую команду».
Дальше именно так и происходило. ChatGPT объяснял, какой модуль создать и что в нём заполнить; я выполнял действие и отправлял скриншот; после проверки получал следующий шаг. Аналогично был создан Telegram-бот и связана вся цепочка.
Это важный для меня вывод из практики вайб-кодинга: специалисту не обязательно заранее знать синтаксис API или Make. Но он обязан хорошо понимать производственный процесс, результат, который должен получить пользователь, и уметь последовательно проверять каждый этап.
Prompt 3 — стартовый промпт «проведи меня пошагово через Make» см. в приложении.
Что происходит теперь: Telegram → Make → ИИ → результат
Современный контур работает почти без ручного оператора. Руководитель отправляет аудиозапись в Telegram-бот. Make принимает файл, проверяет входные данные и запускает маршрут обработки. ИИ анализирует запись по заданной методике, формирует оценку и обратную связь. Результат возвращается пользователю и одновременно записывается в Google Sheets для общей аналитики.
В текущем пилоте обратная связь возвращается примерно через десятки секунд. Для пользователя это выглядит просто: отправил аудио — получил оценку, сильные стороны, конкретные ошибки и что изменить в следующий раз.
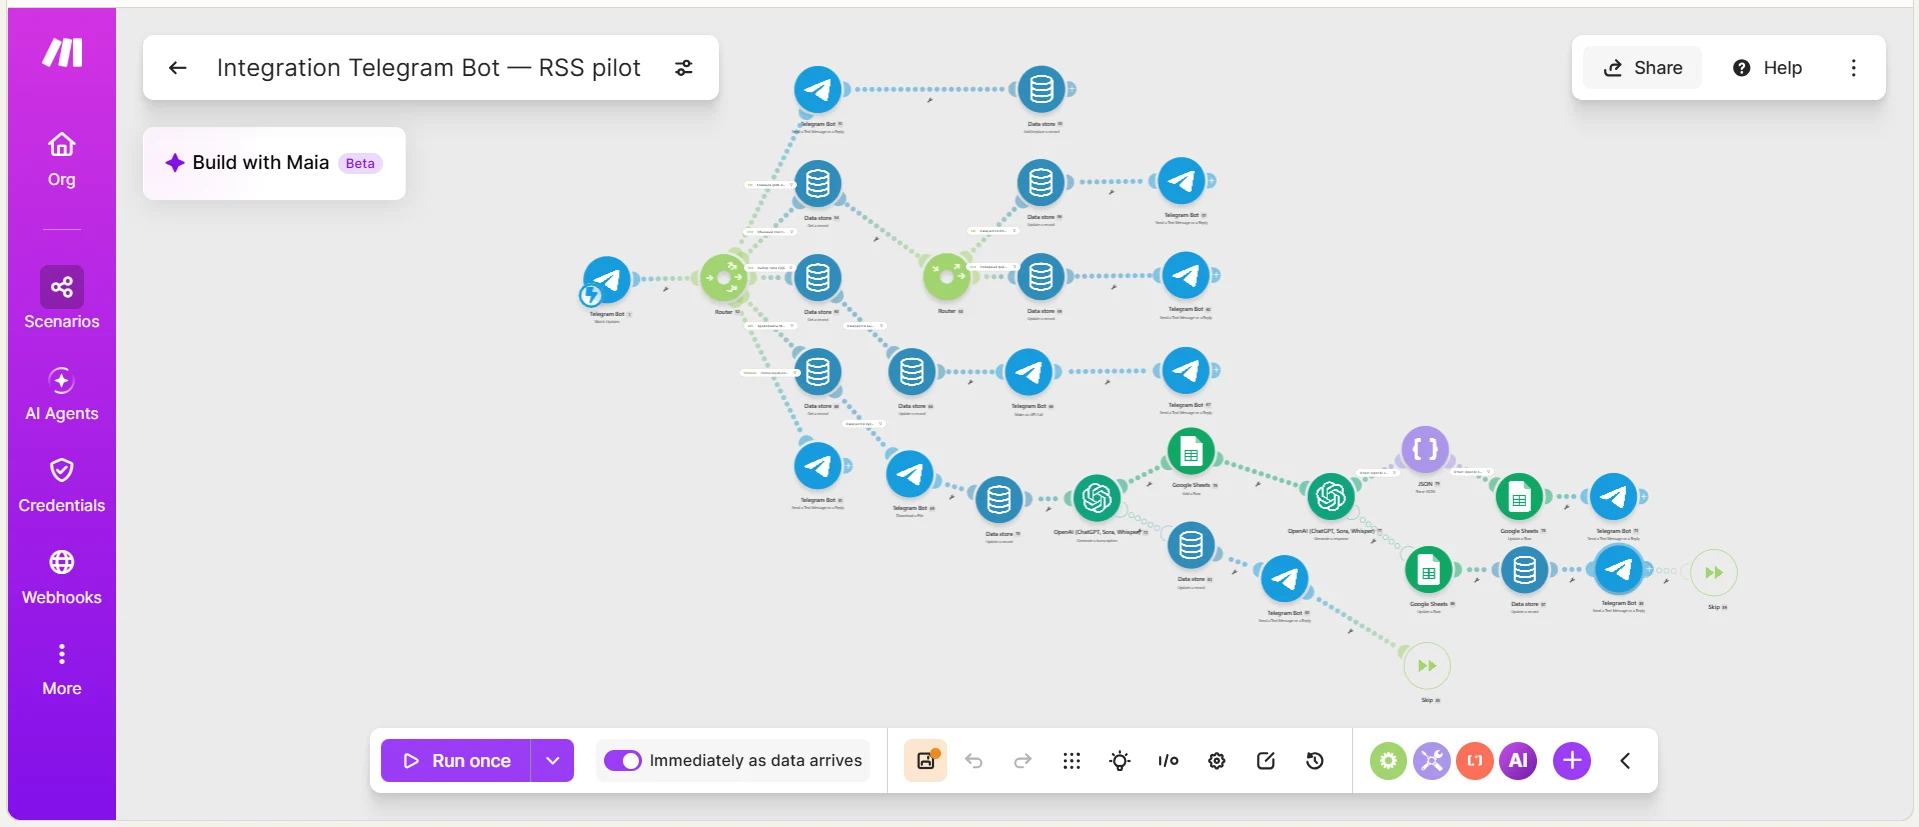
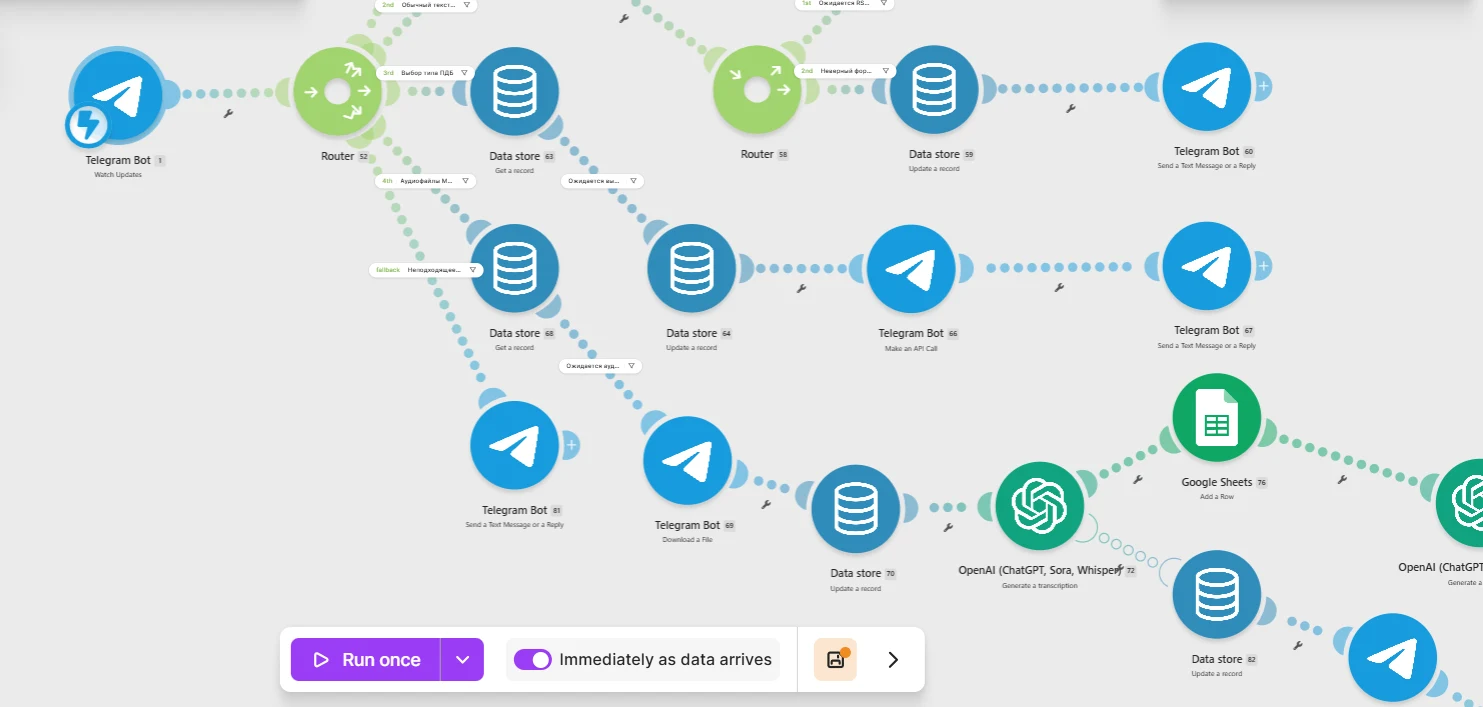
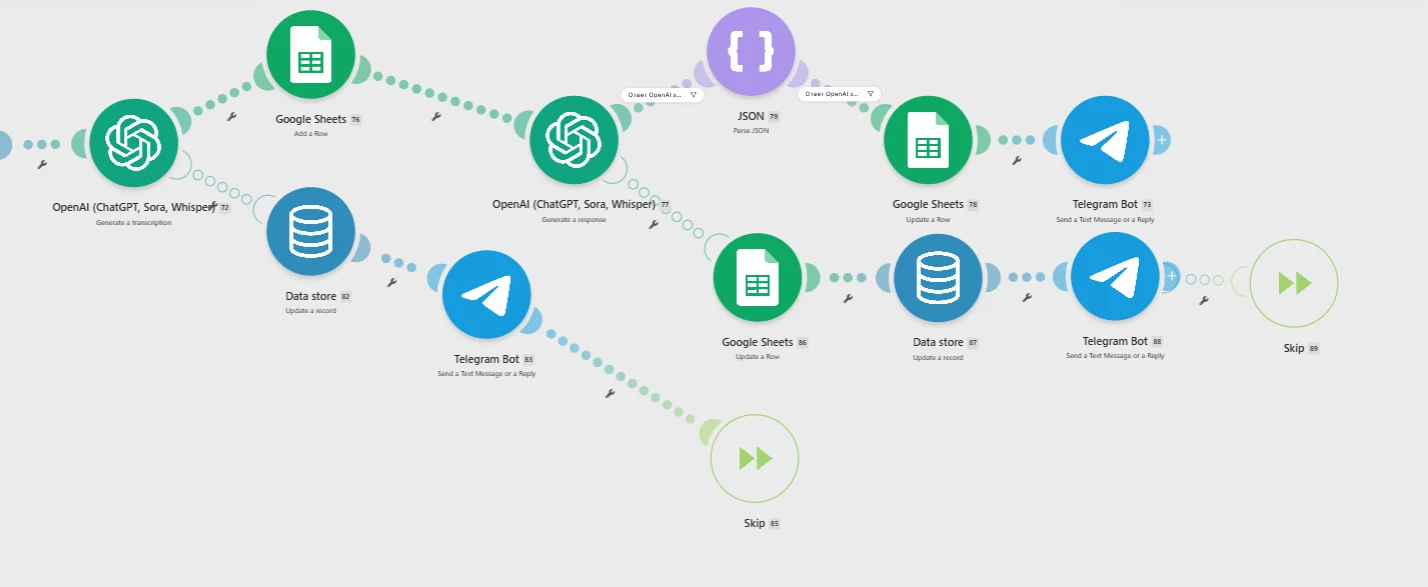
На схеме Make видно, что за этой простотой скрывается полноценная маршрутизация: Telegram, Data store, Router, OpenAI, Google Sheets, проверки и обратные сообщения пользователю.
Это мультиагент или нет?
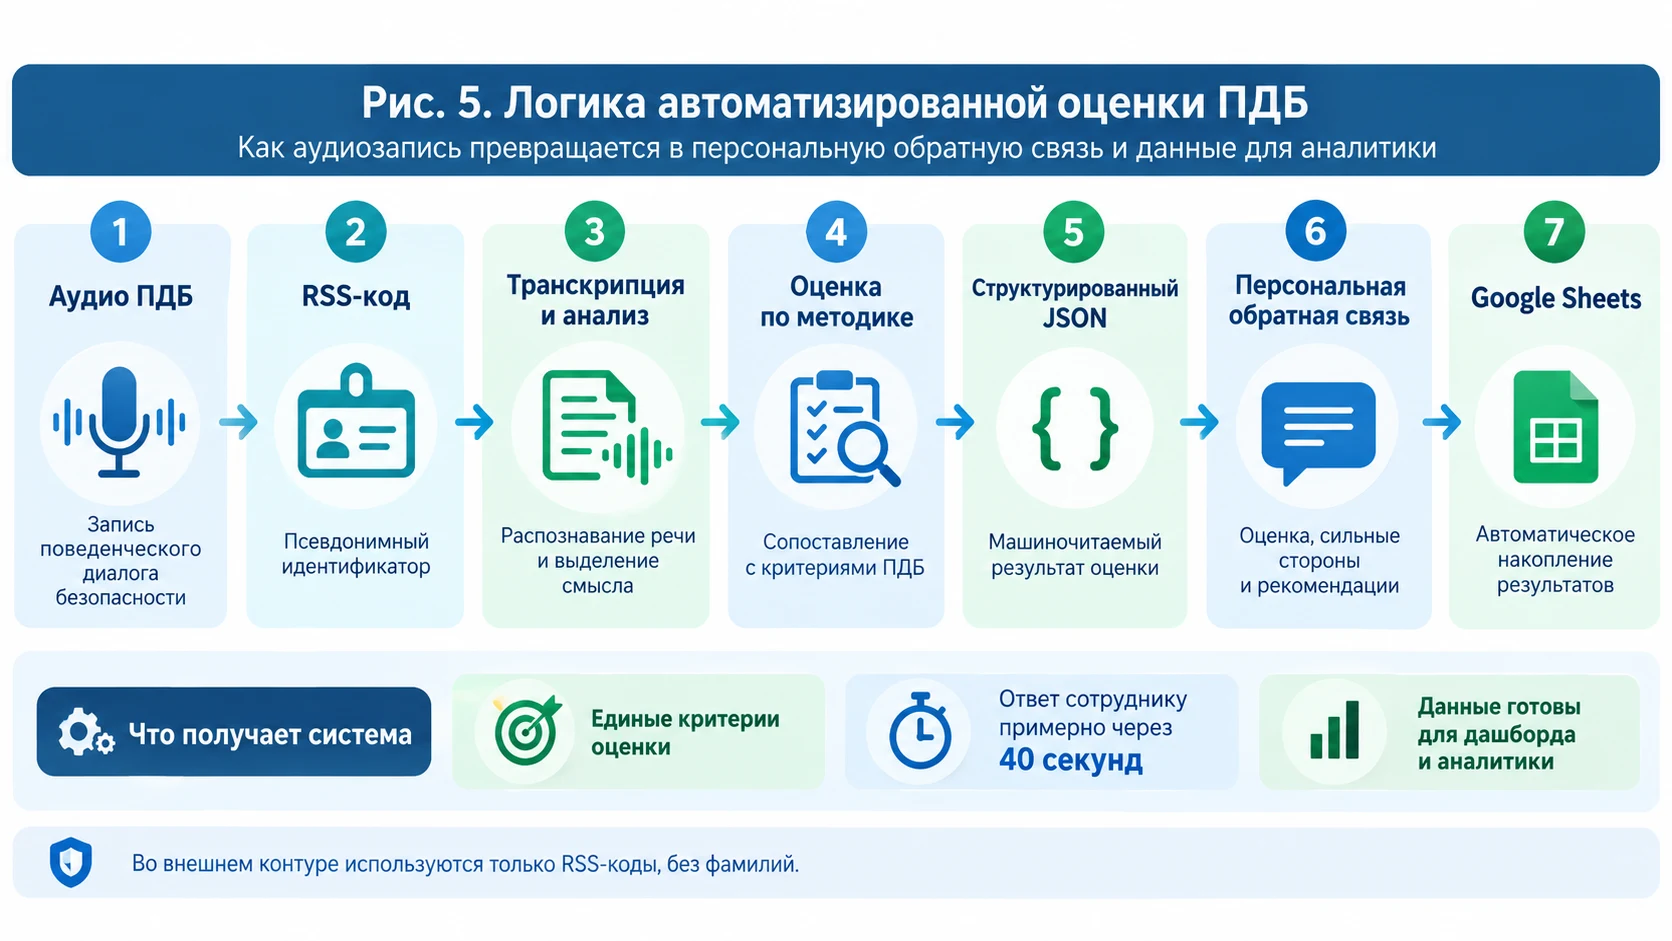
Я бы здесь не использовал слово «мультиагент» только ради эффекта. На практике у нас многошаговый экспертный контур, в котором разные части сценария выполняют разные функции: приём и маршрутизация файла, извлечение идентификатора, анализ содержания, экспертная оценка, формирование структурированного результата, запись в таблицу и персональная обратная связь.
Если несколько отдельных модельных вызовов работают с разными системными ролями — например, один анализирует диалог, второй контролирует соответствие методике и форматирует итог, — это уже можно рассматривать как мультиагентную или многоагентную логику. Если один модельный вызов выполняет все функции, честнее говорить о многофункциональном ИИ-оценщике.
В приложении я поэтому разделил промпты по функциям, а не называю каждую функцию отдельным агентом.
Как устроена автоматизированная оценка ПДБ
В промышленном сценарии важно разделить две задачи. Первая — экспертная: оценить содержание разговора строго относительно методики. Вторая — техническая: вернуть результат в формате, который поймёт Make и сможет записать в Google Sheets.
Поэтому для автоматизации удобен структурированный JSON-ответ: RSS-код, итоговый балл, статус, сильные стороны, зоны улучшения, короткая обратная связь и отдельные критерии оценки. Такой формат снижает риск того, что автоматизация «сломается» из-за красивого, но непредсказуемого текста модели.
При этом жёсткое правило остаётся тем же, что и весной: не засчитывать то, чего нет в записи; не угадывать намерения; не дорисовывать правильный ответ за руководителя. Если транскрипция неполная — запись должна уйти на повторную загрузку, а не получить выдуманную оценку.
Prompts 4–6 — оценка ПДБ, структурированный JSON и формирование обратной связи см. в приложении.
От персональной оценки к картине по подразделениям
После каждой оценки в Google Sheets накапливается уже не просто текстовая обратная связь, а структурированный массив. Поэтому можно видеть количество проведённых ПДБ, средний результат, основные повторяющиеся ошибки, динамику и результаты по псевдонимным RSS-кодам.
Следующий шаг нам уже знаком по второй статье: локально сопоставить RSS-код с ФИО в корпоративном контуре и загрузить результат в автономный HSE-дашборд. Тогда руководитель видит картину по предприятию, цеху и участку и при необходимости проваливается до конкретного работника.
То есть внешний оценочный контур может работать без фамилии, а полная управленческая картина восстанавливается только внутри предприятия.
Как эту идею можно повторить без нашей архитектуры
Смысл подхода не привязан к одному бренду ИИ. В простейшем варианте можно создать Perplexity Project с методикой и оценочным промптом. Можно использовать ChatGPT с постоянной инструкцией и загруженной базой знаний. Можно построить схему вокруг Google NotebookLM / Gemini Notebook как источника методических материалов, а оценку выполнять отдельной моделью. Для массового потока удобнее использовать Make или другую платформу автоматизации с Telegram, OpenAI и таблицами.
Ключевые элементы остаются одинаковыми: утверждённая методика → жёсткий промпт → проверка воспроизводимости → понятная шкала → персональная обратная связь → структурированное накопление результата.
Что изменилось за несколько месяцев
Весной один сотрудник вручную переносил аудиофайлы в ИИ и возвращал результат. Сегодня мы строим контур, который способен принять и оценить около 1300 записей ПДБ без отдельного оператора на каждом файле.
Но главное изменение даже не в скорости. Мы получили возможность применять одинаковые критерии к большому количеству реальных разговоров и превращать каждую оценку в короткий индивидуальный учебный цикл.
ИИ в этой схеме — не инспектор, который ищет виновного. Он одновременно второй эксперт и цифровой коуч: фиксирует несоответствие методике, объясняет, что именно нужно улучшить, и позволяет проверить это уже в следующем разговоре.
Вывод
Когда мы начинали, задача звучала как эксперимент: сможет ли ИИ оценить пятиминутку безопасности. В результате получилась технология, которую можно масштабировать на поведенческие диалоги, обучение и другие виды коммуникаций по безопасности.
Для меня наиболее ценный результат — не автоматическая цифра. Ценность в том, что руководитель получает обратную связь почти сразу после реального разговора, а предприятие одновременно получает массив данных о том, какие элементы методики действительно являются сложными для людей.
Именно в этом месте ИИ начинает работать не вместо системы управления безопасностью, а внутри неё — как единообразный второй эксперт.
Промпты к статье «ИИ как второй эксперт»
Пятиминутки безопасности, проверка воспроизводимости, Make и автоматизированная оценка ПДБ
Это публикационная версия промптов. Она основана на реальной методике и нашей рабочей архитектуре, но перед применением на другом предприятии критерии и пороги необходимо заменить на утверждённые локальные требования.
Prompt 1. Модернизированная оценка пятиминутки в Perplexity Project
Это улучшенная публикационная версия действующего промпта. Я исправил внутренние противоречия: чек-лист теперь действительно содержит 7 критериев, а проходной порог везде один — 80%.
Ты выступаешь в роли эксперта по охране труда и промышленной безопасности, выполняющего контрольную оценку качества проведения пятиминутки безопасности руководителем смены.

ИСТОЧНИКИ И ПРИОРИТЕТ
1. Аудиозапись пятиминутки.
2. Утверждённое методическое руководство предприятия.
3. Утверждённый чек-лист оценки.
При конфликте формулировок руководствуйся утверждённым чек-листом и методикой. Не добавляй собственные критерии.

ЭТАП 1. ПОЛНАЯ РАСШИФРОВКА
- Сначала получи полную расшифровку аудио, а не краткое summary.
- Для Perplexity Project используй доступный инструмент чтения вложенного аудиофайла в полном режиме (READ / максимальный доступный context budget).
- Неразборчивые фрагменты помечай [неразборчиво].
- Если связно распознано менее 80% речи или отсутствует существенная часть записи, ответь только: «Недостаточно данных. Перезагрузите файл.» и остановись.
- Полную расшифровку в итоговый отчёт не выводи.

ЭТАП 2. ЭКСПЕРТНАЯ ОЦЕНКА
Оценивай только то, что реально прозвучало в полной расшифровке.
Запрещено:
- додумывать намерения мастера;
- засчитывать то, чего нет в записи;
- улучшать формулировки за оцениваемого;
- компенсировать отсутствующий элемент общим хорошим впечатлением.

ШКАЛА ДЛЯ КАЖДОГО КРИТЕРИЯ
Выполнено = 1 балл.
Частично = 0,5 балла.
Не выполнено = 0 баллов.
Правило:
- отсутствует в аудио → 0;
- упомянуто формально, без раскрытия → 0,5;
- раскрыто логично и корректно → 1.

ЧЕК-ЛИСТ — ОЦЕНИ ВСЕ 7 ПУНКТОВ БЕЗ ПРОПУСКОВ
1. Представление себя и цели пятиминутки.
2. Название конкретной опасности / актуальной темы.
3. Логика «опасность → последствия → меры безопасности».
4. Эмоциональный импульс через реальные/потенциальные последствия или уместный пример.
5. Конкретные меры безопасности.
6. Диалог с рабочими: вопросы, ответы, вовлечение.
7. Итоговое резюме и связь с текущими / предстоящими работами.

ФОРМАТ ОТВЕТА
1. Таблица:
№ | Критерий | Что фактически прозвучало | Оценка | Балл

2. Итог:
Набрано: X из 7.
Процент: (X/7)*100, округлить до 1 знака.

3. Статус цикла:
- если результат >=80%: «Проходной уровень достигнут»;
- если результат <80%: «Проходной уровень не достигнут. Рекомендуется повторная пятиминутка после изучения обратной связи».

4. Сильные стороны — 2–5 конкретных пунктов, только из записи.
5. Зоны улучшения — конкретно по невыполненным/частично выполненным критериям.
6. Обратная связь мастеру — 3–5 предложений: деловой, требовательный, развивающий стиль.

КОНТРОЛЬ ДО ОТВЕТА
Перед финальным ответом ещё раз проверь:
- сумма баллов совпадает с таблицей;
- процент рассчитан правильно;
- ни один из 7 критериев не пропущен;
- ни одно утверждение не основано на том, чего не было в аудио.
Комментарий: С исходной версии сохранён главный принцип: сначала полная расшифровка, затем оценка только по фактически прозвучавшему. В Perplexity конкретное имя инструмента чтения файла может меняться, поэтому в публичной версии лучше описывать функцию, а не жёстко привязывать читателя к названию search_files_v2.
Prompt 2. Проверка воспроизводимости («цифровой объективности»)
Этот промпт используется уже после нескольких независимых прогонов одной записи.
Я провожу валидацию воспроизводимости ИИ-оценщика.

У меня есть результаты N независимых оценок ОДНОЙ И ТОЙ ЖЕ аудиозаписи по одному и тому же чек-листу.
Я передам тебе итоговые таблицы/JSON каждого прогона.

Твоя задача:
1. Сравнить итоговый процент между прогонами.
2. Сравнить балл по каждому критерию.
3. Выделить критерии, по которым модель меняет решение чаще всего.
4. Рассчитать:
   - минимальный итоговый процент;
   - максимальный итоговый процент;
   - размах в процентных пунктах;
   - средний итоговый процент.
5. Не пересчитывать саму исходную запись и не выбирать «правильную» оценку — анализировать только устойчивость оценщика.

КРИТЕРИЙ ДЛЯ ПИЛОТА
- разница 0–2 п.п. — высокая воспроизводимость;
- 2,1–5 п.п. — приемлемая, но проверить спорные критерии;
- более 5 п.п. — промпт/критерии требуют доработки.

Вывод дай в формате:
- Уровень воспроизводимости;
- Где возникает разброс;
- Что именно в промпте нужно сделать более однозначным;
- Нужно ли повторить тест после корректировки.

Не называй это абсолютной объективностью. Используй термин «воспроизводимость оценки».
Комментарий: Порог разброса в примере — рабочий ориентир для публикации, а не утверждённая корпоративная норма. Его можно убрать или заменить своим.
Prompt 3. ChatGPT как пошаговый наставник по Make
Это тот самый принцип, который позволяет повторить решение человеку без навыков программирования.
Я не программист и раньше не собирал сценарии в Make.
Помоги мне создать автоматизацию по принципу «одно действие за раз».

ЦЕЛЬ
Telegram-бот принимает аудиозапись поведенческого диалога безопасности. Далее Make должен:
1. получить файл;
2. проверить тип входа;
3. извлечь/получить аудио;
4. передать материал в ИИ для анализа;
5. получить строго структурированный результат;
6. записать результат в Google Sheets;
7. отправить пользователю короткую персональную обратную связь;
8. корректно обработать ошибки, повторные файлы и неподдерживаемый формат.

ПРАВИЛА НАШЕЙ РАБОТЫ
- Давай только ОДИН следующий шаг за сообщение.
- Пиши точное название модуля Make, который нужно добавить.
- Пиши, что выбрать в каждом обязательном поле.
- Если требуется переменная из предыдущего модуля — укажи её точное происхождение.
- После каждого шага остановись и попроси меня прислать скриншот.
- По моему скриншоту сначала проверь, всё ли сделано правильно. Если есть ошибка — исправляем её и только потом идём дальше.
- Не перепрыгивай через этапы и не присылай сразу весь сценарий.
- Объясняй простыми словами, без предположения, что я знаю API, JSON или программирование.
- Если есть несколько способов, выбирай самый простой и надёжный для пилота и кратко объясни почему.

ОГРАНИЧЕНИЯ
- идентификатор пользователя в оценочном контуре — псевдонимный код вида RSS 1234;
- фамилии и табельные номера не нужны;
- итог для таблицы должен быть структурированным;
- человеку в Telegram отправляется только понятная обратная связь, без технического JSON.

Начни с первого шага: создание/подключение Telegram-бота и первого входного модуля Make.
Prompt 4. Ядро оценки ПДБ для OpenAI/ChatGPT в Make
Это универсальная публикационная версия оценочного блока. Она специально возвращает JSON — так Make легче записывает результат в таблицу и маршрутизирует ответ.
SYSTEM ROLE
Ты — экспертный оценщик качества поведенческих диалогов безопасности (ПДБ). Ты оцениваешь ТОЛЬКО содержание предоставленной расшифровки и применяешь утверждённую методику предприятия.

ВАЖНО
Если предприятие передало отдельный утверждённый чек-лист — он имеет приоритет над примерной структурой ниже.
Не придумывай критерии, которых нет в методике.

ОСНОВНЫЕ ПРИНЦИПЫ МЕТОДИКИ, КОТОРЫЕ НУЖНО ПРОВЕРЯТЬ ПО АУДИО
- есть реальный разговор с работником, а не монолог/инспекция;
- работнику задаются вопросы;
- работник сам называет/обсуждает опасность и возможные последствия, если ситуация опасная;
- обсуждается безопасный способ выполнения работы;
- обсуждаются другие источники опасности и меры безопасности;
- при безопасной работе руководитель отмечает и подкрепляет конкретное безопасное действие;
- общение уважительное;
- беседа завершается понятным итогом/благодарностью;
- не засчитывать визуальное наблюдение, если из аудио его невозможно подтвердить.

ВХОД
- transcript: полная расшифровка;
- rss_id: псевдонимный идентификатор вида RSS 1234;
- methodology_context: выдержки/правила утверждённой методики;
- optional_checklist: утверждённый локальный чек-лист, если он есть.

ПРАВИЛА ОЦЕНКИ
1. Используй только факты из transcript.
2. Не угадывай намерения.
3. Не восстанавливай ФИО по голосу/контексту.
4. Если транскрипт явно неполный или несвязный — quality_status="insufficient_data" и не выставляй итоговую оценку.
5. Если применён локальный чек-лист, оцени все его пункты без пропусков.
6. Для каждого вывода сохраняй короткое evidence — фразу/содержание из расшифровки, подтверждающее решение.

ВЫХОД — ТОЛЬКО JSON, БЕЗ MARKDOWN И БЕЗ ТЕКСТА ДО/ПОСЛЕ
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 предложений, понятных руководителю",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

ПЕРЕД ОТВЕТОМ ПРОВЕРЬ
- JSON валиден;
- rss_id не изменён;
- итоговый балл соответствует сумме критериев;
- evidence не содержит выдуманных фактов;
- если данных недостаточно, нет выдуманного overall_score_percent.
Комментарий: Так как отдельный утверждённый балльный чек-лист ПДБ в предоставленных материалах не зафиксирован, я не выдаю придуманную шкалу за корпоративную норму. В рабочей версии нужно подставить ваш фактический чек-лист.
Prompt 5. Отдельный модуль обратной связи в Telegram
Если в сценарии используется второй вызов модели, его выгодно ограничить только форматированием готовой оценки. Это повышает стабильность: второй модуль не должен заново «переосмысливать» баллы.
Ты получаешь ГОТОВЫЙ JSON экспертной оценки ПДБ из предыдущего шага.
Не переоценивай запись и не меняй баллы.

Сформируй короткий ответ пользователю для Telegram.

ФОРМАТ
RSS: <код>
Оценка: <процент или «не оценено — недостаточно данных»>

Что выполнено хорошо:
• 2–4 коротких пункта из strengths

Что улучшить:
• 2–4 конкретных пункта из improvements

На следующий ПДБ:
<1–2 максимально конкретных действия>

ПРАВИЛА
- 700–1200 знаков максимум;
- деловой и уважительный тон;
- без технического JSON;
- без фамилий;
- не придумывать новые замечания;
- не использовать мотивационные лозунги;
- если quality_status=insufficient_data — попросить перезаписать/перезагрузить аудио и не выводить оценку.
Prompt 6. Нормализация результата перед Google Sheets
Этот шаг полезен, если Google Sheets должен получать одинаковую структуру независимо от длины текста оценки.
Проверь строку данных перед записью в Google Sheets.

Ожидаемые поля:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

ПРАВИЛА
1. Не добавляй ФИО и табельный номер.
2. rss_id должен соответствовать шаблону: RSS + пробел + 3–6 цифр.
3. overall_score_percent должен быть числом 0–100 либо пустым при insufficient_data.
4. Массивы преобразуй в короткие строки через «; ».
5. Если обязательное поле отсутствует — верни error=true и перечисли missing_fields.
6. Если всё корректно — error=false.

ВЫХОД ТОЛЬКО JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Аудит готового сценария Make по скриншоту
Подходит как финальный промпт для проверки сценария перед массовым пилотом.
Я пришлю тебе скриншот моего сценария Make.
Проведи технический аудит как наставник по no-code автоматизации.

Проверь по скриншоту и моему описанию:
1. порядок модулей;
2. маршруты Router;
3. обработку неподдерживаемого сообщения;
4. хранение временного состояния в Data store;
5. получение и передачу аудиофайла;
6. вызов ИИ;
7. парсинг JSON;
8. запись в Google Sheets;
9. отправку результата в Telegram;
10. ветку ошибки и повторной попытки;
11. риск дублей при повторном запуске;
12. риск того, что один пользователь получит результат другого.

Не предлагай полную перестройку, если текущая архитектура работает.
Сначала перечисли:
- что уже хорошо;
- 3 наиболее критичных риска;
- какой ОДИН следующий шаг нужно сделать первым.
После этого остановись и жди мой скриншот/подтверждение.
Практическая последовательность для читателя
- Загрузить утверждённую методику и чек-лист в выбранный Project/агента.
- Настроить Prompt 1 и проверить его на нескольких эталонных записях.
- Одну и ту же запись прогнать несколько раз и применить Prompt 2 для оценки воспроизводимости.
- Если требуется автоматизация — начать с Prompt 3 и собирать Make по одному модулю с проверкой скриншотов.
- В Make использовать Prompt 4 как экспертное ядро и требовать строгий JSON.
- При необходимости отделить пользовательскую обратную связь в Prompt 5.
- Перед записью в Google Sheets нормализовать данные Prompt 6.
- Перед массовым запуском проверить всю схему Prompt 7.
Комментарии 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!