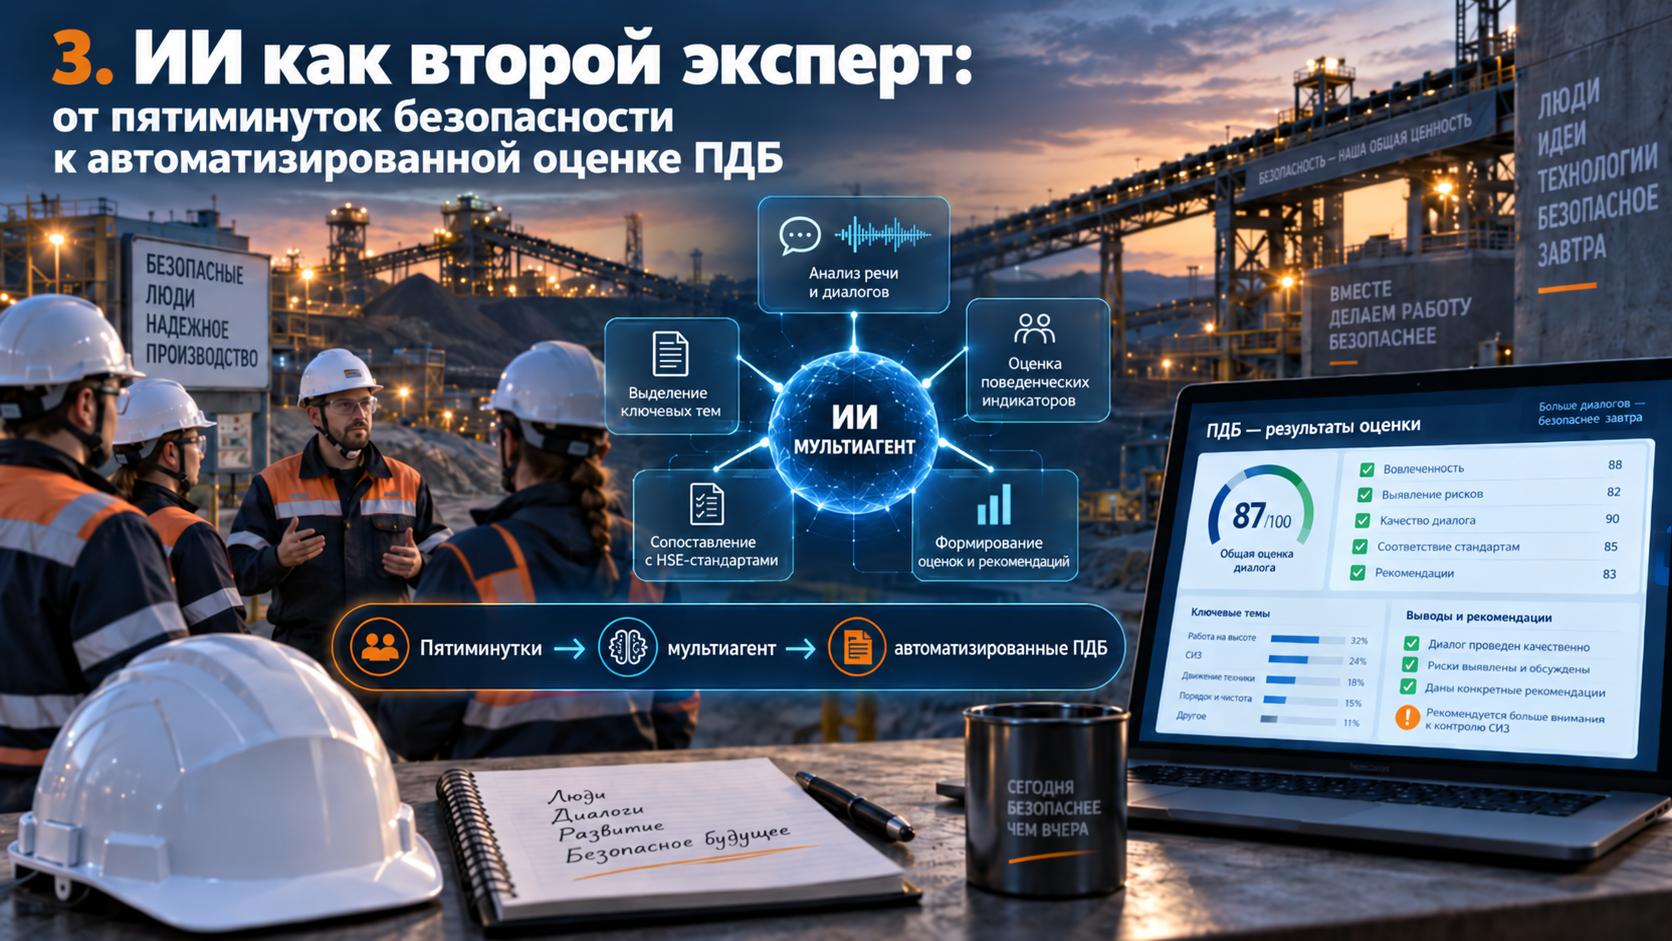
AI作为第二专家:从安全短会到BSD的自动化评估
安全短会 → 数字化评估 → Make → 自动化的行为安全对话
核心理念:AI不会取代主管或安全专家。它成为了一个统一的“第二专家”,应用相同的标准,提供个性化反馈,并将质量控制扩展到成百上千次真实的对话中。
为什么我们开始评估对话内容,而不是单纯记录其是否举行
在职业健康与安全领域中,很容易统计事实:开展了安全短会,登记了行为安全对话 (BSD),填写了卡片。但要回答主管进行该对话的质量如何以及是否达到了目标,则要困难得多。
在我们的方法中,安全短会是班前会不可或缺的一部分,时长5到10分钟。主管必须探讨一个具体的、切合实际的主题,并建立清晰的逻辑联系:危险源 → 可能的后果 → 安全措施。同时,重要的不仅是工长的独白,还包括与工人的对话:提问、回答以及鼓励参与讨论。
因此,最初的任务不是“检查是否有记录”,而是:能否教会AI以统一的标准评估此类对话的真实质量,并向主管提供实质性的反馈?
第一阶段。先有方法论,后有人工智能
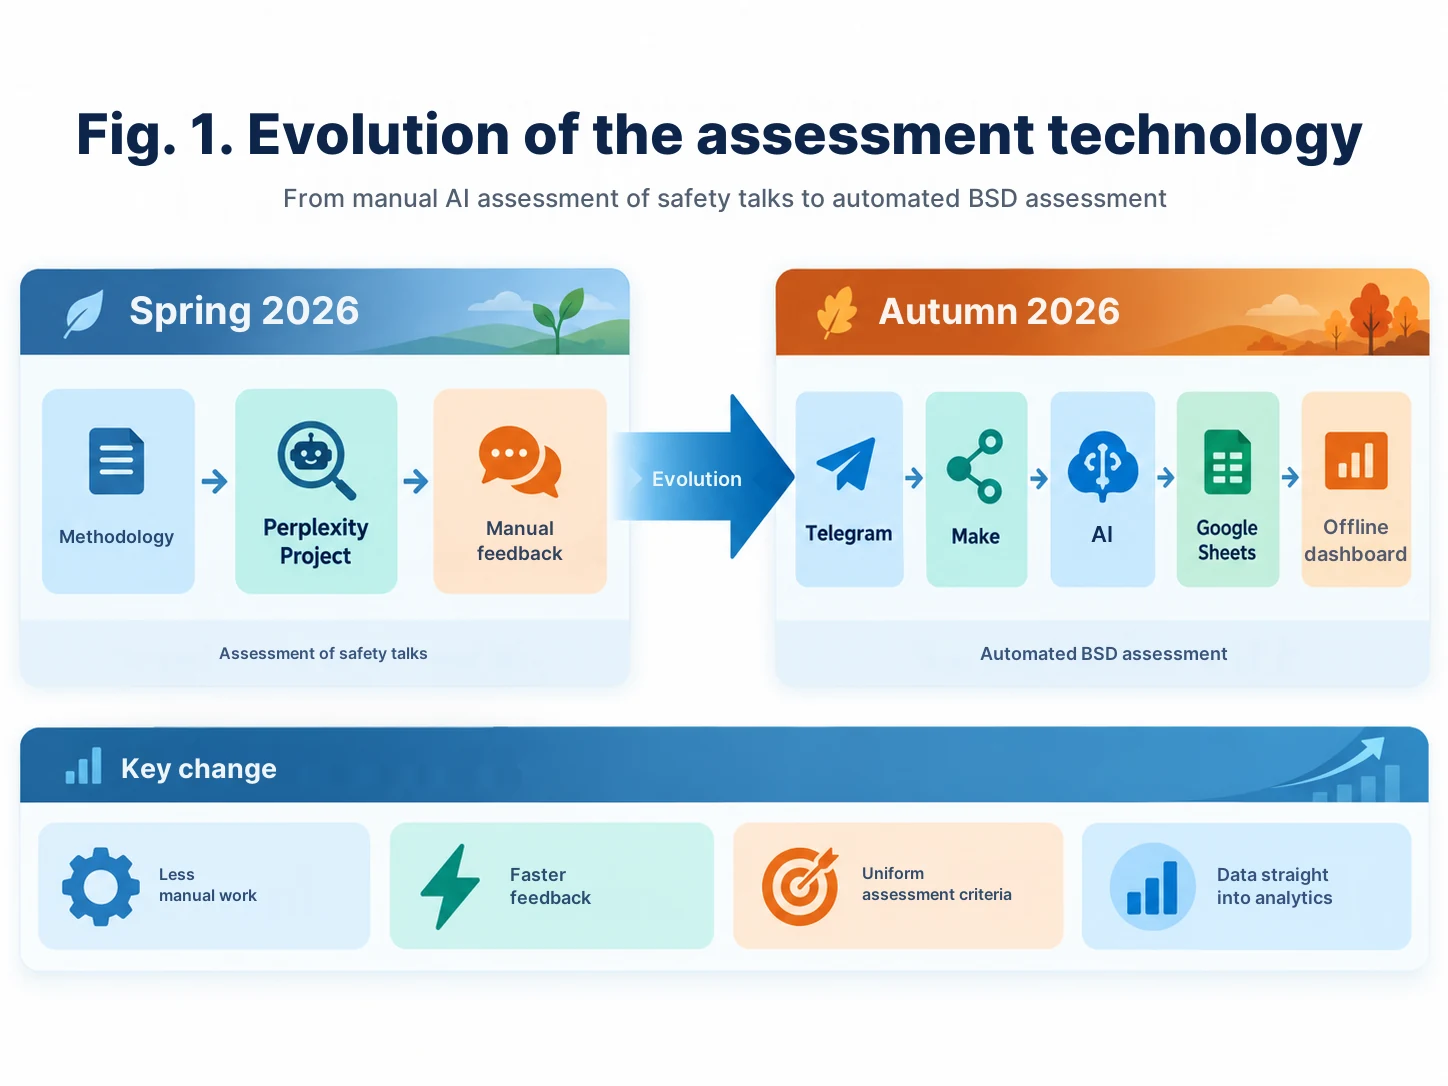
2026年春季,我们从安全短会开始。在启动AI评估之前,我们准备了关于如何正确开展安全短会的方法指南和教学视频。在此之后,数字评估员才应运而生。
作为第一个工作流,我们使用了Perplexity Space——今天Perplexity中类似的环境被称为Project。我们将方法指南和评估检查表上传到项目中,并为模型单独准备了严格的Prompt。
该Prompt的任务与普通的“评估演讲”请求有着本质的区别。AI只被允许计入音频中实际听到的内容。如果缺少某个要素,则为0分。如果是形式上提及,则为部分完成。如果阐述得逻辑严密且全面,则为已完成。
现行的检查表包含七个标准:开场与目标;具体的危险源;“危险源 – 后果 – 安全措施”的逻辑;情感驱动;安全措施;与工人的对话;最后的总结及其与正在进行的工作的联系。
Prompt 1——适用于Perplexity Project的升级版Prompt,详见附件。
最初的人工工作流是什么样的
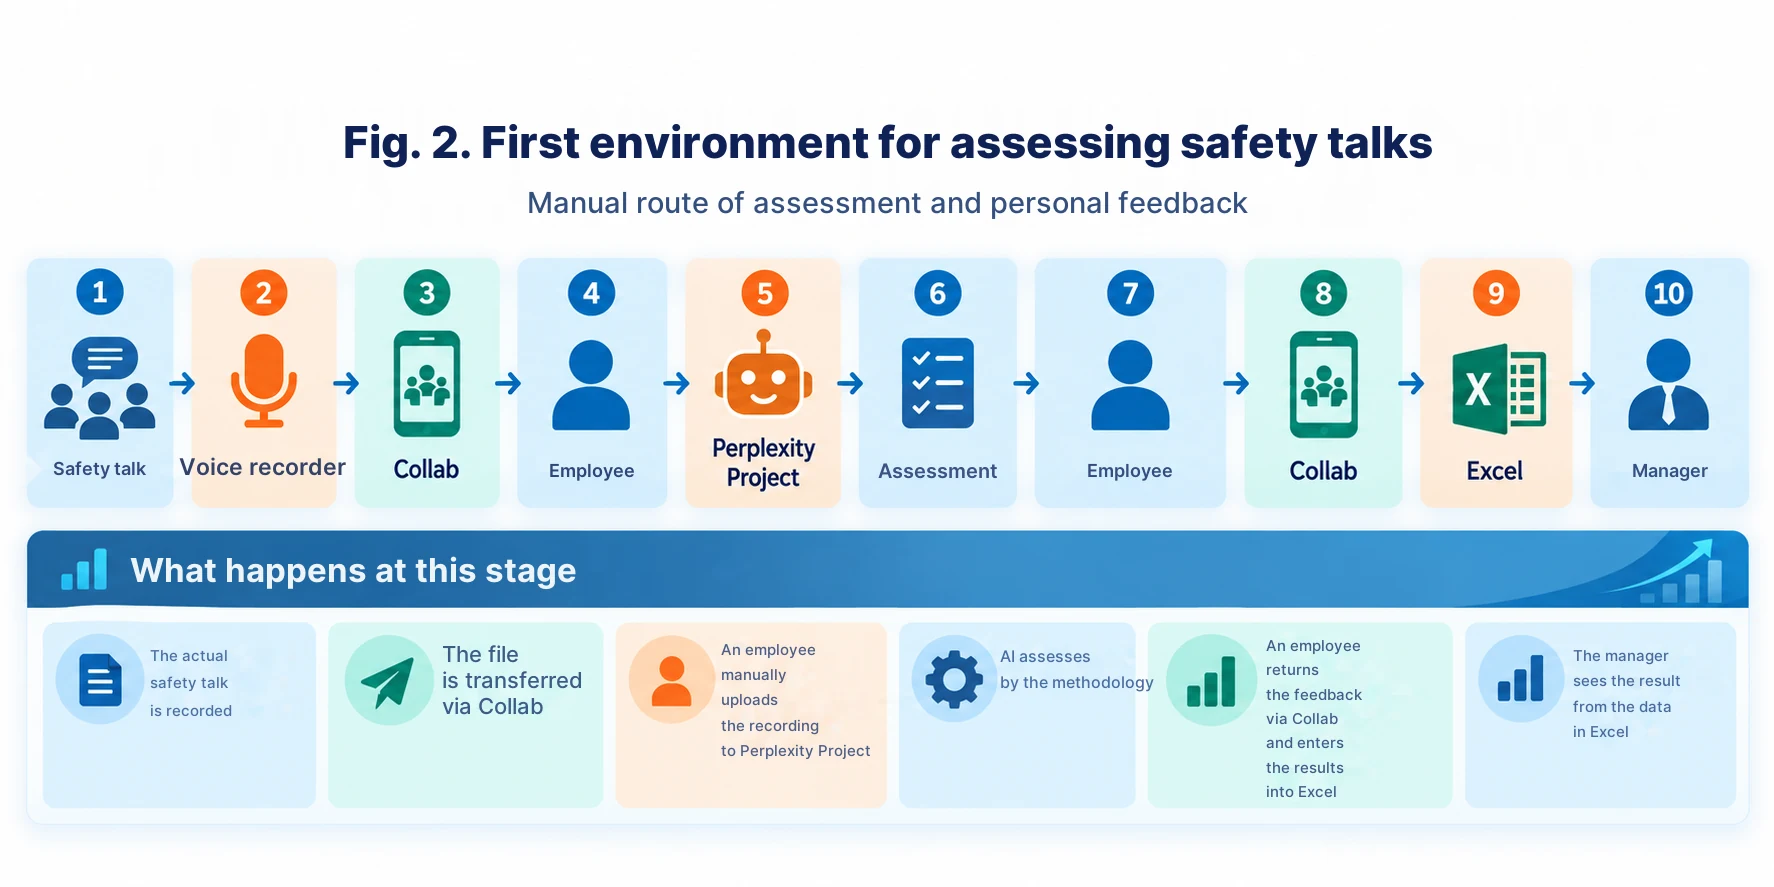
当班主管使用录音笔录下开展的安全短会。录音通过企业应用Collab发送给指定的员工。该员工将音频上传到Perplexity Project,获取评估结果,然后同样通过Collab将个性化的反馈返回给主管。
同时,结果会被录入Excel:部门、主管、评分、尝试次数。根据该表格,我们进行了简单的分析——部门的平均成绩、动态趋势以及重复循环的次数。
在实践环节中,我们将及格线设定为80%。如果得分低于及格线,主管在开展下一次安全短会时就必须考虑到AI提出的意见。这样一来,它不仅是一种监督,更是在工作场所进行的个性化培训。
不仅仅是测试人——我们首先测试了AI本身
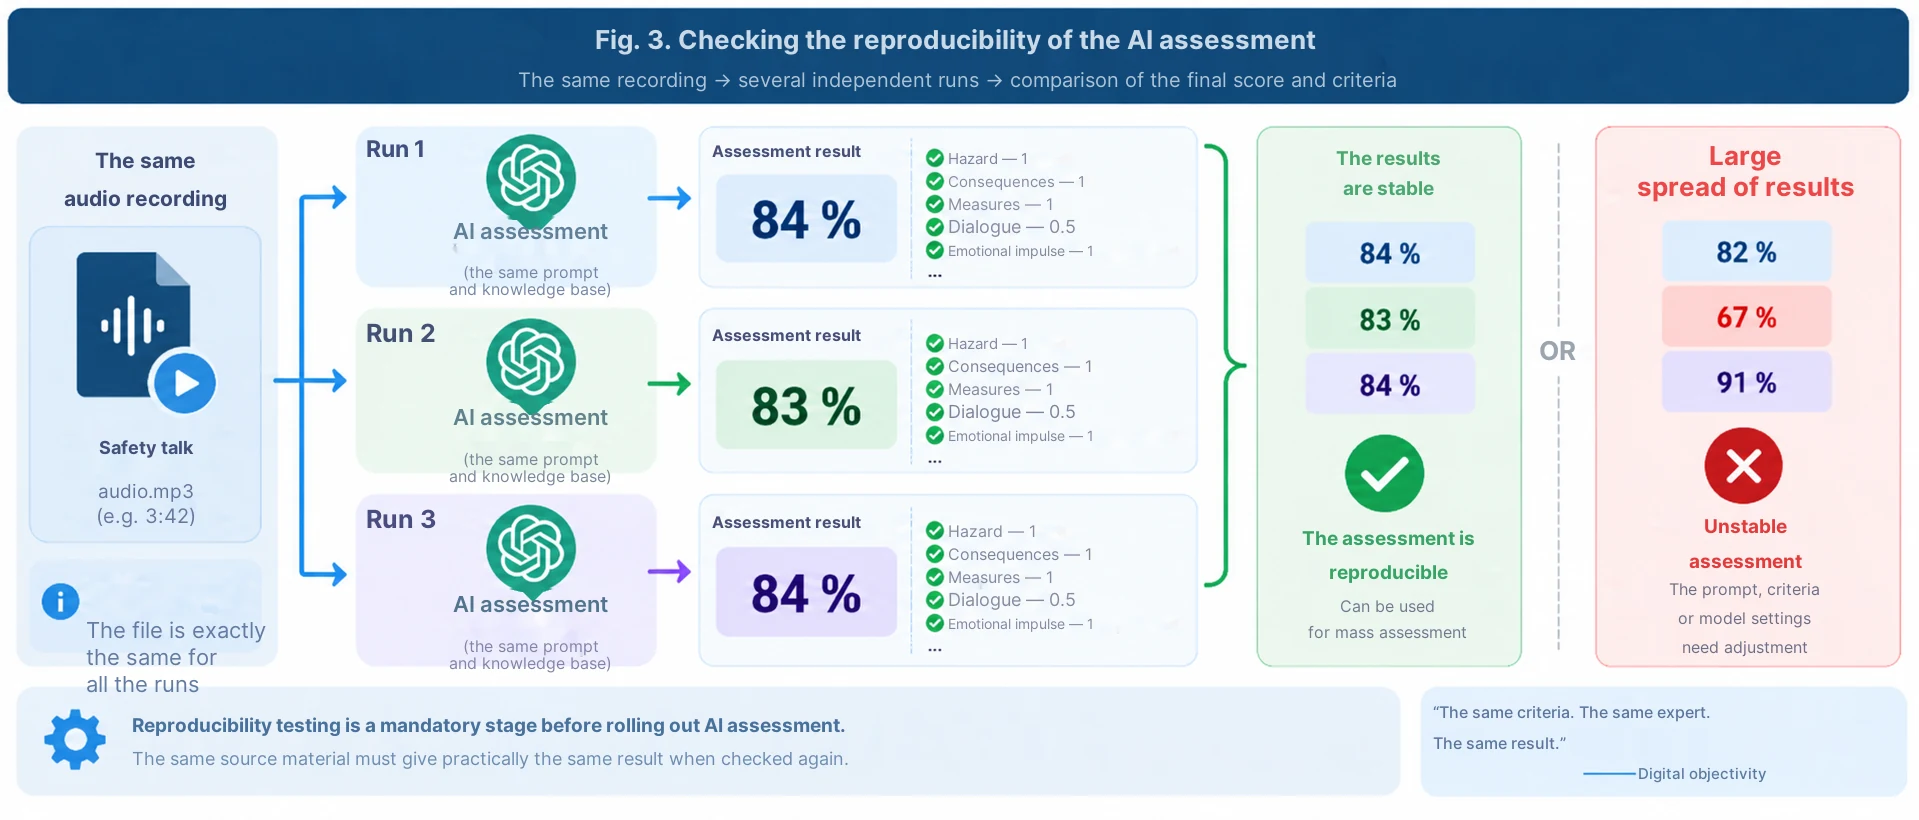
对我来说,这是整个方案中最重要的环节之一。我们特意将同一段音频多次发送进行评估。如果同样的材料今天得分82%,一分钟后得分65%,之后又是91%,那么这样的数字专家显然还没有准备好去评估人类。
因此,我们追求可复现性:相同的录音必须得出相同或几乎相同的评分。如果差异变得明显,我们就会调整Prompt,明确标准,并消除模棱两可的表述。
我个人将其称为“数字客观性”。这并不意味着AI掌握了绝对的真理。重点在于:一个统一的专家对所有人都采用相同的尺度,并且不受情绪、个人喜好或今天具体由谁来进行检查的影响。
Prompt 2——评估可复现性测试记录,详见附件。
为什么人工方案不再满足需求
在试点阶段,人工流程很方便:接收文件,上传,等待结果,返回反馈,并将分数记录在Excel中。但这种方法有着天然的局限性。
当数量达到成百上千条录音时,我们就不再是自动评估,而是围绕评估创造了新的行政管理工作。因此,在过渡到行为安全对话 (BSD) 时,任务被重新定义了:在无法创造价值的环节,将人从技术链条中移除。
第二阶段。行为安全对话比普通的安全短会更复杂
BSD不仅仅是简短的讲话。该方法包括观察实际工作以及与人交谈。主管必须看到安全或危险的行为,然后通过提问,引导工人自己说出危险源、可能的后果以及安全的工作方式。
如果工人进行危险作业,对话的关键部分是讨论危险源和后果,然后是安全的工作方式以及其他危险来源。如果人员的工作方式是安全的,主管应该注意到并肯定这种正确的行为,然后利用对话讨论其他安全问题。
正因如此,BSD的评估工作流不仅要检查主管所说的话,还要检查是否存在真实的对话:是否提出了问题,工人是否作了回答,是否讨论了行为的原因、后果、安全行动以及对话的总结。
使用假名标识符代替姓氏
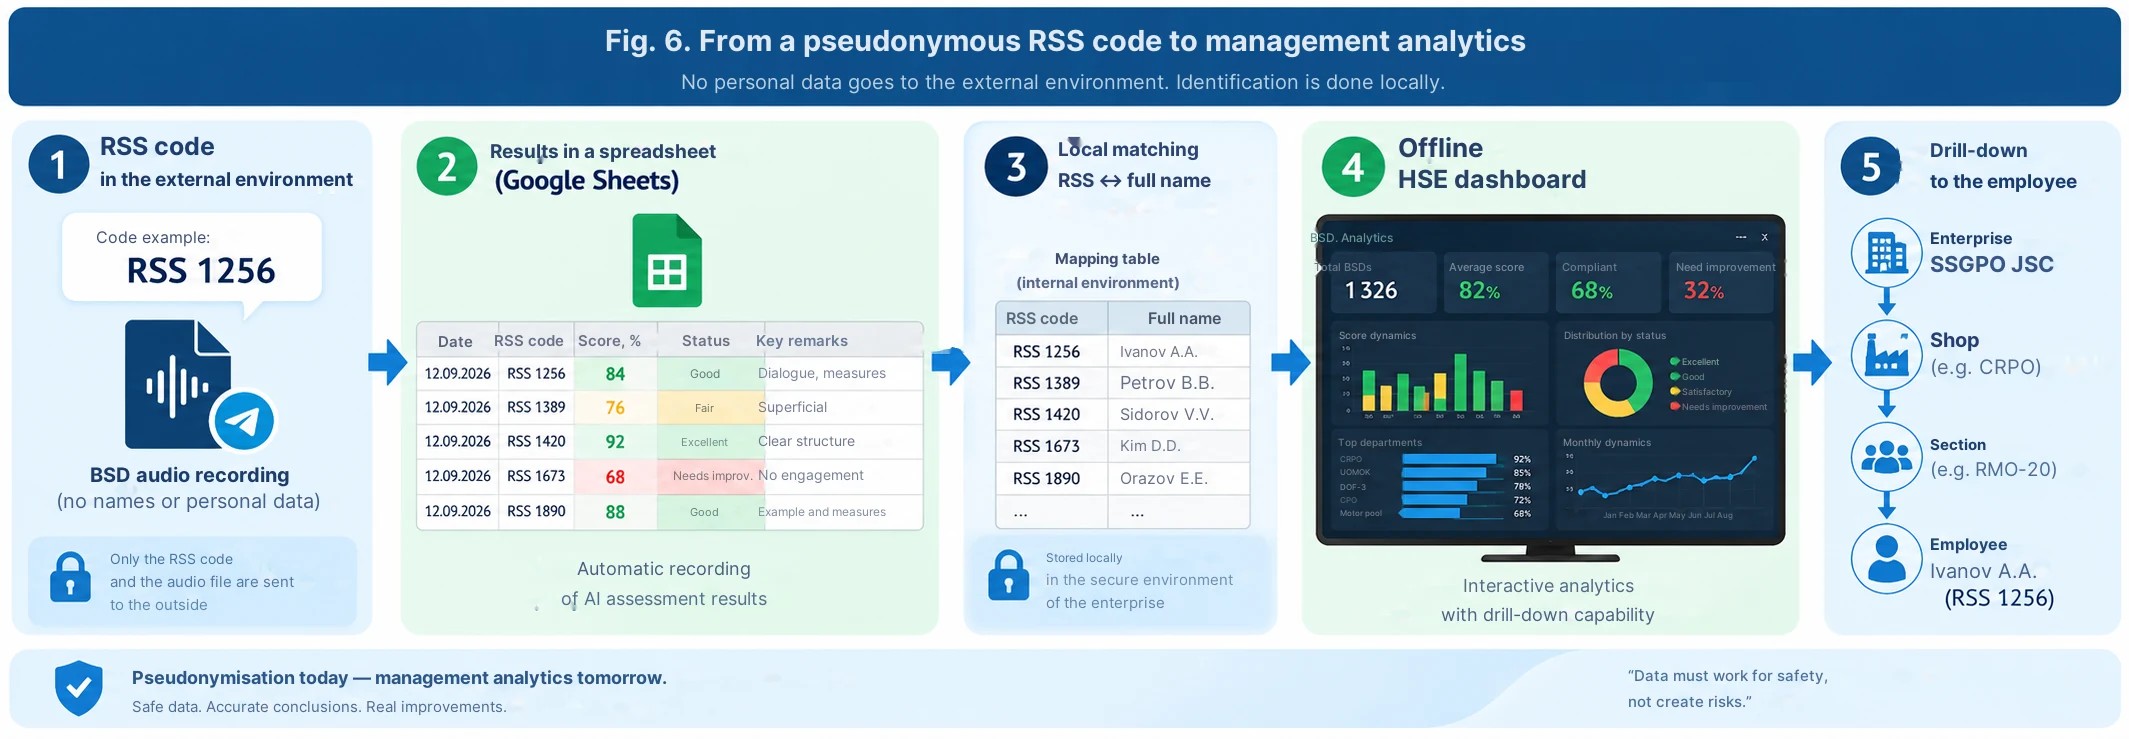
在大规模自动化过程中,我们单独解决了身份识别问题。在企业内部系统ERGIS中,每个参与者都会被分配一个类似 RSS 1256 的特殊代码。这不是工号,也不是姓氏。
在开始录音前,主管会念出自己的RSS代码,然后开展BSD。在对话中不需要提及姓氏或工号。“RSS代码 ↔ 具体员工”的对应关系保留在企业内部系统中,并在随后用于本地分析。
在这里,更准确的说法不是完全的匿名化,而是假名化:音频文件中依然保留了人的声音。但流经自动化工作流的个人数据量大大减少了。
一个小秘密:我不是程序员
我们通过Make搭建了新解决方案的架构。我不是程序员,在工作之初我就直接向ChatGPT说明了这一点。
我的请求很简单:“请一步步指导我创建这个自动化流程。一次只给一个操作步骤。我会在Make中执行它并发送截图。检查无误后,再给我下一个指令。”
接下来正是这样进行的。ChatGPT解释要创建哪个模块以及在其中填写什么;我执行操作并发送截图;检查通过后获得下一步指令。Telegram机器人也是以同样的方式创建的,并将整个链条连接了起来。
这是我从自然语言编程(vibe-coding)实践中得出的一个重要结论:专业人员不一定需要预先掌握API或Make的语法。但他必须非常了解生产过程、用户应当获得的结果,并能够有条不紊地验证每一个阶段。
Prompt 3——“一步步指导我使用Make”的初始Prompt,详见附件。
现在的情况:Telegram → Make → AI → 结果
现在的工作流几乎不需要人工操作员。主管将音频录音发送到Telegram机器人。Make接收文件,检查输入数据,并启动处理流程。AI按照既定方法分析录音,生成评分和反馈。结果返回给用户,同时记录在Google Sheets中以供整体分析。
在当前的试点中,反馈大约在几十秒内返回。对用户来说,这看起来很简单:发送音频——收到评分、优势、具体错误以及下次需要改进的地方。
在Make的流程图中可以看到,这种简单的背后隐藏着一套完整的路由系统:Telegram、Data store、Router、OpenAI、Google Sheets、验证以及发给用户的回复消息。
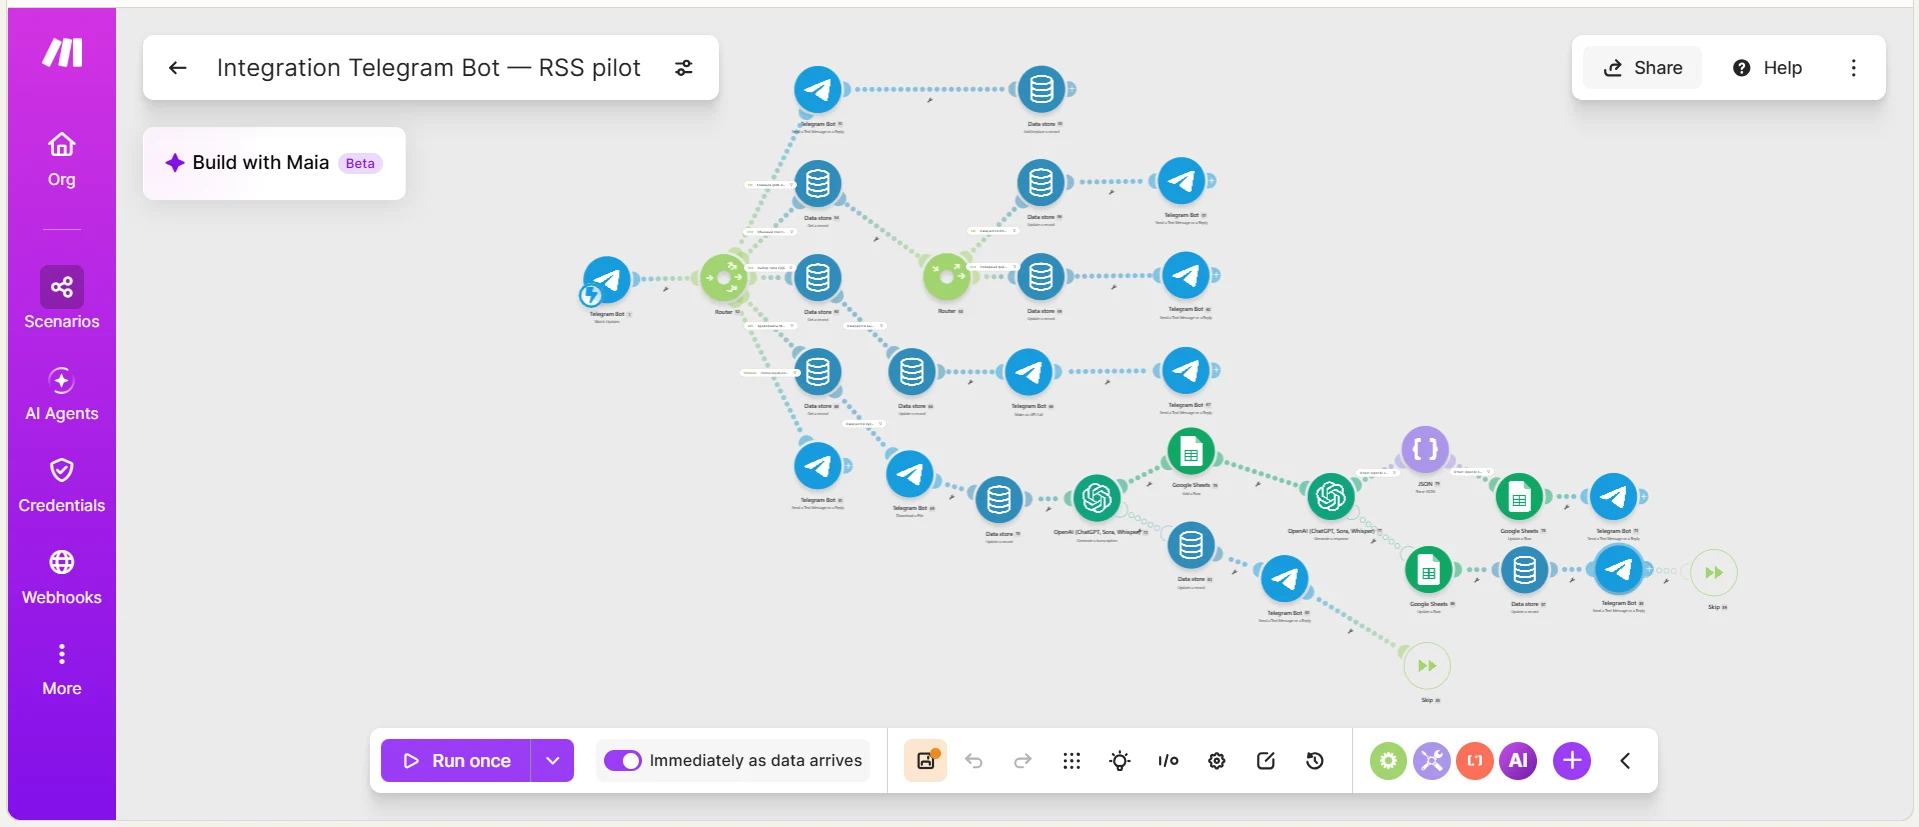
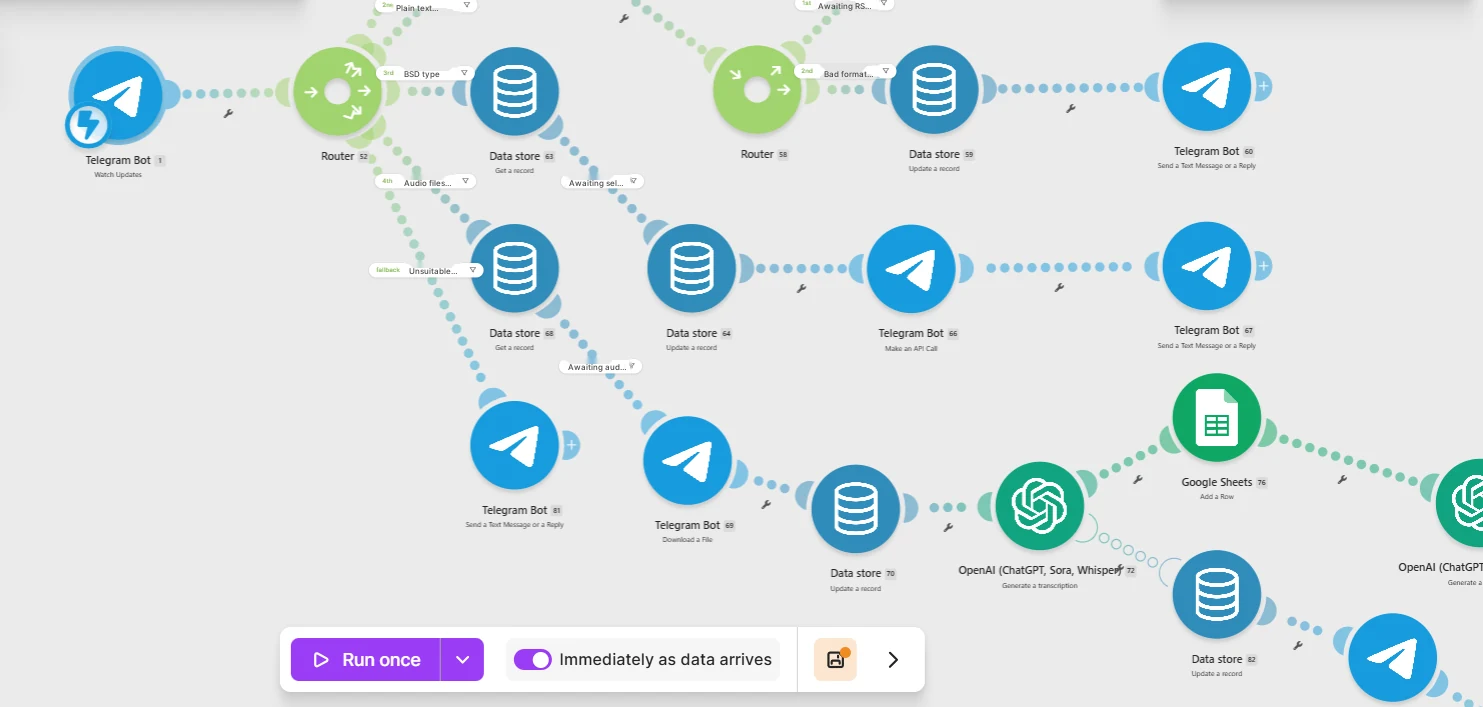
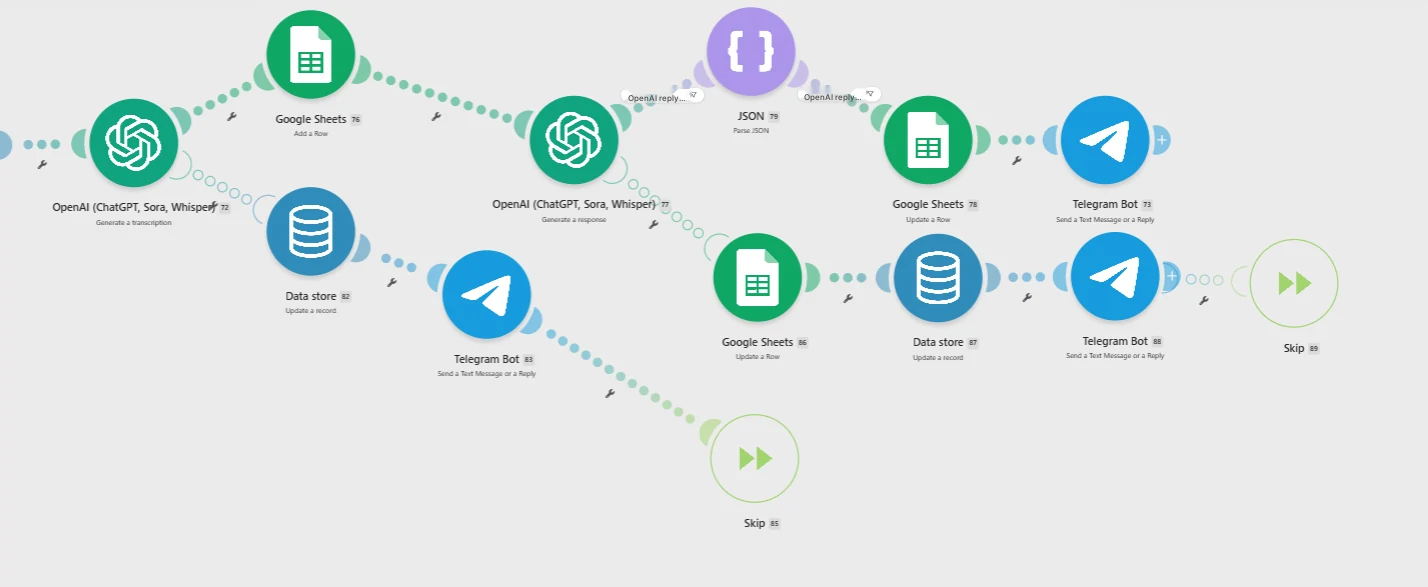
这是不是多智能体?
我不会在这里仅仅为了效果而使用“多智能体”这个词。在实践中,我们有一个多步骤的专家循环,其中场景的不同部分执行不同的功能:接收和路由文件、提取标识符、分析内容、专家评估、生成结构化结果、写入表格和个人反馈。
如果几个独立的模型调用使用不同的系统角色——例如,一个分析对话,第二个控制是否符合方法并格式化结果——这已经可以被视为多智能体或多代理逻辑。如果一个模型调用执行所有功能,更准确的说法是多功能 AI 评估器。
因此,在附录中,我按功能划分了 Prompts,而不是将每个功能称为一个单独的智能体。
自动评估 BSD 是如何运作的
在工业场景中,将两项任务分开很重要。第一项是专家级的:严格根据方法评估对话内容。第二项是技术性的:以 Make 能够理解并能写入 Google Sheets 的格式返回结果。
因此,结构化的 JSON 响应对于自动化来说很方便:RSS 代码、总分、状态、优势、改进空间、简短反馈和单独的评估标准。这种格式降低了自动化因模型生成优美但不可预测的文本而“崩溃”的风险。
同时,硬性规则与春季相同:不计入录音中没有的内容;不猜测意图;不替主管虚构正确答案。如果转录不完整——应重新上传录音,而不是得到一个编造的评估。
Prompts 4–6 — 评估 BSD、结构化 JSON 和反馈生成请见附录。
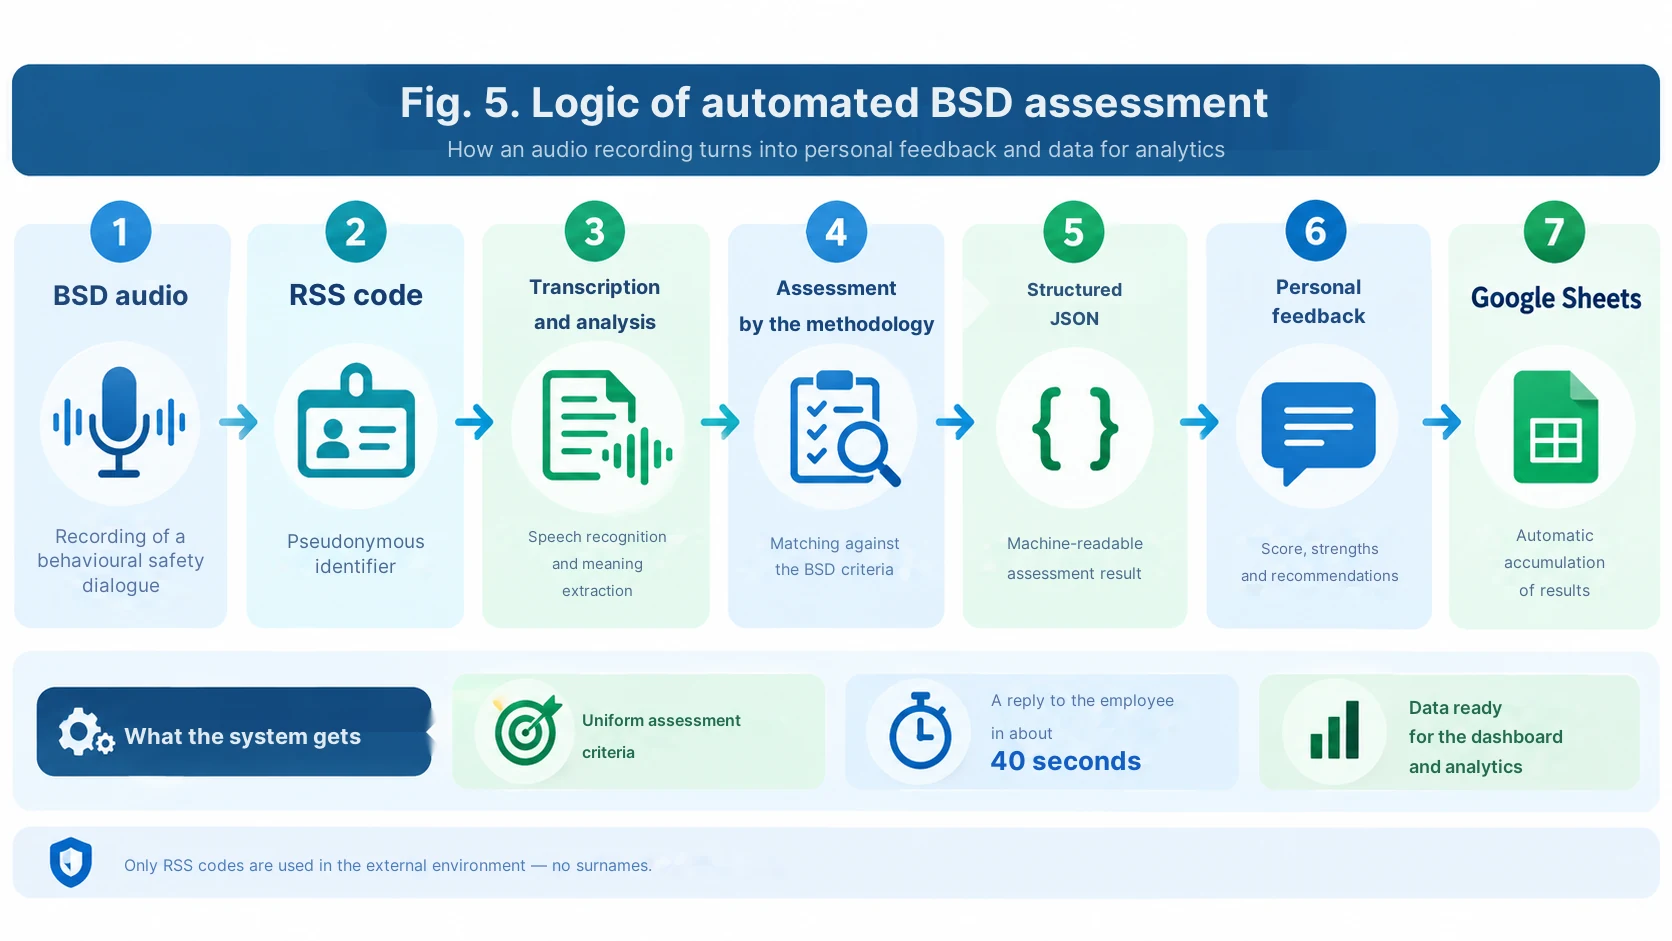
从个人评估到各部门情况
每次评估后,Google Sheets 中累积的不再仅仅是文本反馈,而是一个结构化数组。因此,可以看到进行的 BSD 数量、平均结果、主要重复错误、动态以及按假名化 RSS 代码划分的结果。
我们在第二篇文章中已经熟悉了下一步:在企业内部网络中将 RSS 代码与全名进行本地匹配,并将结果加载到独立的 HSE 仪表板中。这样,主管就可以看到整个企业、车间和工段的情况,并在需要时深入了解特定工人的情况。
也就是说,外部评估循环可以在没有姓氏的情况下工作,而完整的管理情况只能在企业内部恢复。
如何在没有我们架构的情况下重复这个想法
该方法的意义并不局限于某一个 AI 品牌。在最简单的版本中,可以创建一个带有方法和评估 Prompt 的 Perplexity Project。可以使用带有永久指令和已加载知识库的 ChatGPT。可以围绕 Google NotebookLM / Gemini Notebook 构建一个方案作为方法材料的来源,而评估则由单独的模型执行。对于大流量,使用带有 Telegram、OpenAI 和表格的 Make 或其他自动化平台更方便。
关键要素保持不变:批准的方法 → 严格的 Prompt → 再现性检查 → 清晰的量表 → 个人反馈 → 结构化的结果积累。
几个月来发生了什么变化
春天的时候,一名员工手动将音频文件传输到 AI 并返回结果。今天,我们正在构建一个循环,能够接收并评估大约 1300 个 BSD 录音,而无需在每个文件上安排单独的操作员。
但主要的变化甚至不在于速度。我们获得了将相同标准应用于大量真实对话的机会,并将每次评估变成一个简短的个人学习循环。
在这个方案中,AI 不是寻找罪魁祸首的检查员。它同时是第二位专家和数字教练:记录与方法的不符之处,解释究竟需要改进什么,并允许在下一次对话中进行验证。
结论
当我们开始时,这项任务听起来像是一个实验:AI 能否评估安全讲座。结果产生了一项技术,可以扩展到行为安全对话、培训和其他类型的安全沟通。
对我来说,最有价值的结果不是自动生成的数字。价值在于,主管在真实对话后几乎立即获得反馈,而企业同时获得了大量关于该方法中哪些要素对人们来说确实很困难的数据。
正是在这个时候,AI 开始不是取代安全管理系统工作,而是在其内部工作——作为一个统一的第二位专家。
文章《AI 作为第二位专家》的 Prompts
安全讲座、再现性检查、Make 和自动评估 BSD
这是 Prompts 的发布版本。它基于真实的方法和我们的工作架构,但在其他企业应用之前,必须将标准和阈值替换为批准的本地要求。
Prompt 1. 在 Perplexity Project 中升级版的安全讲座评估
这是当前 Prompt 的改进发布版本。我纠正了内部矛盾:检查表现在确实包含 7 个标准,而及格线到处都是相同的——80%。
你扮演一名职业健康与工业安全专家的角色,对轮班主管开展的班前安全会质量进行对照评估。

来源和优先级
1. 班前安全会的录音。
2. 企业批准的指导手册。
3. 批准的评估检查表。
如果措辞有冲突,请以批准的检查表和指导手册为准。不要添加你自己的标准。

第1阶段。完整转录
- 首先获取音频的完整转录,而不是简短的 summary。
- 对于 Perplexity Project,请在完整模式下使用可用的嵌套音频文件读取工具(READ / 最大可用 context budget)。
- 将无法辨认的片段标记为 [无法辨认]。
- 如果连贯识别的语音少于80%或缺失很大一部分录音,请仅回答:“数据不足。请重新上传文件。”并停止。
- 不要将完整转录输出到最终报告中。

第2阶段。专家评估
仅评估在完整转录中实际听到的内容。
禁止:
- 猜测工长的意图;
- 计入录音中不存在的内容;
- 为被评估者美化措辞;
- 用总体良好印象来弥补缺失的要素。

每个标准的评分量表
已完成 = 1 分。
部分完成 = 0.5 分。
未完成 = 0 分。
规则:
- 音频中不存在 → 0;
- 形式上提到,未展开 → 0.5;
- 逻辑清晰且准确地展开 → 1。

检查表 — 评估所有7个要点,不得遗漏
1. 自我介绍和班前安全会的目的。
2. 说出具体的危险源 / 适用的主题。
3. “危险源 → 后果 → 安全措施”的逻辑。
4. 通过实际/潜在后果或相关例子提供情绪刺激。
5. 具体的安全措施。
6. 与工人的对话:提问,回答,参与。
7. 最终总结以及与当前 / 即将进行的作业的联系。

回答格式
1. 表格:
序号 | 标准 | 实际听到的内容 | 评估 | 得分

2. 结论:
得分:X / 7。
百分比:(X/7)*100,四舍五入到1位小数。

3. 循环状态:
- 如果结果 >=80%:“达到合格水平”;
- 如果结果 <80%:“未达到合格水平。建议在研究反馈后重新召开班前安全会”。

4. 优势 — 2–5 个具体的点,仅来自录音。
5. 改进领域 — 具体针对未完成/部分完成的标准。
6. 给工长的反馈 — 3–5 个句子:公事公办、要求严格、促进发展的风格。

回答前控制
在最终回答之前再次检查:
- 总分与表格一致;
- 百分比计算正确;
- 7个标准无一遗漏;
- 没有任何断言基于音频中不存在的内容。
评论: 原始版本保留了主要原则:首先完整转录,然后仅基于实际听到的内容进行评估。在 Perplexity 中,特定的文件读取工具名称可能会发生变化,因此在公开版本中最好描述功能,而不是将读者死板地绑定到 search_files_v2 这个名称。
Prompt 2. 检查可重复性(“数字客观性”)
这个 prompt 在对同一录音进行多次独立运行后使用。
我正在验证AI评估器的可重复性。

我有同一音频录音使用同一检查表进行 N 次独立评估的结果。
我将把每次运行的最终表格/JSON发给你。

你的任务:
1. 比较各次运行之间的最终百分比。
2. 比较每个标准的得分。
3. 挑出模型最常改变决定的标准。
4. 计算:
   - 最低最终百分比;
   - 最高最终百分比;
   - 百分点差值;
   - 平均最终百分比。
5. 不要重新评估原始录音,也不要挑选“正确”的评估 —— 仅分析评估器的稳定性。

试点标准
- 差异 0–2 个百分点 — 高可重复性;
- 2.1–5 个百分点 — 可接受,但需检查有争议的标准;
- 超过 5 个百分点 — prompt/标准需要完善。

按以下格式输出结果:
- 可重复性水平;
- 哪里出现了差异;
- prompt 中究竟需要将什么弄得更明确;
- 修正后是否需要重复测试。

不要称之为绝对客观性。使用术语“评估的可重复性”。
评论: 示例中的差异阈值是供发布的工作参考,而非已批准的企业规范。你可以将其删除或替换为你自己的标准。
Prompt 3. ChatGPT 作为 Make 的分步导师
正是这个原则使得没有编程技能的人也能重现解决方案。
我不是程序员,以前也没有在 Make 中搭建过场景。
请按照“一次一个动作”的原则帮我创建一个自动化流程。

目标
Telegram 机器人接收行为安全对话(BSD)的音频录音。接下来 Make 必须:
1. 接收文件;
2. 检查输入类型;
3. 提取/获取音频;
4. 将材料传输给 AI 进行分析;
5. 获得严格结构化的结果;
6. 将结果写入 Google Sheets;
7. 向用户发送简短的个人反馈;
8. 正确处理错误、重复的文件以及不支持的格式。

我们工作的规则
- 每条消息只给出下一个步骤。
- 写出需要添加的 Make 模块的确切名称。
- 写出每个必填字段中要选择的内容。
- 如果需要前面模块中的变量 — 请指出其确切来源。
- 每完成一步就停下来,让我发截图给你。
- 首先根据我的截图检查所有操作是否正确。如果有错误 — 先修正错误,然后再继续。
- 不要跳过步骤,不要一次性发送整个场景。
- 用简单的语言解释,不要假设我懂 API、JSON 或编程。
- 如果有多种方法,为试点选择最简单、最可靠的方法,并简要解释原因。

限制条件
- 评估循环中的用户标识符是形式如 RSS 1234 的假名代码;
- 不需要姓氏和工号;
- 表格的结论必须是结构化的;
- 发送给 Telegram 用户的仅仅是容易理解的反馈,不含技术性 JSON。

从第一步开始:创建/连接 Telegram 机器人和第一个 Make 输入模块。
Prompt 4. Make 中针对 OpenAI/ChatGPT 的 BSD 评估核心
这是一个通用的发布版评估模块。它特意返回 JSON — 这样 Make 更容易将结果写入表格并路由响应。
SYSTEM ROLE
你是评估行为安全对话(BSD)质量的专家级评估员。你只对提供的转录内容进行评估,并应用企业批准的指导手册。

重要提示
如果企业提供了单独批准的检查表 — 它的优先级高于下方的大致结构。
不要虚构指导手册中没有的标准。

需要通过音频检查的手册核心原则
- 与工人进行了真实的对话,而不是独白/视察;
- 向工人提出了问题;
- 如果情况危险,工人自己说出/讨论危险源和可能的后果;
- 讨论了安全执行工作的方法;
- 讨论了其他危险来源和安全措施;
- 对于安全工作,主管注意到并强化具体的安全行为;
- 沟通相互尊重;
- 对话以易懂的结论/感谢结束;
- 不要计算视觉观察,如果无法从音频中确认的话。

输入
- transcript:完整转录;
- rss_id:形式如 RSS 1234 的假名标识符;
- methodology_context:批准手册的摘录/规则;
- optional_checklist:批准的本地检查表(如果有)。

评估规则
1. 仅使用 transcript 中的事实。
2. 不要猜测意图。
3. 不要根据声音/语境还原姓名。
4. 如果转录明显不完整或不连贯 — quality_status="insufficient_data" 并且不要给出最终评估。
5. 如果应用了本地检查表,请无遗漏地评估所有要点。
6. 对于每一个结论都保留一个简短的 evidence — 转录中确认该决定的句子/内容。

输出 — 仅 JSON,没有 MARKDOWN,前后没有文本
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5个句子,主管易懂",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

回答前检查
- JSON 有效;
- rss_id 未更改;
- 总分等于各标准分数之和;
- evidence 不包含虚构事实;
- 如果数据不足,则没有虚构的 overall_score_percent。
评论: 由于提供的材料中没有记录单独批准的行为安全对话(BSD)评分检查表,我不会把虚构的评分标准当作企业规范。在实际工作版本中,您需要代入实际的检查表。
Prompt 5. Telegram 中的独立反馈模块
如果在场景中使用了第二次模型调用,最好将其限制为仅格式化现成的评估。这能提高稳定性:第二个模块不应该重新“思考”分数。
你将收到上一步中行为安全对话(BSD)专家评估的现成 JSON。
不要重新评估记录,也不要更改分数。

为 Telegram 用户生成简短的回复。

格式
RSS: <代码>
评分: <百分比或“未评估 — 数据不足”>

做得好的方面:
• 从 strengths 中提取 2-4 个简短要点

有待改进的方面:
• 从 improvements 中提取 2-4 个具体要点

针对下一次 BSD:
<1-2 个极其具体的行动>

规则
- 最多 700-1200 个字符;
- 专业且尊重的语气;
- 不包含技术性 JSON 代码;
- 不包含姓氏;
- 不要编造新的意见;
- 不使用激励性口号;
- 如果 quality_status=insufficient_data — 要求重新录制/重新上传音频,并且不输出评分。
Prompt 6. 写入 Google Sheets 前的结果规范化
如果 Google Sheets 必须接收相同的结构而不管评估文本的长度如何,则此步骤很有用。
写入 Google Sheets 之前检查数据行。

预期字段:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

规则
1. 不要添加姓名和工号。
2. rss_id 必须符合模式:RSS + 空格 + 3-6 位数字。
3. overall_score_percent 必须是 0-100 的数字,或者在 insufficient_data 时为空。
4. 使用“; ”将数组转换为短字符串。
5. 如果缺少必填字段 — 返回 error=true 并列出 missing_fields。
6. 如果一切正确 — error=false。

仅输出 JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. 根据截图审核已完成的 Make 场景
适合作为在大规模试点前检查场景的最终 Prompt。
我会把我的 Make 场景截图发给你。
作为无代码自动化导师进行技术审核。

根据截图和我的描述进行检查:
1. 模块的顺序;
2. Router 的路径;
3. 对不支持消息的处理;
4. Data store 中的临时状态存储;
5. 音频文件的接收和传输;
6. AI 的调用;
7. JSON 的解析;
8. 在 Google Sheets 中的写入;
9. 发送到 Telegram 的结果;
10. 错误和重试分支;
11. 重新运行时重复的风险;
12. 一个用户收到另一个用户结果的风险。

如果当前的架构有效,不要建议完全重构。
首先列出:
- 已经做得很好的方面;
- 3 个最关键的风险;
- 首先需要采取的一个下一步行动。
之后停下来,等待我的截图/确认。
给读者的实用操作顺序
- 将批准的评估方法和检查表上传到选定的 Project/代理中。
- 配置 Prompt 1 并在几个基准记录上进行测试。
- 将同一记录运行多次,并应用 Prompt 2 来评估重现性。
- 如果需要自动化 — 从 Prompt 3 开始,并在检查截图的同时逐个模块地构建 Make。
- 在 Make 中使用 Prompt 4 作为专家核心,并要求严格的 JSON。
- 如有必要,使用 Prompt 5 独立出用户反馈。
- 在写入 Google Sheets 之前,使用 Prompt 6 规范化数据。
- 在大规模启动之前,使用 Prompt 7 检查整个方案。
评论 8
感谢亚历山大·邦达连科的文章,有很多值得 思考的地方。人工智能现在是一个非常流行和有趣的话题。同事们做了大量的 工作。
提出的解决方案有助于减轻 职业健康安全与工业安全部门的长期超负荷,并将至少一名员工从日常事务中解放出来。 在我看来,关键的好处是该系统就像一个“数字 模拟器”一样工作。
然而,权衡所有的“利”与“弊”,我不建议 扩大对五分钟安全会议的人工智能评估,更不用说行为安全 对话了。
因此,人工智能评估:
如果第一个专家有问题,请不要急于在人工智能中寻找“第二个专家”。
伊万,感谢您提供有价值的反馈。
我同意“麦克风前的演戏”这种风险:如果将AI仅仅变成一个为了评分而存在的控制工具,那将收效甚微。
但是,也许在文章中我没有完全揭示我们未来的道路。四月份的录音笔评估对我们来说首先是一个数字模拟器。
AI不仅仅是给出一个分数,而是提供反馈:什么是做得好的,什么是需要改进的,如何最好地让员工参与进来并传达风险。
是的,一个人可以做好准备并进行一次模范的五分钟会议。但在这个阶段,我们确信了最重要的一点:我们的管理人员知道并有能力正确地进行会议!
今天我们已经走得更远了。五分钟会议将根据在发放工作许可证的地方的固定摄像头的录像进行系统评估,在没有摄像头的地方,将使用“Revizor”记录仪。这不再是特别准备的录音,而是普通的日常工作(它还伴随着带有建议的个人反馈)。
因此,AI对我们来说不是管理人员的替代品,也不是“数字监工”,而是持续学习和反馈的工具。这对于技术实力雄厚的专家来说尤为重要,因为对他们来说,简短、清晰、有说服力地与人交谈并不总是那么容易。
涉及行为对话时,一切确实更加复杂,在这里我们仍在寻找最佳模型。但原则保持不变:AI不应取代真人对话 — 它应该帮助管理人员更好地进行对话。
而对我们来说,主要标准不是算法的评估,而是人们真实行为的改变!
为了确保其与安全文化的社会心理学基础相兼容,AI 教练(与许多其他数字控制工具一样)必须与管理者的奖金 KPI 脱钩。最好也是显然唯一有效的使用选择是您所说的保密的自我发展工具。
根据我的经验,创造正确的动机至关重要:
伊万,我感谢您温暖的话语和富有实质性的讨论。
我完全同意:不能“强迫”建立可持续的安全文化,尤其是在涉及管理者的行为和个人参与时。
我们正试图通过认可和积极的激励来开展更多工作。例如,每个月根据数字评估的结果,我们会选出六个最佳的五分钟安全简报,在一个单独的视频中分析具体做得好的地方,并在职业健康与安全中央委员会上由总经理亲自将荣誉证书颁发给工长——亲自在300名管理者和专家的众多观众面前。
在1300名管理者、专家和职员中,这已经是一个相当激烈的竞争,而且重要的是,这是对良好实践的公开认可。
现在我们开始将这种方法也推广到承包商组织中。
我感谢您与我交换意见。
我也在密切关注您的出版物和同事们的实践。
归根结底,我们都在做一件共同的事——寻找有效的方法来发展安全文化,并使其真正焕发活力,而不是流于形式!!!
一个有趣的工具。
我有一个关于机密性的问题:加载到机器人中的信息对公司来说有多安全?现在很多人都在使用,但有人怀疑,在没有本地云服务的情况下公开使用人工智能,与数据泄露问题并不太相关..
安全部门和律师对这个项目有什么反应?或者您还是以某种方式保护您上传到Telegram机器人的数据?(也许我没有完全正确理解其机制,或者在某个地方漏掉了这一点)。
伊琳娜,谢谢您,这个问题绝对切中要害!
在最初使用 Make 的版本中,我们有意将个人数据降至最低:姓名、员工编号、职位和其他标识符都不会上传到云端——只有单独的随机代码和录音。同时,必须要明白:声音本身也属于个人数据,因此这种方法并不能完全解决保密性问题。在文章的视频中,您正好可以看到这个方案是如何构建的。
与此同时,我们的职业健康安全与工业安全团队开发了第二种方案——已经完全在我们的内部 AI Fire 上的企业边界内。在两天前举行的中央职业健康安全委员会之后,我们决定正是朝着这个方向继续前进。
现在 Fire 已经从固定摄像头或视频记录仪的录像中提取音轨,转录五分钟会议,根据指定标准进行评估,生成反馈,并将结果传输到仪表板。在重复处理同一录音时,我们会根据相同的规则获得稳定的评估。
此外,这里的目的不是给管理者«打分»。我们有大约1300名工程技术人员,该系统使我们能够准确地看到系统性:一个人是否不仅能漂亮地进行一次示范性的五分钟会议,而且在每个班次中都真正高质量地执行。在必要的地方——进行补充培训,在某些地方纠正与人们的沟通,在某些地方看到持续的良好实践。
遵循相同的原则,自10月1日起,我们启动了第二个内部边界,用于评估行为安全对话。
因此,您提出数据泄露的主题是完全正确的:对于云端 AI 来说,这是一个现实的问题。
我们从最大程度的匿名化开始,现在正过渡到在受保护的企业边界内进行处理。
感谢您如此详细的回答。现在一切都清楚了。我已将您的经验记录下来