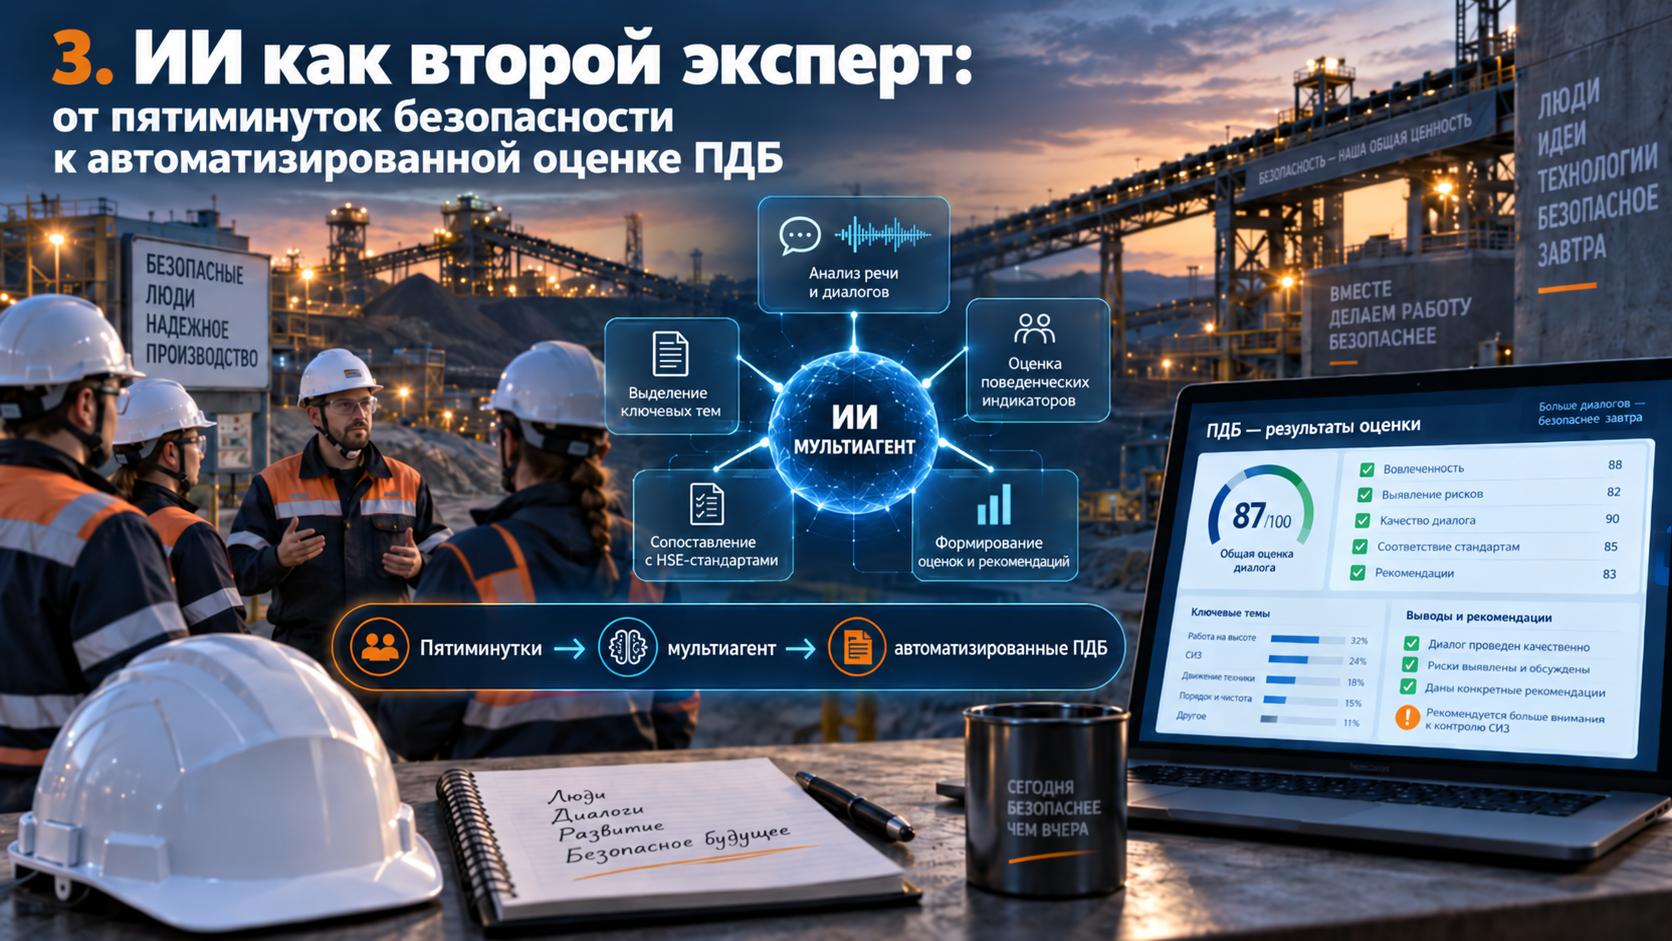
AI를 두 번째 전문가로: 안전 미팅에서 자동화된 BSD 평가까지
5분 안전 미팅 → 디지털 평가 → Make → 자동화된 행동 기반 안전 대화
핵심 아이디어: AI는 관리자나 안전 전문가를 대체하지 않습니다. 동일한 기준을 적용하고, 개인화된 피드백을 제공하며, 수백, 수천 건의 실제 대화에 대한 품질 관리를 확장할 수 있게 해주는 단일한 '제2의 전문가'가 됩니다.
애초에 실시 여부가 아닌 대화 내용을 평가하기 시작한 이유
산업안전보건 및 산업안전 분야에서는 사실을 집계하기 쉽습니다. 5분 안전 미팅을 실시했는지, 행동 기반 안전 대화를 등록했는지, 카드를 작성했는지 등입니다. 하지만 관리자가 대화 자체를 얼마나 양질로 이끌었는지, 목표를 달성했는지 답하는 것은 훨씬 더 어렵습니다.
우리의 방법론에서 5분 안전 미팅은 5~10분간 진행되는 교대조 회의의 필수적인 부분입니다. 관리자는 구체적이고 시의적절한 주제 하나를 다루고, 위험 → 결과 → 안전 조치라는 명확한 연결 고리를 구축해야 합니다. 이때 작업반장의 독백뿐만 아니라 질문, 답변, 토론 참여 등 작업자와의 대화도 중요합니다.
따라서 초기 과제는 '기록 유무 확인'이 아니라, '이러한 대화의 실제 품질을 동일하게 평가하고 관리자에게 구체적인 피드백을 제공하도록 AI를 학습시킬 수 있는가?'였습니다.
1단계. 인공지능보다 방법론이 먼저다
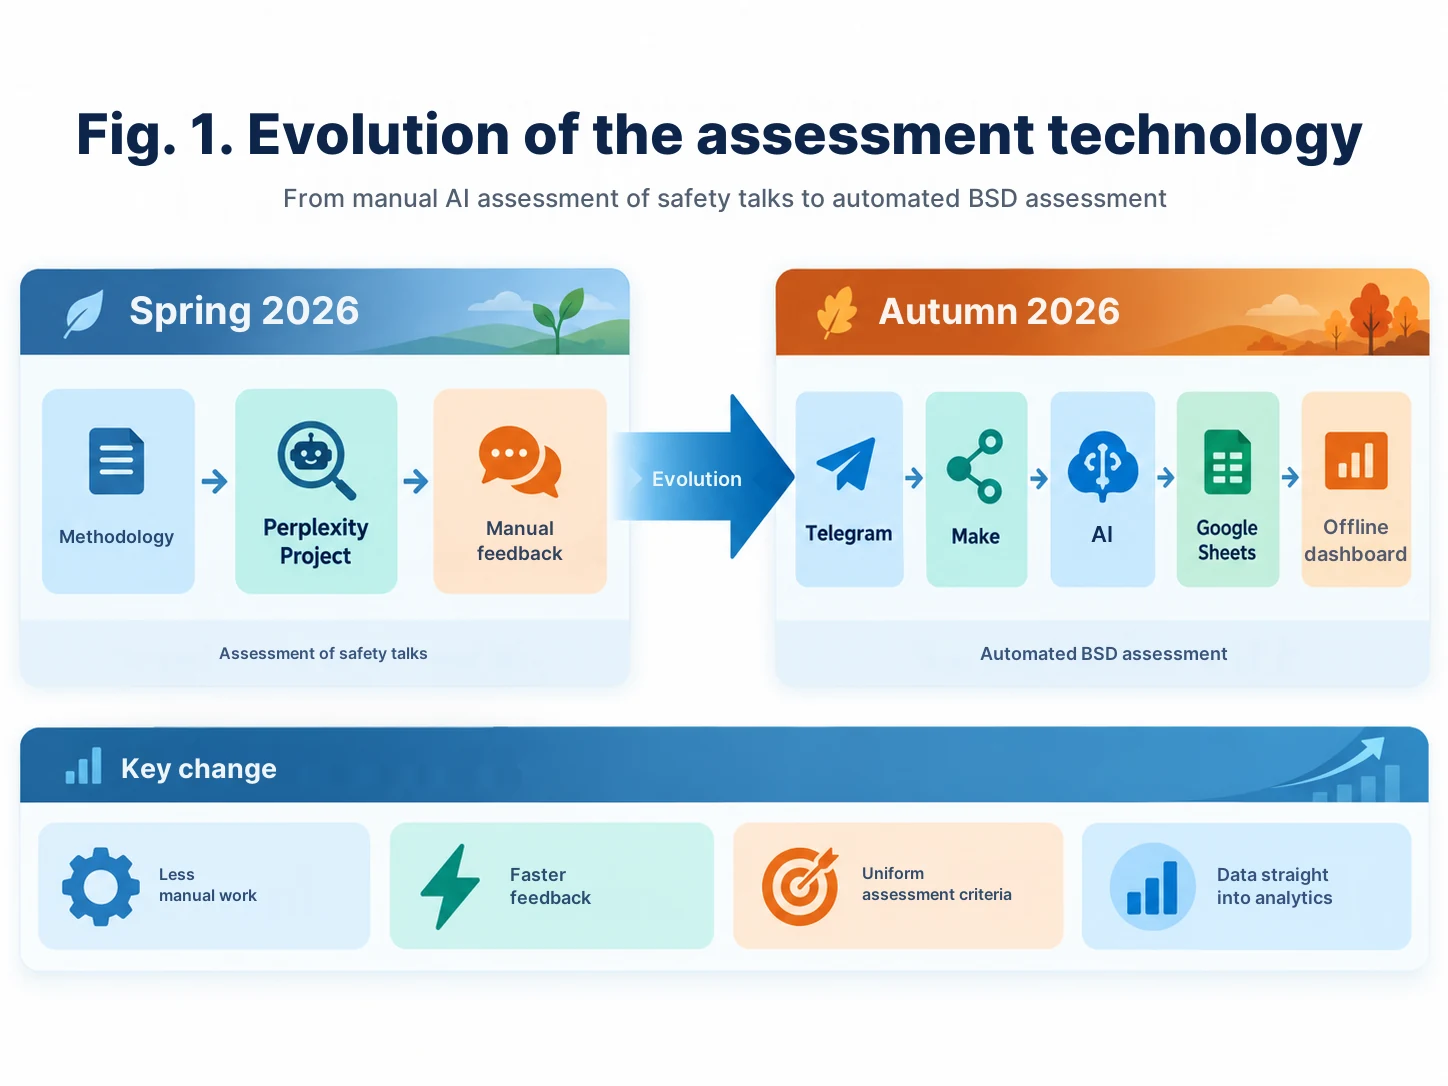
2026년 봄, 우리는 5분 안전 미팅부터 시작했습니다. AI 평가를 도입하기 전에 5분 안전 미팅을 올바르게 진행하는 방법에 대한 방법론적 지침과 교육 비디오를 먼저 준비했습니다. 디지털 평가자는 그 이후에 도입되었습니다.
첫 번째 작업 환경으로는 Perplexity Space를 사용했는데, 현재 Perplexity에서는 유사한 환경을 Project라고 부릅니다. 이 프로젝트에 방법론 가이드와 평가 체크리스트를 업로드하고, 모델을 위한 엄격한 Prompt를 별도로 준비했습니다.
Prompt의 과제는 일반적인 '발표 평가' 요청과는 근본적으로 달랐습니다. AI는 오디오에서 실제로 들린 내용만 인정하도록 허용되었습니다. 요소가 없으면 0점, 형식적으로만 언급되면 부분 수행, 논리적이고 완전하게 설명되면 수행 완료로 처리했습니다.
현재 체크리스트에는 일곱 가지 기준이 있습니다. 소개 및 목표, 구체적인 위험, '위험 - 결과 - 안전 조치' 논리, 정서적 자극, 안전 조치, 작업자와의 대화, 최종 요약 및 수행 중인 작업과의 연관성입니다.
Prompt 1 — Perplexity Project를 위해 수정된 버전의 Prompt는 부록을 참조하십시오.
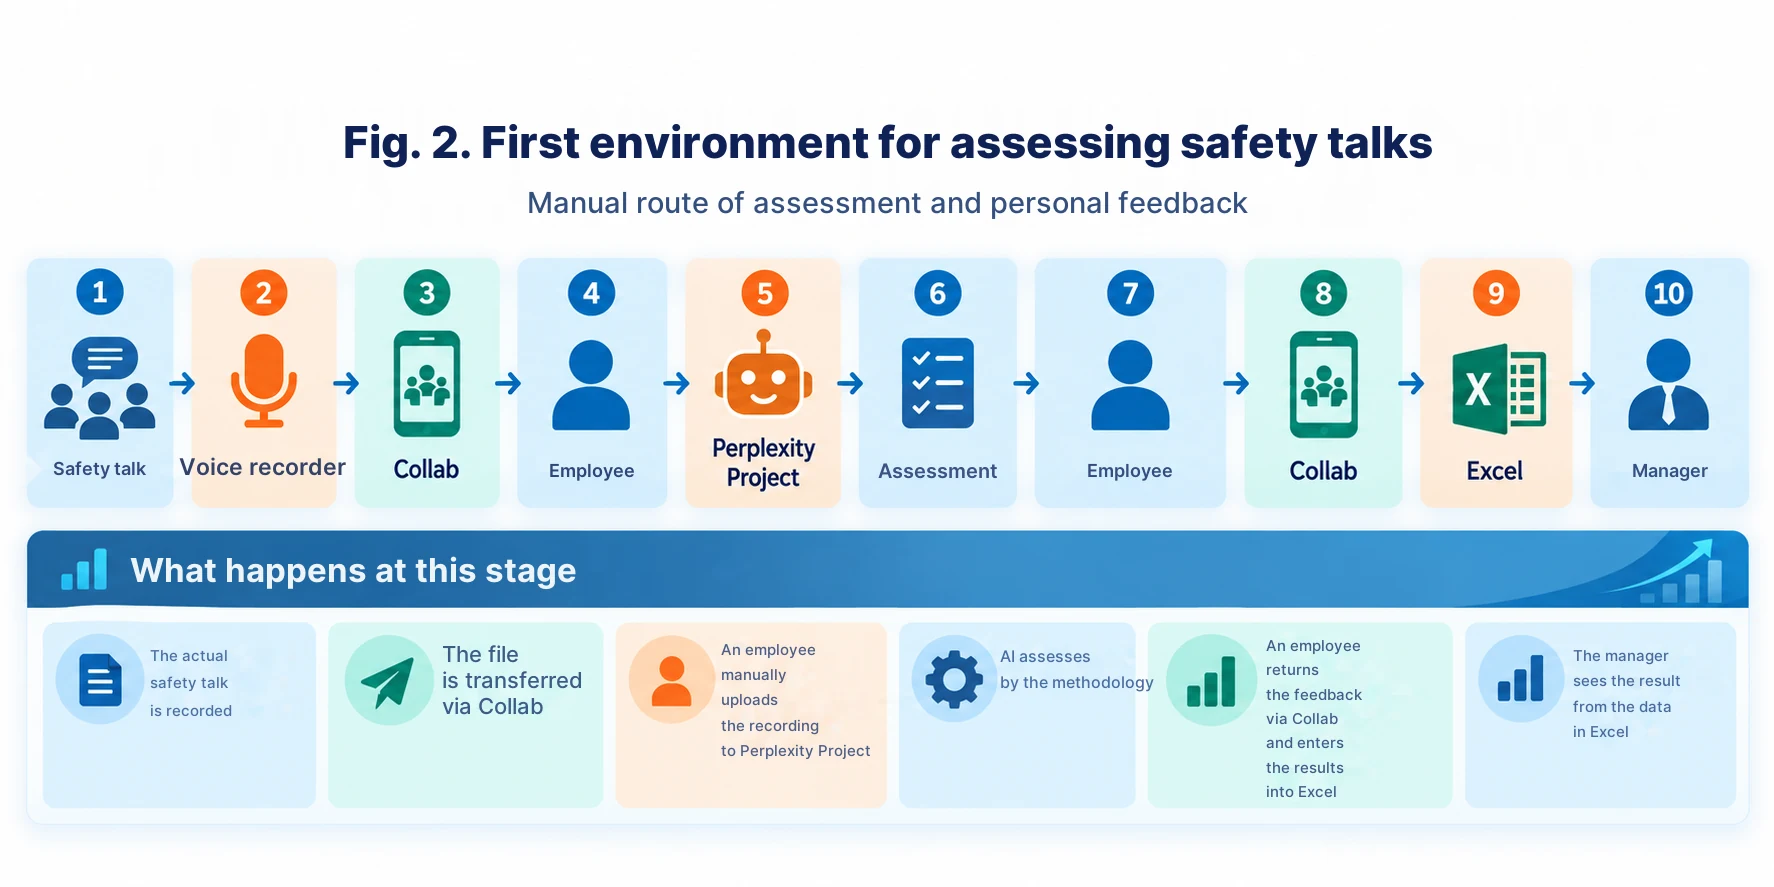
아직 수동이었던 첫 번째 평가 체계의 모습
교대조 감독관은 진행된 5분 안전 미팅을 녹음기에 녹음했습니다. 사내 애플리케이션인 Collab을 통해 녹음 파일이 지정된 담당자에게 전달되었습니다. 담당자는 오디오를 Perplexity Project에 업로드하고 평가를 받은 후, 역시 Collab을 통해 개인화된 피드백을 교대조 감독관에게 돌려주었습니다.
동시에 결과는 Excel에 부서, 관리자, 평가 점수, 시도 횟수 등의 항목으로 기록되었습니다. 이 표를 바탕으로 부서별 평균 점수, 변화 추이, 반복 주기 횟수 등 간단한 분석 자료를 만들었습니다.
우리는 실무 주기의 합격 기준을 80%로 설정했습니다. 결과가 그보다 낮으면 관리자는 AI의 지적 사항을 반영하여 다음 5분 안전 미팅을 진행했습니다. 이는 단순한 통제를 넘어 실제 작업 현장에서 이루어지는 개별 훈련의 효과를 낳았습니다.
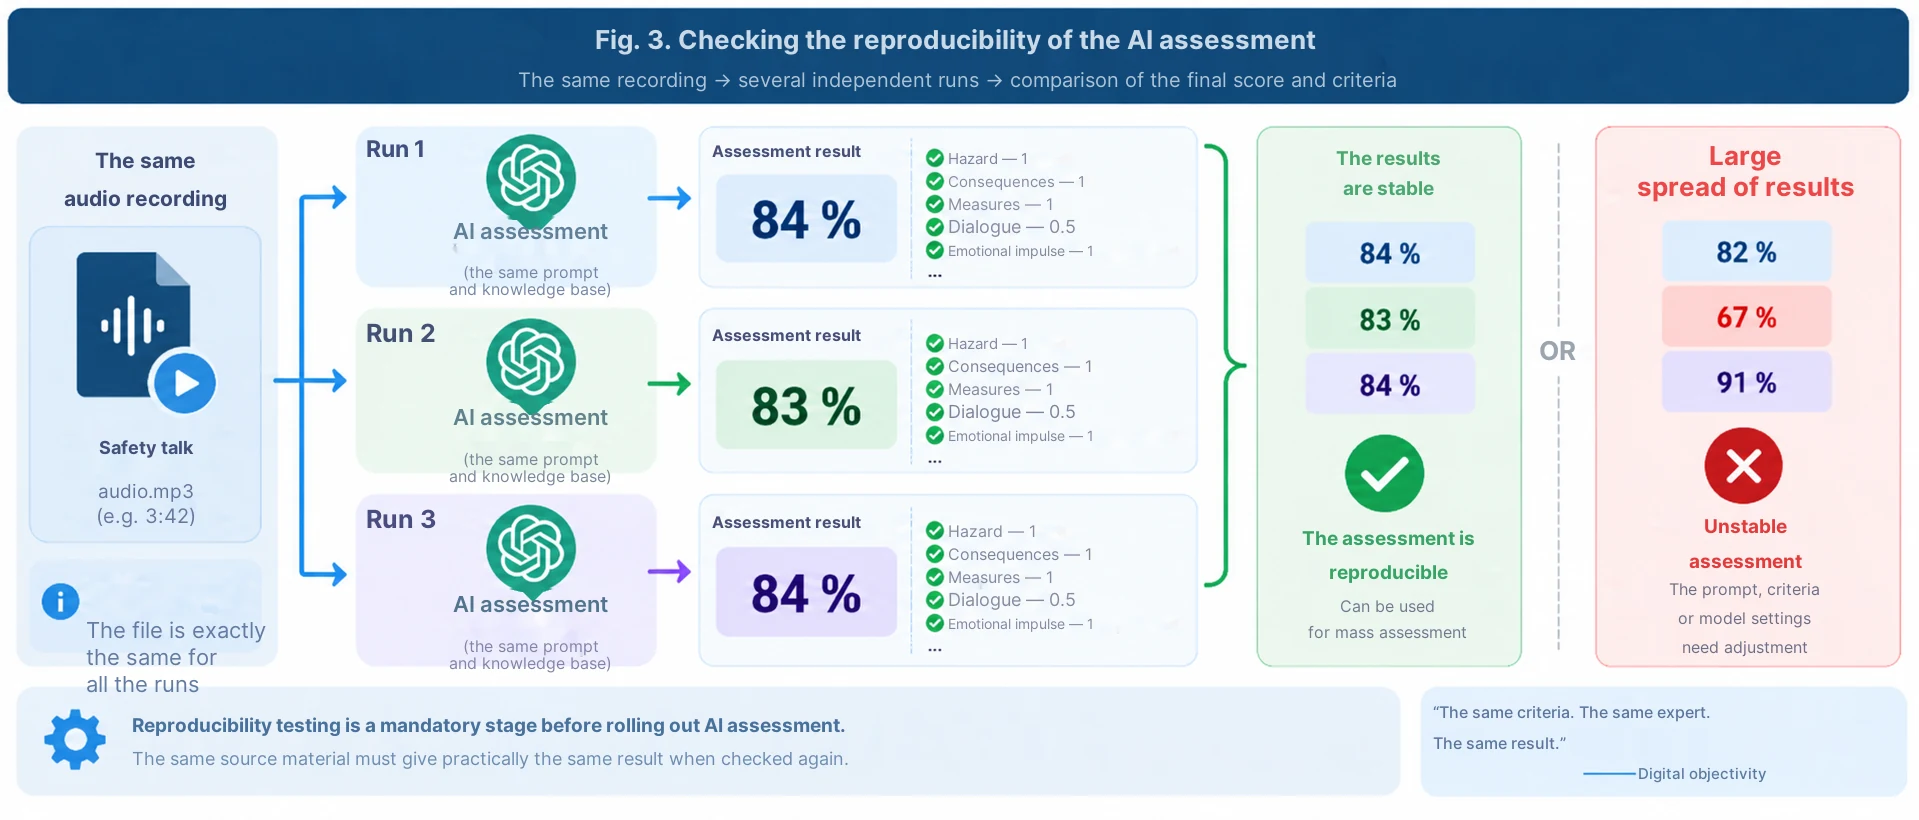
사람만 확인한 것이 아니다 — 먼저 AI 자체를 검증했다
이는 전체 프로세스에서 제가 생각하는 가장 중요한 요소 중 하나입니다. 우리는 일부러 동일한 오디오 녹음 파일을 여러 번 평가에 보냈습니다. 만약 같은 자료가 오늘 82점을 받고, 1분 뒤 65점을 받으며, 그 다음에 91점을 받는다면, 그러한 디지털 전문가는 아직 사람을 평가할 준비가 되지 않은 것입니다.
그래서 우리는 재현성을 확보하기 위해 노력했습니다. 동일한 녹음 파일은 동일하거나 거의 동일한 평가 결과를 내야 했습니다. 점수 편차가 눈에 띄게 커지면 Prompt를 수정하고, 기준을 구체화하며, 모호한 표현을 제거했습니다.
개인적으로 저는 이것을 '디지털 객관성'이라고 부릅니다. 이는 AI가 절대적인 진리를 가졌다는 의미가 아닙니다. 단일 전문가가 기분이나 개인적인 호감도, 혹은 오늘 평가를 진행하는 사람이 누구인지에 영향을 받지 않고 모든 사람에게 동일한 척도를 적용한다는 뜻입니다.
Prompt 2 — 평가 재현성 검증 프로토콜은 부록을 참조하십시오.
수동 체계가 더 이상 만족스럽지 않게 된 이유
파일을 받아 업로드하고, 결과를 기다렸다가 피드백을 반환하고 Excel에 점수를 입력하는 수동 방식은 파일럿 테스트 단계에서는 편리했습니다. 하지만 이러한 접근 방식에는 태생적인 한계가 있습니다.
처리 물량이 수백, 수천 개의 녹음 파일로 늘어나면, 우리는 평가 자체를 자동화하는 것이 아니라 평가를 둘러싼 새로운 행정 업무를 만들어내게 됩니다. 따라서 행동 기반 안전 대화(BSD)로 넘어갈 때의 목표는 다르게 설정되었습니다. 사람의 개입이 가치를 창출하지 못하는 기술적 프로세스 단계에서 사람을 배제하는 것입니다.
2단계. 행동 기반 안전 대화는 일반적인 5분 안전 미팅보다 복잡하다
행동 기반 안전 대화(BSD)는 단순히 짧은 발표가 아닙니다. 이 방법론은 실제 작업에 대한 관찰과 작업자와의 대화를 포함합니다. 관리자는 안전하거나 위험한 행동을 확인한 후, 질문을 통해 작업자 스스로 위험, 결과, 그리고 안전한 작업 수행 방법을 말하도록 유도하는 것이 중요합니다.
작업자가 위험하게 작업하는 경우, 대화의 핵심은 위험과 결과를 논의한 다음 안전한 작업 방식과 기타 위험 요소를 토론하는 것입니다. 작업자가 안전하게 작업하는 경우, 관리자는 올바른 행동을 발견하고 칭찬하여 이를 강화한 다음, 다른 안전 문제에 대해 논의하는 기회로 대화를 활용해야 합니다.
그렇기 때문에 BSD 평가 체계는 관리자의 말뿐만 아니라 실제 대화의 존재 여부도 확인해야 합니다. 질문을 던졌는지, 작업자가 대답했는지, 행동의 원인, 결과, 안전 조치 및 대화의 마무리가 제대로 이루어졌는지를 확인해야 합니다.
성명 대신 가명처리 식별자 사용
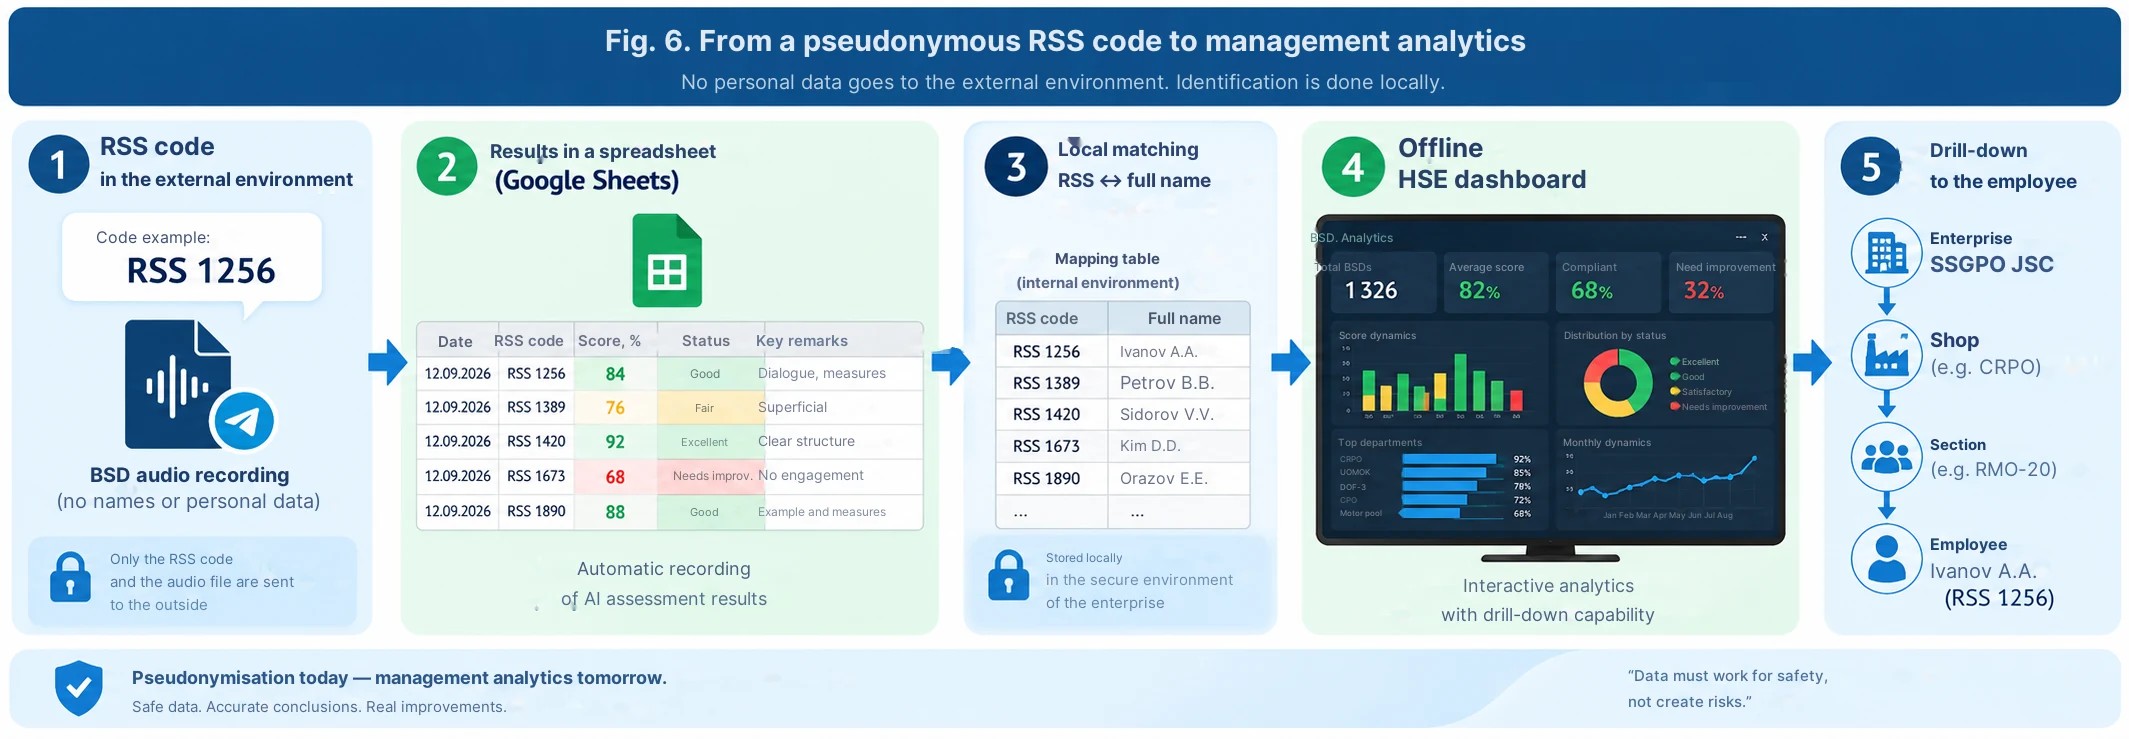
대규모 자동화 과정에서 우리는 식별 문제를 별도로 해결했습니다. ERGIS 사내 시스템 내부에서는 모든 참가자에게 RSS 1256과 같은 특수 코드가 부여됩니다. 이는 사번이나 성명이 아닙니다.
녹음을 시작하기 전에 관리자는 자신의 RSS 코드를 말한 후 PDB를 진행합니다. 대화 중에는 성명이나 사번을 언급할 필요가 없습니다. 'RSS 코드 ↔ 특정 직원'의 대응 관계는 사내 시스템 내부에 유지되며 이후 자체적인 분석에 사용됩니다.
이 경우 완전한 익명처리보다는 가명처리라고 부르는 것이 더 정확합니다. 오디오 파일에는 여전히 사람의 목소리가 남아있기 때문입니다. 하지만 자동화된 체계를 통과하는 개인 데이터의 양은 현저히 줄어듭니다.
작은 비밀: 나는 프로그래머가 아니다
새로운 솔루션의 아키텍처는 Make를 통해 구축했습니다. 저는 프로그래머가 아니며, 작업을 시작할 때 ChatGPT에게 이 사실을 솔직하게 말했습니다.
요청은 간단했습니다. "이 자동화를 구축하는 과정을 단계별로 안내해 줘. 한 번에 하나의 작업만 알려줘. 내가 Make에서 수행하고 스크린샷을 보낼게. 확인이 끝나면 다음 명령을 내려줘."
그 이후 과정은 정확히 그대로 진행되었습니다. ChatGPT가 어떤 모듈을 만들고 무엇을 채워야 할지 설명하면, 제가 작업을 수행하고 스크린샷을 보냈고, 확인을 받은 후 다음 단계를 안내받았습니다. Telegram 봇도 같은 방식으로 만들어졌고 전체 프로세스가 연결되었습니다.
이는 바이브 코딩(vibe coding)을 실천하며 얻은 저에게 매우 중요한 결론입니다. 전문가는 API나 Make의 구문을 미리 알 필요가 없습니다. 하지만 업무 프로세스와 사용자가 얻어야 할 결과를 잘 이해하고, 각 단계를 순차적으로 검증할 수 있어야 합니다.
Prompt 3 — 'Make를 통해 단계별로 안내해 줘'라는 시작 Prompt는 부록을 참조하십시오.
현재 진행되는 과정: Telegram → Make → AI → 결과
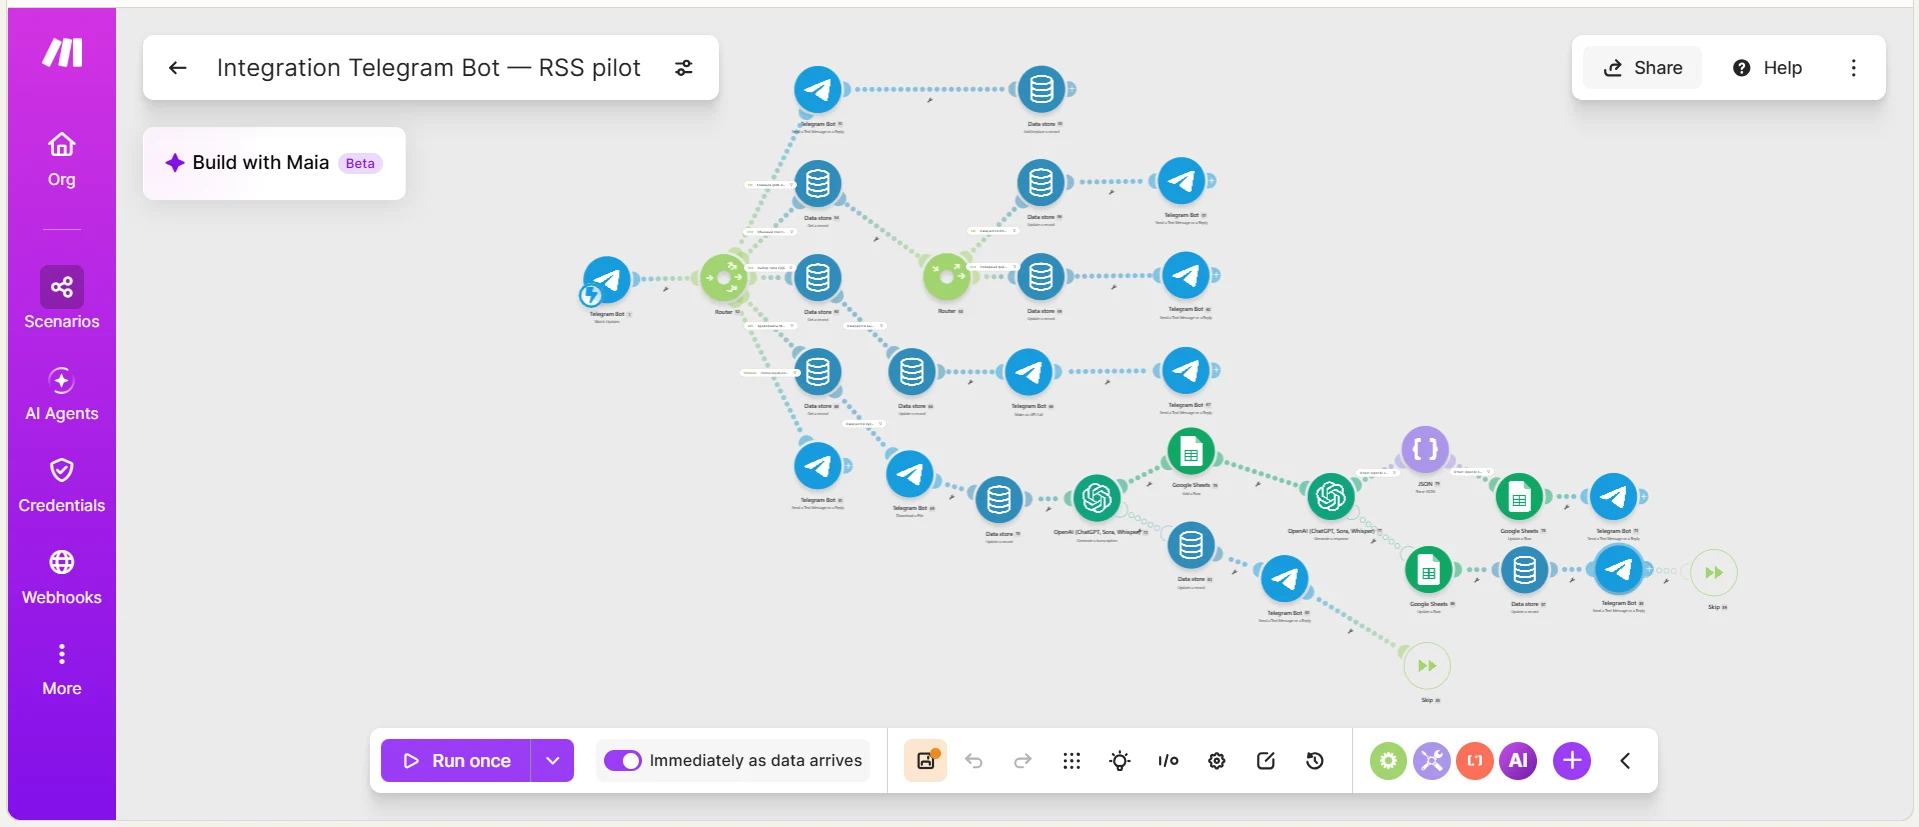
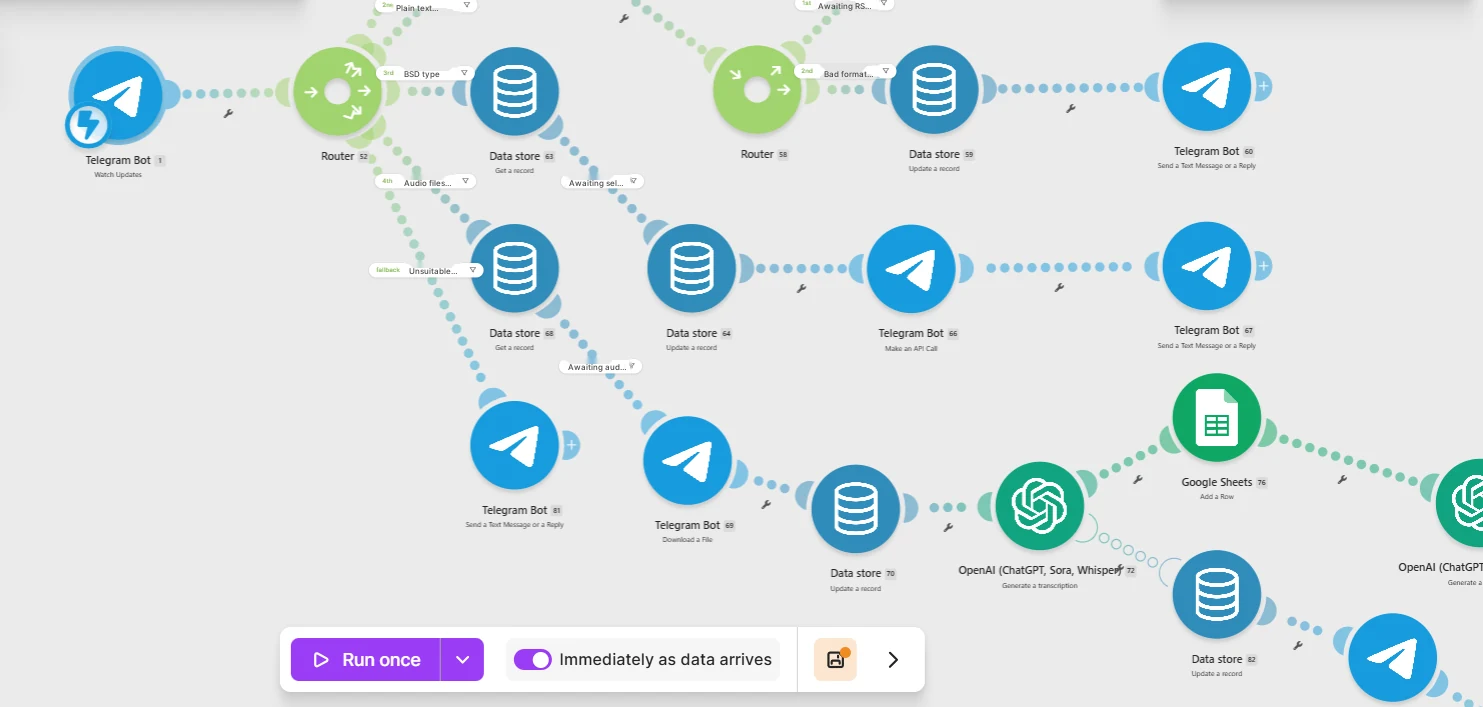
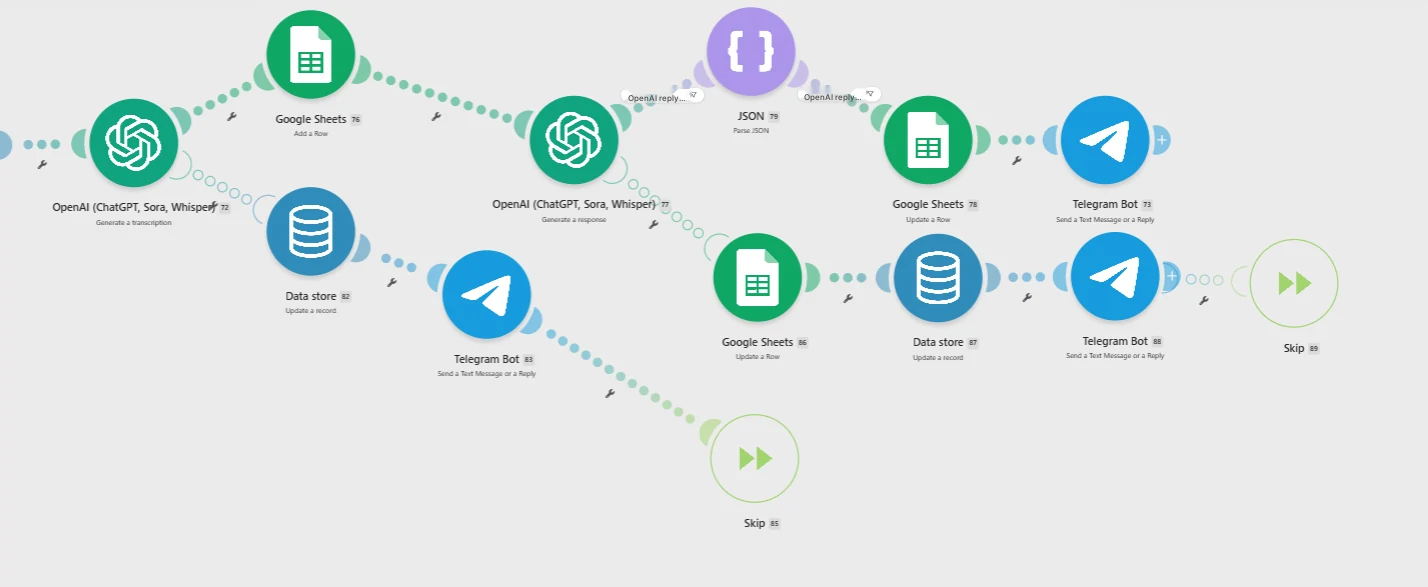
현재의 체계는 수동 작업자 없이 거의 자동으로 작동합니다. 관리자가 오디오 녹음 파일을 Telegram 봇으로 보냅니다. Make는 파일을 받아 입력 데이터를 확인하고 처리 경로를 실행합니다. AI는 지정된 방법론에 따라 녹음을 분석하여 평가와 피드백을 생성합니다. 결과는 사용자에게 반환되는 동시에 전체 분석을 위해 Google Sheets에 기록됩니다.
현재의 파일럿 단계에서는 피드백이 약 수십 초 내에 반환됩니다. 사용자가 보기에는 간단합니다. 오디오를 보내면 평가, 강점, 구체적인 실수, 그리고 다음에 수정할 사항을 받습니다.
Make의 흐름도를 보면 이 단순함 뒤에 Telegram, Data store, Router, OpenAI, Google Sheets, 검증 작업 및 사용자에게 보내는 응답 메시지 등 완벽한 라우팅이 숨어 있음을 알 수 있습니다.
이것은 멀티에이전트인가 아닌가?
저는 여기서 단순히 효과를 위해 '멀티에이전트'라는 단어를 사용하지는 않겠습니다. 실제로는 시나리오의 여러 부분이 각각 다른 기능을 수행하는 다단계 전문가 루프를 가지고 있습니다. 파일 수신 및 라우팅, 식별자 추출, 내용 분석, 전문가 평가, 구조화된 결과 생성, 스프레드시트 기록, 그리고 개인 피드백 등의 기능이 이에 해당합니다.
여러 개의 개별 모델 호출이 각기 다른 시스템 역할로 작동한다면(예: 하나는 대화를 분석하고, 다른 하나는 방법론과의 일치 여부를 제어하고 결과를 포맷팅하는 경우), 이는 멀티에이전트 또는 다중에이전트 논리로 간주할 수 있습니다. 단일 모델 호출이 모든 기능을 수행한다면, 다기능 AI 평가자라고 부르는 것이 더 정확합니다.
따라서 부록에서는 각 기능을 개별 에이전트라고 부르지 않고, 기능별로 프롬프트를 나누었습니다.
BSD 자동화 평가는 어떻게 구성되어 있는가
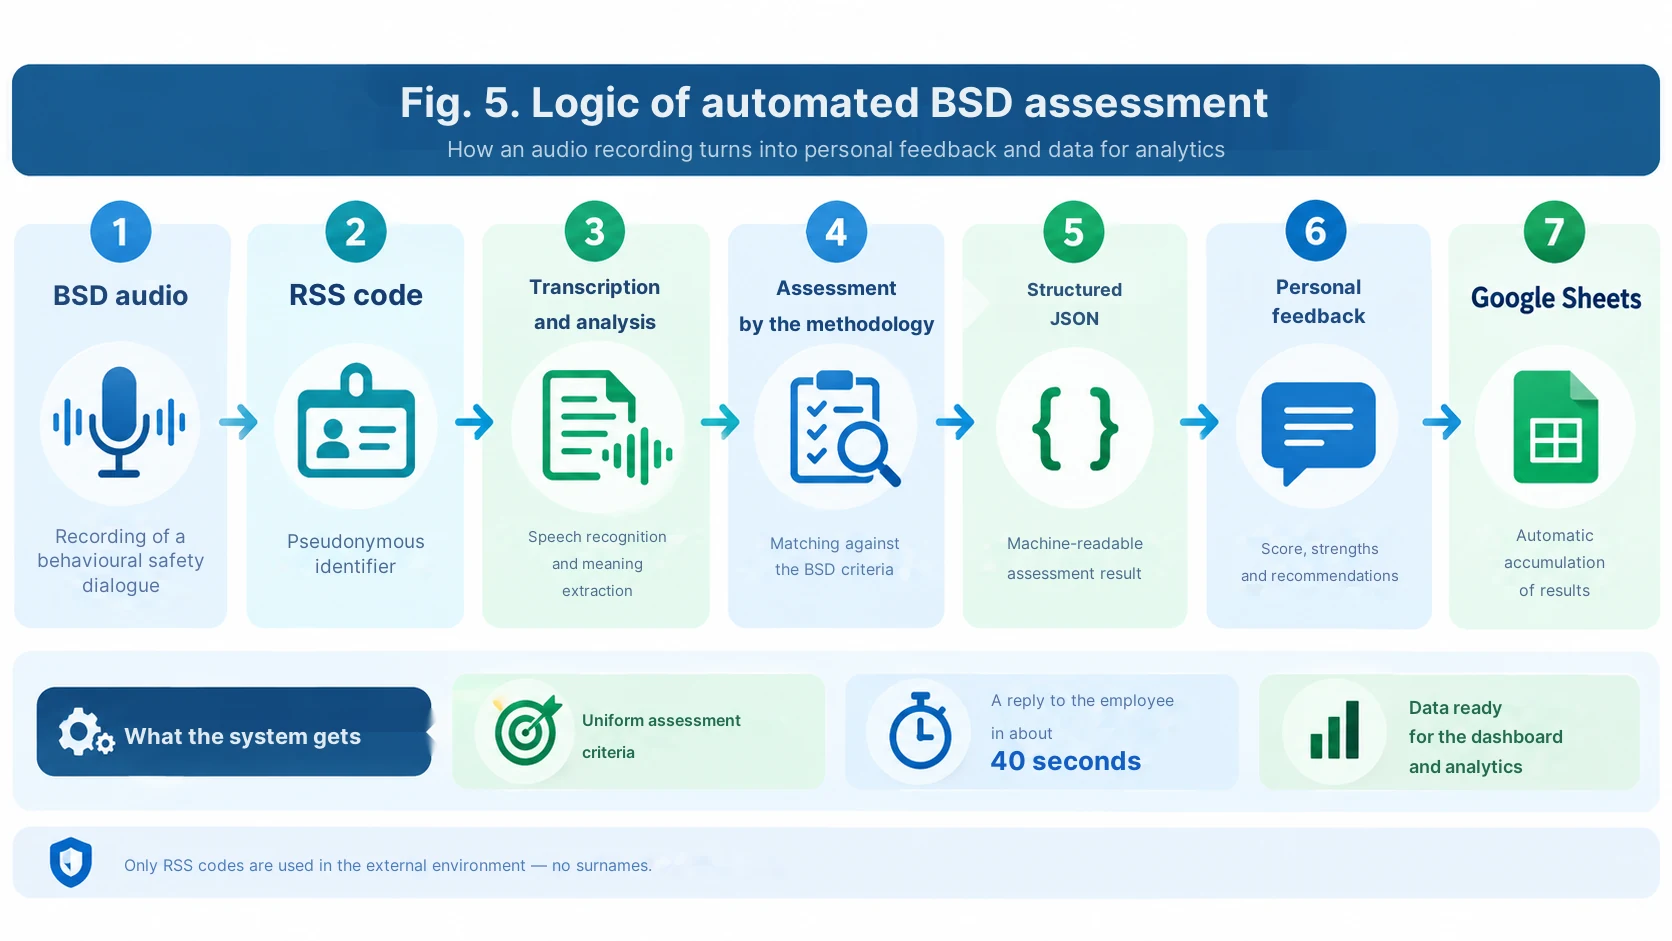
산업 시나리오에서는 두 가지 작업을 분리하는 것이 중요합니다. 첫 번째는 전문가 작업으로, 대화 내용을 방법론에 따라 엄격하게 평가하는 것입니다. 두 번째는 기술적 작업으로, Make가 이해하고 Google Sheets에 기록할 수 있는 형식으로 결과를 반환하는 것입니다.
그렇기 때문에 자동화를 위해서는 구조화된 JSON 응답이 편리합니다. 즉, RSS 코드, 최종 점수, 상태, 강점, 개선 영역, 짧은 피드백, 개별 평가 기준이 포함됩니다. 이러한 형식은 그럴듯하지만 예측할 수 없는 모델의 텍스트로 인해 자동화가 '망가질' 위험을 줄여줍니다.
이때 올봄과 동일한 엄격한 규칙이 유지됩니다. 녹음에 없는 내용은 인정하지 않기, 의도를 추측하지 않기, 감독관을 대신하여 정답을 지어내지 않기입니다. 전사가 불완전할 경우 지어낸 평가를 받아서는 안 되며, 녹음본을 다시 업로드하도록 처리해야 합니다.
Prompts 4–6 — BSD 평가, 구조화된 JSON 및 피드백 생성은 부록을 참조하십시오.
개인 평가에서 부서별 현황으로
각 평가 이후 Google Sheets에는 단순한 텍스트 피드백이 아닌 구조화된 데이터 배열이 축적됩니다. 따라서 실시된 PDB의 횟수, 평균 결과, 반복되는 주요 오류, 추이, 그리고 가명 처리된 RSS 코드별 결과를 확인할 수 있습니다.
다음 단계는 두 번째 기사에서 이미 익숙한 방식입니다. 사내망에서 RSS 코드를 성명과 로컬로 대조한 다음, 그 결과를 독립된 HSE 대시보드에 업로드하는 것입니다. 그러면 관리자는 기업, 작업장, 구역별 현황을 볼 수 있으며 필요시 특정 작업자의 상세 정보까지 파고들 수 있습니다.
즉, 외부 평가 루프는 이름 없이 작동할 수 있으며, 전체적인 관리 현황은 기업 내부에서만 복원됩니다.
우리의 아키텍처 없이 이 아이디어를 재현하는 방법
이 접근 방식의 핵심은 특정 AI 브랜드에 얽매이지 않는다는 점입니다. 가장 간단한 변형으로는 방법론과 평가 프롬프트가 포함된 Perplexity Project를 생성할 수 있습니다. 상시 지침과 업로드된 지식 기반을 갖춘 ChatGPT를 사용할 수도 있습니다. 방법론 자료의 출처로 Google NotebookLM / Gemini Notebook을 중심에 두고 스키마를 구축하되, 평가는 별도의 모델로 수행할 수도 있습니다. 대규모 트래픽의 경우 Telegram, OpenAI 및 스프레드시트를 연동하여 Make나 기타 자동화 플랫폼을 사용하는 것이 더 편리합니다.
핵심 요소는 동일하게 유지됩니다: 승인된 방법론 → 엄격한 프롬프트 → 재현성 검증 → 명확한 척도 → 개인 피드백 → 구조화된 결과 축적.
몇 달 동안 무엇이 변했는가
올봄에는 직원 한 명이 오디오 파일을 수동으로 AI에 업로드하고 결과를 반환받았습니다. 오늘날 우리는 각 파일마다 별도의 작업자 없이 약 1300개의 BSD 녹음본을 수신하고 평가할 수 있는 루프를 구축하고 있습니다.
하지만 주요한 변화는 속도에만 있는 것이 아닙니다. 저희는 다수의 실제 대화에 동일한 기준을 적용하고, 각 평가를 짧은 개별 학습 사이클로 전환할 수 있는 능력을 갖추게 되었습니다.
이 스키마에서 AI는 책임자를 찾는 감독관이 아닙니다. AI는 제2의 전문가이자 디지털 코치 역할을 동시에 수행합니다. 즉, 방법론과의 불일치를 기록하고, 정확히 무엇을 개선해야 하는지 설명하며, 다음 대화에서 이를 바로 확인할 수 있게 해줍니다.
결론
저희가 처음 시작할 때 이 과제는 'AI가 안전 미팅을 평가할 수 있을까'라는 실험에 가까웠습니다. 결과적으로 이 기술은 행동 기반 대화, 교육 및 기타 형태의 안전 커뮤니케이션으로 확장할 수 있는 기술이 되었습니다.
저에게 가장 가치 있는 결과는 자동화된 수치가 아닙니다. 진정한 가치는 관리자가 실제 대화 직후에 거의 즉각적으로 피드백을 받고, 기업은 방법론의 어떤 요소가 사람들에게 실제로 어려운지에 대한 대규모 데이터를 동시에 얻는다는 점입니다.
바로 이 지점에서 AI는 안전 관리 시스템을 대체하는 것이 아니라 그 시스템 내부에서 일관된 제2의 전문가로서 작동하기 시작합니다.
기사 '제2의 전문가로서의 AI'에 대한 프롬프트
안전 미팅, 재현성 검증, Make 및 BSD 자동화 평가
이것은 프롬프트의 공개용 버전입니다. 실제 방법론과 저희의 작업 아키텍처를 기반으로 하지만, 다른 기업에 적용하기 전에는 기준과 임계값을 승인된 현장 요건으로 교체해야 합니다.
Prompt 1. Perplexity Project에서의 개선된 안전 미팅 평가
이것은 현재 사용 중인 프롬프트의 개선된 공개용 버전입니다. 저는 내부 모순을 수정했습니다. 체크리스트는 이제 실제로 7개의 기준을 포함하며, 통과 기준은 모두 80%로 동일합니다.
당신은 교대조 감독관이 진행하는 툴박스 미팅의 품질을 평가하는 산업 보건 및 산업 안전 전문가 역할을 수행합니다.

출처 및 우선순위
1. 툴박스 미팅의 오디오 녹음.
2. 승인된 기업의 방법론 가이드라인.
3. 승인된 평가 체크리스트.
내용이 상충될 경우 승인된 체크리스트와 방법론을 따르십시오. 자체적인 기준을 추가하지 마십시오.

1단계. 전체 전사
- 요약본이 아닌 오디오의 전체 전사본을 먼저 확보하십시오.
- Perplexity Project의 경우, 전체 모드에서 첨부된 오디오 파일을 읽을 수 있는 도구(READ / 최대 가용 context budget)를 사용하십시오.
- 알아들을 수 없는 부분은 [알아들을 수 없음]으로 표시하십시오.
- 음성의 80% 미만이 일관되게 인식되거나 녹음의 중요한 부분이 누락된 경우 "데이터가 불충분합니다. 파일을 다시 로드하십시오."라고만 응답하고 중단하십시오.
- 최종 보고서에 전체 전사본을 포함하지 마십시오.

2단계. 전문가 평가
전체 전사본에서 실제로 언급된 내용만 평가하십시오.
금지 사항:
- 작업반장의 의도를 추측하는 것;
- 녹음에 없는 내용을 인정하는 것;
- 피평가자를 위해 표현을 개선하는 것;
- 누락된 요소를 전반적인 좋은 인상으로 보완하는 것.

각 기준에 대한 척도
충족 = 1점.
부분 충족 = 0.5점.
미충족 = 0점.
규칙:
- 오디오에 없음 → 0;
- 자세한 설명 없이 형식적으로 언급됨 → 0.5;
- 논리적이고 정확하게 설명됨 → 1.

체크리스트 — 7개 항목 모두 누락 없이 평가하십시오
1. 자기소개 및 툴박스 미팅의 목적.
2. 특정 위험 요인 / 현재 주제의 명명.
3. 위험 요인 → 결과 → 안전 조치의 논리.
4. 실제/잠재적 결과 또는 적절한 예시를 통한 감정적 자극.
5. 구체적인 안전 조치.
6. 작업자와의 대화: 질문, 답변, 참여.
7. 최종 요약 및 현재 / 예정된 작업과의 연계.

응답 형식
1. 표:
번호 | 기준 | 실제로 언급된 내용 | 평가 | 점수

2. 결과:
획득 점수: 7점 만점에 X점.
백분율: (X/7)*100, 소수점 첫째 자리까지 반올림.

3. 주기 상태:
- 결과 >=80%인 경우: "합격 기준 도달";
- 결과 <80%인 경우: "합격 기준 미달. 피드백을 검토한 후 툴박스 미팅을 다시 진행할 것을 권장함".

4. 강점 — 구체적인 2~5개 항목, 녹음 내용에서만 발췌.
5. 개선 영역 — 미충족/부분 충족 기준에 대해 구체적으로 작성.
6. 작업반장을 위한 피드백 — 3~5문장: 비즈니스적이고, 요구 수준이 높으며, 발전을 도모하는 어조.

응답 전 확인 사항
최종 응답 전에 다음 사항을 다시 확인하십시오:
- 총점이 표와 일치하는지;
- 백분율이 정확하게 계산되었는지;
- 7개 기준 중 어느 하나도 누락되지 않았는지;
- 오디오에 없는 내용을 바탕으로 한 진술이 없는지.
코멘트: 전체 전사본을 먼저 확보하고 실제로 언급된 내용에 대해서만 평가한다는 기본 원칙은 원본 버전에서 그대로 유지됩니다. Perplexity에서는 특정 파일 읽기 도구의 이름이 변경될 수 있으므로, 공개 버전에서는 독자를 search_files_v2라는 이름에 얽매이게 하는 것보다 기능을 설명하는 것이 더 좋습니다.
Prompt 2. 재현성("디지털 객관성") 검증
이 프롬프트는 단일 녹음을 여러 번 독립적으로 실행한 후에 사용됩니다.
나는 AI 평가자의 재현성을 검증하고 있습니다.

동일한 체크리스트를 사용하여 동일한 오디오 녹음에 대해 N번 독립적으로 평가한 결과가 있습니다.
각 실행의 최종 표/JSON을 제공하겠습니다.

당신의 임무:
1. 실행 간의 최종 백분율을 비교합니다.
2. 각 기준의 점수를 비교합니다.
3. 모델이 가장 자주 결정을 바꾸는 기준을 강조 표시합니다.
4. 다음을 계산합니다:
   - 최소 최종 백분율;
   - 최대 최종 백분율;
   - 퍼센트 포인트 범위;
   - 평균 최종 백분율.
5. 원본 녹음 자체를 재평가하거나 "올바른" 평가를 선택하지 마십시오 — 평가자의 안정성만 분석하십시오.

파일럿 기준
- 0~2%p 차이 — 높은 재현성;
- 2.1~5%p — 허용 가능하지만 논쟁의 여지가 있는 기준을 확인해야 함;
- 5%p 초과 — 프롬프트/기준의 수정이 필요함.

출력은 다음 형식으로 제공하십시오:
- 재현성 수준;
- 편차가 발생하는 위치;
- 프롬프트에서 구체적으로 더 명확하게 해야 할 사항;
- 수정 후 테스트를 반복해야 하는지 여부.

이것을 절대적인 객관성이라고 부르지 마십시오. "평가 재현성"이라는 용어를 사용하십시오.
코멘트: 예시에 있는 범위 임계값은 승인된 기업 표준이 아니라 게시를 위한 실무 지침입니다. 제거하거나 자체 기준으로 대체할 수 있습니다.
Prompt 3. Make를 위한 단계별 멘토로서의 ChatGPT
이것은 프로그래밍 기술이 없는 사람이 솔루션을 복제할 수 있게 해주는 바로 그 원칙입니다.
나는 프로그래머가 아니며 이전에 Make에서 시나리오를 구성해 본 적이 없습니다.
"한 번에 하나의 작업" 원칙을 사용하여 자동화를 구축하도록 도와주세요.

목표
Telegram 봇이 행동 기반 안전 대화(BSD)의 오디오 녹음을 수신합니다. 그런 다음 Make는 다음을 수행해야 합니다:
1. 파일 수신;
2. 입력 유형 확인;
3. 오디오 추출/수신;
4. 분석을 위해 자료를 AI에 전달;
5. 엄격하게 구조화된 결과를 수신;
6. 결과를 Google Sheets에 기록;
7. 사용자에게 짧은 개인 맞춤형 피드백 전송;
8. 오류, 중복 파일 및 지원되지 않는 형식을 올바르게 처리.

우리의 작업 규칙
- 메시지당 하나의 다음 단계만 제공하십시오.
- 추가해야 할 Make 모듈의 정확한 이름을 작성하십시오.
- 각 필수 필드에서 선택해야 할 항목을 작성하십시오.
- 이전 모듈의 변수가 필요한 경우 정확한 출처를 지정하십시오.
- 각 단계 후에 멈춰서 나에게 스크린샷을 보내달라고 요청하십시오.
- 내 스크린샷을 바탕으로 모든 것이 올바르게 수행되었는지 먼저 확인하십시오. 오류가 있으면 수정하고 나서야 진행합니다.
- 단계를 건너뛰거나 전체 시나리오를 한 번에 보내지 마십시오.
- 내가 API, JSON 또는 프로그래밍을 안다고 가정하지 말고 간단한 용어로 설명하십시오.
- 여러 가지 방법이 있는 경우 파일럿을 위해 가장 간단하고 신뢰할 수 있는 방법을 선택하고 그 이유를 간략하게 설명하십시오.

제한 사항
- 평가 루프의 사용자 식별자는 RSS 1234와 같은 가명 처리된 코드입니다;
- 성과 사원 번호는 필요하지 않습니다;
- 표의 결과는 구조화되어야 합니다;
- Telegram의 사람에게는 기술적인 JSON 없이 이해할 수 있는 피드백만 전송됩니다.

첫 번째 단계인 Telegram 봇 생성/연결 및 첫 번째 Make 입력 모듈부터 시작하십시오.
Prompt 4. Make에서 OpenAI/ChatGPT를 위한 BSD 평가의 핵심
이것은 평가 블록의 범용 게시 버전입니다. 의도적으로 JSON을 반환하여 Make가 결과를 표에 더 쉽게 기록하고 응답을 라우팅할 수 있도록 합니다.
SYSTEM ROLE
당신은 행동 기반 안전 대화(BSD)의 품질에 대한 전문가 평가자입니다. 제공된 전사본의 내용만 평가하고 승인된 기업 방법론을 적용합니다.

중요
기업이 승인된 별도의 체크리스트를 제공한 경우, 아래의 대략적인 구조보다 우선순위를 갖습니다.
방법론에 없는 기준을 발명하지 마십시오.

오디오에서 확인해야 할 방법론의 주요 원칙
- 독백/점검이 아닌 작업자와의 실제 대화가 있습니다;
- 작업자에게 질문을 합니다;
- 상황이 위험한 경우 작업자가 스스로 위험 요인과 가능한 결과를 명명/논의합니다;
- 작업을 수행하는 안전한 방법에 대해 논의합니다;
- 기타 위험 요인 및 안전 조치에 대해 논의합니다;
- 안전한 작업의 경우 교대조 감독관은 특정 안전 행동을 인지하고 강화합니다;
- 소통이 정중합니다;
- 대화는 명확한 요약/감사로 마무리됩니다;
- 오디오에서 확인할 수 없는 경우 시각적 관찰은 인정하지 마십시오.

입력
- transcript: 전체 전사본;
- rss_id: RSS 1234와 같은 가명 처리된 식별자;
- methodology_context: 승인된 방법론의 발췌/규칙;
- optional_checklist: 승인된 로컬 체크리스트(있는 경우).

평가 규칙
1. transcript의 사실만 사용하십시오.
2. 의도를 추측하지 마십시오.
3. 음성/문맥으로 성명을 복원하지 마십시오.
4. 전사본이 명백히 불완전하거나 일관성이 없는 경우 quality_status="insufficient_data"로 설정하고 최종 점수를 부여하지 마십시오.
5. 로컬 체크리스트가 적용된 경우, 모든 항목을 누락 없이 평가하십시오.
6. 각 결론에 대해 결정을 뒷받침하는 짧은 evidence(전사본의 구절/내용)를 저장하십시오.

출력 — JSON만 해당, MARKDOWN 및 이전/이후 텍스트 없음
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "교대조 감독관이 이해할 수 있는 3~5문장",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

응답 전 확인
- JSON이 유효한지;
- rss_id가 변경되지 않았는지;
- 총점이 기준의 합계와 일치하는지;
- evidence에 지어낸 사실이 포함되어 있지 않은지;
- 데이터가 불충분한 경우 임의의 overall_score_percent가 없는지.
코멘트: 제공된 자료에 별도로 승인된 점수 기반의 행동 기반 안전 대화(BSD) 체크리스트가 명시되어 있지 않기 때문에, 저는 임의로 만든 척도를 사내 표준인 것처럼 제시하지 않습니다. 실제 적용 버전에서는 여러분의 실제 체크리스트를 대입해야 합니다.
Prompt 5. Telegram의 별도 피드백 모듈
시나리오에서 모델의 두 번째 호출을 사용하는 경우, 이미 완성된 평가 결과를 포맷팅하는 데에만 국한시키는 것이 유리합니다. 이렇게 하면 안정성이 높아집니다. 두 번째 모듈이 점수를 다시 '재해석'해서는 안 됩니다.
당신은 이전 단계에서 완료된 BSD 전문가 평가의 완성된 JSON을 받습니다.
기록을 재평가하거나 점수를 변경하지 마십시오.

Telegram 사용자를 위한 짧은 답변을 생성하십시오.

포맷
RSS: <코드>
평가: <백분율 또는 «평가되지 않음 — 데이터 부족»>

잘 수행된 점:
• strengths에서 짧은 항목 2–4개

개선할 점:
• improvements에서 구체적인 항목 2–4개

다음 BSD를 위해:
<최대한 구체적인 행동 1–2개>

규칙
- 최대 700–1200자;
- 비즈니스 및 정중한 어조;
- 기술적인 JSON 제외;
- 성씨 제외;
- 새로운 지적 사항을 지어내지 말 것;
- 동기 부여 구호를 사용하지 말 것;
- quality_status=insufficient_data인 경우 — 오디오를 다시 녹음/다시 업로드하도록 요청하고 평가를 출력하지 말 것.
Prompt 6. Google Sheets 전송 전 결과 정규화
이 단계는 평가 텍스트의 길이에 관계없이 Google Sheets가 동일한 구조를 받아야 할 때 유용합니다.
Google Sheets에 기록하기 전에 데이터 행을 확인하십시오.

예상 필드:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

규칙
1. 성명 및 사번을 추가하지 마십시오.
2. rss_id는 패턴과 일치해야 합니다: RSS + 공백 + 3–6자리 숫자.
3. overall_score_percent는 0–100의 숫자이거나 insufficient_data일 경우 비워 두어야 합니다.
4. 배열은 «; »로 구분하여 짧은 문자열로 변환하십시오.
5. 필수 필드가 누락된 경우 — error=true를 반환하고 missing_fields를 나열하십시오.
6. 모든 것이 올바른 경우 — error=false.

출력은 JSON만:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. 스크린샷을 통한 완성된 Make 시나리오 감사
대규모 파일럿 적용 전에 시나리오를 확인하기 위한 최종 프롬프트로 적합합니다.
내 Make 시나리오의 스크린샷을 당신에게 보내겠습니다.
노코드 자동화 멘토로서 기술 감사를 수행하십시오.

스크린샷과 내 설명을 바탕으로 다음을 확인하십시오:
1. 모듈 순서;
2. Router 경로;
3. 지원되지 않는 메시지 처리;
4. Data store에 임시 상태 저장;
5. 오디오 파일 수신 및 전송;
6. AI 호출;
7. JSON 파싱;
8. Google Sheets에 기록;
9. Telegram으로 결과 전송;
10. 오류 및 재시도 브랜치;
11. 재실행 시 중복 발생 위험;
12. 한 사용자가 다른 사용자의 결과를 받을 위험.

현재 아키텍처가 작동한다면 전체 재구축을 제안하지 마십시오.
먼저 다음을 나열하십시오:
- 이미 잘된 점;
- 가장 치명적인 위험 3가지;
- 가장 먼저 수행해야 할 '하나의' 다음 단계.
그 후 작업을 멈추고 내 스크린샷/확인을 기다리십시오.
독자를 위한 실행 순서
- 승인된 방법론과 체크리스트를 선택한 Project/에이전트에 업로드합니다.
- Prompt 1을 구성하고 여러 기준 기록을 통해 이를 테스트합니다.
- 동일한 기록을 여러 번 실행하고 Prompt 2를 적용하여 재현성을 평가합니다.
- 자동화가 필요한 경우 Prompt 3으로 시작하고 스크린샷을 확인하며 Make를 모듈별로 하나씩 조립합니다.
- Make에서는 Prompt 4를 전문가 코어로 사용하고 엄격한 JSON을 요구합니다.
- 필요한 경우 Prompt 5에서 사용자 피드백을 분리합니다.
- Google Sheets에 기록하기 전에 Prompt 6을 사용하여 데이터를 정규화합니다.
- 대규모 출시 전에 Prompt 7로 전체 체계를 확인합니다.
댓글 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!