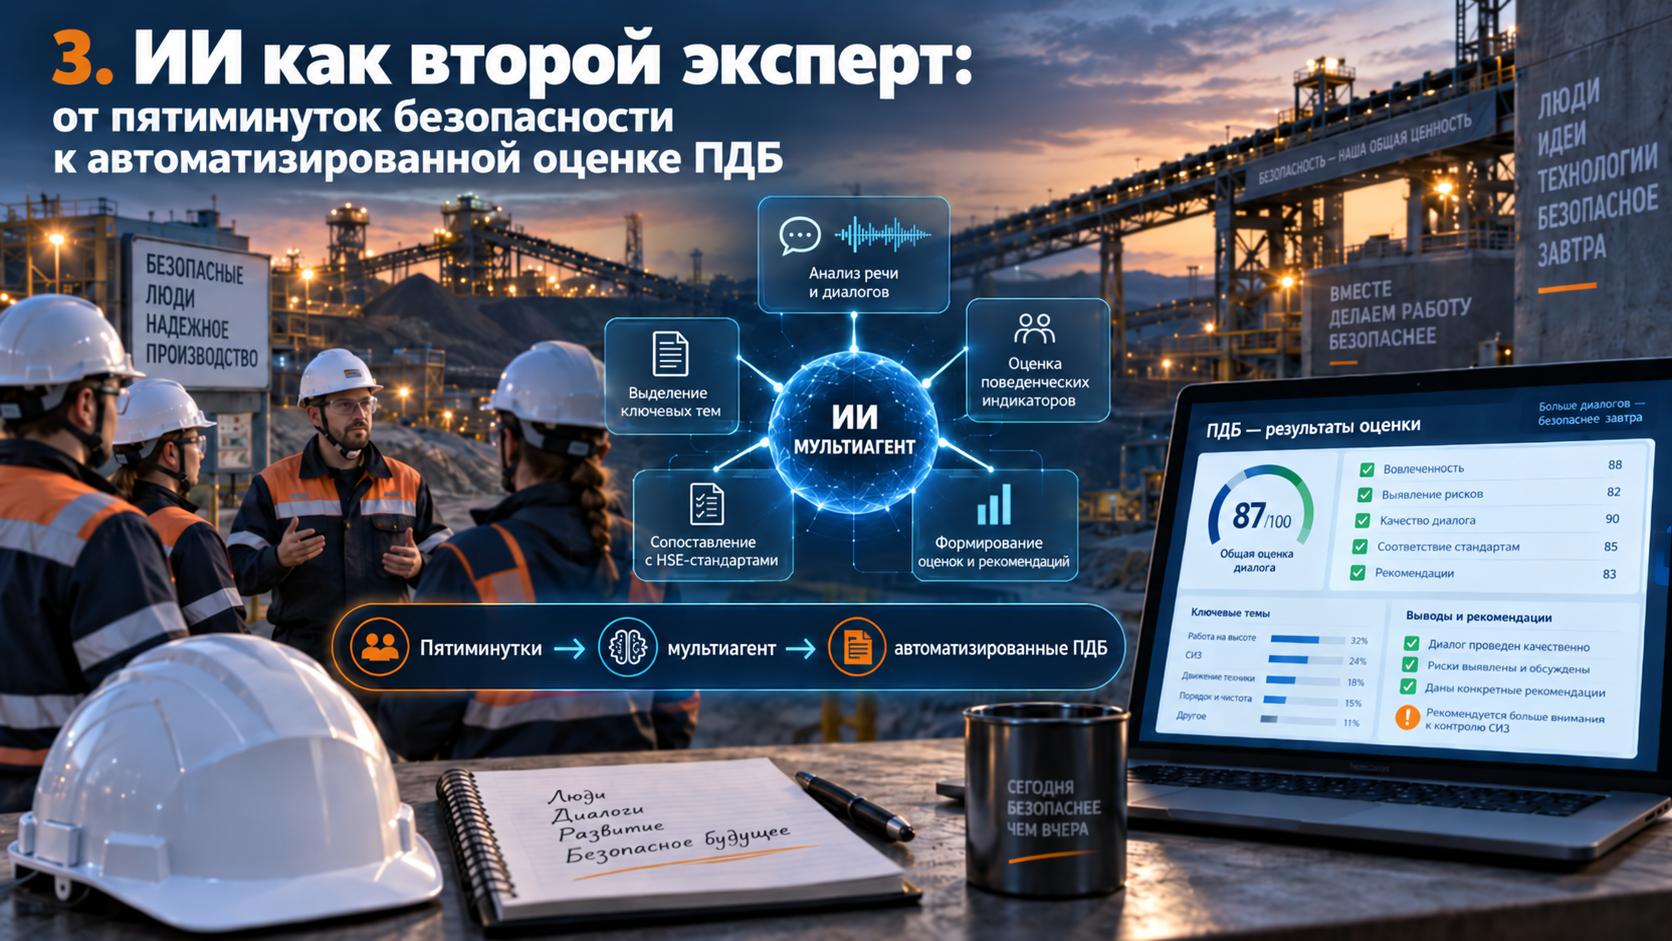
AI như một chuyên gia thứ hai: từ họp an toàn 5 phút đến đánh giá BSD tự động
Buổi họp an toàn 5 phút → đánh giá kỹ thuật số → Make → đối thoại an toàn hành vi tự động hóa
Ý tưởng chính: AI không thay thế người quản lý hoặc chuyên gia an toàn. Nó trở thành một "chuyên gia thứ hai" thống nhất, áp dụng cùng các tiêu chí, cung cấp phản hồi cá nhân hóa và cho phép mở rộng quy mô kiểm soát chất lượng lên hàng trăm, hàng nghìn cuộc trò chuyện thực tế.
Tại sao ngay từ đầu chúng tôi lại bắt đầu đánh giá cuộc trò chuyện chứ không phải việc nó có diễn ra hay không
Trong an toàn vệ sinh lao động, rất dễ để đếm các sự kiện: một buổi họp an toàn 5 phút đã được tổ chức, một đối thoại an toàn hành vi đã được ghi nhận, một thẻ đã được điền. Khó hơn nhiều để trả lời câu hỏi rằng người quản lý đã thực hiện cuộc trò chuyện với chất lượng ra sao và liệu nó có đạt được mục tiêu hay không.
Buổi họp an toàn 5 phút trong phương pháp của chúng tôi là một phần bắt buộc của cuộc họp giao ca kéo dài từ 5–10 phút. Người quản lý phải xem xét một chủ đề thực tế cụ thể và xây dựng một mối liên hệ rõ ràng: mối nguy → hậu quả → biện pháp an toàn. Đồng thời, không chỉ độc thoại của tổ trưởng là quan trọng, mà còn cả đối thoại với công nhân: câu hỏi, câu trả lời và sự tham gia vào quá trình thảo luận.
Do đó, nhiệm vụ ban đầu không phải là "kiểm tra xem có bản ghi âm hay không", mà là một điều khác: liệu có thể dạy AI đánh giá đồng nhất chất lượng thực tế của các cuộc trò chuyện như vậy và cung cấp cho người quản lý phản hồi thực tế không?
Giai đoạn 1. Phương pháp trước, trí tuệ nhân tạo sau
Vào mùa xuân năm 2026, chúng tôi đã bắt đầu với các buổi họp an toàn 5 phút. Trước khi triển khai tính năng đánh giá bằng AI, các hướng dẫn phương pháp và một video đào tạo về cách tiến hành buổi họp an toàn 5 phút đúng chuẩn đã được chuẩn bị. Chỉ sau đó, công cụ đánh giá kỹ thuật số mới xuất hiện.
Làm môi trường làm việc đầu tiên, chúng tôi đã sử dụng Perplexity Space — ngày nay môi trường tương tự trong Perplexity được gọi là Project. Vào dự án, chúng tôi đã tải lên tài liệu hướng dẫn phương pháp và danh sách kiểm tra đánh giá, còn đối với mô hình, chúng tôi đã chuẩn bị riêng một Prompt chặt chẽ.
Nhiệm vụ của Prompt khác biệt căn bản so với yêu cầu "đánh giá bài phát biểu" thông thường. AI chỉ được phép ghi nhận những gì thực sự được nói ra trong đoạn âm thanh. Nếu thiếu một yếu tố — 0 điểm. Nếu được đề cập một cách hình thức — hoàn thành một phần. Nếu được trình bày logic và đầy đủ — hoàn thành.
Trong danh sách kiểm tra hiện hành có bảy tiêu chí: giới thiệu và mục tiêu; mối nguy cụ thể; logic "mối nguy – hậu quả – biện pháp an toàn"; tác động cảm xúc; biện pháp an toàn; đối thoại với công nhân; tóm tắt cuối cùng và liên kết với các công việc đang thực hiện.
Prompt 1 — xem phiên bản Prompt được hiện đại hóa cho Perplexity Project trong phụ lục.
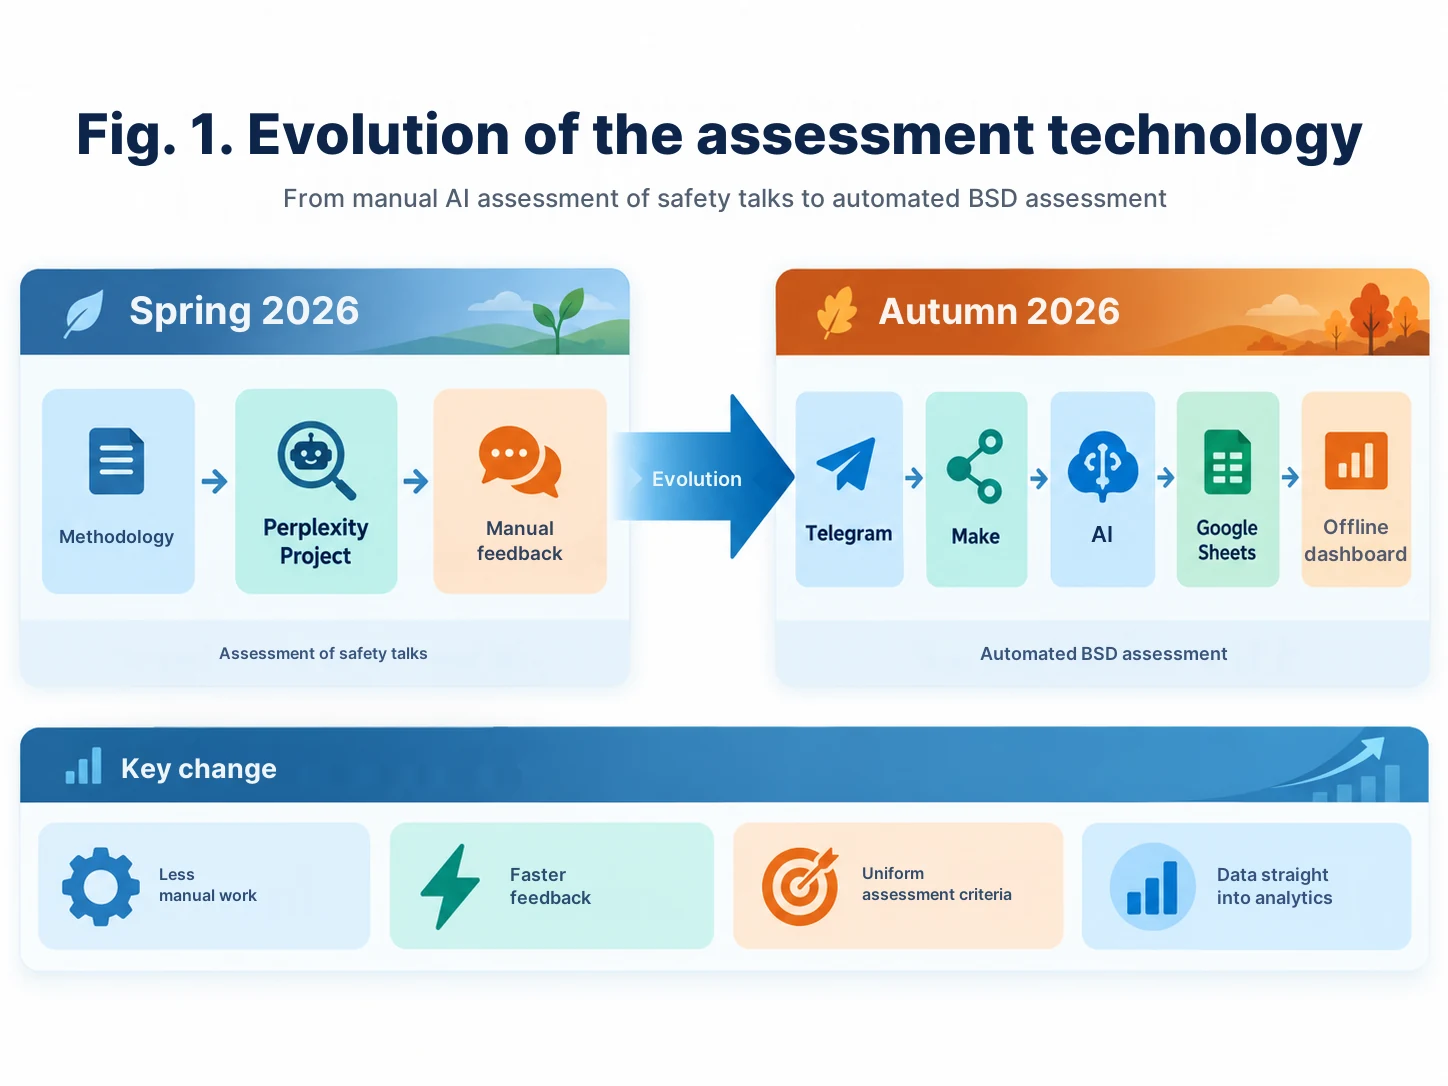
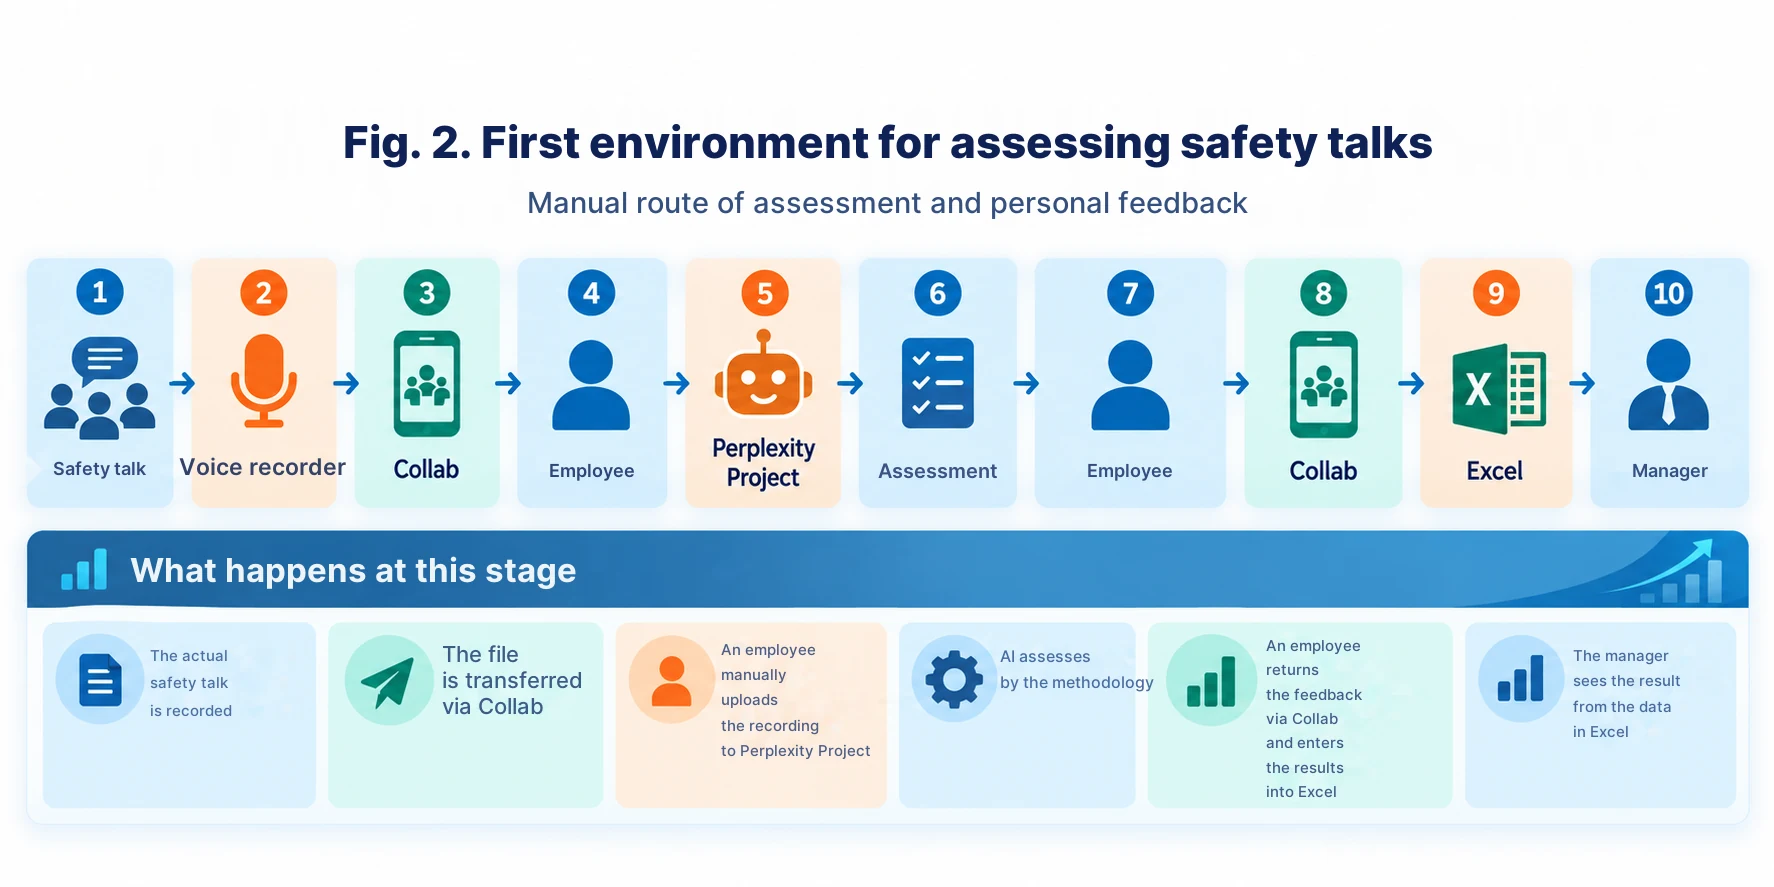
Mô hình đầu tiên, vẫn còn thủ công, trông như thế nào
Trưởng ca đã ghi âm buổi họp an toàn 5 phút vừa thực hiện vào máy ghi âm. Thông qua ứng dụng doanh nghiệp Collab, bản ghi được chuyển cho một nhân viên được chỉ định. Nhân viên này tải đoạn âm thanh lên Perplexity Project, nhận kết quả đánh giá và gửi lại phản hồi cá nhân hóa cho người quản lý cũng thông qua Collab.
Đồng thời, kết quả được nhập vào Excel: bộ phận, người quản lý, điểm đánh giá, số lần thử. Dựa trên bảng, chúng tôi đã xây dựng các phân tích đơn giản — kết quả trung bình của các bộ phận, tính năng động và số lượng chu kỳ lặp lại.
Chúng tôi đã chọn 80 % làm mức đạt cho chu trình thực hành. Nếu kết quả thấp hơn, người quản lý sẽ tiến hành buổi họp an toàn 5 phút tiếp theo có tính đến các nhận xét của AI. Điều này không chỉ tạo ra sự kiểm soát mà còn là một quá trình đào tạo cá nhân hóa ngay tại nơi làm việc.
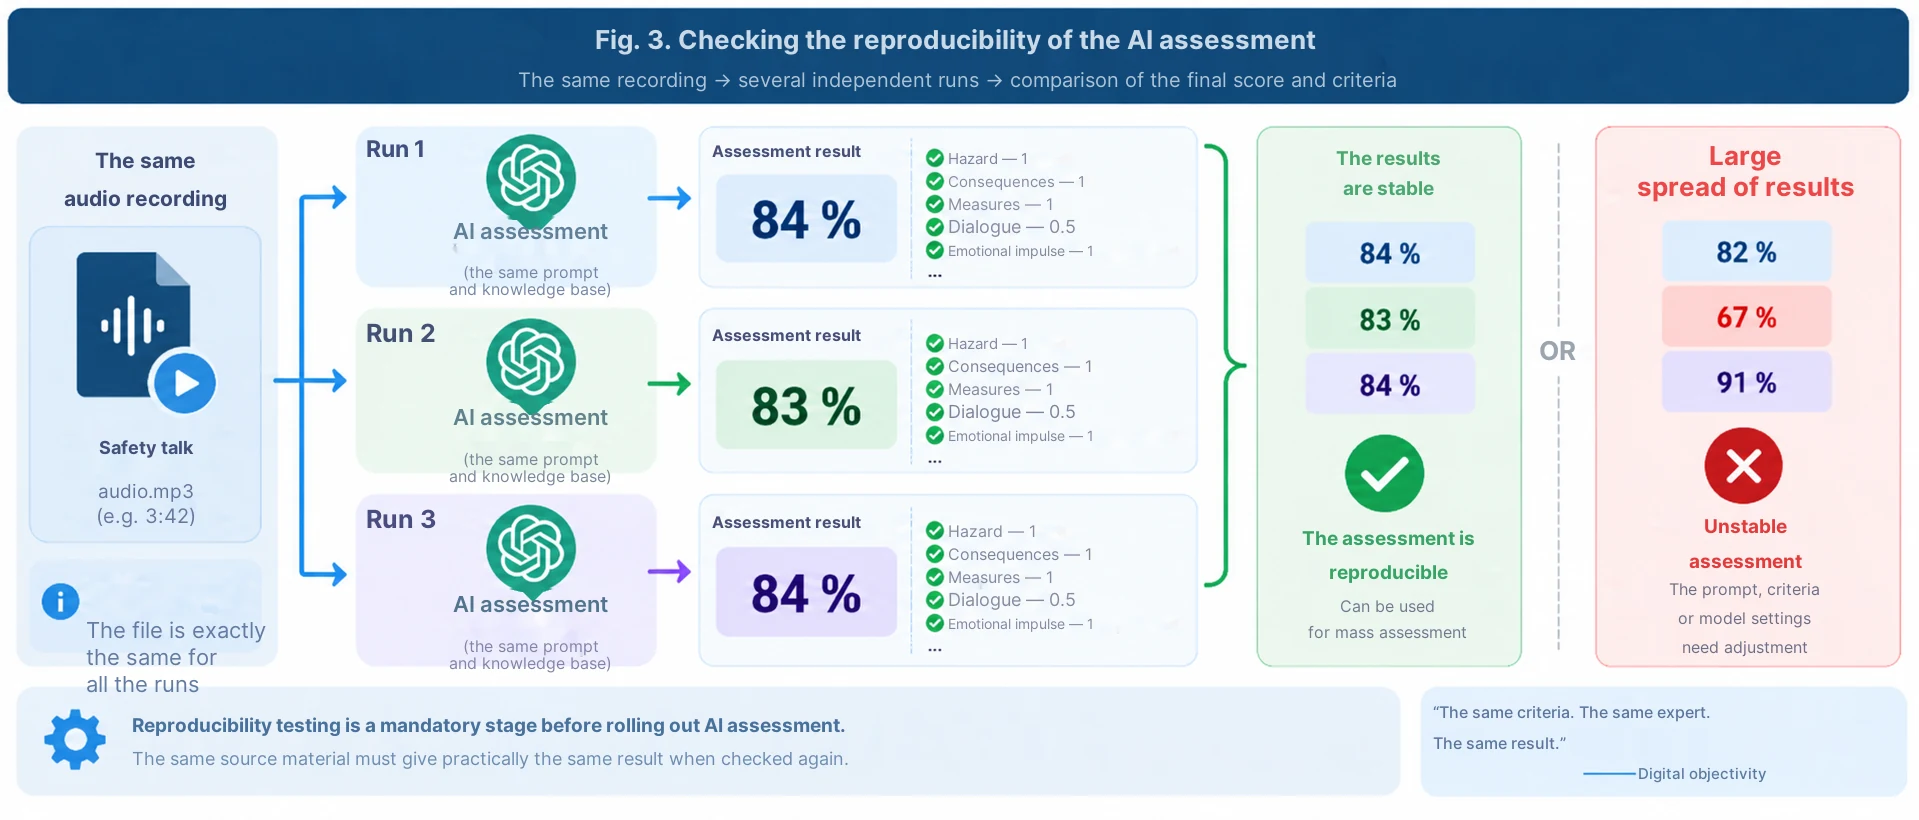
Không chỉ kiểm tra con người — đầu tiên chúng tôi đã kiểm tra chính AI
Đối với tôi, đây là một trong những yếu tố quan trọng nhất của toàn bộ hệ thống. Chúng tôi đã cố ý gửi cùng một đoạn ghi âm để đánh giá nhiều lần. Nếu cùng một tài liệu hôm nay đạt 82 %, một phút sau đạt 65 %, và sau đó là 91 %, thì chuyên gia kỹ thuật số như vậy vẫn chưa sẵn sàng để đánh giá con người.
Do đó, chúng tôi đã cố gắng đạt được khả năng tái tạo: cùng một bản ghi âm phải cho ra cùng một mức điểm đánh giá hoặc gần như giống nhau. Nếu sự chênh lệch trở nên đáng kể, chúng tôi sẽ điều chỉnh Prompt, làm rõ các tiêu chí và loại bỏ các cách diễn đạt mơ hồ.
Đối với cá nhân tôi, tôi gọi đây là "tính khách quan kỹ thuật số". Điều này không có nghĩa là AI nắm giữ chân lý tuyệt đối. Vấn đề nằm ở chỗ khác: một chuyên gia duy nhất áp dụng cùng một thang điểm cho tất cả mọi người và không phụ thuộc vào tâm trạng, cảm tình cá nhân hay vào việc ai là người thực hiện kiểm tra vào ngày hôm nay.
Prompt 2 — xem biên bản kiểm tra khả năng tái tạo của đánh giá trong phụ lục.
Tại sao mô hình thủ công không còn phù hợp
Đối với giai đoạn thí điểm, quy trình thủ công rất thuận tiện: nhận tệp, tải lên, chờ kết quả, trả lại phản hồi và nhập điểm vào Excel. Nhưng cách tiếp cận như vậy có một giới hạn tự nhiên.
Khi khối lượng được đo lường bằng hàng trăm và hàng nghìn bản ghi, chúng tôi không còn tự động hóa việc đánh giá nữa, mà đang tạo ra một công việc hành chính mới xung quanh việc đánh giá. Do đó, khi chuyển sang các đối thoại an toàn hành vi (BSD), nhiệm vụ được diễn đạt khác đi: loại bỏ con người khỏi chuỗi kỹ thuật ở những nơi mà sự tham gia của họ không tạo ra giá trị.
Giai đoạn 2. Đối thoại hành vi phức tạp hơn một buổi họp 5 phút thông thường
Đối thoại an toàn hành vi — không chỉ đơn thuần là một bài phát biểu ngắn. Phương pháp này bao gồm việc quan sát công việc thực tế và nói chuyện với con người. Điều quan trọng đối với người quản lý là nhìn thấy hành vi an toàn hoặc nguy hiểm, sau đó thông qua các câu hỏi để đạt được việc công nhân tự gọi tên mối nguy, những hậu quả có thể xảy ra và cách thực hiện công việc an toàn.
Nếu công nhân làm việc nguy hiểm, phần cốt lõi của cuộc trò chuyện — là thảo luận về các mối nguy và hậu quả, sau đó là cách làm việc an toàn và các nguồn nguy hiểm khác. Nếu người đó làm việc an toàn, người quản lý phải ghi nhận và củng cố hành vi đúng đắn, và sau đó sử dụng cuộc trò chuyện để thảo luận về các vấn đề an toàn khác.
Đó chính là lý do tại sao quy trình đánh giá BSD phải kiểm tra không chỉ lời nói của người quản lý, mà còn cả sự tồn tại của một cuộc đối thoại thực sự: các câu hỏi có được đặt ra không, công nhân có trả lời không, các nguyên nhân của hành vi, hậu quả, hành động an toàn và việc kết thúc cuộc trò chuyện có được thảo luận không.
Định danh giả danh thay vì họ tên
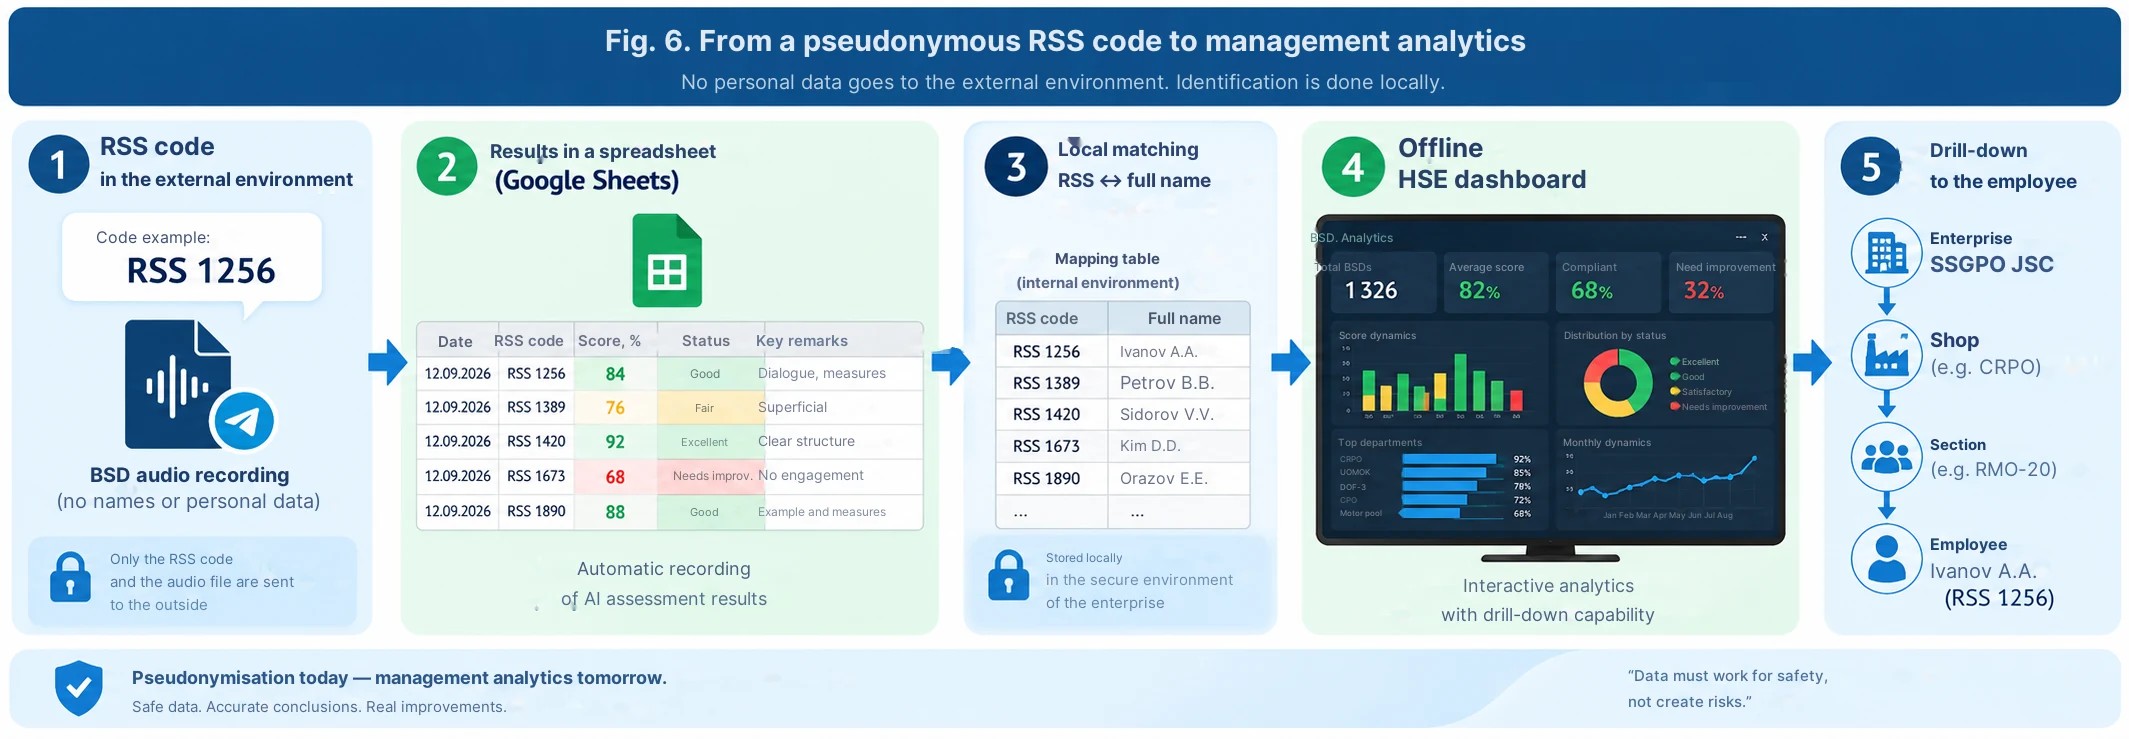
Trong quá trình tự động hóa hàng loạt, chúng tôi đã giải quyết riêng vấn đề nhận dạng. Bên trong hệ thống doanh nghiệp ERGIS, mỗi người tham gia được cấp một mã đặc biệt dạng RSS 1256. Đây không phải là mã số nhân viên hay họ tên.
Trước khi bắt đầu ghi âm, người quản lý đọc mã RSS của mình, sau đó tiến hành BSD. Trong cuộc trò chuyện, không cần thiết phải nêu họ tên hay mã số nhân viên. Sự tương ứng "mã RSS ↔ nhân viên cụ thể" vẫn được giữ bên trong hệ thống doanh nghiệp và được sử dụng sau này cho các phân tích cục bộ.
Ở đây, sẽ chính xác hơn khi không nói về việc ẩn danh hóa hoàn toàn, mà là về giả danh hóa: trong tệp âm thanh, giọng nói của con người vẫn được giữ lại. Nhưng khối lượng dữ liệu cá nhân đi qua hệ thống tự động hóa được giảm thiểu đáng kể.
Bí mật nhỏ: tôi không phải là lập trình viên
Chúng tôi đã xây dựng kiến trúc của giải pháp mới thông qua Make. Tôi không phải là lập trình viên và khi bắt đầu công việc, tôi đã trực tiếp viết điều này cho ChatGPT.
Yêu cầu rất đơn giản: «Hãy dẫn dắt tôi tạo quá trình tự động hóa này từng bước một. Đưa ra từng hành động một. Tôi sẽ thực hiện nó trong Make và gửi ảnh chụp màn hình. Sau khi kiểm tra, hãy đưa ra lệnh tiếp theo».
Sau đó mọi chuyện diễn ra đúng như vậy. ChatGPT giải thích cần tạo mô-đun nào và cần điền gì vào đó; tôi thực hiện thao tác và gửi ảnh chụp màn hình; sau khi kiểm tra, tôi nhận được bước tiếp theo. Tương tự, một bot Telegram đã được tạo và toàn bộ chuỗi được liên kết lại.
Đây là một kết luận quan trọng đối với tôi từ thực tiễn vibe coding: một chuyên gia không nhất thiết phải biết trước cú pháp của API hay Make. Nhưng người đó bắt buộc phải hiểu rõ quy trình sản xuất, kết quả mà người dùng cần nhận được, và phải biết cách kiểm tra tuần tự từng giai đoạn.
Prompt 3 — xem Prompt khởi đầu «hãy dẫn dắt tôi từng bước qua Make» trong phụ lục.
Điều gì đang diễn ra hiện nay: Telegram → Make → AI → kết quả
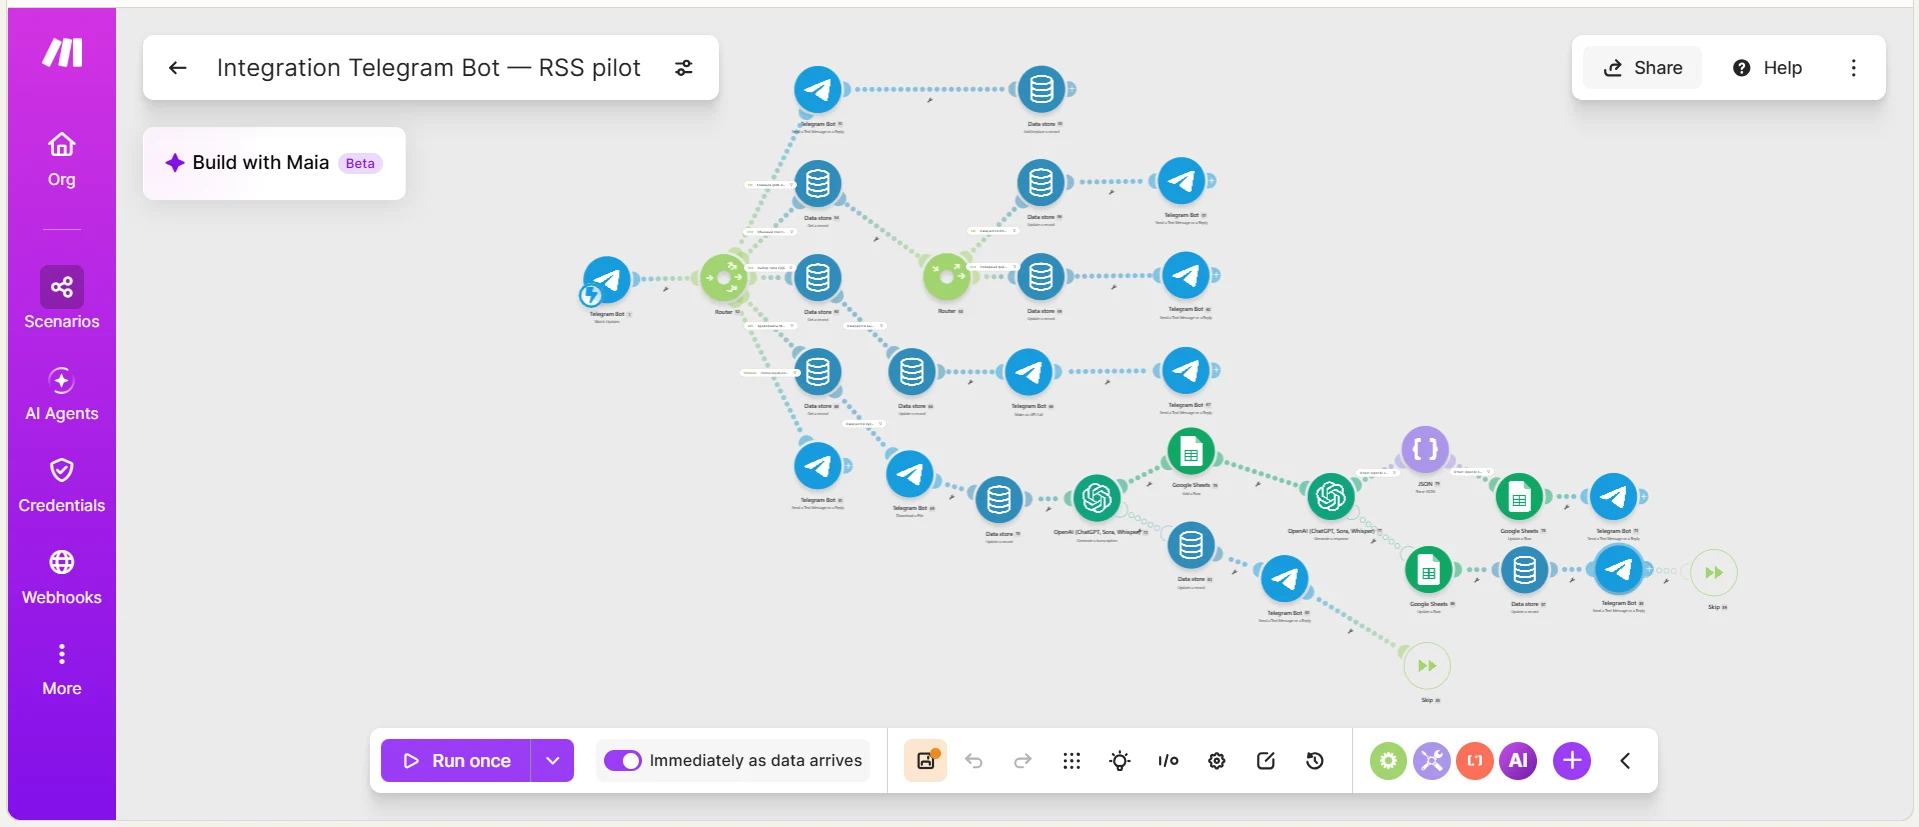
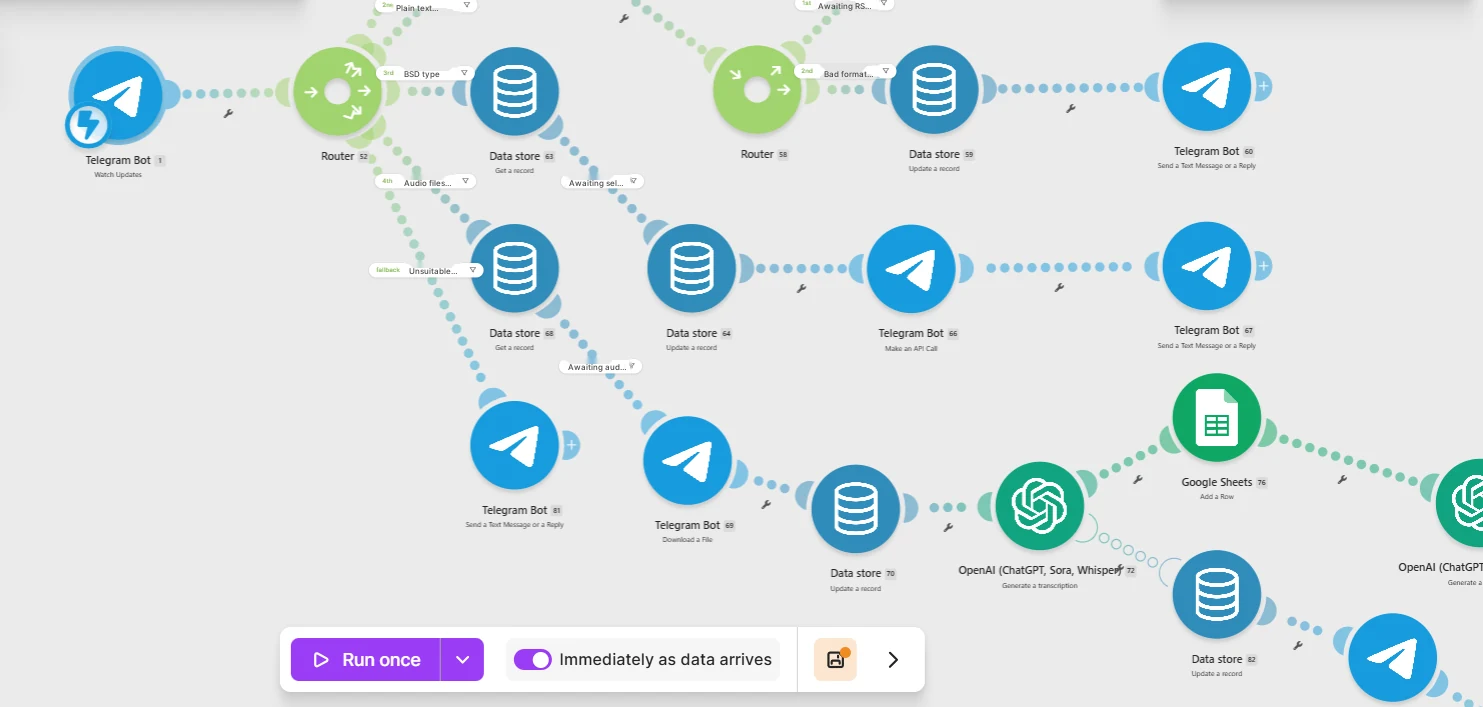
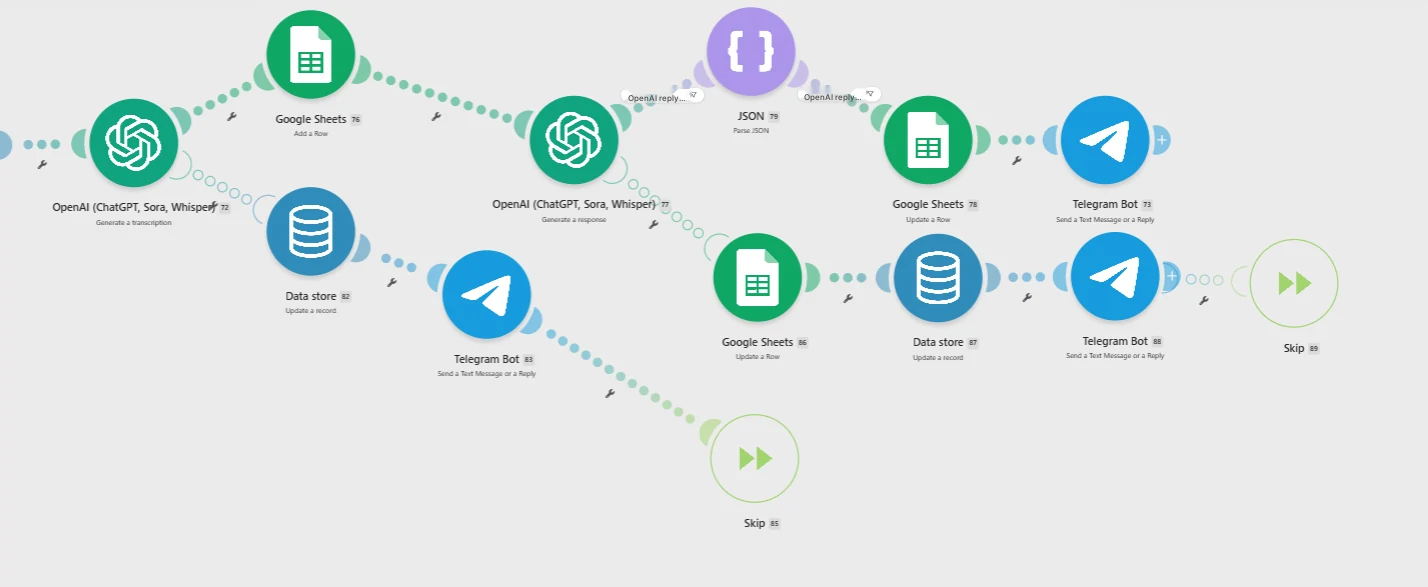
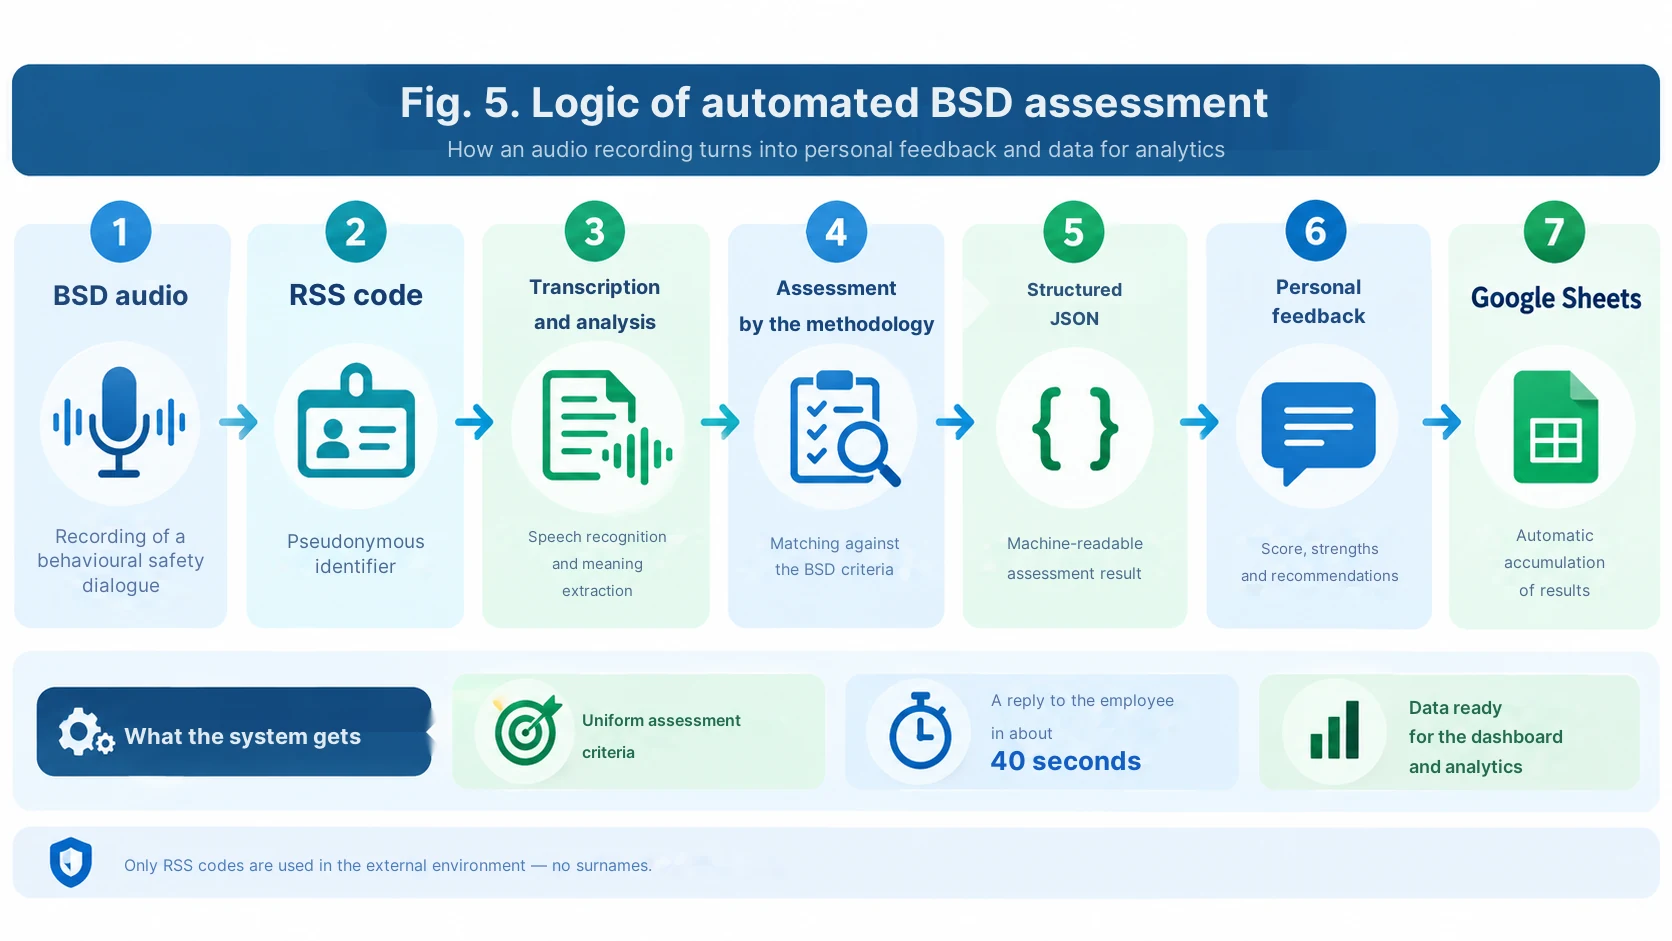
Mô hình hiện tại hoạt động gần như không cần người thao tác thủ công. Người quản lý gửi bản ghi âm vào bot Telegram. Make tiếp nhận tệp, kiểm tra dữ liệu đầu vào và khởi chạy lộ trình xử lý. AI phân tích bản ghi theo phương pháp đã định, hình thành kết quả đánh giá và phản hồi. Kết quả được trả về cho người dùng và đồng thời được ghi vào Google Sheets để phân tích tổng thể.
Trong đợt thí điểm hiện tại, phản hồi được trả về sau khoảng vài chục giây. Đối với người dùng, điều này trông rất đơn giản: gửi đoạn âm thanh — nhận được điểm đánh giá, điểm mạnh, những sai sót cụ thể và những gì cần thay đổi trong lần tới.
Trên sơ đồ Make, có thể thấy ẩn sau sự đơn giản này là một quy trình định tuyến hoàn chỉnh: Telegram, Data store, Router, OpenAI, Google Sheets, các khâu kiểm tra và tin nhắn phản hồi cho người dùng.
Đây có phải là đa tác tử hay không?
Tôi sẽ không sử dụng từ “đa tác tử” ở đây chỉ để tạo ấn tượng. Trên thực tế, chúng ta có một chu trình chuyên gia gồm nhiều bước, trong đó các phần khác nhau của kịch bản thực hiện các chức năng khác nhau: tiếp nhận và định tuyến tệp, trích xuất định danh, phân tích nội dung, đánh giá chuyên môn, tạo kết quả có cấu trúc, ghi vào bảng và phản hồi cá nhân.
Nếu một vài lệnh gọi mô hình riêng biệt hoạt động với các vai trò hệ thống khác nhau — ví dụ, một lệnh phân tích cuộc đối thoại, lệnh thứ hai kiểm soát sự tuân thủ phương pháp luận và định dạng kết quả, — thì điều này đã có thể được xem xét như một logic đa tác tử hoặc nhiều tác tử. Nếu một lệnh gọi mô hình thực hiện tất cả các chức năng, thì gọi là người đánh giá AI đa chức năng sẽ thành thực hơn.
Vì vậy, trong phần phụ lục, tôi đã chia các Prompt theo chức năng, chứ không gọi mỗi chức năng là một tác tử riêng biệt.
Đánh giá BSD tự động được tổ chức như thế nào
Trong kịch bản công nghiệp, điều quan trọng là phải chia thành hai nhiệm vụ. Nhiệm vụ đầu tiên là chuyên môn: đánh giá nội dung cuộc trò chuyện tuân thủ nghiêm ngặt theo phương pháp luận. Nhiệm vụ thứ hai là kỹ thuật: trả về kết quả ở định dạng mà Make có thể hiểu và có thể ghi vào Google Sheets.
Do đó, đối với tự động hóa, phản hồi JSON có cấu trúc rất thuận tiện: mã RSS, điểm tổng kết, trạng thái, điểm mạnh, điểm cần cải thiện, phản hồi ngắn gọn và các tiêu chí đánh giá riêng biệt. Định dạng như vậy làm giảm rủi ro tự động hóa bị “phá vỡ” do văn bản đẹp mắt nhưng không thể đoán trước của mô hình.
Đồng thời, quy tắc cứng rắn vẫn giữ nguyên như vào mùa xuân: không tính những gì không có trong bản ghi âm; không đoán ý định; không vẽ thêm câu trả lời đúng thay cho người quản lý. Nếu bản ghi lời thoại không đầy đủ — bản ghi âm phải được chuyển sang tải lên lại, chứ không phải nhận một đánh giá bịa đặt.
Prompts 4–6 — đánh giá BSD, JSON có cấu trúc và việc tạo phản hồi, xem trong phần phụ lục.
Từ đánh giá cá nhân đến bức tranh theo các bộ phận
Sau mỗi lần đánh giá, trong Google Sheets tích lũy không chỉ đơn thuần là phản hồi bằng văn bản, mà là một mảng có cấu trúc. Do đó, có thể thấy số lượng các cuộc BSD đã thực hiện, kết quả trung bình, các lỗi lặp đi lặp lại chính, động lực học và kết quả theo các mã RSS giả danh hóa.
Bước tiếp theo chúng ta đã quen thuộc từ bài viết thứ hai: đối chiếu cục bộ mã RSS với họ tên trong hệ thống nội bộ của công ty và tải kết quả lên bảng điều khiển HSE độc lập. Khi đó, người quản lý sẽ nhìn thấy bức tranh toàn cảnh về doanh nghiệp, phân xưởng và khu vực, và khi cần thiết có thể đi sâu xuống đến từng công nhân cụ thể.
Tức là, chu trình đánh giá bên ngoài có thể hoạt động mà không cần họ tên, còn bức tranh quản lý toàn diện chỉ được khôi phục lại ở bên trong doanh nghiệp.
Làm thế nào có thể lặp lại ý tưởng này mà không cần kiến trúc của chúng tôi
Ý nghĩa của phương pháp tiếp cận này không bị trói buộc vào một thương hiệu AI nào. Ở phiên bản đơn giản nhất, có thể tạo một Perplexity Project với phương pháp luận và Prompt đánh giá. Có thể sử dụng ChatGPT với một hướng dẫn cố định và cơ sở kiến thức được tải lên. Có thể xây dựng sơ đồ xoay quanh Google NotebookLM / Gemini Notebook như một nguồn tài liệu phương pháp luận, còn việc đánh giá được thực hiện bởi một mô hình riêng biệt. Đối với lưu lượng lớn, sử dụng Make hoặc một nền tảng tự động hóa khác với Telegram, OpenAI và các bảng tính sẽ thuận tiện hơn.
Các yếu tố then chốt vẫn giữ nguyên: phương pháp luận đã được phê duyệt → Prompt cứng → kiểm tra khả năng tái tạo → thang điểm dễ hiểu → phản hồi cá nhân → tích lũy kết quả có cấu trúc.
Điều gì đã thay đổi trong vài tháng qua
Vào mùa xuân, một nhân viên đã phải chuyển các tệp âm thanh vào AI theo cách thủ công và trả về kết quả. Ngày nay, chúng tôi đang xây dựng một chu trình có khả năng tiếp nhận và đánh giá khoảng 1300 bản ghi BSD mà không cần người vận hành riêng cho từng tệp.
Nhưng thay đổi chính thậm chí không nằm ở tốc độ. Chúng tôi đã có được khả năng áp dụng các tiêu chí giống nhau cho một số lượng lớn các cuộc trò chuyện thực tế và biến mỗi đánh giá thành một chu kỳ học tập cá nhân ngắn hạn.
AI trong sơ đồ này — không phải là một thanh tra viên chuyên đi tìm người có lỗi. Nó đồng thời là chuyên gia thứ hai và một huấn luyện viên kỹ thuật số: ghi nhận sự không tuân thủ với phương pháp luận, giải thích chính xác những gì cần cải thiện, và cho phép kiểm tra điều đó ngay trong cuộc trò chuyện tiếp theo.
Kết luận
Khi chúng tôi mới bắt đầu, nhiệm vụ nghe giống như một thử nghiệm: liệu AI có thể đánh giá một buổi tọa đàm an toàn hay không. Kết quả đã tạo ra một công nghệ có thể mở rộng quy mô cho các cuộc đối thoại hành vi, công tác đào tạo và các loại hình giao tiếp về an toàn khác.
Đối với tôi, kết quả giá trị nhất — không phải là một con số tự động. Giá trị nằm ở chỗ người quản lý nhận được phản hồi gần như ngay lập tức sau một cuộc trò chuyện thực tế, còn doanh nghiệp đồng thời nhận được một mảng dữ liệu về việc các yếu tố nào của phương pháp luận thực sự gây khó khăn cho con người.
Chính tại điểm này, AI bắt đầu làm việc không phải để thay thế hệ thống quản lý an toàn, mà là ở bên trong nó — như một chuyên gia thứ hai đồng nhất.
Các Prompt cho bài viết “AI như một chuyên gia thứ hai”
Tọa đàm an toàn, kiểm tra khả năng tái tạo, Make và tự động hóa đánh giá BSD
Đây là phiên bản xuất bản của các Prompt. Nó được dựa trên phương pháp luận thực tế và kiến trúc hoạt động của chúng tôi, nhưng trước khi áp dụng ở một doanh nghiệp khác, các tiêu chí và ngưỡng cần phải được thay thế bằng các yêu cầu đã được phê duyệt tại địa phương.
Prompt 1. Đánh giá tọa đàm an toàn được hiện đại hóa trong Perplexity Project
Đây là phiên bản xuất bản được cải thiện của Prompt hiện hành. Tôi đã sửa chữa những mâu thuẫn bên trong: danh sách kiểm tra hiện đã thực sự có chứa 7 tiêu chí, và ngưỡng vượt qua ở mọi nơi đều như nhau — 80%.
Bạn đóng vai trò là một chuyên gia về an toàn vệ sinh lao động và an toàn công nghiệp, thực hiện đánh giá kiểm soát chất lượng của buổi họp an toàn 5 phút do trưởng ca thực hiện.

NGUỒN VÀ MỨC ĐỘ ƯU TIÊN
1. Bản ghi âm buổi họp an toàn 5 phút.
2. Hướng dẫn phương pháp luận đã được phê duyệt của doanh nghiệp.
3. Danh sách kiểm tra đánh giá đã được phê duyệt.
Trong trường hợp có xung đột về từ ngữ, hãy tuân theo danh sách kiểm tra và phương pháp luận đã được phê duyệt. Không thêm các tiêu chí của riêng bạn.

GIAI ĐOẠN 1. BẢN CHÉP LỜI ĐẦY ĐỦ
- Trước tiên, hãy lấy bản chép lời đầy đủ của âm thanh, không phải là một bản tóm tắt (summary) ngắn.
- Đối với Perplexity Project, hãy sử dụng công cụ đọc tệp âm thanh đính kèm có sẵn ở chế độ đầy đủ (READ / context budget tối đa có sẵn).
- Đánh dấu các đoạn không nghe rõ là [không nghe rõ].
- Nếu nhận dạng giọng nói liền mạch dưới 80% hoặc thiếu một phần đáng kể của bản ghi, chỉ trả lời: «Không đủ dữ liệu. Vui lòng tải lại tệp.» và dừng lại.
- Không xuất bản chép lời đầy đủ vào báo cáo cuối cùng.

GIAI ĐOẠN 2. ĐÁNH GIÁ CHUYÊN MÔN
Chỉ đánh giá những gì thực sự được nói trong bản chép lời đầy đủ.
Nghiêm cấm:
- suy đoán ý định của đốc công;
- tính điểm cho những thứ không có trong bản ghi;
- cải thiện từ ngữ thay cho người được đánh giá;
- bù đắp cho phần bị thiếu bằng ấn tượng tốt chung.

THANG ĐIỂM CHO TỪNG TIÊU CHÍ
Hoàn thành = 1 điểm.
Một phần = 0,5 điểm.
Không hoàn thành = 0 điểm.
Quy tắc:
- không có trong âm thanh → 0;
- đề cập qua loa, không triển khai → 0,5;
- triển khai logic và chính xác → 1.

DANH SÁCH KIỂM TRA — ĐÁNH GIÁ TẤT CẢ 7 MỤC KHÔNG BỎ SÓT
1. Giới thiệu bản thân và mục đích của buổi họp an toàn 5 phút.
2. Tên của mối nguy cụ thể / chủ đề hiện tại.
3. Logic «mối nguy → hậu quả → biện pháp an toàn».
4. Tác động cảm xúc thông qua các hậu quả thực tế/tiềm ẩn hoặc ví dụ phù hợp.
5. Các biện pháp an toàn cụ thể.
6. Đối thoại với công nhân: câu hỏi, câu trả lời, sự tham gia.
7. Tóm tắt cuối cùng và sự liên kết với các công việc hiện tại / sắp tới.

ĐỊNH DẠNG TRẢ LỜI
1. Bảng:
STT | Tiêu chí | Những gì thực sự được nói | Đánh giá | Điểm

2. Tổng kết:
Đạt được: X trên 7.
Phần trăm: (X/7)*100, làm tròn đến 1 chữ số thập phân.

3. Trạng thái chu kỳ:
- nếu kết quả >=80%: «Đã đạt mức đạt yêu cầu»;
- nếu kết quả <80%: «Chưa đạt mức đạt yêu cầu. Khuyến nghị tổ chức lại buổi họp an toàn 5 phút sau khi nghiên cứu phản hồi».

4. Điểm mạnh — 2–5 điểm cụ thể, chỉ từ bản ghi.
5. Các vùng cần cải thiện — cụ thể theo các tiêu chí không hoàn thành/hoàn thành một phần.
6. Phản hồi cho đốc công — 3–5 câu: văn phong công việc, khắt khe, mang tính phát triển.

KIỂM TRA TRƯỚC KHI TRẢ LỜI
Trước khi đưa ra câu trả lời cuối cùng, hãy kiểm tra lại:
- tổng số điểm khớp với bảng;
- phần trăm được tính chính xác;
- không bỏ sót bất kỳ tiêu chí nào trong 7 tiêu chí;
- không có khẳng định nào dựa trên những gì không có trong âm thanh.
Bình luận: Nguyên tắc chính từ phiên bản gốc được giữ nguyên: đầu tiên là bản chép lời đầy đủ, sau đó chỉ đánh giá dựa trên những gì thực sự được nói. Trong Perplexity, tên cụ thể của công cụ đọc tệp có thể thay đổi, do đó trong phiên bản công khai, tốt hơn là nên mô tả chức năng thay vì gán chặt người đọc vào cái tên search_files_v2.
Prompt 2. Kiểm tra khả năng tái tạo («tính khách quan kỹ thuật số»)
Prompt này được sử dụng sau nhiều lần chạy độc lập trên cùng một bản ghi.
Tôi đang tiến hành xác thực khả năng tái tạo của AI đánh giá.

Tôi có kết quả của N lần đánh giá độc lập CÙNG MỘT bản ghi âm theo cùng một danh sách kiểm tra.
Tôi sẽ chuyển cho bạn các bảng/JSON tổng kết của mỗi lần chạy.

Nhiệm vụ của bạn:
1. So sánh phần trăm tổng kết giữa các lần chạy.
2. So sánh điểm số cho từng tiêu chí.
3. Làm nổi bật các tiêu chí mà mô hình thay đổi quyết định thường xuyên nhất.
4. Tính toán:
   - phần trăm tổng kết tối thiểu;
   - phần trăm tổng kết tối đa;
   - biên độ chênh lệch theo điểm phần trăm;
   - phần trăm tổng kết trung bình.
5. Không đánh giá lại bản thân bản ghi gốc và không chọn đánh giá «đúng» — chỉ phân tích tính ổn định của người đánh giá.

TIÊU CHÍ CHO GIAI ĐOẠN THỬ NGHIỆM (PILOT)
- chênh lệch 0–2 điểm phần trăm — khả năng tái tạo cao;
- 2,1–5 điểm phần trăm — có thể chấp nhận được, nhưng cần kiểm tra các tiêu chí gây tranh cãi;
- trên 5 điểm phần trăm — Prompt/tiêu chí cần được tinh chỉnh.

Đưa ra đầu ra theo định dạng:
- Mức độ của khả năng tái tạo;
- Nơi xảy ra sự phân tán;
- Chính xác thì điều gì trong Prompt cần được làm rõ ràng hơn;
- Có cần lặp lại bài kiểm tra sau khi điều chỉnh không.

Không gọi đây là tính khách quan tuyệt đối. Hãy sử dụng thuật ngữ «khả năng tái tạo đánh giá».
Bình luận: Ngưỡng phân tán trong ví dụ là một hướng dẫn làm việc để xuất bản, không phải là một tiêu chuẩn doanh nghiệp đã được phê duyệt. Bạn có thể xóa hoặc thay thế nó bằng ngưỡng của riêng bạn.
Prompt 3. ChatGPT như một người hướng dẫn từng bước trên Make
Đây chính là nguyên tắc cho phép một người không có kỹ năng lập trình lặp lại được giải pháp.
Tôi không phải là lập trình viên và trước đây chưa từng thiết lập các kịch bản trong Make.
Hãy giúp tôi tạo tự động hóa theo nguyên tắc «từng hành động một».

MỤC TIÊU
Telegram bot nhận bản ghi âm đối thoại an toàn hành vi (ĐTATHV). Tiếp theo Make phải:
1. nhận tệp;
2. kiểm tra loại đầu vào;
3. trích xuất/lấy âm thanh;
4. chuyển tài liệu cho AI để phân tích;
5. nhận được một kết quả có cấu trúc chặt chẽ;
6. ghi lại kết quả vào Google Sheets;
7. gửi cho người dùng một phản hồi cá nhân ngắn gọn;
8. xử lý chính xác các lỗi, tệp trùng lặp và định dạng không được hỗ trợ.

QUY TẮC LÀM VIỆC CỦA CHÚNG TA
- Chỉ đưa ra MỘT bước tiếp theo cho mỗi tin nhắn.
- Viết tên chính xác của module Make cần thêm.
- Viết những gì cần chọn trong mỗi trường bắt buộc.
- Nếu cần một biến từ module trước — hãy chỉ rõ nguồn gốc chính xác của nó.
- Sau mỗi bước, hãy dừng lại và yêu cầu tôi gửi ảnh chụp màn hình.
- Dựa trên ảnh chụp màn hình của tôi, trước tiên hãy kiểm tra xem mọi thứ đã được thực hiện đúng chưa. Nếu có lỗi — chúng ta sẽ sửa nó và chỉ sau đó mới tiếp tục.
- Không nhảy qua các giai đoạn và không gửi ngay toàn bộ kịch bản.
- Giải thích bằng những từ ngữ đơn giản, không giả định rằng tôi biết về API, JSON hoặc lập trình.
- Nếu có nhiều cách, hãy chọn cách đơn giản và đáng tin cậy nhất cho giai đoạn thử nghiệm (pilot) và giải thích ngắn gọn lý do tại sao.

GIỚI HẠN
- định danh người dùng trong quy trình đánh giá là một mã giả danh hóa có dạng RSS 1234;
- không cần họ tên và số thẻ nhân viên;
- kết quả cho bảng tính phải có cấu trúc;
- người dùng trong Telegram chỉ nhận được phản hồi dễ hiểu, không chứa các đoạn JSON kỹ thuật.

Hãy bắt đầu với bước đầu tiên: tạo/kết nối Telegram bot và module đầu vào đầu tiên của Make.
Prompt 4. Lõi đánh giá ĐTATHV cho OpenAI/ChatGPT trong Make
Đây là phiên bản xuất bản chung của khối đánh giá. Nó đặc biệt trả về dạng JSON — theo cách này, Make dễ dàng ghi lại kết quả vào bảng tính và định tuyến câu trả lời hơn.
SYSTEM ROLE
Bạn là một người đánh giá chuyên gia về chất lượng của các đối thoại an toàn hành vi (ĐTATHV). Bạn CHỈ đánh giá nội dung của bản chép lời được cung cấp và áp dụng phương pháp luận đã được phê duyệt của doanh nghiệp.

QUAN TRỌNG
Nếu doanh nghiệp đã chuyển giao một danh sách kiểm tra riêng đã được phê duyệt — nó có ưu tiên hơn so với cấu trúc ví dụ dưới đây.
Không phát minh ra các tiêu chí không có trong phương pháp luận.

CÁC NGUYÊN TẮC CƠ BẢN CỦA PHƯƠNG PHÁP LUẬN CẦN KIỂM TRA BẰNG ÂM THANH
- có một cuộc trò chuyện thực tế với công nhân, không phải là độc thoại/thanh tra;
- công nhân được đặt câu hỏi;
- công nhân tự gọi tên/thảo luận về mối nguy và hậu quả có thể xảy ra, nếu tình huống nguy hiểm;
- thảo luận về cách thực hiện công việc an toàn;
- thảo luận về các nguồn mối nguy khác và các biện pháp an toàn;
- trong lúc làm việc an toàn, người quản lý ghi nhận và củng cố một hành động an toàn cụ thể;
- giao tiếp tôn trọng;
- cuộc trò chuyện kết thúc bằng một tóm tắt/lời cảm ơn dễ hiểu;
- không tính điểm cho quan sát bằng mắt thường, nếu không thể xác nhận từ âm thanh.

ĐẦU VÀO
- transcript: bản chép lời đầy đủ;
- rss_id: định danh giả danh hóa có dạng RSS 1234;
- methodology_context: các trích đoạn/quy tắc của phương pháp luận đã được phê duyệt;
- optional_checklist: danh sách kiểm tra cục bộ đã được phê duyệt, nếu có.

QUY TẮC ĐÁNH GIÁ
1. Chỉ sử dụng các sự kiện từ transcript.
2. Không đoán ý định.
3. Không khôi phục họ tên từ giọng nói/ngữ cảnh.
4. Nếu transcript rõ ràng không đầy đủ hoặc không mạch lạc — quality_status="insufficient_data" và không đưa ra đánh giá tổng thể.
5. Nếu áp dụng danh sách kiểm tra cục bộ, hãy đánh giá tất cả các mục mà không bỏ sót.
6. Đối với mỗi kết luận, hãy giữ một evidence ngắn gọn — cụm từ/nội dung từ bản chép lời xác nhận quyết định.

ĐẦU RA — CHỈ JSON, KHÔNG CÓ MARKDOWN VÀ KHÔNG CÓ VĂN BẢN TRƯỚC/SAU
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 câu, người quản lý có thể hiểu được",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

KIỂM TRA TRƯỚC KHI TRẢ LỜI
- JSON hợp lệ;
- rss_id không bị thay đổi;
- tổng điểm tương ứng với tổng của các tiêu chí;
- evidence không chứa các sự kiện bịa đặt;
- nếu dữ liệu không đủ, không có overall_score_percent bịa đặt.
Bình luận: Vì không có checklist tính điểm đối thoại an toàn hành vi (ĐTAT) riêng biệt nào được phê duyệt ghi nhận trong các tài liệu cung cấp, tôi không đưa ra thang điểm tự nghĩ ra để làm tiêu chuẩn doanh nghiệp. Trong phiên bản làm việc, bạn cần thay thế bằng checklist thực tế của bạn.
Prompt 5. Mô-đun phản hồi riêng biệt trên Telegram
Nếu trong kịch bản sử dụng lệnh gọi mô hình lần thứ hai, tốt nhất nên giới hạn nó chỉ ở việc định dạng đánh giá đã hoàn thành. Điều này giúp tăng tính ổn định: mô-đun thứ hai không nên "suy nghĩ lại" các điểm số.
Bạn nhận được JSON ĐÃ HOÀN THÀNH đánh giá của chuyên gia đối với ĐTAT từ bước trước.
Đừng đánh giá lại bản ghi và đừng thay đổi điểm số.

Tạo một phản hồi ngắn gọn cho người dùng trên Telegram.

ĐỊNH DẠNG
RSS: <mã>
Đánh giá: <phần trăm hoặc «không được đánh giá — không đủ dữ liệu»>

Những gì đã thực hiện tốt:
• 2–4 mục ngắn gọn từ strengths

Những gì cần cải thiện:
• 2–4 mục cụ thể từ improvements

Cho ĐTAT tiếp theo:
<1–2 hành động cụ thể nhất có thể>

QUY TẮC
- tối đa 700–1200 ký tự;
- giọng điệu công việc và tôn trọng;
- không có JSON kỹ thuật;
- không có họ tên;
- không bịa ra các nhận xét mới;
- không sử dụng khẩu hiệu động viên;
- nếu quality_status=insufficient_data — yêu cầu ghi âm lại/tải lại âm thanh và không hiển thị đánh giá.
Prompt 6. Chuẩn hóa kết quả trước khi vào Google Sheets
Bước này hữu ích nếu Google Sheets cần nhận cùng một cấu trúc bất kể độ dài của văn bản đánh giá.
Kiểm tra hàng dữ liệu trước khi ghi vào Google Sheets.

Các trường dự kiến:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

QUY TẮC
1. Không thêm họ tên và mã số nhân viên.
2. rss_id phải khớp với mẫu: RSS + dấu cách + 3–6 chữ số.
3. overall_score_percent phải là một số 0–100 hoặc để trống nếu insufficient_data.
4. Chuyển đổi mảng thành các chuỗi ngắn phân tách bằng «; ».
5. Nếu thiếu trường bắt buộc — trả về error=true và liệt kê missing_fields.
6. Nếu tất cả đều đúng — error=false.

CHỈ ĐẦU RA JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Kiểm toán kịch bản Make đã hoàn thành qua ảnh chụp màn hình
Phù hợp làm prompt cuối cùng để kiểm tra kịch bản trước khi thí điểm hàng loạt.
Tôi sẽ gửi cho bạn ảnh chụp màn hình kịch bản Make của tôi.
Hãy thực hiện kiểm toán kỹ thuật với tư cách là cố vấn về tự động hóa no-code.

Kiểm tra theo ảnh chụp màn hình và mô tả của tôi:
1. thứ tự các mô-đun;
2. các tuyến đường Router;
3. xử lý tin nhắn không được hỗ trợ;
4. lưu trữ trạng thái tạm thời trong Data store;
5. nhận và truyền tệp âm thanh;
6. lệnh gọi AI;
7. phân tích cú pháp JSON;
8. ghi vào Google Sheets;
9. gửi kết quả đến Telegram;
10. nhánh lỗi và thử lại;
11. nguy cơ trùng lặp khi chạy lại;
12. nguy cơ một người dùng nhận được kết quả của người khác.

Đừng đề xuất xây dựng lại toàn bộ nếu kiến trúc hiện tại hoạt động.
Trước tiên hãy liệt kê:
- những gì đã tốt;
- 3 rủi ro nghiêm trọng nhất;
- MỘT bước tiếp theo cần thực hiện đầu tiên là gì.
Sau đó hãy dừng lại và đợi ảnh chụp màn hình/xác nhận của tôi.
Trình tự thực hành cho người đọc
- Tải phương pháp và checklist đã phê duyệt vào Project/tác nhân đã chọn.
- Thiết lập Prompt 1 và kiểm tra trên một số bản ghi tiêu chuẩn.
- Chạy cùng một bản ghi nhiều lần và áp dụng Prompt 2 để đánh giá khả năng tái tạo.
- Nếu cần tự động hóa — bắt đầu với Prompt 3 và lắp ráp Make theo từng mô-đun cùng với việc kiểm tra ảnh chụp màn hình.
- Trong Make, sử dụng Prompt 4 làm cốt lõi chuyên gia và yêu cầu JSON nghiêm ngặt.
- Nếu cần thiết, tách biệt phản hồi của người dùng trong Prompt 5.
- Trước khi ghi vào Google Sheets, chuẩn hóa dữ liệu bằng Prompt 6.
- Trước khi khởi chạy hàng loạt, kiểm tra toàn bộ sơ đồ bằng Prompt 7.
Bình luận 8
Cảm ơn Alexander Bondarenko vì bài viết, có rất nhiều điều để suy ngẫm. AI hiện là một chủ đề rất thịnh hành và thú vị. Các đồng nghiệp đã làm một công việc tuyệt vời.
Giải pháp được đề xuất giúp giảm thiểu sự quá tải mãn tính của bộ phận an toàn và sức khỏe nghề nghiệp và an toàn công nghiệp và giải phóng ít nhất một nhân viên khỏi công việc thường ngày. Theo ý kiến của tôi, lợi ích chính là hệ thống hoạt động như một "trình mô phỏng kỹ thuật số".
Tuy nhiên, sau khi cân nhắc tất cả những "ưu điểm" và "nhược điểm", tôi sẽ không khuyên mở rộng quy mô đánh giá bằng AI đối với các cuộc họp an toàn năm phút và, đặc biệt là, các cuộc đối thoại an toàn hành vi.
Do đó, đánh giá bằng AI:
Đừng vội vã tìm kiếm một "chuyên gia thứ hai" trong AI, nếu có vấn đề với người đầu tiên.
Ivan, cảm ơn bạn về những phản hồi mang tính xây dựng.
Tôi đồng ý với rủi ro của "vở kịch trước micro": nếu AI chỉ đơn thuần bị biến thành một công cụ kiểm soát vì mục đích đánh giá, sẽ có rất ít lợi ích.
Nhưng, có lẽ, trong bài viết tôi đã không tiết lộ đầy đủ con đường phía trước của chúng tôi. Cuộc đánh giá bằng máy ghi âm hồi tháng Tư đối với chúng tôi trước hết là một trình mô phỏng kỹ thuật số.
AI không chỉ đưa ra điểm số mà còn đưa ra phản hồi: những gì đã làm tốt, những gì cần cải thiện, cách tốt nhất để thu hút công nhân và truyền đạt rủi ro.
Đúng vậy, một người có thể chuẩn bị và tiến hành một cuộc họp giao ban năm phút mẫu mực. Nhưng ở giai đoạn này, chúng tôi đã bị thuyết phục về điều chính: các nhà quản lý của chúng tôi biết và có khả năng tiến hành nó một cách chính xác!
Hôm nay chúng tôi đã tiến xa hơn. Các cuộc họp giao ban năm phút được đánh giá một cách có hệ thống dựa trên bản ghi từ các camera cố định tại những nơi cấp giấy phép làm việc, và ở những nơi không có camera, máy ghi hình "Revizor" được sử dụng. Đây không còn là một bản ghi âm được chuẩn bị đặc biệt, mà là công việc hàng ngày thông thường (nó cũng đi kèm với phản hồi cá nhân với các khuyến nghị).
Do đó, đối với chúng tôi, AI không phải là sự thay thế cho người quản lý và không phải là "người giám sát kỹ thuật số", mà là một công cụ thường xuyên để học tập và phản hồi. Điều này đặc biệt quan trọng đối với các chuyên gia có thế mạnh về kỹ thuật, những người không phải lúc nào cũng dễ dàng nói chuyện một cách ngắn gọn, rõ ràng và thuyết phục với mọi người.
Với các cuộc đối thoại về hành vi, mọi thứ thực sự phức tạp hơn, và ở đây chúng tôi vẫn đang tìm kiếm mô hình tối ưu. Nhưng nguyên tắc vẫn giữ nguyên: AI không nên thay thế một cuộc trò chuyện trực tiếp — nó nên giúp người quản lý tiến hành điều đó tốt hơn.
Và tiêu chí chính đối với chúng tôi không phải là sự đánh giá của thuật toán, mà là sự thay đổi trong hành vi thực sự của mọi người!
Để đảm bảo khả năng tương thích với các nền tảng tâm lý xã hội của văn hóa an toàn, huấn luyện viên AI (cũng như nhiều công cụ kiểm soát kỹ thuật số khác) phải được tách biệt khỏi KPI tiền thưởng của các nhà quản lý. Lựa chọn tốt nhất và có vẻ như là lựa chọn hiệu quả duy nhất để sử dụng nó là công cụ tự phát triển bảo mật, mà bạn đang nói đến.
Theo kinh nghiệm của tôi, điều cực kỳ quan trọng là tạo ra động lực phù hợp:
Ivan, tôi xin cảm ơn bạn vì những lời lẽ ấm áp và cuộc thảo luận đầy ý nghĩa.
Tôi hoàn toàn đồng ý: không thể xây dựng một văn hóa an toàn bền vững "bằng sự ép buộc", đặc biệt là khi nói đến hành vi và sự tham gia cá nhân của các nhà quản lý.
Chúng tôi đang cố gắng làm việc nhiều hơn thông qua sự công nhận và động lực tích cực. Ví dụ, mỗi tháng dựa trên kết quả đánh giá kỹ thuật số, chúng tôi chọn ra sáu buổi họp an toàn năm phút xuất sắc nhất, phân tích trong một video riêng biệt về chính xác những gì đã được thực hiện tốt, và trao tặng bằng khen cho các quản đốc từ tay tổng giám đốc tại Ủy ban Trung ương về An toàn và Vệ sinh Lao động — trực tiếp trước một lượng lớn (300) nhà quản lý và chuyên gia.
Với 1300 nhà quản lý, chuyên gia và nhân viên văn phòng, đây đã là một cuộc cạnh tranh khá nghiêm túc và quan trọng là sự công nhận công khai đối với các thực tiễn tốt.
Hiện nay chúng tôi đang bắt đầu mở rộng phương pháp này sang các tổ chức nhà thầu.
Tôi xin cảm ơn bạn vì sự trao đổi ý kiến.
Tôi cũng đang theo dõi sát sao các ấn phẩm của bạn và thực tiễn của các đồng nghiệp.
Cuối cùng, tất cả chúng ta đều đang làm chung một việc — tìm kiếm những cách thức hiệu quả để phát triển văn hóa an toàn và làm cho nó thực sự sống động, chứ không phải là hình thức!!!
Một công cụ thú vị.
Tôi có một câu hỏi về tính bảo mật: thông tin được tải vào bot an toàn cho công ty đến mức nào? Hiện nay nhiều người đang sử dụng, nhưng có những nghi ngờ rằng việc sử dụng mở AI mà không có dịch vụ cục bộ trên đám mây không tương quan tốt lắm với vấn đề rò rỉ dữ liệu..
Bộ phận an ninh, luật sư đã phản ứng thế nào với dự án này? Hay Quý vị vẫn bảo vệ theo một cách nào đó dữ liệu của mình được tải lên bot Telegram? (có thể tôi đã không hiểu hoàn toàn chính xác cơ chế hoặc đã bỏ lỡ chi tiết này ở đâu đó).
Irina, cảm ơn bạn, câu hỏi hoàn toàn đúng trọng tâm!
Trong phiên bản ban đầu với Make, chúng tôi đã cố ý giảm thiểu dữ liệu cá nhân: họ tên, mã số nhân viên, chức vụ và các thông tin định danh khác không được đưa lên đám mây — chỉ có mã ngẫu nhiên cá nhân và bản ghi âm. Đồng thời, điều quan trọng cần hiểu là: bản thân giọng nói cũng thuộc về dữ liệu cá nhân, vì vậy cách tiếp cận này không giải quyết hoàn toàn vấn đề bảo mật. Trong video của bài viết, bạn có thể thấy chính xác sơ đồ này đã được xây dựng như thế nào.
Song song đó, nhóm an toàn và vệ sinh lao động và an toàn công nghiệp của chúng tôi đã phát triển một tùy chọn thứ hai — đã hoàn toàn nằm trong phạm vi công ty trên AI nội bộ Fire của chúng tôi. Sau ủy ban trung ương về an toàn và vệ sinh lao động diễn ra hai ngày trước, đây chính xác là hướng đi mà chúng tôi quyết định tiến tới.
Bây giờ Fire đã trích xuất rãnh âm thanh từ các bản ghi của camera cố định hoặc máy ghi hình, chép lời cuộc họp năm phút, tiến hành đánh giá theo các tiêu chí đã chỉ định, tạo phản hồi và chuyển kết quả đến bảng điều khiển. Khi xử lý lặp lại cùng một bản ghi, chúng tôi nhận được một đánh giá ổn định theo cùng một quy tắc.
Hơn nữa, mục tiêu ở đây không phải là «chấm điểm» cho người quản lý. Chúng tôi có khoảng 1.300 kỹ sư và nhân viên kỹ thuật, và hệ thống cho phép chúng tôi thấy chính xác tính hệ thống: liệu một người có khả năng tiến hành một cuộc họp năm phút mẫu mực đẹp mắt không chỉ một lần, mà thực sự làm điều đó với chất lượng cao trong mỗi ca làm việc. Nơi nào cần thiết — để đào tạo thêm, ở đâu đó để sửa chữa giao tiếp với mọi người, ở đâu đó để thấy một thực hành tốt bền vững.
Theo cùng một nguyên tắc, kể từ ngày 1 tháng 10, một phạm vi nội bộ thứ hai đã được triển khai để đánh giá các cuộc đối thoại an toàn hành vi.
Do đó, bạn đã nêu chủ đề rò rỉ dữ liệu hoàn toàn đúng: đối với AI đám mây, đây là một vấn đề thực tế.
Chúng tôi đã bắt đầu với việc ẩn danh tối đa, và bây giờ chúng tôi đang chuyển sang xử lý bên trong một phạm vi công ty được bảo vệ.
cảm ơn ngài vì câu trả lời rất chi tiết này. Bây giờ mọi thứ đã rõ ràng. Tôi đã ghi nhận kinh nghiệm của ngài