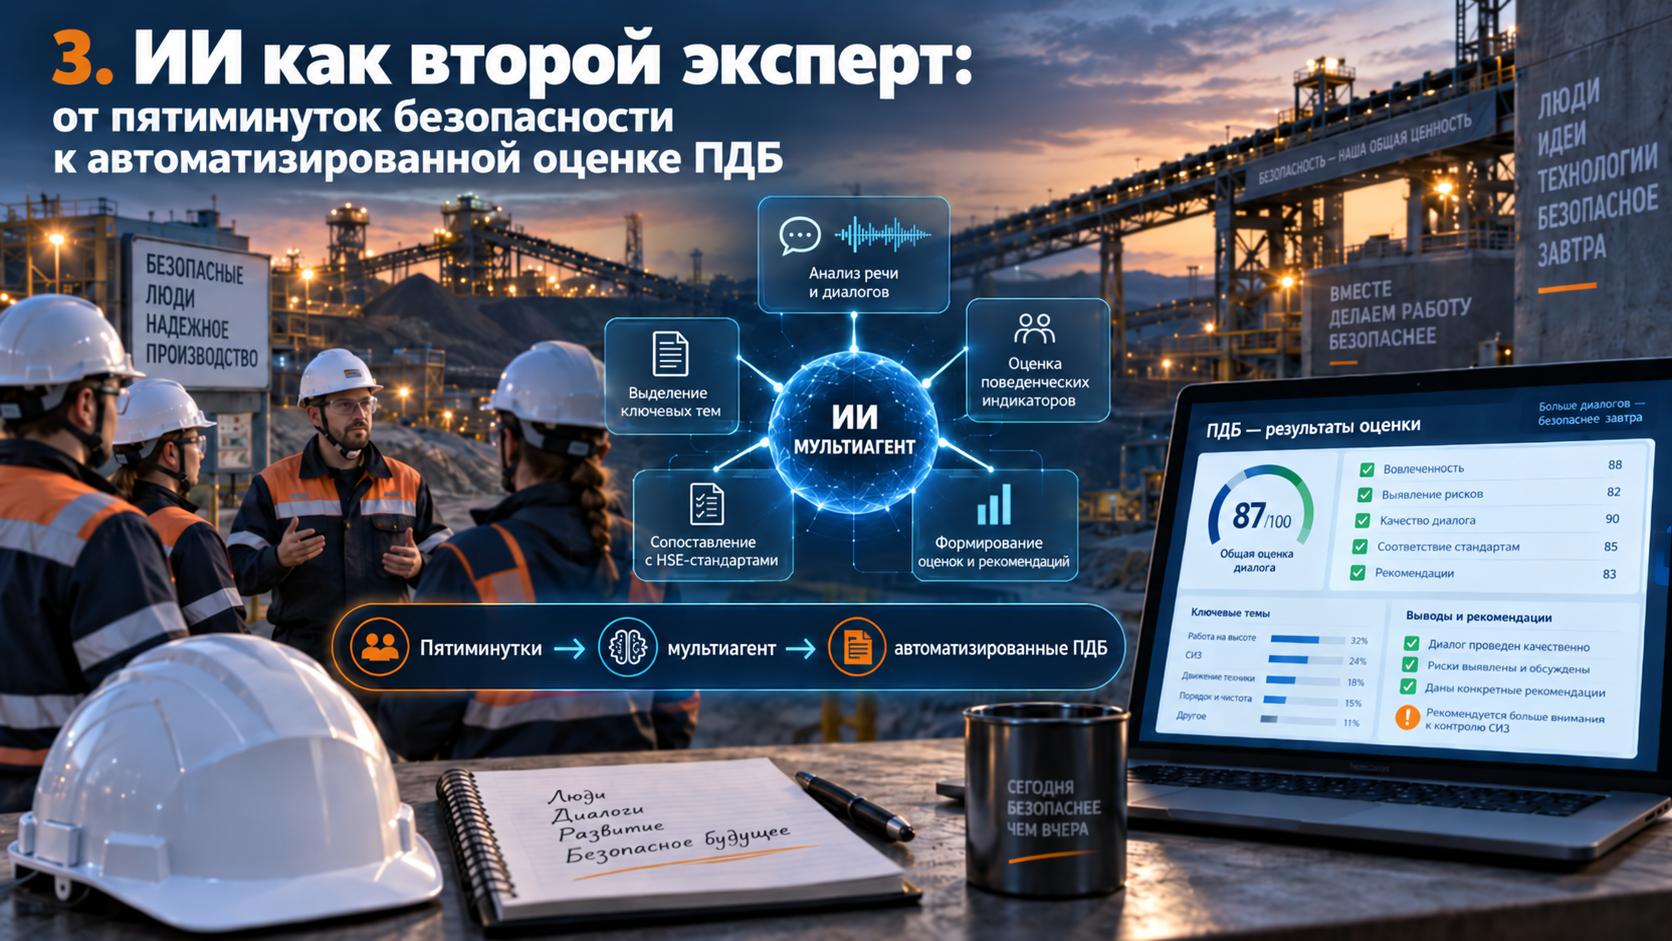
KI als zweiter Experte: von Sicherheitskurzgesprächen zur automatisierten BSD-Bewertung
Sicherheitskurzgespräche → digitale Bewertung → Make → automatisierte verhaltensbezogene Sicherheitsdialoge
Hauptidee: Die KI ersetzt nicht den Schichtleiter oder Sicherheitsexperten. Sie wird zu einem einheitlichen „zweiten Experten“, der dieselben Kriterien anwendet, persönliches Feedback gibt und es ermöglicht, die Qualitätskontrolle auf hunderte und tausende reale Gespräche zu skalieren.
Warum wir überhaupt anfingen, das Gespräch zu bewerten, und nicht die Tatsache der Durchführung
Im Arbeitsschutz ist es einfach, Fakten zu zählen: Ein Sicherheitskurzgespräch wurde durchgeführt, ein verhaltensbezogener Sicherheitsdialog wurde registriert, eine Karte ausgefüllt. Viel schwieriger ist es, die Frage zu beantworten, wie qualitativ hochwertig die Führungskraft das Gespräch selbst geführt hat und ob sie das Ziel erreicht hat.
Das Sicherheitskurzgespräch in unserer Methodik ist ein obligatorischer Teil der Schichtübergabe mit einer Dauer von 5–10 Minuten. Die Führungskraft muss ein spezifisches, aktuelles Thema behandeln und einen verständlichen Zusammenhang herstellen: Gefahr → Folgen → Sicherheitsmaßnahmen. Dabei ist nicht nur der Monolog des Vorarbeiters wichtig, sondern auch der Dialog mit den Mitarbeitern: Fragen, Antworten und die Einbeziehung in die Diskussion.
Deshalb lautete die ursprüngliche Aufgabe nicht „das Vorhandensein eines Protokolls überprüfen“, sondern anders: Kann man einer KI beibringen, die reale Qualität solcher Gespräche einheitlich zu bewerten und der Führungskraft sachliches Feedback zu geben?
Phase 1. Zuerst die Methodik, dann die Künstliche Intelligenz
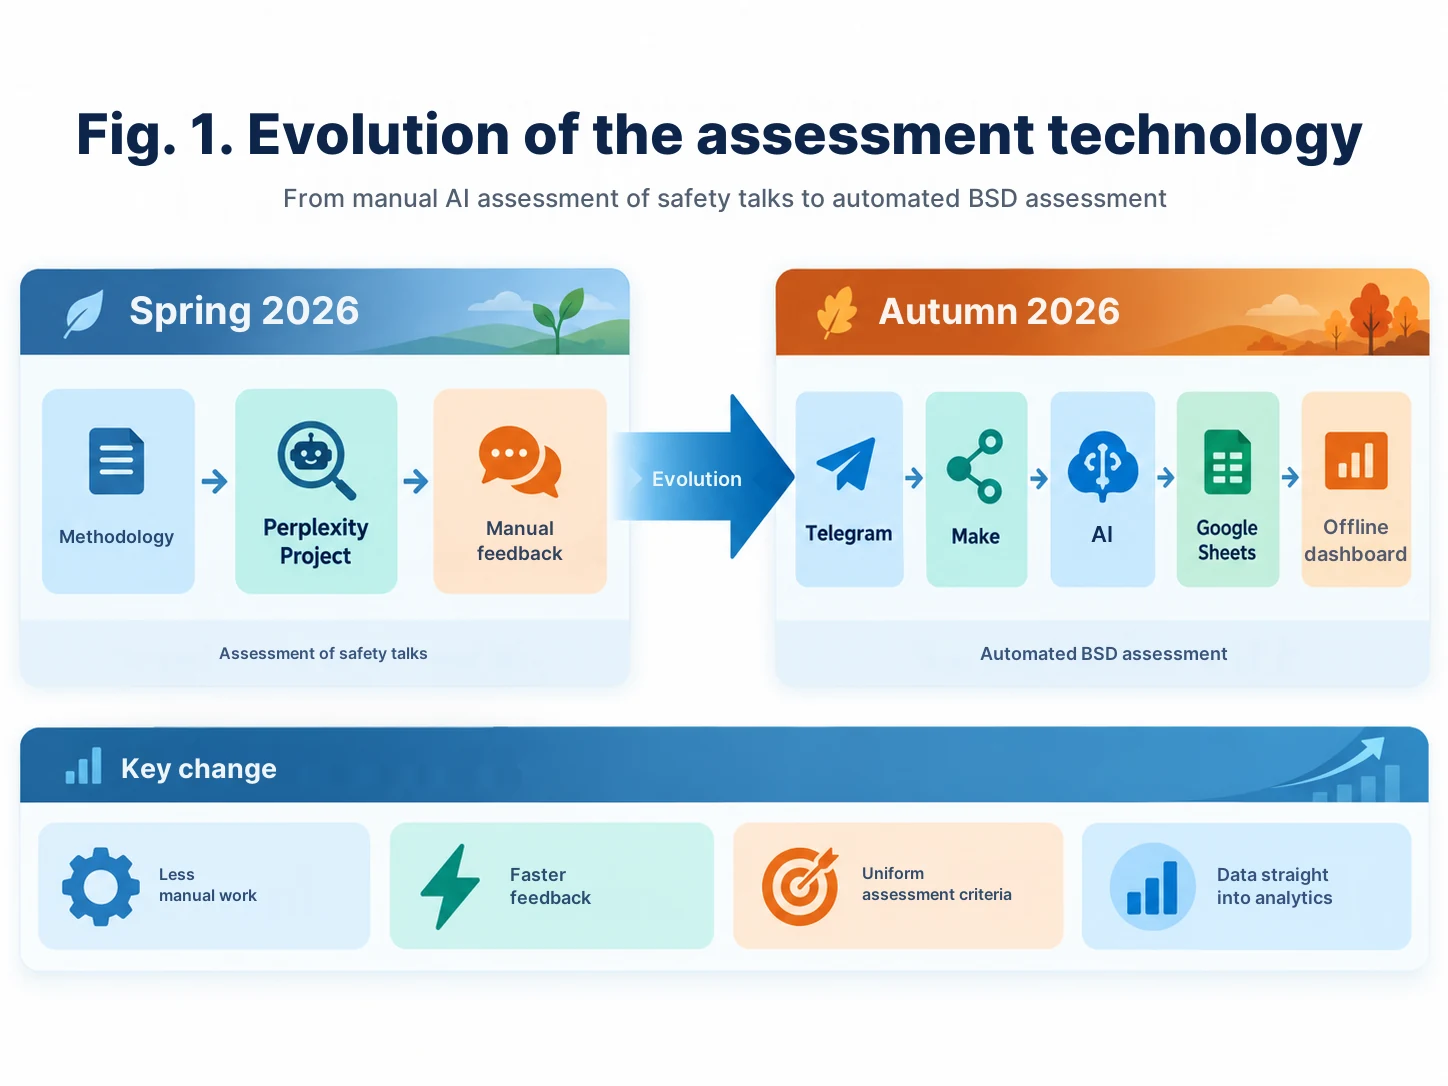
Im Frühjahr 2026 begannen wir mit Sicherheitskurzgesprächen. Vor der Einführung der KI-Bewertung wurden methodische Empfehlungen und ein Schulungsvideo darüber erstellt, wie man ein Sicherheitskurzgespräch richtig durchführt. Erst danach erschien der digitale Bewerter.
Als ersten Arbeitsbereich nutzten wir Perplexity Space — heute heißt eine ähnliche Umgebung in Perplexity Project. In das Project luden wir den methodischen Leitfaden und die Bewertungs-Checkliste hoch, und für das Modell wurde separat ein strenger Prompt vorbereitet.
Die Aufgabe des Prompts unterschied sich grundlegend von der üblichen Anfrage „bewerte den Auftritt“. Der KI war es nur erlaubt, das anzurechnen, was im Audio tatsächlich zu hören war. Fehlt das Element — 0 Punkte. Wenn es nur formell erwähnt wurde — teilweise Erfüllung. Wenn es logisch und vollständig ausgeführt wurde — erfüllt.
In der aktuellen Checkliste gibt es sieben Kriterien: Vorstellung und Zielsetzung; konkrete Gefahr; Logik „Gefahr – Folgen – Maßnahmen“; emotionaler Impuls; Sicherheitsmaßnahmen; Dialog mit den Mitarbeitern; abschließendes Resümee und Verbindung zu den auszuführenden Arbeiten.
Prompt 1 — die modernisierte Version des Prompts für Perplexity Project siehe im Anhang.
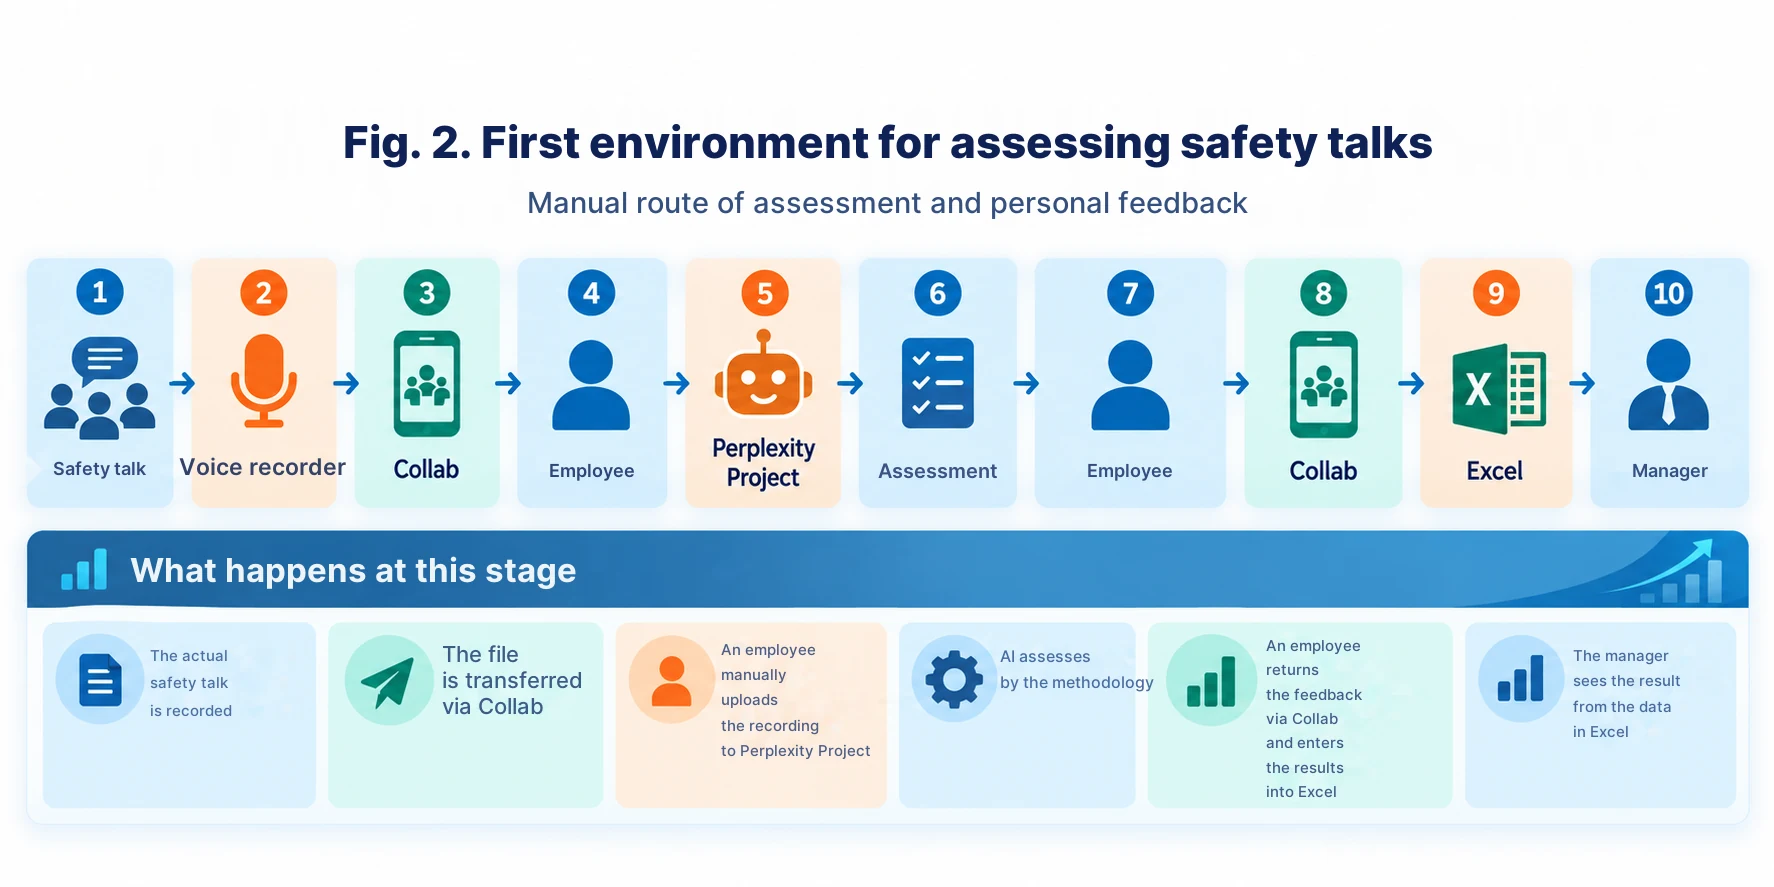
Wie der erste, noch manuelle Kreislauf aussah
Der Schichtleiter zeichnete das durchgeführte Sicherheitskurzgespräch mit einem Diktiergerät auf. Über die Unternehmensanwendung Collab wurde die Aufnahme an einen zugewiesenen Mitarbeiter übermittelt. Der Mitarbeiter lud das Audio in Perplexity Project hoch, erhielt die Bewertung und gab das persönliche Feedback ebenfalls über Collab an die Führungskraft zurück.
Gleichzeitig wurde das Ergebnis in Excel eingetragen: Abteilung, Führungskraft, Bewertung, Anzahl der Versuche. Anhand der Tabelle erstellten wir eine einfache Analytik — Durchschnittsergebnisse der Abteilungen, Dynamik und Anzahl der Wiederholungszyklen.
Als Bestehensgrenze für den praktischen Zyklus legten wir 80 % fest. Wenn das Ergebnis niedriger war, führte die Führungskraft das nächste Sicherheitskurzgespräch bereits unter Berücksichtigung der Anmerkungen der KI durch. So entstand nicht nur eine Kontrolle, sondern auch ein individuelles Training direkt am Arbeitsplatz.
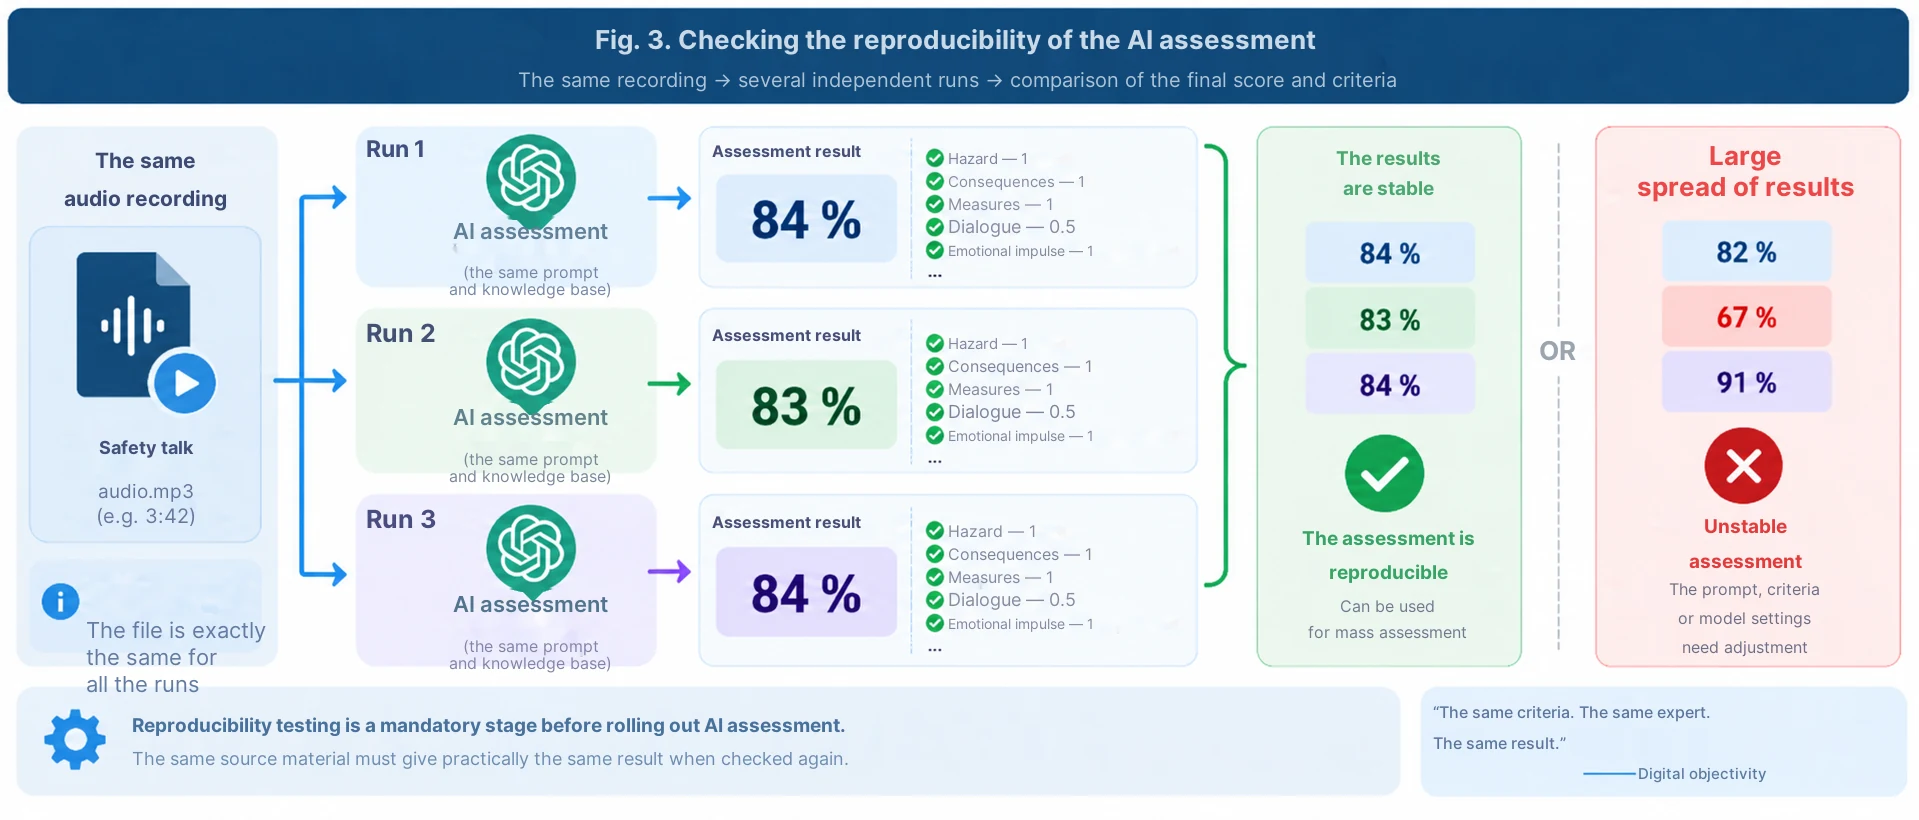
Wir überprüften nicht nur den Menschen — zuerst überprüften wir die KI selbst
Für mich ist das eines der wichtigsten Elemente des gesamten Schemas. Wir haben dieselbe Audioaufnahme absichtlich mehrmals zur Bewertung eingeschickt. Wenn ein und dasselbe Material heute 82 %, eine Minute später 65 % und dann 91 % erhält, ist ein solcher digitaler Experte noch nicht bereit, Menschen zu bewerten.
Deshalb strebten wir nach Reproduzierbarkeit: Eine identische Aufnahme musste eine identische oder nahezu identische Bewertung ergeben. Wenn die Streuung spürbar wurde, korrigierten wir den Prompt, präzisierten die Kriterien und entfernten zweideutige Formulierungen.
Für mich nenne ich das „digitale Objektivität“. Das bedeutet nicht, dass die KI die absolute Wahrheit besitzt. Es geht um etwas anderes: Ein einheitlicher Experte wendet bei allen den gleichen Maßstab an und ist unabhängig von Stimmung, persönlichen Sympathien oder davon, wer genau heute die Überprüfung durchführt.
Prompt 2 — das Protokoll zur Überprüfung der Reproduzierbarkeit der Bewertung siehe im Anhang.
Warum das manuelle Schema nicht mehr ausreichend war
Für den Piloten war der manuelle Weg bequem: eine Datei erhalten, hochladen, auf das Ergebnis warten, Feedback zurückgeben und die Punktzahl in Excel eintragen. Aber dieser Ansatz hat eine natürliche Grenze.
Wenn das Volumen bereits in hunderten und tausenden Aufnahmen gemessen wird, fangen wir an, nicht die Bewertung zu automatisieren, sondern neue administrative Arbeit rund um die Bewertung zu schaffen. Daher wurde beim Übergang zu verhaltensbezogenen Sicherheitsdialogen die Aufgabe anders formuliert: den Menschen aus der technischen Kette dort entfernen, wo seine Beteiligung keinen Wert schafft.
Phase 2. Ein verhaltensbezogener Dialog ist komplexer als ein gewöhnliches Sicherheitskurzgespräch
Ein verhaltensbezogener Sicherheitsdialog (BSD) ist nicht einfach nur ein kurzer Vortrag. Die Methodik umfasst die Beobachtung der tatsächlichen Arbeit und ein Gespräch mit dem Menschen. Für die Führungskraft ist es wichtig, sicheres oder unsicheres Verhalten zu erkennen und dann durch Fragen zu erreichen, dass der Mitarbeiter selbst die Gefahr, mögliche Folgen und die sichere Arbeitsweise benennt.
Wenn der Mitarbeiter unsicher arbeitet, besteht der Kernteil des Gesprächs darin, die Gefahren und Folgen zu diskutieren, danach die sichere Arbeitsweise und andere Gefahrenquellen. Wenn die Person sicher arbeitet, muss die Führungskraft das richtige Verhalten bemerken und bekräftigen, und dann das Gespräch nutzen, um andere Sicherheitsfragen zu diskutieren.
Genau deshalb muss der Bewertungskreislauf des BSD nicht nur die Worte der Führungskraft überprüfen, sondern auch das Vorhandensein eines echten Dialogs: Wurden Fragen gestellt, hat der Mitarbeiter geantwortet, wurden die Gründe für das Verhalten, die Folgen, die sicheren Handlungen und der Abschluss des Gesprächs diskutiert.
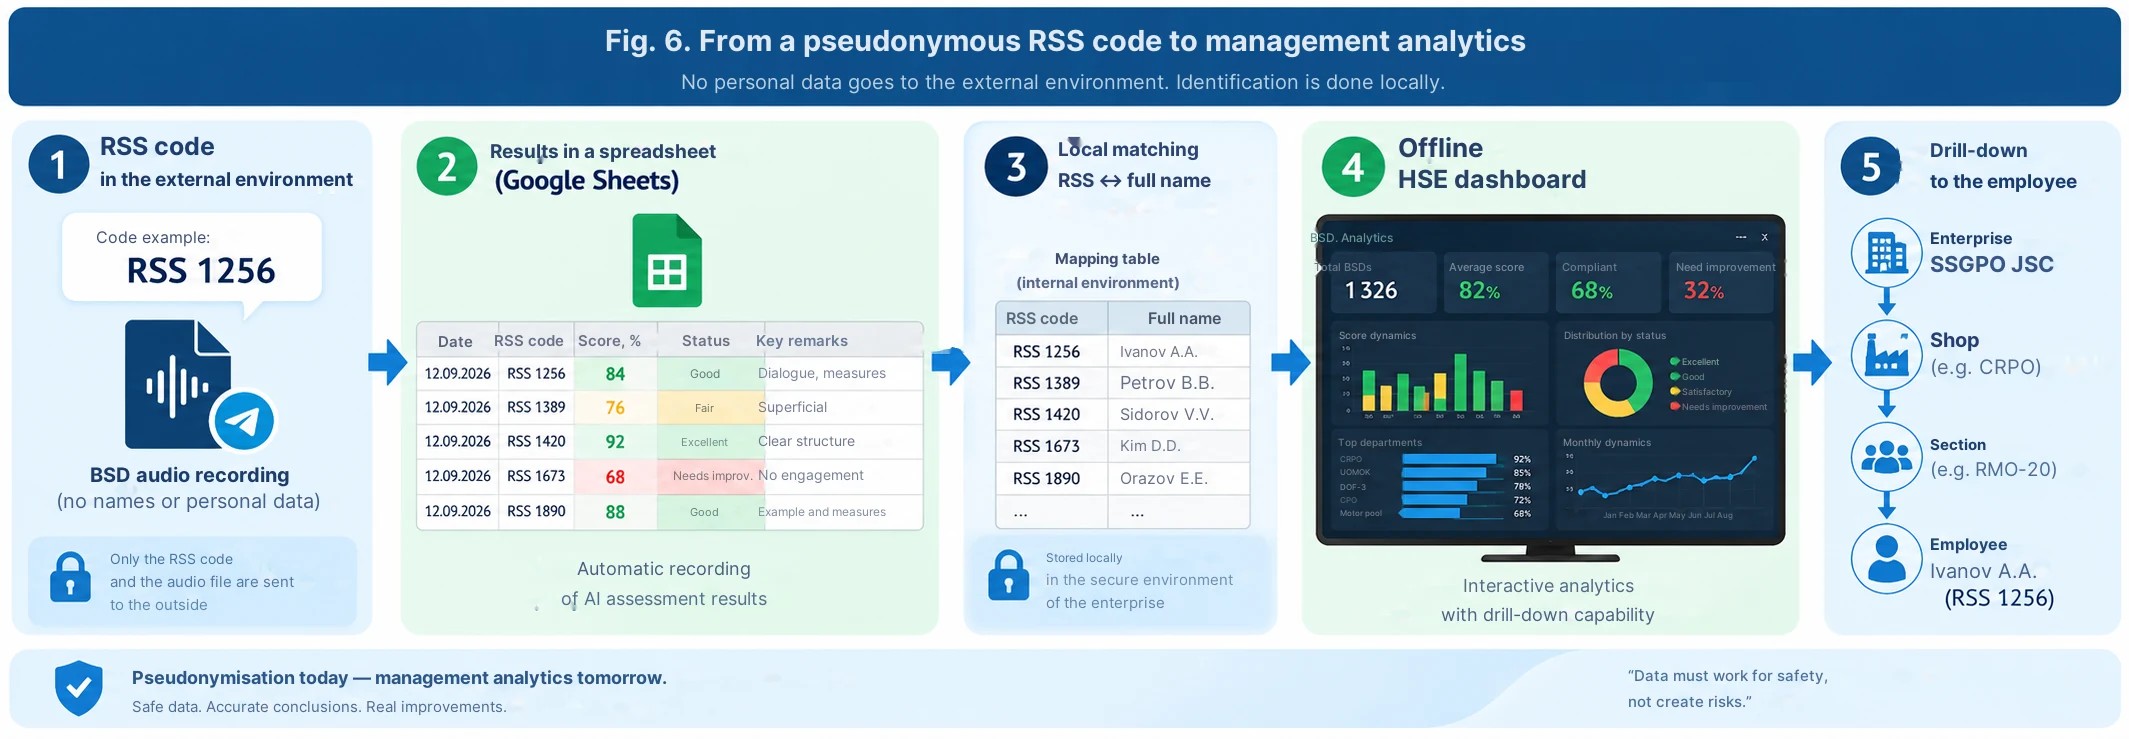
Pseudonymer Identifikator statt Nachname
Bei der massenhaften Automatisierung haben wir das Problem der Identifikation separat gelöst. Innerhalb der Unternehmensumgebung ERGIS wird jedem Teilnehmer ein spezieller Code der Art RSS 1256 zugewiesen. Das ist weder eine Personalnummer noch ein Nachname.
Vor Beginn der Aufnahme spricht die Führungskraft ihren RSS-Code ein, wonach sie den BSD durchführt. Im Gespräch besteht keine Notwendigkeit, Nachnamen oder Personalnummern zu nennen. Die Zuordnung „RSS-Code ↔ konkreter Mitarbeiter“ bleibt innerhalb der Unternehmensumgebung und wird später bei der lokalen Analytik verwendet.
Hier ist es korrekter, nicht von vollständiger Anonymisierung zu sprechen, sondern von Pseudonymisierung: In der Audiodatei bleibt dennoch die Stimme der Person. Aber der Umfang der personenbezogenen Daten, die den automatisierten Kreislauf durchlaufen, wird erheblich reduziert.
Ein kleines Geheimnis: Ich bin kein Programmierer
Die Architektur der neuen Lösung haben wir über Make zusammengebaut. Ich bin kein Programmierer und habe dies zu Beginn der Arbeit direkt an ChatGPT geschrieben.
Die Anfrage war einfach: „Führe mich Schritt für Schritt durch die Erstellung dieser Automatisierung. Lass uns eine Aktion nach der anderen machen. Ich werde sie in Make ausführen und einen Screenshot senden. Nach der Überprüfung gib mir den nächsten Befehl.“
Danach lief es genau so ab. ChatGPT erklärte, welches Modul zu erstellen ist und was darin auszufüllen ist; ich führte die Aktion aus und sendete einen Screenshot; nach der Überprüfung erhielt ich den nächsten Schritt. Auf ähnliche Weise wurde ein Telegram-Bot erstellt und die gesamte Kette verknüpft.
Dies ist für mich eine wichtige Schlussfolgerung aus der Praxis des Vibe-Codings: Ein Spezialist muss die Syntax von API oder Make nicht im Voraus kennen. Aber er ist verpflichtet, den Produktionsprozess gut zu verstehen, das Ergebnis, das der Benutzer erhalten soll, und in der Lage zu sein, jede Phase konsequent zu überprüfen.
Prompt 3 — der Start-Prompt „führe mich Schritt für Schritt durch Make“ siehe im Anhang.
Was jetzt passiert: Telegram → Make → KI → Ergebnis
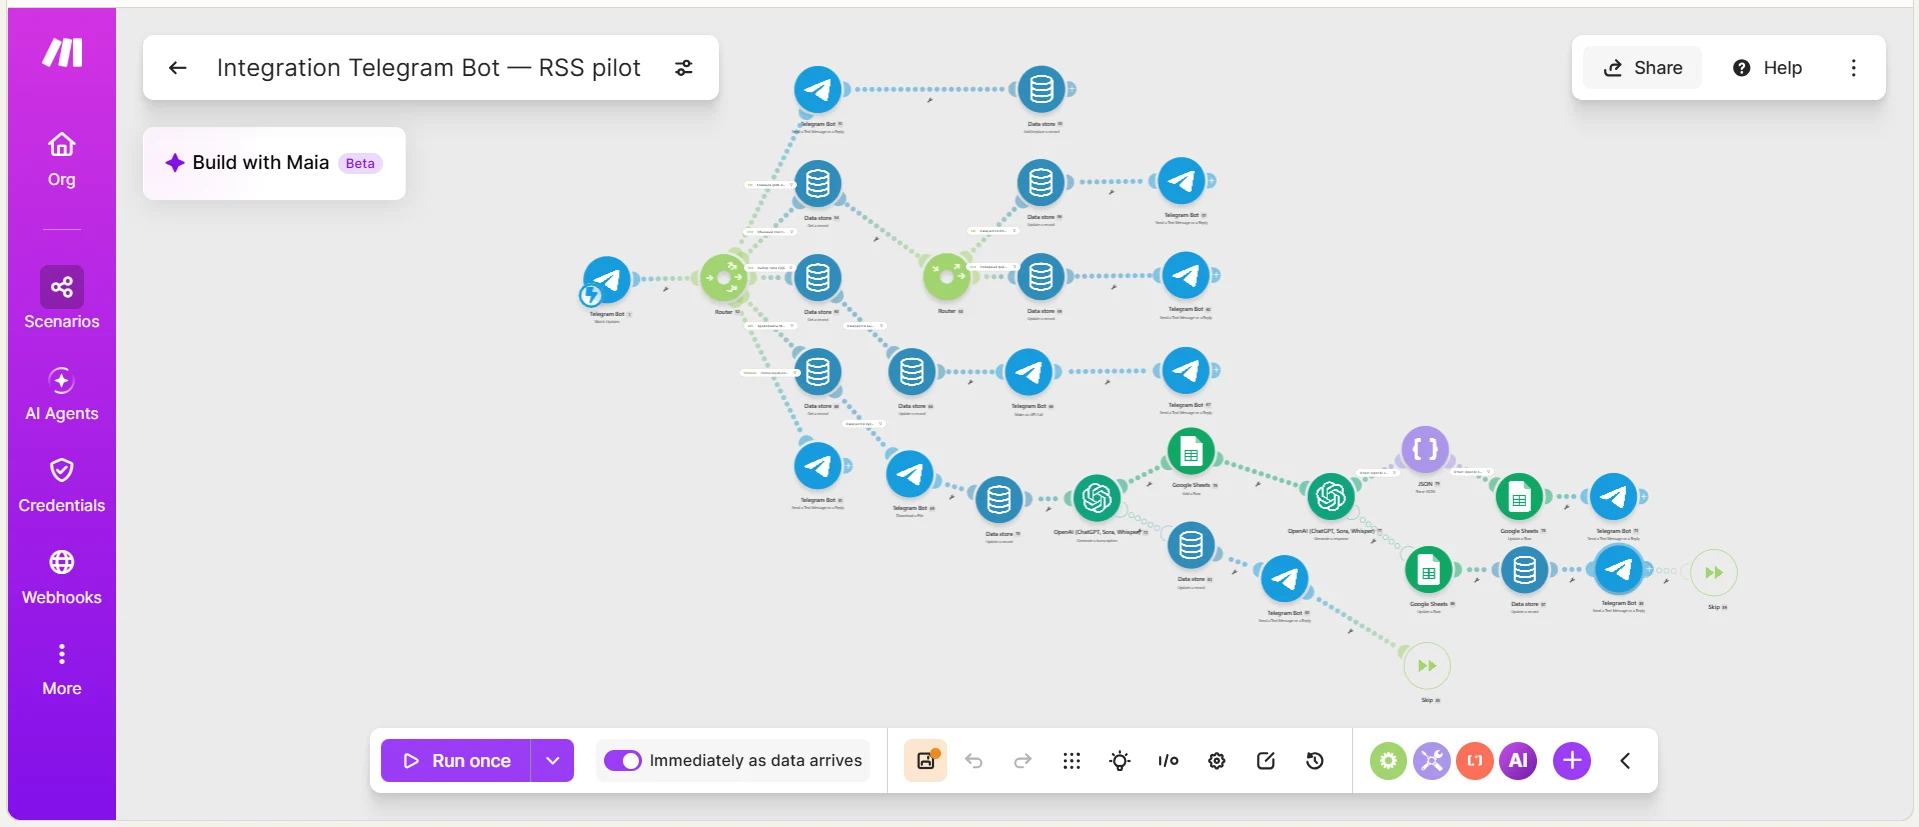
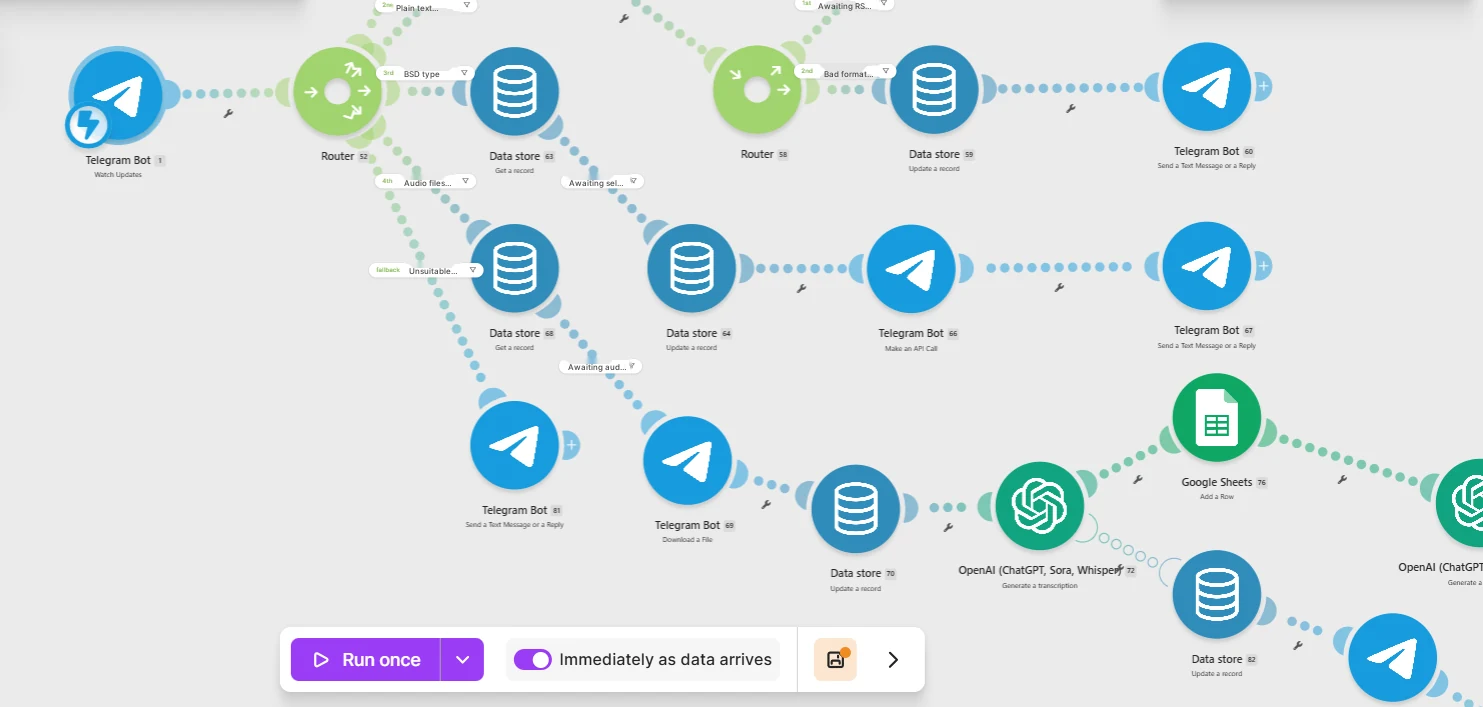
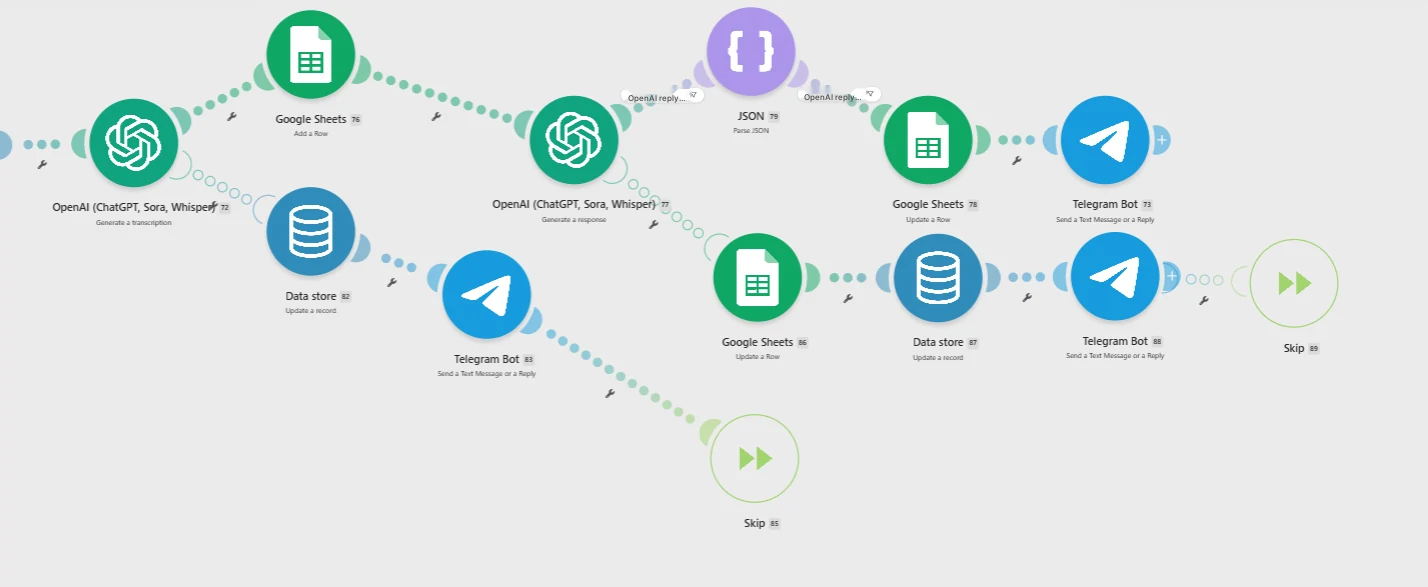
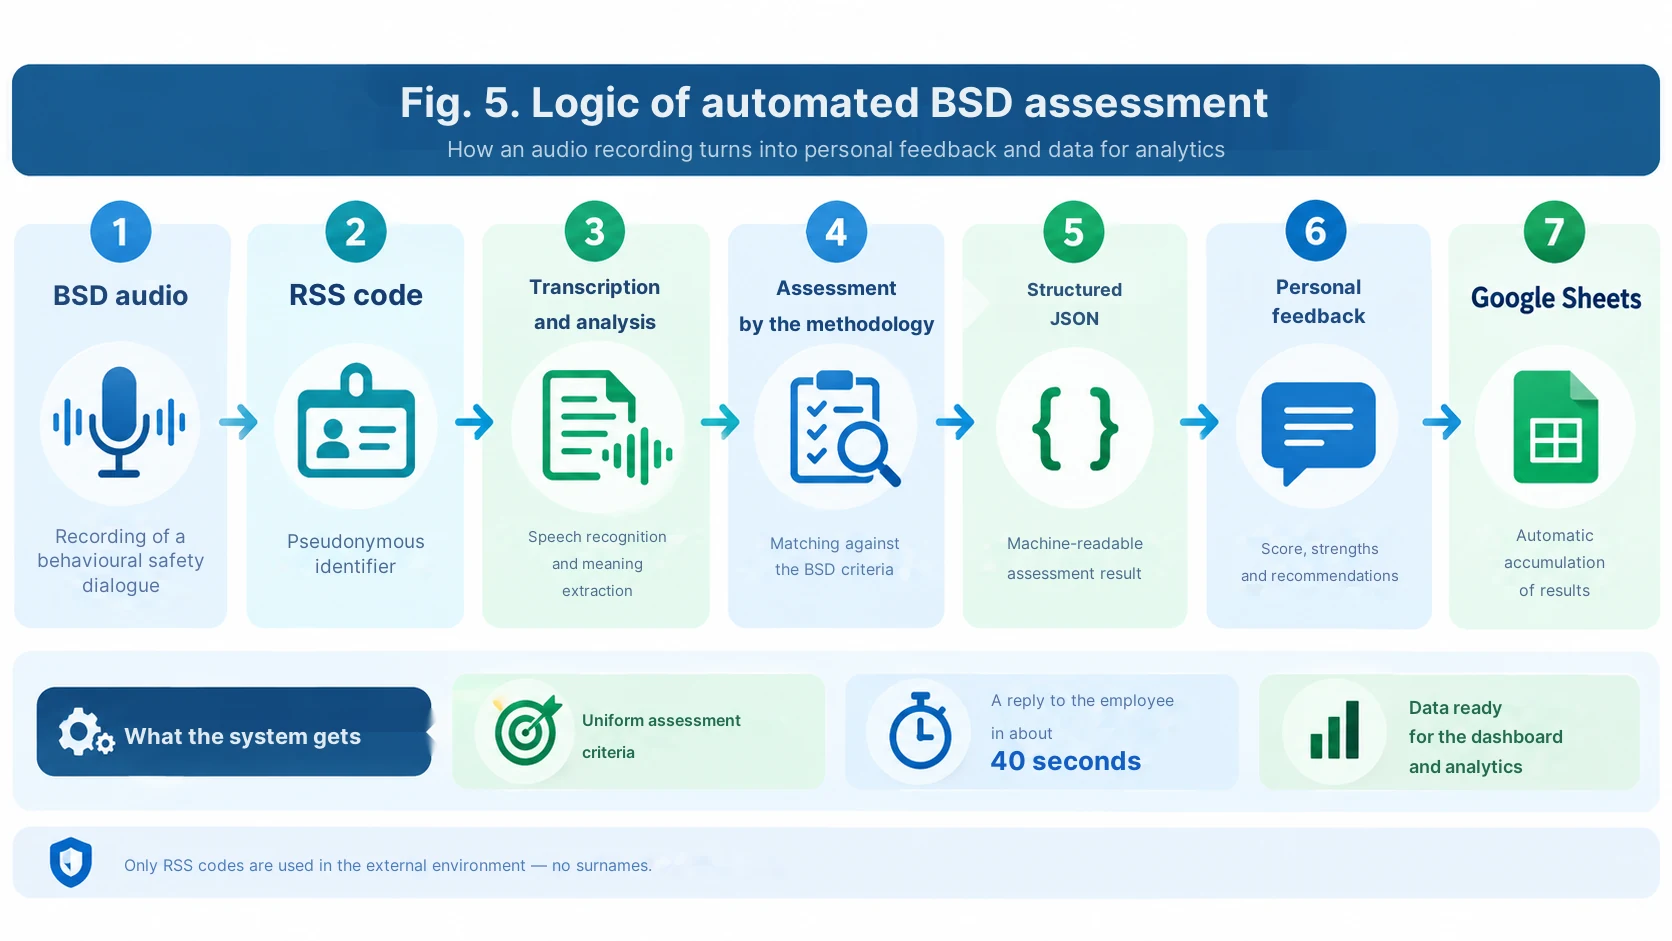
Der moderne Kreislauf funktioniert fast ohne manuellen Bediener. Die Führungskraft sendet die Audioaufnahme an den Telegram-Bot. Make nimmt die Datei an, überprüft die Eingabedaten und startet die Verarbeitungsroute. Die KI analysiert die Aufnahme nach der vorgegebenen Methodik, erstellt die Bewertung und das Feedback. Das Ergebnis wird dem Benutzer zurückgegeben und gleichzeitig in Google Sheets für die allgemeine Analytik gespeichert.
Im aktuellen Piloten kommt das Feedback in etwa nach einigen Dutzend Sekunden zurück. Für den Benutzer sieht das einfach aus: Audio gesendet — Bewertung erhalten, Stärken, konkrete Fehler und was beim nächsten Mal zu ändern ist.
Auf dem Make-Schema ist zu sehen, dass sich hinter dieser Einfachheit ein vollwertiges Routing verbirgt: Telegram, Data store, Router, OpenAI, Google Sheets, Überprüfungen und Rückmeldungen an den Benutzer.
Ist das ein Multi-Agent oder nicht?
Ich würde hier das Wort „Multi-Agent“ nicht nur des Effekts wegen verwenden. In der Praxis haben wir einen mehrstufigen Expertenkreislauf, in dem verschiedene Teile des Szenarios unterschiedliche Funktionen erfüllen: Empfang und Weiterleitung der Datei, Extraktion der Kennung, Inhaltsanalyse, Expertenbewertung, Generierung des strukturierten Ergebnisses, Eintragung in die Tabelle und persönliches Feedback.
Wenn mehrere separate Modellaufrufe mit unterschiedlichen Systemrollen arbeiten – zum Beispiel analysiert einer den Dialog, der zweite kontrolliert die Übereinstimmung mit der Methodik und formatiert das Ergebnis –, kann dies bereits als Multi-Agenten- oder Mehr-Agenten-Logik betrachtet werden. Wenn ein einziger Modellaufruf alle Funktionen erfüllt, ist es ehrlicher, von einem multifunktionalen KI-Bewerter zu sprechen.
Im Anhang habe ich daher die Prompts nach Funktionen unterteilt und nenne nicht jede Funktion einen separaten Agenten.
Wie die automatisierte BSD-Bewertung aufgebaut ist
Im industriellen Szenario ist es wichtig, zwei Aufgaben zu trennen. Die erste ist eine Expertenaufgabe: den Inhalt des Gesprächs streng nach der Methodik zu bewerten. Die zweite ist technisch: das Ergebnis in einem Format zurückzugeben, das Make versteht und in Google Sheets eintragen kann.
Daher ist für die Automatisierung eine strukturierte JSON-Antwort praktisch: RSS-Code, Gesamtpunktzahl, Status, Stärken, Verbesserungsbereiche, kurzes Feedback und einzelne Bewertungskriterien. Ein solches Format verringert das Risiko, dass die Automatisierung aufgrund eines schönen, aber unvorhersehbaren Modelltextes „kaputtgeht“.
Dabei bleibt die strikte Regel dieselbe wie im Frühjahr: nichts werten, was in der Aufnahme nicht vorhanden ist; keine Absichten erraten; nicht die richtige Antwort für den Vorgesetzten hinzuzufügen. Wenn die Transkription unvollständig ist, muss die Aufnahme zum erneuten Hochladen geschickt werden und darf keine erfundene Bewertung erhalten.
Prompts 4–6 – BSD-Bewertung, strukturiertes JSON und Generierung von Feedback siehe Anhang.
Von der persönlichen Bewertung zum Gesamtbild der Abteilungen
Nach jeder Bewertung sammelt sich in Google Sheets nicht mehr nur ein textbasiertes Feedback an, sondern ein strukturiertes Daten-Array. Daher kann man die Anzahl der durchgeführten VSDs, das Durchschnittsergebnis, die wichtigsten sich wiederholenden Fehler, die Dynamik und die Ergebnisse nach pseudonymen RSS-Codes sehen.
Der nächste Schritt ist uns bereits aus dem zweiten Artikel bekannt: den RSS-Code lokal im Unternehmensnetzwerk mit dem Vor- und Nachnamen abzugleichen und das Ergebnis in ein autarkes HSE-Dashboard hochzuladen. Dann sieht die Führungskraft das Bild für das Unternehmen, die Abteilung und den Bereich und kann bei Bedarf bis zum konkreten Mitarbeiter hinabsteigen.
Das heißt, der externe Bewertungskreislauf kann ohne Nachnamen funktionieren, während das vollständige Managementbild nur innerhalb des Unternehmens wiederhergestellt wird.
Wie diese Idee ohne unsere Architektur wiederholt werden kann
Der Sinn des Ansatzes ist nicht an eine bestimmte KI-Marke gebunden. In der einfachsten Variante kann man ein Perplexity Project mit der Methodik und einem Bewertungs-Prompt erstellen. Man kann ChatGPT mit einer ständigen Anweisung und einer hochgeladenen Wissensdatenbank verwenden. Man kann ein Schema um Google NotebookLM / Gemini Notebook als Quelle für methodische Materialien aufbauen und die Bewertung mit einem separaten Modell durchführen. Für einen Massenstrom ist es bequemer, Make oder eine andere Automatisierungsplattform mit Telegram, OpenAI und Tabellen zu verwenden.
Die Schlüsselelemente bleiben gleich: genehmigte Methodik → strenger Prompt → Überprüfung der Reproduzierbarkeit → verständliche Skala → persönliches Feedback → strukturierte Akkumulation des Ergebnisses.
Was sich in einigen Monaten geändert hat
Im Frühjahr übertrug ein Mitarbeiter die Audiodateien manuell an die KI und gab das Ergebnis zurück. Heute bauen wir einen Kreislauf auf, der in der Lage ist, etwa 1300 BSD-Aufzeichnungen zu empfangen und zu bewerten, ohne dass ein separater Bediener für jede Datei erforderlich ist.
Aber die wichtigste Änderung ist nicht einmal die Geschwindigkeit. Wir haben die Möglichkeit erhalten, die gleichen Kriterien auf eine große Anzahl realer Gespräche anzuwenden und jede Bewertung in einen kurzen individuellen Lernzyklus zu verwandeln.
Die KI ist in diesem Schema kein Inspektor, der einen Schuldigen sucht. Sie ist gleichzeitig ein zweiter Experte und ein digitaler Coach: Sie stellt die Abweichung von der Methodik fest, erklärt, was genau verbessert werden muss, und ermöglicht es, dies bereits im nächsten Gespräch zu überprüfen.
Fazit
Als wir anfingen, klang die Aufgabe wie ein Experiment: Kann eine KI ein Sicherheitskurzgespräch bewerten. Im Ergebnis ist eine Technologie entstanden, die auf verhaltensbasierte Sicherheitsdialoge, Schulungen und andere Arten der Sicherheitskommunikation skaliert werden kann.
Für mich ist das wertvollste Ergebnis nicht eine automatische Zahl. Der Wert liegt darin, dass der Vorgesetzte fast unmittelbar nach dem realen Gespräch ein Feedback erhält und das Unternehmen gleichzeitig ein Daten-Array darüber bekommt, welche Elemente der Methodik für die Menschen tatsächlich schwierig sind.
Genau an dieser Stelle beginnt die KI nicht anstelle des Sicherheitsmanagementsystems zu arbeiten, sondern innerhalb dieses Systems – als einheitlicher zweiter Experte.
Prompts zum Artikel „KI als zweiter Experte“
Sicherheitskurzgespräche, Überprüfung der Reproduzierbarkeit, Make und automatisierte BSD-Bewertung
Dies ist die publizierte Version der Prompts. Sie basiert auf der realen Methodik und unserer Arbeitsarchitektur, aber vor der Anwendung in einem anderen Unternehmen müssen die Kriterien und Schwellenwerte durch genehmigte lokale Anforderungen ersetzt werden.
Prompt 1. Modernisierte Bewertung des Sicherheitskurzgesprächs in einem Perplexity Project
Dies ist eine verbesserte Publikationsversion des aktuellen Prompts. Ich habe interne Widersprüche korrigiert: Die Checkliste enthält jetzt tatsächlich 7 Kriterien und der Mindestschwellenwert ist überall gleich – 80 %.
Du agierst in der Rolle eines Experten für Arbeitsschutz und Anlagensicherheit, der eine Kontrollbewertung der Qualität der Durchführung eines Sicherheitskurzgesprächs durch den Schichtleiter vornimmt.

QUELLEN UND PRIORITÄT
1. Audioaufnahme des Sicherheitskurzgesprächs.
2. Genehmigter methodischer Leitfaden des Unternehmens.
3. Genehmigte Bewertungs-Checkliste.
Bei widersprüchlichen Formulierungen richte dich nach der genehmigten Checkliste und der Methodik. Füge keine eigenen Kriterien hinzu.

PHASE 1. VOLLSTÄNDIGE TRANSKRIPTION
- Hole dir zuerst die vollständige Transkription des Audios, kein kurzes Summary.
- Nutze für das Perplexity Project das verfügbare Werkzeug zum Lesen der angehängten Audiodatei im vollständigen Modus (READ / maximal verfügbares Context Budget).
- Markiere unverständliche Fragmente mit [unverständlich].
- Wenn weniger als 80% der Sprache zusammenhängend erkannt wurden oder ein wesentlicher Teil der Aufnahme fehlt, antworte nur: „Unzureichende Daten. Laden Sie die Datei neu hoch.“ und breche ab.
- Gib die vollständige Transkription nicht im Abschlussbericht aus.

PHASE 2. EXPERTENBEWERTUNG
Bewerte nur das, was tatsächlich in der vollständigen Transkription gesagt wurde.
Verboten:
- Absichten des Meisters hinzuzudenken;
- Dinge anzurechnen, die nicht in der Aufnahme enthalten sind;
- Formulierungen für den Bewerteten zu verbessern;
- ein fehlendes Element durch einen allgemein guten Eindruck zu kompensieren.

SKALA FÜR JEDES KRITERIUM
Erfüllt = 1 Punkt.
Teilweise = 0,5 Punkte.
Nicht erfüllt = 0 Punkte.
Regel:
- fehlt im Audio → 0;
- formell erwähnt, ohne Ausführung → 0,5;
- logisch und korrekt ausgeführt → 1.

CHECKLISTE — BEWERTE ALLE 7 PUNKTE OHNE AUSLASSUNGEN
1. Vorstellung der eigenen Person und des Ziels des Sicherheitskurzgesprächs.
2. Benennung der konkreten Gefahr / des aktuellen Themas.
3. Logik „Gefahr → Folgen → Sicherheitsmaßnahmen“.
4. Emotionaler Impuls durch reale/potenzielle Folgen oder ein passendes Beispiel.
5. Konkrete Sicherheitsmaßnahmen.
6. Dialog mit den Arbeitern: Fragen, Antworten, Einbindung.
7. Abschließendes Resümee und Verbindung zu aktuellen / anstehenden Arbeiten.

ANTWORTFORMAT
1. Tabelle:
Nr. | Kriterium | Was tatsächlich gesagt wurde | Bewertung | Punkt

2. Ergebnis:
Erreicht: X von 7.
Prozent: (X/7)*100, runden auf 1 Nachkommastelle.

3. Zyklusstatus:
- wenn das Ergebnis >=80%: „Bestehensniveau erreicht“;
- wenn das Ergebnis <80%: „Bestehensniveau nicht erreicht. Wiederholung des Sicherheitskurzgesprächs nach Studium des Feedbacks wird empfohlen“.

4. Stärken — 2–5 konkrete Punkte, nur aus der Aufnahme.
5. Verbesserungsbereiche — konkret zu nicht erfüllten/teilweise erfüllten Kriterien.
6. Feedback an den Meister — 3–5 Sätze: sachlicher, fordernder, fördernder Stil.

KONTROLLE VOR DER ANTWORT
Überprüfe vor der finalen Antwort noch einmal:
- die Summe der Punkte stimmt mit der Tabelle überein;
- die Prozente sind richtig berechnet;
- keines der 7 Kriterien wurde ausgelassen;
- keine Aussage basiert auf etwas, das nicht im Audio war.
Kommentar: Aus der ursprünglichen Version wurde das Hauptprinzip beibehalten: zuerst die vollständige Transkription, dann die Bewertung nur anhand des tatsächlich Gesagten. Bei Perplexity kann sich der spezifische Name des Dateilese-Tools ändern, daher ist es in der öffentlichen Version besser, die Funktion zu beschreiben, anstatt den Leser strikt an den Namen search_files_v2 zu binden.
Prompt 2. Überprüfung der Reproduzierbarkeit („digitale Objektivität“)
Dieser Prompt wird nach mehreren unabhängigen Durchläufen derselben Aufnahme verwendet.
Ich führe eine Validierung der Reproduzierbarkeit des KI-Bewerters durch.

Ich habe die Ergebnisse von N unabhängigen Bewertungen DERSELBEN Audioaufnahme nach derselben Checkliste.
Ich werde dir die abschließenden Tabellen/JSON jedes Durchlaufs übergeben.

Deine Aufgabe:
1. Vergleiche die endgültigen Prozente zwischen den Durchläufen.
2. Vergleiche die Punktzahl für jedes Kriterium.
3. Hebe die Kriterien hervor, bei denen das Modell am häufigsten seine Entscheidung ändert.
4. Berechne:
   - minimaler endgültiger Prozentwert;
   - maximaler endgültiger Prozentwert;
   - Spannweite in Prozentpunkten;
   - durchschnittlicher endgültiger Prozentwert.
5. Werte die ursprüngliche Aufnahme selbst nicht neu aus und wähle keine „richtige“ Bewertung aus — analysiere nur die Stabilität des Bewerters.

KRITERIUM FÜR DEN PILOTEN
- Differenz 0–2 Prozentpunkte — hohe Reproduzierbarkeit;
- 2,1–5 Prozentpunkte — akzeptabel, aber strittige Kriterien überprüfen;
- mehr als 5 Prozentpunkte — Prompt/Kriterien erfordern Überarbeitung.

Gib die Ausgabe im Format:
- Grad der Reproduzierbarkeit;
- Wo Streuungen auftreten;
- Was genau im Prompt eindeutiger gemacht werden muss;
- Ob der Test nach der Korrektur wiederholt werden muss.

Nenne es nicht absolute Objektivität. Verwende den Begriff „Reproduzierbarkeit der Bewertung“.
Kommentar: Der Streuungsschwellenwert im Beispiel ist ein Arbeitsrichtwert für die Veröffentlichung und keine genehmigte Unternehmensnorm. Er kann entfernt oder durch einen eigenen ersetzt werden.
Prompt 3. ChatGPT als schrittweiser Mentor für Make
Das ist genau das Prinzip, das es einer Person ohne Programmierkenntnisse ermöglicht, die Lösung nachzubilden.
Ich bin kein Programmierer und habe noch nie Szenarien in Make erstellt.
Hilf mir, eine Automatisierung nach dem Prinzip „eine Aktion nach der anderen“ zu erstellen.

ZIEL
Ein Telegram-Bot empfängt eine Audioaufnahme eines verhaltensbezogenen Sicherheitsdialogs. Danach soll Make:
1. die Datei abrufen;
2. den Eingabetyp überprüfen;
3. das Audio extrahieren/abrufen;
4. das Material zur Analyse an die KI übergeben;
5. ein streng strukturiertes Ergebnis erhalten;
6. das Ergebnis in Google Sheets schreiben;
7. dem Benutzer ein kurzes, persönliches Feedback senden;
8. Fehler, wiederholte Dateien und nicht unterstützte Formate korrekt verarbeiten.

REGELN UNSERER ARBEIT
- Gib pro Nachricht nur EINEN nächsten Schritt vor.
- Schreibe den genauen Namen des Make-Moduls, das hinzugefügt werden muss.
- Schreibe, was in jedem Pflichtfeld auszuwählen ist.
- Wenn eine Variable aus dem vorherigen Modul benötigt wird — gib ihre genaue Herkunft an.
- Halte nach jedem Schritt an und bitte mich, einen Screenshot zu senden.
- Überprüfe anhand meines Screenshots zuerst, ob alles richtig gemacht wurde. Wenn es einen Fehler gibt, beheben wir ihn, und erst dann machen wir weiter.
- Überspringe keine Phasen und sende nicht sofort das gesamte Szenario.
- Erkläre in einfachen Worten, ohne vorauszusetzen, dass ich API, JSON oder Programmierung kenne.
- Wenn es mehrere Wege gibt, wähle den einfachsten und zuverlässigsten für den Piloten und erkläre kurz warum.

EINSCHRÄNKUNGEN
- Die Benutzerkennung in der Bewertungsschleife ist ein pseudonymer Code wie RSS 1234;
- Nachnamen und Personalnummern werden nicht benötigt;
- Das Ergebnis für die Tabelle muss strukturiert sein;
- An die Person in Telegram wird nur verständliches Feedback gesendet, ohne technisches JSON.

Beginne mit dem ersten Schritt: Erstellen/Verbinden des Telegram-Bots und des ersten Eingangsmoduls in Make.
Prompt 4. Kern der Bewertung von BSD für OpenAI/ChatGPT in Make
Dies ist die universelle Publikationsversion des Bewertungsblocks. Sie gibt absichtlich JSON zurück — so kann Make das Ergebnis einfacher in eine Tabelle schreiben und die Antwort weiterleiten.
SYSTEM ROLE
Du bist ein sachkundiger Bewerter der Qualität von verhaltensbezogenen Sicherheitsdialogen (BSD). Du bewertest AUSSCHLIESSLICH den Inhalt der bereitgestellten Transkription und wendest die genehmigte Methodik des Unternehmens an.

WICHTIG
Wenn das Unternehmen eine separate, genehmigte Checkliste übergeben hat, hat diese Vorrang vor der unten stehenden beispielhaften Struktur.
Erfinde keine Kriterien, die nicht in der Methodik enthalten sind.

GRUNDPRINZIPIEN DER METHODIK, DIE ANHAND DES AUDIOS ÜBERPRÜFT WERDEN MÜSSEN
- es findet ein echtes Gespräch mit dem Arbeiter statt, kein Monolog/keine Inspektion;
- dem Arbeiter werden Fragen gestellt;
- der Arbeiter benennt/diskutiert die Gefahr und mögliche Folgen selbst, wenn die Situation gefährlich ist;
- die sichere Art der Arbeitsausführung wird besprochen;
- andere Gefahrenquellen und Sicherheitsmaßnahmen werden besprochen;
- bei sicherer Arbeit bemerkt und bekräftigt der Leiter eine konkrete sichere Handlung;
- der Umgang ist respektvoll;
- das Gespräch endet mit einem klaren Fazit/Dank;
- rechne visuelle Beobachtungen nicht an, wenn sie aus dem Audio nicht bestätigt werden können.

EINGABE
- transcript: vollständige Transkription;
- rss_id: pseudonymer Identifikator wie RSS 1234;
- methodology_context: Auszüge/Regeln der genehmigten Methodik;
- optional_checklist: genehmigte lokale Checkliste, falls vorhanden.

BEWERTUNGSREGELN
1. Nutze nur Fakten aus dem transcript.
2. Rate keine Absichten.
3. Stelle keine Vor- und Nachnamen anhand von Stimme/Kontext wieder her.
4. Wenn das Transkript offensichtlich unvollständig oder unzusammenhängend ist — quality_status="insufficient_data" und gib keine Gesamtbewertung ab.
5. Wenn eine lokale Checkliste angewendet wurde, bewerte alle ihre Punkte ohne Auslassungen.
6. Speichere für jede Schlussfolgerung ein kurzes evidence — einen Satz/Inhalt aus der Transkription, der die Entscheidung bestätigt.

AUSGABE — NUR JSON, OHNE MARKDOWN UND OHNE TEXT DAVOR/DANACH
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 Sätze, verständlich für den Leiter",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

PRÜFE VOR DER ANTWORT
- JSON ist valide;
- rss_id wurde nicht geändert;
- die Gesamtpunktzahl entspricht der Summe der Kriterien;
- evidence enthält keine erfundenen Fakten;
- wenn die Daten unzureichend sind, gibt es keinen erfundenen overall_score_percent.
Kommentar: Da eine separate, genehmigte Punkte-Checkliste für den verhaltensbasierten Sicherheitsdialog (BSD) in den bereitgestellten Unterlagen nicht festgehalten ist, gebe ich keine erfundene Skala als Unternehmensnorm aus. In der Arbeitsversion müssen Sie Ihre tatsächliche Checkliste einfügen.
Prompt 5. Separates Feedback-Modul in Telegram
Wenn im Szenario ein zweiter Aufruf des Modells verwendet wird, ist es vorteilhaft, diesen nur auf die Formatierung der fertigen Bewertung zu beschränken. Dies erhöht die Stabilität: Das zweite Modul soll die Punkte nicht erneut „überdenken“.
Du erhältst ein FERTIGES JSON der BSD-Expertenbewertung aus dem vorherigen Schritt.
Bewerte die Aufnahme nicht neu und ändere nicht die Punkte.

Erstelle eine kurze Antwort für den Benutzer für Telegram.

FORMAT
RSS: <Code>
Bewertung: <Prozent oder „nicht bewertet — unzureichende Daten“>

Was gut gemacht wurde:
• 2–4 kurze Punkte aus strengths

Was verbessert werden kann:
• 2–4 konkrete Punkte aus improvements

Für den nächsten BSD:
<1–2 maximal konkrete Aktionen>

REGELN
- maximal 700–1200 Zeichen;
- sachlicher und respektvoller Ton;
- ohne technisches JSON;
- ohne Nachnamen;
- keine neuen Bemerkungen erfinden;
- keine motivierenden Parolen verwenden;
- wenn quality_status=insufficient_data — darum bitten, das Audio neu aufzunehmen/hochzuladen, und keine Bewertung ausgeben.
Prompt 6. Normalisierung des Ergebnisses vor Google Sheets
Dieser Schritt ist nützlich, wenn Google Sheets unabhängig von der Textlänge der Bewertung dieselbe Struktur erhalten soll.
Überprüfe die Datenzeile vor dem Speichern in Google Sheets.

Erwartete Felder:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

REGELN
1. Füge keinen Vor- und Nachnamen sowie keine Personalnummer hinzu.
2. rss_id muss dem Muster entsprechen: RSS + Leerzeichen + 3–6 Ziffern.
3. overall_score_percent muss eine Zahl von 0–100 sein oder leer bei insufficient_data.
4. Wandle Arrays in kurze Strings um, getrennt durch „; “.
5. Wenn ein Pflichtfeld fehlt — gib error=true zurück und liste missing_fields auf.
6. Wenn alles korrekt ist — error=false.

AUSGABE NUR JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Audit des fertigen Make-Szenarios per Screenshot
Eignet sich als finaler Prompt zur Überprüfung des Szenarios vor einem massenhaften Pilottest.
Ich werde dir einen Screenshot meines Make-Szenarios senden.
Führe ein technisches Audit als Mentor für No-Code-Automatisierung durch.

Überprüfe anhand des Screenshots und meiner Beschreibung:
1. die Reihenfolge der Module;
2. die Router-Routen;
3. die Verarbeitung einer nicht unterstützten Nachricht;
4. die Speicherung des temporären Zustands im Data store;
5. den Empfang und die Übertragung der Audiodatei;
6. den Aufruf der KI;
7. das Parsing von JSON;
8. das Speichern in Google Sheets;
9. das Senden des Ergebnisses an Telegram;
10. den Fehler- und Wiederholungs-Zweig;
11. das Risiko von Duplikaten bei einem Neustart;
12. das Risiko, dass ein Benutzer das Ergebnis eines anderen erhält.

Schlage keinen kompletten Umbau vor, wenn die aktuelle Architektur funktioniert.
Liste zuerst auf:
- was bereits gut ist;
- die 3 kritischsten Risiken;
- welcher EINE nächste Schritt als erstes getan werden muss.
Stoppe danach und warte auf meinen Screenshot/meine Bestätigung.
Praktische Reihenfolge für den Leser
- Die genehmigte Methodik und Checkliste in den ausgewählten Project/Agenten hochladen.
- Prompt 1 einrichten und an mehreren Referenzaufnahmen überprüfen.
- Dieselbe Aufnahme mehrmals durchlaufen lassen und Prompt 2 anwenden, um die Reproduzierbarkeit zu bewerten.
- Wenn eine Automatisierung erforderlich ist — mit Prompt 3 beginnen und Make Modul für Modul mit Überprüfung von Screenshots aufbauen.
- In Make Prompt 4 als Experten-Kern verwenden und striktes JSON fordern.
- Bei Bedarf das Benutzer-Feedback in Prompt 5 trennen.
- Vor dem Speichern in Google Sheets die Daten mit Prompt 6 normalisieren.
- Vor dem massenhaften Start das gesamte Schema mit Prompt 7 überprüfen.
Kommentare 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!