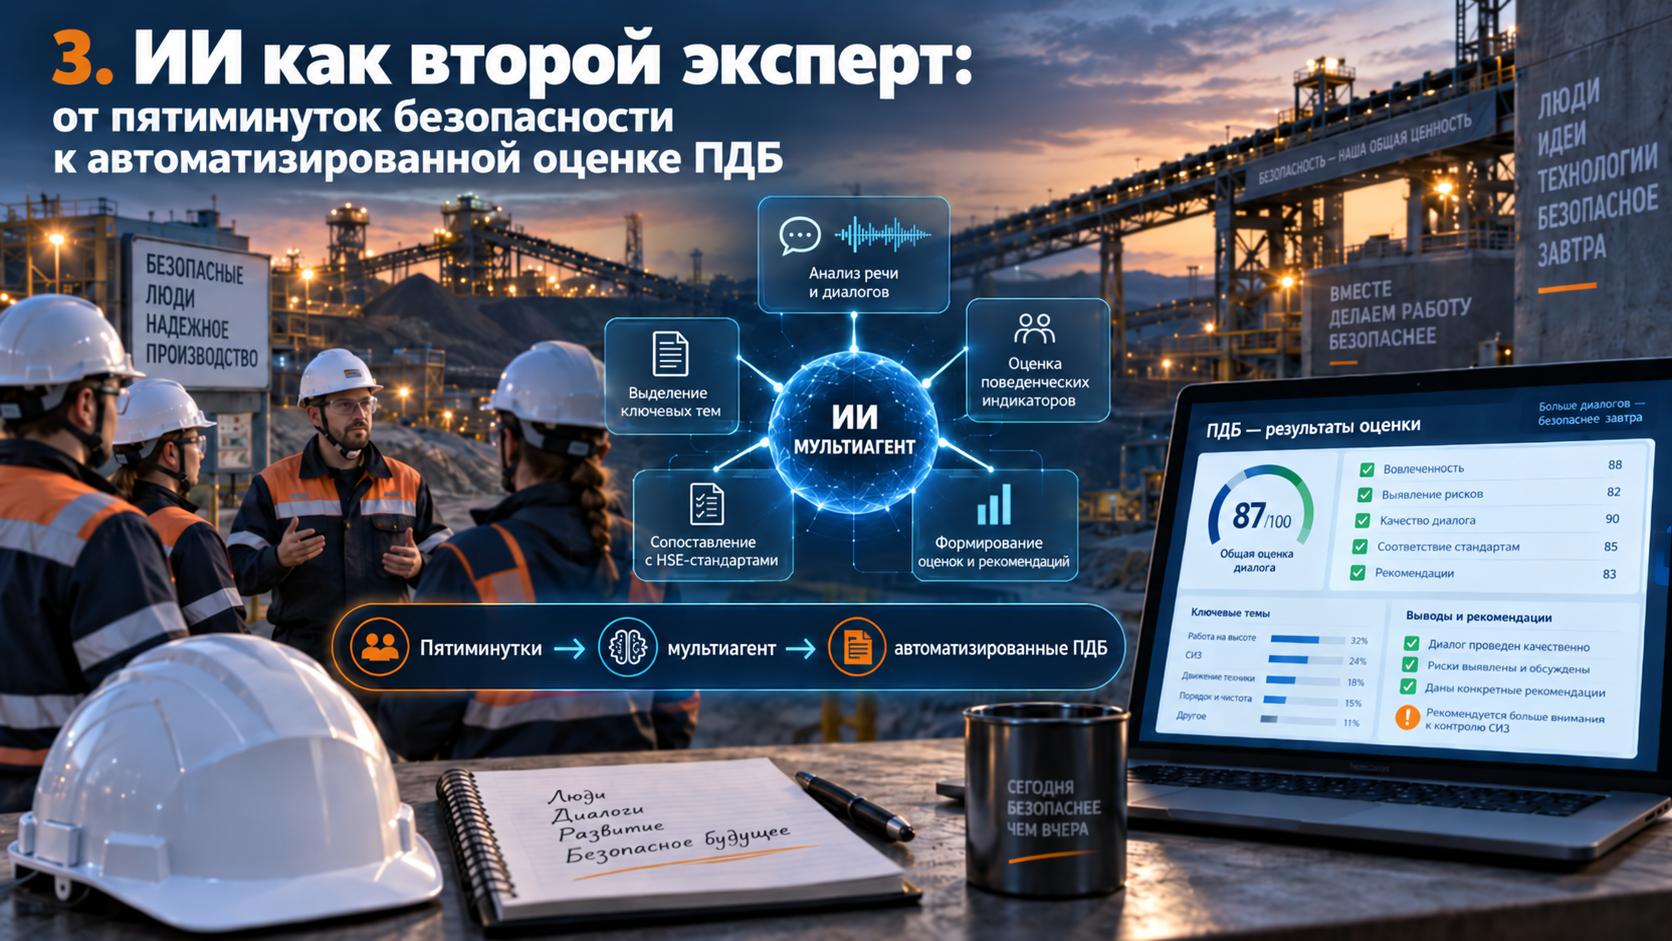
AI sebagai pakar kedua: dari safety talk hingga penilaian otomatis BSD
Safety talk → penilaian digital → Make → behavioural safety dialogue otomatis
Ide utama: AI tidak menggantikan manajer atau spesialis keselamatan. Ia menjadi "ahli kedua" tunggal yang menerapkan kriteria yang sama, memberikan feedback secara personal, dan memungkinkan penskalaan kontrol kualitas pada ratusan dan ribuan percakapan nyata.
Mengapa kami mulai menilai percakapan, dan bukan sekadar fakta pelaksanaannya
Dalam occupational health and industrial safety, mudah untuk menghitung fakta: safety talk telah dilaksanakan, behavioural safety dialogue telah didaftarkan, kartu telah diisi. Jauh lebih sulit untuk menjawab pertanyaan tentang seberapa baik supervisor melakukan percakapan itu sendiri dan apakah ia mencapai tujuannya.
Safety talk dalam metodologi kami adalah bagian wajib dari rapat pergantian sif yang berdurasi 5–10 menit. Supervisor harus membahas satu topik aktual tertentu dan membangun hubungan yang jelas: hazard → consequences → safety measures. Pada saat yang sama, tidak hanya monolog foreman yang penting, tetapi juga dialog dengan para worker: pertanyaan, jawaban, dan keterlibatan dalam diskusi.
Oleh karena itu, tugas awalnya bukan "memeriksa keberadaan rekaman", melainkan sebaliknya: bisakah AI diajarkan untuk menilai kualitas nyata dari percakapan semacam itu secara seragam dan memberikan feedback yang substansial kepada supervisor?
Tahap 1. Pertama metodologi, lalu kecerdasan buatan
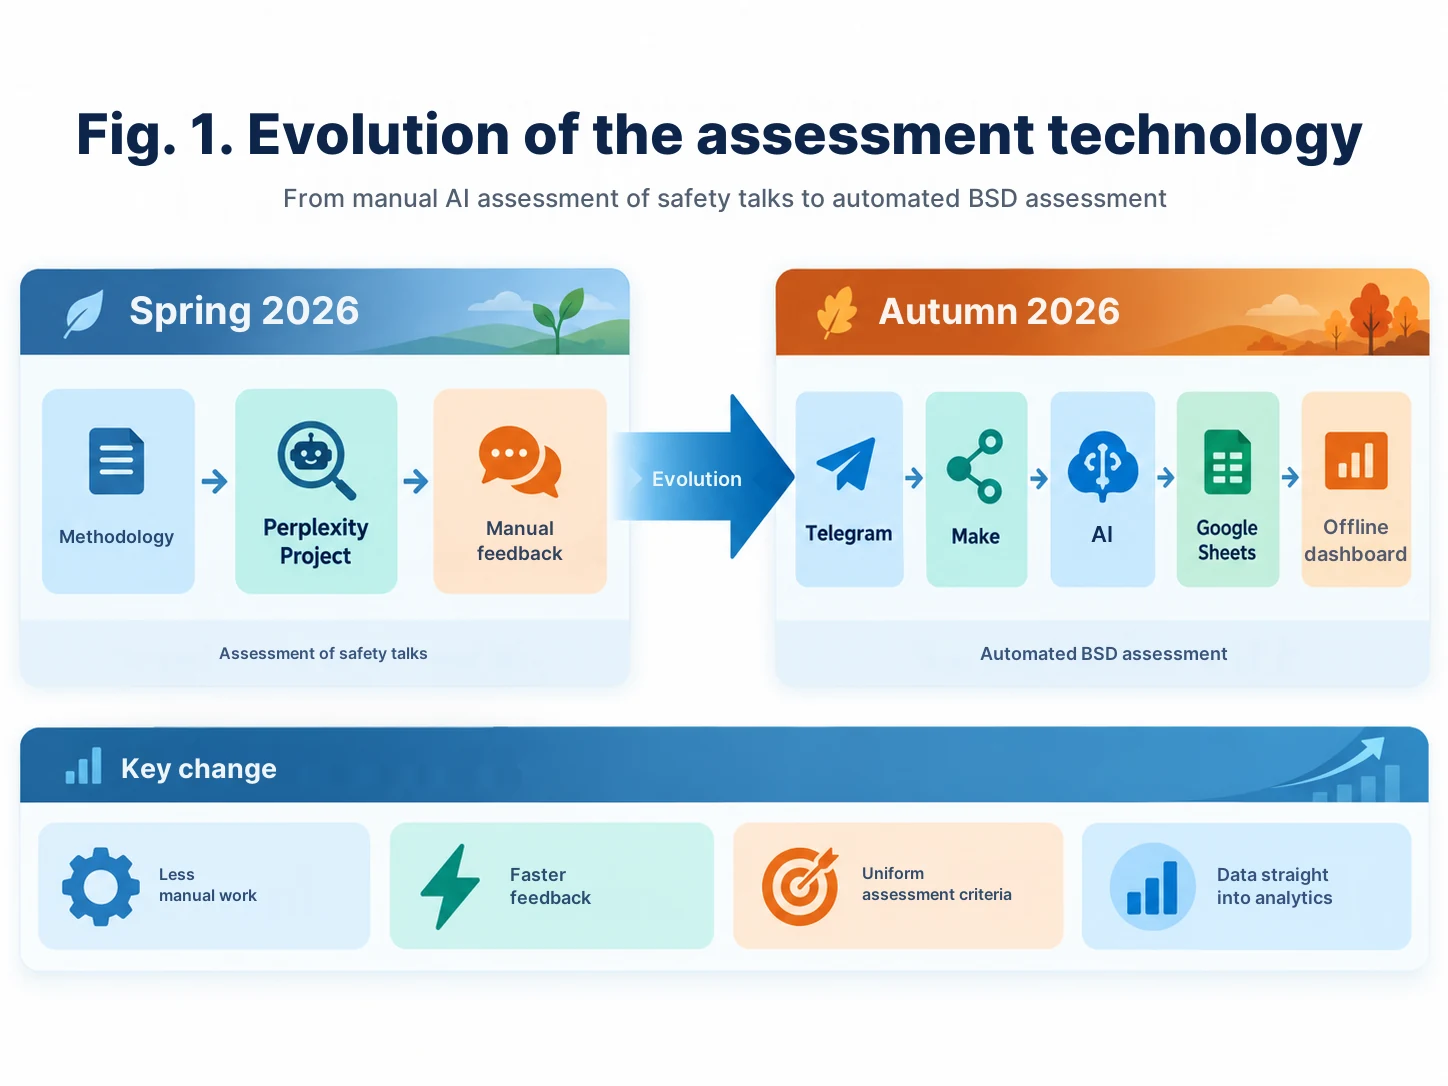
Pada musim semi tahun 2026, kami memulai dengan safety talk. Sebelum peluncuran penilaian AI, pedoman metodologis dan video pelatihan tentang cara melakukan safety talk dengan benar telah dipersiapkan. Hanya setelah itulah penilai digital muncul.
Sebagai lingkungan kerja pertama, kami menggunakan Perplexity Space — saat ini lingkungan serupa di Perplexity disebut Project. Kami mengunggah panduan metodologis dan daftar periksa penilaian ke dalam Project, dan untuk model tersebut kami secara terpisah menyiapkan Prompt yang ketat.
Tugas Prompt pada prinsipnya berbeda dari permintaan biasa "nilai presentasi ini". AI hanya diizinkan untuk menghitung apa yang benar-benar diucapkan dalam audio. Jika ada elemen yang hilang — 0 poin. Jika disebutkan secara formal — penyelesaian parsial. Jika dijelaskan secara logis dan lengkap — selesai.
Terdapat tujuh kriteria dalam daftar periksa saat ini: perkenalan dan tujuan; bahaya spesifik; logika "hazard – consequences – safety measures"; dorongan emosional; langkah-langkah keselamatan; dialog dengan worker; ringkasan akhir dan hubungan dengan pekerjaan yang sedang dilakukan.
Prompt 1 — versi Prompt yang dimodernisasi untuk Perplexity Project lihat di lampiran.
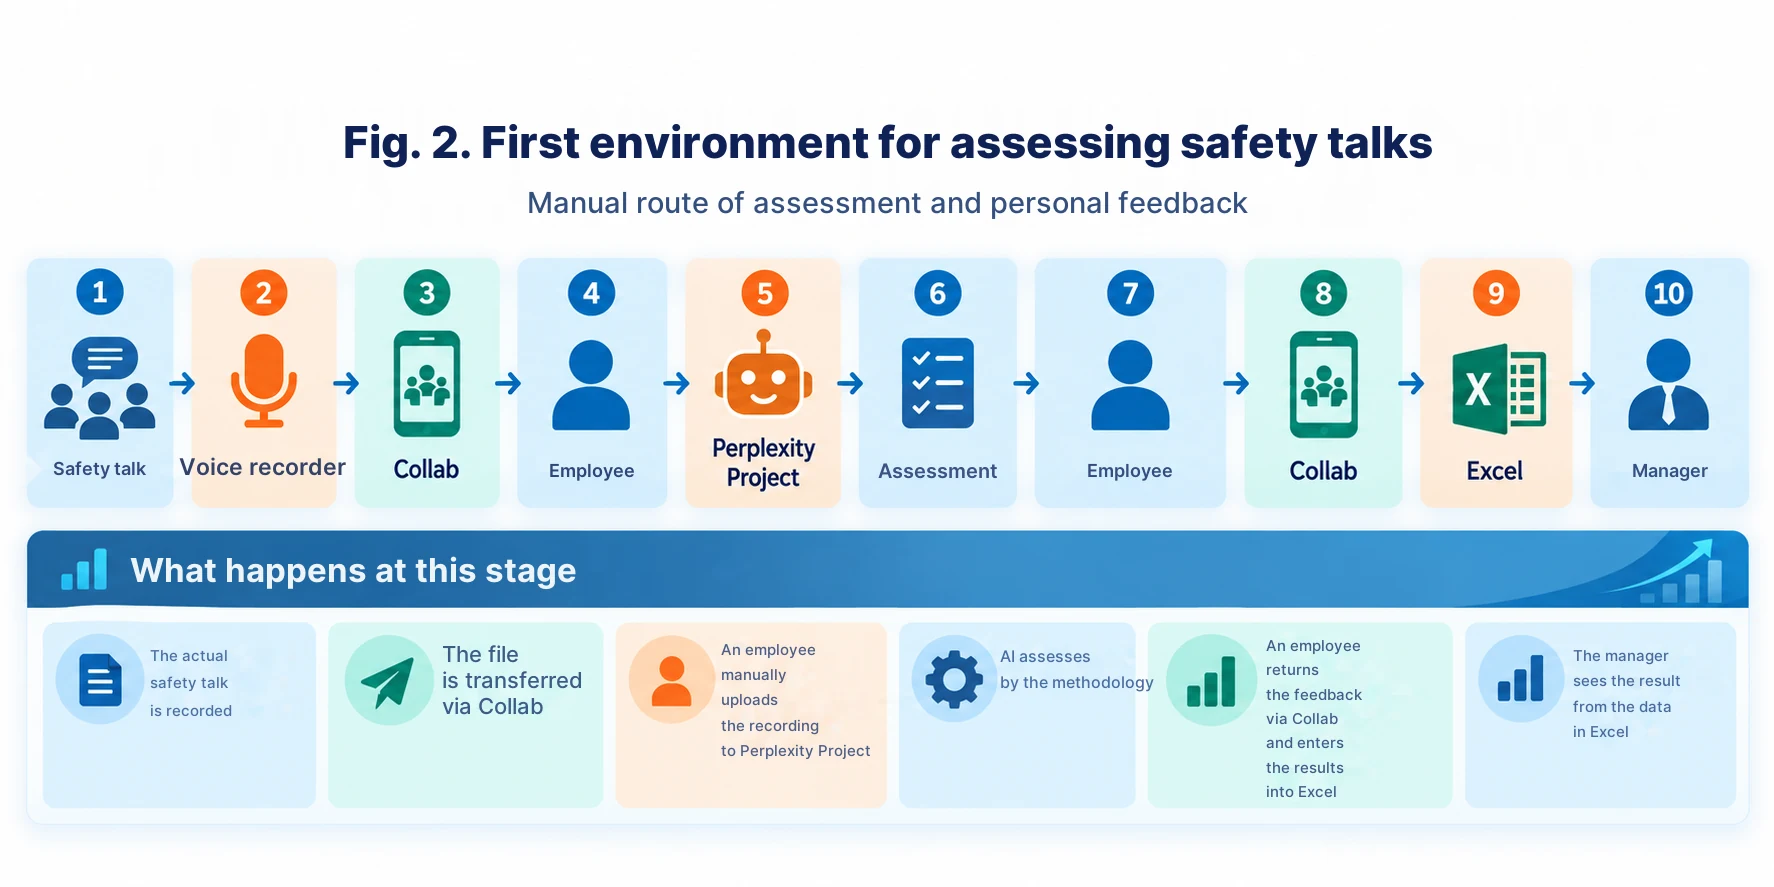
Seperti apa tampilan lingkungan pertama yang masih manual
Shift supervisor merekam safety talk yang diadakan menggunakan perekam suara. Melalui aplikasi perusahaan Collab, rekaman tersebut dikirimkan ke karyawan yang ditunjuk. Karyawan tersebut mengunggah audio ke Perplexity Project, menerima penilaian, dan mengembalikan feedback secara personal kepada shift supervisor juga melalui Collab.
Pada saat yang sama, hasilnya dimasukkan ke dalam Excel: departemen, supervisor, penilaian, jumlah percobaan. Dari tabel tersebut, kami membangun analitik sederhana — hasil rata-rata departemen, dinamika, dan jumlah siklus yang diulang.
Kami menetapkan tingkat kelulusan untuk siklus praktis sebesar 80 %. Jika hasilnya lebih rendah, supervisor akan mengadakan safety talk berikutnya dengan mempertimbangkan catatan AI. Ini tidak hanya menghasilkan kontrol, tetapi juga pelatihan individu secara langsung di tempat kerja.
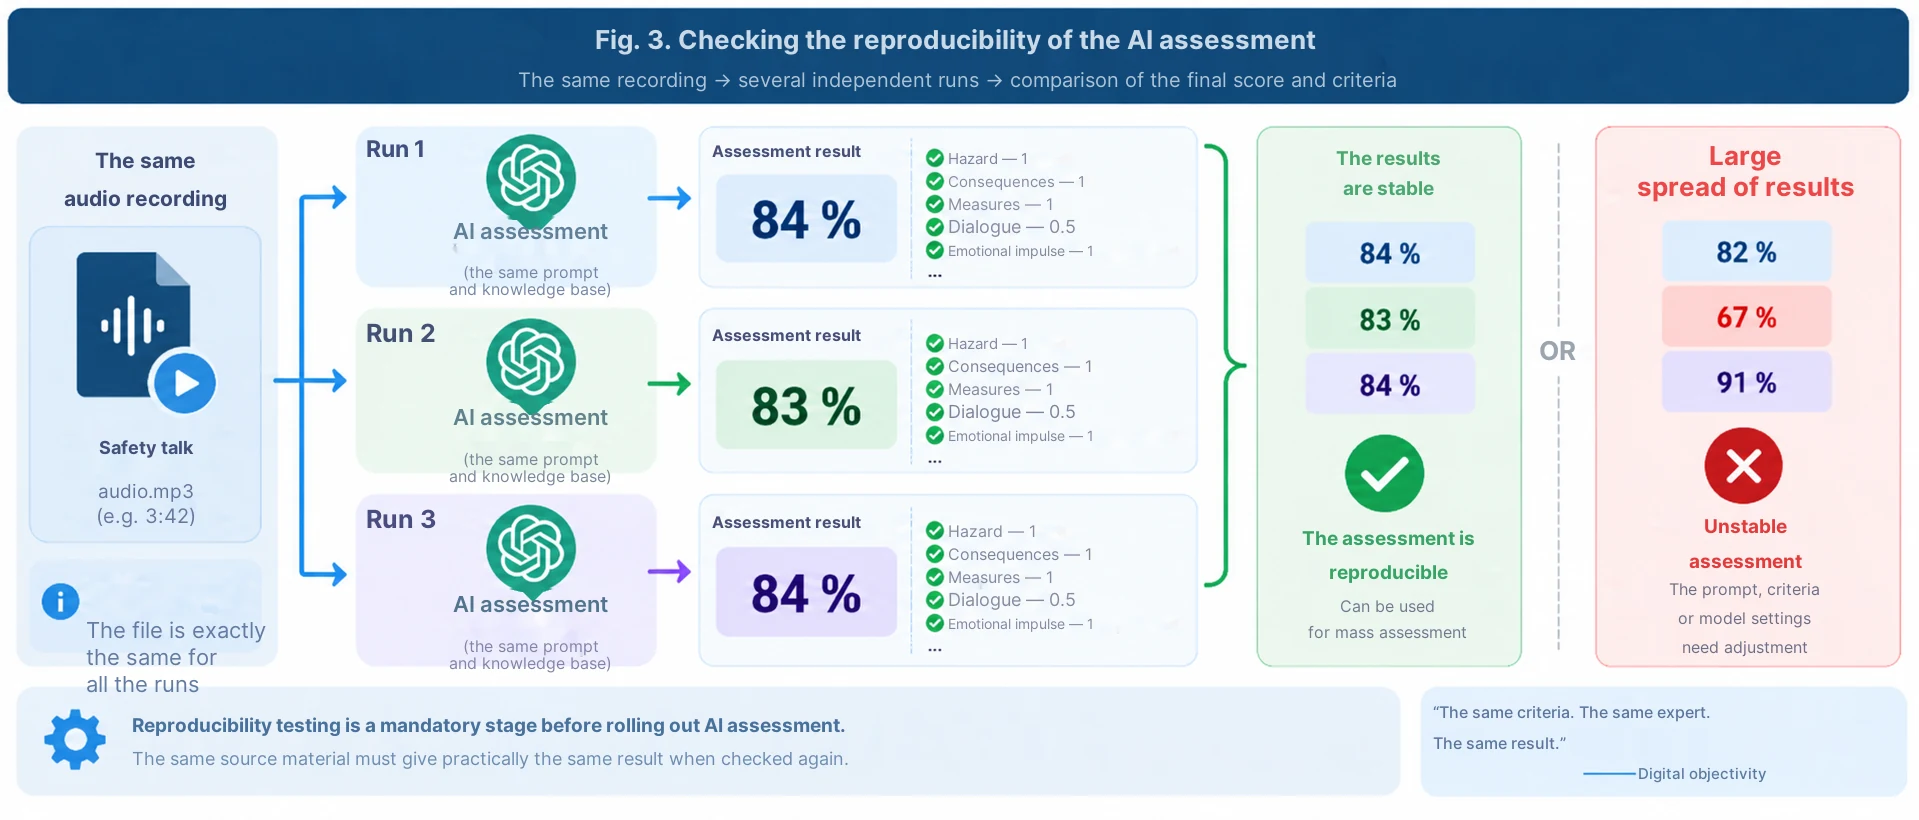
Bukan hanya manusia yang diperiksa — pertama-tama AI itu sendiri yang diperiksa
Bagi saya, ini adalah salah satu elemen terpenting dari keseluruhan skema. Kami sengaja mengirimkan rekaman audio yang sama untuk penilaian beberapa kali. Jika materi yang sama hari ini mendapat 82 %, semenit kemudian 65 %, dan kemudian 91 %, pakar digital semacam itu belum siap untuk menilai manusia.
Oleh karena itu, kami berjuang untuk reproducibility: rekaman yang sama harus memberikan penilaian yang sama atau hampir sama. Jika variasinya menjadi terlihat, kami mengoreksi Prompt, mengklarifikasi kriteria, dan menghilangkan frasa yang ambigu.
Bagi saya sendiri, saya menyebutnya "objektivitas digital". Ini tidak berarti bahwa AI memiliki kebenaran mutlak. Intinya adalah hal lain: satu pakar tunggal menerapkan skala yang sama kepada semua orang dan tidak bergantung pada suasana hati, simpati pribadi, atau siapa sebenarnya yang melakukan pemeriksaan hari ini.
Prompt 2 — protokol pemeriksaan reproducibility penilaian lihat di lampiran.
Mengapa skema manual tidak lagi memadai
Untuk uji coba, rute manual dirasa nyaman: menerima file, mengunggahnya, menunggu hasil, mengembalikan feedback, dan memasukkan skor ke dalam Excel. Namun, pendekatan ini memiliki batas alami.
Ketika volumenya sudah diukur dalam ratusan dan ribuan rekaman, kami tidak mulai mengotomatiskan penilaian, melainkan menciptakan pekerjaan administratif baru di sekitar penilaian. Oleh karena itu, selama transisi ke behavioural safety dialogue, tugasnya dirumuskan secara berbeda: menghapus manusia dari rantai teknis di mana keterlibatannya tidak menciptakan nilai.
Tahap 2. Behavioural safety dialogue lebih kompleks daripada safety talk biasa
Behavioural safety dialogue bukanlah sekadar presentasi singkat. Metodologinya mencakup mengamati pekerjaan yang sebenarnya dan berbicara dengan seseorang. Penting bagi supervisor untuk melihat perilaku yang aman atau berbahaya, dan kemudian melalui pertanyaan, memastikan bahwa worker itu sendiri menyebutkan hazard, consequences yang mungkin terjadi, dan cara yang aman untuk melakukan pekerjaan tersebut.
Jika worker bekerja secara berbahaya, bagian kunci dari percakapan adalah membahas hazard dan consequences, kemudian cara kerja yang aman dan sumber bahaya lainnya. Jika orang tersebut bekerja dengan aman, supervisor harus memperhatikan dan memperkuat perilaku yang benar, lalu menggunakan percakapan tersebut untuk membahas masalah keselamatan lainnya.
Itulah sebabnya mengapa lingkungan penilaian PDB harus memeriksa tidak hanya kata-kata supervisor, tetapi juga keberadaan dialog yang nyata: apakah pertanyaan diajukan, apakah worker menjawab, apakah alasan perilaku, consequences, tindakan aman, dan penyelesaian percakapan dibahas.
Pengidentifikasi pseudonim sebagai ganti nama belakang
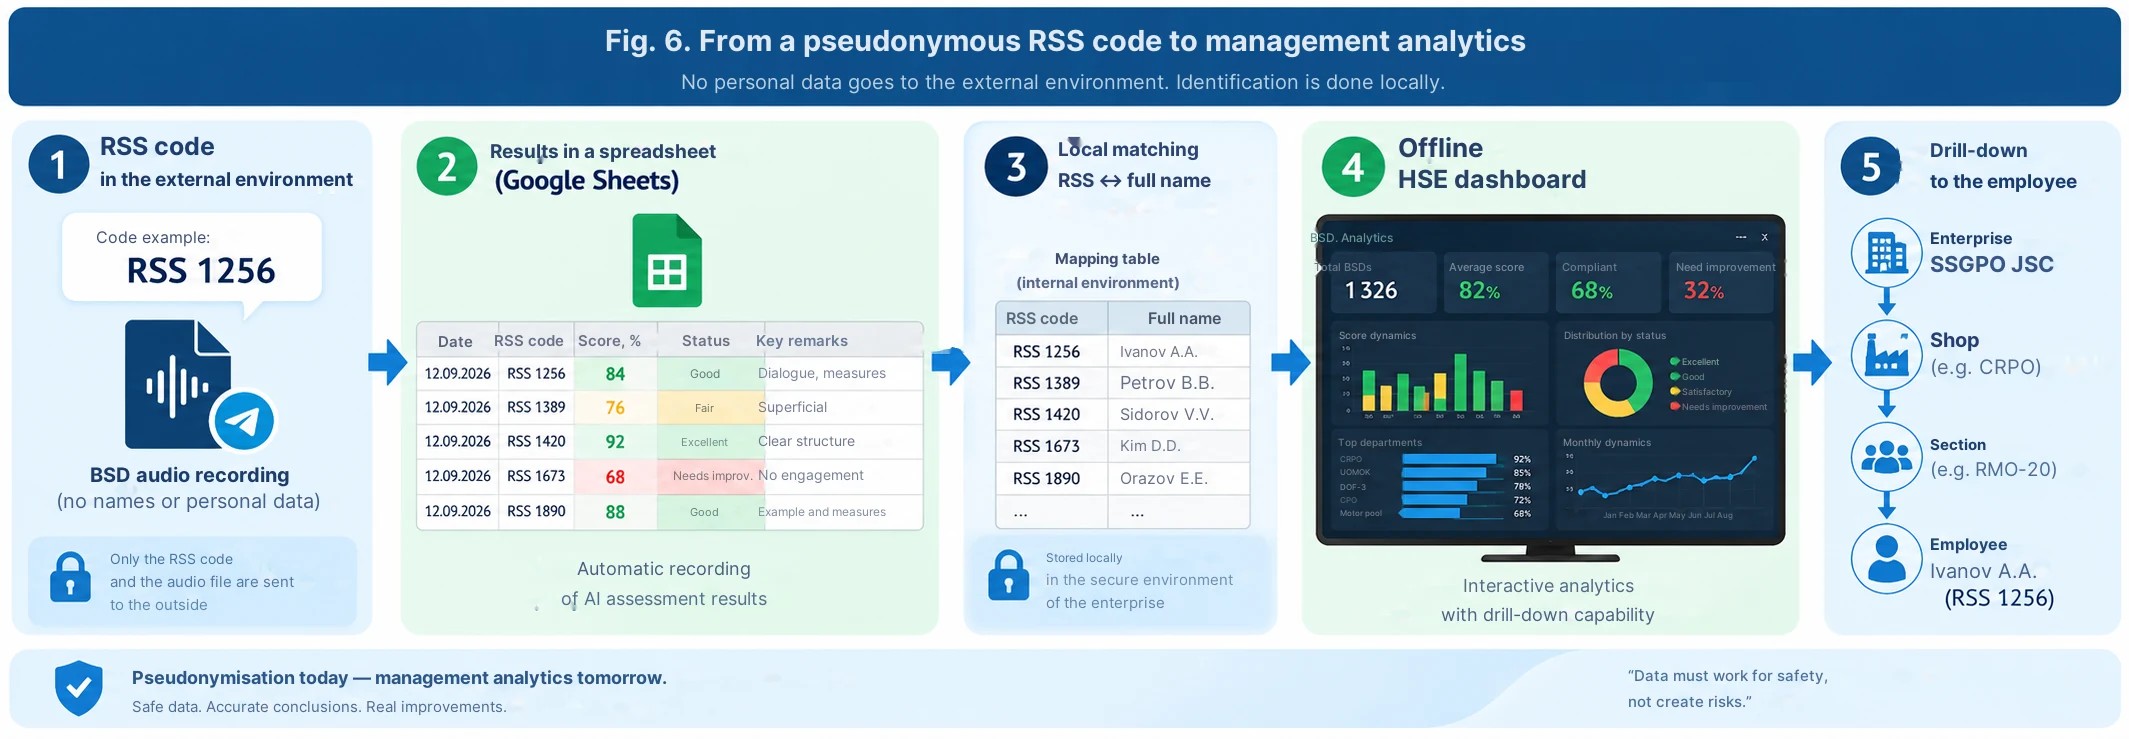
Dengan otomatisasi massal, kami menyelesaikan masalah identifikasi secara terpisah. Di dalam lingkungan perusahaan ERGIS, setiap peserta diberikan kode khusus seperti RSS 1256. Ini bukan nomor pegawai atau nama belakang.
Sebelum memulai perekaman, supervisor mengucapkan kode RSS mereka, lalu melakukan PDB. Dalam percakapan, tidak perlu menyebutkan nama belakang atau nomor pegawai. Pemetaan "kode RSS ↔ karyawan tertentu" tetap berada di dalam lingkungan perusahaan dan digunakan kemudian untuk analitik lokal.
Di sini, lebih tepat untuk berbicara bukan tentang anonymisation penuh, melainkan tentang pseudonymisation: suara manusia masih tetap ada di file audio. Namun, volume data pribadi yang melewati lingkungan otomatis berkurang secara signifikan.
Sebuah rahasia kecil: saya bukan seorang programmer
Kami membangun arsitektur solusi baru tersebut melalui Make. Saya bukan seorang programmer dan pada awal pekerjaan saya secara langsung menulis tentang ini kepada ChatGPT.
Permintaannya sederhana: "Pandu saya melalui pembuatan otomatisasi ini selangkah demi selangkah. Berikan satu tindakan pada satu waktu. Saya akan mengeksekusinya di Make dan mengirimkan tangkapan layar. Setelah diperiksa, berikan perintah berikutnya."
Kemudian, hal itulah yang persis terjadi. ChatGPT menjelaskan modul apa yang harus dibuat dan apa yang harus diisi di dalamnya; saya melakukan tindakan tersebut dan mengirimkan tangkapan layar; setelah verifikasi, saya mendapatkan langkah berikutnya. Dengan cara yang sama, bot Telegram dibuat dan seluruh rantainya dihubungkan.
Ini adalah kesimpulan penting bagi saya dari praktik vibe-coding: seorang spesialis tidak harus mengetahui sintaks API atau Make sebelumnya. Akan tetapi, ia harus memiliki pemahaman yang baik tentang proses produksi, hasil yang harus didapatkan pengguna, dan mampu memverifikasi setiap tahapan secara berurutan.
Prompt 3 — Prompt awal "pandu saya selangkah demi selangkah melalui Make" lihat di lampiran.
Apa yang terjadi sekarang: Telegram → Make → AI → hasil
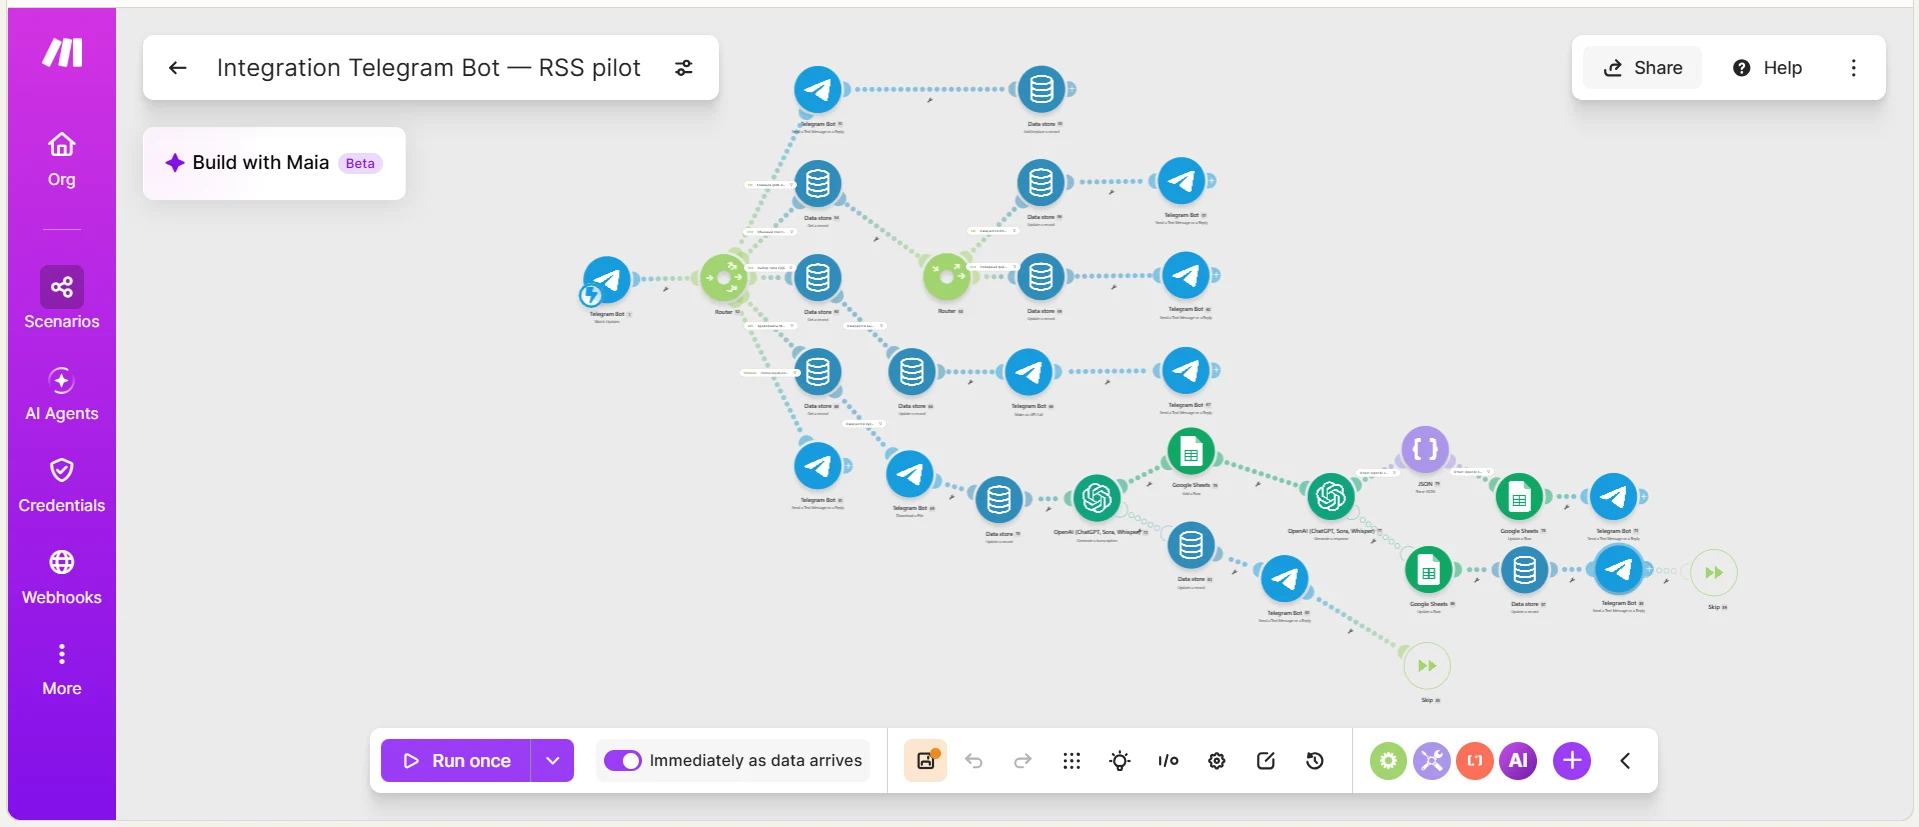
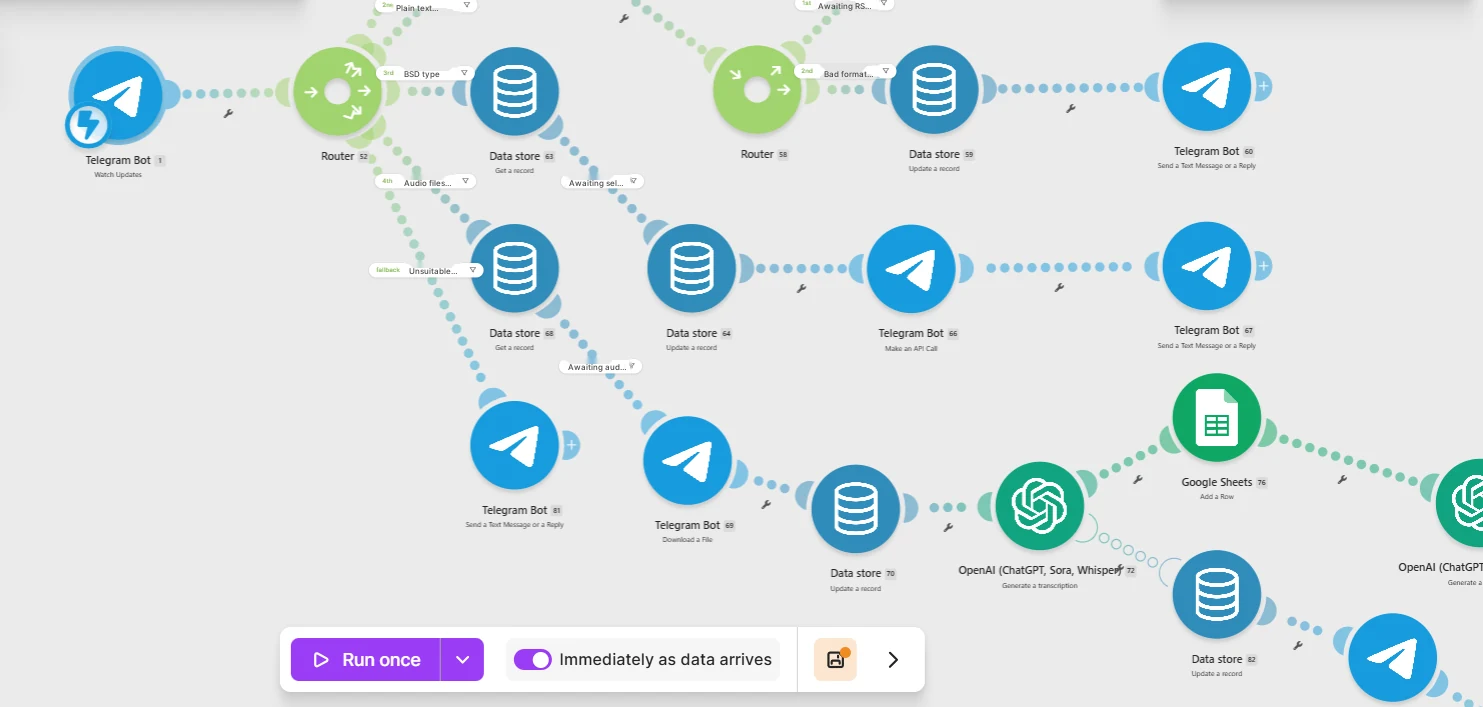
Lingkungan modern bekerja hampir tanpa operator manual. Supervisor mengirimkan rekaman audio ke bot Telegram. Make menerima file, memeriksa data masukan, dan memulai rute pemrosesan. AI menganalisis rekaman berdasarkan metodologi yang ditentukan, menghasilkan penilaian dan feedback. Hasilnya dikembalikan ke pengguna dan secara bersamaan dicatat di Google Sheets untuk analitik umum.
Dalam proyek percontohan saat ini, feedback dikembalikan dalam waktu sekitar puluhan detik. Bagi pengguna, kelihatannya sederhana: mengirimkan audio — menerima penilaian, poin kekuatan, kesalahan spesifik, dan apa yang harus diubah di waktu berikutnya.
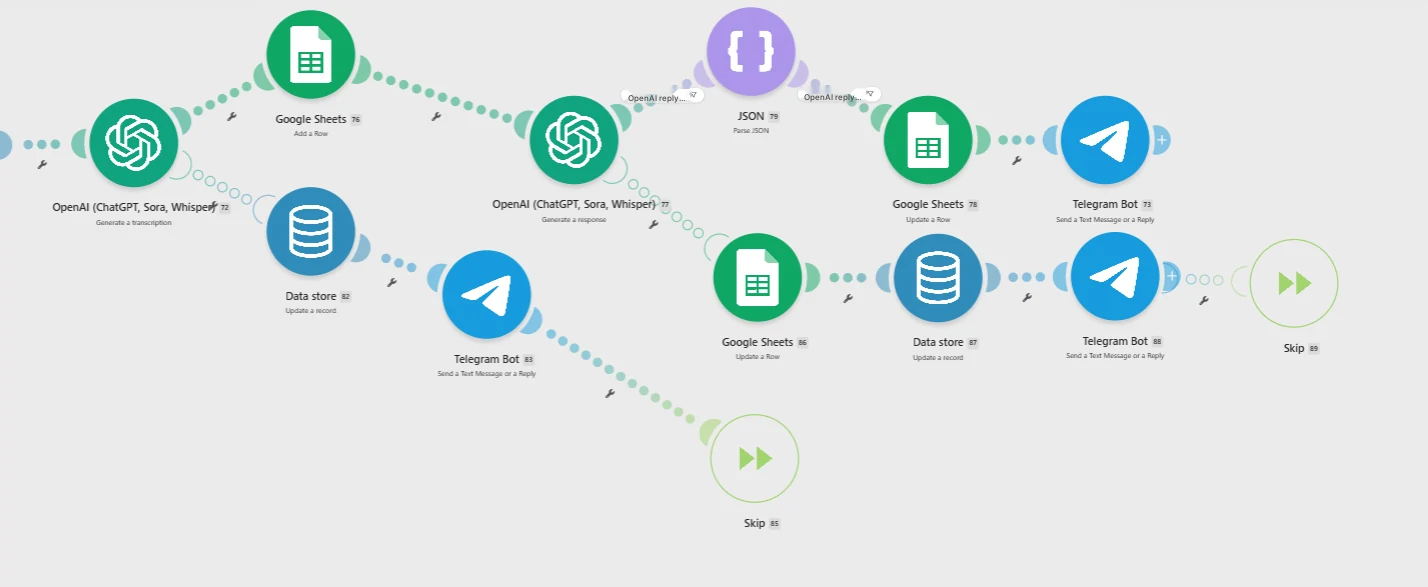
Pada skema Make, terlihat bahwa di balik kesederhanaan ini terdapat perutean yang utuh: Telegram, Data store, Router, OpenAI, Google Sheets, pemeriksaan, dan pesan balasan kepada pengguna.
Apakah ini multi-agen atau bukan?
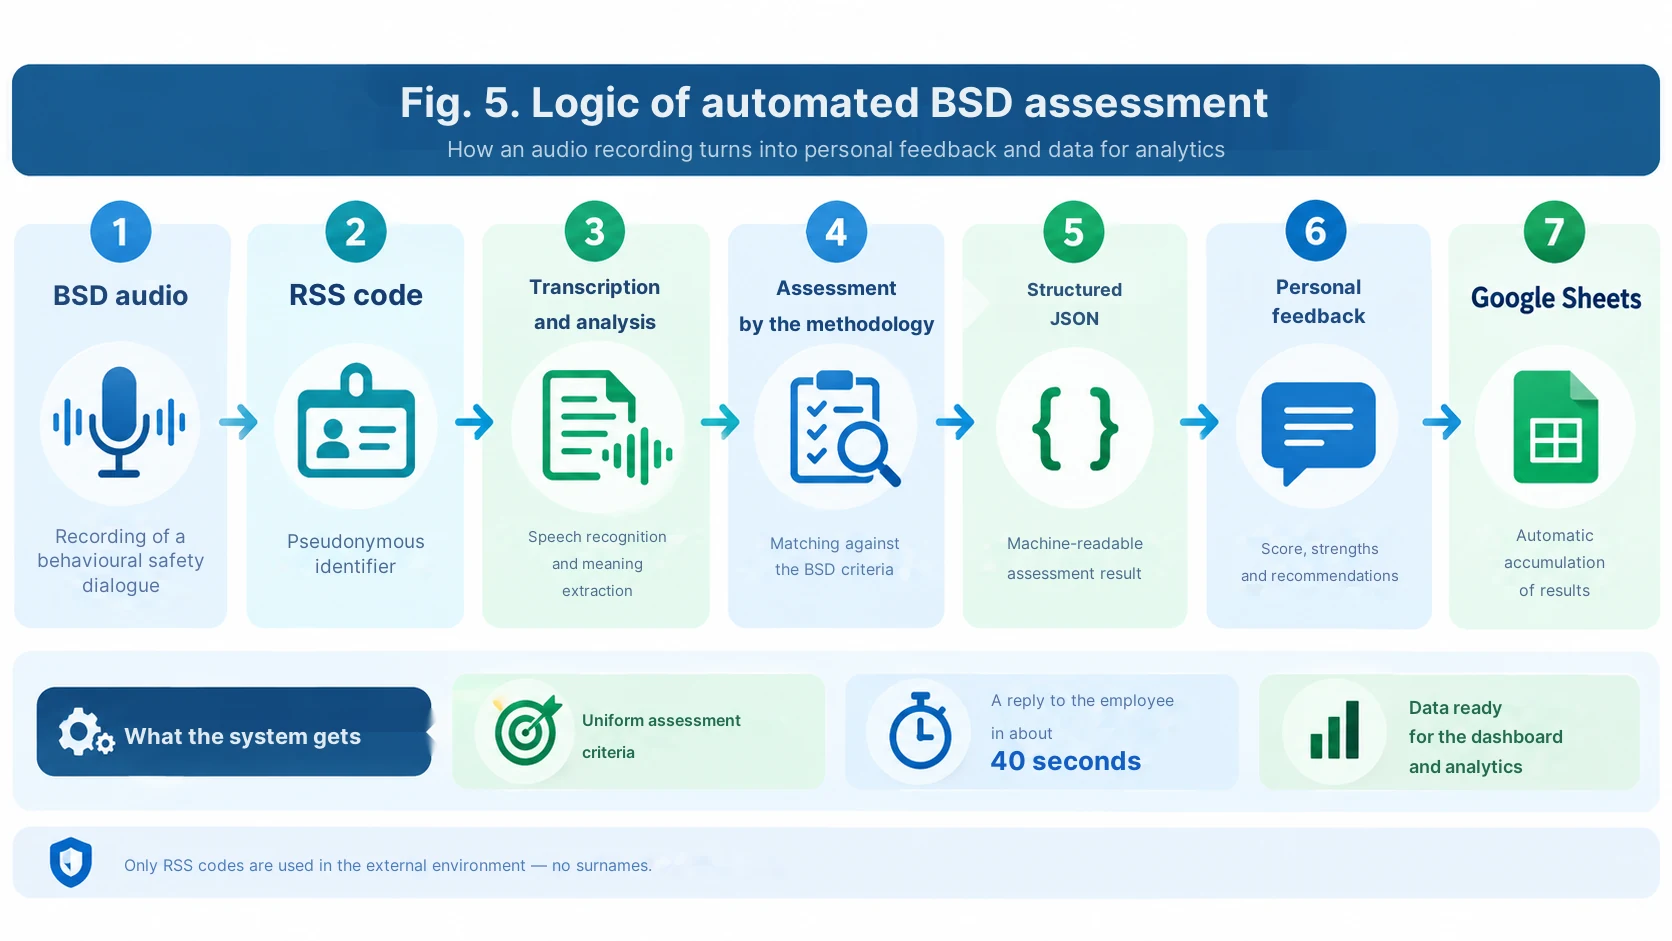
Saya tidak akan menggunakan kata «multi-agen» di sini hanya untuk mencari efek. Pada praktiknya, kita memiliki alur pakar multi-langkah, di mana berbagai bagian skenario menjalankan fungsi yang berbeda: penerimaan dan perutean file, ekstraksi pengidentifikasi, analisis konten, penilaian pakar, pembentukan hasil terstruktur, penulisan ke tabel, dan umpan balik personal.
Jika beberapa pemanggilan model terpisah bekerja dengan peran sistem yang berbeda — misalnya, satu menganalisis dialog, yang kedua mengontrol kepatuhan terhadap metodologi dan memformat hasilnya, — ini sudah dapat dianggap sebagai logika multi-agen atau banyak-agen. Jika satu pemanggilan model menjalankan semua fungsi, lebih jujur untuk menyebutnya sebagai penilai AI multifungsi.
Oleh karena itu, pada lampiran saya membagi Prompt berdasarkan fungsi, daripada menyebut setiap fungsi sebagai agen terpisah.
Bagaimana otomatisasi penilaian PDB dirancang
Dalam skenario industri, penting untuk memisahkan dua tugas. Pertama — pakar: menilai konten percakapan secara ketat sesuai dengan metodologi. Kedua — teknis: mengembalikan hasil dalam format yang akan dipahami Make dan dapat ditulis ke Google Sheets.
Oleh karena itu, untuk otomatisasi, respons JSON yang terstruktur sangat mudah digunakan: kode RSS, skor akhir, status, kekuatan, area perbaikan, umpan balik singkat, dan kriteria penilaian terpisah. Format seperti ini mengurangi risiko otomatisasi menjadi «rusak» karena teks model yang indah namun tidak dapat diprediksi.
Pada saat yang sama, aturan ketat tetap sama seperti di musim semi: jangan menghitung apa yang tidak ada dalam rekaman; jangan menebak niat; jangan mengarang jawaban yang benar untuk manajer. Jika transkripsi tidak lengkap — rekaman harus dikirim untuk diunggah ulang, bukan menerima penilaian palsu.
Prompts 4–6 — penilaian PDB, JSON terstruktur, dan pembentukan umpan balik, lihat di lampiran.
Dari penilaian personal menuju gambaran per departemen
Setelah setiap penilaian, yang terakumulasi di Google Sheets bukan lagi sekadar umpan balik teks, melainkan susunan yang terstruktur. Oleh karena itu, kita dapat melihat jumlah PDB yang dilakukan, hasil rata-rata, kesalahan utama yang berulang, dinamika, dan hasil berdasarkan kode RSS pseudonim.
Langkah selanjutnya sudah kita ketahui dari artikel kedua: mencocokkan secara lokal kode RSS dengan nama lengkap dalam lingkungan perusahaan dan memuat hasilnya ke dasbor HSE otonom. Dengan demikian, manajer melihat gambaran di seluruh perusahaan, pabrik, dan lokasi kerja, dan jika perlu, melihat lebih dalam hingga ke pekerja tertentu.
Artinya, alur penilaian eksternal dapat beroperasi tanpa nama belakang, dan gambaran manajerial yang utuh hanya dapat dipulihkan di dalam perusahaan.
Bagaimana ide ini dapat direplikasi tanpa arsitektur kita
Esensi dari pendekatan ini tidak terikat pada satu merek AI. Pada varian yang paling sederhana, Anda dapat membuat Perplexity Project dengan metodologi dan Prompt penilaian. Anda dapat menggunakan ChatGPT dengan instruksi permanen dan basis pengetahuan yang dimuat. Anda dapat membangun skema di sekitar Google NotebookLM / Gemini Notebook sebagai sumber materi metodologis, sedangkan penilaian dilakukan oleh model terpisah. Untuk aliran massal, lebih mudah menggunakan Make atau platform otomatisasi lainnya dengan Telegram, OpenAI, dan tabel.
Elemen-elemen kuncinya tetap sama: metodologi yang disetujui → Prompt ketat → pemeriksaan reprodusibilitas → skala yang mudah dipahami → umpan balik personal → akumulasi hasil yang terstruktur.
Apa yang berubah selama beberapa bulan ini
Di musim semi, seorang karyawan secara manual mentransfer file audio ke AI dan mengembalikan hasilnya. Hari ini, kami membangun alur yang mampu menerima dan menilai sekitar 1300 rekaman PDB tanpa memerlukan operator terpisah untuk setiap file.
Namun, perubahan utamanya bahkan bukan pada kecepatan. Kami mendapatkan kemampuan untuk menerapkan kriteria yang sama pada sejumlah besar percakapan nyata dan mengubah setiap penilaian menjadi siklus pembelajaran individu yang singkat.
AI dalam skema ini — bukanlah seorang inspektur yang mencari siapa yang bersalah. AI secara bersamaan merupakan pakar kedua dan pelatih digital: ia mencatat ketidaksesuaian dengan metodologi, menjelaskan apa yang sebenarnya perlu diperbaiki, dan memungkinkan Anda untuk memeriksanya di percakapan berikutnya.
Kesimpulan
Saat kami memulai, tugas tersebut terdengar seperti sebuah eksperimen: mungkinkah AI menilai safety talk. Hasilnya adalah sebuah teknologi yang dapat diskalakan ke dialog keselamatan perilaku, pelatihan, dan jenis komunikasi keselamatan lainnya.
Bagi saya, hasil yang paling berharga — bukanlah angka otomatis. Nilainya terletak pada fakta bahwa manajer menerima umpan balik segera setelah percakapan nyata, dan pada saat yang sama perusahaan menerima kumpulan data tentang elemen metodologi apa yang sebenarnya sulit bagi orang-orang.
Tepat di titik inilah AI mulai bekerja bukan sebagai pengganti sistem manajemen keselamatan, tetapi di dalamnya — sebagai pakar kedua yang seragam.
Prompt untuk artikel «AI sebagai pakar kedua»
Safety talk, pemeriksaan reprodusibilitas, Make, dan otomatisasi penilaian PDB
Ini adalah versi publikasi dari Prompt tersebut. Ia didasarkan pada metodologi nyata dan arsitektur kerja kami, tetapi sebelum diterapkan di perusahaan lain, kriteria dan ambang batas harus diganti dengan persyaratan lokal yang disetujui.
Prompt 1. Penilaian safety talk yang dimodernisasi di Perplexity Project
Ini adalah versi publikasi yang disempurnakan dari Prompt yang sedang berjalan. Saya telah memperbaiki kontradiksi internal: daftar periksa sekarang benar-benar berisi 7 kriteria, dan ambang batas kelulusan sama di semua tempat — 80%.
Anda bertindak sebagai pakar K3 dan keselamatan industri yang melakukan penilaian kontrol terhadap kualitas pelaksanaan toolbox talk oleh supervisor shift.

SUMBER DAN PRIORITAS
1. Rekaman audio toolbox talk.
2. Panduan metodologi perusahaan yang disetujui.
3. Daftar periksa penilaian yang disetujui.
Jika terjadi konflik rumusan, berpedomanlah pada daftar periksa dan metodologi yang disetujui. Jangan menambahkan kriteria sendiri.

TAHAP 1. TRANSKRIPSI LENGKAP
- Pertama-tama, dapatkan transkripsi audio yang lengkap, bukan ringkasan singkat.
- Untuk Perplexity Project, gunakan alat pembaca file audio terlampir yang tersedia dalam mode penuh (READ / anggaran konteks maksimal yang tersedia).
- Tandai fragmen yang tidak jelas dengan [tidak jelas].
- Jika kurang dari 80% ucapan dikenali secara koheren atau sebagian besar rekaman hilang, jawab saja: «Data tidak cukup. Unggah ulang file.» lalu berhenti.
- Jangan tampilkan transkripsi lengkap ke dalam laporan akhir.

TAHAP 2. PENILAIAN PAKAR
Nilailah hanya apa yang benar-benar terdengar dalam transkripsi lengkap.
Dilarang:
- menebak-nebak niat mandor;
- menghitung hal yang tidak ada dalam rekaman;
- memperbaiki kalimat atas nama orang yang dinilai;
- mengkompensasi elemen yang tidak ada dengan kesan baik secara umum.

SKALA UNTUK SETIAP KRITERIA
Selesai = 1 poin.
Sebagian = 0,5 poin.
Tidak selesai = 0 poin.
Aturan:
- tidak ada di audio → 0;
- disebutkan secara formal, tanpa penjelasan → 0,5;
- dijelaskan secara logis dan benar → 1.

DAFTAR PERIKSA — NILAI SEMUA 7 POIN TANPA ADA YANG TERLEWAT
1. Perkenalan diri dan tujuan toolbox talk.
2. Nama bahaya spesifik / topik saat ini.
3. Logika «bahaya → konsekuensi → langkah-langkah keselamatan».
4. Dorongan emosional melalui konsekuensi nyata/potensial atau contoh yang relevan.
5. Langkah-langkah keselamatan spesifik.
6. Dialog dengan pekerja: pertanyaan, jawaban, pelibatan.
7. Ringkasan akhir dan kaitan dengan pekerjaan saat ini / yang akan datang.

FORMAT JAWABAN
1. Tabel:
No | Kriteria | Apa yang sebenarnya terdengar | Penilaian | Poin

2. Hasil:
Dicapai: X dari 7.
Persentase: (X/7)*100, bulatkan ke 1 angka desimal.

3. Status siklus:
- jika hasil >=80%: «Tingkat kelulusan tercapai»;
- jika hasil <80%: «Tingkat kelulusan tidak tercapai. Disarankan melakukan toolbox talk ulang setelah mempelajari umpan balik».

4. Kekuatan — 2–5 poin spesifik, hanya dari rekaman.
5. Area perbaikan — spesifik pada kriteria yang tidak selesai/selesai sebagian.
6. Umpan balik kepada mandor — 3–5 kalimat: gaya bisnis, menuntut, membangun.

KONTROL SEBELUM MENJAWAB
Sebelum memberikan jawaban akhir, periksa kembali:
- jumlah poin sesuai dengan tabel;
- persentase dihitung dengan benar;
- tidak ada satu pun dari 7 kriteria yang terlewat;
- tidak ada satu pun pernyataan yang didasarkan pada sesuatu yang tidak ada dalam audio.
Komentar: Dari versi aslinya, prinsip utamanya tetap dipertahankan: pertama transkripsi lengkap, lalu penilaian hanya pada apa yang sebenarnya terdengar. Di Perplexity, nama spesifik alat pembaca file bisa berubah, jadi dalam versi publik lebih baik mendeskripsikan fungsinya daripada mengikat pembaca secara ketat pada nama search_files_v2.
Prompt 2. Pemeriksaan reproduktibilitas («objektivitas digital»)
Prompt ini digunakan setelah beberapa kali eksekusi independen dari rekaman yang sama.
Saya melakukan validasi reproduktibilitas penilai AI.

Saya memiliki hasil dari N penilaian independen dari REKAMAN AUDIO YANG SAMA menggunakan daftar periksa yang sama.
Saya akan memberikan tabel/JSON akhir dari setiap eksekusi.

Tugas Anda:
1. Membandingkan persentase akhir di antara eksekusi.
2. Membandingkan poin untuk setiap kriteria.
3. Menyoroti kriteria di mana model paling sering mengubah keputusannya.
4. Menghitung:
   - persentase akhir minimum;
   - persentase akhir maksimum;
   - rentang dalam poin persentase;
   - persentase akhir rata-rata.
5. Jangan menilai ulang rekaman aslinya dan jangan memilih penilaian yang «benar» — cukup analisis stabilitas penilai.

KRITERIA UNTUK PILOT
- perbedaan 0–2 p.p. — reproduktibilitas tinggi;
- 2,1–5 p.p. — dapat diterima, tetapi periksa kriteria yang diperdebatkan;
- lebih dari 5 p.p. — prompt/kriteria memerlukan perbaikan.

Berikan output dalam format:
- Tingkat reproduktibilitas;
- Di mana sebaran terjadi;
- Apa sebenarnya dalam prompt yang perlu dibuat lebih tidak ambigu;
- Apakah perlu mengulang tes setelah koreksi.

Jangan menyebutnya sebagai objektivitas absolut. Gunakan istilah «reproduktibilitas penilaian».
Komentar: Ambang batas sebaran dalam contoh adalah pedoman kerja untuk publikasi, bukan norma perusahaan yang disetujui. Anda dapat menghapusnya atau menggantinya dengan milik Anda sendiri.
Prompt 3. ChatGPT sebagai mentor Make langkah demi langkah
Ini adalah prinsip yang sama persis yang memungkinkan seseorang tanpa keterampilan pemrograman untuk mengulangi solusi tersebut.
Saya bukan seorang programmer dan belum pernah merakit skenario di Make sebelumnya.
Bantu saya membuat otomatisasi dengan prinsip «satu tindakan pada satu waktu».

TUJUAN
Bot Telegram menerima rekaman audio dari dialog keselamatan perilaku. Selanjutnya Make harus:
1. mendapatkan file;
2. memeriksa jenis input;
3. mengekstrak/mendapatkan audio;
4. mengirimkan materi ke AI untuk dianalisis;
5. mendapatkan hasil yang terstruktur dengan ketat;
6. mencatat hasil ke Google Sheets;
7. mengirimkan umpan balik pribadi yang singkat kepada pengguna;
8. menangani kesalahan, file ganda, dan format yang tidak didukung dengan benar.

ATURAN KERJA KITA
- Berikan hanya SATU langkah selanjutnya per pesan.
- Tuliskan nama persis modul Make yang perlu ditambahkan.
- Tuliskan apa yang harus dipilih di setiap kolom yang wajib diisi.
- Jika variabel dari modul sebelumnya diperlukan — tunjukkan asal pastinya.
- Setelah setiap langkah, berhentilah dan minta saya mengirimkan tangkapan layar.
- Melalui tangkapan layar saya, pertama-tama periksa apakah semuanya dilakukan dengan benar. Jika ada kesalahan — kita perbaiki dan baru setelah itu kita lanjutkan.
- Jangan lompati tahapan dan jangan kirimkan seluruh skenario sekaligus.
- Jelaskan dengan kata-kata sederhana, tanpa berasumsi bahwa saya mengetahui API, JSON, atau pemrograman.
- Jika ada beberapa cara, pilih yang paling sederhana dan andal untuk pilot serta jelaskan alasannya secara singkat.

BATASAN
- pengidentifikasi pengguna dalam sirkuit penilaian adalah kode pseudonim seperti RSS 1234;
- nama belakang dan nomor kepegawaian tidak diperlukan;
- hasil untuk tabel harus terstruktur;
- orang di Telegram hanya dikirimi umpan balik yang dapat dipahami, tanpa teknis JSON.

Mulailah dengan langkah pertama: membuat/menghubungkan bot Telegram dan modul input pertama Make.
Prompt 4. Inti penilaian BSD untuk OpenAI/ChatGPT di Make
Ini adalah versi publikasi universal dari blok evaluasi. Versi ini secara khusus mengembalikan JSON — dengan begitu Make lebih mudah mencatat hasilnya ke dalam tabel dan merutekan jawabannya.
SYSTEM ROLE
Anda adalah penilai pakar kualitas dialog keselamatan perilaku (BSD). Anda mengevaluasi HANYA konten transkripsi yang diberikan dan menerapkan metodologi perusahaan yang disetujui.

PENTING
Jika perusahaan telah menyediakan daftar periksa yang disetujui secara terpisah — itu memiliki prioritas di atas perkiraan struktur di bawah ini.
Jangan membuat kriteria yang tidak ada dalam metodologi.

PRINSIP-PRINSIP DASAR METODOLOGI YANG HARUS DIPERIKSA MELALUI AUDIO
- ada percakapan nyata dengan pekerja, bukan monolog/inspeksi;
- pekerja ditanyai pertanyaan;
- pekerja itu sendiri menyebutkan/mendiskusikan bahaya dan konsekuensi yang mungkin terjadi, jika situasinya berbahaya;
- mendiskusikan cara kerja yang aman;
- mendiskusikan sumber bahaya lain dan langkah-langkah keselamatan;
- pada pekerjaan yang aman, supervisor mencatat dan memperkuat tindakan aman yang spesifik;
- komunikasi berjalan dengan penuh hormat;
- percakapan diakhiri dengan kesimpulan/ucapan terima kasih yang jelas;
- jangan menghitung pengamatan visual jika tidak dapat dikonfirmasi dari audio.

INPUT
- transcript: transkripsi lengkap;
- rss_id: pengidentifikasi pseudonim seperti RSS 1234;
- methodology_context: kutipan/aturan dari metodologi yang disetujui;
- optional_checklist: daftar periksa lokal yang disetujui, jika ada.

ATURAN PENILAIAN
1. Gunakan hanya fakta-fakta dari transcript.
2. Jangan menebak-nebak niat.
3. Jangan mengembalikan nama lengkap berdasarkan suara/konteks.
4. Jika transkrip jelas-jelas tidak lengkap atau tidak koheren — quality_status="insufficient_data" dan jangan berikan penilaian akhir.
5. Jika daftar periksa lokal diterapkan, nilai semua poinnya tanpa ada yang terlewat.
6. Untuk setiap kesimpulan, simpan evidence yang singkat — frasa/konten dari transkripsi yang mengonfirmasi keputusan tersebut.

OUTPUT — HANYA JSON, TANPA MARKDOWN DAN TANPA TEKS SEBELUM/SESUDAH
{
  "rss_id": "RSS 1234",
  "quality_status": "ok | insufficient_data",
  "overall_score_percent": 0,
  "result_status": "meets | partly_meets | does_not_meet | not_scored",
  "criteria": [
    {
      "criterion": "...",
      "score": 0,
      "max_score": 1,
      "evidence": "...",
      "comment": "..."
    }
  ],
  "strengths": ["..."],
  "improvements": ["..."],
  "feedback_short": "3–5 kalimat, dapat dipahami oleh supervisor",
  "method_errors": ["..."],
  "worker_involvement": "high | medium | low | not_clear"
}

SEBELUM MENJAWAB, PERIKSA
- JSON valid;
- rss_id tidak diubah;
- poin akhir sesuai dengan jumlah kriteria;
- evidence tidak mengandung fakta yang dikarang;
- jika data tidak cukup, tidak ada overall_score_percent yang dikarang.
Komentar: Karena daftar periksa berbasis poin terpisah yang disetujui untuk PDB tidak terdapat dalam materi yang diberikan, saya tidak menyajikan skala buatan sendiri sebagai standar perusahaan. Dalam versi kerja, Anda perlu memasukkan daftar periksa aktual Anda.
Prompt 5. Modul umpan balik terpisah di Telegram
Jika skenario menggunakan pemanggilan model yang kedua, sebaiknya dibatasi hanya untuk memformat penilaian yang sudah selesai. Ini meningkatkan stabilitas: modul kedua tidak boleh "memikirkan ulang" poin penilaian.
Anda menerima JSON penilaian ahli PDB yang SUDAH SELESAI dari langkah sebelumnya.
Jangan menilai ulang rekaman dan jangan mengubah poin penilaian.

Buat balasan singkat untuk pengguna di Telegram.

FORMAT
RSS: <kode>
Penilaian: <persentase atau "tidak dinilai — data tidak cukup">

Apa yang dilakukan dengan baik:
• 2–4 poin singkat dari strengths

Apa yang perlu ditingkatkan:
• 2–4 poin spesifik dari improvements

Untuk PDB berikutnya:
<1–2 tindakan yang paling spesifik>

ATURAN
- maksimum 700–1200 karakter;
- nada bisnis dan sopan;
- tanpa JSON teknis;
- tanpa nama keluarga;
- jangan mengarang komentar baru;
- jangan menggunakan slogan motivasi;
- jika quality_status=insufficient_data — minta untuk merekam/mengunggah ulang audio dan jangan tampilkan penilaian.
Prompt 6. Normalisasi hasil sebelum Google Sheets
Langkah ini berguna jika Google Sheets harus menerima struktur yang sama terlepas dari panjang teks penilaian.
Periksa baris data sebelum ditulis ke Google Sheets.

Bidang yang diharapkan:
- timestamp
- rss_id
- overall_score_percent
- result_status
- worker_involvement
- strengths_short
- improvements_short
- method_errors_short
- feedback_short
- source_message_id

ATURAN
1. Jangan tambahkan nama lengkap dan nomor induk karyawan.
2. rss_id harus sesuai dengan pola: RSS + spasi + 3–6 angka.
3. overall_score_percent harus berupa angka 0–100 atau kosong jika insufficient_data.
4. Ubah array menjadi string pendek dengan pemisah «; ».
5. Jika ada bidang wajib yang hilang — kembalikan error=true dan sebutkan missing_fields.
6. Jika semuanya benar — error=false.

KELUARAN HANYA JSON:
{
  "error": false,
  "missing_fields": [],
  "row": {
    "timestamp": "...",
    "rss_id": "...",
    "overall_score_percent": 0,
    "result_status": "...",
    "worker_involvement": "...",
    "strengths_short": "...",
    "improvements_short": "...",
    "method_errors_short": "...",
    "feedback_short": "...",
    "source_message_id": "..."
  }
}
Prompt 7. Audit skenario Make yang sudah selesai melalui tangkapan layar
Cocok sebagai Prompt akhir untuk memeriksa skenario sebelum uji coba massal.
Saya akan mengirimkan tangkapan layar dari skenario Make saya.
Lakukan audit teknis sebagai mentor otomasi no-code.

Periksa melalui tangkapan layar dan deskripsi saya:
1. urutan modul;
2. rute Router;
3. penanganan pesan yang tidak didukung;
4. penyimpanan status sementara di Data store;
5. penerimaan dan transmisi file audio;
6. pemanggilan AI;
7. parsing JSON;
8. penulisan ke Google Sheets;
9. pengiriman hasil ke Telegram;
10. cabang kesalahan dan percobaan ulang;
11. risiko duplikat saat peluncuran ulang;
12. risiko di mana satu pengguna mendapatkan hasil dari pengguna lain.

Jangan mengusulkan perombakan total jika arsitektur saat ini berfungsi.
Pertama, sebutkan:
- apa yang sudah baik;
- 3 risiko yang paling kritis;
- SATU langkah selanjutnya apa yang harus dilakukan pertama kali.
Setelah itu, berhenti dan tunggu tangkapan layar/konfirmasi dari saya.
Urutan praktis untuk pembaca
- Unggah metodologi dan daftar periksa yang disetujui ke dalam Project/agen yang dipilih.
- Konfigurasikan Prompt 1 dan ujilah pada beberapa rekaman referensi.
- Jalankan rekaman yang sama beberapa kali dan gunakan Prompt 2 untuk menilai reprodusibilitas.
- Jika otomatisasi diperlukan — mulai dengan Prompt 3 dan rakit Make modul demi modul dengan memeriksa tangkapan layarnya.
- Di Make gunakan Prompt 4 sebagai inti keahlian dan wajibkan JSON yang ketat.
- Jika perlu, pisahkan umpan balik pengguna di Prompt 5.
- Sebelum menulis ke Google Sheets normalisasikan data dengan Prompt 6.
- Sebelum peluncuran massal, periksa seluruh skema dengan Prompt 7.
Komentar 2
Спасибо Александру Бондаренко за статью, есть над чем подумать. ИИ — сейчас очень модная и интересная тема. Коллеги проделали большую работу.
Предложенное решение помогает снизить хроническую перегрузку службы ОТ и ПБ и освободить от рутины как минимум одного сотрудника. На мой взгляд, ключевая польза в том, что система работает как «цифровой тренажер».
Однако, взвешивая все «за» и «против», я бы не советовал масштабировать ИИ-оценку пятиминуток и, тем более, поведенческих диалогов безопасности.
Таким образом, ИИ-оценка:
Не спешите искать в ИИ «второго эксперта», если проблемы с первым.
Иван, спасибо за содержательную обратную связь.
С риском «театра у микрофона» я согласен: если ИИ превратить просто в инструмент контроля ради оценки, пользы будет мало.
Но, наверное, в статье я не до конца раскрыл наш дальнейший путь. Апрельская диктофонная оценка была для нас прежде всего цифровым тренажёром.
ИИ не просто ставил оценку, а давал обратную связь: что сделано хорошо, что нужно улучшить, как лучше вовлекать работников и доносить риски.
Да, человек мог подготовиться и провести показательную пятиминутку. Но этим этапом мы убедились в главном: наши руководители знают и умеют проводить её правильно!
Сегодня мы уже идём дальше. Пятиминутки оцениваются системно по записям стационарных камер в местах выдачи наряд-заданий, а там, где камер нет, используются регистраторы «Ревизор». Это уже не специально подготовленная запись, а обычная ежедневная работа (она также сопровождается индивидуальной обратной связью с рекомендациями).
Поэтому ИИ для нас — не замена руководителю и не «цифровой надзиратель», а постоянный инструмент обучения и обратной связи. Особенно это важно для технически сильных специалистов, которым не всегда легко коротко, понятно и убедительно разговаривать с людьми.
С поведенческими диалогами всё действительно сложнее, и здесь мы пока ищем оптимальную модель. Но принцип остаётся тем же: ИИ не должен заменять живой разговор — он должен помогать руководителю проводить его лучше.
А главный критерий для нас — не оценка алгоритма, а изменение реального поведения людей!